


Questo documento fornisce un'architettura di alto livello per un sistema di AI multi-agente bidirezionale in tempo reale, su Google Cloud. Il sistema aiuta gli utenti a completare attività tecniche, come assemblare componenti complessi, diagnosticare malfunzionamenti delle apparecchiature o seguire procedure di riparazione complesse. Il sistema di AI agentica fornisce indicazioni tecniche basate su dati concreti e monitoraggio automatico della sicurezza tramite un flusso continuo e bidirezionale di dati multimodali.
Il pubblico di destinazione di questo documento include architetti, sviluppatori e amministratori che creano e gestiscono l'infrastruttura e le applicazioni di AI nel cloud. Questo documento presuppone una conoscenza di base degli agenti e dei modelli di AI. Il documento non fornisce indicazioni specifiche per la progettazione e la codifica degli agenti di AI.
La sezione relativa al deployment di questo documento elenca esempi di codice che puoi utilizzare per scoprire come creare ed eseguire il deployment di sistemi di AI multi-agente.
Architettura
Il seguente diagramma mostra una visualizzazione di alto livello di un'architettura che utilizza un sistema di AI multi-agente per abilitare lo streaming di dati multimodali bidirezionale in tempo reale:
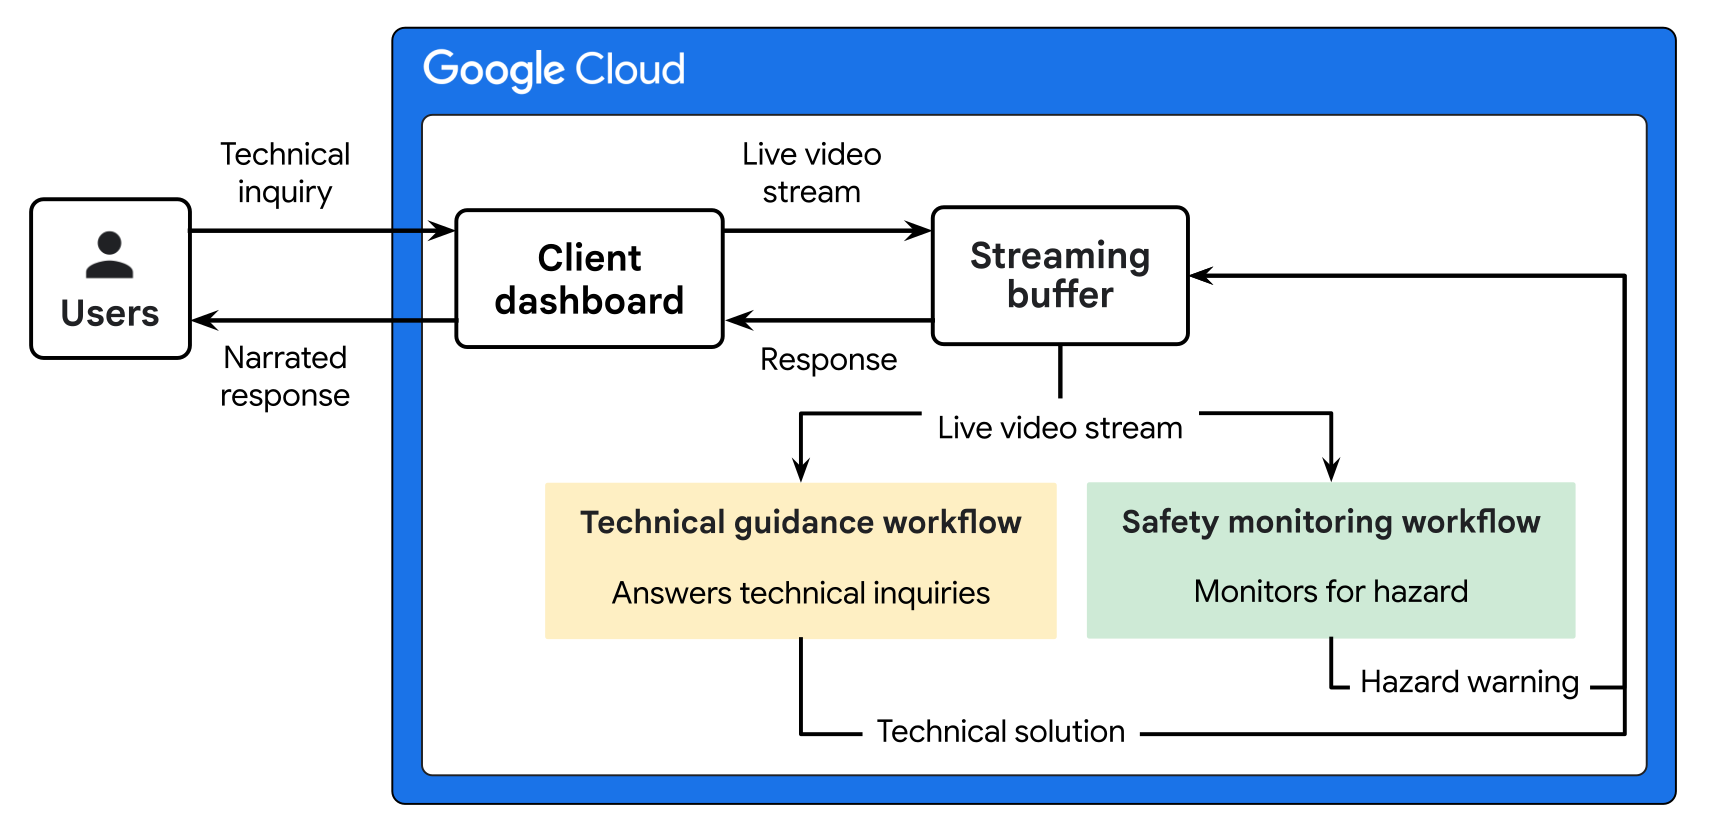
L'architettura nel diagramma precedente ha due flussi di lavoro: indicazioni tecniche e monitoraggio della sicurezza.
- Il flusso di lavoro delle indicazioni tecniche consente agli utenti di ricevere soluzioni narrate in tempo reale a domande tecniche complesse. Questo flusso di lavoro utilizza il modello Gemini Live per elaborare flussi multimodali e coordinarsi con un sottoagente per recuperare informazioni sul prodotto basate su dati concreti dal database di conoscenza.
- Il flusso di lavoro di monitoraggio della sicurezza fornisce il rilevamento automatico dei pericoli per garantire la sicurezza dell'utente durante le procedure tecniche. Questo workflow utilizza Gemini per analizzare i segmenti video in diretta, identificare potenziali rischi e attivare avvisi immediati tramite la dashboard client.
Le seguenti schede forniscono diagrammi dell'architettura che mostrano i flussi di lavoro delle indicazioni tecniche e del monitoraggio della sicurezza:
Flusso di lavoro delle indicazioni tecniche
Il seguente diagramma mostra un'architettura dettagliata per un flusso di lavoro di indicazioni tecniche.
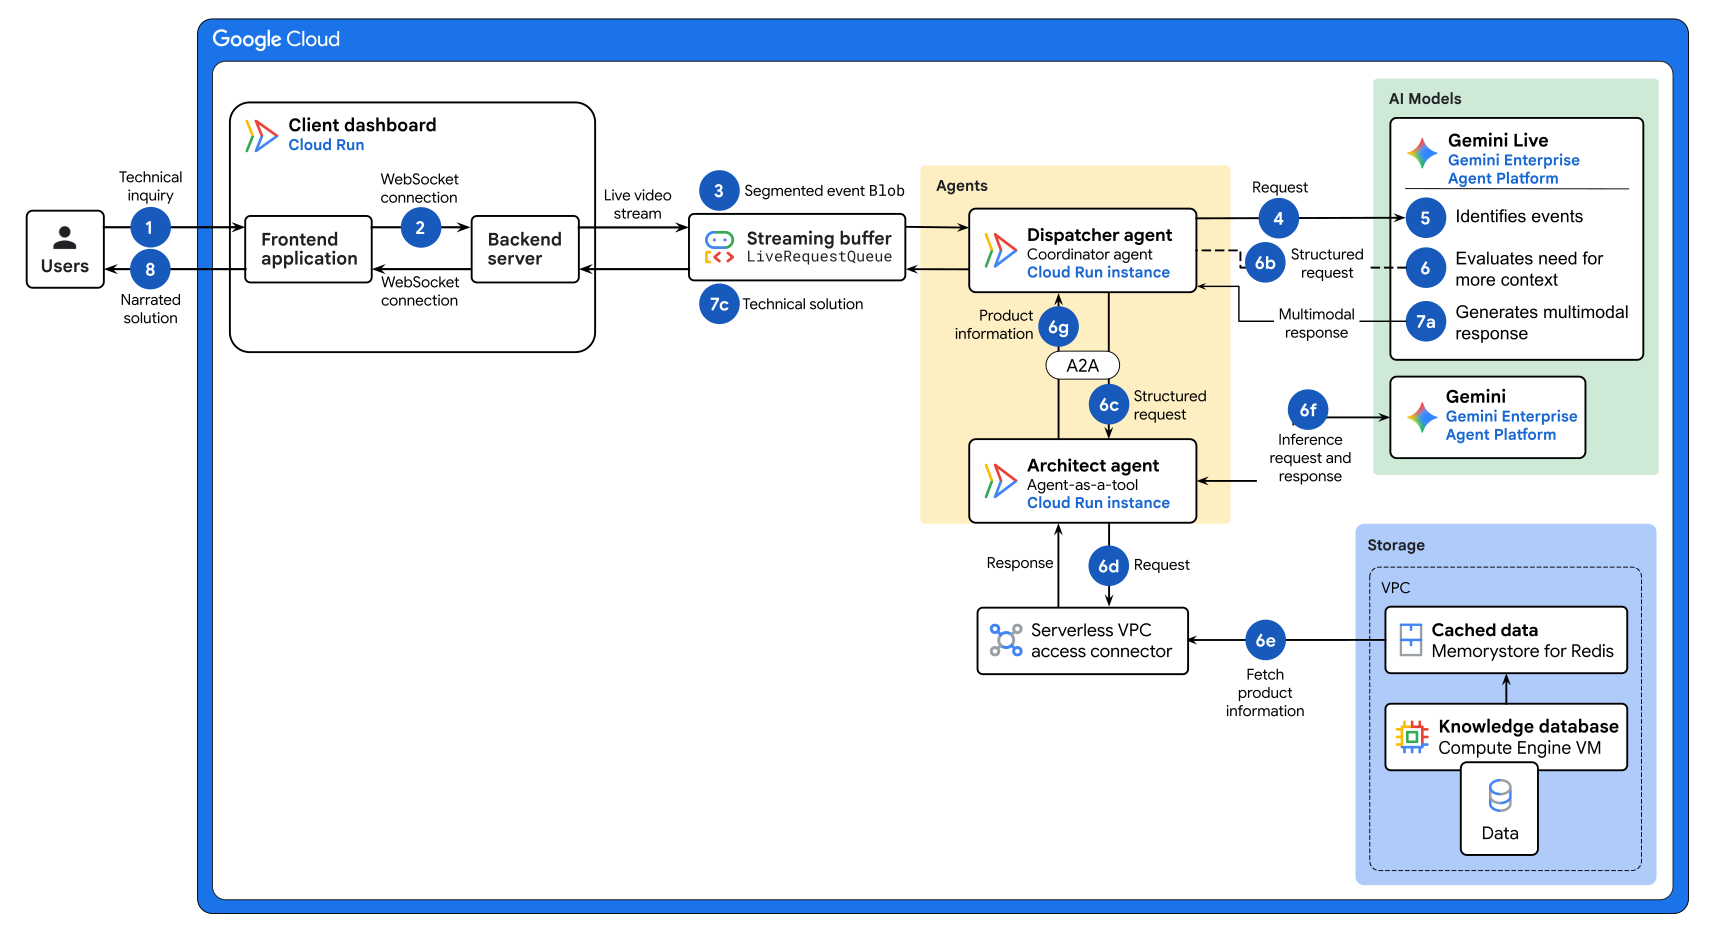
Il diagramma precedente mostra il seguente flusso di dati:
-
Un utente avvia una sessione ponendo una domanda tecnica tramite la dashboard client. Ad esempio, un tecnico potrebbe puntare la fotocamera su un pannello di controllo e chiedere: "Aiuto, cosa significa questa spia rossa di errore lampeggiante?"
-
La dashboard client stabilisce una connessione WebSocket persistente tra il frontend e il server di backend.
-
I messaggi WebSocket impacchettano i dati multimediali non elaborati in oggetti
Blob. Il componenteLiveRequestQueuedi Agent Development Kit (ADK) trasmette continuamente i dati di input all'agente dispatcher. -
L'agente dispatcher rileva i comandi audio o visivi che richiedono indicazioni tecniche e invia il flusso di input al modello Gemini Live.
-
Il modello Gemini Live cerca i dati non elaborati per identificare gli eventi. Gli eventi sono parole chiave audio, come "assembla" o "aiuto", o segnali visivi, come i gesti delle mani.
Gemini valuta ogni evento per determinare se è pertinente alla domanda dell'utente. Ad esempio, un gesto con la mano o le parole di riempimento potrebbero non essere pertinenti, pertanto Gemini non elabora questi eventi.
-
Per ogni evento pertinente, Gemini abilita la chiamata di funzione per valutare se ha bisogno di un contesto aggiuntivo. A seconda che sia necessario un contesto aggiuntivo, Gemini o un agente architetto invia una risposta all'agente dispatcher.
-
Se ha bisogno di un contesto aggiuntivo, Gemini cerca la scheda dell'agente architetto agente scheda per capire come strutturare la richiesta.
-
Gemini invia una richiesta strutturata all'agente dispatcher. La richiesta contiene i dettagli dell'evento, come il tipo di prodotto, il numero di modello, il tipo di evento e gli attributi.
-
L'agente dispatcher utilizza il protocollo Agent2Agent (A2A) per inviare la richiesta strutturata all'agente architetto.
-
L'agente architetto invia la query tramite un connettore di accesso VPC serverless . Il connettore consente all'agente di accedere in modo sicuro alle risorse nella rete Virtual Private Cloud (VPC) utilizzata per le risorse di archiviazione in questa architettura.
-
Il connettore di accesso VPC serverless interagisce con i dati memorizzati nella cache in Memorystore for Redis Cluster. Se i dati non sono disponibili nel livello memorizzato nella cache, l'agente architetto interagisce con le istanze di Compute Engine che ospitano il database di conoscenza.
-
L'agente architetto riceve le informazioni sul prodotto dalla cache di dati o dal database di conoscenza. L'agente architetto invia le informazioni sul prodotto a Gemini per generare una risposta. Ad esempio, "Codice di errore 3B: malfunzionamento della ventola. Azione consigliata: controlla se ci sono ostruzioni."
L'agente architetto invia le informazioni sul prodotto all'agente dispatcher.
Se non ha bisogno di un contesto aggiuntivo, Gemini genera una risposta direttamente alla richiesta dell'utente.
-
-
L'agente dispatcher riceve la risposta da Gemini o dall'agente architetto e genera una risposta multimodale:
-
Utilizza il modello Gemini Live e la funzione
run_livedi ADK per generare una risposta multimodale che contiene la soluzione tecnica. -
Memorizza la risposta come oggetto
Blob. -
Invia la soluzione tecnica tramite il buffer di streaming e la connessione WebSocket persistente per fornire la soluzione tecnica alla dashboard client.
-
-
La dashboard client estrae i dati
Blobdalla soluzione tecnica per fornire indicazioni narrate immediate e aggiorna la UI con le trascrizioni pertinenti. Il ciclo di richiesta viene completato mentre viene mantenuto il flusso bidirezionale attivo.
Flusso di lavoro di monitoraggio della sicurezza
Il seguente diagramma mostra un'architettura dettagliata per un flusso di lavoro di monitoraggio della sicurezza.
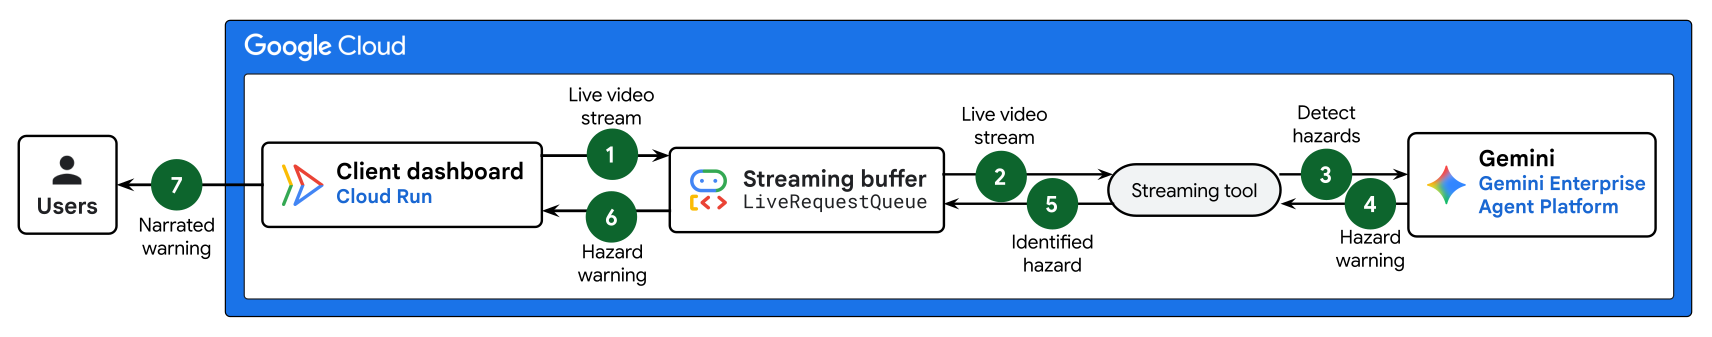
Il diagramma precedente mostra il seguente flusso di dati:
- La dashboard client stabilisce una connessione
WebSocket persistente
tra il frontend e il server di backend per osservare il flusso video
in tempo reale. Il messaggio WebSocket impacchetta questi dati multimediali non elaborati in
Bloboggetti e li invia continuamente al buffer di streaming utilizzando il componente ADKLiveRequestQueue. - Il buffer di streaming indirizza il flusso di input a uno strumento di streaming che viene eseguito in un ciclo di sfondo continuo per rilevare i pericoli nel frame video.
- Lo strumento di streaming invia l'ultimo frame video dal buffer di streaming a Gemini.
- Gemini osserva i frame video
per rilevare eventuali pericoli, come una luce intensa o vapore.
- Se non viene rilevato alcun pericolo, non succede nulla.
- Se viene rilevato un pericolo,
Gemini genera una
risposta multimodale contenente il tipo di pericolo, gli attributi e la sua
posizione e la memorizza come oggetto
Blob. Gemini invia la risposta di avviso di pericolo allo strumento di streaming.
- Lo strumento di streaming inoltra la risposta di avviso di pericolo al buffer di streaming.
- Il buffer di streaming utilizza la connessione WebSocket persistente per fornire la soluzione tecnica alla dashboard client.
- La dashboard client estrae i dati
Blobdalla soluzione tecnica per fornire indicazioni narrate immediate e aggiorna la UI con le trascrizioni pertinenti. In questo modo viene completato il ciclo di richiesta mantenendo attivo il flusso bidirezionale.
Prodotti utilizzati
Questa architettura di riferimento utilizza i seguenti Google Cloud prodotti e strumenti:
- Cloud Run: una piattaforma di computing serverless che ti consente di eseguire container direttamente sull'infrastruttura scalabile di Google.
- Gemini: una famiglia di modelli di AI multimodale sviluppati da Google.
- Gemini Enterprise Agent Platform: una piattaforma completa che ti consente di creare, scalare, gestire e ottimizzare agenti di AI di livello enterprise.
- Agent Development Kit (ADK): un insieme di strumenti e librerie per sviluppare, testare ed eseguire il deployment di agenti di AI.
- Protocollo Agent2Agent (A2A): un protocollo aperto che consente la comunicazione e l'interoperabilità tra gli agenti indipendentemente dal linguaggio di programmazione e dal runtime.
- Accesso VPC serverless: un servizio che consente agli ambienti serverless di connettersi alle risorse in una rete Virtual Private Cloud.
- Virtual Private Cloud (VPC): un sistema virtuale che fornisce funzionalità di rete globali e scalabili per i tuoi Google Cloud workload. VPC include il peering di rete VPC, Private Service Connect, l'accesso privato ai servizi e il VPC condiviso.
- Memorystore for Redis Cluster: un servizio di datastore in memoria completamente gestito per Redis.
- Compute Engine: un servizio di computing sicuro e personalizzabile che ti consente di creare ed eseguire VM sull'infrastruttura di Google.
Per informazioni sulla selezione di componenti alternativi per il sistema di AI agentica inclusi framework, runtime dell'agente, strumenti, memoria e pattern di progettazione, consulta Scegliere i componenti dell'architettura di AI agentica.
Caso d'uso
Questa architettura di riferimento è progettata per i casi d'uso che richiedono la sintesi in tempo reale di flussi di dati multimodali bidirezionali continui. Di seguito sono riportati alcuni esempi di casi d'uso per l'architettura descritta in questo documento:
- Produzione industriale e manutenzione sul campo: consente la riparazione senza mani di macchinari complessi fornendo ai tecnici un assistente AI che elabora audio e video in tempo reale da occhiali smart. Il tecnico parla con l'assistente AI per recuperare gli schemi della macchina. L'assistente AI utilizza un agente di database interno che accede alla documentazione del prodotto per garantire istruzioni di riparazione e assemblaggio basate su dati concreti. Uno strumento di visione in background simultaneo monitora il flusso bidirezionale per avvisare in modo proattivo il tecnico di pericoli meccanici o passaggi di assemblaggio errati.
- Assistenza tecnica da remoto: migliora i risultati della risoluzione dei problemi dei clienti consentendo agli utenti di condividere un feed della fotocamera dello smartphone in tempo reale con un sistema di AI agentica multimodale. L'architettura di streaming bidirezionale supporta una conversazione dinamica in cui il sistema osserva l'hardware in tempo reale. Se un processo di visione in background identifica una connessione difettosa, ad esempio un cavo nella porta sbagliata, il sistema utilizza il flusso a bassa latenza per interrompere immediatamente l'utente con indicazioni correttive.
Note sul layout
Le seguenti sezioni forniscono consigli generali per la progettazione degli agenti di AI e l'implementazione di questa architettura per la produzione.
Progettazione di agenti AI
Per migliorare il costo e il rendimento degli agenti, tieni presente i seguenti consigli:
- Script del ciclo di controllo: scrivi prompt di sistema per gli agenti live bidirezionali come cicli di comportamento di macchine a stati rigorosi anziché solo linee guida sulla personalità. Il prompt di sistema deve indicare esplicitamente all'agente di rimanere in silenzio finché non viene attivato. Deve applicare risposte brevi e orientate all'azione in modo che l'interazione vocale sia concisa e naturale.
- Separazione delle responsabilità: utilizza uno strumento di streaming in background dedicato per monitorare i feed video indipendentemente dall'agente principale. L'agente root nell'architettura è bidirezionale e può interrompere immediatamente il proprio discorso per trasmettere all'utente questi avvisi di sicurezza critici. Inoltre, se chiedi a un singolo agente di monitorare costantemente un feed video, può causare un sovraccarico cognitivo e allucinazioni.
- Prompting conveniente: la lunghezza dei prompt (input) e delle risposte generate (output) influisce direttamente sul rendimento e sul costo. Scrivi prompt brevi, diretti e che forniscano un contesto sufficiente. Progetta i prompt in modo da ottenere risposte concise dal modello. Ad esempio, includi frasi come "riepiloga in 2 frasi" o "elenca 3 punti chiave". Per ulteriori informazioni, consulta le best practice per la progettazione dei prompt.
Progettazione di produzione
Per implementare questa architettura per la produzione, tieni presente i seguenti consigli:
- Sicurezza in entrata: per controllare l'accesso all'applicazione,
disattiva l'URL
run.apppredefinito del servizio Cloud Run frontend e configura un bilanciatore del carico delle applicazioni esterno regionale. Oltre a bilanciare il carico del traffico in entrata verso l'applicazione, il bilanciatore del carico gestisce la gestione dei certificati SSL. Per una maggiore protezione, puoi utilizzare i criteri di sicurezza di Google Cloud Armor per fornire il filtro delle richieste, la protezione dagli attacchi DDoS e limitazione di frequenza per il servizio. - Controllo dell'accesso: quando configuri le autorizzazioni per le risorse nella tua topologia, segui il principio del privilegio minimo.
- Buffering asincrono: per disaccoppiare i pacchetti audio e video in entrata dal motore di inferenza del modello, utilizza un buffer FIFO (First-In-First-Out) asincrono e thread-safe. Questo buffer funge da multiplexer che garantisce che il sistema rimanga reattivo alle interruzioni dell'utente senza bloccare l'interfaccia utente durante i calcoli intensivi.
- Costi di acquisizione dei dati: per ridurre i costi dei token ed evitare l'esaurimento della finestra contestuale, utilizza un campionamento dei frame a bassa frequenza, ad esempio 2 frame al secondo, e comprimi tutti i dati in file JPEG Base64.
- Memorizzazione nella cache in memoria: per ottenere velocità di lettura inferiori al millisecondo, utilizza un database Memorystore for Redis Cluster in memoria per il vault schematico dell'agente architetto. Questa implementazione riduce al minimo la latenza, impedisce i silenzi durante le interazioni vocali in tempo reale e fornisce un'unica fonte di verità scalabile.
- Sicurezza WebSocket: proteggi i dati multimodali sensibili, come le impronte vocali e i video, applicando la crittografia TLS per tutte le connessioni WebSocket bidirezionali.
- Comunicazione A2A sicura:
- Utilizza schede di agenti estese autenticate per proteggere la comunicazione A2A.
- Collega i token di identità OpenID Connect (OIDC) alle richieste. I token di identità OIDC ti consentono di utilizzare Identity and Access Management (IAM) per verificare che solo gli agenti autorizzati accedano ai dati.
- Allocazione delle risorse: a seconda dei requisiti di rendimento, configura i limiti di memoria e i limiti di CPU da allocare al servizio Cloud Run.
Per ulteriori informazioni sui fattori di progettazione, sulle best practice e sui consigli per la creazione e il deployment di un sistema di AI multi-agente, consulta Sistema di AI multi-agente in Google Cloud.
Deployment
Per eseguire il deployment di un'implementazione di esempio di questa architettura, prova i seguenti codelab:
- Codelab per la creazione di un agente di streaming bidirezionale ADK: crea un sistema di AI a singolo agente che elabora uno stream video in diretta per riconoscere gesti specifici dell'utente.
- Codelab per la creazione di un sistema multi-agente bidirezionale in tempo reale: crea un sistema di AI multi-agente che utilizza lo streaming bidirezionale per l'interazione vocale e video in tempo reale. Il sistema include uno strumento di streaming proattivo per il monitoraggio continuo della sicurezza.
Passaggi successivi
- Scopri come avviare e gestire le sessioni live.
- Esplora l'introduzione al toolkit API ADK in Gemini Live.
- Scopri come ospitare agenti di AI su Cloud Run.
- Scopri come scegliere i componenti dell'architettura di AI agentica.
- Esplora le risorse di apprendimento per creare ed eseguire il deployment di agenti di livello enterprise con Gemini Enterprise Agent Ready (GEAR).
- Esplora altre guide all'architettura di AI agentica.
- Per una panoramica dei principi e dei consigli di architettura specifici per i workload di AI e ML in Google Cloud, consulta la prospettiva AI e ML nel framework Well-Architected.
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora il Cloud Architecture Center.
Collaboratori
Autori:
- Christina Lin | Developer Relations Engineer Manager
- Samantha He | Technical Writer
Altri collaboratori:
- Kumar Dhanagopal | Cross-Product Solution Developer
- Olivier Bourgeois | Developer Relations Engineer