


Gen AI Evaluation Service 提供企業級工具,可以客觀、資料導向的方式評估生成式 AI 模型。這項功能支援並提供多項開發工作的相關資訊,例如模型遷移、提示編輯和微調。
Gen AI Evaluation Service 功能
Gen AI Evaluation Service 的主要特色是能使用調整型評分量表,也就是針對每個提示詞量身打造的通過/不通過測試。評估量表類似於軟體開發中的單元測試,旨在提升模型在各種工作上的效能。
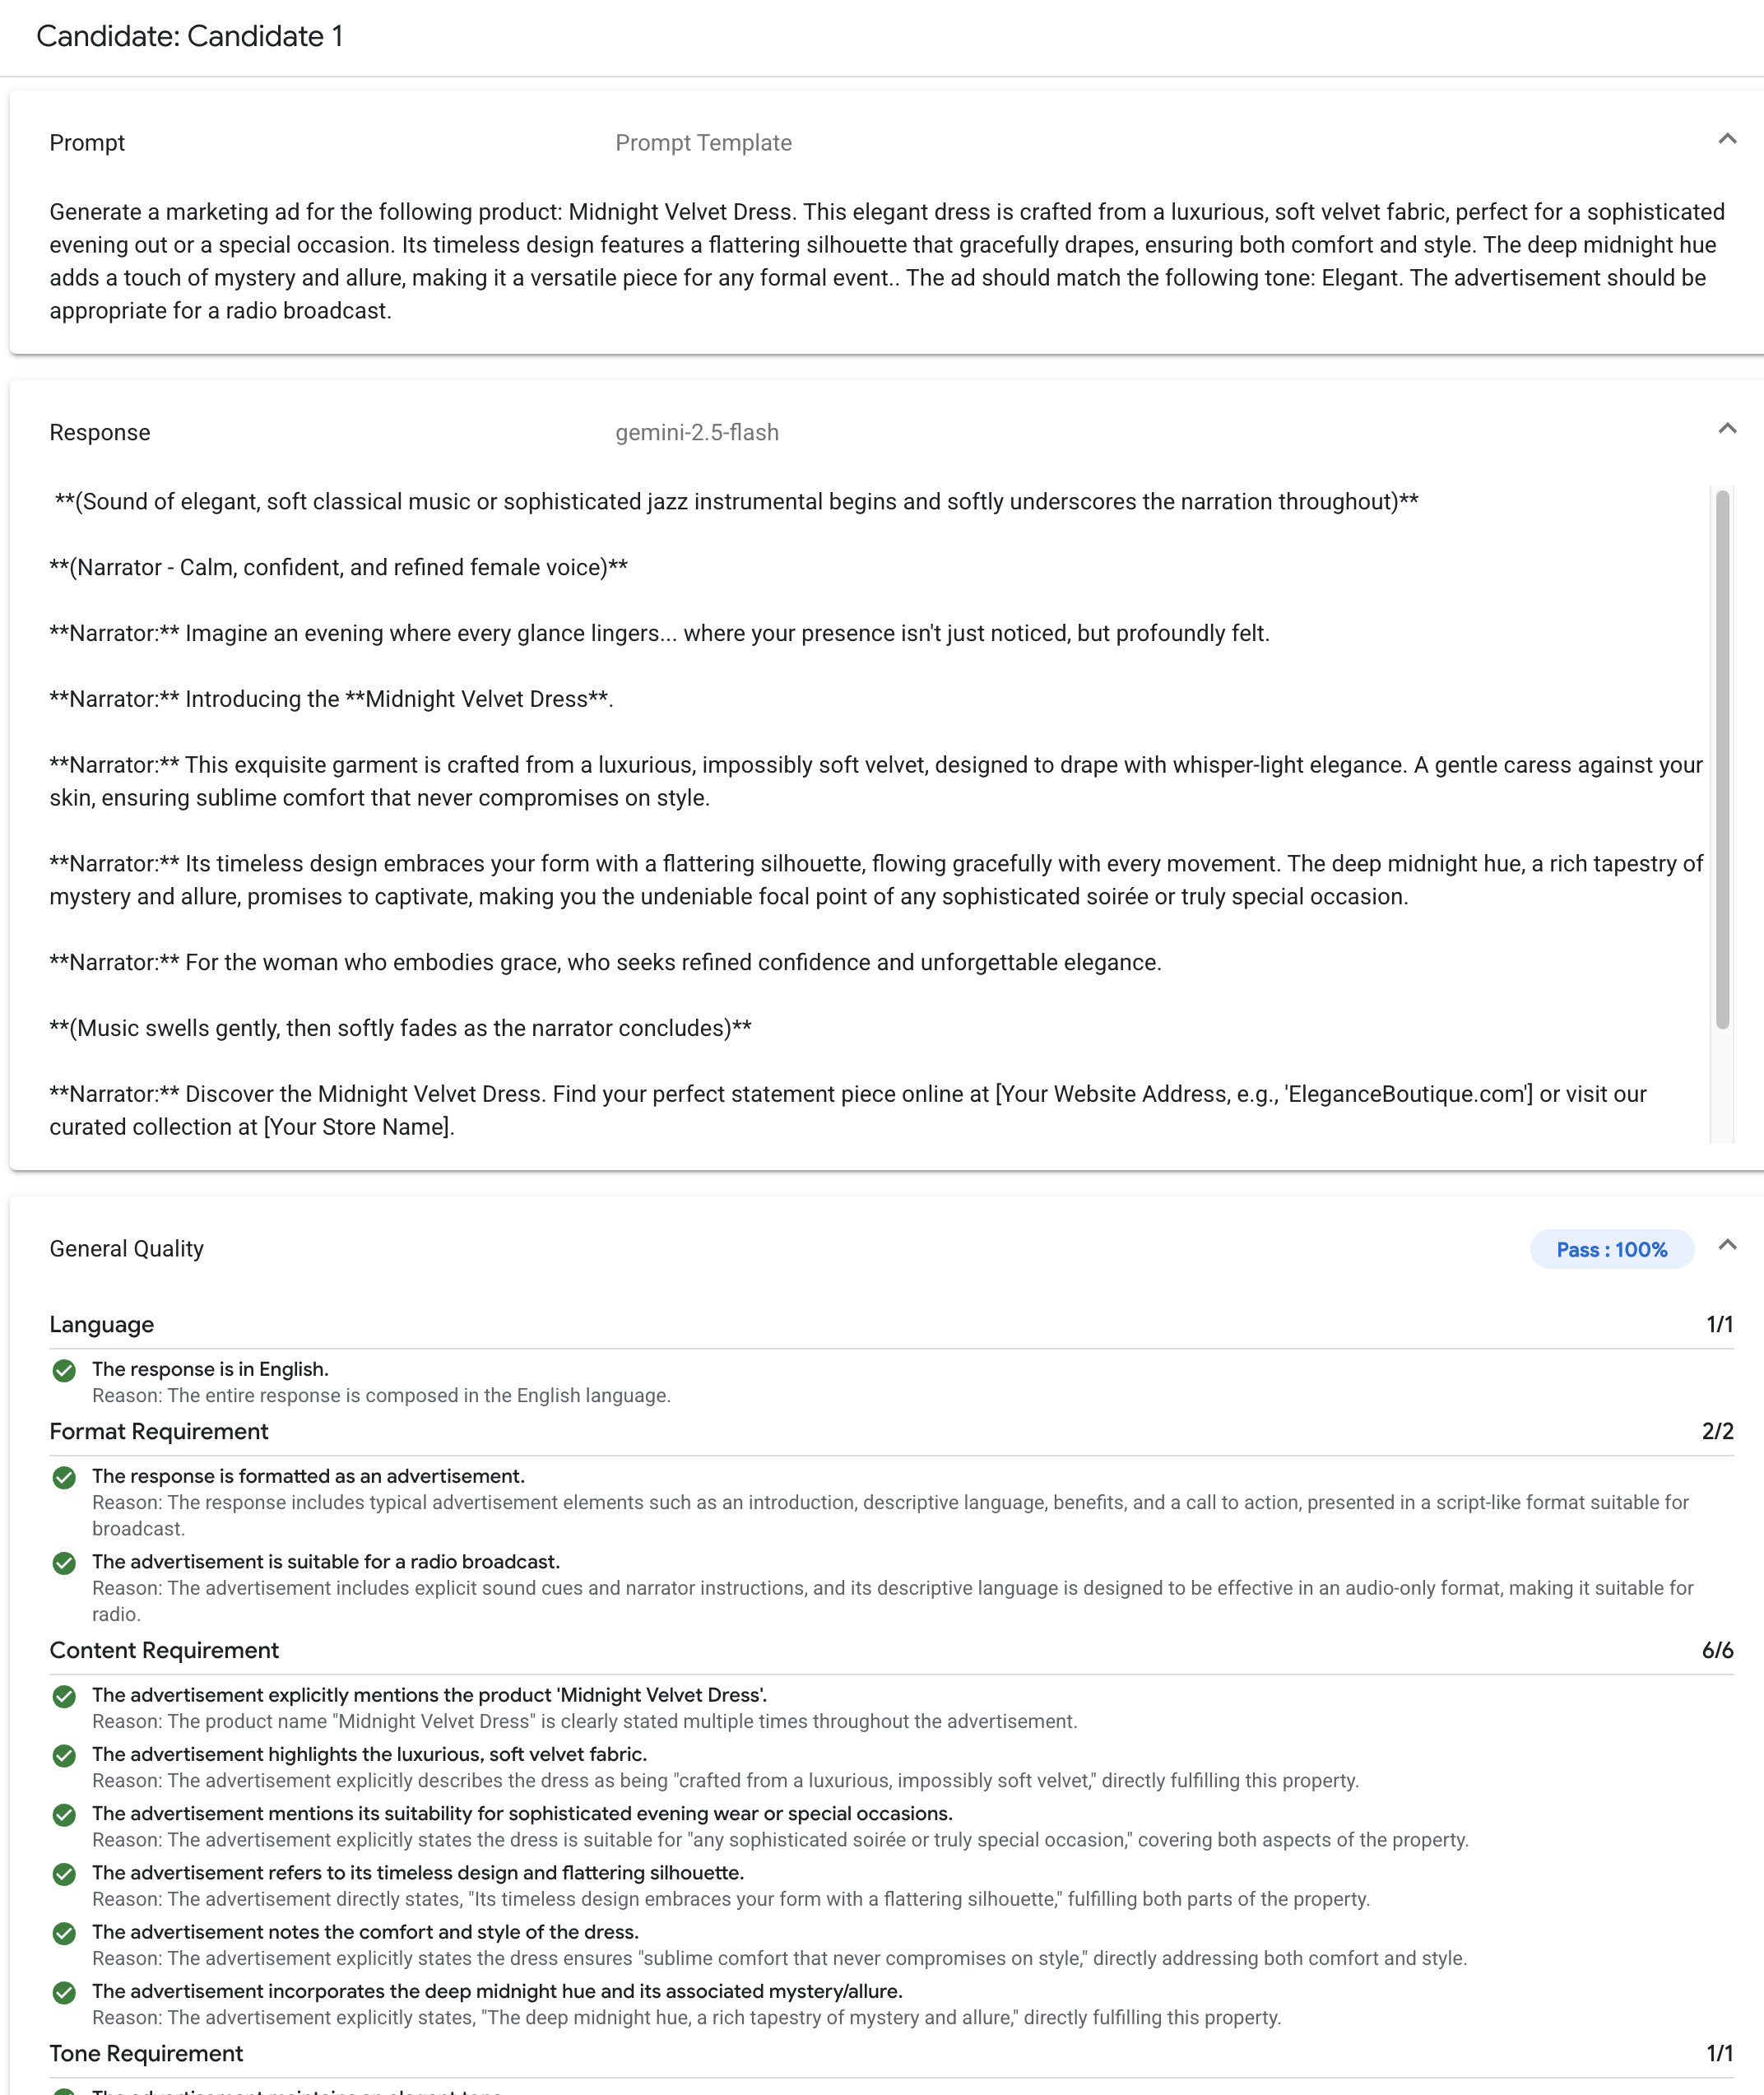
Gen AI Evaluation Service 支援下列常見的評估方法:
自動調整評分量表 (建議):為資料集中的每個提示,產生一組專屬的通過或不通過評分量表。
靜態評分量表:對所有提示套用一組固定的評分標準。
以運算為基礎的指標:如有基準真相,請使用
ROUGE或BLEU等確定性演算法。自訂函式:使用 Python 定義專屬評估邏輯,滿足特殊需求。
生成評估資料集
您可以透過下列方法建立評估資料集:
上傳檔案:檔案應包含完整的提示詞例項。您也可以提供提示詞範本,以及含有對應變數值的檔案,用來填入完整的提示詞。
直接從正式版記錄中取樣,評估模型的實際使用情形。
使用合成資料生成功能,為任何提示詞範本生成大量一致的範例。
支援的介面
您可以使用下列介面定義及執行評估:
Google Cloud 控制台:提供引導式端對端工作流程的網頁使用者介面。管理資料集、執行評估,以及深入查看互動式報表和圖表。請參閱「使用控制台執行評估」。
Python SDK:直接在 Colab 或 Jupyter 環境中,以程式輔助方式執行評估,並並列呈現模式比較結果。請參閱「使用 Agent Platform SDK 中的 GenAI 用戶端執行評估」
用途
Gen AI Evaluation Service 可讓您瞭解模型在特定工作和獨特標準下的成效,提供公開排行榜和一般基準無法提供的寶貴洞察資訊。這項功能支援重要的開發工作,包括:
模型遷移:比較模型版本,瞭解行為差異,並據此微調提示和設定。
找出最佳模型:使用您的資料,直接比較 Google 和第三方模型,建立成效基準,並找出最適合您用途的模型。
改善提示詞:根據評估結果調整自訂內容。重新執行評估可建立緊密的意見回饋循環,立即提供可量化的變更意見回饋。
模型微調:對每次執行作業套用一致的評估標準,評估微調模型的品質。
代理評估:使用代理追蹤記錄和回覆品質等代理專屬指標,評估代理效能。
評估工作流程
完成評估通常需要完成下列步驟:
建立評估資料集:收集反映特定用途的提示執行個體,建立資料集。如果打算使用以運算為基礎的指標,可以加入參考答案 (基準真相)。
定義評估指標:選擇要用於評估模型成效的指標。
生成模型回覆:選取一或多個模型,為資料集生成回覆。Agent Platform SDK 支援任何可透過
LiteLLM呼叫的模型,控制台則支援 Gemini 模型。執行評估:執行評估工作,根據所選指標評估各模型的回覆。
解讀結果:查看匯總分數和個別回覆,分析模型成效。
評估指標
以下是評估指標相關的核心概念:
評分標準:評估 LLM 模型或應用程式回覆的標準。
指標:根據評分標準評估模型輸出內容的分數。
Gen AI Evaluation Service 提供下列類別的指標:
以評分量表為基礎的指標:將 LLM 納入評估工作流程,評估模型回覆品質。評分量表式評估適用於各種工作,尤其是寫作品質、安全性和指令遵循,這些工作通常難以透過確定性演算法評估。
調整型評分量表 (建議):系統會為每個提示動態生成評分量表,就像單元測試一樣。系統會根據資料集中每個提示詞的專屬通過或失敗測試,評估回覆。評分量表可確保評估內容與所要求的工作有關,並提供客觀、可解釋且一致的結果。
自適應評量表通常是開始評估的最快方式,可確保每項評估都與要評估的特定工作相關。
靜態評分標準:明確定義評分標準,並將相同標準套用至所有提示。系統會使用同一組數值評分評估工具來評估回覆。每個提示一個數字分數 (例如 1 到 5)。如需評估非常特定的維度,或所有提示都必須使用完全相同的評量標準,請使用靜態評量標準。
以運算為基礎的指標:使用確定性演算法評估回覆,通常會使用基準真相。每個提示的數值分數 (例如 0.0 至 1.0)。有基準真相,且可與確定性方法比對。
自訂函式指標 (僅限 Agent Platform SDK):透過 Python 函式定義自己的指標。
自動調整式評分量表示例
每則提示的評估程序分為兩個步驟:
生成評分標準:服務會先分析提示詞,並生成一份具體、可驗證的測試清單 (即評分標準),列出優質回覆應符合的條件。
評分標準驗證:模型生成回覆後,服務會根據各項評分標準評估回覆,並提供明確的
Pass或Fail判定結果和理由。
最終結果會顯示匯總通過率,以及模型通過哪些評分標準的詳細細目,提供可做為行動依據的洞察資料,協助您診斷問題及評估改善成效。
從高層級的主觀分數,轉為精細的客觀測試結果,您就能採用評估導向的開發週期,並將軟體工程最佳做法,融入生成式 AI 應用程式的建構程序。
以下範例顯示針對一組提示生成的自動調整評分量表:
使用者提示:Write a four-sentence summary of the provided article about renewable energy, maintaining an optimistic tone.
針對這則提示,評分標準生成步驟可能會產生下列評分標準:
評分量表 1:回覆內容是所提供文章的摘要。
評分標準 2:回覆內容剛好有四個句子。
評分標準 3:回覆內容保持樂觀語氣。
模型可能會產生下列回覆:The article highlights significant growth in solar and wind power. These advancements are making clean energy more affordable. The future looks bright for renewables. However, the report also notes challenges with grid infrastructure.
在評分標準驗證期間,Gen AI Evaluation Service 會根據各項評分標準評估回覆:
評分量表 1:回覆內容是所提供文章的摘要。
判定:
Pass原因:回覆準確總結了重點。
評分標準 2:回覆內容剛好有四個句子。
判定:
Pass原因:回覆由四個不同的句子組成
評分標準 3:回覆內容保持樂觀語氣。
判定:
Fail原因:最後一句話帶有負面觀點,破壞了樂觀的語氣。
這項回覆的最終通過率為 66.7%。如要比較兩個模型,您可以根據這組生成的測試評估模型回覆,並比較整體通過率。
開始評估
您可以使用控制台開始評估。
或者,您也可以使用 Agent Platform SDK 中的 GenAI 用戶端完成評估,程式碼如下:
from vertexai import Client
from vertexai import types
import pandas as pd

client = Client(project=PROJECT_ID, location=LOCATION)

# Create an evaluation dataset
prompts_df = pd.DataFrame({
    "prompt": [
        "Write a simple story about a dinosaur",
        "Generate a poem about Agent Platform",
    ],
})

# Get responses from one or multiple models
eval_dataset = client.evals.run_inference(model="gemini-2.5-flash", src=prompts_df)

# Define the evaluation metrics and run the evaluation job
eval_result = client.evals.evaluate(
    dataset=eval_dataset,
    metrics=[types.RubricMetric.GENERAL_QUALITY]
)

# View the evaluation results
eval_result.show()
Gen AI Evaluation Service 提供兩種 Agent Platform SDK 介面:
Agent Platform SDK 中的 GenAI 用戶端 (建議) (預先發布版)
from vertexai import clientGenAI Client 是較新的評估介面,建議透過統一的 Client 類別存取。支援所有評估方法,適用於包含模型比較、筆記本內視覺化,以及模型自訂洞察的工作流程。
Agent Platform SDK 中的評估模組 (正式發布版)
from vertexai.evaluation import EvalTask評估模組是舊版介面,雖然仍會維護,以確保與現有工作流程回溯相容,但已不再積極開發。您可以透過
EvalTask類別存取。這個方法支援標準 LLM 評估和以運算為基礎的指標,但不支援較新的評估方法,例如自動調整評分標準。
支援的地區
Gen AI Evaluation Service 支援下列區域:
愛荷華州 (
us-central1)南卡羅來納州 (
us-east1)北維吉尼亞州 (
us-east4)俄亥俄州哥倫布 (
us-east5)德州達拉斯 (
us-south1)奧勒岡州 (
us-west1)內華達州拉斯維加斯 (
us-west4)波蘭華沙 (
europe-central2)芬蘭 (
europe-north1)西班牙馬德里 (
europe-southwest1)比利時 (
europe-west1)荷蘭 (
europe-west4)義大利米蘭 (
europe-west8)法國巴黎 (
europe-west9)全球專線 (
global)
可用的筆記本
| 筆記本連結 | 說明 |
|---|---|
| 入門指南:快速評估生成式 AI | 介紹 Gen AI Evaluation Service。 |
| 使用 Gen AI Evaluation Service 評估第三方模型 | 示範如何使用 **Agent Platform SDK** 評估各種第三方模型,包括透過 API 存取的模型 (例如 OpenAI、Anthropic)、Gemini Enterprise Agent Platform Model Garden 的模型即服務 (MaaS),以及自備模型 (BYOM) 端點。 |
| 使用 Gen AI Evaluation Service 遷移模型 | 說明如何使用 Gen AI Evaluation Service 的 **Agent Platform SDK**,比較兩個第一方模型 (例如 Gemini 2.0 Flash 和 Gemini 2.5 Flash)。重點在於使用預先定義的調整型評分量表指標,以及如何根據評估結果調整提示。此外,我們也會介紹多候選模型評估、筆記本內視覺化,以及非同步批次評估等重要功能。 |
| 使用 Gen AI Evaluation Service 評估文字轉圖像品質 | 說明如何使用 Vertex AI SDK for Gen AI Evaluation Service,根據文字提示詞評估生成圖像的品質。示範如何使用預先定義、依據評分標準調整的 Gecko 指標。 |
| 使用 Gen AI Evaluation Service 評估文字轉影片品質 | 說明如何使用 Gen AI Evaluation Service 的 **Agent Platform SDK**,根據文字提示詞評估生成影片的品質。示範如何使用預先定義、依據評分標準調整的 Gecko 指標。 |