


O modelo de embeddings multimodais gera vetores multidimensionais com base na entrada fornecida, que pode incluir uma combinação de dados de imagem, texto e vídeo. Os vetores de embedding podem ser usados para tarefas subsequentes, como classificação de imagem ou moderação de conteúdo de vídeo.
Os vetores de embedding de imagem e embedding de texto estão no mesmo espaço semântico com a mesma dimensionalidade. Consequentemente, esses vetores podem ser usados de maneira intercambiável em casos de uso como pesquisa de imagens por texto ou pesquisa de vídeo por imagem.
Para casos de uso de embedding de texto, recomendamos usar a API de embedding de texto da Gemini Enterprise Agent Platform. Por exemplo, a API de embedding de texto pode ser melhor para pesquisa semântica baseada em texto, clustering, análise de documentos de longa duração e outros casos de uso de recuperação de texto ou respostas a perguntas. Para mais informações, consulte Usar embeddings de texto.
Modelos compatíveis
É possível conseguir embeddings multimodais usando os seguintes modelos:
gemini-embedding-2multimodalembedding@001
Práticas recomendadas
Considere os seguintes aspectos de entrada ao usar o modelo de embeddings multimodais:
- Texto em imagens: o modelo pode distinguir texto em imagens, semelhante ao reconhecimento óptico de caracteres (OCR). Se você precisar distinguir entre uma descrição do conteúdo da imagem e o texto dentro de uma imagem, considere usar engenharia imediata para especificar o conteúdo de destino.
Por exemplo: em vez de apenas "gato", especifique "imagem de um gato" ou "o texto 'gato'", dependendo do seu caso de uso.
o texto "gato"
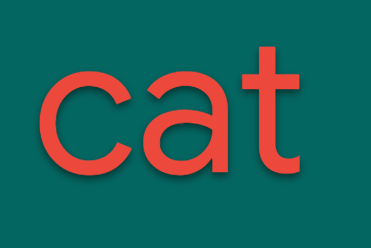
A palavra "gato" renderizada em uma fonte grande e em negrito.
imagem de um gato
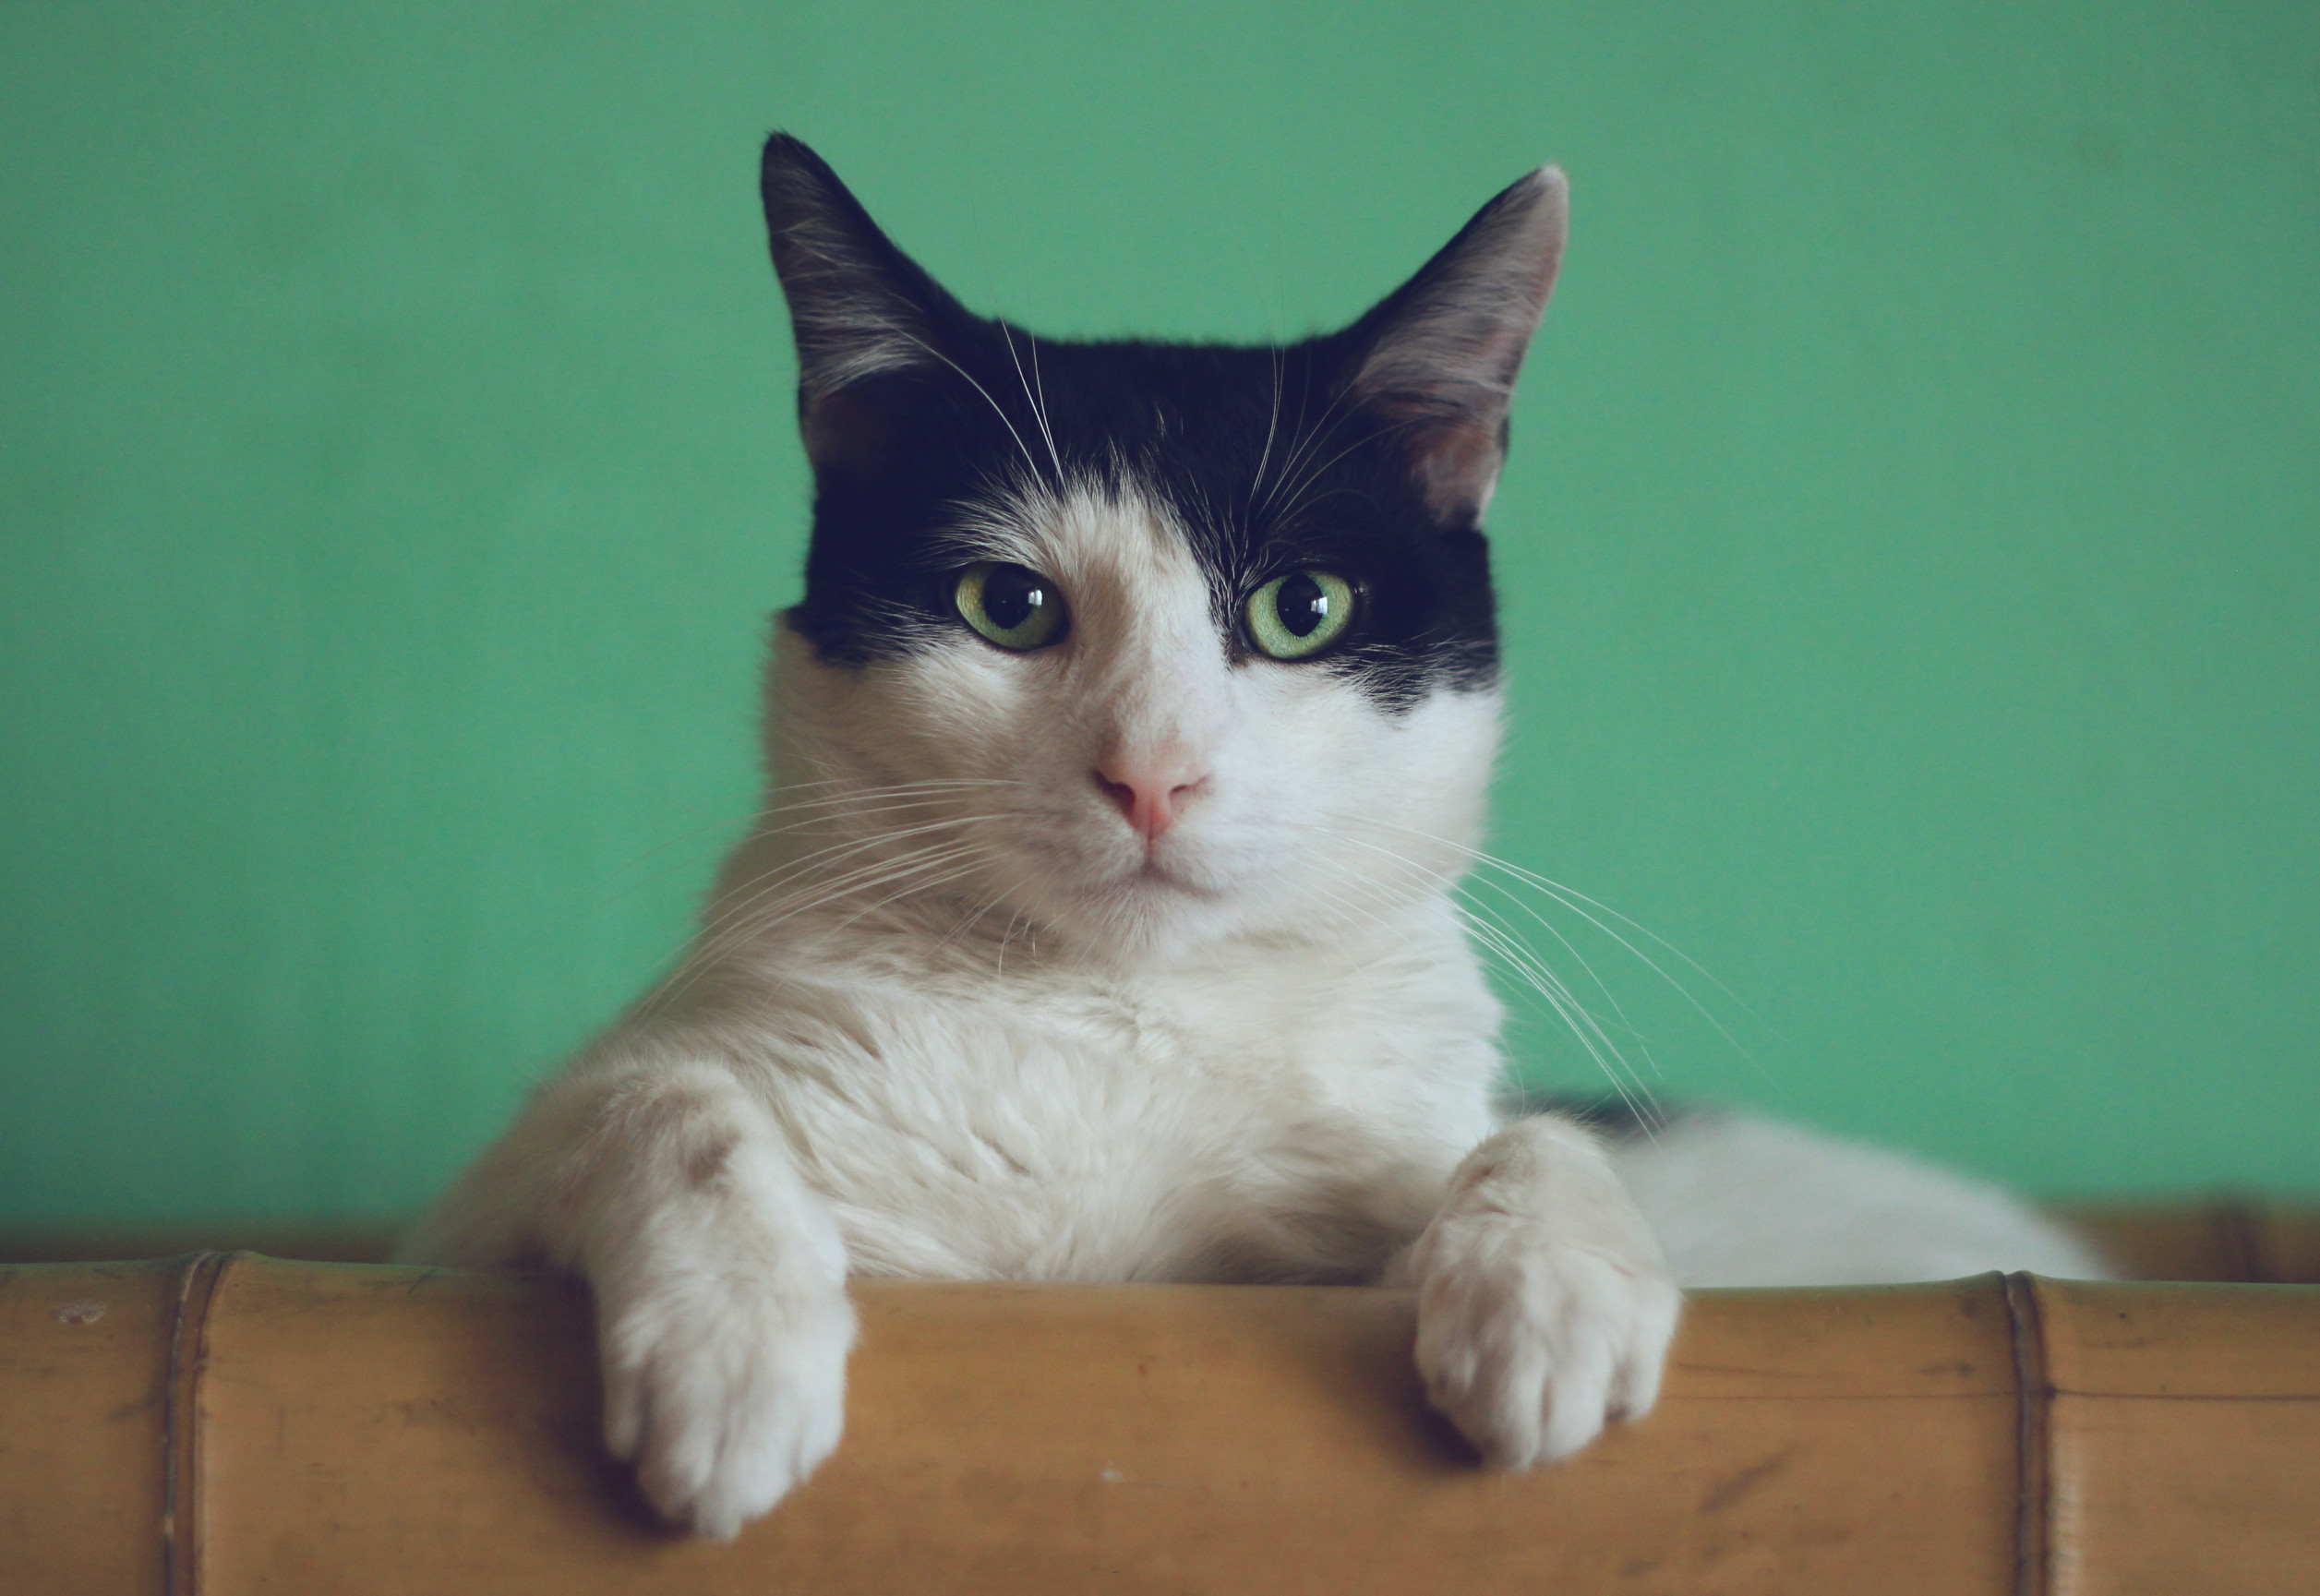
Crédito da imagem: Manja Vitolic em Unsplash. - Semelhanças de embedding: o produto escalar de embeddings não é uma probabilidade calibrada. O produto escalar é uma métrica de similaridade e pode ter diferentes distribuições de pontuação para diferentes casos de uso. Consequentemente, evite usar um limite de valor fixo para avaliar a qualidade. Em vez disso, use abordagens de classificação para recuperação ou use sigmoid para classificação.
Usar gemini-embedding-2
O modelo gemini-embedding-2 aceita entradas intercaladas em modalidades de imagem, texto, documento, áudio e vídeo.
Especificar instruções de tarefa para melhorar a performance
É possível usar embeddings para várias tarefas, desde classificação até pesquisa de documentos. Especificar a instrução de tarefa certa ajuda a otimizar os embeddings para as relações pretendidas, maximizando a acurácia e a eficiência.
As tabelas a seguir mostram exemplos de como formatar consultas e documentos para casos de uso simétricos e assimétricos usando o modelo gemini-embedding-2.
Casos de uso de recuperação (formato assimétrico)
| Caso de uso | Estrutura da consulta | Estrutura do documento |
|---|---|---|
| Consulta de pesquisa | task: search result | query: {content} |
title: {title} | text: {content}Se não houver um título, use title: none. |
| Respostas a perguntas | task: question answering | query: {content} |
title: {title} | text: {content} |
| Checagem de fatos | task: fact checking | query: {content} |
title: {title} | text: {content} |
| Recuperação de código | task: code retrieval | query: {content} |
title: {title} | text: {content} |
Casos de uso de entrada única (formato simétrico)
| Caso de uso | Estrutura de entrada |
|---|---|
| Classificação | task: classification | query: {content} |
| Clustering | task: clustering | query: {content} |
| Similaridade semântica | task: sentence similarity | query: {content}Não use para pesquisa ou recuperação. Ela é destinada à similaridade textual semântica. |
Exemplo de uso em Python
Python
# Generate embedding for a search query
def prepare_query(query):
    return f"task: search result | query: {query}"

# Generate embedding for a search document
def prepare_document(content, title=None):
    if title is None:
        title = "none"
    return f"title: {title} | text: {content}"

# Generate embedding for classification
def prepare_classification_input(content):
    return f"task: classification | query: {content}"
Uso da API
Limites da API
Os limites a seguir se aplicam quando você usa o modelo gemini-embedding-2.
| Limite | Valor e descrição |
|---|---|
| Dados de texto, imagem, documento, vídeo e áudio | |
| Limite de tokens de entrada | 8.192 tokens Entradas com mais de 8.192 tokens são truncadas silenciosamente. Todas as modalidades compartilham a janela de contexto total de 8.192 tokens. Os tokens são contados da seguinte forma por modalidade:
|
| Dimensionalidade da saída | 3.072 (padrão, configurável usando o parâmetro output_dimensionality) |
| Limites de imagens | 6 imagens por solicitação |
| Formatos de imagem | JPEG, PNG, WebP, BMP, HEIC, HEIF, AVIF |
| Dimensões da imagem | Máximo de 16384 x 16384 pixels por imagem |
| Limites de documentos | Um arquivo por solicitação, até 6 páginas Recomendamos uma página por PDF para ter a melhor qualidade. |
| Formatos de documento | |
| Dados de áudio e vídeo | |
| Limites de vídeo | 1 vídeo por solicitação, até 120 frames O limite de 120 segundos é baseado na configuração padrão de 1 QPS. A duração varia quando você define QPS diferentes: duração = 120 / QPS. Por padrão, a extração de áudio está desativada para vídeos. Quando a opção de extração de faixa de áudio está ativada, a duração está sujeita ao limite máximo de 180 segundos, e a duração total do vídeo é limitada pelo limite de áudio e pela janela de contexto do token (8.192 tokens). |
| Formatos de vídeo | Contêiner: MOV, MP4. Codec: AV1, H264, H265, VP9. |
| Limites de áudio | 180 segundos por solicitação O suporte de áudio é otimizado para fala. O som ambiente e a música podem não ser reproduzidos com a mais alta qualidade. |
| Formatos de áudio | MP3, WAV |
Duração do vídeo com extração de áudio
Como todas as modalidades compartilham a janela de contexto total de 8.192 tokens, a duração máxima do vídeo varia quando você ativa o audio_track_extraction:
| Modalidade | Contagem de tokens |
|---|---|
| Áudio | 25 tokens por segundo |
| Frame de vídeo | 66 tokens por frame |
| Carimbos de data/hora | 10 tokens por segundo (dois carimbos de data/hora por segundo formatados como "mm:ss") |
| FPS | Determinado pela configuração de QPS (o padrão é 1) |
A duração total do vídeo é limitada pelo suporte máximo de áudio de 180 segundos e pela janela de contexto de 8.192 tokens.
Exemplo de cálculo:
Se você processar um vídeo com uma taxa de amostragem padrão de 1 FPS e ativar a extração de áudio:
- Taxa de consumo: cada segundo de vídeo consome 66 tokens (1 frame) + 25 tokens (1 segundo de áudio) + 10 tokens (carimbos de data/hora) = 101 tokens.
- Duração máxima: com um limite de 8.192 tokens, a duração máxima é de aproximadamente 8.192 / 101 ≈ 81 segundos.
Se a entrada exceder a janela de contexto, a parte excedida será truncada sem aviso.
Acessar embeddings multimodais
REST
PROJECT_ID="YOUR_PROJECT_ID"
LOCATION="us"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.${LOCATION}.rep.googleapis.com/v1/projects/${PROJECT_ID}/locations/${LOCATION}/publishers/google/models/gemini-embedding-2:embedContent" \
  -d '{
  "content": {
    "parts": [
      {
        "text": "Whats this"
      },
      {
        "file_data": {
          "mime_type": "video/mp4",
          "file_uri": "gs://cloud-samples-data/generative-ai/video/pixel8.mp4"
        }
      }
    ]
  }
}'
Python
from google import genai
from google.genai import types

# Initialize the client.
client = genai.Client(vertexai=True, project="YOUR_PROJECT_ID", location="us")

content = types.Content(
    parts=[
        types.Part.from_text(text="Audio AI"),
        types.Part.from_uri(
            file_uri="gs://cloud-samples-data/generative-ai/audio/Chirp-3-Docs-Dive.mp3",
            mime_type="audio/mpeg",
        ),
    ],
)

response = client.models.embed_content(
    model="gemini-embedding-2",
    contents=[content]
)

print(response.embeddings[0].values)
Locais
Um local é uma região que pode ser especificada em uma solicitação para controlar onde os dados são armazenados em repouso. Para conferir uma lista de regiões disponíveis, consulte Locais da Agent Platform.
Cotas
Para verificar o limite de cota do gemini-embedding-2, consulte
Cotas e limites do sistema da Agent Platform.
Dimensões
Ao usar o modelo gemini-embedding-2, é possível especificar dimensões menores usando o parâmetro output_dimensionality em EmbedContentConfig.
O exemplo a seguir retorna um vetor 128-dimensional. Para gemini-embedding-2, os embeddings de saída já são normalizados por L2 para dimensões não padrão (ao contrário de gemini-embedding-001).
Python
import numpy as np
from google import genai
from google.genai import types

# Initialize the client.
client = genai.Client(vertexai=True, project="YOUR_PROJECT_ID", location="us")

content = types.Content(
    parts=[
        types.Part.from_uri(
            file_uri="gs://cloud-samples-data/generative-ai/audio/Chirp-3-Docs-Dive.mp3",
            mime_type="audio/mpeg",
        ),
    ],
)

response = client.models.embed_content(
    model="gemini-embedding-2",
    contents=[content],
    config=types.EmbedContentConfig(output_dimensionality=128),
)

embedding_values_np = np.array(response.embeddings[0].values)

print(f"Embedding length: {len(embedding_values_np)}")
print(f"Norm of embedding: {np.linalg.norm(embedding_values_np):.6f}") # Should be very close to 1
Parâmetros
A taxa de amostragem de vídeo padrão é de 1 frame por segundo (FPS). Outros parâmetros podem ser adicionados usando video_metadata:
Python
from google import genai
from google.genai import types

# Initialize the client.
client = genai.Client(vertexai=True, project="YOUR_PROJECT_ID", location="us")

content = types.Content(
    parts=[
        types.Part(
            file_data=types.FileData(
                file_uri="gs://cloud-samples-data/generative-ai/video/pixel8.mp4",
                mime_type="video/mp4",
            ),
            video_metadata=types.VideoMetadata(
                fps=0.5,
                start_offset="10s",
                end_offset="20s",
            ),
        ),
    ]
)

response = client.models.embed_content(
    model="gemini-embedding-2",
    contents=[content]
)

print(response.embeddings[0].values)
Há outras opções em EmbedContentConfig.
| Opção | Tipo | Descrição |
|---|---|---|
output_dimensionality |
int |
Reduza a dimensionalidade do embedding de saída. |
document_ocr |
bool |
Ative o OCR para entrada de documentos. |
audio_track_extraction |
bool |
Extrair áudio da entrada de vídeo. |
Usar multimodalembedding@001
Os limites a seguir se aplicam quando você usa o modelo multimodalembedding@001 para embeddings de texto e imagem:
| Limite | Valor e descrição |
|---|---|
| Dados de texto e imagem | |
| Número máximo de solicitações de API por minuto em cada projeto | 120 a 600, dependendo da região |
| Tamanho máximo do texto | 32 tokens (aproximadamente 32 palavras) O tamanho máximo do texto é de 32 tokens (aproximadamente 32 palavras). Se a entrada exceder 32 tokens, o modelo encurtará internamente a entrada para esse comprimento. |
| Idioma | Inglês |
| Formatos de imagem | BMP, GIF, JPG e PNG |
| Tamanho da imagem | Imagens codificadas em Base64: 20 MB (quando transcodificadas para PNG) Imagens do Cloud Storage: 20 MB (formato de arquivo original) O tamanho máximo de imagem aceito é 20 MB. Para evitar o aumento da latência da rede, use imagens menores. Além disso, o modelo redimensiona imagens para uma resolução de 512 x 512 pixels. Consequentemente, você não precisa fornecer imagens de resolução mais alta. |
| Dados de vídeo | |
| Compatível com áudio | N/A: o modelo não considera o conteúdo de áudio ao gerar embeddings de vídeo |
| Formatos de vídeo | AVI, FLV, MKV, MOV, MP4, MPEG, MPG, WEBM, e WMV |
| Duração máxima do vídeo (Cloud Storage) | Sem limite. No entanto, somente dois minutos de conteúdo podem ser analisados por vez. |
Antes de começar
- Faça login na sua conta do Google Cloud . Se você começou a usar o Google Cloudagora, crie uma conta para avaliar o desempenho dos nossos produtos em situações reais. Clientes novos também recebem US $300 em créditos para executar, testar e implantar cargas de trabalho.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Gemini Enterprise Agent Platform API, if it is not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Configure a autenticação do ambiente.
Selecione a guia para como planeja usar as amostras nesta página:
Java
Para usar os exemplos em Java desta página em um ambiente de desenvolvimento local, instale e inicialize a CLI gcloud e configure o Application Default Credentials com suas credenciais de usuário.
-
Instale a CLI do Google Cloud.
-
Ao usar um provedor de identidade (IdP) externo, primeiro faça login na CLI gcloud com sua identidade federada.
-
Depois de inicializar a CLI gcloud, atualize e instale os componentes necessários:
gcloud components update
gcloud components install beta
-
Se você estiver usando um shell local, crie credenciais de autenticação local para sua conta de usuário:
gcloud auth application-default login
Não é necessário fazer isso se você estiver usando o Cloud Shell.
Se um erro de autenticação for retornado e você estiver usando um provedor de identidade (IdP) externo, confirme se você fez login na CLI gcloud com sua identidade federada.
Para mais informações, consulte Configurar o ADC para um ambiente de desenvolvimento local na documentação de autenticação do Google Cloud .
Node.js
Para usar os exemplos do Node.js nesta página em um ambiente de desenvolvimento local, instale e inicialize a CLI gcloud e configure o Application Default Credentials com suas credenciais de usuário.
-
Instale a CLI do Google Cloud.
-
Ao usar um provedor de identidade (IdP) externo, primeiro faça login na CLI gcloud com sua identidade federada.
-
Depois de inicializar a CLI gcloud, atualize e instale os componentes necessários:
gcloud components update
gcloud components install beta
-
Se você estiver usando um shell local, crie credenciais de autenticação local para sua conta de usuário:
gcloud auth application-default login
Não é necessário fazer isso se você estiver usando o Cloud Shell.
Se um erro de autenticação for retornado e você estiver usando um provedor de identidade (IdP) externo, confirme se você fez login na CLI gcloud com sua identidade federada.
Para mais informações, consulte Configurar o ADC para um ambiente de desenvolvimento local na documentação de autenticação do Google Cloud .
Python
Para usar os exemplos do Python nesta página em um ambiente de desenvolvimento local, instale e inicialize a CLI gcloud e configure o Application Default Credentials com suas credenciais de usuário.
-
Instale a CLI do Google Cloud.
-
Ao usar um provedor de identidade (IdP) externo, primeiro faça login na CLI gcloud com sua identidade federada.
-
Depois de inicializar a CLI gcloud, atualize e instale os componentes necessários:
gcloud components update
gcloud components install beta
-
Se você estiver usando um shell local, crie credenciais de autenticação local para sua conta de usuário:
gcloud auth application-default login
Não é necessário fazer isso se você estiver usando o Cloud Shell.
Se um erro de autenticação for retornado e você estiver usando um provedor de identidade (IdP) externo, confirme se você fez login na CLI gcloud com sua identidade federada.
Para mais informações, consulte Configurar o ADC para um ambiente de desenvolvimento local na documentação de autenticação do Google Cloud .
REST
Para usar as amostras da API REST nesta página em um ambiente de desenvolvimento local, use as credenciais fornecidas para a CLI gcloud.
-
Instale a CLI do Google Cloud.
-
Ao usar um provedor de identidade (IdP) externo, primeiro faça login na CLI gcloud com sua identidade federada.
-
Depois de inicializar a CLI gcloud, atualize e instale os componentes necessários:
gcloud components update
gcloud components install beta
Saiba mais em Autenticar para usar REST na documentação de autenticação do Google Cloud .
-
- Para usar o SDK do Python, siga as instruções em Instalar o SDK da Agent Platform para Python. Saiba mais na documentação de referência da API Python do SDK do Agent Platform.
- Opcional. Confira os preços desse recurso. Os preços dos embeddings dependem do tipo de dados enviados (como imagem ou texto) e também do modo usado para determinados tipos de dados (como Vídeo Plus, Vídeo Standard ou Vídeo Essential).
Locais
Um local é uma região que pode ser especificada em uma solicitação para controlar onde os dados são armazenados em repouso. Para conferir uma lista de regiões disponíveis, consulte Locais da Agent Platform.
Mensagens de erro
Esta seção descreve mensagens de erro comuns que você pode encontrar.
Erro de cota excedida
google.api_core.exceptions.ResourceExhausted: 429 Quota exceeded for
aiplatform.googleapis.com/online_prediction_requests_per_base_model with base
model: multimodalembedding. Please submit a quota increase request.
Se esta for a primeira vez que você recebe esse erro, use o console do Google Cloud para solicitar um ajuste de cota para o projeto. Use os filtros a seguir antes de solicitar um ajuste:
Service ID: aiplatform.googleapis.commetric: aiplatform.googleapis.com/online_prediction_requests_per_base_modelbase_model:multimodalembedding
Se você já tiver enviado uma solicitação de ajuste de cota, aguarde antes de enviar outra. Se você precisar aumentar ainda mais a cota, repita o pedido de ajuste com sua justificativa para um ajuste de cota sustentado.
Especificar embeddings de dimensões menores
Dependendo do modelo usado, uma solicitação de embedding retorna um vetor de ponto flutuante 1408 ou 3072. Você pode especificar embeddings de dimensão menor para dados de texto e imagem e otimizar a latência, o armazenamento ou a qualidade. Embeddings de menor dimensão diminuem as necessidades de armazenamento e oferecem menor latência para tarefas de embedding subsequentes (como pesquisa ou recomendação). Os embeddings de maior dimensão oferecem mais precisão para essas tarefas, mas com maiores necessidades de armazenamento e maior latência.
A tabela a seguir ilustra as dimensões menores padrão e disponíveis para cada modelo:
| Modelo | Dimensões padrão (mais altas) | Dimensões aceitas (intervalo) | Dimensões recomendadas |
|---|---|---|---|
gemini-embedding-2 |
3.072 | 128 a 3072 | 128, 768 ou 1536 |
multimodalembedding@001 |
1408 | 128 a 1408 | 128, 256 ou 512 |
Use os exemplos a seguir para gerar embeddings com dimensões menores:
REST
Para acessar dimensões menores, adicione o campo parameters.dimension.
O parâmetro aceita qualquer um dos valores de dimensão disponíveis para o modelo.
Por exemplo, você pode especificar 128, 256, 512 ou 1408 ao usar o modelo multimodalembedding@001. A resposta inclui o embedding da dimensão especificada.
Antes de usar os dados da solicitação abaixo, faça as substituições a seguir:
- PROJECT_ID: o ID do projeto do Google Cloud .
-
IMAGE_URI: o URI do Cloud Storage da imagem de destino para receber embeddings. Por exemplo,
gs://my-bucket/embeddings/supermarket-img.png.Também é possível fornecer a imagem como uma string de bytes codificada em base64:
[...] "image": { "bytesBase64Encoded": "B64_ENCODED_IMAGE" } [...] -
TEXT: o texto de destino para receber embeddings. Por exemplo,
a
      cat
. -
EMBEDDING_DIMENSION: o número de dimensões de incorporação. Valores mais baixos oferecem latência reduzida ao usar esses embeddings para tarefas subsequentes, enquanto valores mais altos oferecem melhor precisão. Valores disponíveis:
128,256,512e1408(padrão).
Método HTTP e URL:
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict
Corpo JSON da solicitação:
{
  "instances": [
    {
      "image": {
        "gcsUri": "IMAGE_URI"
      },
      "text": "TEXT"
    }
  ],
  "parameters": {
    "dimension": EMBEDDING_DIMENSION
  }
}
Para enviar a solicitação, escolha uma destas opções:
curl
Salve o corpo da solicitação em um arquivo com o nome request.json e execute o comando abaixo:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict"
PowerShell
Salve o corpo da solicitação em um arquivo com o nome request.json e execute o comando a seguir:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict" | Select-Object -Expand Content
128 dimensões:
{
  "predictions": [
    {
      "imageEmbedding": [
        0.0279239565,
        [...128 dimension vector...]
        0.00403284049
      ],
      "textEmbedding": [
        0.202921599,
        [...128 dimension vector...]
        -0.0365431122
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
256 dimensões:
{
  "predictions": [
    {
      "imageEmbedding": [
        0.248620048,
        [...256 dimension vector...]
        -0.0646447465
      ],
      "textEmbedding": [
        0.0757875815,
        [...256 dimension vector...]
        -0.02749932
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
512 dimensões:
{
  "predictions": [
    {
      "imageEmbedding": [
        -0.0523675755,
        [...512 dimension vector...]
        -0.0444030389
      ],
      "textEmbedding": [
        -0.0592851527,
        [...512 dimension vector...]
        0.0350437127
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Python
Go
Receber embeddings de imagem e texto (multimodalembedding@001)
Use os exemplos de código a seguir para enviar uma solicitação de incorporação com dados de imagem e texto. Nos exemplos, mostramos como enviar uma solicitação com os dois tipos de dados, mas você também pode usar o serviço com um tipo de dados individual.
Receber embeddings de texto e imagem
REST
Antes de usar os dados da solicitação abaixo, faça as substituições a seguir:
- PROJECT_ID: o ID do projeto do Google Cloud.
-
TEXT: o texto de destino para receber embeddings. Por exemplo,
a
      cat
. - B64_ENCODED_IMG: a imagem de destino que receberá os embeddings. A imagem precisa ser especificada como uma string de bytes codificada em base64.
Método HTTP e URL:
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict
Corpo JSON da solicitação:
{
  "instances": [
    {
      "text": "TEXT",
      "image": {
        "bytesBase64Encoded": "B64_ENCODED_IMG"
      }
    }
  ]
}
Para enviar a solicitação, escolha uma destas opções:
curl
Salve o corpo da solicitação em um arquivo com o nome request.json e execute o comando abaixo:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict"
PowerShell
Salve o corpo da solicitação em um arquivo com o nome request.json e execute o comando a seguir:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict" | Select-Object -Expand Content
{
  "predictions": [
    {
      "textEmbedding": [
        0.010477379,
        -0.00399621,
        0.00576670747,
        [...]
        -0.00823613815,
        -0.0169572588,
        -0.00472954148
      ],
      "imageEmbedding": [
        0.00262696808,
        -0.00198890246,
        0.0152047109,
        -0.0103145819,
        [...]
        0.0324628279,
        0.0284924973,
        0.011650892,
        -0.00452344026
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Python
Antes de testar este exemplo, siga as instruções de configuração do Python no Guia de início rápido do Agent Platform: como usar bibliotecas de cliente.
Para autenticar no Agent Platform, configure o Application Default Credentials. Para mais informações, consulte Configurar a autenticação para um ambiente de desenvolvimento local.
Node.js
Antes de testar este exemplo, siga as instruções de configuração do Node.js no Guia de início rápido do Agent Platform: como usar bibliotecas de cliente.
Para autenticar no Agent Platform, configure o Application Default Credentials. Para mais informações, consulte Configurar a autenticação para um ambiente de desenvolvimento local.
Java
Antes de testar este exemplo, siga as instruções de configuração do Java no Guia de início rápido do Agent Platform: como usar bibliotecas de cliente.
Para autenticar no Agent Platform, configure o Application Default Credentials. Para mais informações, consulte Configurar a autenticação para um ambiente de desenvolvimento local.
Go
Antes de testar este exemplo, siga as instruções de configuração do Go no Guia de início rápido do Agent Platform: como usar bibliotecas de cliente.
Para autenticar no Agent Platform, configure o Application Default Credentials. Para mais informações, consulte Configurar a autenticação para um ambiente de desenvolvimento local.
Acessar embeddings de vídeo, imagem ou texto (multimodalembedding@001)
Ao enviar uma solicitação de embedding, especifique apenas um vídeo de entrada ou uma combinação de dados de vídeo, imagem e texto.
Modos de embedding de vídeo
Existem três modos que podem ser usados com embeddings de vídeo: Essential, Standard ou Plus. O modo corresponde à densidade dos embeddings gerados, que pode ser especificado pela configuração interval_sec na solicitação. Para cada intervalo de vídeo com interval_sec de duração, um embedding é gerado. A duração mínima do intervalo de vídeo é de 4 segundos. Intervalos maiores que 120 segundos podem afetar negativamente a qualidade dos embeddings gerados.
Os preços dos embeddings de vídeo dependem do modo usado. Para mais informações, consulte Preços.
A tabela a seguir resume os três modos que podem ser usados para embeddings de vídeo:
| Modo | Número máximo de embeddings por minuto | Intervalo de embedding de vídeo (valor mínimo) |
|---|---|---|
| Essencial | 4 | 15 Isso corresponde a: intervalSec >= 15 |
| Padrão | 8 | 8 Isso corresponde a: 8 <= intervalSec < 15 |
| Plus | 15 | 4 Isso corresponde a: 4 <= intervalSec < 8 |
Práticas recomendadas para embeddings de vídeo
Ao enviar solicitações de embedding de vídeo, considere isto:
Para gerar um único embedding para os dois primeiros minutos de um vídeo de entrada de qualquer duração, use a seguinte configuração de
videoSegmentConfig:request.json:// other request body content "videoSegmentConfig": { "intervalSec": 120 } // other request body contentPara gerar o embedding de um vídeo com duração superior a dois minutos, envie várias solicitações que especifiquem os horários de início e término em
videoSegmentConfig:request1.json:// other request body content "videoSegmentConfig": { "startOffsetSec": 0, "endOffsetSec": 120 } // other request body contentrequest2.json:// other request body content "videoSegmentConfig": { "startOffsetSec": 120, "endOffsetSec": 240 } // other request body contentGerar embeddings de vídeo
Use o exemplo a seguir para receber embeddings para conteúdo de vídeo.
REST
O exemplo a seguir usa um vídeo localizado no Cloud Storage. Também é
possível usar o campo video.bytesBase64Encoded para fornecer uma representação de string
codificada em base64 do
vídeo.
Antes de usar os dados da solicitação abaixo, faça as substituições a seguir:
- PROJECT_ID: o ID do projeto do Google Cloud.
-
VIDEO_URI: o URI do Cloud Storage do vídeo de destino para os embeddings serão recebidos. Por exemplo,
gs://my-bucket/embeddings/supermarket-video.mp4.Você também pode fornecer o vídeo como uma string de bytes codificada em base64:
[...] "video": { "bytesBase64Encoded": "B64_ENCODED_VIDEO" } [...] -
videoSegmentConfig(START_SECOND, END_SECOND, INTERVAL_SECONDS). Opcional. Os segmentos de vídeo específicos (em segundos) para os quais os embeddings são gerados.Exemplo:
[...]
"videoSegmentConfig": {
  "startOffsetSec": 10,
  "endOffsetSec": 60,
  "intervalSec": 10
}
[...]
O uso dessa configuração especifica dados de vídeo de 10 a 60 segundos e gera embeddings para os seguintes intervalos de vídeo de 10 segundos: [10, 20), [20, 30), [30, 40), [40, 50), [50, 60). Esse intervalo de vídeo (
"intervalSec": 10) se enquadra no modo de embedding de vídeo Standard, e a cobrança é feita conforme a taxa de preços do modo Standard.Se você omitir
videoSegmentConfig, o serviço usará os seguintes valores padrão:"videoSegmentConfig": { "startOffsetSec": 0, "endOffsetSec": 120, "intervalSec": 16 }. Esse intervalo de vídeo ("intervalSec": 16) se enquadra no modo de embedding de vídeo Essential, e a cobrança do usuário é feita conforme a taxa de preços do modo Essential.
Método HTTP e URL:
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict
Corpo JSON da solicitação:
{
  "instances": [
    {
      "video": {
        "gcsUri": "VIDEO_URI",
        "videoSegmentConfig": {
          "startOffsetSec": START_SECOND,
          "endOffsetSec": END_SECOND,
          "intervalSec": INTERVAL_SECONDS
        }
      }
    }
  ]
}
Para enviar a solicitação, escolha uma destas opções:
curl
Salve o corpo da solicitação em um arquivo com o nome request.json e execute o comando abaixo:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict"
PowerShell
Salve o corpo da solicitação em um arquivo com o nome request.json e execute o comando a seguir:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict" | Select-Object -Expand Content
Resposta (vídeo de sete segundos, sem videoSegmentConfig especificado):
{
  "predictions": [
    {
      "videoEmbeddings": [
        {
          "endOffsetSec": 7,
          "embedding": [
            -0.0045467657,
            0.0258095954,
            0.0146885719,
            0.00945400633,
            [...]
            -0.0023291884,
            -0.00493789,
            0.00975185353,
            0.0168156829
          ],
          "startOffsetSec": 0
        }
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Resposta (vídeo de 59 segundos, com a seguinte configuração de trecho de vídeo: "videoSegmentConfig": { "startOffsetSec": 0, "endOffsetSec": 60, "intervalSec": 10 }):
{
  "predictions": [
    {
      "videoEmbeddings": [
        {
          "endOffsetSec": 10,
          "startOffsetSec": 0,
          "embedding": [
            -0.00683252793,
            0.0390476175,
            [...]
            0.00657121744,
            0.013023301
          ]
        },
        {
          "startOffsetSec": 10,
          "endOffsetSec": 20,
          "embedding": [
            -0.0104404651,
            0.0357737206,
            [...]
            0.00509833824,
            0.0131902946
          ]
        },
        {
          "startOffsetSec": 20,
          "embedding": [
            -0.0113538112,
            0.0305239167,
            [...]
            -0.00195809244,
            0.00941874553
          ],
          "endOffsetSec": 30
        },
        {
          "embedding": [
            -0.00299320649,
            0.0322436653,
            [...]
            -0.00993082579,
            0.00968887936
          ],
          "startOffsetSec": 30,
          "endOffsetSec": 40
        },
        {
          "endOffsetSec": 50,
          "startOffsetSec": 40,
          "embedding": [
            -0.00591270532,
            0.0368893594,
            [...]
            -0.00219071587,
            0.0042470959
          ]
        },
        {
          "embedding": [
            -0.00458270218,
            0.0368121453,
            [...]
            -0.00317760976,
            0.00595594104
          ],
          "endOffsetSec": 59,
          "startOffsetSec": 50
        }
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Python
Antes de testar este exemplo, siga as instruções de configuração do Python no Guia de início rápido do Agent Platform: como usar bibliotecas de cliente.
Para autenticar no Agent Platform, configure o Application Default Credentials. Para mais informações, consulte Configurar a autenticação para um ambiente de desenvolvimento local.
Go
Antes de testar este exemplo, siga as instruções de configuração do Go no Guia de início rápido do Agent Platform: como usar bibliotecas de cliente.
Para autenticar no Agent Platform, configure o Application Default Credentials. Para mais informações, consulte Configurar a autenticação para um ambiente de desenvolvimento local.
Incorporar imagens, textos e vídeos
Use o exemplo a seguir para conseguir embeddings para conteúdo de vídeo, texto e imagem.
REST
O exemplo a seguir usa dados de imagem, texto e vídeo. É possível usar qualquer combinação desses tipos de dados no corpo da solicitação.
Além disso, essa
amostra usa um vídeo localizado no Cloud Storage. Também é
possível usar o campo video.bytesBase64Encoded para fornecer uma representação de string
codificada em base64 do
vídeo.
Antes de usar os dados da solicitação abaixo, faça as substituições a seguir:
- PROJECT_ID: o ID do projeto do Google Cloud.
-
TEXT: o texto de destino para receber embeddings. Por exemplo,
a
      cat
. -
IMAGE_URI: o URI do Cloud Storage da imagem de destino para receber embeddings. Por exemplo,
gs://my-bucket/embeddings/supermarket-img.png.Também é possível fornecer a imagem como uma string de bytes codificada em base64:
[...] "image": { "bytesBase64Encoded": "B64_ENCODED_IMAGE" } [...] -
VIDEO_URI: o URI do Cloud Storage do vídeo de destino para os embeddings serão recebidos. Por exemplo,
gs://my-bucket/embeddings/supermarket-video.mp4.Você também pode fornecer o vídeo como uma string de bytes codificada em base64:
[...] "video": { "bytesBase64Encoded": "B64_ENCODED_VIDEO" } [...] -
videoSegmentConfig(START_SECOND, END_SECOND, INTERVAL_SECONDS). Opcional. Os segmentos de vídeo específicos (em segundos) para os quais os embeddings são gerados.Exemplo:
[...]
  "videoSegmentConfig": {
    "startOffsetSec": 10,
    "endOffsetSec": 60,
    "intervalSec": 10
  }
  [...]
O uso dessa configuração especifica dados de vídeo de 10 a 60 segundos e gera embeddings para os seguintes intervalos de vídeo de 10 segundos: [10, 20), [20, 30), [30, 40), [40, 50), [50, 60). Esse intervalo de vídeo (
"intervalSec": 10) se enquadra no modo de embedding de vídeo Standard, e a cobrança é feita conforme a taxa de preços do modo Standard.Se você omitir
videoSegmentConfig, o serviço usará os seguintes valores padrão:"videoSegmentConfig": { "startOffsetSec": 0, "endOffsetSec": 120, "intervalSec": 16 }. Esse intervalo de vídeo ("intervalSec": 16) se enquadra no modo de embedding de vídeo Essential, e a cobrança do usuário é feita conforme a taxa de preços do modo Essential.
Método HTTP e URL:
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict
Corpo JSON da solicitação:
{
  "instances": [
    {
      "text": "TEXT",
      "image": {
        "gcsUri": "IMAGE_URI"
      },
      "video": {
        "gcsUri": "VIDEO_URI",
        "videoSegmentConfig": {
          "startOffsetSec": START_SECOND,
          "endOffsetSec": END_SECOND,
          "intervalSec": INTERVAL_SECONDS
        }
      }
    }
  ]
}
Para enviar a solicitação, escolha uma destas opções:
curl
Salve o corpo da solicitação em um arquivo com o nome request.json e execute o comando abaixo:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict"
PowerShell
Salve o corpo da solicitação em um arquivo com o nome request.json e execute o comando a seguir:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict" | Select-Object -Expand Content
{
  "predictions": [
    {
      "textEmbedding": [
        0.0105433334,
        -0.00302835181,
        0.00656806398,
        0.00603460241,
        [...]
        0.00445805816,
        0.0139605571,
        -0.00170318608,
        -0.00490092579
      ],
      "videoEmbeddings": [
        {
          "startOffsetSec": 0,
          "endOffsetSec": 7,
          "embedding": [
            -0.00673126569,
            0.0248149596,
            0.0128901172,
            0.0107588246,
            [...]
            -0.00180952181,
            -0.0054573305,
            0.0117037306,
            0.0169312079
          ]
        }
      ],
      "imageEmbedding": [
        -0.00728622358,
        0.031021487,
        -0.00206603738,
        0.0273937676,
        [...]
        -0.00204976718,
        0.00321615417,
        0.0121978866,
        0.0193375275
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Python
Antes de testar este exemplo, siga as instruções de configuração do Python no Guia de início rápido do Agent Platform: como usar bibliotecas de cliente.
Para autenticar no Agent Platform, configure o Application Default Credentials. Para mais informações, consulte Configurar a autenticação para um ambiente de desenvolvimento local.
Go
Antes de testar este exemplo, siga as instruções de configuração do Go no Guia de início rápido do Agent Platform: como usar bibliotecas de cliente.
Para autenticar no Agent Platform, configure o Application Default Credentials. Para mais informações, consulte Configurar a autenticação para um ambiente de desenvolvimento local.
A seguir
- Leia o blog "What is Multimodal Search: 'LLMs with vision" change business".
- Para informações sobre casos de uso somente de texto (pesquisa semântica baseada em texto, clustering, análise de documentos de longa duração e outros casos de uso de recuperação de texto ou resposta a perguntas), leia Receber embeddings de texto.
- Confira modelos pré-treinados no Model Garden.
- Saiba mais sobre as práticas recomendadas de IA responsável e os filtros de segurança na Gemini Enterprise Agent Platform.