


Puoi utilizzare gli enrichment degli oggetti per generare automaticamente metadati strutturati senza creare pipeline di machine learning personalizzate. Gli enrichment degli oggetti applicano i modelli di machine learning preaddestrati di Google direttamente agli oggetti archiviati per aiutarti a cercare, curare e gestire i dati non strutturati su larga scala.
Per iniziare a generare metadati per gli oggetti, consulta Configurare gli enrichment degli oggetti.
Come funziona
Per utilizzare gli enrichment degli oggetti, devi interagire con le seguenti parti del sistema:
- Configurazione delle funzionalità (
FeatureConfig): crei una configurazione delle funzionalità per specificare i bucket o i progetti monitorati da Cloud Storage. - Modelli di machine learning: nella configurazione scegli i modelli da applicare, ad esempio i modelli che rilevano gli oggetti, etichettano le immagini, analizzano i volti o classificano i documenti PDF.
- Enrichment degli oggetti (metadati): Cloud Storage esegue la scansione asincrona degli oggetti e valuta gli oggetti idonei con i modelli selezionati. Cloud Storage collega quindi i metadati risultanti direttamente agli oggetti come contesti degli oggetti.
Dopo che Cloud Storage ha collegato i metadati di enrichment agli oggetti, i metadati sono pronti per l'uso. Puoi esaminare i singoli enrichment degli oggetti o utilizzare i set di dati di Storage Insights per analizzare i metadati di milioni di oggetti utilizzando SQL in BigQuery.
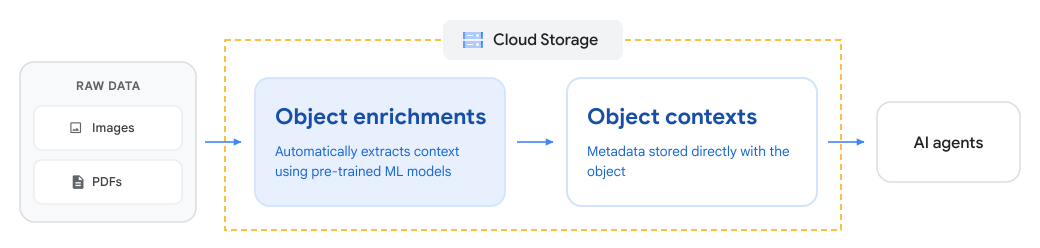
Il seguente diagramma mostra come Cloud Storage utilizza gli enrichment degli oggetti per estrarre il contesto dai dati non strutturati e archiviarlo come contesti degli oggetti per i flussi di lavoro di analisi e AI downstream:
Modelli supportati
Quando crei una configurazione delle funzionalità, seleziona i modelli di machine learning più adatti ai tuoi dati e agli obiettivi di analisi. Cloud Storage valuta gli oggetti idonei utilizzando i modelli scelti e genera metadati strutturati in contexts.custom.
La tabella dei modelli supportati elenca ogni modello, ciò che rileva e i dati di output di esempio. Per definizioni dettagliate dello schema e chiavi di contesto, consulta Modelli e schemi supportati.
| Modello | Descrizione | Dati di output di esempio |
|---|---|---|
| Rilevamento di oggetti | Rileva più oggetti all'interno di un'immagine e fornisce le loro posizioni e i limiti rettangolari. | Prodotto, Animale, Persona |
| Etichettatura delle immagini | Rileva ed estrae informazioni sulle entità in un'immagine in un'ampia gamma di categorie, come oggetti, località e attività. | Paesaggio, Urbano, Notte |
| Riconoscimento facciale | Rileva i volti nelle immagini, inclusi poligoni di delimitazione, punti di riferimento facciali (occhi, naso, bocca), angoli di orientamento e probabilità di espressione. | Numero di volti, angolo di rollio e inclinazione |
| Rilevamento contenuti espliciti | Valuta le immagini per contenuti sensibili o inappropriati, inclusi materiale per adulti o violento. | Valutazioni di probabilità di contenuti per adulti e violenti |
| Classificazione PDF | Classifica i documenti PDF in categorie standard di attività e settore in base ai contenuti. | Finanza, Imposte, Fattura (categorie e punteggi) |
Casi d'uso
Puoi utilizzare gli enrichment degli oggetti per semplificare la gestione dei dati non strutturati e preparare gli oggetti per i seguenti flussi di lavoro di analisi e AI downstream:
- Organizzare e catalogare gli oggetti non organizzati: classifica automaticamente le raccolte di documenti PDF (ad esempio fatture, estratti conto bancari e moduli fiscali) e immagini. Puoi utilizzare queste classificazioni per creare cataloghi di dati ricercabili nei bucket senza scrivere codice personalizzato.
- Basare gli agenti AI e migliorare la ricerca: trasforma i repository di documenti disorganizzati in knowledge base strutturate. Puoi utilizzare le categorie di documenti e le etichette delle immagini per migliorare il recupero durante la Retrieval-Augmented Generation (RAG) e basare le applicazioni di AI generativa.
- Campionare e preparare i dati per l'AI generativa: distingui tra i tipi di documenti per eseguire il campionamento stratificato prima di indirizzare i contenuti ai modelli linguistici di grandi dimensioni (LLM) o alla revisione umana.
- Curare i set di dati di addestramento di machine learning: filtra e segmenta immagini e documenti in base alla tassonomia o alle etichette visive per assemblare set di dati di addestramento specifici del dominio per la messa a punto del modello.
- Eseguire la scansione per rilevare contenuti sensibili o espliciti: ispeziona automaticamente le immagini caricate per rilevare materiale inappropriato a supporto delle norme di moderazione dei contenuti e sicurezza.
- Migliorare i prompt multimodali: trasmetti metadati strutturati, come riquadri di delimitazione e categorie di documenti, come contesto quando richiedi modelli multimodali come Gemini.
- Semplificare le architetture dei dati: elimina le pipeline di importazione personalizzate e l'infrastruttura di calcolo generando metadati direttamente in Cloud Storage.
Eseguire query e analizzare i metadati
Cloud Storage collega gli enrichment degli oggetti direttamente agli oggetti come contesti degli oggetti. A seconda della scalabilità e del flusso di lavoro, puoi accedere e analizzare questi metadati nei seguenti modi:
- Esaminare i singoli oggetti: utilizza la Google Cloud console o le API Cloud Storage per esaminare gli enrichment di oggetti specifici. Per le istruzioni, consulta Gestire gli enrichment degli oggetti.
- Analizzare su larga scala con SQL: utilizza i set di dati di Storage Insights per esportare
i metadati di milioni o miliardi di oggetti direttamente in
BigQuery. Dopo che Storage Insights ha esportato i metadati, puoi
eseguire query sulla visualizzazione
object_contexts_catalog_viewutilizzando SQL standard. Ad esempio, puoi cercare etichette, filtrare per categoria o trovare oggetti con punteggi di confidenza elevati.
Per iniziare a utilizzare le query SQL e le ricette di esempio, consulta Analizzare gli enrichment degli oggetti in BigQuery.
Considerazioni e limitazioni
Prima di configurare gli enrichment degli oggetti, esamina le seguenti considerazioni operative:
Località di elaborazione
Gli enrichment degli oggetti elaborano i dati in tre posizioni geografiche: us, eu e asia. Quando selezioni una località di elaborazione, tieni presente le seguenti considerazioni:
- Conformità: assicurati che la località di elaborazione scelta soddisfi i tuoi requisiti normativi e di sovranità dei dati.
- Prestazioni: scegli la località di elaborazione più vicina alla regione di archiviazione del bucket.
- Costo: per evitare addebiti duplicati, configura una sola località di elaborazione per ogni bucket e modello. Se configuri più località per lo stesso bucket e modello, Cloud Storage elabora gli oggetti in ogni località e ti addebita ogni esecuzione.
Elaborazione e prestazioni
Esamina i seguenti vincoli relativi a tipi di contenuti, dimensioni degli oggetti e tempistiche di elaborazione:
Elaborazione asincrona: Cloud Storage elabora gli oggetti in modo asincrono.
Limite di dimensioni degli oggetti: gli oggetti (sia immagini che PDF) devono avere dimensioni pari o inferiori a 20 MiB o inferiori.
Tipi di contenuti supportati: Cloud Storage utilizza il
Content-Typemetadati campo impostato su un oggetto per determinare se valutarlo. Se un oggetto ha unContent-Typenon valido o mancante, Cloud Storage non lo elabora anche se i dati sottostanti sono un'immagine o un PDF validi. Per assicurarti che Cloud Storage elabori l'oggetto, aggiorna i metadatiContent-Typea uno dei seguenti tipi supportati:- Immagini: BMP, GIF, ICO, JPEG, PNG, TIFF e WEBP.
- Documenti: PDF (
application/pdf).
Funzionalità non supportate
Gli enrichment degli oggetti non sono compatibili con i seguenti tipi di bucket e operazioni:
- Rilocalizzazione dei bucket: gli enrichment degli oggetti non sono compatibili con la rilocalizzazione dei bucket. Rimuovi il bucket dalle configurazioni delle funzionalità prima di rilocalizzarlo.
- Tipi di bucket non supportati: non puoi abilitare gli enrichment degli oggetti nei bucket Rapid o nei bucket con lo spazio dei nomi gerarchico abilitato.
Gestione della configurazione e dell'ambito
Quando definisci e gestisci i bucket di destinazione nelle configurazioni delle funzionalità, si applicano i seguenti requisiti:
- Ambito del bucket: specifica i nomi esatti dei bucket nella configurazione delle funzionalità. Cloud Storage non supporta le espressioni regolari o i pattern con caratteri jolly.
- Ciclo di vita del bucket: Cloud Storage non aggiunge automaticamente i bucket appena creati, ricreati o rilocalizzati alle configurazioni esistenti. Devi aggiornare la configurazione delle funzionalità per includere questi bucket.
Costi e sicurezza
Esamina i seguenti dettagli operativi relativi alle chiavi di crittografia e agli addebiti per l'accesso ai dati:
- Chiavi fornite dal cliente (CSEK): gli enrichment degli oggetti non supportano gli oggetti criptati con chiavi di crittografia fornite dal cliente.
- Accesso all'archiviazione e Autoclass: per generare i metadati, gli enrichment degli oggetti leggono i dati degli oggetti. Queste operazioni di lettura comportano addebiti standard per l'accesso ai dati. Inoltre, se il bucket ha Autoclass abilitato, queste letture attivano le transizioni della classe di archiviazione.
Prezzi
L'utilizzo degli enrichment degli oggetti comporta addebiti per l'inferenza del modello, l'archiviazione dei metadati, le operazioni di accesso ai dati e la rete. Per saperne di più, consulta i prezzi.
Monitora e risolvi i problemi
Per monitorare l'avanzamento della generazione dei metadati e risolvere i problemi durante la configurazione degli enrichment degli oggetti, utilizza le seguenti risorse:
- Monitorare le operazioni: per monitorare gli oggetti in attesa, i conteggi di esecuzione dei modelli, e lo stato di elaborazione in Cloud Monitoring, consulta Monitorare le metriche degli enrichment degli oggetti.
- Risolvere i problemi: se mancano gli enrichment o si verificano errori di autorizzazione, consulta Risoluzione dei problemi relativi agli enrichment degli oggetti.
Passaggi successivi
- Configurare gli enrichment degli oggetti.
- Analizzare gli enrichment degli oggetti in BigQuery.
- Gestire gli enrichment degli oggetti.
- Esaminare i modelli e gli schemi supportati.
- Esaminare la risorsa API JSON
featureConfigs. - Scopri di più sui contesti degli oggetti.