


Anda dapat menggunakan pengayaan objek untuk membuat metadata terstruktur secara otomatis tanpa membuat pipeline machine learning kustom. Pengayaan objek menerapkan model machine learning terlatih Google secara langsung ke objek tersimpan Anda untuk membantu Anda menelusuri, menata, dan mengelola data tidak terstruktur dalam skala besar.
Untuk mulai membuat metadata untuk objek Anda, lihat Mengonfigurasi pengayaan objek.
Cara kerjanya
Untuk menggunakan pengayaan objek, Anda akan menggunakan bagian sistem berikut:
- Konfigurasi fitur (
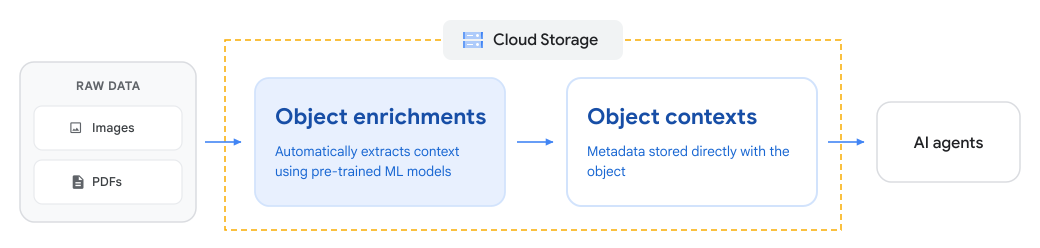
FeatureConfig): Anda membuat konfigurasi fitur untuk menentukan bucket atau project mana yang dipantau Cloud Storage. - Model machine learning: Dalam konfigurasi, Anda memilih model yang ingin diterapkan, seperti model yang mendeteksi objek, memberi label pada gambar, menganalisis wajah, atau mengategorikan dokumen PDF.
- Pengayaan objek (metadata): Cloud Storage memindai objek Anda secara asinkron dan mengevaluasi objek yang memenuhi syarat dengan model yang Anda pilih. Kemudian, Cloud Storage melampirkan metadata yang dihasilkan langsung ke objek Anda sebagai konteks objek.
Setelah Cloud Storage melampirkan metadata pengayaan ke objek Anda, metadata tersebut siap digunakan. Anda dapat memeriksa pengayaan objek individual, atau menggunakan set data Insight Penyimpanan untuk menganalisis metadata di jutaan objek menggunakan SQL di BigQuery.
Diagram berikut menunjukkan cara Cloud Storage menggunakan pengayaan objek untuk mengekstrak konteks dari data tidak terstruktur dan menyimpannya sebagai konteks objek untuk alur kerja AI dan analisis downstream:
Model yang didukung
Saat membuat konfigurasi fitur, Anda memilih model machine learning
yang paling sesuai dengan data dan tujuan analisis Anda. Cloud Storage mengevaluasi
objek yang memenuhi syarat menggunakan model yang Anda pilih dan menghasilkan metadata terstruktur
di contexts.custom.
Tabel model yang didukung mencantumkan setiap model, hal yang dideteksi, dan contoh data output. Untuk mengetahui definisi skema dan kunci konteks yang mendetail, lihat Model dan skema yang didukung.
| Model | Deskripsi | Contoh data output |
|---|---|---|
| Deteksi objek | Mendeteksi beberapa objek dalam gambar serta memberikan posisi dan batas persegi panjangnya. | Produk, Hewan, Orang |
| Pelabelan gambar | Mendeteksi dan mengekstrak informasi tentang entity dalam gambar di berbagai kategori yang luas, seperti objek, lokasi, dan aktivitas. | Lanskap, Perkotaan, Malam |
| Deteksi wajah | Mendeteksi wajah dalam gambar, termasuk poligon pembatas, landmark wajah (mata, hidung, mulut), sudut orientasi, dan kemungkinan ekspresi. | Jumlah wajah, Sudut putar dan kemiringan |
| Deteksi konten vulgar | Mengevaluasi gambar untuk konten sensitif atau tidak pantas, termasuk materi dewasa atau kekerasan. | Rating kemungkinan konten khusus dewasa dan kekerasan |
| Klasifikasi PDF | Mengklasifikasikan dokumen PDF ke dalam kategori bisnis dan industri standar berdasarkan kontennya. | Keuangan, Pajak, Invoice (kategori dan skor) |
Kasus penggunaan
Anda dapat menggunakan pengayaan objek untuk menyederhanakan pengelolaan data tidak terstruktur dan menyiapkan objek untuk alur kerja AI dan analisis hilir berikut:
- Mengatur dan membuat katalog objek yang tidak teratur: Mengklasifikasikan koleksi dokumen PDF (seperti invoice, laporan mutasi bank, dan formulir pajak) serta gambar secara otomatis. Anda dapat menggunakan klasifikasi ini untuk membuat katalog data yang dapat ditelusuri di seluruh bucket Anda tanpa menulis kode kustom.
- Mendasari agen AI dan meningkatkan penelusuran: Mengubah repositori dokumen yang tidak teratur menjadi pusat informasi terstruktur. Anda dapat menggunakan kategori dokumen dan label gambar untuk meningkatkan kualitas pengambilan selama retrieval-augmented generation (RAG) dan melakukan grounding aplikasi AI generatif Anda.
- Mengambil sampel dan menyiapkan data untuk AI generatif: Bedakan antara jenis dokumen untuk melakukan pengambilan sampel bertingkat sebelum mengarahkan konten ke model bahasa besar (LLM) atau peninjauan manual.
- Menyeleksi set data pelatihan machine learning: Filter dan segmentasikan gambar dan dokumen berdasarkan taksonomi atau label visual untuk menyusun set data pelatihan khusus domain untuk penyesuaian model.
- Memindai konten sensitif atau vulgar: Memeriksa gambar yang diupload secara otomatis untuk menemukan materi yang tidak pantas guna mendukung kebijakan moderasi dan keamanan konten Anda.
- Meningkatkan kualitas perintah multimodal: Teruskan metadata terstruktur—seperti kotak pembatas dan kategori dokumen—sebagai konteks saat memberikan perintah ke model multimodal seperti Gemini.
- Menyederhanakan arsitektur data: Hilangkan pipeline penyerapan kustom dan infrastruktur komputasi dengan membuat metadata langsung di Cloud Storage.
Membuat kueri dan menganalisis metadata Anda
Cloud Storage melampirkan pengayaan objek langsung ke objek Anda sebagai konteks objek. Bergantung pada skala dan alur kerja Anda, Anda dapat mengakses dan menganalisis metadata ini dengan cara berikut:
- Periksa setiap objek: Gunakan konsol Google Cloud atau Cloud Storage API untuk memeriksa pengayaan objek tertentu. Untuk mengetahui petunjuknya, lihat Mengelola pengayaan objek.
- Menganalisis dalam skala besar dengan SQL: Gunakan set data Storage Insights untuk mengekspor metadata di seluruh jutaan atau miliaran objek langsung ke BigQuery. Setelah Insight Penyimpanan mengekspor metadata, Anda dapat
membuat kueri tampilan
object_contexts_catalog_viewmenggunakan SQL standar. Misalnya, Anda dapat menelusuri label, memfilter berdasarkan kategori, atau menemukan objek yang memiliki skor keyakinan tinggi.
Untuk mulai menggunakan kueri SQL dan contoh resep, lihat Menganalisis pengayaan objek di BigQuery.
Pertimbangan dan batasan
Sebelum mengonfigurasi pengayaan objek, tinjau pertimbangan operasional berikut:
Lokasi pemrosesan
Pengayaan objek memproses data di tiga lokasi geografis:
us, eu, dan asia. Saat memilih lokasi pemrosesan, perhatikan pertimbangan berikut:
- Kepatuhan: Pastikan lokasi pemrosesan yang Anda pilih memenuhi persyaratan peraturan dan kedaulatan data Anda.
- Performa: Pilih lokasi pemrosesan yang paling dekat dengan region penyimpanan bucket Anda.
- Biaya: Untuk menghindari biaya duplikat, konfigurasi hanya satu lokasi pemrosesan untuk setiap bucket dan model. Jika Anda mengonfigurasi beberapa lokasi untuk bucket dan model yang sama, Cloud Storage akan memproses objek Anda di setiap lokasi dan menagih Anda untuk setiap proses.
Pemrosesan dan performa
Tinjau batasan berikut pada jenis konten, ukuran objek, dan linimasa pemrosesan:
Pemrosesan asinkron: Cloud Storage memproses objek secara asinkron.
Batas ukuran objek: Objek (gambar dan PDF) harus berukuran 20 MiB atau lebih kecil.
Jenis konten yang didukung: Cloud Storage menggunakan
Content-Typekolom metadata yang ditetapkan pada objek untuk menentukan apakah objek tersebut akan dievaluasi. Jika objek memilikiContent-Typeyang tidak valid atau tidak ada, Cloud Storage tidak akan memproses objek tersebut meskipun data yang mendasarinya adalah gambar atau PDF yang valid. Untuk memastikan bahwa Cloud Storage memproses objek, perbarui metadataContent-Typeke salah satu jenis yang didukung berikut:- Gambar: BMP, GIF, ICO, JPEG, PNG, TIFF, dan WEBP.
- Dokumen: PDF (
application/pdf).
Fitur yang tidak didukung
Pengayaan objek tidak kompatibel dengan jenis bucket dan operasi berikut:
- Relokasi bucket: Pengayaan objek tidak kompatibel dengan relokasi bucket. Hapus bucket dari konfigurasi fitur Anda sebelum merelokasi bucket.
- Jenis bucket yang tidak didukung: Anda tidak dapat mengaktifkan pengayaan objek di bucket Rapid atau bucket yang mengaktifkan namespace hierarkis.
Konfigurasi dan pengelolaan cakupan
Saat Anda menentukan dan mengelola bucket target dalam konfigurasi fitur, persyaratan berikut berlaku:
- Pencakupan bucket: Tentukan nama bucket yang tepat dalam konfigurasi fitur Anda. Cloud Storage tidak mendukung ekspresi reguler atau pola karakter pengganti.
- Siklus proses bucket: Cloud Storage tidak otomatis menambahkan bucket yang baru dibuat, dibuat ulang, atau direlokasi ke konfigurasi yang ada. Anda harus memperbarui konfigurasi fitur untuk menyertakan bucket ini.
Biaya dan keamanan
Tinjau detail operasional berikut terkait kunci enkripsi dan biaya akses data:
- Kunci yang disediakan pelanggan (CSEK): Pengayaan objek tidak mendukung objek yang dienkripsi dengan kunci enkripsi yang disediakan pelanggan.
- Akses penyimpanan dan Autoclass: Untuk menghasilkan metadata, pengayaan objek membaca data objek Anda. Operasi baca ini dikenai biaya akses data standar. Selain itu, jika bucket Anda mengaktifkan Autoclass, pembacaan ini akan memicu transisi kelas penyimpanan.
Harga
Penggunaan pengayaan objek akan dikenai biaya untuk inferensi model, penyimpanan metadata, operasi akses data, dan jaringan. Untuk mengetahui informasi selengkapnya, lihat Harga.
Pantau dan pecahkan masalah
Untuk melacak progres pembuatan metadata dan menyelesaikan masalah saat mengonfigurasi pengayaan objek, gunakan referensi berikut:
- Memantau operasi: Untuk melacak objek yang tertunda, jumlah eksekusi model, dan status pemrosesan di Cloud Monitoring, lihat Memantau metrik pengayaan objek.
- Menyelesaikan masalah: Jika pengayaan tidak ada atau Anda mengalami error izin, lihat Memecahkan masalah pengayaan objek.
Langkah berikutnya
- Mengonfigurasi pengayaan objek.
- Menganalisis pengayaan objek di BigQuery.
- Mengelola pengayaan objek.
- Tinjau model dan skema yang didukung.
- Tinjau resource
featureConfigsJSON API. - Baca tentang konteks objek.