


אתם יכולים להשתמש בהעשרת אובייקטים כדי ליצור באופן אוטומטי מטא-נתונים מובנים בלי לבנות צינורות עיבוד נתונים מותאמים אישית ללמידת מכונה. התכונה "העשרת אובייקטים" מיישמת את המודלים של למידת המכונה שאומנו מראש על ידי Google ישירות על האובייקטים שמאוחסנים, כדי לעזור לכם לחפש, לאסוף ולנהל את הנתונים הלא מובְנים שלכם בקנה מידה רחב.
כדי להתחיל ליצור מטא-נתונים לאובייקטים, אפשר לעיין במאמר הגדרת העשרת אובייקטים.
איך זה עובד
כדי להשתמש בהעשרת אובייקטים, צריך לעבוד עם החלקים הבאים במערכת:
- הגדרת תכונה (
FeatureConfig): יוצרים הגדרת תכונה כדי לציין אילו קטגוריות או פרויקטים Cloud Storage מנטר. - מודלים של למידת מכונה: בהגדרה, בוחרים את המודלים שרוצים להחיל, כמו מודלים שמזהים אובייקטים, מתייגים תמונות, מנתחים פנים או מסווגים מסמכי PDF.
- העשרת אובייקטים (מטא-נתונים): Cloud Storage סורק את האובייקטים באופן אסינכרוני ומעריך אובייקטים שעומדים בדרישות באמצעות המודלים שבחרתם. Cloud Storage מצרף את המטא-נתונים שמתקבלים ישירות לאובייקטים שלכם כהקשרים של אובייקטים.
אחרי ש-Cloud Storage מצרף את המטא-נתונים של ההעשרה לאובייקטים, אפשר להשתמש במטא-נתונים. אתם יכולים לבדוק העשרת אובייקטים בודדים, או להשתמש במערכי נתונים של Storage Insights כדי לנתח מטא-נתונים של מיליוני אובייקטים באמצעות SQL ב-BigQuery.
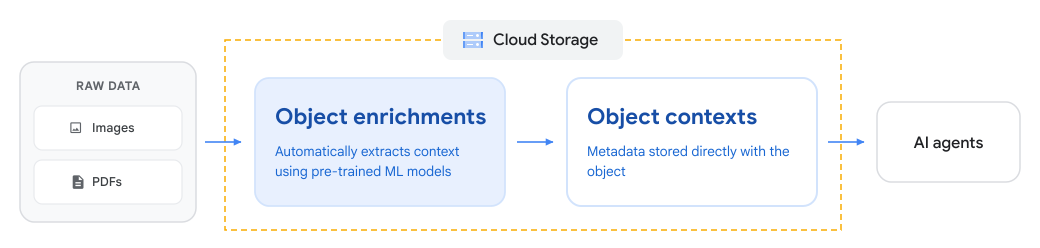
בתרשים הבא אפשר לראות איך Cloud Storage משתמש בהעשרת אובייקטים כדי לחלץ הקשר מנתונים לא מובְנים ולשמור אותו כהקשרים של אובייקטים, בשביל תהליכי עבודה של AI וניתוח נתונים בהמשך:
מודלים נתמכים
כשיוצרים הגדרת תכונה, בוחרים את המודלים של למידת המכונה שהכי מתאימים לנתונים וליעדי הניתוח. מערכת Cloud Storage מעריכה אובייקטים שעומדים בדרישות באמצעות המודלים שבחרתם, ומפיקה מטא-נתונים מובְנים בקטע contexts.custom.
בטבלת המודלים הנתמכים מפורט כל מודל, מה הוא מזהה ודוגמה לנתוני הפלט. הגדרות מפורטות של סכימות ומפתחות הקשר זמינות במאמר מודלים וסכימות נתמכים.
| דגם | תיאור | נתוני פלט לדוגמה |
|---|---|---|
| זיהוי אובייקטים | מזהה כמה אובייקטים בתמונה ומספק את המיקומים שלהם ואת הגבולות המלבניים שלהם. | מוצר, בעל חיים, אדם |
| תיוג תמונות | זיהוי וחילוץ מידע על ישויות בתמונה בקבוצה רחבה של קטגוריות, כמו אובייקטים, מיקומים ופעילויות. | נוף, עירוני, לילה |
| זיהוי פנים | זיהוי פנים בתמונות, כולל מצולעים חוסמים, ציוני דרך בפנים (עיניים, אף, פה), זוויות אוריינטציה וסבירות להבעות פנים. | מספר הפנים, זווית הגלגול וההטיה |
| זיהוי תוכן בוטה | בודק אם יש בתמונות תוכן רגיש או בלתי הולם, כולל תוכן למבוגרים בלבד או תוכן אלים. | סיווגים לפי סבירות לתוכן למבוגרים בלבד או לתוכן אלים |
| סיווג קובצי PDF | מסווגת מסמכי PDF לקטגוריות עסקיות וקטגוריות ענף רגילות על סמך התוכן שלהם. | כספים, מיסים, חשבונית (קטגוריות וציונים) |
תרחישים לדוגמה
אתם יכולים להשתמש בהעשרת אובייקטים כדי לייעל את הניהול של נתונים לא מובְנים, ולהכין אובייקטים לתהליכי העבודה הבאים של ניתוח נתונים ו-AI:
- ארגון וקטלוג של אובייקטים לא מאורגנים: סיווג אוטומטי של אוספים של מסמכי PDF (כמו חשבוניות, דפי חשבון בנק וטפסים של מס הכנסה) ותמונות. אתם יכולים להשתמש בסיווגים האלה כדי ליצור קטלוגים של נתונים שניתן לחפש בהם בקטגוריות, בלי לכתוב קוד בהתאמה אישית.
- הארקה של סוכני AI ושיפור החיפוש: הופכים מאגרי מסמכים לא מאורגנים למאגרי ידע מובנים. אתם יכולים להשתמש בקטגוריות של מסמכים ובתוויות של תמונות כדי לשפר את השליפה במהלך יצירת נתונים באמצעות אחזור (RAG) ולבסס את האפליקציות שלכם ל-AI גנרטיבי.
- דגימה והכנה של נתונים ל-AI גנרטיבי: הבחנה בין סוגי מסמכים כדי לבצע דגימה לפי קבוצות באוכלוסייה לפני ניתוב התוכן למודלים גדולים של שפה (LLM) או לבדיקה אנושית.
- לאסוף קבוצות נתונים לאימון של למידת מכונה: לסנן ולפלח תמונות ומסמכים לפי טקסונומיה או תוויות חזותיות, כדי לאסוף קבוצות נתונים לאימון בתחום ספציפי לצורך כוונון מודלים.
- סריקה לאיתור תוכן רגיש או בוטה: בדיקה אוטומטית של תמונות שהועלו כדי לאתר חומר בלתי הולם, כחלק ממדיניות ניהול התוכן והבטיחות.
- שיפור פרומפטים מולטי-מודאליים: העברת מטא-נתונים מובְנים – כמו תיבות תוחמות וקטגוריות של מסמכים – כהקשר כשמנחים מודלים מולטימודאליים כמו Gemini.
- פישוט ארכיטקטורות נתונים: אפשר ליצור מטא-נתונים ישירות ב-Cloud Storage וכך לבטל צינורות הטמעה מותאמים אישית ותשתית מחשוב.
שליחת שאילתות וניתוח המטא-נתונים
Cloud Storage מצרף העשרות של אובייקטים ישירות לאובייקטים שלכם בתור הקשרים של אובייקטים. בהתאם להיקף ולתהליך העבודה, אפשר לגשת למטא-נתונים ולנתח אותם בדרכים הבאות:
- בדיקת אובייקטים ספציפיים: אפשר להשתמש במסוף Google Cloud או בממשקי ה-API של Cloud Storage כדי לבדוק את ההעשרות של אובייקטים ספציפיים. הוראות מפורטות זמינות במאמר בנושא ניהול העשרות של אובייקטים.
- ניתוח בקנה מידה גדול באמצעות SQL: אפשר להשתמש במערכי נתונים של Storage Insights כדי לייצא מטא-נתונים של מיליוני או מיליארדי אובייקטים ישירות ל-BigQuery. אחרי שתובנות האחסון מייצאות את המטא-נתונים, אתם יכולים לשלוח שאילתות לתצוגה
object_contexts_catalog_viewבאמצעות SQL סטנדרטי. לדוגמה, אתם יכולים לחפש תוויות, לסנן לפי קטגוריה או למצוא אובייקטים עם ציוני מהימנות גבוהים.
כדי להתחיל להשתמש בשאילתות SQL ובמתכונים לדוגמה, אפשר לעיין במאמר ניתוח של העשרות אובייקטים ב-BigQuery.
שיקולים ומגבלות
לפני שמגדירים העשרת אובייקטים, כדאי לקרוא את השיקולים התפעוליים הבאים:
מיקום העיבוד
תהליכי העשרת אובייקטים מעבדים נתונים בשלושה מיקומים גיאוגרפיים: us, eu ו-asia. כשבוחרים מיקום לעיבוד, חשוב לזכור את הדברים הבאים:
- תאימות: חשוב לוודא שמיקום העיבוד שבחרתם עומד בדרישות הרגולטוריות ובדרישות של ריבונות הנתונים.
- ביצועים: בוחרים את מיקום העיבוד שהכי קרוב לאזור האחסון של הקטגוריה.
- עלות: כדי להימנע מחיובים כפולים, הגדירו רק מיקום עיבוד אחד לכל קטגוריה ומודל. אם מגדירים כמה מיקומים לאותה קטגוריה ולאותו מודל, מערכת Cloud Storage מעבדת את האובייקטים בכל מיקום ומחייבת אתכם על כל הרצה.
עיבוד וביצועים
כדאי לעיין במגבלות הבאות על סוגי תוכן, גדלי אובייקטים ולוחות זמנים לעיבוד:
עיבוד אסינכרוני: Cloud Storage מעבד אובייקטים באופן אסינכרוני.
מגבלת גודל האובייקט: האובייקטים (גם תמונות וגם קובצי PDF) צריכים להיות בגודל של עד 20MiB.
סוגי תוכן נתמכים: מערכת Cloud Storage משתמשת בשדה המטא-נתונים
Content-Typeשמוגדר באובייקט כדי לקבוע אם להעריך אותו. אם לאובייקט יש ערךContent-Typeלא חוקי או חסר, Cloud Storage לא מעבד את האובייקט גם אם הנתונים הבסיסיים הם תמונה או קובץ PDF חוקיים. כדי לוודא ש-Cloud Storage יעבד את האובייקט, צריך לעדכן את המטא-נתונים שלContent-Typeלאחד מהסוגים הנתמכים הבאים:- תמונות: BMP, GIF, ICO, JPEG, PNG, TIFF ו-WEBP.
- מסמכים: PDF (
application/pdf).
תכונות שלא נתמכות
העשרת אובייקטים לא תואמת לסוגי הבאקטים ולפעולות הבאים:
- העברת קטגוריות למיקום גיאוגרפי אחר: העשרת אובייקטים לא תואמת להעברת קטגוריות למיקום גיאוגרפי אחר. צריך להסיר את הקטגוריה מההגדרות של התכונה לפני שמזיזים את הקטגוריה.
- סוגי קטגוריות לא נתמכים: אי אפשר להפעיל העשרת אובייקטים בקטגוריות Rapid או בקטגוריות שמופעל בהן מרחב שמות היררכי.
ניהול ההגדרות וההיקף
כשמגדירים ומתחזקים קטגוריות יעד בהגדרות של התכונות, צריך לעמוד בדרישות הבאות:
- הגדרת היקף לקטגוריה: מציינים שמות מדויקים של קטגוריות בהגדרת התכונה. Cloud Storage לא תומך בביטויים רגולריים או בתבניות של תווים כלליים.
- מחזור חיים של קטגוריה: Cloud Storage לא מוסיף באופן אוטומטי קטגוריות שנוצרו, נוצרו מחדש או הועברו לאחרונה להגדרות קיימות. צריך לעדכן את הגדרות התכונה כדי לכלול את הדליים האלה.
עלויות ואבטחה
כדאי לעיין בפרטים התפעוליים הבאים לגבי מפתחות הצפנה וחיובים על גישה לנתונים:
- מפתחות באספקת הלקוח (CSEK): התכונה 'העשרת אובייקטים' לא תומכת באובייקטים שמוצפנים באמצעות מפתחות הצפנה באספקת הלקוח.
- גישה לאחסון וסיווג אוטומטי: כדי ליצור מטא-נתונים, התכונה 'העשרת אובייקטים' קוראת את נתוני האובייקטים. פעולות הקריאה האלה כרוכות בחיובים רגילים על גישה לנתונים. בנוסף, אם הסיווג האוטומטי מופעל בקטגוריה, פעולות הקריאה האלה מפעילות מעברים בין סוגי אחסון.
תמחור
השימוש בהעשרות אובייקטים כרוך בחיובים על הסקת מסקנות של מודלים, אחסון מטא-נתונים, פעולות גישה לנתונים ושימוש ברשת. למידע נוסף, ראו תמחור.
מעקב ופתרון בעיות
כדי לעקוב אחרי ההתקדמות של יצירת המטא-נתונים ולפתור בעיות בהגדרת העשרת האובייקטים, אתם יכולים להיעזר במקורות המידע הבאים:
- מעקב אחרי פעולות: כדי לעקוב אחרי אובייקטים בהמתנה, מספר הפעמים שהמודל הופעל וסטטוס העיבוד ב-Cloud Monitoring, קראו את המאמר מעקב אחרי מדדי העשרת אובייקטים.
- פתרון בעיות: אם חסרים העשרות או שנתקלתם בשגיאות הרשאה, אפשר לעיין במאמר פתרון בעיות בהעשרת אובייקטים.
המאמרים הבאים
- הגדרה של העשרת אובייקטים.
- ניתוח של העשרות אובייקטים ב-BigQuery.
- ניהול העשרת אובייקטים.
- בדיקת המודלים והסכימות הנתמכים
- בודקים את המשאב של
featureConfigsAPI בפורמט JSON. - מידע על הקשרים של אובייקטים