


Questo documento è la prima parte di una serie che illustra il disaster recovery (RE) in Google Cloud. Questa parte fornisce una panoramica del processo di pianificazione del RE: cosa devi sapere per progettare e implementare un piano di RE. Le parti successive illustrano casi d'uso specifici di RE con esempi di implementazioni su Google Cloud.
La serie è composta dalle seguenti parti:
- Guida alla pianificazione del disaster recovery (questo documento)
- Componenti di base del disaster recovery
- Scenari di disaster recovery per i dati
- Scenari di disaster recovery per le applicazioni
- Progettazione ripristino di emergenza per i workload con limitazioni a livello di località
- Casi d'uso di disaster recovery: applicazioni di analisi dei dati con limitazioni di località
- Progettazione ripristino di emergenza per le interruzioni dell'infrastruttura cloud
Gli eventi che interrompono il servizio possono verificarsi in qualsiasi momento. La tua rete potrebbe subire un'interruzione, l'ultima applicazione potrebbe introdurre un bug critico o potresti dover affrontare una calamità naturale. Quando le cose vanno male, è importante avere un piano di RE solido, mirato e ben testato.
Con un piano di RE ben progettato e testato, puoi assicurarti che, in caso di catastrofe, l'impatto sui profitti della tua attività sia minimo. Indipendentemente dalle tue esigenze di RE, Google Cloud offre una selezione solida, flessibile ed economica di prodotti e funzionalità che puoi utilizzare per creare o migliorare la soluzione più adatta a te.
Nozioni di base sulla pianificazione del RE
RE è un sottoinsieme della pianificazione della continuità aziendale. La pianificazione RE inizia con un'analisi dell'impatto aziendale che definisce due metriche chiave:
- Un Recovery Time Objective (RTO), ovvero il periodo di tempo massimo accettabile per cui l'applicazione può essere offline. Questo valore viene solitamente definito nell'ambito di un accordo sul livello del servizio (SLA) più ampio.
- Un Recovery Point Objective (RPO), ovvero il periodo di tempo massimo accettabile durante il quale i dati potrebbero andare persi da un'applicazione a causa di un incidente grave. Questa metrica varia in base ai modi in cui vengono utilizzati i dati. Ad esempio, i dati utente che vengono modificati di frequente potrebbero avere un RPO di pochi minuti. Al contrario, i dati meno critici e modificati raramente potrebbero avere un RPO di diverse ore. Questa metrica descrive solo la durata, non la quantità o la qualità dei dati persi.
In genere, più bassi sono i valori RTO e RPO (ovvero, più velocemente l'applicazione deve riprendersi da un'interruzione), maggiori saranno i costi di esecuzione dell'applicazione. Il grafico seguente mostra il rapporto tra costo e RTO/RPO.
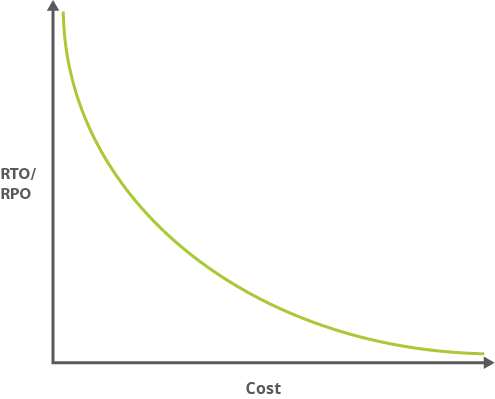
Poiché valori RTO e RPO più piccoli spesso significano una maggiore complessità, l'overhead amministrativo associato segue una curva simile. Un'applicazione ad alta affidabilità potrebbe richiedere la gestione della distribuzione tra due data center fisicamente separati, la gestione della replica e altro ancora.
I valori RTO e RPO in genere vengono raggruppati in un'altra metrica: l'obiettivo del livello di servizio (SLO), che è un elemento misurabile chiave di uno SLA. Spesso gli SLA e gli SLO vengono confusi. Uno SLA è l'intero contratto che specifica il servizio da fornire, il modo in cui è supportato, i tempi, le località, i costi, le prestazioni, le sanzioni e le responsabilità delle parti coinvolte. Gli SLO sono caratteristiche specifiche e misurabili dello SLA, come disponibilità, throughput, frequenza, tempo di risposta o qualità. Un SLA può contenere molti SLO. Gli RTO e gli RPO sono misurabili e devono essere considerati SLO.
Puoi scoprire di più su SLO e SLA nel libro Google Site Reliability Engineering.
Potresti anche pianificare un'architettura per l'alta affidabilità (HA). L'HA non si sovrappone completamente al RE, ma spesso è necessario tenerla in considerazione quando si pensa ai valori RTO e RPO. L'alta affidabilità contribuisce a garantire un livello concordato di prestazioni operative, di solito l'uptime, per un periodo superiore al normale. Quando esegui workload di produzione su Google Cloud, potresti utilizzare un sistema distribuito a livello globale in modo che, se qualcosa va storto in una regione, l'applicazione continui a fornire il servizio anche se è meno disponibile. In sostanza, l'applicazione richiama il proprio piano di RE.
Perché Google Cloud?
Google Cloud può ridurre notevolmente i costi associati sia a RTO che a RPO rispetto alla soddisfazione dei requisiti RTO e RPO on-premise. Ad esempio, la pianificazione RE richiede di tenere conto di una serie di requisiti, tra cui:
- Capacità: assicurarsi risorse sufficienti per scalare in base alle esigenze.
- Sicurezza: fornire sicurezza fisica per proteggere gli asset.
- Infrastruttura di rete: inclusi componenti software come firewall e bilanciatori del carico.
- Assistenza: messa a disposizione di tecnici qualificati per eseguire la manutenzione e risolvere i problemi.
- Larghezza di banda: pianifica una larghezza di banda adeguata per il carico di picco.
- Strutture: garantire l'infrastruttura fisica, inclusi apparecchiature e alimentazione.
Fornendo una soluzione altamente gestita su una piattaforma di produzione di livello mondiale, Google Cloud ti aiuta a evitare la maggior parte o tutti questi fattori complicanti, eliminando molti costi aziendali nel processo. Inoltre, l'attenzione di Google Cloudalla semplicità amministrativa consente di ridurre anche i costi di gestione di un'applicazione complessa.
Google Cloud offre diverse funzionalità utili per la pianificazione RE, tra cui:
- Una rete globale. Google dispone di una delle reti di computer più grandi e avanzate al mondo. La rete backbone di Google utilizza servizi avanzati di networking software-defined ed edge caching per offrire prestazioni rapide, coerenti e scalabili.
- Ridondanza. La presenza di più punti di presenza (POP) in tutto il mondo garantisce una forte ridondanza. I tuoi dati vengono sottoposti automaticamente a mirroring sui dispositivi di archiviazione in più località.
- Scalabilità. Google Cloud è progettato per scalare come altri prodotti Google (ad esempio, la Ricerca e Gmail), anche in caso di un picco di traffico enorme. I servizi gestiti come Cloud Run, Compute Engine e Firestore offrono la scalabilità automatica, che consente alla tua applicazione di crescere e ridursi in base alle esigenze.
- Sicurezza. Il modello di sicurezza di Google si basa su decenni di esperienza nel contribuire a proteggere i clienti su applicazioni Google come Gmail e Google Workspace. Inoltre, i team di Site Reliability Engineering di Google contribuiscono a garantire l'alta affidabilità e a prevenire l'abuso delle risorse della piattaforma.
- Conformità. Google si sottopone regolarmente a controlli indipendenti di terze parti per verificare che Google Cloud sia in linea con le normative e le best practice in materia di sicurezza, privacy e conformità. Google Cloudrispetta certificazioni come ISO 27001, SOC 2/3 e PCI DSS 3.0.
Pattern di RE
I pattern di RE sono considerati cold, warm o hot. Questi pattern indicano la facilità con cui il sistema può riprendersi quando qualcosa va storto. Un'analogia potrebbe essere quello che faresti se stessi guidando e forassi uno pneumatico dell'auto.
Il modo in cui affronti una foratura dipende da quanto sei preparato:
- Freddo: non hai una ruota di scorta, quindi devi chiamare qualcuno che ti porti una nuova ruota e la sostituisca. La corsa viene interrotta finché non arrivano i soccorsi per effettuare la riparazione.
- Caldo: hai una ruota di scorta e un kit di sostituzione, quindi puoi rimetterti in viaggio utilizzando ciò che hai in auto. Tuttavia, devi interrompere il viaggio per risolvere il problema.
- Hot: hai pneumatici run-flat. Potresti dover rallentare un po', ma non c'è un impatto immediato sul tuo percorso. Gli pneumatici funzionano abbastanza bene da consentirti di continuare (anche se alla fine dovrai risolvere il problema).
Creazione di un piano di RE dettagliato
Questa sezione fornisce consigli su come creare il tuo piano di RE.
Progetta in base ai tuoi obiettivi di ripristino
Quando progetti il tuo piano di RE, devi combinare le tecniche di recupero dei dati e delle applicazioni e considerare il quadro generale. Il modo tipico per farlo è esaminare i valori RTO e RPO e il pattern di RE che puoi adottare per soddisfare questi valori. Ad esempio, nel caso di dati storici orientati alla conformità, probabilmente non hai bisogno di un accesso rapido ai dati, quindi un valore RTO elevato e un pattern di RE cold sono appropriati. Tuttavia, se il tuo servizio online subisce un'interruzione, devi essere in grado di recuperare sia i dati sia la parte dell'applicazione rivolta agli utenti il più rapidamente possibile. In questo caso, un pattern hot sarebbe più appropriato. Il tuo sistema di notifiche via email, che in genere non è fondamentale per l'attività, è probabilmente un candidato per un pattern warm.
Per indicazioni sull'utilizzo di Google Cloud per affrontare scenari di RE comuni, consulta gli scenari di ripristino delle applicazioni. Questi scenari forniscono strategie di RE mirate per una varietà di casi d'uso e offrono esempi di implementazioni suGoogle Cloud per ciascuno.
Progetta per il ripristino end-to-end
Non basta avere un piano per il backup o l'archiviazione dei dati. Assicurati che il tuo piano di RE copra l'intero processo di recupero, dal backup al ripristino fino alla pulizia. Questo argomento viene trattato nei documenti correlati sui dati e sul ripristino di RE.
Crea attività specifiche
Quando è il momento di eseguire il piano di RE, non devi trovarti a indovinare il significato di ogni passaggio. Fai in modo che ogni attività del tuo piano di RE sia costituita da uno o più comandi o azioni concreti e non ambigui. Ad esempio, "Esegui lo script di ripristino" è troppo generico. Al contrario, "Apri una shell ed esegui /home/example/restore.sh" è preciso e concreto.
Implementazione di misure di controllo
Aggiungi controlli per evitare che si verifichino disastri e per rilevare i problemi prima che si verifichino. Ad esempio, aggiungi un monitor che invia un avviso quando un flusso distruttivo di dati, come una pipeline di eliminazione, mostra picchi imprevisti o altre attività insolite. Questo monitor potrebbe anche terminare i processi della pipeline se viene raggiunta una determinata soglia di eliminazione, evitando una situazione catastrofica.
Preparazione del software
Parte della pianificazione del RE consiste nell'assicurarsi che il software su cui fai affidamento sia pronto per un evento di ripristino.
Verifica di poter installare il software
Assicurati che l'applicazione possa essere installata dall'origine o da un'immagine preconfigurata. Assicurati di disporre della licenza appropriata per qualsiasi software di cui eseguirai il deployment su Google Cloud. Per indicazioni, rivolgiti al fornitore del software.
Assicurati che le risorse di Compute Engine necessarie siano disponibili nell'ambiente di ripristino. Potrebbe essere necessario preallocare o prenotare le istanze.
Progetta il deployment continuo per il ripristino
Il set di strumenti di deployment continuo (CD) è un componente fondamentale per il deployment delle applicazioni. Nell'ambito del tuo piano di ripristino, devi considerare dove eseguire il deployment degli artefatti nell'ambiente ripristinato. Pianifica dove vuoi ospitare l'ambiente e gli artefatti di CD, che devono essere disponibili e operativi in caso di emergenza.
Implementazione dei controlli di sicurezza e conformità
Quando progetti un piano di RE, la sicurezza è importante. Gli stessi controlli che hai nel tuo ambiente di produzione devono essere applicati al tuo ambiente recuperato. Le normative di conformità si applicheranno anche all'ambiente recuperato.
Configura la sicurezza allo stesso modo per gli ambienti di RE e di produzione
Assicurati che i controlli di rete forniscano la stessa separazione e lo stesso blocco utilizzati dall'ambiente di produzione di origine. Scopri come configurare il VPC condiviso e i firewall per stabilire un controllo centralizzato della rete e della sicurezza del tuo deployment, configurare le subnet e controllare il traffico in entrata e in uscita. Scopri come utilizzare i service account per implementare il privilegio minimo per le applicazioni che accedono alle API Google Cloud . Assicurati di utilizzare i service account come parte delle regole firewall.
Assicurati di concedere agli utenti lo stesso accesso all'ambiente di RE che hanno nell'ambiente di produzione di origine. Il seguente elenco descrive i modi per sincronizzare le autorizzazioni tra gli ambienti:
Se l'ambiente di produzione è Google Cloud, la replica delle policy IAM nell'ambiente di RE è semplice. Puoi utilizzare strumenti di infrastructure as code (IaC) come Terraform per eseguire il deployment delle policy IAM in produzione. Utilizza poi gli stessi strumenti per associare le policy alle risorse corrispondenti nell'ambiente di RE nell'ambito del processo di configurazione dell'ambiente di RE.
Se l'ambiente di produzione è on-premise, devi mappare i ruoli funzionali, ad esempio i ruoli di amministratore di rete e revisore, alle policy IAM con i ruoli IAM appropriati. La documentazione di IAM contiene alcuni esempi di configurazioni dei ruoli funzionali. Ad esempio, consulta la documentazione per la creazione di ruoli funzionali di networking e audit logging.
Devi configurare le policy IAM per concedere le autorizzazioni appropriate ai prodotti. Ad esempio, potresti voler limitare l'accesso a bucket Cloud Storage specifici.
Se il tuo ambiente di produzione è un altro cloud provider, mappa le autorizzazioni nelle policy IAM dell'altro provider alle policy IAM di Google Cloud .
Verifica la sicurezza del tuo RE
Dopo aver configurato le autorizzazioni per l'ambiente di RE, assicurati di testare tutto. Crea un ambiente di test. Verifica che le autorizzazioni che concedi agli utenti corrispondano a quelle che hanno on-premise.
Assicurati che gli utenti possano accedere all'ambiente di RE
Non aspettare che si verifichi un disastro prima di verificare che gli utenti possano accedere all'ambiente di RE. Assicurati di aver concesso i diritti di accesso appropriati a utenti, sviluppatori, operatori, data scientist, amministratori della sicurezza, amministratori di rete e qualsiasi altro ruolo nella tua organizzazione. Se utilizzi un sistema di identità alternativo, assicurati che gli account siano stati sincronizzati con il tuo account Cloud Identity. Poiché l'ambiente di RE sarà il tuo ambiente di produzione per un po', chiedi agli utenti che dovranno accedere all'ambiente di RE di eseguire l'accesso e risolvi eventuali problemi di autenticazione. Includi gli utenti che accedono all'ambiente di RE nei test di RE regolari che implementi.
Per gestire centralmente chi dispone dell'accesso amministrativo alle macchine virtuali (VM) avviate, attiva la funzionalità OS Login sui progetti Google Cloud che costituiscono il tuo ambiente di RE.
Forma gli utenti
Gli utenti devono capire come eseguire in Google Cloud le azioni che sono abituati a compiere nell'ambiente di produzione, ad esempio l'accesso e l'utilizzo delle VM. Utilizzando l'ambiente di test, addestra gli utenti su come eseguire queste attività in modo da salvaguardare la sicurezza del sistema.
Assicurati che l'ambiente di RE soddisfi i requisiti di conformità
Verifica che l'accesso all'ambiente di RE sia limitato solo a chi ne ha bisogno. Assicurati che i dati PII siano oscurati e criptati. Se esegui test di penetrazione regolari nel tuo ambiente di produzione, devi includere l'ambiente di RE nell'ambito ed eseguire test regolari configurando un ambiente di RE.
Assicurati che, mentre l'ambiente di RE è in servizio, tutti i log che raccogli vengano inseriti nell'archivio dei log dell'ambiente di produzione. Allo stesso modo, assicurati che, nell'ambito del tuo ambiente di RE, tu possa esportare gli audit log raccolti tramite Cloud Logging nel tuo archivio sink di log principale. Utilizza le funzionalità del sink di esportazione. Per i log delle applicazioni, crea un mirror dell'ambiente di logging e monitoraggio on-premise. Se il tuo ambiente di produzione è un altro cloud provider, mappa il logging e il monitoraggio di quel provider ai servizi Google Cloud equivalenti. Implementa un processo per formattare l'input nel tuo ambiente di produzione.
Tratta i dati recuperati come dati di produzione
Assicurati che i controlli di sicurezza applicati ai dati di produzione vengano applicati anche ai dati recuperati: devono essere applicati gli stessi requisiti di autorizzazioni, crittografia e audit.
Sapere dove si trovano i backup e chi è autorizzato a ripristinare i dati. Assicurati che il processo di ripristino sia verificabile: dopo un ripristino di emergenza, assicurati di poter mostrare chi aveva accesso ai dati di backup e chi ha eseguito il ripristino.
Verifica del funzionamento del piano di RE
Assicurati che, in caso di emergenza, il tuo piano di RE funzioni come previsto.
Mantieni più di un percorso di recupero dati
In caso di emergenza, il metodo di connessione a Google Cloud potrebbe non essere più disponibile. Implementa un mezzo di accesso alternativo aGoogle Cloud per assicurarti di poter trasferire i dati aGoogle Cloud. Verifica regolarmente che il percorso di backup sia operativo.
Testa regolarmente il tuo piano
Dopo aver creato un piano di RE, testalo regolarmente, prendendo nota di eventuali problemi che si presentano e modificando il piano di conseguenza. Utilizzando Google Cloud, puoi testare gli scenari di ripristino a un costo minimo. Ti consigliamo di implementare quanto segue per facilitare i test:
- Automatizza il provisioning dell'infrastruttura. Puoi utilizzare strumenti IaC come Terraform per automatizzare il provisioning della tua infrastruttura Google Cloud. Se esegui l'ambiente di produzione on-premise, assicurati di avere un processo di monitoraggio in grado di avviare il processo di RE quando rileva un errore e di attivare le azioni di ripristino appropriate.
- Monitora i tuoi ambienti con Google Cloud Observability. Google Cloud dispone di eccellenti strumenti di logging e monitoraggio a cui puoi accedere tramite chiamate API, che ti consentono di automatizzare il deployment degli scenari di ripristino reagendo alle metriche. Quando progetti i test, assicurati di aver predisposto un monitoraggio e un sistema di avvisi adeguati che possano attivare azioni di recupero appropriate.
Esegui i test indicati in precedenza:
- Verifica che le autorizzazioni e l'accesso degli utenti funzionino nell'ambiente di RE come nell'ambiente di produzione.
- Esegui test di penetrazione nell'ambiente di RE.
- Esegui un test in cui il tuo percorso di accesso abituale a Google Cloud non funziona.
Passaggi successivi
- Scopri di più su Google Cloud aree geografiche e regioni.
- Leggi altri documenti di questa serie sul RE:
- Componenti di base del disaster recovery
- Scenari di disaster recovery per i dati
- Scenari di disaster recovery per le applicazioni
- Progettazione ripristino di emergenza per i workload con limitazioni a livello di località
- Casi d'uso di disaster recovery: applicazioni di analisi dei dati con limitazioni di località
- Progettazione ripristino di emergenza per le interruzioni dell'infrastruttura cloud
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora Cloud Architecture Center.
Collaboratori
Autori:
- Grace Mollison | Solutions Lead
- Marco Ferrari | Cloud Solutions Architect