


Explore クエリ トラッカーと Explore の [パフォーマンス] パネルには、Explore クエリのパフォーマンス データがステップごとに表示されます。このデータは、クエリのパフォーマンスの問題をトラブルシューティングして解決するための重要なエントリ ポイントを特定し、改善のための推奨事項を提供するのに役立ちます。
クエリ トラッカーを調べる
Explore クエリ トラッカーは、クエリの実行中にクエリの 3 つのフェーズを通じて Explore クエリの進行状況を表示します。
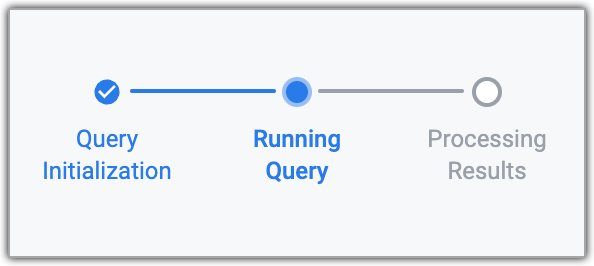
クエリの実行に時間がかかる場合は、クエリ トラッカーを使用して、パフォーマンスの問題の原因となっているクエリのフェーズを特定できます。これは、パフォーマンスの問題が発生する可能性のある場所や、最適化の取り組みが最も効果的な場所を特定するのに役立ちます。
クエリ トラッカーは、Explore の [可視化] パネルまたは Explore の [データ] パネルが開いている限り、Explore の実行中に表示されます。
[パフォーマンス] パネルを調べる
Explore の [パフォーマンス] パネルを表示するには、実行された Explore クエリで利用可能な [パフォーマンスの詳細を表示] リンクをクリックします。
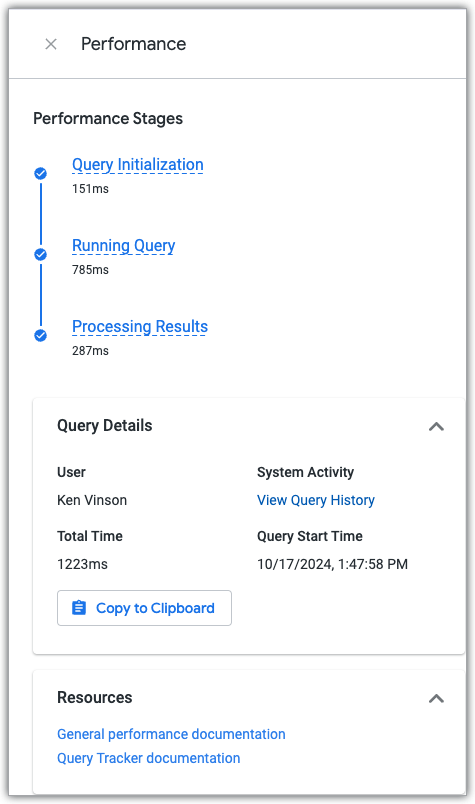
[パフォーマンス] パネルには、クエリが 3 つのクエリフェーズのそれぞれに費やした時間が表示されます。また、パフォーマンス ドキュメントと クエリ履歴 システム アクティビティ ダッシュボードへのリンクも表示されます。このダッシュボードには、クエリと、クエリの作成に使用された Explore の現在のパフォーマンス データと過去のパフォーマンス データが表示されます。
クエリフェーズ
Looker の Explore がデータベース クエリを実行すると、クエリは次の 3 つのフェーズで実行されます。
クエリの初期化フェーズ
クエリの初期化フェーズでは、クエリがデータベースに送信される前に必要なすべてのタスクを Looker が行います。クエリの初期化フェーズには、次のタスクが含まれます。
- LookML モデルのコンパイル
- 永続的な派生テーブル(PDT)を作成する必要があるかどうかの確認
- クエリ SQL の生成
- データベース接続の取得
ドキュメント ページ クエリのパフォーマンス指標を把握するでは、システム アクティビティのクエリ パフォーマンス指標 Explore を使用して、クエリの詳細な内訳を確認する方法について説明しています。クエリ トラッカーのクエリの初期化フェーズには、クエリ パフォーマンス指標 Explore の非同期ワーカー フェーズ、初期化フェーズ、接続処理フェーズで説明されているイベントが含まれます。
クエリの初期化フェーズでパフォーマンスの問題が発生した場合や、クエリに時間がかかる場合は、次の手順を行います。
- スケジュール設定された配信を分散する: スケジュール設定された多くの Look やダッシュボードが同時にトリガーされると(特に正時)、同時クエリ リクエストが急増し、インスタンス リソースが過負荷になり、接続プールが飽和状態になる可能性があります。この同時実行のボトルネックにより、初期化中にクエリが待機するか、無限にスピンします。スケジュール設定したコンテンツをすべて
:00に公開するのではなく、15 分または 30 分の間隔(:15、:30、:45など)で公開するようにします。詳細については、Looker サーバーのパフォーマンスの最適化をご覧ください。 - スケジュールにデータグループを使用する: 可能な限り、時間ベースのトリガーではなく、ETL サイクルに沿ったデータグループを使用して、スケジュール設定された配信をトリガーします。データグループを使用すると、クエリの実行が分散され、更新されていないデータに対して冗長なクエリが実行されるのを防ぐことができます。
- API 呼び出しのバッチ処理とスロットリング: 自動化スクリプトまたは外部ツールが Looker API を介してクエリまたはレポートをトリガーする場合は、バッチ リクエストを行うか、遅延を導入して、クエリ初期化キューの過負荷を回避します。
- スタックしたプロセスをクリアする: 同時実行が急増してクエリがスタックし、インスタンスが応答しなくなった場合は、インスタンスを再起動して、進行中のタスクをクリアし、内部キューをリセットします。
クエリフェーズの実行
クエリの実行フェーズは、Looker がデータベースに接続してクエリを実行し、クエリの結果を返すフェーズです。このフェーズでパフォーマンスの問題が発生した場合は、外部データベースに問題がある可能性があります。たとえば、PDT の再構築に時間がかかり、最適化が必要な場合や、外部データベース テーブルの最適化が必要な場合があります。クエリの実行フェーズには、次のタスクが含まれます。
- Explore クエリに必要な PDT をデータベースに構築する
- データベースでリクエストされたクエリを実行する
ドキュメント ページ クエリのパフォーマンス指標を把握するでは、システム アクティビティのクエリ パフォーマンス指標 Explore を使用して、クエリの詳細な内訳を確認する方法について説明しています。クエリ トラッカーのクエリの実行フェーズには、クエリ パフォーマンス指標 Explore のメインクエリのフェーズで説明されているイベントが含まれます。
このフェーズでパフォーマンスの問題が発生した場合に考えられる対応策は次のとおりです。
- 可能な限り、
many_to_one結合を使用して Explore を作成します。ビューを最も粒度の細かいレベルから最も詳細なレベル(many_to_one)まで結合すると、通常、クエリ パフォーマンスが最も高くなります。 - 可能な限りキャッシュを最大化して ETL ポリシーと同期し、データベースのクエリ トラフィックを削減します。デフォルトでは、Looker でクエリがキャッシュされるのは 1 時間です。
persist_withパラメータを使用して Explore 内でデータグループを適用することで、キャッシュ ポリシーを制御し、Looker のデータ更新を ETL プロセスと同期できます。キャッシュを最大化することで、Looker とバックエンド データ パイプラインの統合を強化できるので、古いデータを分析するリスクを伴わずにキャッシュ使用量を最大化できます。名前の付けられたキャッシュ ポリシーをモデル全体や個々の Explore、永続的な派生テーブル(PDT)に適用することができます。 - Looker の集約テーブルの自動認識機能を使用して、Looker がロール アップまたはサマリー テーブルを作成できます。Looker は可能な限り、特に大規模なデータベースの一般的なクエリの場合にこのテーブルを使用できます。また、集約テーブルの自動認識を利用して、大幅にダッシュボード全体のパフォーマンスを改善することもできます。詳細については、集約テーブルの自動認識のチュートリアルをご覧ください。
- PDT を使用してクエリを高速化します。多くの複雑な結合やパフォーマンスの低い結合を持つ Explore や、サブクエリやサブセレクトを持つディメンションを PDT に変換すると、ビューが事前結合され、ランタイム前に使用可能な状態になります。
- データベース言語が増分 PDT をサポートしている場合は、増分 PDT を構成して、Looker が PDT テーブルの再構築にかかる時間を短縮します。
- Looker で定義された連結済みの主キーでビューを Explore に結合しないようにします。ビューに含まれる、連結済みの主キーを構成する基本フィールドで結合します。または、ビューの LookML ではなく、テーブルの SQL 定義で事前定義された連結済みの主キーを使用して、ビューを PDT として再作成します。
- ベンチマークには、SQL Runner ツールの Explain を使用します。
EXPLAINは、特定の SQL クエリに対するデータベースのクエリ実行プランの概要を生成し、最適化可能なクエリ コンポーネントを検出できるようにします。詳細については、コミュニティ投稿のEXPLAINを使用して SQL を最適化する方法をご覧ください。 - インデックスを宣言します。各テーブルのインデックスは、Looker で SQL Runner から直接確認できます。テーブルの歯車アイコンをクリックし、[Show Indexes] を選択します。
よく使われる列のうち、インデックスのメリットを得られる列は、重要な日付と外部キーです。これらの列にインデックスを追加すると、ほぼすべてのクエリのパフォーマンスが向上します。これは PDT にも適用されます。
indexes、sort keys、distributionなどの LookML パラメータが適切に適用できます。
結果の処理フェーズ
結果の処理フェーズでは、Looker がクエリを処理し、結果をレンダリングします。結果の処理フェーズには、次のタスクが含まれます。
- クエリ結果をキャッシュにストリーミングする
- 表計算の解決
- Liquid テンプレート言語の結果をフォーマットする
- クエリをマージする
- 合計と小計の計算
ドキュメント ページ クエリのパフォーマンス指標を把握するでは、システム アクティビティのクエリ パフォーマンス指標 Explore を使用して、クエリの詳細な内訳を確認する方法について説明しています。クエリ トラッカーの結果の処理フェーズには、クエリ パフォーマンス指標 Explore のクエリ後のフェーズで説明されているイベントが含まれます。
このフェーズでパフォーマンスの問題が発生した場合に考えられる対策は次のとおりです。
- 統合された結果、カスタム フィールド、表計算などの機能の使用は控えめにします。これらの機能は、モデルの設計に役立つ概念実証として使用することを目的としています。 使用頻度の高い計算や関数は LookML にハードコードすることをおすすめします。これにより、データベースで処理される SQL を生成します。過剰な計算は Looker インスタンスの Java メモリと競合する可能性があるため、Looker インスタンスのレスポンスが遅くなります。
- 多数のビューファイルが存在する場合は、モデルに含めるビューの数を制限します。1 つのモデルにすべてのビューを含めると、パフォーマンスが低下する可能性があります。プロジェクト内に多数のビューが存在する場合は、各モデル内で必要なビューファイルのみを含めることを検討してください。モデルにビューグループを簡単に含められるように、ビューファイルの名前に戦略的な命名規則を採用することを検討してください。例については、
includesパラメータのドキュメントをご覧ください。 - ダッシュボードのタイルと Look 内に、大量のデータポイントをデフォルトで返すのを避けます。数千のデータポイントを返すクエリは、より多くのメモリを消費します。フロントエンドの
フィルタをダッシュボード、Look、Explore に適用し、LookML レベルで
required filters、conditionally_filter、sql_always_whereパラメータを使用して、可能な限りデータを制限できるようにします。 - クエリのサイズが非常に大きくなり、処理する際に Looker サーバーに負荷がかかる可能性があるため、[すべての結果] オプションを使用してのクエリのダウンロードや配信は控えめにします。