


Le suivi des requêtes Explorer et le panneau Performances d'Explorer fournissent des données sur les performances détaillées pour une requête Explorer. Ces données peuvent vous aider à identifier les points d'entrée clés pour résoudre les problèmes de performances liés aux requêtes et à fournir des recommandations pour les améliorer.
Explorer le suivi des requêtes
Le suivi des requêtes Explore affiche la progression d'une requête Explore au cours des trois phases de la requête pendant son exécution.
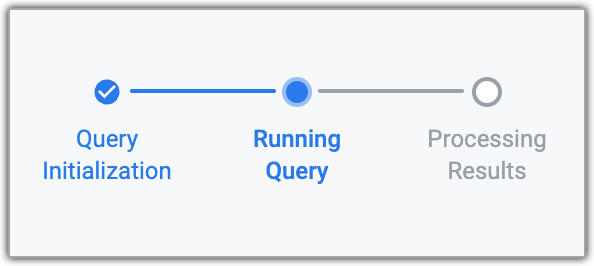
Si une requête prend beaucoup de temps à s'exécuter, le suivi des requêtes peut indiquer la phase de la requête qui est à l'origine du problème de performances. Cela permet d'identifier les zones où des problèmes de performances peuvent survenir et où les efforts d'optimisation peuvent être les plus efficaces.
Le suivi des requêtes s'affiche lorsqu'une exploration est en cours d'exécution, à condition que le panneau Visualisation ou le panneau Données de l'exploration soit ouvert.
Explorer le panneau Performances
Pour afficher le panneau Performances d'Explorer, cliquez sur le lien Afficher les détails des performances, disponible pour toute requête Explorer exécutée.
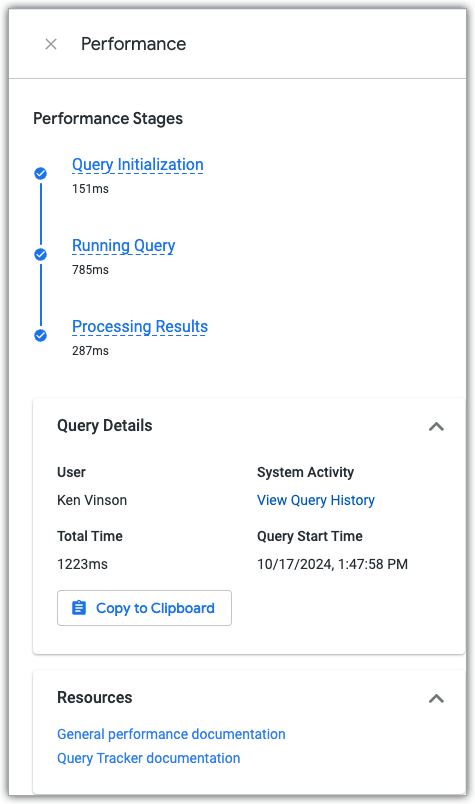
Le panneau Performances indique le temps passé par la requête dans chacune des trois phases de la requête. Il inclut des liens vers la documentation sur les performances et le tableau de bord des activités Historique des requêtes, qui affiche les données sur les performances actuelles et l'historique des performances pour la requête et l'exploration utilisées pour créer la requête.
Phases de la requête
Lorsqu'une exploration Looker exécute une requête de base de données, celle-ci est exécutée en trois phases :
- La phase d'initialisation de la requête
- Phase d'exécution de la requête
- La phase de traitement des résultats
Phase d'initialisation de la requête
Pendant la phase d'initialisation de la requête, Looker effectue toutes les tâches requises avant l'envoi de la requête à votre base de données. La phase d'initialisation de la requête comprend les tâches suivantes :
- Compilation du modèle LookML
- Vérification de la nécessité de créer des tables dérivées persistantes (PDT)
- Générer la requête SQL
- Acquisition de la connexion à la base de données
La page de documentation Comprendre les métriques sur les performances des requêtes explique comment utiliser l'exploration Métriques sur les performances des requêtes dans Activité du système pour afficher des détails sur une requête. La phase Initialisation de la requête du suivi des requêtes inclut les événements décrits dans les phases Worker asynchrone, Initialisation et Gestion des connexions de l'exploration Métriques sur les performances des requêtes.
Phase d'exécution de la requête
La phase Exécution de la requête correspond au moment où Looker contacte et interroge votre base de données, puis renvoie les résultats de la requête. Les problèmes de performances pendant cette phase peuvent indiquer un problème avec la base de données externe, comme des PDT qui mettent longtemps à se reconstruire et qui peuvent avoir besoin d'être optimisées, ou des tables de base de données externes qui peuvent avoir besoin d'être optimisées. La phase Exécution de la requête comprend les tâches suivantes :
- Créer les PDT nécessaires à la requête Explore dans la base de données
- Exécution de la requête demandée sur la base de données
La page de documentation Comprendre les métriques sur les performances des requêtes explique comment utiliser l'exploration Métriques sur les performances des requêtes dans Activité du système pour afficher des détails sur une requête. La phase Requête en cours d'exécution du suivi des requêtes inclut les événements décrits dans la phase Requêtes principales de l'outil Explorer Métriques sur les performances des requêtes.
Voici quelques mesures que vous pouvez prendre si vous rencontrez des problèmes de performances au cours de cette phase :
- Créez des explorations à l'aide de jointures
many_to_oneautant que possible. Joindre des vues du niveau le plus précis au niveau de détail le plus élevé (many_to_one) offre généralement les meilleures performances de requête. - Maximisez la mise en cache afin de vous synchroniser avec vos règles ETL, dans la mesure du possible, pour réduire le trafic des requêtes de base de données. Par défaut, Looker met en cache les requêtes pendant une heure. Vous pouvez contrôler la règle de mise en cache et synchroniser les actualisations des données Looker avec votre processus ETL en appliquant des groupes de données dans les explorations à l'aide du paramètre
persist_with. La maximisation de la mise en cache permet à Looker de s'intégrer plus étroitement au pipeline de données backend afin que l'utilisation du cache puisse être maximisée, sans risque d'analyser des données obsolètes. Les règles de mise en cache nommées peuvent être appliquées à un modèle entier ou à des explorations et des tables dérivées persistantes (PDT) individuelles. - Utilisez la fonctionnalité de reconnaissance d'agrégats de Looker pour créer des tables de cumul ou de synthèse que Looker peut utiliser pour les requêtes chaque fois que cela est possible, en particulier pour les requêtes courantes de grandes bases de données. Vous pouvez également utiliser la reconnaissance d'agrégats pour améliorer considérablement les performances de tableaux de bord entiers. Pour en savoir plus, consultez le tutoriel sur la sensibilisation agrégée.
- Utilisez des PDT pour accélérer les requêtes. Convertissez les explorations comportant de nombreuses jointures complexes ou peu performantes, ou des dimensions avec des sous-requêtes ou des sous-sélections, en PDT afin que les vues soient pré-jointes et prêtes avant l'exécution.
- Si votre dialecte de base de données prend en charge les PDT incrémentales, configurez les PDT incrémentales pour réduire le temps que Looker consacre à la régénération des tables PDT.
- Évitez de joindre des vues dans des explorations sur des clés primaires concaténées définies dans Looker. À la place, effectuez une jointure sur les champs de base qui composent la clé primaire concaténée de la vue. Vous pouvez également recréer la vue en tant que PDT avec la clé primaire concaténée prédéfinie dans la définition SQL de la table, plutôt que dans le LookML d'une vue.
- Utilisez l'outil "Expliquer dans l'exécuteur SQL" pour effectuer des benchmarks.
EXPLAINgénère un aperçu du plan d'exécution des requêtes de votre base de données pour une requête SQL donnée, ce qui vous permet de détecter les composants de requête qui peuvent être optimisés. Pour en savoir plus, consultez le post de la communauté Optimiser SQL avecEXPLAIN. - Déclarez les index. Vous pouvez consulter les index de chaque table directement dans Looker depuis Exécuteur SQL. Pour ce faire, cliquez sur l'icône en forme de roue dentée dans une table, puis sélectionnez Afficher les index.
Les colonnes les plus courantes qui peuvent bénéficier d'index sont les dates importantes et les clés étrangères. L'ajout d'index à ces colonnes améliorera les performances de presque toutes les requêtes. Cela s'applique également aux PDT. Les paramètres LookML, tels que
indexes,sort keysetdistribution, peuvent être appliqués de manière appropriée.
Phase de traitement des résultats
Pendant la phase de traitement des résultats, Looker traite et affiche les résultats de la requête. La phase Traitement des résultats comprend les tâches suivantes :
- Diffusion en continu des résultats de requête vers le cache
- Résoudre les problèmes liés aux calculs de table
- Mettre en forme les résultats du langage de templating Liquid
- Fusionner des requêtes
- Calculer les totaux et les sous-totaux
La page de documentation Comprendre les métriques sur les performances des requêtes explique comment utiliser l'exploration Métriques sur les performances des requêtes dans Activité du système pour afficher des détails sur une requête. La phase Résultats du traitement du suivi des requêtes inclut les événements décrits dans la phase post-requête de l'outil Explorer Métriques sur les performances des requêtes.
Voici quelques mesures que vous pouvez prendre si vous rencontrez des problèmes de performances au cours de cette phase :
- Utilisez les fonctionnalités telles que Fusionner les résultats, Champs personnalisés et Calculs de tables avec parcimonie. Ces fonctionnalités sont destinées à être utilisées comme des démonstrations de faisabilité pour vous aider à concevoir votre modèle. Il est recommandé de coder en dur les calculs et les fonctions fréquemment utilisés dans LookML, ce qui générera du code SQL à traiter dans votre base de données. Des calculs excessifs peuvent entrer en concurrence pour la mémoire Java sur l'instance Looker, ce qui ralentit la réponse de l'instance Looker.
- Limitez le nombre de vues que vous incluez dans un modèle lorsqu'un grand nombre de fichiers de vues sont présents. Inclure toutes les vues dans un seul modèle peut ralentir les performances. Lorsqu'un projet contient un grand nombre de vues, envisagez d'inclure uniquement les fichiers de vue nécessaires dans chaque modèle. Envisagez d'utiliser des conventions de nommage stratégiques pour les noms de fichiers de vues afin de permettre l'inclusion de groupes de vues dans un modèle. Un exemple est présenté dans la documentation sur le paramètre
includes. - Évitez de renvoyer un grand nombre de points de données par défaut dans les tuiles de tableaux de bord et les Looks. Les requêtes qui renvoient des milliers de points de données consomment plus de mémoire. Assurez-vous de limiter les données autant que possible en appliquant des
filtres frontend aux tableaux de bord, aux Looks et aux explorations, et au niveau LookML avec les paramètres
required filters,conditionally_filteretsql_always_where. - N'utilisez l'option Tous les résultats pour télécharger ou envoyer des requêtes que de manière ponctuelle, car certaines requêtes peuvent être très volumineuses et surcharger le serveur Looker lors de leur traitement.