


Vous pouvez gérer l'ordre des mises à niveau automatiques des clusters Google Kubernetes Engine (GKE) dans plusieurs environnements à l'aide du séquençage du déploiement. Par exemple, vous pouvez qualifier une nouvelle version dans des clusters de préproduction avant de mettre à niveau les clusters de production. GKE fournit également une version antérieure de cette fonctionnalité, le séquençage de déploiement basé sur un parc, qui offre des fonctionnalités plus limitées et n'est pas recommandée pour les nouveaux environnements.
Ce document suppose que vous connaissez les éléments suivants :
- Mises à niveau de cluster
- Présentation de la gestion de parc
- Canaux de publication
- Schéma de gestion des versions dans GKE
- Tests d'endurance
Présentation
Le séquençage du déploiement GKE vous permet de définir une séquence ordonnée spécifique pour les mises à niveau de clusters dans différents environnements. Par exemple, vous pouvez d'abord mettre à niveau les clusters de l'environnement de développement, puis ceux de l'environnement de test et enfin ceux de l'environnement de production. Cette stratégie progressive offre un temps de préparation intégré, ce qui vous permet de détecter et de limiter les problèmes potentiels avant que la mise à niveau n'atteigne vos systèmes les plus critiques.
Le séquençage des déploiements repose sur le concept de parcs, qui sont des regroupements logiques de clusters GKE mappés à un environnement (par exemple, de test). Pour utiliser cette fonctionnalité, vous définissez une séquence composée de parcs et définissez le temps de stabilisation entre chaque groupe. Lorsque GKE sélectionne une nouvelle version, vos clusters sont mis à niveau dans l'ordre défini, ce qui vous permet de valider les charges de travail avant que la version ne soit entièrement déployée dans votre environnement de production.
Les parcs sont compatibles avec les appartenances légères, qui vous permettent de regrouper logiquement des clusters pour le séquençage du déploiement sans activer toutes les configurations et fonctionnalités au niveau du parc. L'appartenance légère est un bon choix si vous souhaitez utiliser le séquençage de déploiement sans certaines des autres implications de la gestion complète du parc, telles que l'uniformité des espaces de noms au niveau du parc. Pour en savoir plus, consultez Appartenances légères.
Choisir une stratégie de séquençage du déploiement
GKE propose deux versions de séquençage du déploiement. Les deux versions reposent sur les mêmes principes de base de mises à niveau progressives basées sur le parc, mais nous vous recommandons d'utiliser le séquençage du déploiement avec des étapes personnalisées pour les nouveaux environnements :
- Séquençage du déploiement avec des étapes personnalisées (recommandé pour les nouveaux environnements) : cette version est une évolution du modèle basé sur le parc, offrant un contrôle et une flexibilité plus précis, mais ne disposant pas d'une compatibilité complète avec la console Google Cloud . Les étapes personnalisées vous permettent de définir des étapes spécifiques au sein d'un parc à l'aide d'étiquettes. Elles constituent donc un bon choix pour les stratégies de déploiement plus complexes, comme le déploiement d'une nouvelle version sur un petit sous-ensemble de clusters de production avant un déploiement plus large. De plus, vous disposez d'un meilleur contrôle sur les déploiements, par exemple en lançant un déploiement vers une version spécifique, en choisissant les types de mises à niveau à déployer dans une séquence, et en mettant en pause ou en annulant les déploiements. Choisissez cette option si vous créez une séquence de déploiement pour la première fois.
- Séquencement de déploiement basé sur un parc : cette version de la fonctionnalité est plus complète dans la console Google Cloud , mais ses fonctionnalités sont plus limitées et elle n'est pas recommandée si vous créez une séquence de déploiement pour la première fois.
Le reste de ce document ne concerne que le séquençage du déploiement avec des phases personnalisées.
Séquençage du déploiement avec des étapes personnalisées
Lorsque vous utilisez le séquençage de déploiement avec des étapes personnalisées, vous définissez l'ordre des mises à niveau du parc et définissez des temps de stabilisation. Vous pouvez également effectuer les opérations suivantes :
- Définissez une séquence avec des étapes précises qui peuvent cibler des sous-ensembles spécifiques de clusters au sein d'un parc à l'aide d'étiquettes. Cela en fait un bon choix pour des stratégies telles que les déploiements progressifs.
- Bénéficiez d'un meilleur contrôle et d'une meilleure observabilité grâce aux nouveaux objets d'API
RolloutSequenceetRollout.
Cette méthode offre une flexibilité et un contrôle précis optimaux sur les mises à niveau de votre cluster. Pour cibler des sous-ensembles spécifiques de clusters au sein d'un parc, vous utilisez un label-selector pour ne cibler que les clusters dotés d'étiquettes Kubernetes spécifiques.
Le diagramme suivant montre comment GKE met automatiquement à niveau les clusters dans une séquence de déploiement qui utilise des étapes personnalisées. L'étape cible les clusters avec un label-selector nommé canary dans le parc prod :
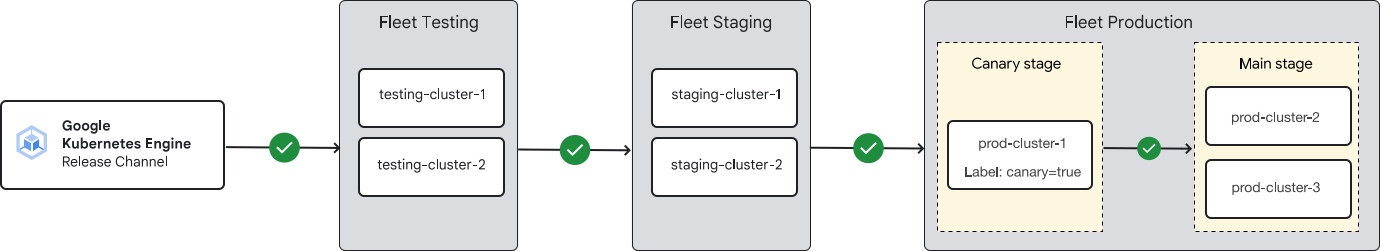
Lorsque GKE déploie une nouvelle version, il met d'abord à niveau les clusters du parc de test, puis ceux du parc de préproduction.
Ensuite, dans le parc de production, GKE donne la priorité aux clusters qui correspondent à label-selector. Comme prod-cluster-1 est étiqueté avec canary:
true, GKE met ensuite à niveau ce cluster. GKE met à niveau tous les clusters restants du parc de production (dans l'étape principale) à la fin du processus, car cette étape ne comporte pas de sélecteur d'étiquette.
Pendant le temps de stabilisation configuré entre les étapes, vous pouvez vérifier que vos charges de travail s'exécutent comme prévu sur les clusters mis à niveau. L'exemple précédent montre une étape personnalisée dans le parc de production, mais vous pouvez ajouter plusieurs étapes à n'importe quel parc ou n'utiliser qu'un seul parc avec plusieurs étapes.
Concepts clés
- Temps de stabilisation : période d'attente configurable qui se produit après la mise à niveau de tous les clusters d'une étape. Ce temps de stabilisation vous permet de valider la nouvelle version dans un environnement et de détecter les problèmes potentiels avant que la mise à niveau ne passe à l'environnement suivant. Vous pouvez configurer un temps de stabilisation de 30 jours maximum pour chaque étape de votre séquence. Un temps de stabilisation plus long en préproduction vous donne plus de temps pour la validation.
RolloutSequence: cet objet est la ressource principale que vous utilisez pour définir votre séquence de mise à niveau.RolloutSequencecontient une série ordonnée d'étapes, qui vérifie que les clusters des étapes précédentes sont entièrement mis à niveau et ont terminé leur période de test avant que la mise à niveau ne passe à l'étape suivante. ChaqueRolloutSequencepossède unRolloutpour chaque nouvelle version déployée.Rollout: cet objet vous permet d'observer la progression d'une mise à niveau de version unique dans votre séquence. Vous pouvez utiliserRolloutpour afficher l'état du déploiement, suivre sa progression et voir si des clusters ne sont pas éligibles à la mise à niveau, et pourquoi. ChaqueRolloutest associé à unRolloutSequencespécifique représentant la séquence dans laquelle la version est déployée.- Projet hôte dédié : nous vous recommandons d'utiliser un projetGoogle Cloud dédié pour héberger vos objets
RolloutSequence. Placer la séquence dans un projet dédié fournit un point de contrôle neutre et central pour vos séquences de déploiement, ce qui est une bonne pratique similaire pour la gestion des pipelines de CI/CD.
Créez et gérez vos ressources RolloutSequence dans un projet hôte dédié.
- Étapes : une étape est une phase de la séquence de déploiement. Chaque étape contient un groupe de clusters qui sont mis à niveau ensemble.
- Parcs : les parcs sont le principal moyen de regrouper des clusters. Une étape d'une séquence de déploiement peut référencer un ou plusieurs parcs. Une même séquence de déploiement peut inclure des parcs hébergés dans plusieurs organisationsGoogle Cloud .
- Sélecteurs d'étiquettes : une séquence de déploiement est composée d'une ou de plusieurs étapes. Chaque étape contient des clusters d'un parc, et vous pouvez utiliser des sélecteurs d'étiquettes sur les clusters pour diviser un parc en plusieurs étapes. Cette approche permet d'adopter des stratégies telles que les déploiements progressifs, où un petit sous-ensemble de clusters de production est mis à niveau en premier.
Comment GKE met-il à niveau les clusters dans une séquence de déploiement ?
Lorsque GKE met à niveau un cluster, d'abord le plan de contrôle, puis les nœuds sont mis à niveau. Dans une séquence de déploiement, les clusters sont toujours mis à niveau à l'aide de ce processus, mais vous contrôlez également l'ordre dans lequel les groupes (parcs) de clusters sont mis à niveau. Vous spécifiez également un temps de stabilisation qui définit la durée pendant laquelle GKE observe une pause avant que les mises à niveau ne passent d'un groupe au groupe suivant.
Les mises à niveau des clusters dans une séquence de déploiement se déroulent de la façon suivante :
- GKE démarre un nouveau déploiement dans la séquence de déploiement. Par défaut, un déploiement est lancé lorsque GKE définit une nouvelle cible de mise à niveau automatique pour les clusters d'une version mineure dans un version disponible spécifique. Pour le séquençage du déploiement avec des étapes personnalisées, vous pouvez également déclencher un nouveau déploiement dans une séquence de déploiement vers une version spécifique de votre choix.
GKE commence à mettre à niveau les plans de contrôle du cluster vers la nouvelle version dans le premier groupe de clusters. Après avoir mis à niveau le plan de contrôle d'un cluster, GKE commence à mettre à niveau les nœuds du cluster. GKE respecte la disponibilité de la maintenance lors de la mise à niveau des clusters dans une séquence de déploiement.
GKE effectue les étapes suivantes pour les mises à niveau du plan de contrôle :
- Une fois que toutes les mises à niveau du plan de contrôle du cluster dans le premier groupe sont terminées, GKE lance la période de stabilisation pour les mises à niveau du plan de contrôle. GKE lance également la période de stabilisation si plus de 30 jours se sont écoulés depuis le début des mises à niveau du plan de contrôle.
Une fois la période de stabilisation terminée pour les mises à niveau du plan de contrôle du cluster du premier groupe, GKE commence à mettre à niveau les plans de contrôle du deuxième groupe vers la nouvelle version. Notez toutefois les points suivants :
- Dans certains cas, GKE peut mettre à niveau les plans de contrôle du cluster du premier groupe plusieurs fois avant de mettre à niveau les plans de contrôle du cluster du deuxième groupe. Dans ce cas, GKE choisit la dernière version qui possède également les attributs suivants :
- La version est qualifiée par le premier groupe.
- La version est au plus une version mineure ultérieure à la version du plan de contrôle des clusters du deuxième groupe.
- GKE ne met pas à niveau le plan de contrôle des clusters du deuxième groupe qui disposent d'une version ultérieure à celle qualifiée par le premier groupe.
- Dans certains cas, GKE peut mettre à niveau les plans de contrôle du cluster du premier groupe plusieurs fois avant de mettre à niveau les plans de contrôle du cluster du deuxième groupe. Dans ce cas, GKE choisit la dernière version qui possède également les attributs suivants :
Parallèlement aux mises à niveau du plan de contrôle, GKE effectue les étapes suivantes pour les mises à niveau des nœuds :
- Une fois que toutes les mises à niveau des nœuds du premier groupe sont terminées, GKE lance la période de stabilisation pour les mises à niveau des nœuds. GKE lance également la période de stabilisation si plus de 30 jours se sont écoulés depuis le début des mises à niveau des nœuds.
- Une fois la période de stabilisation terminée pour les mises à niveau des nœuds du premier groupe, GKE commence à mettre à niveau les nœuds du deuxième groupe vers la nouvelle version. Notez toutefois les points suivants :
- Dans certains cas, GKE peut mettre à niveau les nœuds de cluster du premier groupe plusieurs fois avant de mettre à niveau les nœuds de cluster du deuxième groupe. Dans ce cas, GKE choisit la dernière version qui possède également les attributs suivants :
- La version est qualifiée par le premier groupe.
- La version n'est pas postérieure à la version du plan de contrôle du cluster du deuxième groupe.
- GKE ne met pas à niveau les nœuds des clusters du deuxième groupe dont la version est ultérieure à celle qualifiée par le premier groupe.
- Dans certains cas, GKE peut mettre à niveau les nœuds de cluster du premier groupe plusieurs fois avant de mettre à niveau les nœuds de cluster du deuxième groupe. Dans ce cas, GKE choisit la dernière version qui possède également les attributs suivants :
GKE répète ces étapes du deuxième au troisième groupe, jusqu'à ce que les clusters de tous les groupes de la séquence de déploiement aient été mis à niveau vers la nouvelle version.
Pendant la mise à niveau des clusters de chaque groupe, pendant le temps de stabilisation, vérifiez que vos charges de travail avec des clusters exécutant la nouvelle version de GKE fonctionnent comme prévu.
Les mises à niveau des clusters peuvent également être bloquées en raison d'exclusions ou d'intervalles de maintenance, de l'utilisation d'une API obsolète ou pour d'autres raisons.
Contrôler les mises à niveau dans une séquence de déploiement
Avec les mises à niveau séquentielles d'un cluster, les groupes de clusters sont mis à niveau dans l'ordre que vous avez défini et sont stabilisés dans chaque groupe pendant la durée que vous avez choisie. Pour en savoir plus sur le contrôle de ce processus, consultez les ressources suivantes :
- Pour en savoir plus sur la gestion du déploiement d'une version spécifique, consultez Gérer un déploiement.
- Pour en savoir plus sur la gestion de la séquence de déploiement pour tous les déploiements, consultez Gérer une séquence de déploiement.
Exemple : la banque communautaire déploie progressivement les modifications des tests en production.
L'administrateur de plate-forme d'une banque communautaire gère trois environnements de déploiement principaux : test, préproduction et production. Les clusters de production sont répartis dans plusieurs régions, avec différents niveaux de criticité. Pour gérer efficacement les mises à niveau, l'administrateur regroupe les clusters de chaque environnement dans des parcs. Comme cela est nécessaire pour le séquençage du déploiement, chaque cluster des trois parcs est enregistré dans le même version disponible (dans ce cas, le canal standard) et tous les clusters exécutent la même version mineure.
L'objectif principal de l'administrateur est de s'assurer que les nouvelles versions de GKE sont minutieusement vérifiées avant d'atteindre l'environnement de production critique de la banque. Elle souhaite également mettre à niveau progressivement les clusters d'une région à faible trafic, puis passer à une région à trafic plus élevé et enfin à sa région la plus critique. Pour ce faire, ils utilisent le séquençage du déploiement avec des étapes personnalisées afin de définir une stratégie de mise à niveau progressive qui inclut l'étiquetage des clusters de production en fonction de leur région. Cette approche leur permet de valider une nouvelle version sur un petit sous-ensemble du trafic de production avant un déploiement complet.
Pour mettre en œuvre ce plan, l'administrateur applique les libellés suivants aux clusters du parc de production :
- Les clusters de
us-west1(trafic plus faible) sont étiquetés avecprod-region: us-west1. - Les clusters de
europe-west1(trafic plus élevé) sont étiquetésprod-region: europe-west1. - Les clusters de
us-east1(trafic le plus critique) ne sont pas étiquetés. La dernière étape d'un parc dans une séquence doit servir de "fourre-tout" pour tous les clusters restants. Par conséquent, l'administrateur n'a pas besoin d'ajouter d'étiquettes à ces clusters restants.
Ensuite, dans un projet hôte dédié utilisé pour gérer les configurations CI/CD, ils définissent un objet RolloutSequence. Cette nouvelle séquence comporte cinq étapes distinctes :
- Tests : cette étape inclut tous les clusters du parc
testing. L'administrateur définit un temps de stabilisation de trois jours pour permettre une validation approfondie. - Staging : cette étape inclut tous les clusters du parc
staging, avec un temps de stabilisation de trois jours. - Production dans la région
us-west1: cette étape cible le parc de production, mais utilise unlabel-selectorpour n'inclure que les clusters portant l'étiquetteprod-region: us-west1. Cette étape permet à l'administrateur de surveiller les problèmes sur un petit sous-ensemble de clusters de production avec un temps de stabilisation de trois jours. - Production dans la région
europe-west1: cette étape inclut les clusters du parcproductionqui portent l'étiquetteprod-region: europe-west1. L'administrateur définit un temps de stabilisation plus long de quatre jours pour une validation plus approfondie. - Production dans la région
us-east1: cette étape finale inclut les clusters restants du parcproduction, c'est-à-dire tous les clusters deus-east1.
Cette approche permet à l'administrateur de contrôler de manière précise les mises à niveau de production, ce qui améliore considérablement la sécurité et la fiabilité du processus de mise à niveau en détectant les problèmes potentiels avant qu'ils n'affectent l'ensemble de l'environnement de production.
Lors d'une mise à niveau de routine, les tests automatisés de la banque se terminent avec succès dans l'environnement de préproduction beaucoup plus rapidement que prévu. L'administrateur constate que la nouvelle version est stable et décide que le temps de stabilisation de trois jours après la mise à niveau du parc de préproduction est inutilement long pour ce type de mise à jour de routine.
Pour accélérer ce déploiement, l'administrateur modifie la définition de RolloutSequence et réduit la durée de stabilisation de l'étape us-west1 du parc de production. Étant donné que cette modification de la définition de RolloutSequence met à jour le temps de stabilisation par défaut pour tous les déploiements actuels et futurs, l'administrateur note de rétablir le temps de stabilisation à la période initiale de trois jours une fois ce déploiement de correctif spécifique terminé. Cette approche permet de s'assurer que le temps de stabilisation standard, plus prudent, est en place pour les futures mises à niveau de versions mineures.
L'administrateur utilise des intervalles de maintenance et des exclusions pour s'assurer que GKE met à jour les clusters au moment où cela perturbe le moins la banque. GKE respecte la disponibilité de la maintenance pour les clusters mis à niveau dans une séquence de déploiement :
- L'administrateur a configuré des intervalles de maintenance pour ses clusters afin que GKE ne les mette à niveau qu'en dehors des heures d'ouverture.
- L'administrateur utilise également les exclusions de maintenance pour empêcher temporairement la mise à niveau des clusters s'il détecte des problèmes avec les charges de travail du cluster.
De plus, l'administrateur peut gérer un déploiement en effectuant des actions telles que la mise en pause d'un déploiement s'il détecte des problèmes, ou l'achèvement d'une étape s'il est satisfait des modifications apportées à cette étape et qu'il est prêt à continuer immédiatement.
L'administrateur utilise une combinaison de mises à niveau de surutilisation et de mises à niveau bleu-vert pour ses nœuds, équilibrant ainsi la vitesse et la tolérance aux risques selon les charges de travail s'exécutant sur ces nœuds.
Comment GKE démarre-t-il le déploiement d'une nouvelle version ?
Par défaut, GKE crée un déploiement lorsqu'il définit une nouvelle cible de mise à niveau automatique. La version que GKE sélectionne pour le déploiement dépend de la version mineure et du version disponible des clusters de la séquence. Par exemple, si vos clusters exécutent la version 1.35 de GKE dans le canal standard et que GKE définit une cible de mise à niveau automatique sur 1.35.5-gke.1000000, GKE crée un Rollout.
Toutefois, vous pouvez également choisir une version que vous souhaitez que GKE déploie.
Déployer une version spécifique
Vous pouvez également lancer un déploiement vers une version spécifique si, par exemple, vous souhaitez corriger rapidement une faille de sécurité ou résoudre un problème critique avec vos clusters GKE. Cette action crée un objet Rollout, qui lance un déploiement dans votre séquence de déploiement, de la même manière que lorsque GKE définit une cible de mise à niveau automatique. Pour déployer une nouvelle version, consultez Déployer une version spécifique.
Si vous devez déployer une nouvelle version sur un cluster le plus rapidement possible, vous pouvez également effectuer des mises à niveau manuelles pour les clusters individuels. Les mises à niveau manuelles des clusters sont effectuées au niveau du cluster.
Choisir les types de mises à niveau que GKE effectue dans une séquence de déploiement
Par défaut, GKE déploie tous les types de mises à niveau de cluster dans une séquence de déploiement, y compris les mises à niveau de version de correctif et de version mineure du plan de contrôle et des nœuds.
Il existe quatre principaux types de mises à niveau :
- Mises à niveau de versions de correctif du plan de contrôle
- Mises à niveau de versions de correctif des nœuds
- Mises à niveau de version mineure du plan de contrôle
- Mises à niveau de versions mineures des nœuds
Vous pouvez limiter le champ d'application des mises à niveau de cluster dans une séquence de déploiement pour n'effectuer que des types de mises à niveau spécifiques. Par exemple, si vous souhaitez que GKE ne déploie que les mises à niveau du plan de contrôle, et non celles des nœuds, vous pouvez le spécifier pour votre séquence de déploiement.
Si vous limitez le champ d'application des mises à niveau de clusters pour une séquence de déploiement, GKE n'effectuera pas ce type de mise à niveau automatique pour les clusters de la séquence de déploiement, à l'exception des mises à niveau automatiques obligatoires, si nécessaire. Pour en savoir plus, consultez Déploiements pour les mises à niveau automatiques obligatoires. Limiter le champ d'application des mises à niveau de cluster n'annule pas les déploiements en cours du type que vous limitez. Cela empêche seulement GKE de créer de futurs déploiements de ce type.
Étant donné que GKE ne met pas à niveau les nœuds d'un cluster vers une version ultérieure à celle du plan de contrôle, limiter le champ d'application des mises à niveau du plan de contrôle peut également limiter les mises à niveau des nœuds.
Pour limiter le champ d'application des mises à niveau automatiques dans une séquence de déploiement, consultez Choisir les types de mises à niveau que GKE effectue dans une séquence de déploiement.
La restriction du champ d'application d'une séquence de déploiement fonctionne de la même manière que les exclusions de maintenance, mais les exclusions de maintenance sont définies pour des clusters individuels ou des pools de nœuds au sein d'un cluster.
Déploiements pour les mises à niveau automatiques obligatoires
Que votre cluster soit enregistré ou non dans une séquence de déploiement, GKE effectue des mises à niveau automatiques du cluster pour des raisons de sécurité et de compatibilité. Si les plans de contrôle des clusters de votre séquence de déploiement n'ont pas été mis à niveau depuis 90 jours, ou si les clusters exécutent une version mineure qui a atteint la fin de la période de compatibilité, GKE crée un déploiement obligatoire pour effectuer des mises à niveau automatiques. Ces déploiements permettent de s'assurer que votre cluster reste performant, disponible et sécurisé. GKE crée des déploiements pour ces scénarios, quelles que soient les restrictions sur le champ d'application des déploiements, les exclusions de maintenance ou toute autre raison de retard.
Vous ne pouvez pas suspendre ni annuler ce type de déploiement. GKE effectue ces types de mises à niveau de cluster, quel que soit l'enregistrement de la séquence de déploiement.
Pour en savoir plus sur ces règles, consultez les sections suivantes :
- Mises à niveau automatiques à la fin de la période de compatibilité
- Règle de correctif du plan de contrôle sur 90 jours
Éligibilité au déploiement
Pour qu'une version soit déployée via une séquence qui utilise des étapes personnalisées, les clusters doivent être éligibles à une cible de mise à niveau à partir de leur version disponible. Lorsqu'une nouvelle version de GKE est disponible, le système crée un objet Rollout si les clusters de la séquence sont éligibles à la nouvelle version.
Bien que nous recommandions d'enregistrer tous les clusters dans le même canal de publication, si ce n'est pas le cas, GKE sélectionne une version du canal le plus conservateur de la séquence. Par exemple, si les clusters sont répartis entre les canaux stable et standard, GKE choisit la version du canal stable.
Le Rollout passe ensuite par les étapes définies dans votre RolloutSequence. Au cours d'une étape donnée, le déploiement du plan de contrôle et celui du pool de nœuds peuvent s'exécuter en parallèle. Une règle clé régissant cette progression est que, lorsqu'une étape est à l'état SOAKING avec une version particulière, elle n'est pas éligible pour commencer une nouvelle Rollout pour une version plus récente. Cela permet de s'assurer qu'une version est entièrement validée avant le début de la mise à niveau suivante. Vous pouvez observer la progression et l'éligibilité de chaque cluster en surveillant l'objet Rollout. Si vous constatez des écarts de version qui rendent un cluster inéligible, vous devrez peut-être prendre des mesures, telles que la mise à niveau manuelle du cluster ou l'exclusion d'un cluster d'une séquence de déploiement, pour permettre au déploiement de se poursuivre. Si un cluster n'est éligible à aucun déploiement, GKE ne le mettra pas à niveau automatiquement tant qu'il n'aura pas besoin de créer des déploiements pour les mises à niveau automatiques obligatoires, comme décrit dans la section précédente.
Les clusters exécutant des versions ultérieures à la cible de mise à niveau n'empêchent pas les mises à niveau
Si une étape de la séquence contient des clusters qui exécutent une version ultérieure à la version cible d'un déploiement, GKE met à niveau les clusters éligibles pour la version cible et ignore les clusters qui sont déjà sur une version ultérieure. Ce comportement n'empêche pas la séquence de déploiement de passer à l'étape suivante.
Par exemple, si la version cible d'un déploiement pour une étape est la version 1.32 et que cette étape comporte des clusters exécutant les versions 1.31 et 1.33, GKE met à niveau les clusters de la version 1.31 vers la version 1.32 et ignore les clusters qui sont déjà sur la version 1.33.
L'étape précédente a qualifié plusieurs cibles de mise à niveau pour l'étape suivante
Une étape précédente d'une séquence peut terminer les déploiements de plusieurs nouvelles versions alors qu'une étape ultérieure est suspendue (par exemple, par une exclusion de maintenance) ou traite encore une mise à niveau précédente. Dans ce cas, lorsque l'étape suivante est prête à accepter une nouvelle mise à niveau, GKE met à niveau l'étape vers la dernière version qualifiée. Pour les mises à niveau du plan de contrôle, cette version peut être au maximum une version mineure ultérieure à la version du plan de contrôle des clusters de l'étape suivante. Pour les mises à niveau de nœuds, cette version peut être égale à la version du plan de contrôle des clusters de l'étape suivante, mais pas ultérieure.
Par exemple, ce scénario est pertinent si vous avez configuré des exclusions de maintenance pour empêcher temporairement les mises à niveau sur vos clusters de production. Si vos clusters en préproduction n'avaient pas les mêmes exclusions de maintenance, ces clusters pourraient être mis à niveau plusieurs fois, ce qui qualifierait plusieurs nouvelles versions, mais vos étapes de production ne seraient pas mises à niveau.
Forced soaking après 30 jours
Pour s'assurer qu'une séquence de déploiement termine la mise à niveau des clusters, GKE lance la période de stabilisation d'un groupe si les mises à niveau du plan de contrôle ou des nœuds ne sont pas terminées sur tous les clusters dans le délai maximal de mise à niveau (30 jours). Les mises à niveau des clusters restants du groupe peuvent continuer pendant la période de soaking.
Fonctionnement du séquençage du déploiement avec d'autres fonctionnalités de mise à niveau
Le séquençage du déploiement fonctionne avec d'autres fonctionnalités de mise à niveau de GKE :
Intervalles et exclusions de maintenance : vous pouvez toujours utiliser des intervalles et des exclusions de maintenance pour contrôler à quel moment les mises à niveau peuvent être effectuées ou non sur vos clusters. GKE ne lance la mise à niveau d'un cluster que dans l'intervalle de maintenance du cluster. Vous pouvez utiliser une exclusion de maintenance pour empêcher temporairement la mise à niveau d'un cluster. Les deux méthodes suivantes permettent de limiter GKE à certains types de mises à niveau :
- Au niveau du cluster ou du pool de nœuds : exclusions de maintenance
- Niveau de la séquence de déploiement : choisir les types de mises à niveau que GKE effectue dans une séquence de déploiement
Cependant, aucune de ces méthodes qui limitent le champ d'application des mises à niveau de cluster n'empêche les mises à niveau automatiques obligatoires. Si GKE ne peut pas mettre à niveau un cluster en raison d'un intervalle ou d'une exclusion de maintenance, cela peut empêcher l'achèvement des mises à niveau du cluster dans une étape. Si une mise à niveau de cluster ne peut pas être terminée dans les 30 jours en raison d'intervalles ou d'exclusions de maintenance, l'étape entre dans sa phase de stabilisation, que tous les clusters aient terminé ou non la mise à niveau.
Stratégies de mise à niveau des nœuds : le séquençage du déploiement n'affecte pas les stratégies de mise à niveau des nœuds que vous avez configurées (par exemple, les mises à niveau bleu-vert). Comme pour les mises à niveau de clusters sans séquençage du déploiement, GKE utilise les mises à niveau de la surutilisation pour les nœuds Autopilot. Pour en savoir plus, consultez Mises à niveau automatiques des nœuds.
Si les mises à niveau des nœuds ne peuvent pas être terminées dans les 30 jours, le groupe entre dans sa phase de stabilisation, que tous les clusters aient terminé la mise à niveau ou non. Cela peut se produire si la stratégie de mise à niveau de nœuds entraîne une mise à niveau plus longue des nœuds d'un cluster Standard, en particulier s'il s'agit d'un pool de nœuds volumineux. Cette situation peut également être exagérée par des intervalles de maintenance qui ne sont pas assez importants pour qu'une mise à niveau de nœuds se termine.
Canaux de publication : nous vous recommandons d'enregistrer tous les clusters d'une séquence de déploiement dans le même version disponible.
Détection de l'utilisation d'API obsolètes : la détection de l'utilisation d'API obsolètes par GKE fonctionne toujours comme prévu, ce qui peut suspendre les mises à niveau sur les clusters qui utilisent une API obsolète.
Mises à niveau manuelles : la mise à niveau manuelle des clusters lors de la première étape d'une séquence ne qualifie pas, en soi, cette version et ne déclenche pas le déploiement. Le processus de déploiement automatisé est piloté par les cibles de mise à niveau automatique officielles définies pour le version disponible. Une mise à niveau manuelle met à jour les clusters, mais la séquence ne commence à avancer pour cette version qu'une fois qu'elle devient la cible de mise à niveau automatique désignée.
Notifications de cluster : GKE fournit des notifications pour le séquençage du déploiement, en plus des autres notifications de cluster disponibles. Pour en savoir plus, consultez Notifications pour le séquençage du déploiement.
Recevoir plusieurs mises à niveau au sein d'une séquence
Un version disponible sélectionne une cible de mise à niveau pour le cluster. Si une nouvelle version devient disponible alors que les mises à niveau vers une cible précédente sont toujours en cours, la première étape peut commencer le déploiement d'une nouvelle version, même si les étapes ultérieures reçoivent toujours la mise à niveau précédente. Par exemple, si le troisième groupe d'une séquence déploie la version 1.31.12-gke.1265000, le premier groupe de la séquence peut déployer simultanément la version 1.31.13-gke.1008000.
Éléments à prendre en compte lors du choix du séquençage du déploiement
Pensez à utiliser le séquençage du déploiement si vous souhaitez gérer les mises à niveau de cluster en qualifiant de nouvelles versions dans un environnement avant de les déployer dans un autre.
Toutefois, cette stratégie peut ne pas convenir dans votre environnement si l'une des affirmations suivantes est vraie :
- Vous disposez de clusters qui ne sont pas sur le même version disponible ou sur la même version mineure dans le même environnement de production.
- Vous effectuez fréquemment des mises à niveau manuelles qui entraînent des versions cibles de mise à niveau automatique différentes pour les clusters d'un groupe.
Notifications concernant le séquençage du déploiement
GKE envoie des notifications de cluster, qui fournissent des informations critiques sur les mises à niveau au niveau du cluster. De plus, GKE fournit des notifications sur les séquences de déploiement avec des étapes personnalisées, ainsi que sur les déploiements qui ont lieu avec ces séquences de déploiement. Par exemple, GKE envoie des notifications lorsqu'une étape de déploiement démarre, se termine ou est bloquée. GKE envoie également une notification si vous avez mal configuré une séquence de déploiement. Pour en savoir plus, consultez le document Notifications de cluster et ses sections respectives pour RolloutEvent et RolloutSequenceEvent.
Gérer un déploiement
Lorsque GKE déploie une nouvelle version sur les clusters de votre séquence de déploiement, vous pouvez utiliser les actions suivantes pour contrôler le processus tout en évaluant la façon dont votre cluster et vos charges de travail réagissent au changement. Vous pouvez également créer un déploiement pour déployer une version spécifique.
Tant que les mises à niveau sont en cours, vous pouvez vérifier leur état. En fonction de la progression de la mise à niveau, vous pouvez utiliser les actions expliquées dans les sous-sections suivantes.
Suspendre un déploiement
Vous pouvez suspendre un déploiement en cours. Par exemple, si vous remarquez un problème potentiel avec vos clusters et la nouvelle version en cours de déploiement, vous pouvez suspendre temporairement le déploiement. GKE ne lancera pas de nouvelles opérations de mise à niveau vers cette version, ce qui vous permettra d'examiner tout problème, si nécessaire. GKE n'arrête pas les opérations de mise à niveau en cours, mais n'en lance pas de nouvelles, y compris pour les étapes suivantes.
Pour suspendre un déploiement, consultez Suspendre un déploiement.
Après avoir suspendu un déploiement, vous pouvez le reprendre ou l'annuler. Un déploiement peut être mis en pause pendant 90 jours maximum. Après 90 jours, GKE annule le déploiement.
La mise en pause d'un déploiement n'empêche pas le démarrage des déploiements suivants. Toutefois, ces déploiements ne dépasseront pas l'étape de déploiement suspendue. Par exemple, si GKE a déjà déployé la version 1.34.8-gke.1000000 sur les première et deuxième étapes, et que vous suspendez le déploiement sur la troisième étape, GKE peut lancer un nouveau déploiement vers la version 1.35.5-gke.1163000 et mettre à niveau les clusters des deux premières étapes. Toutefois, GKE ne lancera pas les mises à niveau vers la version 1.35.5-gke.1163000 lors de la troisième étape tant que le déploiement de la version 1.34.8-gke.1000000 n'aura pas été effectué lors de la troisième étape ou annulé.
Si plusieurs déploiements sont en cours pour une séquence de déploiement et que vous souhaitez tous les suspendre, vous devez suspendre chaque déploiement individuellement. Si vous souhaitez empêcher GKE de démarrer des déploiements supplémentaires, vous pouvez choisir les types de mises à niveau que GKE effectue dans une séquence de déploiement.
Reprendre un déploiement
Vous pouvez reprendre un déploiement mis en pause depuis moins de 90 jours, après avoir examiné les problèmes potentiels et lorsque vous êtes prêt à procéder aux mises à niveau. Vous ne pouvez reprendre un déploiement suspendu que si un autre déploiement du même type (déploiement du plan de contrôle ou déploiement de nœuds) n'est pas en cours d'exécution en même temps sur la même étape. Vous pouvez également reprendre un déploiement qui a été automatiquement suspendu par GKE pour des raisons techniques ou commerciales, bien que nous vous recommandions de faire preuve de prudence avant de le faire.
Si vous reprenez le déploiement, GKE lance de nouvelles opérations de mise à niveau pour continuer à déployer la nouvelle version dans les étapes de la séquence de déploiement.
Pour reprendre un déploiement, consultez Reprendre un déploiement.
Annuler un déploiement
Vous pouvez annuler un déploiement, y compris les déploiements actifs ou suspendus. Lorsque vous annulez un déploiement, GKE ne crée pas automatiquement un nouveau déploiement vers la même version. Toutefois, l'annulation d'un déploiement n'empêche pas GKE de déployer des versions ultérieures. Si vous souhaitez également empêcher GKE de déployer des versions ultérieures, annulez tous les déploiements en cours et limitez le champ d'application des mises à niveau de cluster dans la séquence de déploiement.
Pour annuler un déploiement, consultez Annuler un déploiement.
Si vous devez déployer la même version que celle qui a été annulée, déployez une version spécifique.
Terminer une étape de déploiement
Si vous êtes certain que le déploiement d'une version peut passer à l'étape suivante de la séquence de déploiement, par exemple parce que vous avez terminé vos tests à cette étape, vous pouvez faire progresser manuellement votre déploiement en terminant l'étape. Si vous terminez l'étape, les clusters que GKE n'a pas encore mis à niveau ne seront pas mis à niveau dans le cadre de ce déploiement. La finalisation de l'étape permet également d'ignorer le temps de stabilisation restant. Cette action signifie également que vous n'avez pas besoin de modifier le temps de stabilisation au niveau de la séquence de déploiement.
Pour terminer une étape de déploiement, consultez Terminer une étape de déploiement.
Gérer un déploiement en modifiant la séquence de déploiement
Vous pouvez également gérer un déploiement en effectuant des actions qui affectent l'ensemble de la séquence de déploiement. Toutefois, avant de procéder, envisagez de prendre les mesures décrites dans les sections précédentes, telles que la suspension d'un déploiement. Certaines modifications apportées à une séquence de déploiement peuvent entraîner l'annulation des déploiements en cours, en plus d'affecter le fonctionnement des futurs déploiements de la séquence. Si vous ne souhaitez modifier qu'un seul déploiement, utilisez les outils fournis pour gérer un déploiement, au lieu de modifier l'ensemble de la séquence.
Toutefois, si vous souhaitez modifier le fonctionnement d'une séquence de déploiement pour tous les déploiements (et pas seulement pour le déploiement d'une nouvelle version), consultez la section suivante, Gérer une séquence de déploiement.
Contrôler les mises à niveau de clusters individuels pour gérer le déploiement
Pour les mises à niveau individuelles des clusters, vous pouvez utiliser les outils suivants pour gérer les mises à niveau :
- Contrôler manuellement les mises à niveau en effectuant des actions telles que l'annulation, la reprise, le rollback ou la fin de mises à niveau des pools de nœuds
- Utilisez des intervalles et des exclusions de maintenance pour décider si un cluster peut être mis à niveau ou non.
- Configurez des stratégies de mise à niveau des nœuds pour équilibrer la vitesse et la tolérance aux risques en fonction des charges de travail s'exécutant sur ces nœuds.
Pour en savoir plus, consultez Fonctionnement du séquençage du déploiement avec d'autres fonctionnalités de mise à niveau.
Gérer une séquence de déploiement
Pour gérer une séquence de déploiement, vous pouvez effectuer des actions de base telles que les suivantes :
- Répertorier vos séquences de déploiement
- Décrire une séquence de déploiement
Vous pouvez également effectuer des actions telles que la modification d'une séquence de déploiement et l'ignorance d'un cluster dans une séquence de déploiement. Ces actions sont décrites dans les sous-sections suivantes.
Pour en savoir plus sur la gestion du déploiement d'une seule version au lieu de l'ensemble de la séquence de déploiement, consultez la section précédente, Gérer un déploiement.
Ignorer un cluster dans une séquence de déploiement
Par défaut, tous les clusters faisant partie d'un parc dans une séquence de déploiement sont mis à niveau dans le cadre de la séquence de déploiement. Vous pouvez ajouter des clusters à des étapes spécifiques. Sinon, tous les clusters d'un parc qui ne sont pas étiquetés seront mis à niveau ensemble.
Toutefois, si vous avez un cluster que vous ne souhaitez pas inclure dans la séquence de déploiement, vous pouvez l'étiqueter afin que GKE l'ignore lors du déploiement de nouvelles versions. Vous devrez peut-être le faire si, par exemple, vous avez besoin de plus de temps avant de mettre à niveau ce cluster spécifique. Vous pouvez ignorer un ou plusieurs clusters dans une séquence de déploiement.
Si vous ignorez un cluster dans une séquence de déploiement, GKE ne le prendra pas en compte lors du déploiement d'une nouvelle version et n'effectuera pas de mises à niveau automatiques pour le cluster, à l'exception des mises à niveau automatiques obligatoires, y compris les mises à niveau automatiques à la fin de la période de compatibilité et les mises à niveau automatiques pour les plans de contrôle qui n'ont pas été mis à niveau depuis 90 jours.
Pour ignorer un cluster dans une séquence de déploiement, consultez Ignorer un cluster dans une séquence de déploiement.
Modifier une séquence de déploiement
Si vous souhaitez modifier le déroulement des déploiements dans une séquence de déploiement existante, vous pouvez modifier la séquence de deux manières :
- Modifiez une séquence de déploiement en modifiant le fichier de configuration YAML dans lequel vous avez défini la séquence.
- Modifiez les clusters de la séquence.
Voici ce qui se produit si vous modifiez une séquence de déploiement :
- Si vous ajoutez une étape, supprimez une étape, modifiez l'ordre des étapes ou modifiez une étape (par exemple, pour modifier l'ID du projet ou les sélecteurs d'étiquettes de cette étape) dans une séquence de déploiement, GKE annule tous les déploiements actifs.
- Si vous modifiez le temps de stabilisation d'une étape, GKE n'annule pas les déploiements actifs.
Pour modifier une séquence de déploiement, consultez Modifier une séquence de déploiement.
Voici ce qui se passe si vous modifiez les clusters d'une séquence :
- Si vous supprimez un cluster d'une séquence de déploiement en le supprimant d'un parc, les déploiements actifs se poursuivent. GKE peut mettre à niveau automatiquement le cluster en fonction des procédures standards pour les clusters non enregistrés dans une séquence.
- Si vous ajoutez un cluster à un parc dans une séquence de déploiement, GKE mettra à niveau ce cluster dans le cadre de tous les déploiements actifs qui n'ont pas encore dépassé l'étape à laquelle vous l'avez ajouté. Toutefois, si l'étape a été effectuée pour le déploiement, GKE ne mettra pas à niveau le cluster dans ce déploiement.
Si vous déplacez un cluster vers une autre étape sans modifier la configuration de la séquence de déploiement, voici ce qui se passe, selon que l'étape vers laquelle vous déplacez le cluster est terminée ou non :
- Si vous déplacez un cluster vers une étape dont le déploiement est déjà terminé, GKE ne met pas à niveau le cluster dans ce déploiement.
- Si vous déplacez un cluster qui a déjà été mis à niveau lors d'un déploiement vers une étape ultérieure non terminée, GKE l'ignore et n'interrompt pas la progression du déploiement.
Pour modifier les clusters d'une séquence, consultez Enregistrer un cluster sur Google Cloud dans votre parc.
Limites
Les limites suivantes s'appliquent lorsque vous mettez à niveau vos clusters à l'aide du séquençage du déploiement avec des étapes personnalisées :
- Vous ne pouvez pas utiliser la console Google Cloud pour créer ou modifier des séquences de déploiement avec des étapes personnalisées. Toutefois, vous pouvez utiliser la console pour surveiller un déploiement (preview).
- Lorsqu'une séquence de déploiement fait référence à un parc, vous devez inclure l'intégralité du parc. Cette contrainte signifie que si vous définissez une étape pour cibler uniquement un sous-ensemble de clusters d'un parc avec un
label-selector(par exemple, pour un déploiement progressif), vous devez également définir une étape "catch-all" ultérieure qui inclut tous les clusters restants de ce même parc. Cette étape générique cible le même parc, mais n'inclut pas delabel-selector, ce qui inclut automatiquement tous les clusters qui n'ont pas été sélectionnés par les étapes précédentes de la séquence. - Si vous modifiez une séquence pendant un déploiement, en particulier les modifications qui affectent les clusters participants, GKE annule immédiatement tous les déploiements existants. Si vous ne modifiez que le temps de stabilisation d'une séquence, GKE n'annule pas le déploiement.
- Une étape peut référencer un seul parc au maximum. Vous ne pouvez pas avoir plusieurs parcs dans une même étape.
- Un parc ne peut être référencé que dans une seule séquence de déploiement. Deux séquences de déploiement ne peuvent pas faire référence au même parc.
- Vous ne pouvez pas mettre à niveau des clusters avec un séquençage du déploiement qui utilisent des mises à niveau automatiques de correctifs accélérées.
- Vous pouvez créer une séquence de déploiement comportant jusqu'à 15 étapes.
- Vous pouvez inclure jusqu'à 250 clusters dans un parc. Pour les clusters avec des appartenances légères, vous pouvez demander une augmentation de quota pour un maximum de 2 000 clusters dans un parc. Pour en savoir plus, consultez la page Quotas et limites.
- Vous pouvez configurer un temps de stabilisation maximal par séquence de 90 jours maximum pour toutes les étapes.
Problèmes connus
Cette section décrit les problèmes connus liés au séquençage du déploiement avec des étapes personnalisées.
- Si une étape de votre séquence de déploiement ne contient aucun cluster, elle est ignorée, mais le temps de stabilisation défini pour cette étape s'écoule tout de même avant que le déploiement ne passe à l'étape suivante.