自訂連接器可整合不屬於 Gemini Enterprise 標準連接器資料庫的外部資料來源,讓您能運用 Gemini 和 Google 的進階搜尋智慧技術,以自然語言搜尋及存取機構專屬資料。自訂連接器會直接與 Discovery Engine API 互動,提供強大的資料儲存庫、索引和智慧搜尋功能。連接器會將來源資訊轉換為標準化的 JSON 文件格式 (結構化內容、中繼資料和存取控制清單 (ACL)),並確保這些資料會整理至資料儲存庫。這些存放區可做為邏輯存放區,最好代表單一文件格式,且各自有專屬的搜尋索引和設定。
自訂連接器的運作方式
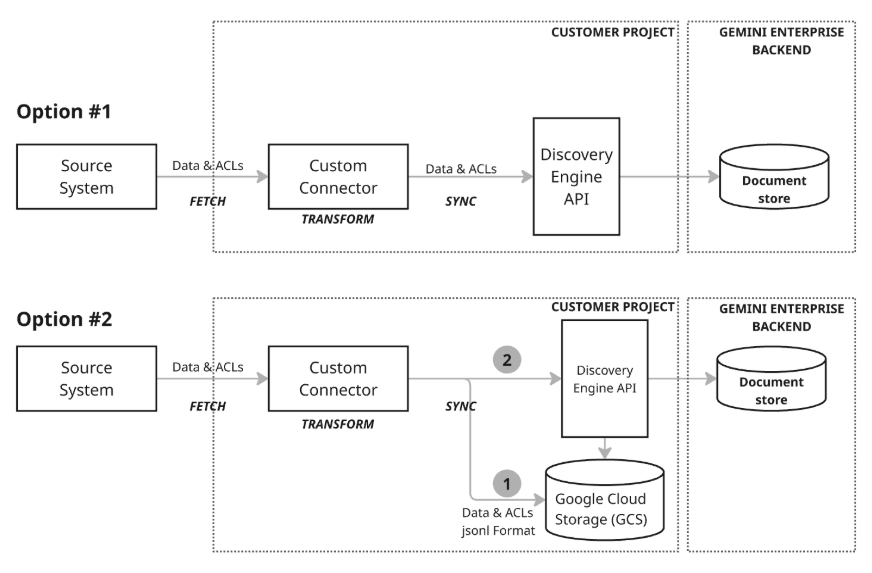
自訂連接器會使用自動化資料管道,執行三個主要動作:擷取、轉換和同步。這個程序可確保外部資料正確準備並上傳至 Gemini Enterprise。
擷取:連接器使用 API、資料庫或檔案格式,從外部系統提取資料,包括文件、中繼資料和權限。
轉換:連接器會將原始資料轉換為 Discovery Engine 的文件格式、建構內容和中繼資料,並為每份文件指派全域專屬 ID。如要控管存取權,可以直接使用 Google 辨識的身分,或為外部使用者或自訂群組設定身分對應。
同步:連接器會將文件上傳至 Gemini Enterprise 資料儲存庫,並透過排定的工作保持最新狀態。資料同步作業會使用為實體建立的資料儲存庫執行。如要進一步瞭解如何建立資料儲存庫,請參閱「資料儲存庫建立程序」。根據需求選擇同步模式:「增量」會新增及更新資料,「完整」則會取代整個資料集。
ACL 和識別資訊對應
如要管理文件層級存取權,請根據資料使用的身分格式,選擇純 ACL 或身分對應這兩種方法。
純 ACL (AclInfo):如果資料來源使用 (Google Cloud) 辨識的電子郵件身分,就會採用這個方法。這個方法適合直接定義哪些人有存取權。
識別資訊對應:如果資料來源使用使用者名稱、舊版 ID 或其他外部身分系統,請使用這個方法:
這項設定會在外部身分群組 (例如 EXT1) 和內部識別資訊提供者 (IDP) 使用者或群組 (例如
IDPUser1@example.com) 之間,建立明確的一對一關聯。系統可藉此瞭解並套用來源系統的群組存取控管機制。如果 API 傳回群組標籤,但未提供完整的使用者成員資格,或需要有效率地擴充 ACL,而不必列出每份文件的數千名使用者,這項功能就非常實用。
身分對應程序需要將所有巢狀或階層式身分結構解析為直接對應的平面清單,通常採用指定的 JSON 格式。
請為外部身分使用不重複的外部身分群組 ID (例如 EXT1),以維護系統完整性。如需更多資訊和範例,請參閱「對應外部身分」。
資料儲存庫建立程序
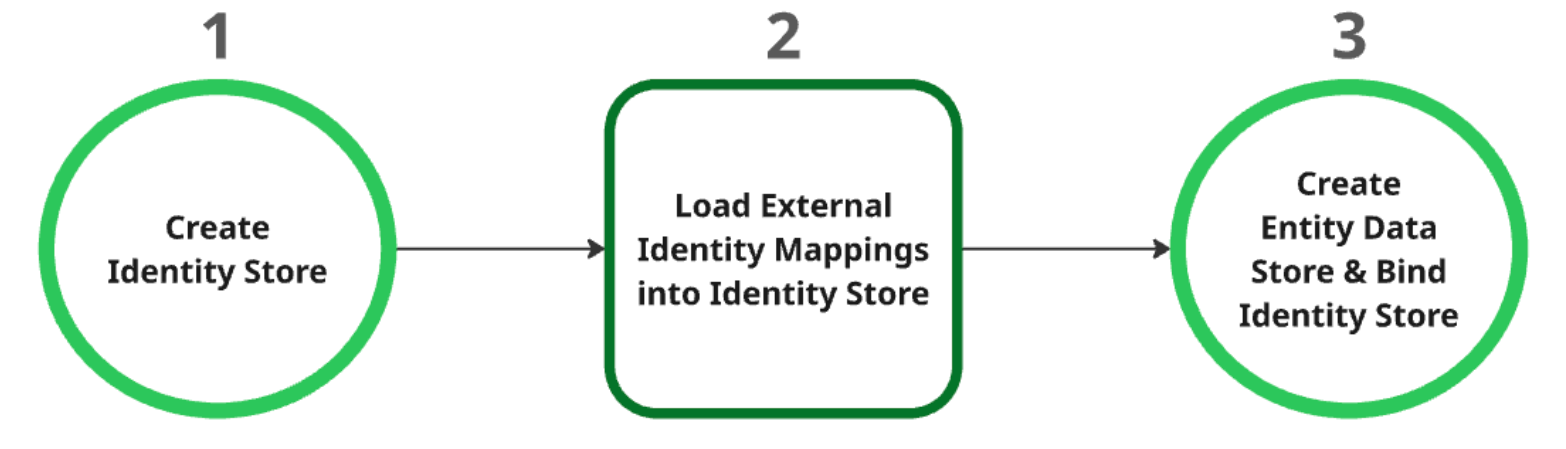
建立身分資訊儲存庫:這個儲存庫會做為所有身分對應關係的父項資源。建立後,系統會自動擷取專案層級的識別資訊提供者 (IDP) 設定。詳情請參閱「擷取或建立身分資訊儲存庫」。
將外部身分對應關係載入身分資訊儲存庫:建立身分資訊儲存庫後,請將外部身分資料載入其中。詳情請參閱「將身分對應關係擷取至身分資訊儲存庫」。
建立並繫結實體資料儲存庫:必須在成功建立身分資訊儲存庫並載入身分對應之後,才能建立實體資料儲存庫。建立實體資料儲存庫時,必須將身分資訊儲存庫繫結至該儲存庫。如要進一步瞭解如何建立實體資料儲存庫,請參閱「建立資料儲存庫」。
同步處理資料
同步處理資料有兩種不同的架構模型:
架構模型 1:遞增 upsert:遞增 upsert 方法最適合用於資料串流和需要即時更新的情境。連接器會運用 Discovery Engine API,在發生微幅變更時呼叫適當函式,有效率地執行增量 upsert (插入或更新資料)。這種做法著重於最小變更大小和最小延遲時間,即使資料快速變更,也能讓文件儲存庫保持最新狀態。
架構模型 2:與 Google Cloud Storage 全面同步:這是建議做法,提供一組完整的資料管理功能,且彈性極高。這項功能支援完整同步,可在整個資料集中插入、更新及刪除資料;也支援增量同步,只會傳送變更來處理插入和更新作業。因此,這種方法非常適合用於各種資料需求,尤其是管理大型或複雜的資料作業。這個模型會使用暫存程序 (圖中的步驟 1),連接器會先將資料寫入 Google Cloud Storage (GCS),然後透過 Discovery Engine API,從暫存的 GCS 位置呼叫必要的匯入函式,更新文件儲存庫。
自訂連接器相當靈活,可支援混合架構,讓您針對快速變化的資料執行漸進式 upsert,並針對排定的完整資料更新或刪除作業執行全面同步。