


Esta arquitectura de referencia proporciona un marco conceptual para implementar y operar bases de datos de Oracle autoadministradas en Google Distributed Cloud (GDC) aislado. Esta solución te permite mantener cargas de trabajo de bases de datos esenciales con el operador de bases de datos de Oracle para Kubernetes oficial en clústeres estándar.
La arquitectura se enfoca en habilitar un modelo de licencia adquirida por el usuario (BYOL), lo que te permite implementar bases de datos estandarizadas, seguras y con alta disponibilidad en entornos aislados. Abarca todo el ciclo de vida, desde el aprovisionamiento y las redes hasta las operaciones de nivel de producción, como la alta disponibilidad, la copia de seguridad, el restablecimiento y la observabilidad.
Características y funciones
La solución proporciona varios componentes funcionales principales para la administración de bases de datos:
- Administración automatizada del ciclo de vida: Usa el operador de base de datos de Oracle para automatizar el aprovisionamiento, la clonación, la aplicación de parches y la configuración de bases de datos de instancia única (SIDB).
- Alta disponibilidad: Compatibilidad integrada con Oracle Data Guard para proporcionar capacidades de replicación síncrona o asíncrona y conmutación por error automatizada. La alta disponibilidad se admite dentro de una sola zona.
- Integración del almacenamiento persistente: Usa sin problemas las clases de almacenamiento standard-rwo existentes de GDC para los archivos de base de datos para garantizar la durabilidad de los datos.
- Administración segura de imágenes: Compatibilidad con la duplicación de imágenes de contenedor de Oracle desde el Container Registry de Oracle hasta los registros locales de Harbor, incluido el análisis de vulnerabilidades integrado.
- Observabilidad unificada: Mecanismos integrados para exportar métricas de bases de datos a Prometheus y reenviar registros de alertas con patrones de archivo adicional.
- Herramientas de redes flexibles: Compatibilidad con balanceadores de cargas L4 internos y externos para exponer extremos de bases de datos de forma segura.
Principios de arquitectura
- Enfoque autoadministrado: Proporciona el marco de trabajo de la arquitectura para implementar y administrar cargas de trabajo de Oracle.
- Operaciones nativas de la nube: Usa el patrón de operador para administrar cargas de trabajo con estado, lo que garantiza la coherencia en diferentes entornos.
- Resiliencia adaptada a la base de datos: Prioriza la replicación a nivel de la base de datos (Data Guard) sobre la replicación a nivel de la infraestructura para garantizar la coherencia lógica y una recuperación más rápida.
- Diseño centrado en la seguridad: Se adhiere a los requisitos de aislamiento físico con el uso de registros locales, análisis de imágenes obligatorio y políticas de red explícitas para todo el tráfico de la base de datos.
Arquitectura
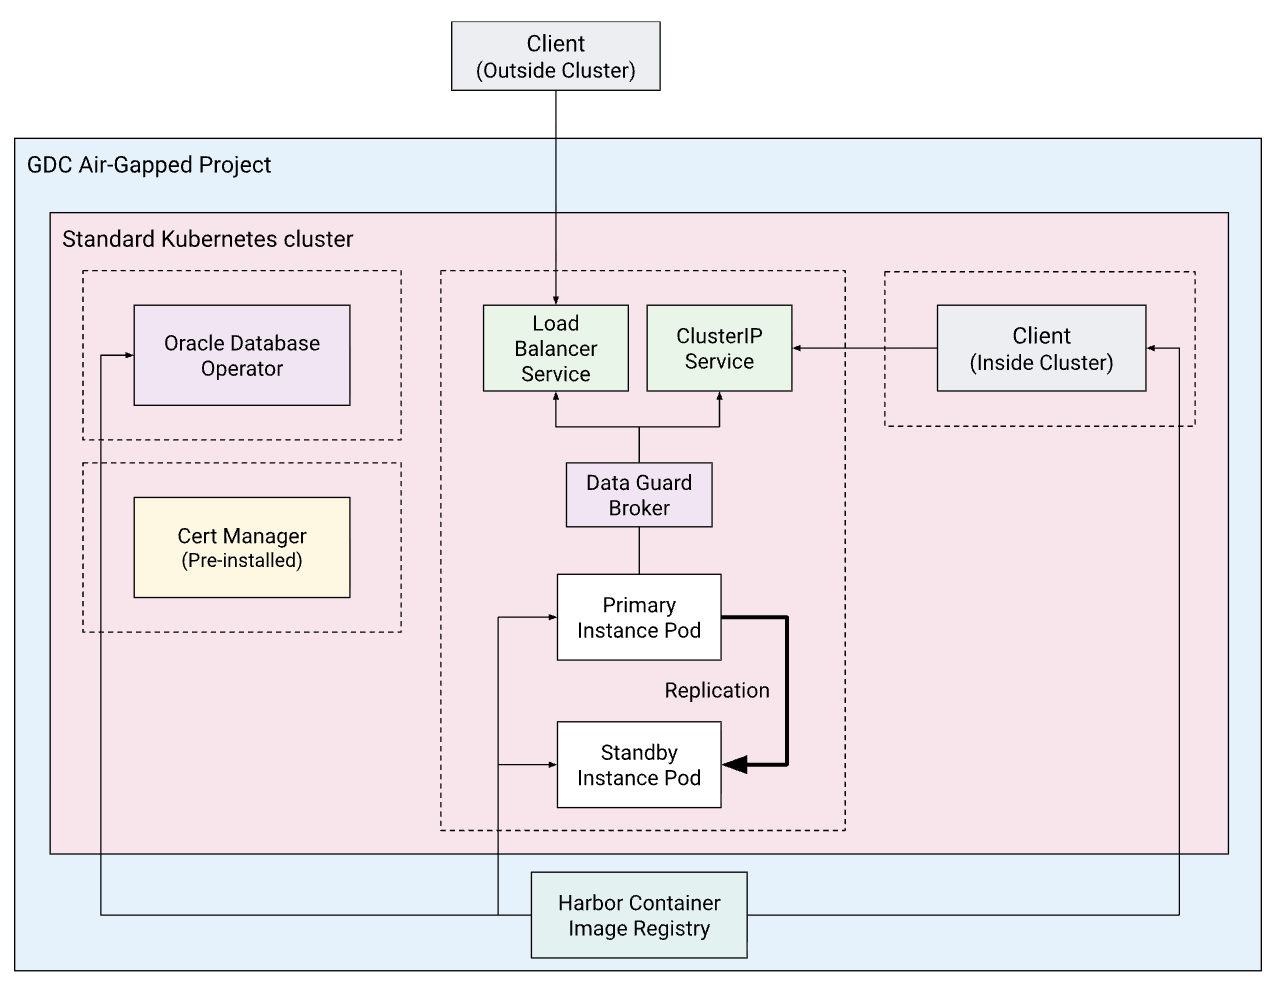
La arquitectura ilustra la relación entre el clúster de GDC estándar, el operador de base de datos de Oracle, los recursos de SIDB y la infraestructura de apoyo, como Harbor.
Conceptos y tecnologías
En esta sección, se detallan los componentes funcionales, sus responsabilidades y cómo se comunican dentro del sistema.
Infraestructura y plataforma
- Clúster estándar de GDC: Es el entorno de procesamiento principal en el que residen el operador de Oracle y los Pods de la base de datos.
- Registro de Harbor: Es la fuente de información local y segura para todas las imágenes de contenedor. Proporciona análisis automatizados para garantizar que las imágenes no tengan vulnerabilidades conocidas.
- Almacenamiento persistente: Las clases de almacenamiento standard-rwo de GDC proporcionan el almacenamiento en bloque subyacente necesario para los archivos de datos, los registros de rehacer y los archivos de control de Oracle con un PersistentVolumeClaim.
Servicios y lógica
- Oracle Database Operator: Es el controlador responsable de supervisar los recursos personalizados,
como
SingleInstanceDatabaseyDataguardBroker. Concilia estos objetos en objetos estándar de Kubernetes, incluidos StatefulSets para Pods de bases de datos y Services para redes. - Base de datos de instancia única (SIDB): Es una implementación alojada en contenedores que usa la arquitectura multiusuario de Oracle (CDB/PDB). Puedes implementar varias instancias de SIDB distintas o consolidar las cargas de trabajo creando varias bases de datos conectables (PDB) dentro de una sola SIDB.
- Data Guard Broker: Organiza las transiciones de roles entre las instancias principal y
en espera. Administra las etiquetas de rol de la base de datos, por ejemplo,
database.oracle.com/role: primary, que usan los servicios de Kubernetes para enrutar el tráfico de forma correcta después de una conmutación por error. - Balanceador de cargas de L4: Proporciona direcciones IP estables para la conectividad de la base de datos.
Flujo de datos e interfaces
- SQL*Net (puerto 1521): Es el protocolo principal para la conectividad de la aplicación.
- Exportador de observabilidad: Expone un extremo
/metricspara Prometheus. - Registros de alertas: Los registros de alertas de la base de datos estándar se envían a
stdoutpara que los recopile el agente de Logging de GDC. - Canales de RMAN: Los recursos de
CronJoblos usan para transmitir copias de seguridad al almacén de objetos compatible con S3.
Consideraciones
- Escalabilidad y rendimiento:
- Los nodos trabajadores deben tener un tamaño mínimo de 8 CPU virtuales y 32 GiB de RAM para las cargas de trabajo de producción.
- Usar
nodeSelectoro taints y tolerancias es una práctica recomendada para dedicar nodos específicos a las cargas de trabajo de la base de datos. - El rendimiento depende en gran medida del almacenamiento subyacente. Se recomienda usar
standard-rwocon IOPS altas.
- Administración de recursos y licencias:
- Esta solución sigue un modelo de licencia adquirida por el usuario (BYOL).
- Las funciones avanzadas, como la encriptación de datos transparente (TDE), la compresión avanzada y Active Data Guard (en espera de solo lectura), requieren licencias específicas de Enterprise Edition.
- La edición gratuita de Oracle Database se puede usar para el desarrollo y las pruebas.
- Disponibilidad y confiabilidad:
- La alta disponibilidad se logra a través de configuraciones de Data Guard de una sola zona, en las que las instancias principal y en espera residen en el mismo espacio de nombres.
- Usar un Service con un selector para la etiqueta de rol
primarygarantiza un redireccionamiento de clientes sin problemas durante la conmutación por error sin cambios del lado del cliente. - Para la protección de datos, la solución usa RMAN para las copias de seguridad en un bucket compatible con S3.
- Administración operativa:
- Si bien el operador simplifica la implementación, las operaciones diarias, como el ajuste y los restablecimientos complejos, siguen beneficiándose de la experiencia en administración de bases de datos.
- Se recomienda usar un contenedor sidecar para reenviar registros de seguimiento y auditoría detallados que no se envían a
stdout.
Decisión de diseño
Las principales opciones de arquitectura para esta solución se enfocan en equilibrar la automatización con las restricciones de un entorno aislado.
Data Guard frente a la replicación a nivel de almacenamiento
Data Guard es el mecanismo de alta disponibilidad porque reconoce la base de datos. Este enfoque protege contra la corrupción lógica y garantiza que no se pierdan datos en el modo de disponibilidad máxima, ya que valida los bloques antes de que se escriban en la base de datos en espera. Si bien esto requiere licencias adicionales para Enterprise Edition y más sobrecarga de configuración que las instantáneas de volumen, proporciona la coherencia necesaria para las cargas de trabajo de perfeccionamiento.
Administración de servicios para balanceadores de cargas
De forma predeterminada, configurar el parámetro loadBalancer: true en la
especificación SingleInstanceDatabase crea automáticamente un servicio de balanceador de cargas
externo. Para un balanceador de cargas interno, se debe crear un recurso de Service independiente de forma manual para incluir la anotación networking.gke.io/load-balancer-type: "internal" necesaria. Este enfoque manual
proporciona un control declarativo sobre las anotaciones y las etiquetas que el
servicio predeterminado administrado por el operador podría no exponer.
Estrategia de observabilidad de sidecars para registros
En la solución, se recomienda usar contenedores sidecar para el reenvío de registros. Esto desvincula la recopilación de registros del proceso principal de la base de datos, lo que garantiza que el gran volumen de registros no afecte el rendimiento de la base de datos. Si bien esto aumenta la huella de recursos por pod de base de datos, garantiza una recopilación de telemetría confiable sin afectar la estabilidad de la base de datos.
Suposiciones y limitaciones
Suposiciones
- El entorno tiene una instancia de Harbor preconfigurada y accesible para el alojamiento de imágenes.
- Cert-manager viene preinstalado en el clúster estándar para controlar los certificados de webhook del operador.
- Hay un almacén de objetos compatible con S3 disponible para los destinos de copia de seguridad de RMAN.
Limitaciones
- HA de zona única: Se admiten las configuraciones de alta disponibilidad dentro de una sola zona.
- No Oracle RAC: No se incluye la compatibilidad con Real Application Clusters (RAC). La solución se enfoca en Single Instance y Data Guard.
- Solo clústeres estándar: La solución se valida para los clústeres estándar de GDC y no es compatible con los clústeres de usuario compartidos.
¿Qué sigue?
- Implementa bases de datos de Oracle autoadministradas
- Implementa bases de datos de Oracle autoadministradas con alta disponibilidad