


Questa guida ti aiuta a valutare i requisiti di archiviazione del tuo carico di lavoro cloud, a comprendere le opzioni di archiviazione disponibili in Google Cloude a progettare una strategia di archiviazione che offra un valore tecnico e commerciale ottimale.
Per informazioni sulla selezione dei servizi di archiviazione per i workload AI e ML, vedi Panoramica dei servizi di archiviazione per i workload AI e ML in AI Hypercomputer.
Panoramica del processo di progettazione
In qualità di cloud architect, quando pianifichi l'archiviazione per un carico di lavoro cloud, devi prima considerare le caratteristiche funzionali del carico di lavoro, i vincoli di sicurezza, i requisiti di resilienza, le aspettative di prestazioni e gli obiettivi di costo. Poi, devi esaminare i servizi e le funzionalità di archiviazione disponibili in Google Cloud. In base ai tuoi requisiti e alle opzioni disponibili, seleziona i servizi e le funzionalità di archiviazione di cui hai bisogno. Il seguente diagramma mostra questo processo di progettazione in tre fasi:
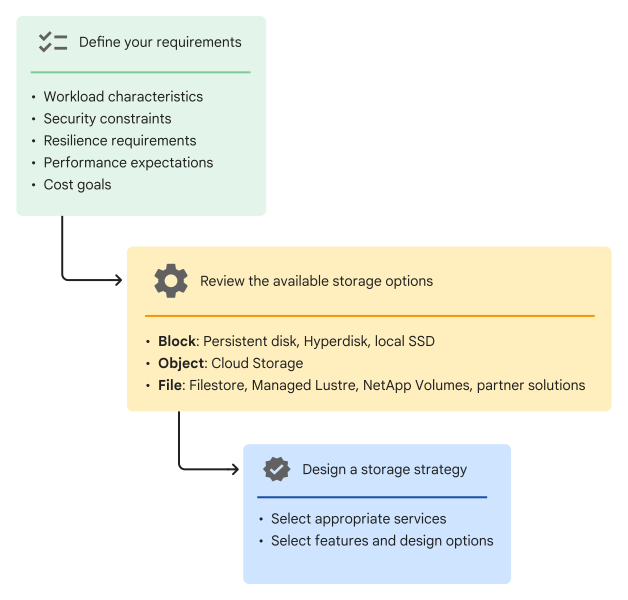
Definisci i requisiti
Utilizza i questionari in questa sezione per definire i requisiti di archiviazione chiave del carico di lavoro che vuoi implementare in Google Cloud.
Linee guida per la definizione dei requisiti di spazio di archiviazione
Quando rispondi ai questionari, tieni presente le seguenti linee guida:
Definisci i requisiti in modo granulare
Ad esempio, se la tua applicazione ha bisogno di uno spazio di archiviazione basato su Network File System (NFS), identifica la versione NFS richiesta.
Considerare i requisiti futuri
Ad esempio, la tua attuale implementazione potrebbe servire utenti in paesi dell'Asia, ma potresti pianificare di espandere l'attività ad altri continenti. In questo caso, considera i requisiti normativi relativi allo spazio di archiviazione dei nuovi territori aziendali.
Considera le opportunità e i requisiti specifici per il cloud
Sfrutta le opportunità specifiche del cloud.
Ad esempio, per ottimizzare i costi di archiviazione dei dati archiviati in Cloud Storage, puoi controllare la durata dell'archiviazione utilizzando le norme di conservazione dei dati e le configurazioni del ciclo di vita.
Considera i requisiti specifici del cloud.
Ad esempio, i dati on-premise potrebbero esistere in un unico data center e potresti dover replicare i dati migrati in due Google Cloud posizioni per la ridondanza.
Questionari
I questionari che seguono non sono elenchi di controllo esaustivi per la pianificazione. Utilizzali come punto di partenza per analizzare sistematicamente tutti i requisiti di archiviazione del workload che vuoi implementare in Google Cloud.
Valuta le caratteristiche del tuo workload
Che tipo di dati devi archiviare?
Esempi
- Contenuti del sito web statico
- Backup e archivi per il ripristino di emergenza
- Audit log per la conformità
- Oggetti di dati di grandi dimensioni che gli utenti scaricano direttamente
- Dati transazionali
- Dati non strutturati ed eterogenei
Di quanta capacità hai bisogno? Considera i tuoi requisiti attuali e futuri.
La capacità deve essere scalata automaticamente in base all'utilizzo?
Quali sono i requisiti di accesso? Ad esempio, i dati devono essere accessibili dall'esterno Google Cloud?
Quali sono i pattern di lettura/scrittura previsti?
Esempi
- Scritture e letture frequenti
- Scritture frequenti, ma letture occasionali
- Scritture e letture occasionali
- Scritture occasionali, ma letture frequenti
Il workload richiede l'accesso basato su file, ad esempio tramite NFS?
Più client devono essere in grado di leggere o scrivere dati contemporaneamente?
Identificare i vincoli di sicurezza
Quali sono i tuoi requisiti di crittografia dei dati? Ad esempio, devi utilizzare chiavi che controlli?
Esistono requisiti di residenza dei dati?
Definisci i requisiti di resilienza dei dati
- Il tuo workload ha bisogno di una memorizzazione nella cache a bassa latenza o di uno spazio di lavoro?
- Hai bisogno di replicare i dati nel cloud per la ridondanza?
- Hai bisogno di una coerenza di lettura/scrittura rigorosa per i set di dati replicati?
Definisci le aspettative di rendimento
Qual è la velocità di I/O richiesta?
Di quali livelli di throughput di lettura e scrittura ha bisogno la tua applicazione?
Per quali ambienti hai bisogno di spazio di archiviazione? Per un determinato carico di lavoro, potresti aver bisogno di spazio di archiviazione ad alte prestazioni per l'ambiente di produzione, ma potresti scegliere un'opzione a prestazioni inferiori per gli ambienti non di produzione.
Esamina le opzioni di archiviazione
Google Cloud offre servizi di archiviazione per tutti i formati di archiviazione chiave: a blocchi, di file e di oggetti. Esamina e valuta le funzionalità, le opzioni di progettazione e i vantaggi relativi dei servizi disponibili per ogni formato di archiviazione.
Panoramica
Archiviazione a blocchi
I dati archiviati nell'archiviazione a blocchi sono suddivisi in blocchi, ognuno memorizzato come blocco separato con un indirizzo univoco. Le applicazioni accedono ai dati facendo riferimento agli indirizzi dei blocchi appropriati. L'archiviazione a blocchi è ottimizzata per i workload con IOPS elevati, come l'elaborazione delle transazioni. È simile ai sistemi SAN (Storage Area Network) e DAS (Directly Attached Storage) on-premise.
Le opzioni di archiviazione a blocchi in Google Cloud fanno parte del servizio Compute Engine.
| Opzione | Panoramica |
|---|---|
| Persistent Disk | Unità disco rigido (HDD) e unità a stato solido (SSD) dedicate per applicazioni aziendali e di database di cui è stato eseguito il deployment su VM di Compute Engine e cluster Google Kubernetes Engine (GKE). |
| Google Cloud Hyperdisk | Spazio di archiviazione di rete veloce e ridondante per le VM Compute Engine e i cluster GKE, con capacità aumentabile in modo dinamico e prestazioni configurabili. |
| SSD locale | Archiviazione a blocchi temporanea collegata in locale per applicazioni ad alte prestazioni. |
Archiviazione di file
I dati sono organizzati e rappresentati in una gerarchia di file archiviati in cartelle, in modo simile all'archiviazione NAS (Network Attached Storage) on-premise. I file system possono essere montati sui client utilizzando protocolli come NFS e Server Message Block (SMB). Le applicazioni accedono ai dati utilizzando il nome file e il percorso della directory pertinenti.
Google Cloud offre una gamma di soluzioni completamente gestite per l'archiviazione di file.
| Soluzione | Panoramica |
|---|---|
| Filestore |
Archiviazione basata su file che utilizza file server NFS per VM Compute Engine e cluster GKE. |
| Google Cloud Managed Lustre |
File system parallelo a bassa latenza per AI, computing ad alte prestazioni (HPC) e applicazioni ad alta intensità di dati. |
| Google Cloud NetApp Volumes | Archiviazione basata su file che utilizza i protocolli NFS, SMB o di archiviazione a blocchi. |
Archiviazione di oggetti
I dati vengono archiviati come oggetti in una gerarchia piatta di bucket. A ogni oggetto viene assegnato un ID univoco globale. Gli oggetti possono avere metadati assegnati dal sistema e definiti dall'utente, per aiutarti a organizzare e gestire i dati. Le applicazioni accedono ai dati facendo riferimento agli ID oggetto, utilizzando le API REST o le librerie client.
Cloud Storage offre un'archiviazione di oggetti a basso costo, altamente durevole e scalabile per diversi tipi di dati. I dati archiviati in Cloud Storage sono accessibili ovunque, all'interno e all'esterno Google Cloud. La ridondanza facoltativa tra le regioni offre alta affidabilità e affidabilità. Puoi selezionare una classe di archiviazione adatta ai tuoi requisiti di conservazione dei dati e frequenza di accesso.
Analisi comparativa
La tabella seguente elenca le funzionalità chiave dei servizi di archiviazione in Google Cloud.
| Persistent Disk | Hyperdisk | SSD locale | Filestore | Managed Lustre | NetApp Volumes | Cloud Storage | |
|---|---|---|---|---|---|---|---|
| Limite di capacità |
64 TiB per disco e 257 TiB per VM. Ultime specifiche: Documentazione di Persistent Disk |
64 TiB per disco, 512 TiB per VM e 5 PiB per pool di archiviazione. Exapools sono pool Hyperdisk con capacità maggiore. Ultime specifiche: Documentazione di Hyperdisk |
375 GiB per disco e 12.000 GiB per VM. I dischi Titanium SSD supportano fino a 6 TiB per disco e 84.000 GiB per VM. Specifiche più recenti: Documentazione SSD locale |
100 TiB per istanza, a seconda del livello di servizio. | 80,1 PiB per istanza, a seconda del livello di rendimento. |
20 PiB per pool di archiviazione e 20 PiB per volume. Ultime specifiche: Documentazione di NetApp Volumes |
5 TiB per oggetto, senza limiti per bucket (tranne Rapid Bucket). Ultime specifiche: Documentazione di Cloud Storage |
|
Scalabilità |
|
|
Non scalabile | Scalabilità verticale (livelli zonale e regionale) | Scale up | Scale up e scale down | Scalabilità automatica in base all'utilizzo |
| Condivisione |
Supportato | Supportato | Non condivisibile | Montabile su più VM di Compute Engine, client remoti e cluster GKE | Montabile su più VM Compute Engine e cluster GKE | Montabile su più VM di Compute Engine, client remoti e cluster GKE |
|
| Opzioni di chiave di crittografia |
|
|
Google-owned and Google-managed encryption keys |
|
|
|
|
| Persistenza |
Durata del disco | Durata del disco | Temporaneo (i dati vengono persi quando la VM viene arrestata o eliminata) | Durata dell'istanza Filestore | Durata dell'istanza Managed Lustre | Durata del volume | Durata del bucket |
| Disponibilità |
|
|
A livello di zona | A livello di zona |
|
| |
| Prestazioni |
Scalabilità lineare in base alle dimensioni del disco e al numero di CPU | Scalabilità dinamica archiviazione permanente | Spazio di archiviazione scratch ad alte prestazioni | A livello di zona e regionale: Prestazioni personalizzate | Scalabilità in base al livello di rendimento selezionato. | Prestazioni scalabili Le aspettative dipendono dal livello di servizio. |
|
| Gestione |
Formattazione e montaggio manuali | Formattazione e montaggio manuali | Formatta, esegui lo striping e monta manualmente | Completamente gestito | Completamente gestito | Completamente gestito | Completamente gestito |
La tabella seguente elenca i tipi di workload per cui è adatta ogni Google Cloud opzione di archiviazione:
| Opzione di archiviazione | Tipi di workload |
|---|---|
| Hyperdisk o Persistent Disk |
|
| SSD locale |
|
| Filestore |
|
| Managed Lustre |
|
| NetApp Volumes |
|
| Cloud Storage |
|
Scegliere un'opzione di archiviazione
La selezione di un'opzione di archiviazione è composta da due parti:
- Decidere quali servizi di archiviazione ti servono.
- Scelta delle funzionalità e delle opzioni di progettazione richieste in un determinato servizio.
Esempi di funzionalità e opzioni di progettazione specifiche del servizio
Persistent Disk
- Regione e zona di deployment
- Replica regionale
- Tipo, dimensioni e IOPS del disco (per il disco permanente con carico estremo)
- Chiavi di crittografia: Google-owned and Google-managed encryption keyso gestite dal cliente
- Pianificazione snapshot
Hyperdisk
- Regione e zona di deployment
- Tipo, dimensioni e IOPS o throughput sottoposti a provisioning del disco
- Chiavi di crittografia: Google-owned and Google-managed encryption keyso gestite dal cliente
- Replica: sincrona o asincrona
- Pianificazione snapshot
Filestore
- Regione e zona di deployment
- Livello istanza
- Capacità
- Intervallo IP: allocato automaticamente o personalizzato
- Controllo degli accessi
Managed Lustre
- Zona di deployment
- Livello di capacità e prestazioni
- Chiavi di crittografia: Google-owned and Google-managed encryption keyso gestite dal cliente
NetApp Volumes
- Regione di deployment
- Livello di servizio per il pool di archiviazione
- Capacità del pool e del volume
- Protocollo del volume
- Regole di esportazione del volume
Cloud Storage
- Località: multiregionale, a due regioni, singola regione, singola zona
- Classe di archiviazione: Standard, Nearline, Coldline, Archive o Rapid
- Controllo dell'accesso: uniforme o granulare
- Chiavi di crittografia: Google-owned and Google-managed encryption keys, gestite dal cliente o fornite dal cliente
- Criterio di conservazione
Suggerimenti per lo spazio di archiviazione
Utilizza i seguenti consigli come punto di partenza per scegliere i servizi e le funzionalità di archiviazione che soddisfano i tuoi requisiti. Per indicazioni specifiche per i workload di AI e ML, consulta Panoramica dei servizi di archiviazione per i workload di AI e ML in AI Hypercomputer.
Per le applicazioni AI, ML e HPC che richiedono un file system parallelo, utilizza Managed Lustre.
Per le applicazioni che richiedono l'accesso basato su file, scegli un servizio di archiviazione di file adatto in base ai tuoi requisiti per protocollo di accesso, disponibilità e prestazioni.
Protocollo di accesso Suggerimento NFS - Se hai bisogno di disponibilità regionale e prestazioni elevate configurabili, utilizza Filestore Regional o NetApp Volumes Flex Unified.
- Se la disponibilità a livello di zona è sufficiente:
- Per configurare le prestazioni indipendentemente dalla capacità, utilizza Filestore zonale o NetApp Volumes Flex Unified.
- Per prestazioni scalabili in base alla capacità, utilizza Filestore Zonal o NetApp Volumes Standard, Premium o Extreme.
Per saperne di più, consulta Livelli di servizio Filestore e Livelli di servizio NetApp Volumes.
SMB Utilizza NetApp Volumes. Per i workload che richiedono spazio di archiviazione primario con prestazioni elevate, utilizza Hyperdisk, SSD locale o Persistent Disk a seconda dei tuoi requisiti.
Requisito Suggerimento Disco temporaneo o cache rapida Utilizza i dischi SSD locali (temporanei). Archiviazione a blocchi con prestazioni e capacità scalabili in modo indipendente Utilizza Hyperdisk, l'archiviazione a blocchi durevole consigliata da Google e richiesta per le serie di macchine più recenti. Scegli un tipo di disco appropriato in base ai tuoi requisiti:
- Carichi di lavoro per uso generico:
hyperdisk-balanced - Workload con I/O elevato, come database ad alte prestazioni:
hyperdisk-extreme - Analisi dello scale out, unità di dati per app sensibili ai costi e spazio di archiviazione
inattivo:
hyperdisk-throughput - Carichi di lavoro ML che richiedono un throughput elevato a più VM in modalità di sola lettura:
hyperdisk-mlin modalità di sola lettura - Più VM con accesso in scrittura simultaneo allo stesso disco:
hyperdisk-balanced-high-availability(in due zone di una regione) ohyperdisk-balancedohyperdisk-extreme(all'interno di una singola zona) in modalità multi-writer
Per saperne di più, consulta Informazioni su Hyperdisk.
Archiviazione a blocchi con capacità scalabile per VM di generazioni precedenti Utilizza Persistent Disk. Scegli un tipo di disco appropriato in base ai tuoi requisiti:
- IOPS sequenziali:
pd-standard - Workload ad alta intensità di IOPS:
pd-extremeopd-ssd - Equilibrio tra rendimento e costi:
pd-balanced
Per saperne di più, consulta la sezione Informazioni su Persistent Disk.
- A seconda dei requisiti di ridondanza, scegli tra dischi a livello di zona e
di regione.
Requisito Suggerimento Ridondanza all'interno di una singola zona in una regione Utilizza Hyperdisk o Persistent Disk a livello di zona. Ridondanza in più zone all'interno di una regione Utilizza Hyperdisk Balanced High Availability o Persistent Disk a livello regionale.
- Carichi di lavoro per uso generico:
Per l'archiviazione su larga scala e disponibile a livello globale, utilizza Cloud Storage.
A seconda della frequenza di accesso ai dati e della durata dell'archiviazione, scegli una classe di archiviazione di Cloud Storage adatta.
Requisito Suggerimento La frequenza di accesso varia o il periodo di conservazione dei dati è sconosciuto o non prevedibile. Utilizza la funzionalità Autoclass per trasferire automaticamente gli oggetti di un bucket alle classi di archiviazione appropriate in base al pattern di accesso di ciascun oggetto. Archiviazione a livello di zona per i workload che richiedono una latenza inferiore al millisecondo e un throughput elevato, come addestramento, checkpointing, inferenza e analisi AI e ML. Utilizza un Rapid Bucket con la classe di archiviazione Rapid. Archiviazione per i dati ad accesso frequente, inclusi quelli per analisi ad alto rendimento, data lake, siti web, video in streaming e app mobile. Utilizza la classe di archiviazione Standard.
Per memorizzare nella cache i dati a cui si accede di frequente e pubblicarli da località vicine ai client, utilizza Cloud CDN.
Per i workload con molte letture e modifiche dei dati poco frequenti e letture frequenti (come l'addestramento, l'inferenza e l'analisi ML), puoi migliorare le prestazioni di lettura e ridurre i costi di trasferimento dei dati utilizzando Rapid Cache.
Archiviazione a basso costo per dati ad accesso non frequente che possono essere archiviati per almeno 30 giorni (ad esempio, backup e contenuti multimediali long-tail). Utilizza la classe di archiviazione Nearline. Archiviazione a basso costo per dati ad accesso non frequente che possono essere archiviati per almeno 90 giorni (ad esempio, ripristino di emergenza). Utilizza la classe di archiviazione Coldline. Archiviazione al costo più basso per i dati ad accesso non frequente che possono essere archiviati per almeno 365 giorni, inclusi gli archivi normativi. Utilizza la classe di archiviazione Archive. Per un'analisi comparativa dettagliata, consulta Classi di Cloud Storage.
Opzioni di trasferimento dei dati
Dopo aver scelto i servizi di archiviazione Google Cloud appropriati, per eseguire il deployment e l'esecuzione dei carichi di lavoro, devi trasferire i dati su Google Cloud. I dati che devi trasferire potrebbero esistere on-premise o su altre piattaforme cloud.
Puoi utilizzare i seguenti metodi per trasferire i dati a Google Cloud:
- Trasferisci i dati online utilizzando Storage Transfer Service: Automatizza il trasferimento di grandi quantità di dati tra sistemi di archiviazione di oggetti e file, tra cui Cloud Storage, Amazon S3, servizi di archiviazione Azure e origini dati on-premise.
- Trasferisci i dati offline utilizzando Transfer Appliance: trasferisci e carica grandi quantità di dati offline su Google Cloud in situazioni in cui la connettività di rete e la larghezza di banda non sono disponibili, sono limitate o costose.
- Carica i dati in Cloud Storage: carica i dati online nei bucket Cloud Storage utilizzando la console Google Cloud , Google Cloud CLI, l'API Storage di Cloud Storage o le librerie client.
Quando scegli un metodo di trasferimento dei dati, considera fattori quali le dimensioni dei dati, i vincoli di tempo, la disponibilità di larghezza di banda, gli obiettivi di costo e i requisiti di sicurezza e conformità. Per informazioni sulla pianificazione e l'implementazione dei trasferimenti di dati a Google Cloud, consulta Opzioni di trasferimento dei dati.
Passaggi successivi
- Stima il costo dello spazio di archiviazione utilizzando il Google Cloud Calcolatore prezzi.
- Scopri le best practice per creare una topologia cloud ottimizzata per sicurezza, resilienza, costi e prestazioni.
- Per ulteriori architetture di riferimento, diagrammi e best practice, esplora Cloud Architecture Center.
Collaboratori
Autore: Kumar Dhanagopal | Cross-Product Solution Developer
Altri collaboratori:
- Brennan Doyle | Solutions Architect
- Dean Hildebrand | Technical Director, Office of the CTO
- Geoffrey Noer | Group Product Manager
- Jack Zhou | Technical Writer
- Jason Wu | Director, Product Management
- Jeff Allen | Solutions Architect
- Samantha He | Technical Writer
- Sean Derrington | Group Product Manager, Storage