


Dokumen ini menyediakan arsitektur referensi yang dapat Anda gunakan untuk mendesain infrastruktur guna menjalankan aplikasi artificial intelligence (AI) generatif dengan retrieval-augmented generation (RAG). Audiens yang dituju untuk dokumen ini mencakup developer dan administrator aplikasi AI generatif serta cloud architect. Dokumen ini mengasumsikan pemahaman dasar tentang konsep AI, machine learning (ML), dan model bahasa besar (LLM). Dokumen ini tidak memberikan panduan tentang cara mendesain dan mengembangkan aplikasi AI generatif.
Arsitektur
Diagram berikut menunjukkan tampilan tingkat tinggi arsitektur untuk aplikasi AI generatif berkemampuan RAG di Google Cloud:

Arsitektur ini berisi komponen yang saling terhubung berikut:
- Subsistem penyerapan data
- Subsistem penyerapan data menyiapkan dan memproses data eksternal yang digunakan untuk mengaktifkan kemampuan RAG. Subsistem ini berinteraksi dengan subsistem lain dalam arsitektur melalui lapisan database.
- Subsistem inferensi
- Subsistem inferensi menangani aliran permintaan-respons antara aplikasi AI generatif dan penggunanya. Subsistem ini berinteraksi dengan subsistem penyerapan data melalui lapisan database.
- Subsistem evaluasi kualitas
- Subsistem evaluasi kualitas mengevaluasi kualitas respons yang dihasilkan oleh subsistem inferensi. Subsistem ini berinteraksi dengan subsistem inferensi secara langsung dan dengan subsistem penyerapan data melalui lapisan database.
- Database
Semua subsistem dalam arsitektur berinteraksi dengan database. Database menyimpan data berikut:
- Perintah
- Embedding vektor dari data yang digunakan untuk RAG
- Konfigurasi fungsi serverless dalam subsistem penyerapan data dan evaluasi kualitas
Diagram berikut menunjukkan tampilan mendetail arsitektur:
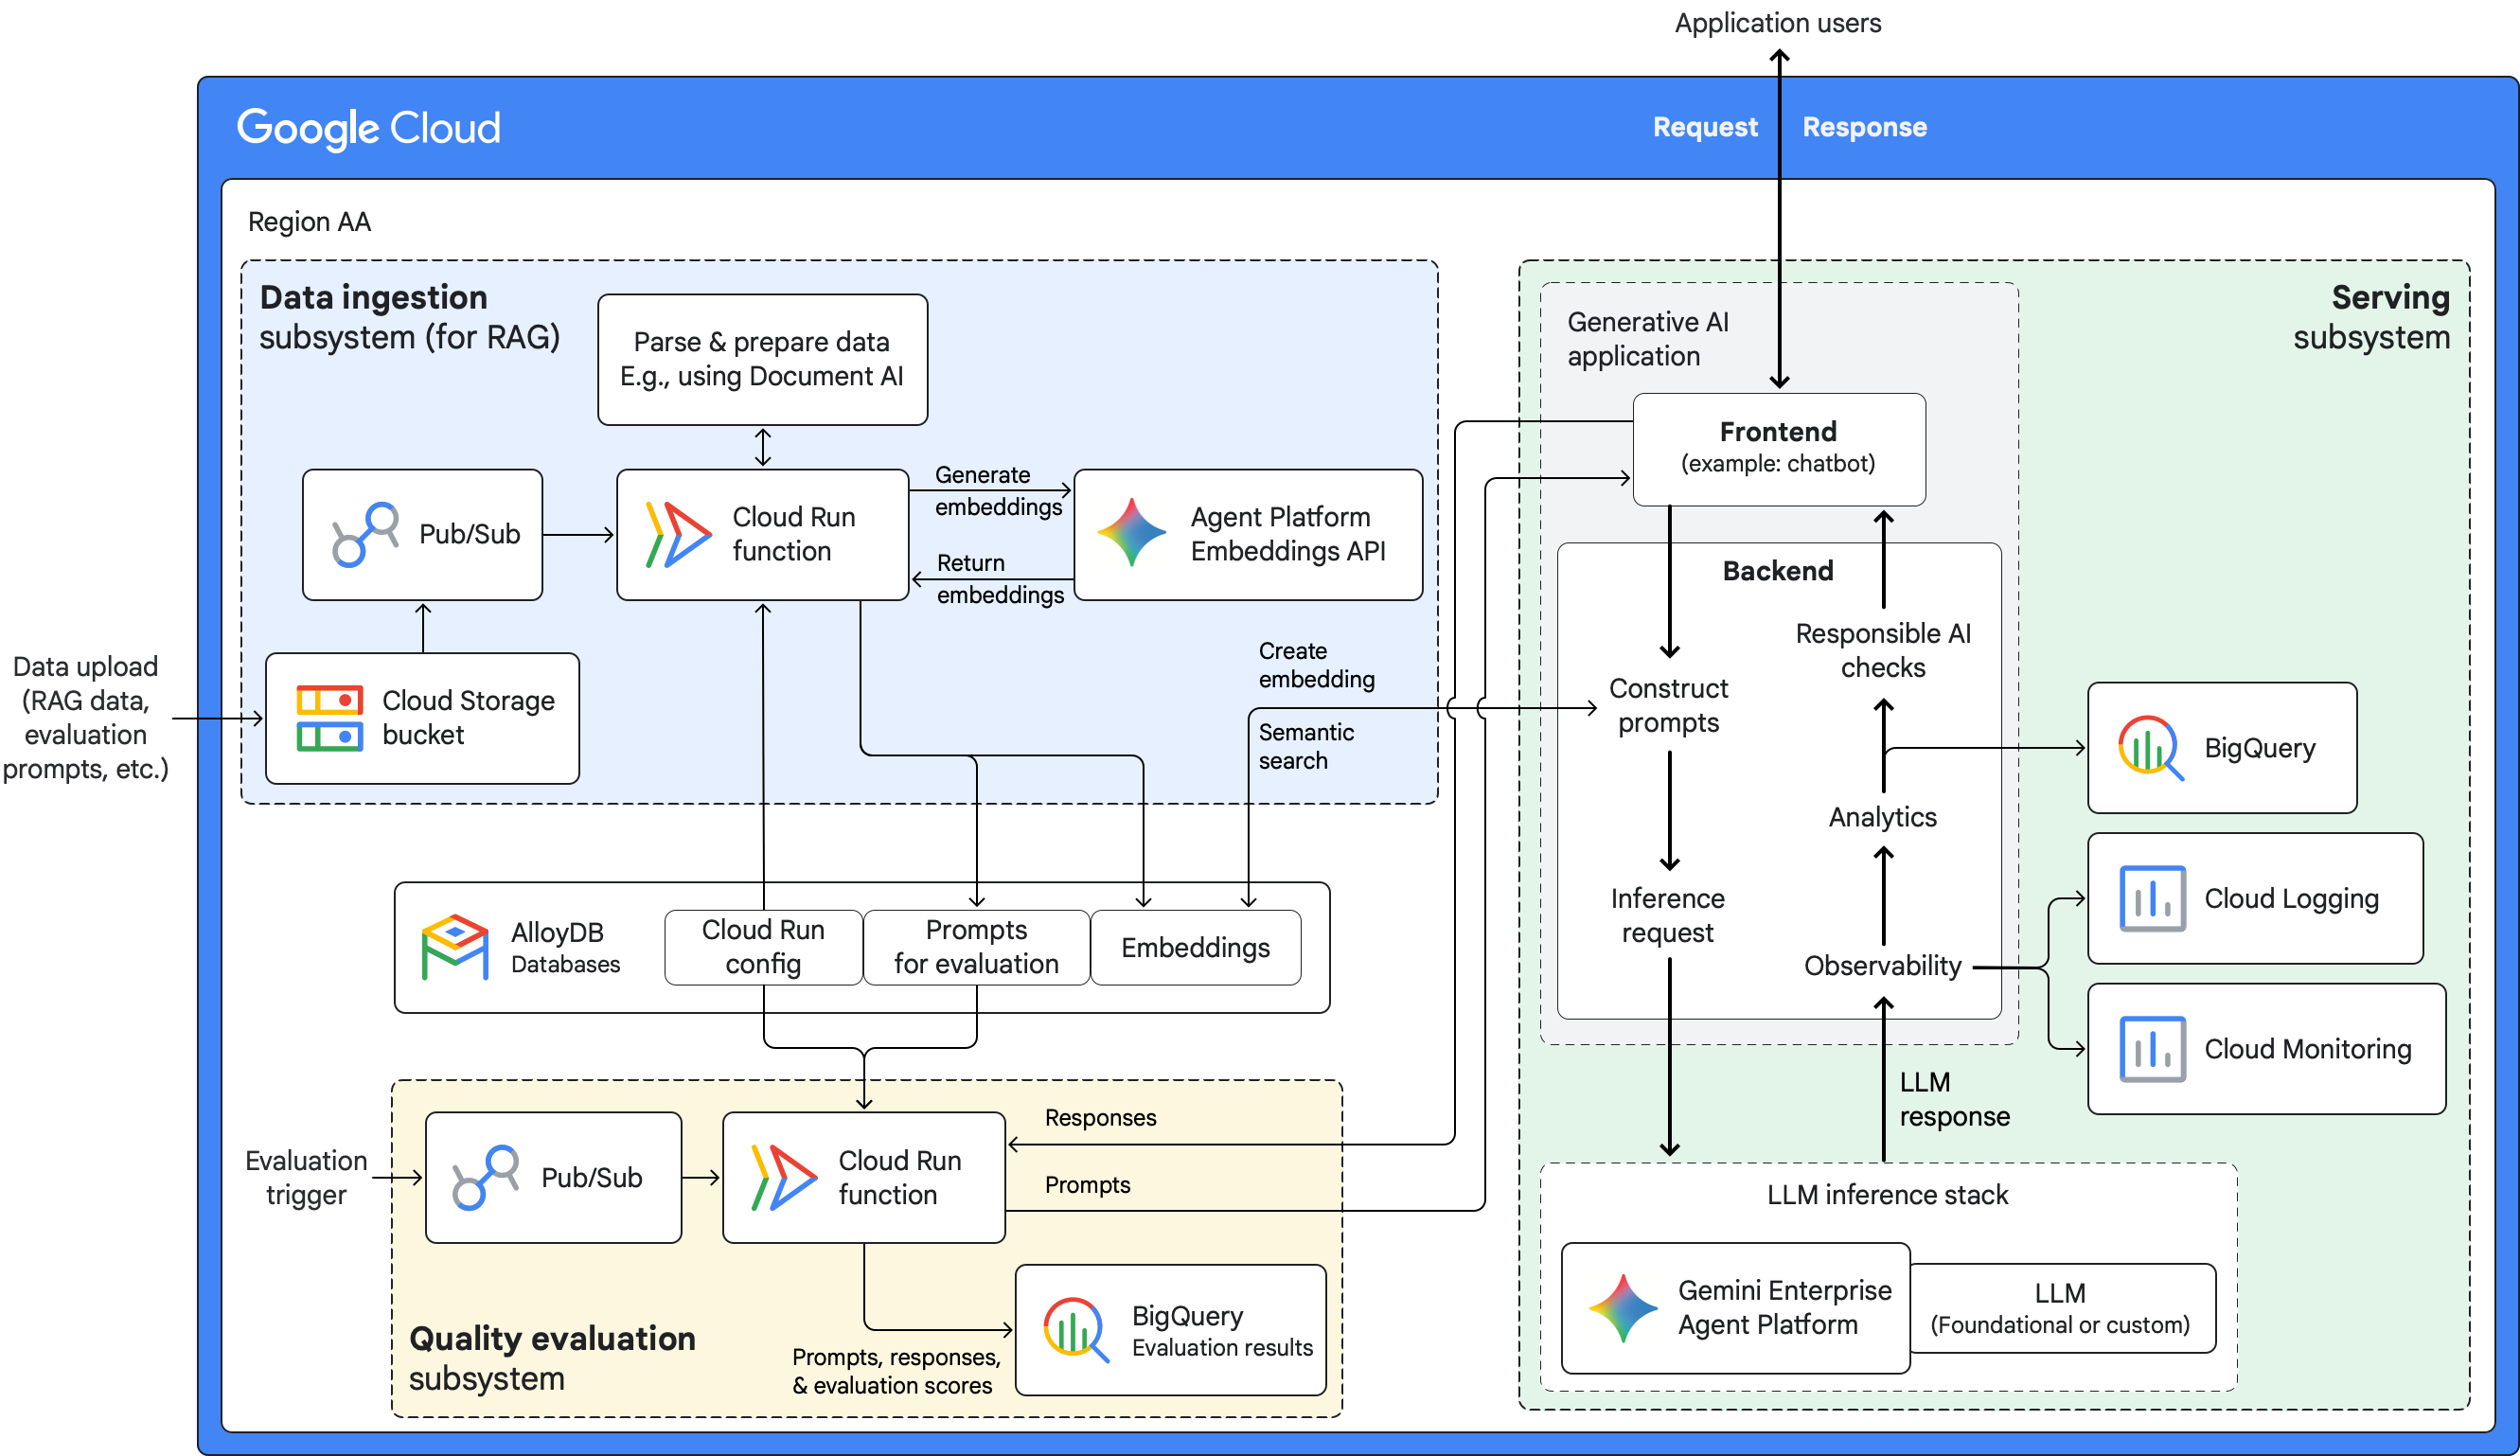
Bagian berikut memberikan deskripsi mendetail terkait komponen dan aliran data dalam tiap subsistem arsitektur.
Subsistem penyerapan data
Subsistem penyerapan data yang menyerap data dari sumber eksternal seperti file, database, dan layanan streaming. Data yang diupload mencakup petunjuk untuk evaluasi kualitas. Subsistem penyerapan data memberikan kemampuan RAG dalam arsitektur. Diagram berikut menunjukkan detail subsistem penyerapan data dalam arsitektur:
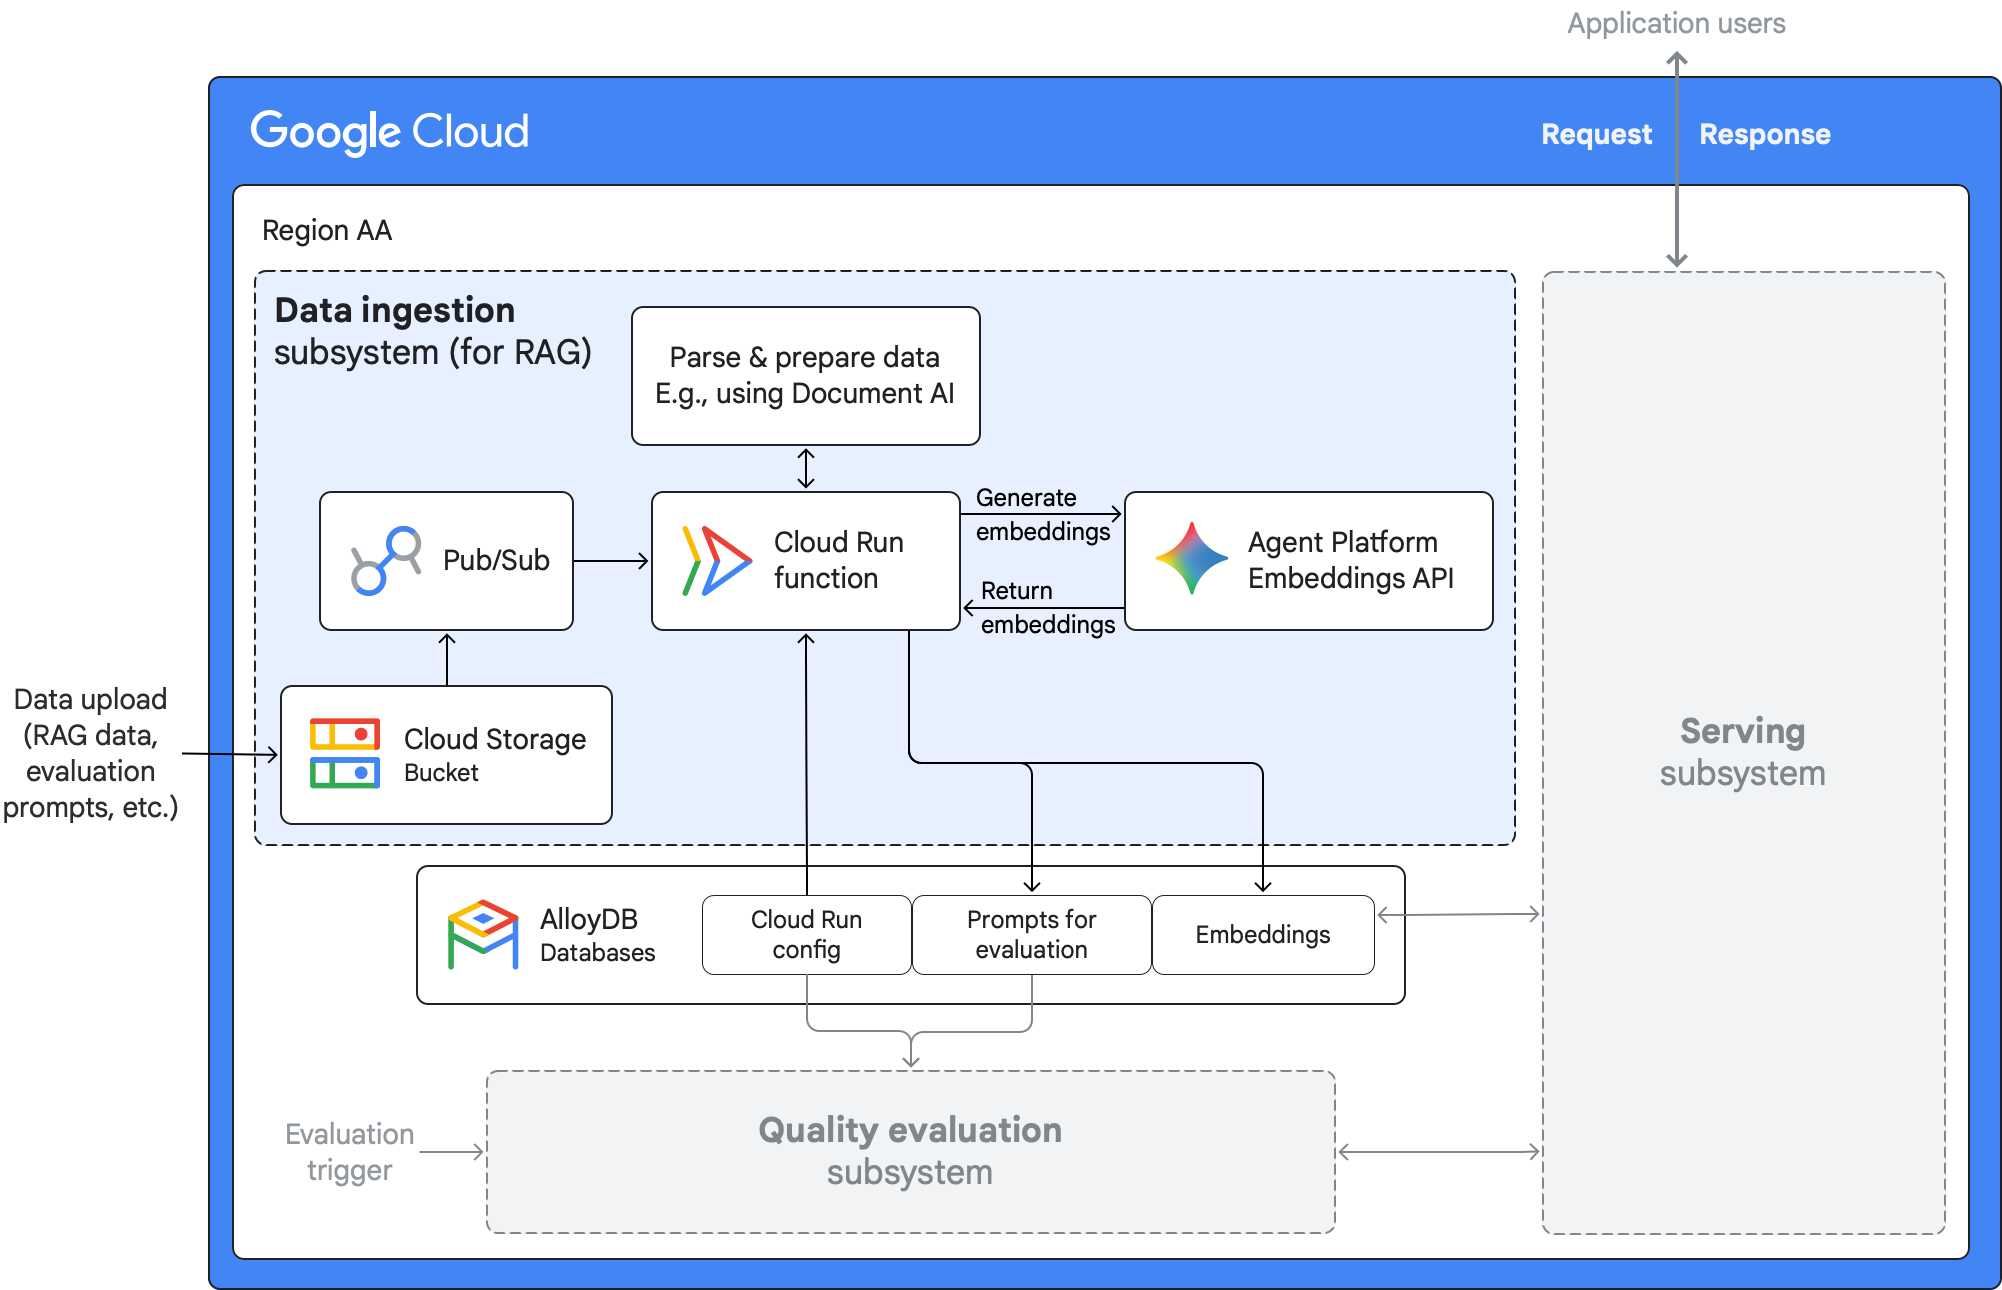
Berikut adalah langkah-langkah dalam alur penyerapan data:
- Data diupload ke bucket Cloud Storage. Sumber data dapat berupa aplikasi, database, atau layanan streaming.
- Saat data diupload ke Cloud Storage, pesan akan dipublikasikan ke topik Pub/Sub.
- Pub/Sub memicu fungsi Cloud Run untuk memproses data yang diupload.
- Fungsi ini dimulai menggunakan data konfigurasi yang disimpan dalam database AlloyDB untuk PostgreSQL.
- Fungsi ini mengurai data mentah, memformatnya sesuai kebutuhan, lalu membaginya menjadi beberapa bagian.
Fungsi ini menggunakan model embedding yang sesuai di Gemini Enterprise Agent Platform untuk membuat embedding vektor dari data yang diserap.
Fungsi ini menyimpan embedding dalam database AlloyDB yang mengaktifkan ekstensi
vectoryang kompatibel denganpgvector. Seperti yang dijelaskan di bagian berikut, saat subsistem inferensi memproses permintaan pengguna, subsistem ini akan menggunakan embedding dalam database vektor untuk mengambil data spesifik domain yang relevan.
Subsistem inferensi
Subsistem inferensi menangani aliran permintaan-respons antara aplikasi AI generatif dan penggunanya. Diagram berikut menunjukkan detail subsistem penyajian dalam arsitektur:
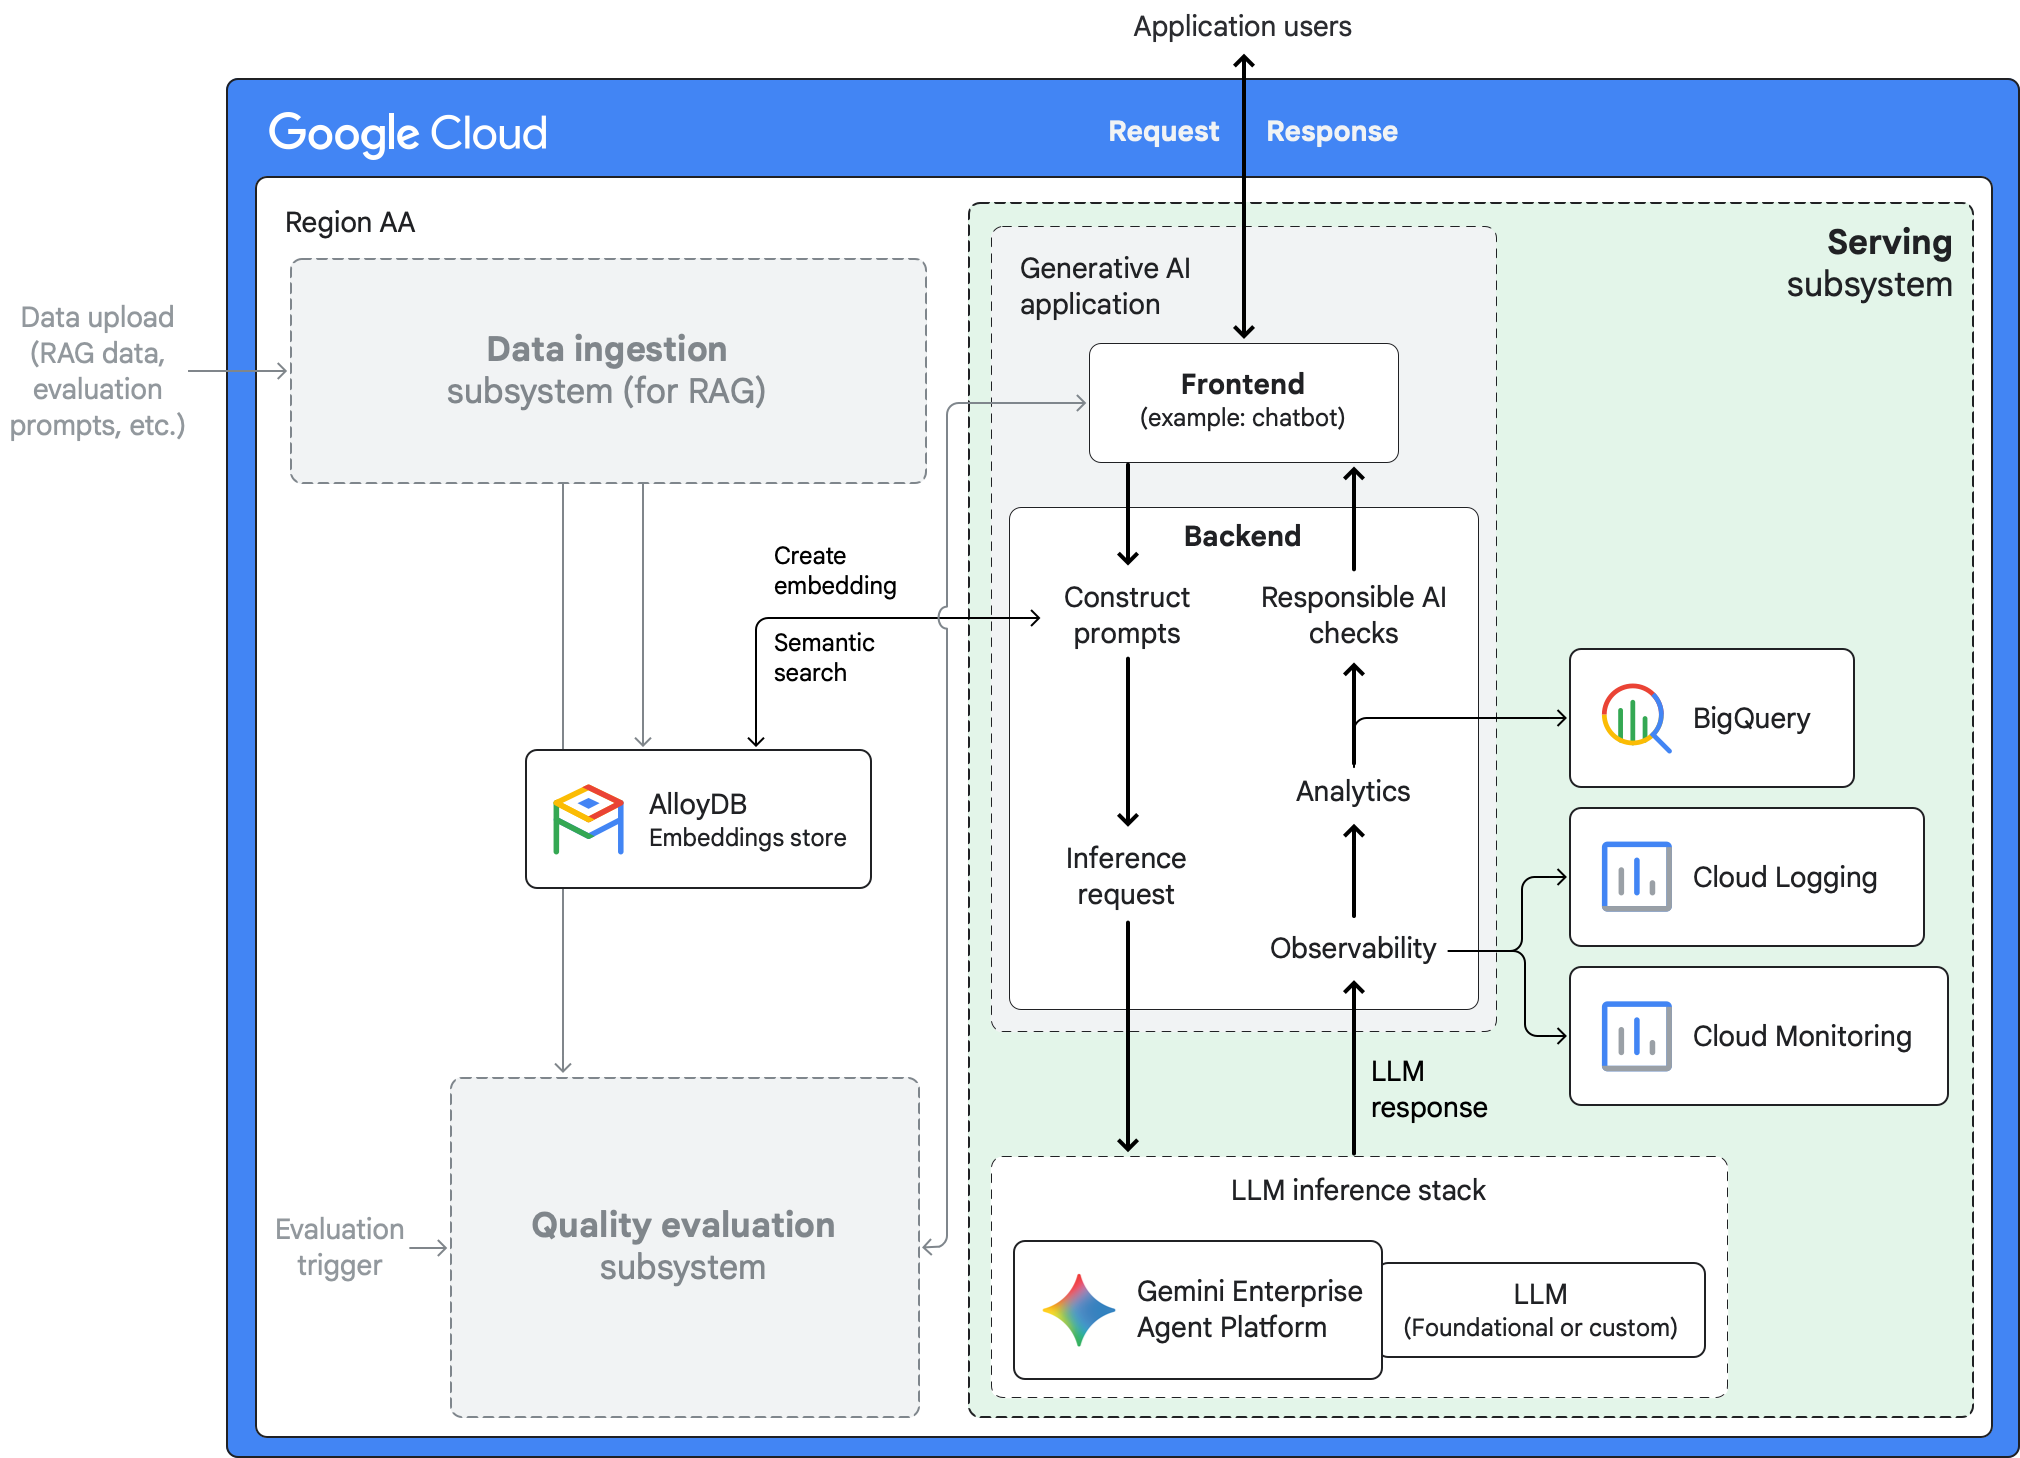
Berikut adalah langkah-langkah dalam alur permintaan-respons di subsistem penayangan:
- Pengguna mengirimkan permintaan ke aplikasi AI generatif melalui frontend (misalnya, chatbot atau aplikasi seluler).
Aplikasi AI generatif mengubah permintaan bahasa alami menjadi embedding.
Aplikasi menyelesaikan bagian pengambilan dari pendekatan RAG:
- Aplikasi ini melakukan penelusuran semantik untuk embedding dalam penyimpanan vektor AlloyDB yang dikelola subsistem penyerapan data. Penelusuran semantik membantu menemukan embedding berdasarkan intent dari perintah, bukan konten tekstualnya.
- Aplikasi ini menggabungkan permintaan asli dengan data mentah yang diambil berdasarkan embedding yang cocok untuk membuat perintah kontekstual.
Aplikasi ini mengirimkan perintah kontekstual ke stack inferensi LLM yang berjalan di Agent Platform.
Stack inferensi LLM menggunakan LLM AI generatif, yang dapat berupa LLM dasar atau LLM kustom, dan menghasilkan respons yang dibatasi pada konteks yang disediakan.
- Aplikasi ini dapat menyimpan log aktivitas permintaan-respons di Cloud Logging. Anda dapat melihat dan menggunakan log untuk pemantauan menggunakan Cloud Monitoring. Google tidak mengakses atau menggunakan data log.
- Aplikasi ini memuat respons ke BigQuery untuk analisis offline.
Aplikasi ini menyaring respons menggunakan filter responsible AI.
Aplikasi ini mengirimkan respons yang disaring kepada pengguna melalui frontend.
Subsistem evaluasi kualitas
Diagram berikut menunjukkan detail subsistem evaluasi kualitas dalam arsitektur:

Saat menerima permintaan, subsistem evaluasi kualitas akan melakukan hal berikut:
- Pub/Sub memicu fungsi Cloud Run.
- Fungsi ini dimulai menggunakan data konfigurasi yang disimpan dalam database AlloyDB.
- Fungsi ini menarik perintah evaluasi dari database AlloyDB. Perintah tersebut sebelumnya diupload ke database oleh subsistem penyerapan data.
Fungsi ini menggunakan perintah evaluasi untuk menilai kualitas respons yang dihasilkan oleh subsistem inferensi.
Output dari evaluasi ini berisi skor evaluasi untuk metrik seperti akurasi dan relevansi faktual.
Fungsi ini memuat skor evaluasi serta perintah dan respons yang dievaluasi ke BigQuery untuk analisis di masa mendatang.
Produk yang digunakan
Berikut adalah ringkasan semua produk Google Cloud yang digunakan oleh arsitektur sebelumnya:
- Gemini Enterprise Agent Platform: Platform komprehensif yang memungkinkan Anda membangun, menskalakan, mengatur, dan mengoptimalkan agen AI tingkat perusahaan.
- Cloud Run Functions: Platform komputasi serverless yang memungkinkan Anda menjalankan fungsi bertujuan tunggal langsung di Google Cloud.
- BigQuery: Data warehouse perusahaan yang membantu Anda mengelola dan menganalisis data dengan fitur bawaan seperti machine learning, analisis geospasial, dan business intelligence.
- Cloud Storage: Penyimpanan objek berbiaya rendah dan tanpa batas untuk beragam jenis data. Data dapat diakses dari dalam dan luar Google Cloud, serta direplikasi di berbagai lokasi untuk redundansi.
- AlloyDB untuk PostgreSQL: Layanan database yang kompatibel dengan PostgreSQL dan terkelola sepenuhnya, yang didesain untuk workload dengan tuntutan tinggi, termasuk pemrosesan transaksional dan analisis hybrid.
- Pub/Sub: Layanan pesan asinkron dan skalabel yang memisahkan layanan yang menghasilkan pesan dari layanan yang memproses pesan tersebut.
- Cloud Logging: Sistem pengelolaan log real-time dengan penyimpanan, penelusuran, analisis, dan pemberitahuan.
- Cloud Monitoring: Layanan yang memberikan visibilitas terkait performa, ketersediaan, dan kondisi aplikasi serta infrastruktur Anda.
Kasus penggunaan
RAG adalah teknik yang efektif untuk meningkatkan kualitas output yang dihasilkan dari LLM. Bagian ini memberikan contoh kasus penggunaan yang dapat Anda gunakan untuk aplikasi AI generatif berkemampuan RAG.
Rekomendasi produk yang dipersonalisasi
Situs belanja online mungkin menggunakan chatbot yang didukung LLM untuk membantu pelanggan menemukan produk atau mendapatkan bantuan terkait belanja. Pertanyaan dari pengguna dapat ditambah dengan menggunakan data historis tentang perilaku pembelian dan pola interaksi situs pengguna. Data tersebut dapat mencakup ulasan dan masukan pengguna yang disimpan di penyimpanan data tidak terstruktur atau metrik terkait penelusuran yang disimpan di data warehouse analisis web. Pertanyaan yang telah diaugmentasi kemudian dapat diproses oleh LLM untuk menghasilkan respons yang dipersonalisasi yang mungkin lebih menarik dan meyakinkan bagi pengguna.
Sistem bantuan klinis
Tenaga klinis di rumah sakit perlu meninjau dan menyintesis informasi kesehatan pasien untuk membuat keputusan perawatan yang tepat. Aplikasi AI generatif yang menggunakan model dasar medis seperti MedGemma dapat membantu tenaga klinis meringkas catatan klinis dan meninjau konteks medis. Respons yang dihasilkan aplikasi dapat didasarkan pada catatan kesehatan pasien historis dengan mengontekstualisasikan perintah dengan data dari database rekam medis elektronik (EHR) rumah sakit atau dari pusat informasi eksternal seperti PubMed.
Riset hukum yang efisien
Riset hukum yang didukung AI generatif memungkinkan pengacara mengkueri sejumlah besar undang-undang dan yurisprudensi dengan cepat untuk mengidentifikasi preseden hukum yang relevan atau meringkas konsep hukum yang kompleks. Output riset tersebut dapat ditingkatkan dengan menambahkan perintah pengacara dengan data yang diambil dari korpus kontrak milik firma hukum, komunikasi hukum sebelumnya, dan catatan kasus internal. Pendekatan desain ini membantu menghasilkan respons yang relevan dengan domain hukum yang menjadi spesialisasi pengacara tersebut.
Alternatif desain
Bagian ini menyajikan pendekatan desain alternatif yang dapat Anda pertimbangkan untuk aplikasi AI generatif berkemampuan RAG di Google Cloud.
Framework RAG terkelola
Untuk mengorkestrasi alur kerja LLM yang dilengkapi konteks tanpa membangun pipeline penyerapan dan pengambilan kustom, Anda dapat menggunakan RAG Engine di Gemini Enterprise Agent Platform. RAG Engine mengelola penyerapan data, pengelompokan, pembuatan embedding, pengindeksan, dan pengambilan untuk workload RAG.
Penelusuran vektor yang terkelola sepenuhnya
Jika Anda memerlukan arsitektur yang menggunakan produk penelusuran vektor yang terkelola sepenuhnya, Anda dapat menggunakan Agent Platform dan Penelusuran Vektor, yang menyediakan infrastruktur penyajian yang dioptimalkan untuk penelusuran vektor berskala sangat besar. Untuk mengetahui informasi selengkapnya, lihat Infrastruktur RAG untuk AI generatif menggunakan Agent Platform dan Penelusuran Vektor.
Alat dan model open source
Jika Anda ingin membangun dan men-deploy aplikasi AI generatif berkemampuan RAG dengan cepat menggunakan alat dan model open source Ray, Hugging Face, dan LangChain, lihat Infrastruktur RAG untuk AI generatif menggunakan GKE dan Cloud SQL.
Pertimbangan desain
Bagian ini memberikan panduan untuk membantu Anda mengembangkan arsitektur AI generatif yang mendukung RAG di Google Cloud yang memenuhi persyaratan spesifik Anda terkait keamanan dan kepatuhan, keandalan, biaya, serta performa. Panduan di bagian ini tidak lengkap. Bergantung pada persyaratan spesifik aplikasi AI generatif Anda serta produk dan fitur Google Cloud yang Anda gunakan, Anda mungkin perlu mempertimbangkan faktor desain dan kompromi tambahan.
Keamanan dan kepatuhan
Bagian ini menjelaskan faktor-faktor yang harus Anda pertimbangkan saat mendesain dan membangun aplikasi AI generatif berkemampuan RAG di Google Cloud yang memenuhi persyaratan keamanan dan kepatuhan Anda.
Pertimbangan keamanan Agent Platform
Untuk membantu memastikan bahwa konfigurasi dan penggunaan Agent Platform Anda memenuhi persyaratan keamanan, pertimbangkan faktor dan rekomendasi desain berikut:
Kontrol keamanan: Agent Platform mendukung Google Cloud kontrol keamanan yang dapat Anda gunakan untuk memenuhi persyaratan residensi data, enkripsi data, keamanan jaringan, dan transparansi akses. Untuk mengetahui informasi selengkapnya, lihat Kontrol keamanan untuk layanan machine learning dan Kontrol keamanan untuk AI Generatif.
Penyaringan perintah dan respons: Untuk menyaring perintah RAG dan respons model dari injeksi perintah, upaya jailbreak, konten berbahaya, dan kebocoran data sensitif, gunakan template dan filter Model Armor.
Enkripsi data Cloud Run Functions
Untuk melindungi data Anda menggunakan kunci yang Anda kontrol, Anda dapat menggunakan kunci enkripsi yang dikelola pelanggan (CMEK).
Pertimbangan keamanan AlloyDB
Untuk membantu memastikan bahwa konfigurasi AlloyDB Anda memenuhi persyaratan keamanan, pertimbangkan rekomendasi berikut:
- Enkripsi data: Secara default, data yang disimpan di AlloyDB dienkripsi menggunakanGoogle-owned and Google-managed encryption keys. Jika Anda perlu menggunakan kunci enkripsi yang Anda kontrol dan kelola, Anda dapat menggunakan CMEK. Untuk mengetahui informasi selengkapnya, lihat Tentang CMEK.
- Kontrol jaringan: Untuk mengurangi risiko pemindahan data yang tidak sah dari database AlloyDB, Anda dapat membuat perimeter layanan menggunakan Kontrol Layanan VPC.
- Keamanan koneksi: Secara default, instance AlloyDB hanya menerima koneksi yang menggunakan SSL. Untuk lebih mengamankan koneksi ke database AlloyDB, Anda dapat menggunakan konektor Proxy Auth AlloyDB. Konektor Auth Proxy menyediakan otorisasi koneksi berbasis Identity and Access Management (IAM) dan menggunakan koneksi TLS 1.3 dengan cipher AES 256-bit untuk memverifikasi identitas klien dan server serta mengenkripsi traffic data. Untuk informasi selengkapnya, lihat Tentang Proxy Auth AlloyDB. Untuk koneksi yang dibuat menggunakan Java, Python, Go, atau Node.js, gunakan Konektor Bahasa yang sesuai, bukan konektor Proxy Auth.
- Residensi data: AlloyDB membantu Anda memenuhi persyaratan residensi data. Data disimpan atau direplikasi dalam region yang Anda tentukan.
Pertimbangan keamanan BigQuery
Untuk membantu memastikan bahwa konfigurasi BigQuery Anda memenuhi persyaratan keamanan, pertimbangkan rekomendasi berikut:
- Tata kelola data: BigQuery menyediakan banyak fitur yang dapat Anda gunakan untuk mengontrol akses ke data, melindungi data sensitif, serta membantu memastikan akurasi dan konsistensi data. Untuk mengetahui informasi selengkapnya, lihat Pengantar tata kelola data di BigQuery.
- Residensi data: BigQuery membantu Anda memenuhi persyaratan residensi data. Data disimpan dalam region yang Anda tentukan.
Pertimbangan keamanan Cloud Storage
Untuk membantu memastikan bahwa konfigurasi Cloud Storage Anda memenuhi persyaratan keamanan, pertimbangkan rekomendasi berikut:
- Enkripsi data: Secara default, data yang disimpan di Cloud Storage dienkripsi menggunakan Google-owned and Google-managed encryption keys. Jika diperlukan, Anda dapat menggunakan CMEK atau kunci Anda sendiri yang Anda kelola menggunakan metode pengelolaan eksternal seperti kunci enkripsi yang disediakan pelanggan (CSEK). Untuk mengetahui informasi selengkapnya, lihat Opsi enkripsi data.
- Kontrol akses: Cloud Storage mendukung dua metode untuk memberi pengguna akses ke bucket dan objek Anda: IAM dan daftar kontrol akses (ACL). Pada umumnya, gunakan IAM, yang memungkinkan Anda memberikan izin di level bucket dan project. Untuk informasi selengkapnya, lihat Ringkasan kontrol akses.
- Perlindungan data: Data yang Anda muat ke subsistem penyerapan data melalui Cloud Storage mungkin menyertakan data sensitif. Untuk melindungi data tersebut, Anda dapat menggunakan Sensitive Data Protection untuk menemukan, mengklasifikasikan, dan melakukan de-identifikasi data. Untuk mengetahui informasi selengkapnya, lihat Menggunakan Sensitive Data Protection dengan Cloud Storage.
- Residensi data: Cloud Storage membantu Anda memenuhi persyaratan residensi data. Data disimpan atau direplikasi dalam region yang Anda tentukan.
Pertimbangan keamanan Pub/Sub
Untuk membantu memastikan bahwa konfigurasi Pub/Sub Anda memenuhi persyaratan keamanan, pertimbangkan rekomendasi berikut:
- Enkripsi data: Secara default, Pub/Sub mengenkripsi semua pesan, baik dalam penyimpanan maupun dalam pengiriman, menggunakan Google-owned and Google-managed encryption keys. Pub/Sub mendukung penggunaan CMEK untuk enkripsi pesan di lapisan aplikasi. Untuk mengetahui informasi selengkapnya, lihat Mengonfigurasi enkripsi pesan.
- Residensi data: Jika Anda memiliki persyaratan residensi data, untuk membantu memastikan bahwa data pesan disimpan di lokasi tertentu, Anda dapat mengonfigurasi kebijakan penyimpanan pesan.
Pertimbangan keamanan Cloud Logging
Untuk membantu memastikan bahwa konfigurasi Cloud Logging Anda memenuhi persyaratan keamanan, pertimbangkan faktor dan rekomendasi desain berikut:
- Audit aktivitas administratif: Log audit Aktivitas Admin diaktifkan secara default untuk semua layanan Google Cloud yang digunakan dalam arsitektur referensi ini. Log ini mencatat panggilan API atau tindakan lain yang mengubah konfigurasi atau metadata resource Google Cloud .
- Audit akses data: Log audit Akses Data diaktifkan secara default untuk BigQuery. Untuk layanan lain yang digunakan dalam arsitektur ini, Anda dapat mengaktifkan log audit Akses Data. Log ini memungkinkan Anda melacak panggilan API yang membaca konfigurasi atau metadata resource atau permintaan pengguna untuk membuat, mengubah, atau membaca data resource yang disediakan pengguna.
- Residensi data: Untuk membantu memenuhi persyaratan residensi data, Anda dapat mengonfigurasi Cloud Logging untuk menyimpan data log di region yang Anda tentukan. Untuk mengetahui informasi selengkapnya, lihat Meregionalkan log Anda.
Untuk prinsip dan rekomendasi keamanan yang khusus untuk workload AI dan ML, lihat Perspektif AI dan ML: Keamanan dalam Well-Architected Framework.
Keandalan
Bagian ini menjelaskan faktor desain yang harus Anda pertimbangkan untuk membangun dan mengoperasikan infrastruktur yang andal untuk aplikasi AI generatif berkemampuan RAG di Google Cloud.
Pertimbangan keandalan Cloud Run Functions
Untuk membantu memastikan bahwa implementasi Cloud Run Functions Anda memenuhi persyaratan keandalan, pertimbangkan faktor desain dan rekomendasi berikut:
- Redundansi zona: Fungsi Cloud Run berjalan di beberapa zona dalam satu region untuk memberikan ketahanan bawaan terhadap pemadaman layanan zona.
- Penanganan kegagalan: Untuk menangani peristiwa duplikat atau kegagalan sementara dengan aman, tulis fungsi idempoten dan konfigurasikan percobaan ulang fungsi berbasis peristiwa. Untuk mengisolasi pesan yang berulang kali gagal diproses, konfigurasikan topik yang dihentikan pengirimannya Pub/Sub.
Pertimbangan keandalan AlloyDB
Untuk membantu memastikan bahwa konfigurasi AlloyDB Anda memenuhi persyaratan keandalan, pertimbangkan faktor desain dan rekomendasi berikut:
- Ketersediaan tinggi: Secara default, cluster AlloyDB menyediakan ketersediaan tinggi (HA) dengan failover otomatis. Instance utama memiliki node redundan yang terletak di dua zona berbeda dalam satu region. Redundansi ini membantu memastikan bahwa cluster tahan terhadap pemadaman layanan zona.
- Pemulihan dari bencana: Untuk merencanakan pemulihan dari pemadaman layanan region, Anda dapat menggunakan replikasi lintas region.
Pertimbangan keandalan BigQuery
Data yang Anda muat ke BigQuery disimpan secara sinkron di dua zona dalam region yang Anda tentukan. Redundansi ini membantu memastikan bahwa data Anda tidak hilang saat terjadi pemadaman layanan zona. Untuk mengetahui informasi selengkapnya tentang fitur keandalan di BigQuery, lihat Memahami keandalan.
Pertimbangan keandalan Cloud Storage
Anda dapat membuat bucket Cloud Storage di salah satu jenis lokasi berikut: regional, dual-region, atau multi-region. Data yang disimpan di bucket regional direplikasi secara sinkron di beberapa zona dalam satu region. Untuk ketersediaan yang lebih tinggi, Anda dapat menggunakan bucket dual-region atau multi-region, tempat data direplikasi secara asinkron di seluruh region.
Pertimbangan keandalan Pub/Sub
Untuk membantu memastikan konfigurasi Pub/Sub Anda memenuhi persyaratan keandalan, pertimbangkan rekomendasi berikut:
- Kontrol kapasitas: Untuk mengelola lonjakan sementara dalam traffic pesan, Anda dapat mengonfigurasi kontrol alur di setelan penayang.
- Penanganan kegagalan: Untuk menangani publikasi yang gagal, sesuaikan variabel retry-request sesuai kebutuhan. Untuk mengetahui informasi selengkapnya, lihat Mencoba ulang permintaan.
Untuk mengetahui informasi selengkapnya tentang pertimbangan spesifik per region, lihat Geografi dan region.
Untuk prinsip dan rekomendasi keandalan yang khusus untuk workload AI dan ML, lihat Perspektif AI dan ML: Keandalan dalam Framework Arsitektur yang Baik.
Pengoptimalan biaya
Bagian ini berisi panduan untuk membantu Anda mengoptimalkan biaya penyiapan dan pengoperasian aplikasi AI generatif yang mendukung RAG di Google Cloud.
Cache konteks Agent Platform
Untuk mengurangi biaya token input saat permintaan RAG berulang menggunakan petunjuk sistem atau konteks yang diambil dalam jumlah besar, gunakan cache konteks.
Pertimbangan biaya AlloyDB
Untuk membantu mengoptimalkan biaya AlloyDB, pertimbangkan rekomendasi berikut:
- Ketersediaan instance: Secara default, instance utama cluster AlloyDB memiliki ketersediaan tinggi (HA). Instance ini memiliki node aktif dan node standby. Jika node aktif gagal, AlloyDB akan otomatis melakukan failover ke node standby. Jika Anda tidak memerlukan HA untuk database, Anda dapat mengurangi biaya dengan menjadikan instance utama cluster sebagai instance dasar. Instance dasar tidak tahan terhadap pemadaman layanan zona, dan memiliki periode nonaktif yang lebih lama selama operasi pemeliharaan. Untuk mengetahui informasi selengkapnya, lihat Mengurangi biaya menggunakan instance dasar.
- Pengoptimalan tarif: Jika Anda dapat memprediksi persyaratan CPU dan memori instance AlloyDB, Anda dapat menghemat uang dengan mendapatkan diskon untuk penggunaan abonemen. Untuk mengetahui informasi selengkapnya, lihat Diskon abonemen AlloyDB.
Pertimbangan biaya BigQuery
BigQuery memungkinkan Anda memperkirakan biaya kueri sebelum menjalankannya. Untuk mengoptimalkan biaya kueri, Anda perlu mengoptimalkan penyimpanan dan komputasi kueri. Untuk mengetahui informasi selengkapnya, lihat Memperkirakan dan mengontrol biaya.
Pertimbangan biaya Cloud Storage
Untuk bucket Cloud Storage yang Anda gunakan untuk memuat data ke subsistem penyerapan data, pilih kelas penyimpanan yang sesuai berdasarkan persyaratan retensi data dan frekuensi akses workload Anda. Misalnya, untuk mengontrol biaya penyimpanan, Anda dapat memilih kelas Standard Storage dan menggunakan Object Lifecycle Management. Dengan pendekatan ini, Anda dapat otomatis mendowngrade objek ke kelas penyimpanan berbiaya lebih rendah atau menghapus objek berdasarkan kondisi yang Anda tetapkan.
Pertimbangan biaya Cloud Logging
Untuk mengontrol biaya penyimpanan log, pertimbangkan rekomendasi berikut:
- Kurangi volume log dengan mengecualikan atau memfilter entri log yang tidak diperlukan. Untuk mengetahui informasi selengkapnya, lihat Filter sink log.
- Mengurangi periode penyimpanan entri log. Untuk mengetahui informasi selengkapnya, lihat Mengonfigurasi retensi kustom.
Untuk prinsip dan rekomendasi pengoptimalan biaya yang khusus untuk workload AI dan ML, lihat Perspektif AI dan ML: Pengoptimalan biaya dalam Well-Architected Framework.
Performa
Bagian ini menjelaskan faktor-faktor yang harus Anda pertimbangkan saat mendesain dan membangun aplikasi AI generatif berkemampuan RAG di Google Cloud yang memenuhi persyaratan performa Anda.
Latensi Cloud Run Functions
Untuk mengurangi latensi cold start setelah periode tidak aktif, konfigurasikan jumlah minimum instance.
Pertimbangan performa AlloyDB
Untuk membantu memastikan bahwa konfigurasi AlloyDB Anda memenuhi persyaratan performa, pertimbangkan rekomendasi berikut:
- Pengindeksan vektor dan mesin berbasis kolom: Untuk mempercepat kueri kesamaan vektor dalam workload RAG, buat indeks Approximate Nearest Neighbor (ANN) seperti ScaNN atau HNSW. Untuk mengetahui informasi selengkapnya, lihat Memilih strategi indeks. Untuk mempercepat pemindaian vektor dan kueri yang difilter, lihat Mempercepat penelusuran vektor dengan columnar engine.
- Analisis performa kueri: Untuk membantu Anda menganalisis dan meningkatkan performa kueri database, AlloyDB menyediakan alat Query Insights. Anda dapat menggunakan alat ini untuk memantau performa dan melacak sumber kueri yang bermasalah. Untuk mengetahui informasi selengkapnya, lihat Tentang Query Insights.
- Pemantauan instance: Untuk mendapatkan ringkasan status dan performa database Anda serta melihat metrik mendetail seperti koneksi puncak dan jeda replikasi maksimum, Anda dapat menggunakan dasbor System Insights. Untuk mengetahui informasi selengkapnya, lihat Memantau instance menggunakan dasbor AlloyDB System Insights.
- Penskalaan baca: Untuk mengurangi beban pada instance AlloyDB utama dan menskalakan kapasitas untuk menangani permintaan baca, Anda dapat menambahkan instance kumpulan baca ke cluster. Untuk mengetahui informasi selengkapnya, lihat Apa yang dimaksud dengan instance AlloyDB?.
Pertimbangan performa BigQuery
Untuk membantu memastikan bahwa penggunaan BigQuery Anda memenuhi persyaratan performa, pertimbangkan rekomendasi berikut:
- Insight performa kueri: BigQuery menyediakan grafik eksekusi kueri yang dapat Anda gunakan untuk menganalisis performa kueri dan mendapatkan insight performa untuk masalah seperti pertentangan slot dan kuota shuffle yang tidak memadai. Untuk mengetahui informasi selengkapnya, lihat Mendapatkan insight performa kueri.
- Pengoptimalan komputasi kueri: Setelah mengatasi masalah yang Anda identifikasi melalui insight performa kueri, Anda dapat mengoptimalkan kueri lebih lanjut menggunakan teknik seperti mengurangi volume data input dan output. Untuk mengetahui informasi selengkapnya, lihat Mengoptimalkan komputasi kueri.
Pertimbangan performa Cloud Storage
Untuk mengupload file besar, Anda dapat menggunakan metode yang disebut upload komposit paralel. Dengan strategi ini, file besar dibagi menjadi beberapa bagian. Bagian-bagian tersebut diupload ke Cloud Storage secara paralel, lalu data disusun ulang di cloud. Jika bandwidth jaringan dan kecepatan disk tidak menjadi faktor pembatas, upload komposit paralel dapat lebih cepat daripada operasi upload reguler. Namun, strategi ini memiliki beberapa keterbatasan dan implikasi biaya. Untuk mengetahui informasi selengkapnya, lihat Upload komposit paralel.
Untuk mengetahui prinsip dan rekomendasi pengoptimalan performa yang khusus untuk workload AI dan ML, lihat Perspektif AI dan ML: Pengoptimalan performa dalam Well-Architected Framework.
Deployment
Untuk mulai dan bereksperimen dengan membangun infrastruktur di Google Cloud untuk aplikasi AI generatif berkemampuan RAG, gunakan kode contoh yang tersedia di GitHub. Kode ini men-deploy aplikasi chat berbasis Python di Cloud Run dan menggunakan database Cloud SQL yang terkelola sepenuhnya untuk penelusuran vektor.
Langkah berikutnya
- Aplikasi RAG Agentic AlloyDB dengan MCP Toolbox
- Infrastruktur RAG untuk AI generatif menggunakan Agent Platform dan Penelusuran Vektor
- Infrastruktur RAG untuk AI generatif menggunakan GKE dan Cloud SQL
- Infrastruktur RAG untuk AI generatif menggunakan Gemini Enterprise dan Agent Platform
- Infrastruktur GraphRAG untuk AI generatif menggunakan Agent Platform dan Spanner Graph
- Untuk ringkasan prinsip dan rekomendasi arsitektur yang khusus untuk workload AI dan ML di Google Cloud, lihat Perspektif AI dan ML dalam Framework Arsitektur yang Baik.
- Untuk mengetahui lebih banyak tentang arsitektur referensi, diagram, dan praktik terbaik lainnya, jelajahi Pusat Arsitektur Cloud.
Kontributor
Penulis: Kumar Dhanagopal | Developer Solusi Lintas Produk
Kontributor lainnya:
- Andrew Brook | Engineering Director
- Anna Berenberg | Engineering Fellow
- Assaf Namer | Principal Cloud Security Architect
- Balachandar Krishnamoorthy | Principal Software Engineer
- Daniel Lees | Cloud Security Architect
- Derek Downey | Developer Relations Engineer
- Eran Lewis | Senior Product Manager
- Geoffrey Anderson | Product Manager
- Gleb Otochkin | Cloud Advocate, Databases
- Hamsa Buvaraghan | AI Product Manager
- Irina Sigler | Product Manager
- Jack Wotherspoon | Developer Advocate
- Jason Davenport | Developer Advocate
- Jordan Totten | Customer Engineer
- Julia Wiesinger | Product Manager
- Kara Greenfield | Customer Engineer
- Kurtis Van Gent | Staff Software Engineer
- Per Jacobsson | Software Engineer
- Pranav Nambiar | Director
- Richard Hendricks | Architecture Center Staff
- Safiuddin Khaja | Cloud Engineer
- Sandy Ghai | Group Product Manager
- Vladimir Vuskovic | Product Management Director
- Steren Giannini | Group Product Manager
- Wietse Venema | Developer Relations Engineer