


En este documento, se proporciona una arquitectura de referencia que puedes usar para diseñar la infraestructura para ejecutar una aplicación de Inteligencia Artificial (IA) generativa con generación aumentada por recuperación (RAG). El público previsto para este documento incluye desarrolladores y administradores de aplicaciones de IA generativa y arquitectos de nube. En el documento, se supone que tienes conocimientos básicos sobre IA, aprendizaje automático (AA) y conceptos del modelo grande de lenguaje (LLM). En este documento, no se proporciona guía sobre cómo diseñar y desarrollar una aplicación de IA generativa.
Arquitectura
En el siguiente diagrama, se muestra una vista de alto nivel de una arquitectura para una aplicación de IA generativa compatible con RAG en Google Cloud:

La arquitectura contiene los siguientes componentes interconectados:
- Subsistema de transferencia de datos
- El subsistema de transferencia de datos prepara y procesa los datos externos que se usan para habilitar la capacidad de RAG. Interactúa con los otros subsistemas en la arquitectura a través de la capa de la base de datos.
- Subsistema de entrega
- El subsistema de entrega controla el flujo de solicitud y respuesta entre la aplicación basada en IA generativa y sus usuarios. Interactúa con el subsistema de ingesta de datos a través de la capa de la base de datos.
- Subsistema de evaluación de calidad
- El subsistema de evaluación de calidad evalúa la calidad de las respuestas que genera el subsistema de entrega. Interactúa directamente con el subsistema de entrega y con el subsistema de transferencia de datos a través de la capa de la base de datos.
- Bases de datos
Todos los subsistemas de la arquitectura interactúan con las bases de datos. Las bases de datos almacenan los siguientes datos:
- Instrucciones
- Embeddings de vector vectorizados de los datos que se usan para la RAG
- Configuraciones de las funciones sin servidores en los subsistemas de transferencia de datos y evaluación de calidad
En el siguiente diagrama, se muestra una vista detallada de la arquitectura:

En las siguientes secciones, se proporcionan descripciones detalladas de los componentes y el flujo de datos dentro de cada subsistema de la arquitectura.
Subsistema de transferencia de datos
El subsistema de ingesta de datos transfiere datos de fuentes externas, como archivos, bases de datos y servicios de transmisión. Los datos subidos incluyen solicitudes para la evaluación de calidad. El subsistema de transferencia de datos proporciona la capacidad de RAG en la arquitectura. En el siguiente diagrama, se muestran los detalles del subsistema de ingesta de datos en la arquitectura:
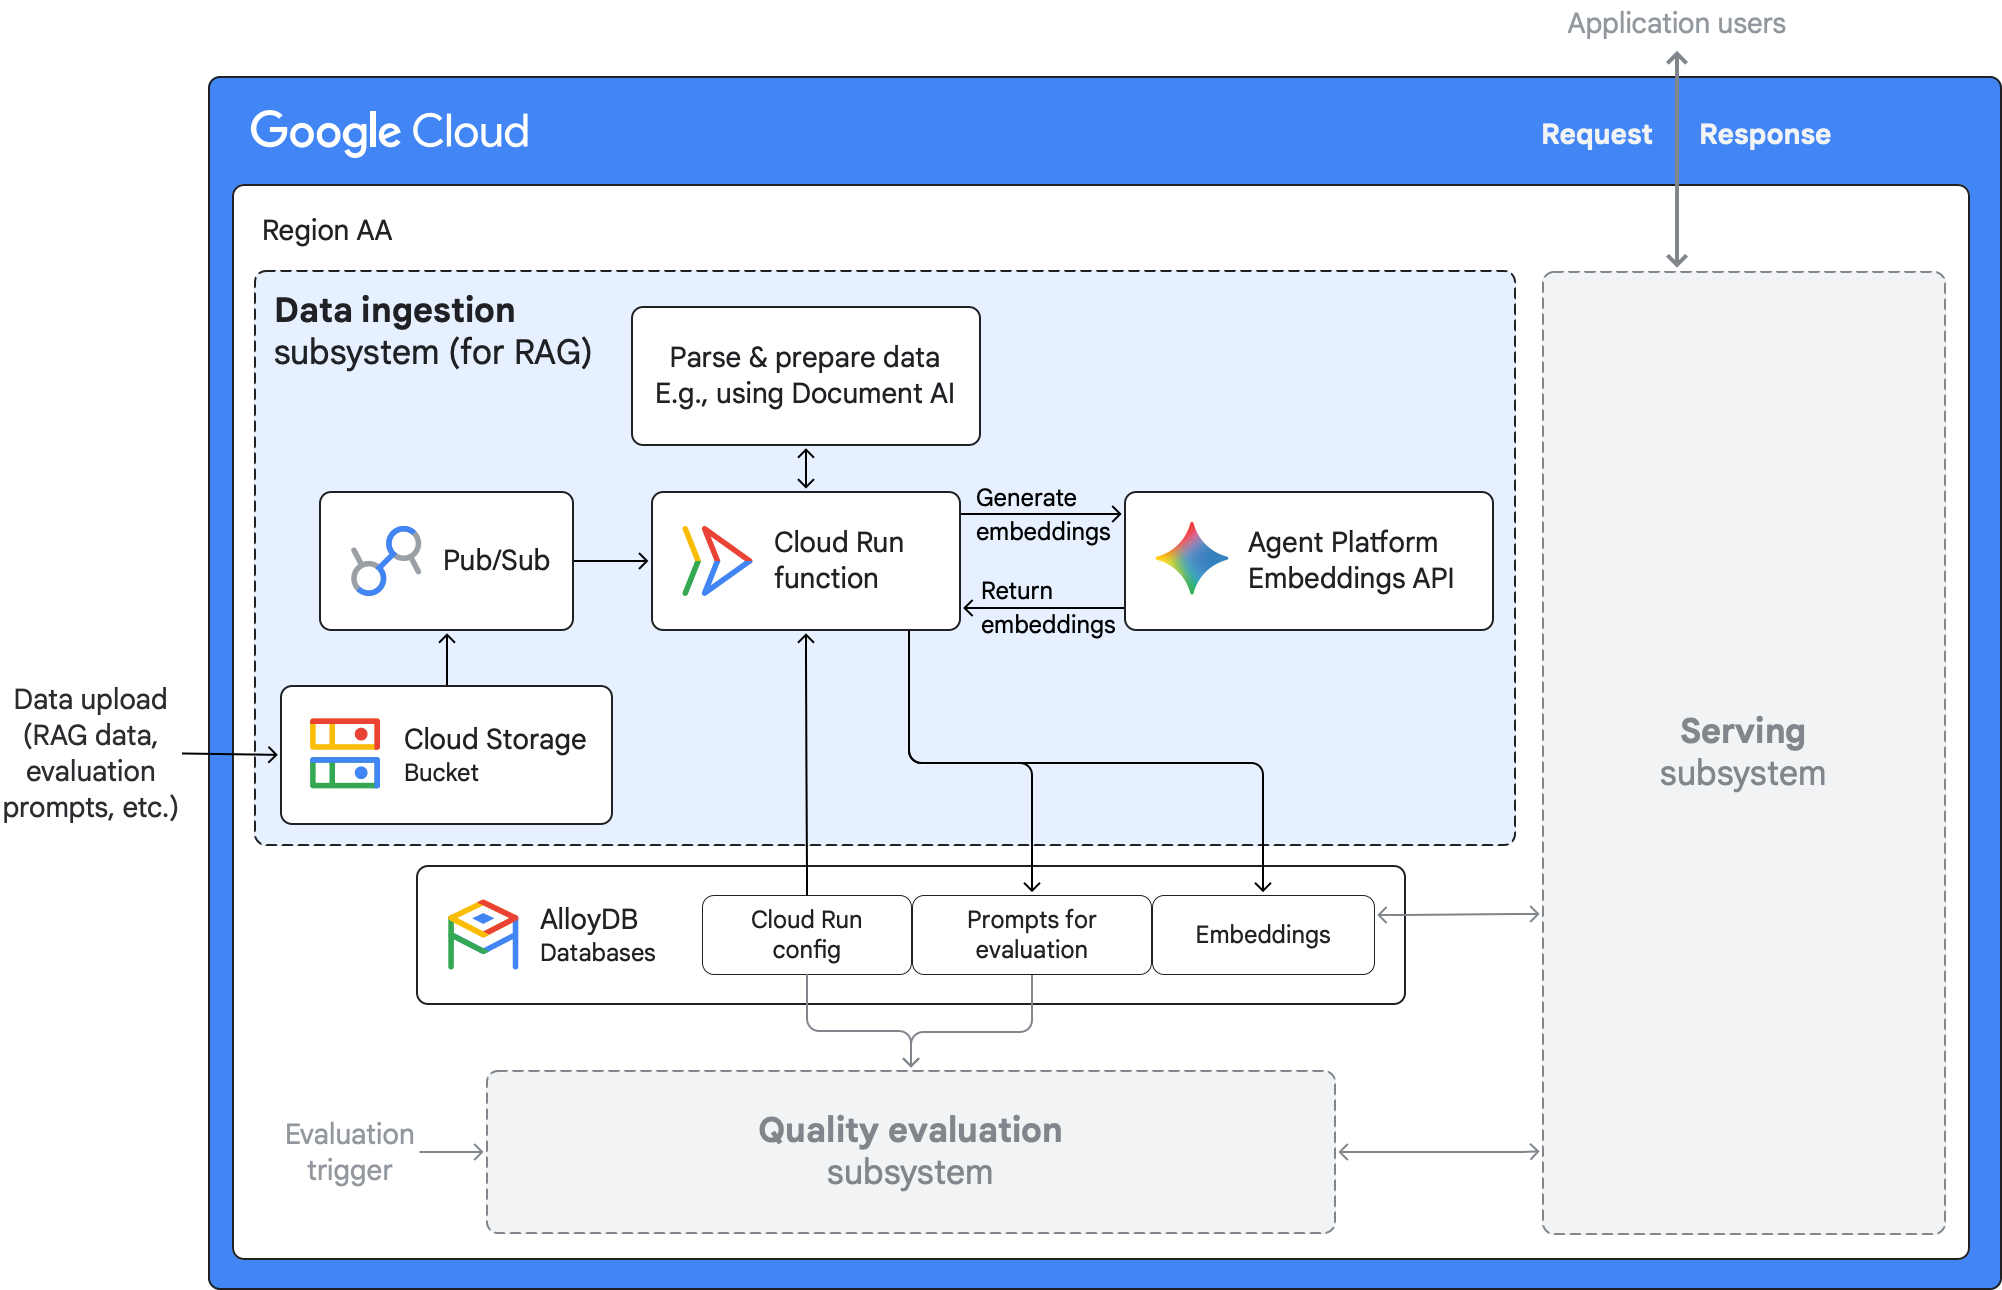
Los siguientes son los pasos en el flujo de transferencia de datos:
- Los datos se suben a un bucket de Cloud Storage. Las fuentes de datos pueden ser aplicaciones, bases de datos o servicios de transmisión.
- Cuando se suben datos a Cloud Storage, se publica un mensaje en un tema de Pub/Sub.
- Pub/Sub activa una función de Cloud Run para procesar los datos subidos.
- La función se inicia con datos de configuración que se almacenan en una base de datos de AlloyDB para PostgreSQL.
- La función analiza los datos sin procesar, les aplica el formato requerido y, luego, los divide en fragmentos.
La función usa un modelo de embedding adecuado en Gemini Enterprise Agent Platform para crear embeddings de vector de los datos transferidos.
La función almacena las incorporaciones en una base de datos de AlloyDB que tiene habilitada la extensión
vectorcompatible conpgvector. Como se describe en la siguiente sección, cuando el subsistema de entrega procesa solicitudes de usuarios, usa las incorporaciones en la base de datos vectorial para recuperar datos específicos del dominio relevantes.
Subsistema de entrega
El subsistema de entrega controla el flujo de solicitud y respuesta entre la aplicación de IA generativa y sus usuarios. En el siguiente diagrama, se muestran los detalles del subsistema de entrega en la arquitectura:

Los siguientes son los pasos en el flujo de solicitud-respuesta en el subsistema de entrega:
- Los usuarios envían solicitudes a la aplicación de IA generativa a través de un frontend (por ejemplo, un chatbot o una app para dispositivos móviles).
La aplicación de IA generativa convierte la solicitud de lenguaje natural en incorporaciones.
La aplicación completa la parte de recuperación del enfoque RAG:
- La aplicación realiza una búsqueda semántica para el embedding en el almacén de vectores de AlloyDB que mantiene el subsistema de transferencia de datos. La búsqueda semántica ayuda a encontrar embeddings basados en la intención de una instrucción, en lugar de su contenido textual.
- La aplicación combina la solicitud original con los datos sin procesar que se recuperan en función de la incorporación coincidente para crear una instrucción contextualizada.
La aplicación envía la instrucción contextualizada a una pila de inferencia de LLM que se ejecuta en Agent Platform.
La pila de inferencia de LLM usa un LLM de IA generativa, que puede ser un LLM de base o uno personalizado, y genera una respuesta limitada al contexto proporcionado.
- La aplicación puede almacenar registros de la actividad de solicitud y respuesta en Cloud Logging. Puedes ver y usar los registros para la supervisión mediante Cloud Monitoring. Google no accede a los datos de registro ni los usa.
- La aplicación carga las respuestas a BigQuery para las estadísticas sin conexión.
La aplicación analiza las respuestas mediante filtros de IA responsables.
La aplicación envía las respuestas filtradas a los usuarios a través del frontend.
Subsistema de evaluación de calidad
En el siguiente diagrama, se muestran los detalles del subsistema de evaluación de calidad en la arquitectura:

Cuando el subsistema de evaluación de calidad recibe una solicitud, realiza lo siguiente:
- Pub/Sub activa una función de Cloud Run.
- La función se inicia con los datos de configuración que se almacenan en una base de datos de AlloyDB.
- La función extrae instrucciones de evaluación de una base de datos de AlloyDB. El subsistema de transferencia de datos subió anteriormente las instrucciones a la base de datos.
La función usa las instrucciones de evaluación para determinar la calidad de las respuestas que genera el subsistema de entrega.
El resultado de esta evaluación consiste en las puntuaciones de evaluación para las métricas como la exactitud y la relevancia fácticas.
La función carga las puntuaciones de evaluación y las instrucciones y respuestas que se evaluaron en BigQuery para su análisis futuro.
Productos usados
El siguiente es un resumen de todos los productos de Google Cloud que usa la arquitectura anterior:
- Gemini Enterprise Agent Platform: Es una plataforma integral que te permite crear, escalar, administrar y optimizar agentes de IA de nivel empresarial.
- Cloud Run Functions: Es una plataforma de computación sin servidores que te permite ejecutar funciones de un solo propósito directamente en Google Cloud.
- BigQuery: Es un almacén de datos empresarial que te ayuda a administrar y analizar tus datos con funciones integradas, como el análisis geoespacial, el aprendizaje automático y la inteligencia empresarial.
- Cloud Storage: Es un almacén de objetos de bajo costo y sin límites para varios tipos de datos. Se puede acceder a los datos desde y hacia Google Cloud, y estos se replican en las ubicaciones para aumentar la redundancia.
- AlloyDB para PostgreSQL: Un servicio de base de datos completamente administrado, compatible con PostgreSQL, que está diseñado para cargas de trabajo exigentes, incluido el procesamiento híbrido transaccional y analítico.
- Pub/Sub: Un servicio de mensajería asíncrona y escalable que separa los servicios que producen mensajes de servicios que procesan esos mensajes.
- Cloud Logging: Un sistema de administración de registros en tiempo real con almacenamiento, búsqueda, análisis y alertas.
- Cloud Monitoring: Un servicio que proporciona visibilidad del rendimiento, la disponibilidad y el estado de la infraestructura y las aplicaciones.
Casos de uso
RAG es una técnica eficaz para mejorar la calidad del resultado que se genera a partir de un LLM. En esta sección, se proporcionan ejemplos de casos de uso para los que puedes usar aplicaciones de IA generativa compatibles con RAG.
Recomendaciones personalizadas de productos
Un sitio de compras en línea puede usar un chatbot con tecnología de LLM para ayudar a los clientes a encontrar productos o a obtener ayuda relacionada con las compras. Las preguntas de un usuario se pueden aumentar mediante el uso de datos históricos sobre el comportamiento de compra del usuario y los patrones de interacción con el sitio web. Los datos pueden incluir opiniones y comentarios de los usuarios que se almacenan en un almacén de datos no estructurado o métricas relacionadas con la búsqueda que se almacenan en un almacén de datos de estadísticas web. Luego, el LLM puede procesar la pregunta aumentada para generar respuestas personalizadas que el usuario podría considerar más interesantes y atractivas.
Sistemas de asistencia clínica
Los médicos de los hospitales deben revisar y sintetizar la información de salud de los pacientes para tomar decisiones fundamentadas sobre la atención. Una aplicación de IA generativa que usa un modelo de base médico como MedGemma puede ayudar a los profesionales clínicos a resumir notas clínicas y revisar el contexto médico. Las respuestas que genera la aplicación se pueden basar en registros históricos de pacientes contextualizando las instrucciones con datos de la base de datos del historial clínico electrónico (HCE) del hospital o de una base de conocimiento externa, como PubMed.
Investigación legal eficiente
La investigación legal impulsada por IA generativa permite a los abogados consultar con rapidez grandes volúmenes de leyes y jurisprudencia para identificar precedentes legales relevantes o resumir conceptos legales complejos. El resultado de esa investigación se puede mejorar mediante la mejora de las indicaciones de un abogado con datos que se recuperan del corpus propio de contratos, comunicaciones jurídicas previas y registros de casos internos. Este enfoque de diseño ayuda a generar respuestas que son relevantes para el dominio legal en el que se especializa el abogado.
Alternativas de diseño
En esta sección, se presentan enfoques de diseño alternativos que puedes considerar para tu aplicación de IA generativa compatible con RAG en Google Cloud.
Framework de RAG administrado
Para organizar flujos de trabajo de LLM con aumento de contexto sin crear una canalización de transferencia y recuperación personalizada, puedes usar RAG Engine en Gemini Enterprise Agent Platform. El motor de RAG administra la transferencia de datos, la división en fragmentos, la generación de incorporaciones, la indexación y la recuperación para las cargas de trabajo de RAG.
Búsqueda de vectores completamente administrada
Si necesitas una arquitectura que use un producto de búsqueda de vectores completamente administrado, puedes usar Agent Platform y Vector Search, que proporciona una infraestructura de entrega optimizada para la búsqueda de vectores a gran escala. Para obtener más información, consulta Infraestructura de RAG para la IA generativa con Agent Platform y Vector Search.
Herramientas y modelos de código abierto
Si quieres compilar e implementar con rapidez aplicaciones de IA generativa compatibles con RAG con las herramientas y los modelos de código abierto Ray, Hugging Face y LangChain, consulta Infraestructura de RAG para IA generativa con GKE y Cloud SQL.
Consideraciones del diseño
En esta sección, se proporciona orientación para ayudarte a desarrollar una arquitectura de IA generativa compatible con RAG en Google Cloud que cumpla con tus requisitos específicos de seguridad y cumplimiento, confiabilidad, costo y rendimiento. La guía de esta sección no está completa. Según los requisitos específicos de tu aplicación de IA generativa y los productos y las funciones de Google Cloud que usas, es posible que debas considerar factores de diseño y compensaciones adicionales.
Seguridad y cumplimiento
En esta sección, se describen los factores que debes tener en cuenta cuando diseñas y compilas una aplicación de IA generativa compatible con RAG en Google Cloud que cumpla con tus requisitos de seguridad y cumplimiento.
Consideraciones de seguridad de Agent Platform
Para garantizar que la configuración y el uso de Agent Platform cumplan con tus requisitos de seguridad, ten en cuenta los siguientes factores y recomendaciones de diseño:
Controles de seguridad: Agent Platform admite los controles de seguridad de Google Cloud que puedes usar para cumplir con tus requisitos de residencia de datos, encriptación de datos, seguridad de redes y transparencia de acceso. Para obtener más información, consulta Controles de seguridad para los servicios de aprendizaje automático y Controles de seguridad para la IA generativa.
Análisis de instrucciones y respuestas: Para analizar las instrucciones de RAG y las respuestas del modelo en busca de inyección de instrucciones, intentos de jailbreak, contenido dañino y filtraciones de datos sensibles, usa las plantillas y los filtros de Model Armor.
Encriptación de datos de Cloud Run Functions
Para proteger tus datos con una clave que controlas, puedes usar claves de encriptación administradas por el cliente (CMEK).
Consideraciones de seguridad de AlloyDB
Para asegurarte de que tu configuración de AlloyDB cumpla con tus requisitos de seguridad, ten en cuenta las siguientes recomendaciones:
- Encriptación de datos: De forma predeterminada, los datos que se almacenan en AlloyDB se encriptan con Google-owned and Google-managed encryption keys. Si necesitas usar claves de encriptación que controlas y administras, puedes usar CMEK. Para obtener más información, consulta Acerca de CMEK.
- Control de red: Para mitigar el riesgo de robo de datos de las bases de datos de AlloyDB, puedes crear un perímetro de servicio con los Controles del servicio de VPC.
- Seguridad de la conexión: De forma predeterminada, una instancia de AlloyDB solo acepta conexiones que usan SSL. Para proteger aún más las conexiones a tus bases de datos de AlloyDB, puedes usar el conector del proxy de autenticación de AlloyDB. El conector de proxy de autenticación proporciona autorización de conexión basada en Identity and Access Management (IAM) y usa una conexión TLS 1.3 con un algoritmo de cifrado AES de 256 bits para verificar las identidades del cliente y del servidor y encriptar el tráfico de datos. Para obtener más información, consulta Acerca del proxy de autenticación de AlloyDB. Para las conexiones que se crean con Java, Python, Go o Node.js, usa el conector de lenguaje adecuado en lugar del conector del proxy de autenticación.
- Residencia de los datos: AlloyDB te ayuda a cumplir con los requisitos de residencia de datos. Los datos se almacenan o replican dentro de las regiones que especifiques.
Consideraciones de seguridad de BigQuery
Para garantizar que tu configuración de BigQuery cumpla con tus requisitos de seguridad, ten en cuenta las siguientes recomendaciones:
- Administración de datos: BigQuery proporciona muchas funciones que puedes usar para controlar el acceso a los datos, proteger los datos sensibles y ayudar a garantizar la exactitud y coherencia de los datos. Para obtener más información, consulta Introducción a la administración de datos en BigQuery.
- Residencia de datos: BigQuery te ayuda a cumplir con los requisitos de residencia de datos. Los datos se almacenan dentro de la región que especifiques.
Consideraciones de seguridad de Cloud Storage
Para asegurarte de que la configuración de Cloud Storage cumpla con tus requisitos de seguridad, ten en cuenta las siguientes recomendaciones:
- Encriptación de datos: De forma predeterminada, los datos que se almacenan en Cloud Storage se encriptan con Google-owned and Google-managed encryption keys. Si es necesario, puedes usar CMEK o tus propias claves que administres con un método de administración externo, como las claves de encriptación proporcionadas por el cliente (CSEK). Para obtener más información, consulta Opciones de encriptación de datos.
- Control de acceso: Cloud Storage admite dos sistemas para otorgar permiso a los usuarios para acceder a tus buckets y objetos: IAM y las listas de control de acceso (LCA). En la mayoría de los casos, usa IAM, que te permite otorgar permisos a nivel de proyecto y de bucket. Para obtener más información, consulta Descripción general del control de acceso.
- Protección de datos: Los datos que cargas en el subsistema de transferencia de datos a través de Cloud Storage pueden incluir datos sensibles. Para proteger estos datos, puedes usar Sensitive Data Protection para descubrir, clasificar y desidentificar los datos. Para obtener más información, consulta Usa Sensitive Data Protection con Cloud Storage.
- Residencia de datos: Cloud Storage te ayuda a cumplir con los requisitos de residencia de datos. Los datos se almacenan o replican dentro de las regiones que especifiques.
Consideraciones de seguridad de Pub/Sub
Para asegurarte de que tu configuración de Pub/Sub cumpla con tus requisitos de seguridad, ten en cuenta las siguientes recomendaciones:
- Encriptación de datos: De forma predeterminada, Pub/Sub encripta todos los mensajes, tanto en reposo como en tránsito, con Google-owned and Google-managed encryption keys. Pub/Sub admite el uso de CMEK para la encriptación de mensajes en la capa de aplicación. Para obtener más información, consulta Configura la encriptación de mensajes.
- Residencia de datos: Si tienes requisitos de residencia de datos, para asegurarte de que los datos de los mensajes se almacenen en ubicaciones específicas, puedes configurar políticas de almacenamiento de mensajes.
Consideraciones de seguridad de Cloud Logging
Para asegurarte de que tu configuración de Cloud Logging cumpla con tus requisitos de seguridad, ten en cuenta los siguientes factores y recomendaciones de diseño:
- Auditoría de actividad administrativa: Los registros de auditoría de actividad del administrador están habilitados de forma predeterminada para todos los servicios de Google Cloud que se usan en esta arquitectura de referencia. En estos registros, se asientan las llamadas a la API y otras acciones que modifican la configuración o los metadatos de los recursos de Google Cloud .
- Auditoría de acceso a los datos: Los registros de auditoría de acceso a los datos están habilitados de forma predeterminada para BigQuery. Para los otros servicios que se usan en esta arquitectura, puedes habilitar los registros de auditoría de acceso a los datos. Los registros te permiten realizar un seguimiento de las llamadas a la API que leen la configuración o los metadatos de los recursos o las solicitudes del usuario para crear, modificar o leer datos de los recursos que proporciona el usuario.
- Residencia de datos: Para cumplir con los requisitos de residencia de datos, puedes configurar Cloud Logging para almacenar datos de registro en la región que especifiques. Para obtener más información, consulta Regionaliza los registros.
Para conocer los principios y las recomendaciones de seguridad específicos de las cargas de trabajo de IA y AA, consulta Perspectiva de IA y AA: Seguridad en el framework de arquitectura de Google Cloud.
Confiabilidad
En esta sección, se describen los factores de diseño que debes tener en cuenta para compilar y operar una infraestructura confiable para una aplicación de IA generativa compatible con RAG en Google Cloud.
Consideraciones de confiabilidad de Cloud Run Functions
Para garantizar que la implementación de Cloud Run Functions cumpla con tus requisitos de confiabilidad, ten en cuenta los siguientes factores de diseño y recomendaciones:
- Redundancia de zona: Las funciones de Cloud Run se ejecutan en varias zonas dentro de una región para proporcionar resiliencia integrada contra las interrupciones de zona.
- Manejo de fallas: Para controlar eventos duplicados o fallas transitorias de forma segura, escribe funciones idempotentes y configura reintentos de funciones controladas por eventos. Para aislar los mensajes que no se procesan de forma reiterada, configura un tema de mensajes no entregados de Pub/Sub.
Consideraciones de confiabilidad de AlloyDB
Para asegurarte de que tu configuración de AlloyDB cumpla con tus requisitos de confiabilidad, ten en cuenta los siguientes factores de diseño y recomendaciones:
- Alta disponibilidad: De forma predeterminada, los clústeres de AlloyDB proporcionan alta disponibilidad (HA) con conmutación por error automática. La instancia principal tiene nodos redundantes que se encuentran en dos zonas diferentes dentro de una región. Esta redundancia ayuda a garantizar que los clústeres sean resistentes a las interrupciones zonales.
- Recuperación ante desastres: Para planificar la recuperación ante interrupciones regionales, puedes usar la replicación entre regiones.
Consideraciones de confiabilidad de BigQuery
Los datos que cargas en BigQuery se almacenan de forma síncrona en dos zonas dentro de la región que especifiques. Esta redundancia ayuda a garantizar que tus datos no se pierdan cuando se produce una interrupción zonal. Para obtener más información sobre las funciones de confiabilidad en BigQuery, consulta Comprende la confiabilidad.
Consideraciones sobre la confiabilidad de Cloud Storage
Puedes crear buckets de Cloud Storage en uno de los siguientes tipos de ubicación: regional, birregional o multirregión. Los datos que se almacenan en buckets regionales se replican de forma síncrona en varias zonas dentro de una región. Para obtener una mayor disponibilidad, puedes usar buckets birregionales o multirregionales, en los que los datos se replican de manera asíncrona en todas las regiones.
Consideraciones de confiabilidad de Pub/Sub
Para asegurarte de que tu configuración de Pub/Sub cumpla con tus requisitos de confiabilidad, ten en cuenta las siguientes recomendaciones:
- Control de frecuencia: Para administrar los aumentos transitorios en el tráfico de mensajes, puedes configurar el control de flujo en la configuración del publicador.
- Control de errores: Para controlar las publicaciones con errores, ajusta las variables de solicitud de reintento según sea necesario. Para obtener más información, consulta Solicitudes de reintento.
Para obtener más información sobre las consideraciones específicas de la región, consulta Ubicación geográfica y regiones.
Para conocer los principios y las recomendaciones de confiabilidad específicos de las cargas de trabajo de IA y AA, consulta Perspectiva de IA y AA: Confiabilidad en el framework de arquitectura de Google Cloud.
Optimización de costos
En esta sección, se proporciona orientación para ayudarte a optimizar el costo de configurar y operar una aplicación de IA generativa compatible con RAG en Google Cloud.
Almacenamiento en caché de contexto de Agent Platform
Para reducir los costos de los tokens de entrada cuando las solicitudes de RAG repetidas comparten instrucciones del sistema grandes o contexto recuperado, usa el almacenamiento en caché de contexto.
Consideraciones de costo de AlloyDB
Para ayudar a optimizar el costo de AlloyDB, ten en cuenta las siguientes recomendaciones:
- Disponibilidad de la instancia: De forma predeterminada, una instancia principal de un clúster de AlloyDB tiene alta disponibilidad (HA). La instancia tiene un nodo activo y uno en espera. Si el nodo activo falla, AlloyDB realiza la conmutación por error automáticamente al nodo en espera. Si no necesitas alta disponibilidad para las bases de datos, puedes reducir los costos si conviertes la instancia principal del clúster en una instancia básica. Una instancia básica no es resiliente a las interrupciones zonales y tiene un tiempo de inactividad más prolongado durante las operaciones de mantenimiento. Para obtener más información, consulta Reduce los costos con instancias básicas.
- Optimización de tarifas: Si puedes predecir los requisitos de CPU y memoria de tu instancia de AlloyDB, puedes ahorrar dinero si obtienes descuentos por compromiso de uso. Para obtener más información, consulta Descuentos por compromiso de uso de AlloyDB.
Consideraciones sobre los costos de BigQuery
BigQuery te permite estimar el costo de las consultas antes de ejecutarlas. Para optimizar los costos de las consultas, debes optimizar el almacenamiento y el procesamiento de las consultas. Para obtener más información, consulta Estima y controla los costos.
Consideraciones de costos de Cloud Storage
Para el bucket de Cloud Storage que usas para cargar datos en el subsistema de ingesta de datos, elige una clase de almacenamiento adecuada según los requisitos de retención de datos y frecuencia de acceso de tus cargas de trabajo. Por ejemplo, para controlar los costos de almacenamiento, puedes elegir la clase Standard Storage y usar la Administración del ciclo de vida de los objetos. Este enfoque te permite cambiar automáticamente los objetos a una clase de almacenamiento de menor costo o borrar objetos según las condiciones que establezcas.
Consideraciones de costos de Cloud Logging
Para controlar el costo de almacenamiento de registros, ten en cuenta las siguientes recomendaciones:
- Reduce el volumen de los registros excluyendo o filtrando las entradas de registro innecesarias. Para obtener más información, consulta Filtros de receptores de registros.
- Reduce el período para el que se retienen las entradas de registro. Para obtener más información, consulta Configura la retención personalizada.
Para conocer los principios y las recomendaciones de optimización de costos específicos de las cargas de trabajo de IA y AA, consulta Perspectiva de IA y AA: Optimización de costos en el framework de buena arquitectura.
Rendimiento
En esta sección, se describen los factores que debes tener en cuenta cuando diseñas y compilas una aplicación de IA generativa compatible con RAG en Google Cloud que cumpla con tus requisitos de rendimiento.
Latencia de Cloud Run Functions
Para reducir la latencia de inicio en frío después de períodos de inactividad, configura una cantidad mínima de instancias.
Consideraciones sobre el rendimiento de AlloyDB
Para asegurarte de que tu configuración de AlloyDB cumpla con tus requisitos de rendimiento, ten en cuenta las siguientes recomendaciones:
- Indexación de vectores y motor de columnas: Para acelerar las consultas de similitud de vectores en las cargas de trabajo de RAG, crea un índice de vecino más cercano aproximado (ANN), como ScaNN o HNSW. Para obtener más información, consulta Elige una estrategia de índice. Para acelerar aún más los análisis de vectores y las consultas filtradas, consulta Acelera la búsqueda de vectores con el motor de columnas.
- Análisis del rendimiento de las consultas: Para ayudarte a analizar y mejorar el rendimiento de las consultas de las bases de datos, AlloyDB proporciona una herramienta de estadísticas de consultas. Puedes usar esta herramienta para supervisar el rendimiento y realizar un seguimiento de la fuente de una consulta problemática. Para obtener más información, consulta Acerca de las estadísticas de consultas.
- Supervisión de instancias: Para obtener una descripción general del estado y el rendimiento de tus bases de datos y ver métricas detalladas, como las conexiones máximas y el retraso máximo de replicación, puedes usar el panel de Estadísticas del sistema. Para obtener más información, consulta Supervisa una instancia con el panel de Estadísticas del sistema de AlloyDB.
- Escalamiento de lectura: Para reducir la carga en tu instancia principal de AlloyDB y escalar horizontalmente la capacidad para controlar solicitudes de lectura, puedes agregar instancias de grupo de lectura al clúster. Para obtener más información, consulta ¿Qué es una instancia de AlloyDB?.
Consideraciones sobre el rendimiento de BigQuery
Para asegurarte de que tu uso de BigQuery cumpla con tus requisitos de rendimiento, ten en cuenta las siguientes recomendaciones:
- Estadísticas de rendimiento de las consultas: BigQuery proporciona un gráfico de ejecución de consultas que puedes usar para analizar el rendimiento de las consultas y obtener estadísticas de rendimiento en cuanto a problemas como la contención de ranuras y la cuota de redistribución insuficiente. Para obtener más información, consulta Obtén estadísticas de rendimiento de las consultas.
- Optimización del procesamiento de consultas: Después de abordar los problemas que identificas a través de las estadísticas de rendimiento de las consultas, puedes optimizar aún más las consultas con técnicas como la reducción del volumen de datos de entrada y salida. Para obtener más información, consulta Optimiza el procesamiento de las consultas.
Consideraciones de rendimiento de Cloud Storage
Para subir archivos grandes, puedes usar un método llamado cargas compuestas en paralelo. Con esta estrategia, el archivo grande se divide en fragmentos. Los fragmentos se suben a Cloud Storage en paralelo y, luego, los datos se recomponen en la nube. Cuando el ancho de banda de red y la velocidad del disco no son factores limitantes, las cargas compuestas paralelas pueden ser más rápidas que las operaciones de carga normales. Sin embargo, esta estrategia tiene algunas implicaciones de costos y limitaciones. Para obtener más información, consulta la sección sobre cargas compuestas paralelas.
Para conocer los principios y las recomendaciones de optimización del rendimiento específicos de las cargas de trabajo de IA y ML, consulta Perspectiva de IA y ML: Optimización del rendimiento en Well-Architected Framework.
Implementación
Para comenzar y experimentar con la compilación de infraestructura en Google Cloud para aplicaciones de IA generativa compatibles con RAG, usa el código de muestra que está disponible en GitHub. Este código implementa una aplicación de chat basada en Python en Cloud Run y usa una base de datos de Cloud SQL completamente administrada para la búsqueda de vectores.
¿Qué sigue?
- Aplicación de RAG agéntica de AlloyDB con MCP Toolbox
- Infraestructura de RAG para IA generativa con Agent Platform y Vector Search
- Infraestructura de RAG para IA generativa con GKE y Cloud SQL
- Infraestructura de RAG para la IA generativa con Gemini Enterprise y Agent Platform
- Infraestructura de GraphRAG para IA generativa con Agent Platform y Spanner Graph
- Para obtener una descripción general de los principios y las recomendaciones de arquitectura específicos de las cargas de trabajo de IA y AA en Google Cloud, consulta la perspectiva de IA y AA en el framework de buena arquitectura.
- Para obtener más información sobre las arquitecturas de referencia, los diagramas y las prácticas recomendadas, explora Cloud Architecture Center.
Colaboradores
Autor: Kumar Dhanagopal | Desarrollador de soluciones entre productos
Otros colaboradores:
- Andrew Brook | Director de Ingeniería
- Anna Berenberg | Socio de Ingeniería
- Assaf Namer | Arquitecto principal de seguridad en la nube
- Balachandar Krishnamoorthy | Ingeniero principal de software
- Daniel Lees | Arquitecto de Seguridad en la Nube
- Derek Downey | Ingeniero de relaciones con desarrolladores
- Eran Lewis | Gerente de producto sénior
- Geoffrey Anderson | Gerente de producto
- Gleb Otochkin | Cloud Advocate, bases de datos
- Hamsa Buvaraghan | Gerenta de productos de IA
- Irina Sigler | Gerenta de producto
- Jack Wotherspoon | Developer Advocate
- Jason Davenport | Developers Advocate
- Jordan Totten | Ingeniero de Atención al cliente
- Julia Wiesinger | Gerenta de producto
- Kara Greenfield | Ingeniera de Atención al cliente
- Kurtis Van Gent | Ingeniero de software de personal
- Per Jacobsson | Ingeniero de software
- Pranav Nambiar Director
- Richard Hendricks | Personal del centro de arquitectura
- Safiuddin Khaja | Ingeniero de la nube
- Sandy Ghai | Gerente de grupo de productos
- Vladimir Vuskovic | Director de administración de productos
- Steren Giannini | Gerente de grupo de productos
- Wietse Venema Ingeniero de relaciones con desarrolladores