


Die Säule „Zuverlässigkeit“ im Google Cloud Well-Architected Framework bietet Prinzipien und Empfehlungen, mit denen Sie zuverlässige Arbeitslasten in Google Cloudentwerfen, bereitstellen und verwalten können.
Dieses Dokument richtet sich an Cloud-Architekten, Entwickler, Plattform-Engineers, Administratoren und Site Reliability Engineers.
Zuverlässigkeit ist die Fähigkeit eines Systems, seine beabsichtigten Funktionen unter den definierten Bedingungen konsistent auszuführen und einen unterbrechungsfreien Dienst aufrechtzuerhalten. Best Practices für die Zuverlässigkeit umfassen Redundanz, fehlertolerantes Design, Monitoring und automatisierte Wiederherstellungsprozesse.
Resilienz ist die Fähigkeit des Systems, Fehler oder unerwartete Störungen zu überstehen und sich davon zu erholen, während die Leistung aufrechterhalten wird. Google Cloud Funktionen wie multiregionale Bereitstellungen, automatisierte Back-ups und Lösungen zur Notfallwiederherstellung können Ihnen helfen, die Resilienz Ihres Systems zu verbessern.
Zuverlässigkeit ist aus vielen Gründen wichtig für Ihre Cloud-Strategie, darunter:
- Minimale Ausfallzeiten: Ausfallzeiten können zu Umsatzverlusten, geringerer Produktivität und Rufschädigung führen. Ausfallsichere Architekturen können dazu beitragen, dass Systeme bei Ausfällen weiter funktionieren oder sich effizient von Ausfällen erholen.
- Verbesserte Nutzerfreundlichkeit: Nutzer erwarten eine nahtlose Interaktion mit Technologie. Ausfallsichere Systeme können dazu beitragen, eine konsistente Leistung und Verfügbarkeit aufrechtzuerhalten, und bieten auch bei hoher Nachfrage oder unerwarteten Problemen einen zuverlässigen Dienst.
- Datenintegrität: Fehler können zu Datenverlust oder Datenbeschädigung führen. Ausfallsichere Systeme implementieren Mechanismen wie Sicherungen, Redundanz und Replikation, um Daten zu schützen und dafür zu sorgen, dass sie korrekt und zugänglich bleiben.
- Geschäftskontinuität: Ihr Unternehmen ist für wichtige Vorgänge auf Technologie angewiesen. Robuste Architekturen können dazu beitragen, die Kontinuität nach einem katastrophalen Ausfall sicherzustellen. So können Geschäftsfunktionen ohne größere Unterbrechungen fortgesetzt werden und eine schnelle Wiederherstellung wird unterstützt.
- Compliance: In vielen Branchen gibt es gesetzliche Anforderungen an die Systemverfügbarkeit und den Datenschutz. Ausfallsichere Architekturen können Ihnen helfen, diese Standards zu erfüllen, da sie dafür sorgen, dass Systeme betriebsbereit und sicher bleiben.
- Niedrigere langfristige Kosten: Ausfallsichere Architekturen erfordern Vorabinvestitionen. Die Ausfallsicherheit kann jedoch im Laufe der Zeit dazu beitragen, die Kosten zu senken, da teure Ausfallzeiten vermieden, reaktive Fehlerbehebungen vermieden und Ressourcen effizienter genutzt werden können.
Organisatorische Denkweise
Damit Ihre Systeme zuverlässig sind, benötigen Sie einen Plan und eine etablierte Strategie. Diese Strategie muss Schulungen und die Befugnis umfassen, die Zuverlässigkeit neben anderen Initiativen zu priorisieren.
Legen Sie die klare Erwartung fest, dass die gesamte Organisation für die Zuverlässigkeit verantwortlich ist, einschließlich Entwicklung, Produktmanagement, Betrieb, Plattform-Engineering und Site Reliability Engineering (SRE). Auch geschäftsorientierte Gruppen wie Marketing und Vertrieb können die Zuverlässigkeit beeinflussen.
Jedes Team muss die Zuverlässigkeitsziele und Risiken seiner Anwendungen kennen. Die Teams müssen für diese Anforderungen verantwortlich sein. Konflikte zwischen Zuverlässigkeit und regulärer Produktfeature-Entwicklung müssen priorisiert und entsprechend eskaliert werden.
Planen und verwalten Sie die Zuverlässigkeit ganzheitlich über alle Funktionen und Teams hinweg. Erwägen Sie die Einrichtung eines Cloud-Kompetenzzentrums (Cloud Centre of Excellence, CCoE), das eine Zuverlässigkeitssäule umfasst. Weitere Informationen finden Sie unter Cloud-Kompetenzzentrum zur Optimierung der Cloud Journey Ihrer Organisation.
Fokusbereiche für Zuverlässigkeit
Die Aktivitäten, die Sie zum Entwerfen, Bereitstellen und Verwalten eines zuverlässigen Systems ausführen, können in die folgenden Schwerpunktbereiche unterteilt werden. Jedes der Zuverlässigkeitsprinzipien und jede der Empfehlungen in dieser Säule bezieht sich auf einen dieser Schwerpunktbereiche.
- Umfang: Führen Sie eine detaillierte Analyse der Architektur Ihres Systems durch, um es zu verstehen. Sie müssen die Komponenten verstehen, wie sie funktionieren und interagieren, wie Daten und Aktionen durch das System fließen und was schiefgehen könnte. Identifizieren Sie potenzielle Fehler, Engpässe und Risiken, um Maßnahmen zur Behebung dieser Probleme zu ergreifen.
- Beobachtung: Implementieren Sie eine umfassende und kontinuierliche Beobachtung und Überwachung, um Systemfehler zu vermeiden. Anhand dieser Beobachtung können Sie Trends erkennen und potenzielle Probleme proaktiv identifizieren.
- Reaktion: Um die Auswirkungen von Fehlern zu reduzieren, sollten Sie angemessen reagieren und effizient wiederherstellen. Automatisierte Antworten können auch dazu beitragen, die Auswirkungen von Fehlern zu reduzieren. Auch bei Planung und Kontrollen können Fehler auftreten.
- Lernen: Um zu verhindern, dass Fehler wieder auftreten, sollten Sie aus jeder Erfahrung lernen und entsprechende Maßnahmen ergreifen.
Arbeitslasten mit einem Agent-Skill bewerten
Wenn Sie KI-Agents Ihre Cloud-Workloads anhand der Grundsätze und Empfehlungen in dieser Säule bewerten lassen möchten, verwenden Sie den Skill google-cloud-waf-reliability, der im Google Agent Skills-Repository auf GitHub verfügbar ist.
Führen Sie den folgenden Befehl im Client oder Terminal Ihres Agenten aus, um den Skill zu installieren:
npx skills add google/skills --skill google-cloud-waf-reliability
Geben Sie bei Aufforderung die KI-Agents an, für die Sie die Skill installieren möchten, und legen Sie den Installationsbereich (Projekt oder global) fest.
Grundprinzipien
Die Empfehlungen im Bereich „Zuverlässigkeit“ des Well-Architected Frameworks sind den folgenden Grundprinzipien zugeordnet:
- Zuverlässigkeit anhand von Zielen für die Nutzererfahrung definieren
- Realistische Zuverlässigkeitsziele festlegen
- Hochverfügbare Systeme durch Ressourcenredundanz erstellen
- Horizontale Skalierbarkeit nutzen
- Potenzielle Fehler mithilfe von Beobachtbarkeit erkennen
- Graceful Degradation
- Tests zur Wiederherstellung nach Fehlern durchführen
- Wiederherstellung nach Datenverlust testen
- Führen Sie gründliche Postmortems durch
Beitragende
Autor*innen:
- Laura Hyatt | Customer Engineer, FSI
- Jose Andrade | Customer Engineer, SRE Specialist
- Gino Pelliccia | Principal Architect
Weitere Beitragende:
- Andrés-Leonardo Martínez-Ortiz | Technical Program Manager
- Brian Kudzia | Enterprise Infrastructure Customer Engineer
- Daniel Lees | Cloudsicherheitsarchitekt
- Filipe Gracio, PhD | Customer Engineer, AI/ML Specialist
- Gary Harmson | Principal Architect
- Kumar Dhanagopal | Cross-Product Solution Developer
- Marwan Al Shawi | Partner Customer Engineer
- Nicolas Pintaux | Customer Engineer, Application Modernization Specialist
- Radhika Kanakam | Program Lead, Google Cloud Well-Architected Framework
- Ryan Cox | Principal Architect
- Samantha He | Technical Writer
- Wade Holmes | Global Solutions Director
- Zach Seils | Networking Specialist
Zuverlässigkeit basierend auf Zielen für die Nutzererfahrung definieren
Dieses Prinzip in der Zuverlässigkeitssäule des Google Cloud Well-Architected Framework hilft Ihnen, die Nutzerfreundlichkeit zu bewerten und die Ergebnisse dann Zuverlässigkeitszielen und ‑messwerten zuzuordnen.
Dieses Prinzip ist für den Schwerpunktbereich Umfang der Zuverlässigkeit relevant.
Grundsatzübersicht
Beobachtbarkeitstools liefern große Datenmengen, aber nicht alle Daten beziehen sich direkt auf die Auswirkungen auf die Nutzer. Beispielsweise können Sie eine hohe CPU-Auslastung, langsame Servervorgänge oder sogar abgestürzte Aufgaben beobachten. Wenn diese Probleme jedoch die Nutzererfahrung nicht beeinträchtigen, stellen sie keinen Ausfall dar.
Um die Nutzererfahrung zu messen, müssen Sie zwischen dem internen Systemverhalten und für Nutzer sichtbaren Problemen unterscheiden. Konzentrieren Sie sich auf Messwerte wie die Erfolgsrate von Nutzeranfragen. Verlassen Sie sich nicht nur auf serverorientierte Messwerte wie die CPU-Auslastung, da dies zu irreführenden Schlussfolgerungen über die Zuverlässigkeit Ihres Dienstes führen kann. Echte Zuverlässigkeit bedeutet, dass Nutzer Ihre Anwendung oder Ihren Dienst konsistent und effektiv verwenden können.
Empfehlungen
Die Empfehlungen in den folgenden Abschnitten können Ihnen helfen, die Nutzerfreundlichkeit effektiv zu messen.
Nutzererfahrung messen
Wenn Sie die Zuverlässigkeit Ihres Dienstes wirklich verstehen möchten, sollten Sie Messwerte priorisieren, die die tatsächliche Nutzererfahrung widerspiegeln. Messen Sie beispielsweise die Erfolgsrate von Nutzeranfragen, die Anwendungslatenz und die Fehlerraten.
Im Idealfall werden diese Daten direkt vom Gerät oder Browser des Nutzers erhoben. Wenn diese direkte Datenerhebung nicht möglich ist, verschieben Sie den Messpunkt im System schrittweise weiter vom Nutzer weg. Sie können beispielsweise den Load Balancer oder den Frontend-Dienst als Messpunkt verwenden. So können Sie Probleme erkennen und beheben, bevor sie sich erheblich auf Ihre Nutzer auswirken.
User Journeys analysieren
Wenn Sie wissen möchten, wie Nutzer mit Ihrem System interagieren, können Sie Tracing-Tools wie Cloud Trace verwenden. Wenn Sie die User Journey durch Ihre Anwendung verfolgen, können Sie Engpässe und Latenzprobleme finden, die die Nutzerfreundlichkeit beeinträchtigen könnten. Cloud Trace erfasst detaillierte Leistungsdaten für jeden Hop in Ihrer Dienstarchitektur. Anhand dieser Daten können Sie Leistungsprobleme effizienter erkennen und beheben, was zu einer zuverlässigeren und zufriedenstellenderen Nutzererfahrung führen kann.
Realistische Ziele für die Zuverlässigkeit festlegen
Dieses Prinzip in der Zuverlässigkeitssäule des Google Cloud Well-Architected Framework hilft Ihnen, Zuverlässigkeitsziele zu definieren, die für Ihre Arbeitslasten in Google Cloudtechnisch machbar sind.
Dieses Prinzip ist für den Umfang des Fokusbereichs „Zuverlässigkeit“ relevant.
Übersicht über die Prinzipien
Gestalten Sie Ihre Systeme so, dass sie gerade zuverlässig genug sind, um Nutzer zufrieden zu machen. Es mag unlogisch klingen, aber ein Ziel von 100% Zuverlässigkeit ist oft nicht die effektivste Strategie. Eine höhere Zuverlässigkeit kann zu deutlich höheren Kosten führen, sowohl in Bezug auf finanzielle Investitionen als auch auf potenzielle Einschränkungen bei Innovationen. Wenn die Nutzer bereits mit dem aktuellen Servicelevel zufrieden sind, können Bemühungen, die Zufriedenheit weiter zu steigern, zu einer geringen Rendite führen. Stattdessen können Sie Ressourcen besser für andere Dinge einsetzen.
Sie müssen das Maß an Zuverlässigkeit ermitteln, mit dem Ihre Nutzer zufrieden sind, und den Punkt bestimmen, an dem die Kosten für inkrementelle Verbesserungen die Vorteile überwiegen. Wenn Sie dieses Maß an ausreichender Zuverlässigkeit ermittelt haben, können Sie Ressourcen strategisch zuweisen und sich auf Funktionen und Verbesserungen konzentrieren, die Ihren Nutzern einen größeren Mehrwert bieten.
Empfehlungen
Beachten Sie die Empfehlungen in den folgenden Unterabschnitten, um realistische Zuverlässigkeitsziele festzulegen.
Einige Fehler akzeptieren und Komponenten priorisieren
Streben Sie eine Hochverfügbarkeit wie 99,99% Betriebszeit an, aber legen Sie kein Ziel von 100 % Betriebszeit fest. Erkenne an, dass einige Fehler unvermeidlich sind.
Die Differenz zwischen 100% Verfügbarkeit und einem Ziel von 99,99% ist die Toleranz für Fehler. Diese Lücke wird oft als Fehlerbudget bezeichnet. Das Fehlerbudget kann Ihnen helfen, Risiken einzugehen und Innovationen zu entwickeln. Das ist für jedes Unternehmen wichtig, um wettbewerbsfähig zu bleiben.
Priorisieren Sie die Zuverlässigkeit der wichtigsten Komponenten im System. Akzeptieren Sie, dass weniger kritische Komponenten eine höhere Fehlertoleranz haben können.
Zuverlässigkeit und Kosten in Einklang bringen
Führen Sie gründliche Kosten-Nutzen-Analysen durch, um das optimale Zuverlässigkeitsniveau für Ihr System zu ermitteln.
Berücksichtigen Sie Faktoren wie Systemanforderungen, die Folgen von Fehlern und die Risikobereitschaft Ihres Unternehmens für die jeweilige Anwendung. Berücksichtigen Sie Ihre Messwerte für die Notfallwiederherstellung, z. B. das Recovery Time Objective (RTO) und das Recovery Point Objective (RPO). Entscheiden Sie, welches Zuverlässigkeitsniveau im Rahmen des Budgets und anderer Einschränkungen akzeptabel ist.
Suchen Sie nach Möglichkeiten, die Effizienz zu verbessern und die Kosten zu senken, ohne dabei auf wichtige Zuverlässigkeitsfunktionen zu verzichten.
Hochverfügbare Systeme durch Ressourcenredundanz erstellen
Dieses Prinzip in der Zuverlässigkeitssäule des Google Cloud Well-Architected Framework enthält Empfehlungen zum Planen, Erstellen und Verwalten von Ressourcenredundanz, mit denen Sie Ausfälle vermeiden können.
Dieses Prinzip ist für den Schwerpunktbereich Umfang der Zuverlässigkeit relevant.
Übersicht über die Prinzipien
Nachdem Sie sich für ein Zuverlässigkeitsniveau entschieden haben, müssen Sie Ihre Systeme so entwerfen, dass Single Points of Failure vermieden werden. Jede kritische Komponente im System muss auf mehreren Maschinen, in mehreren Zonen und in mehreren Regionen repliziert werden. Eine kritische Datenbank darf sich beispielsweise nicht nur in einer Region befinden und ein Metadatenserver darf nicht nur in einer einzelnen Zone oder Region bereitgestellt werden. Wenn in diesen Beispielen die einzige Zone oder Region einen Ausfall hat, hat das System einen globalen Ausfall.
Empfehlungen
Beachten Sie beim Erstellen redundanter Systeme die Empfehlungen in den folgenden Unterabschnitten.
Ausfalldomänen identifizieren und Dienste replizieren
Erstellen Sie eine Übersicht über die fehlerhaften Domains Ihres Systems, von einzelnen VMs bis hin zu Regionen, und sorgen Sie für Redundanz in den fehlerhaften Domains.
Um Hochverfügbarkeit zu gewährleisten, sollten Sie Ihre Dienste und Anwendungen auf mehrere Zonen und Regionen verteilen und replizieren. Konfigurieren Sie das System für ein automatisches Failover, damit die Dienste und Anwendungen auch bei Ausfällen von Zonen oder Regionen verfügbar bleiben.
Beispiele für multizonale und multiregionale Architekturen finden Sie unter Zuverlässige Infrastruktur für Ihre Arbeitslasten in Google Cloud entwerfen.
Probleme rechtzeitig erkennen und beheben
Überwachen Sie kontinuierlich den Status Ihrer Fehlerbereiche, um Probleme rechtzeitig zu erkennen und zu beheben.
Sie können den aktuellen Status von Google Cloud -Diensten in allen Regionen mithilfe des Google Cloud Service Health-Dashboards überwachen. Sie können auch Vorfälle, die für Ihr Projekt relevant sind, mit Personal Service Health anzeigen. Sie können Load Balancer verwenden, um den Zustand von Ressourcen zu ermitteln und Traffic automatisch an fehlerfreie Backends weiterzuleiten. Weitere Informationen finden Sie unter Systemdiagnosen – Übersicht.
Failover-Szenarien testen
Simulieren Sie regelmäßig Fehler, um die Effektivität Ihrer Replikations- und Failover-Strategien zu prüfen.
Weitere Informationen finden Sie unter Ausfall einer Zone für eine regionale MIG simulieren und Zonenausfall in regionalen GKE-Clustern simulieren.
Horizontale Skalierbarkeit nutzen
Dieses Prinzip im Zuverlässigkeitsbereich des Google Cloud Well-Architected Framework enthält Empfehlungen zur Verwendung horizontaler Skalierbarkeit. Durch die horizontale Skalierbarkeit können Sie dafür sorgen, dass Ihre Arbeitslasten inGoogle Cloud effizient skaliert werden und die Leistung beibehalten wird.
Dieses Prinzip ist für den Umfang des Fokusbereichs „Zuverlässigkeit“ relevant.
Übersicht über die Prinzipien
Strukturieren Sie Ihr System in eine horizontale Architektur um. Wenn der Traffic oder die Datenmenge zunimmt, können Sie weitere Ressourcen hinzufügen. Sie können Ressourcen auch entfernen, wenn sie nicht verwendet werden.
Um den Wert der horizontalen Skalierung zu verstehen, sollten Sie die Einschränkungen der vertikalen Skalierung berücksichtigen.
Ein gängiges Szenario für die vertikale Skalierung ist die Verwendung einer MySQL-Datenbank als primäre Datenbank mit kritischen Daten. Mit zunehmender Datenbanknutzung sind mehr RAM und CPU erforderlich. Irgendwann erreicht die Datenbank das Speicherlimit auf dem Hostcomputer und muss aktualisiert werden. Möglicherweise müssen Sie diesen Vorgang mehrmals wiederholen. Das Problem ist, dass es feste Limits für das Wachstum einer Datenbank gibt. VM-Größen sind nicht unbegrenzt. Die Datenbank kann einen Punkt erreichen, an dem es nicht mehr möglich ist, weitere Ressourcen hinzuzufügen.
Selbst wenn die Ressourcen unbegrenzt wären, kann eine große VM zu einem Single Point of Failure werden. Probleme mit der primären Datenbank-VM können zu Fehlerantworten oder zu einem systemweiten Ausfall führen, der alle Nutzer betrifft. Vermeiden Sie Single Points of Failure, wie unter Hochverfügbare Systeme durch Ressourcenredundanz erstellen beschrieben.
Neben diesen Skalierungslimits ist die vertikale Skalierung in der Regel teurer. Die Kosten können exponentiell steigen, wenn Maschinen mit mehr Rechenleistung und Arbeitsspeicher erworben werden.
Die horizontale Skalierung kann dagegen weniger kosten. Das Potenzial für die horizontale Skalierung ist in einem System, das für die Skalierung konzipiert ist, nahezu unbegrenzt.
Empfehlungen
Um von einer Architektur mit einer einzelnen VM zu einer horizontalen Architektur mit mehreren Maschinen zu wechseln, müssen Sie sorgfältig planen und die richtigen Tools verwenden. Beachten Sie die Empfehlungen in den folgenden Unterabschnitten, um eine horizontale Skalierung zu erreichen.
Verwaltete Dienste verwenden
Bei verwalteten Diensten ist keine manuelle Verwaltung der horizontalen Skalierung erforderlich. Mit verwalteten Compute Engine-Instanzgruppen (MIGs) können Sie beispielsweise VMs hinzufügen oder entfernen, um Ihre Anwendung horizontal zu skalieren. Für containerisierte Anwendungen ist Cloud Run eine serverlose Plattform, die Ihre zustandslosen Container automatisch anhand des eingehenden Traffics skalieren kann.
Modulares Design fördern
Dank modularer Komponenten und klarer Schnittstellen können Sie einzelne Komponenten nach Bedarf skalieren, anstatt die gesamte Anwendung zu skalieren. Weitere Informationen finden Sie unter Modulares Design fördern im Pillar zur Leistungsoptimierung.
Zustandslose Architektur implementieren
Entwickeln Sie Anwendungen so, dass sie zustandslos sind, d. h., dass keine Daten lokal gespeichert werden. So können Sie Instanzen hinzufügen oder entfernen, ohne sich Gedanken über die Datenkonsistenz machen zu müssen.
Potenzielle Fehler mithilfe von Beobachtbarkeit erkennen
Dieses Prinzip in der Zuverlässigkeitssäule des Google Cloud Well-Architected Framework enthält Empfehlungen, mit denen Sie Bereiche, in denen Fehler und Ausfälle auftreten können, proaktiv identifizieren können.
Dieses Prinzip ist für den Schwerpunktbereich Beobachtung der Zuverlässigkeit relevant.
Grundsatzübersicht
Um die Zuverlässigkeit Ihrer Arbeitslasten inGoogle Cloudaufrechtzuerhalten und zu verbessern, müssen Sie eine effektive Beobachtbarkeit mithilfe von Messwerten, Logs und Traces implementieren.
- Messwerte sind numerische Messungen von Aktivitäten, die Sie für Ihre Anwendung in bestimmten Zeitintervallen erfassen möchten. Sie können beispielsweise technische Messwerte wie Anforderungsrate und Fehlerrate erfassen, die als Service Level Indicators (SLIs) verwendet werden können. Möglicherweise müssen Sie auch anwendungsspezifische Geschäftsmesswerte wie aufgegebene Bestellungen und eingegangene Zahlungen erfassen.
- Logs sind mit Zeitstempeln versehene Aufzeichnungen einzelner Ereignisse, die in einer Anwendung oder einem System auftreten. Das Ereignis kann ein Fehler oder eine Statusänderung sein. Protokolle können Messwerte enthalten und Sie können Protokolle auch für SLIs verwenden.
- Ein Trace stellt den Weg eines einzelnen Nutzers oder einer einzelnen Transaktion durch mehrere separate Anwendungen oder die Komponenten einer Anwendung dar. Diese Komponenten können beispielsweise Mikrodienste sein. Mithilfe von Traces können Sie nachvollziehen, welche Komponenten in den Abläufen verwendet wurden, wo Engpässe bestehen und wie lange die Abläufe gedauert haben.
Messwerte, Logs und Traces helfen Ihnen, Ihr System kontinuierlich zu überwachen. Durch umfassende Überwachung können Sie herausfinden, wo und warum Fehler aufgetreten sind. Außerdem können Sie potenzielle Fehler erkennen, bevor sie auftreten.
Empfehlungen
Beachten Sie die Empfehlungen in den folgenden Unterabschnitten, um potenzielle Fehler effizient zu erkennen.
Umfassende Einblicke erhalten
Verwenden Sie Cloud Monitoring und Cloud Logging, um wichtige Messwerte wie Antwortzeiten und Fehlerraten zu verfolgen. Mit diesen Tools können Sie auch dafür sorgen, dass die Messwerte den Anforderungen Ihrer Arbeitslast entsprechen.
Um datengestützte Entscheidungen zu treffen, analysieren Sie die Standardmesswerte für Dienste, um die Abhängigkeiten von Komponenten und ihre Auswirkungen auf die Gesamtleistung der Arbeitslast zu verstehen.
Wenn Sie Ihre Monitoring-Strategie anpassen möchten, können Sie mit dem Google Cloud SDK eigene Messwerte erstellen und veröffentlichen.
Proaktive Fehlerbehebung durchführen
Implementieren Sie eine robuste Fehlerbehandlung und aktivieren Sie das Logging für alle Komponenten Ihrer Arbeitslasten in Google Cloud. Aktivieren Sie Logs wie Cloud Storage-Zugriffslogs und VPC-Flusslogs.
Berücksichtigen Sie beim Konfigurieren der Protokollierung die damit verbundenen Kosten. Wenn Sie die Logging-Kosten kontrollieren möchten, können Sie Ausschlussfilter für die Logsenken konfigurieren, um bestimmte Logs von der Speicherung auszuschließen.
Ressourcennutzung optimieren
Überwachen Sie die CPU-Auslastung, Netzwerk-E/A-Messwerte und Laufwerk-E/A-Messwerte, um unter- und überdimensionierte Ressourcen in Diensten wie GKE, Compute Engine und Managed Service for Apache Spark zu erkennen. Eine vollständige Liste der unterstützten Dienste finden Sie unter Cloud Monitoring – Übersicht.
Benachrichtigungen priorisieren
Konzentrieren Sie sich bei Benachrichtigungen auf wichtige Messwerte, legen Sie geeignete Grenzwerte fest, um die Anzahl der Benachrichtigungen zu minimieren, und sorgen Sie dafür, dass rechtzeitig auf wichtige Probleme reagiert wird. Mit diesem gezielten Ansatz können Sie die Zuverlässigkeit von Arbeitslasten proaktiv aufrechterhalten. Weitere Informationen finden Sie unter Benachrichtigungen – Übersicht.
Design für graduelle Fehlertoleranz
Dieses Prinzip im Zuverlässigkeitsbereich des Google Cloud Well-Architected Framework enthält Empfehlungen, mit denen Sie Ihre Google Cloud Arbeitslasten so gestalten können, dass sie im Fehlerfall ordnungsgemäß heruntergefahren werden.
Dieses Prinzip ist für den Schwerpunktbereich Reaktion der Zuverlässigkeit relevant.
Übersicht über die Prinzipien
Die graduelle Fehlertoleranz ist ein Designansatz, bei dem ein System, das einer hohen Last ausgesetzt ist, weiterhin funktioniert, möglicherweise mit reduzierter Leistung oder Genauigkeit. Die graduelle Fehlertoleranz sorgt für die kontinuierliche Verfügbarkeit des Systems und verhindert einen vollständigen Ausfall, auch wenn die Arbeit des Systems nicht optimal ist. Wenn die Last wieder auf ein überschaubares Niveau sinkt, wird die volle Funktionalität des Systems wiederhergestellt.
Bei hoher Last priorisiert die Google Suche beispielsweise Ergebnisse von Webseiten mit einem höheren Ranking, was möglicherweise zu Lasten der Genauigkeit geht. Wenn die Last abnimmt, berechnet die Google Suche die Suchergebnisse neu.
Empfehlungen
Beachten Sie die Empfehlungen in den folgenden Abschnitten, um Ihre Systeme für eine graduelle Fehlertoleranz zu entwerfen.
Drosselung implementieren
Achten Sie darauf, dass Ihre Replikate Überlastungen selbstständig bewältigen und eingehende Anfragen in Szenarien mit hohem Traffic drosseln können. So lassen sich kaskadierende Fehler vermeiden, die durch die Verlagerung von übermäßigem Traffic zwischen Zonen verursacht werden.
Verwenden Sie Tools wie Apigee, um die Rate der API-Anfragen in Zeiten mit hohem Traffic zu steuern. Sie können Richtlinienregeln so konfigurieren, dass sie widerspiegeln, wie Sie Anfragen reduzieren möchten.
Überflüssige Anfragen frühzeitig löschen
Konfigurieren Sie Ihre Systeme so, dass überzählige Anfragen auf der Frontend-Ebene verworfen werden, um Backend-Komponenten zu schützen. Durch das Verwerfen einiger Anfragen werden globale Fehler verhindert und das System kann sich besser erholen.Bei diesem Ansatz können bei einigen Nutzern Fehler auftreten. Sie können jedoch die Auswirkungen von Ausfällen minimieren, im Gegensatz zu einem Ansatz wie Leistungsschutzschalter, bei dem der gesamte Traffic während einer Überlastung verworfen wird.
Teilfehler und Wiederholungsversuche verarbeiten
Erstellen Sie Ihre Anwendungen so, dass sie Teilfehler und Wiederholungsversuche nahtlos verarbeiten können. Dieses Design sorgt dafür, dass in Szenarien mit hoher Last so viel Traffic wie möglich verarbeitet wird.
Überlastungsszenarien testen
Um zu prüfen, ob die Drosselungs- und Anforderungsablehnungsmechanismen effektiv funktionieren, sollten Sie regelmäßig Überlastungsbedingungen in Ihrem System simulieren. Durch Tests können Sie sicherstellen, dass Ihr System auf reale Traffic-Spitzen vorbereitet ist.
Trafficspitzen beobachten
Verwenden Sie Analyse- und Monitoringtools, um Traffic-Spitzen vorherzusagen und darauf zu reagieren, bevor sie zu Überlastungen führen. Eine frühzeitige Erkennung und Reaktion kann dazu beitragen, die Verfügbarkeit von Diensten in Zeiten hoher Nachfrage aufrechtzuerhalten.
Tests zur Wiederherstellung nach Fehlern durchführen
Dieses Prinzip im Zuverlässigkeitsbereich des Google Cloud Well-Architected Framework enthält Empfehlungen, mit denen Sie Tests für die Wiederherstellung im Fehlerfall entwerfen und ausführen können.
Dieses Prinzip ist für den Lernbereich Zuverlässigkeit relevant.
Grundsatzübersicht
Damit Ihr System nach Fehlern wiederhergestellt werden kann, müssen Sie regelmäßig Tests durchführen, die regionale Failover, Release-Rollbacks und die Wiederherstellung von Daten aus Sicherungen umfassen.
Mit diesen Tests können Sie Reaktionen auf Ereignisse üben, die ein großes Risiko für die Zuverlässigkeit darstellen, z. B. den Ausfall einer gesamten Region. Mit diesen Tests können Sie auch prüfen, ob sich Ihr System bei einer Störung wie vorgesehen verhält.
Im unwahrscheinlichen Fall, dass eine gesamte Region ausfällt, müssen Sie den gesamten Traffic auf eine andere Region umleiten. Wenn Daten während des normalen Betriebs Ihrer Arbeitslast geändert werden, müssen sie von der primären Region mit der Failover-Region synchronisiert werden. Sie müssen prüfen, ob die replizierten Daten immer sehr aktuell sind, damit Nutzer keinen Datenverlust oder Sitzungsabbruch erleiden. Das Load-Balancing-System muss außerdem jederzeit ohne Dienstunterbrechungen Traffic in die Failover-Region verschieben können. Um Ausfallzeiten nach einem regionalen Ausfall zu minimieren, müssen Betriebsingenieure auch in der Lage sein, den Nutzer-Traffic manuell und effizient von einer Region wegzuleiten – und zwar so schnell wie möglich. Dieser Vorgang wird manchmal als Region leeren bezeichnet. Das bedeutet, dass Sie den eingehenden Traffic für die Region beenden und den gesamten Traffic an einen anderen Ort verschieben.
Empfehlungen
Beachten Sie beim Entwerfen und Ausführen von Tests zur Fehlerbehebung die Empfehlungen in den folgenden Abschnitten.
Testziele und -umfang definieren
Definieren Sie klar, was Sie mit den Tests erreichen möchten. Ihre Ziele können beispielsweise Folgendes umfassen:
- Validieren Sie das Recovery Time Objective (RTO) und das Recovery Point Objective (RPO). Weitere Informationen finden Sie unter Grundlagen der Planung der Notfallwiederherstellung.
- Bewerten Sie die Ausfallsicherheit und Fehlertoleranz des Systems in verschiedenen Fehlerszenarien.
- Testen Sie die Effektivität automatisierter Failover-Mechanismen.
Legen Sie fest, welche Komponenten, Dienste oder Regionen im Testumfang enthalten sind. Der Bereich kann bestimmte Anwendungsebenen wie das Frontend, das Backend und die Datenbank oder bestimmte Google Cloud -Ressourcen wie Cloud SQL-Instanzen oder GKE-Cluster umfassen. Im Umfang müssen auch alle externen Abhängigkeiten angegeben werden, z. B. APIs von Drittanbietern oder Cloud-Interconnect-Verbindungen.
Umgebung für Tests vorbereiten
Wählen Sie eine geeignete Umgebung aus, vorzugsweise eine Staging- oder Sandbox-Umgebung, die Ihre Produktionsumgebung repliziert. Wenn Sie den Test in der Produktion durchführen, sollten Sie Sicherheitsmaßnahmen wie automatisches Monitoring und manuelle Rollback-Verfahren bereithalten.
Erstellen Sie einen Sicherungsplan. Erstellen Sie Snapshots oder Back-ups von kritischen Datenbanken und Diensten, um Datenverlust während des Tests zu verhindern. Sorgen Sie dafür, dass Ihr Team bereit ist, manuell einzugreifen, wenn die automatisierten Failover-Mechanismen fehlschlagen.
Achten Sie darauf, dass Ihre IAM-Rollen, Richtlinien und Failover-Konfigurationen korrekt eingerichtet sind, um Unterbrechungen des Tests zu vermeiden. Prüfen Sie, ob die erforderlichen Berechtigungen für die Testtools und -skripts vorhanden sind.
Informieren Sie Stakeholder, einschließlich Betrieb, DevOps und Anwendungsinhaber, über den Testzeitplan, den Umfang und die potenziellen Auswirkungen. Stellen Sie den Stakeholdern einen geschätzten Zeitplan und die erwarteten Verhaltensweisen während des Tests zur Verfügung.
Fehlerszenarien simulieren
Planen und führen Sie Fehler mithilfe von Tools wie Chaos Monkey aus. Sie können benutzerdefinierte Skripts verwenden, um Fehler kritischer Dienste zu simulieren, z. B. das Herunterfahren eines primären Knotens in einem GKE-Cluster mit mehreren Zonen oder eine deaktivierte Cloud SQL-Instanz. Sie können auch Skripts verwenden, um einen regionsweiten Netzwerkausfall mithilfe von Firewallregeln oder API-Einschränkungen basierend auf Ihrem Testumfang zu simulieren. Eskalieren Sie die Fehlerszenarien schrittweise, um das Systemverhalten unter verschiedenen Bedingungen zu beobachten.
Führen Sie Lasttests zusammen mit Ausfallszenarien durch, um die reale Nutzung während Ausfällen zu simulieren. Testen Sie die Auswirkungen von kaskadierenden Fehlern, z. B. wie sich Frontend-Systeme verhalten, wenn Backend-Dienste nicht verfügbar sind.
Um Konfigurationsänderungen zu validieren und die Widerstandsfähigkeit des Systems gegen menschliche Fehler zu bewerten, sollten Sie Testszenarien mit Fehlkonfigurationen durchführen. Führen Sie beispielsweise Tests mit falschen DNS-Failover-Einstellungen oder falschen IAM-Berechtigungen aus.
Systemverhalten beobachten
Beobachten Sie, wie Load Balancer, Systemdiagnosen und andere Mechanismen Traffic umleiten. Verwenden Sie Google Cloud Tools wie Cloud Monitoring und Cloud Logging, um während des Tests Messwerte und Ereignisse zu erfassen.
Beobachten Sie während und nach der Fehlersimulation Änderungen bei Latenz, Fehlerraten und Durchsatz und überwachen Sie die Auswirkungen auf die Gesamtleistung. Identifizieren Sie alle Beeinträchtigungen oder Inkonsistenzen der User Experience.
Achten Sie darauf, dass Logs generiert und Benachrichtigungen für wichtige Ereignisse wie Dienstausfälle oder Failover ausgelöst werden. Mit diesen Daten können Sie die Effektivität Ihrer Benachrichtigungs- und Incident Response-Systeme überprüfen.
Wiederherstellung anhand von RTO und RPO prüfen
Messen Sie, wie lange es dauert, bis das System nach einem Ausfall wieder normal funktioniert. Vergleichen Sie diese Daten dann mit der definierten RTO und dokumentieren Sie etwaige Abweichungen.
Sorgen Sie dafür, dass Datenintegrität und ‑verfügbarkeit dem RPO entsprechen. Wenn Sie die Datenbankkonsistenz testen möchten, vergleichen Sie Snapshots oder Sicherungen der Datenbank vor und nach einem Ausfall.
Bewerten Sie die Wiederherstellung des Dienstes und bestätigen Sie, dass alle Dienste in einen funktionsfähigen Zustand mit minimalen Unterbrechungen für die Nutzer zurückversetzt wurden.
Ergebnisse dokumentieren und analysieren
Dokumentieren Sie jeden Testschritt, jedes Fehlerszenario und das entsprechende Systemverhalten. Fügen Sie Zeitstempel, Logs und Messwerte für detaillierte Analysen hinzu.
Heben Sie Engpässe, Single Points of Failure oder unerwartetes Verhalten hervor, die während des Tests beobachtet wurden. Kategorisieren Sie Probleme nach Schweregrad und Auswirkungen, um die Priorisierung von Korrekturen zu erleichtern.
Verbesserungen an der Systemarchitektur, den Failover-Mechanismen oder den Monitoring-Einrichtungen vorschlagen. Aktualisieren Sie basierend auf den Testergebnissen alle relevanten Failover-Richtlinien und Playbooks. Stakeholdern einen Postmortem-Bericht präsentieren Der Bericht sollte die Ergebnisse, gewonnenen Erkenntnisse und nächsten Schritte zusammenfassen. Weitere Informationen finden Sie unter Gründliche Post-Mortem-Analysen durchführen.
Iterieren und verbessern
Um die anhaltende Zuverlässigkeit und Ausfallsicherheit zu validieren, sollten Sie regelmäßige Tests (z. B. vierteljährlich) einplanen.
Führen Sie Tests in verschiedenen Szenarien durch, z. B. bei Infrastrukturänderungen, Softwareupdates und erhöhten Traffic-Lasten.
Automatisieren Sie Failover-Tests mithilfe von CI/CD-Pipelines, um Zuverlässigkeitstests in Ihren Entwicklungszyklus einzubinden.
Nutzen Sie während der Post-Mortem-Analyse das Feedback von Stakeholdern und Endnutzern, um den Testprozess und die Systemstabilität zu verbessern.
Tests zur Wiederherstellung nach Datenverlust durchführen
Dieses Prinzip in der Zuverlässigkeitssäule des Google Cloud Well-Architected Framework enthält Empfehlungen zum Entwerfen und Ausführen von Tests zur Wiederherstellung nach Datenverlust.
Dieses Prinzip ist für den Lernschwerpunkt der Zuverlässigkeit relevant.
Übersicht über die Prinzipien
Damit Ihr System nach Datenverlust oder -beschädigung wiederhergestellt werden kann, müssen Sie Tests für diese Szenarien ausführen. Datenverlust kann durch einen Software-Fehler oder eine Naturkatastrophe verursacht werden. Nach solchen Ereignissen müssen Sie Daten aus Sicherungen wiederherstellen und alle Dienste mit den neu wiederhergestellten Daten wieder in Betrieb nehmen.
Wir empfehlen, den Erfolg oder Misserfolg dieser Art von Wiederherstellungstest anhand von drei Kriterien zu beurteilen: Datenintegrität, Recovery Time Objective (RTO) und Recovery Point Objective (RPO). Weitere Informationen zu den RTO- und RPO-Messwerten finden Sie unter Grundlagen der Planung der Notfallwiederherstellung.
Das Ziel von Tests zur Datenwiederherstellung besteht darin, regelmäßig zu prüfen, ob Ihre Organisation die Anforderungen an die Geschäftskontinuität weiterhin erfüllen kann. Neben der Messung von RTO und RPO muss ein Datenwiederherstellungstest auch das Testen des gesamten Anwendungsstacks und aller kritischen Infrastrukturdienste mit den wiederhergestellten Daten umfassen. Dies ist erforderlich, um zu bestätigen, dass die gesamte bereitgestellte Anwendung in der Testumgebung ordnungsgemäß funktioniert.
Empfehlungen
Berücksichtigen Sie beim Entwerfen und Ausführen von Tests zur Wiederherstellung nach Datenverlust die Empfehlungen in den folgenden Abschnitten.
Sicherungskonsistenz prüfen und Wiederherstellungsprozesse testen
Sie müssen prüfen, ob Ihre Sicherungen konsistente und verwendbare Snapshots von Daten enthalten, die Sie wiederherstellen können, um Anwendungen sofort wieder in Betrieb zu nehmen. Richten Sie zur Validierung der Datenintegrität automatisierte Konsistenzprüfungen ein, die nach jeder Sicherung ausgeführt werden.
Wenn Sie Sicherungen testen möchten, stellen Sie sie in einer Nicht-Produktionsumgebung wieder her. Damit Ihre Sicherungen effizient wiederhergestellt werden können und die wiederhergestellten Daten den Anwendungsanforderungen entsprechen, sollten Sie regelmäßig Szenarien zur Datenwiederherstellung simulieren. Dokumentieren Sie die Schritte zur Datenwiederherstellung und schulen Sie Ihre Teams, damit sie die Schritte im Falle eines Ausfalls effektiv ausführen können.
Regelmäßige und häufige Sicherungen planen
Um Datenverluste bei der Wiederherstellung zu minimieren und RPO-Ziele zu erreichen, ist es wichtig, regelmäßig geplante Sicherungen zu haben. Legen Sie eine Sicherungshäufigkeit fest, die Ihrem RPO entspricht. Wenn Ihr RPO beispielsweise 15 Minuten beträgt, planen Sie Sicherungen so, dass sie mindestens alle 15 Minuten ausgeführt werden. Optimieren Sie die Sicherungsintervalle, um das Risiko von Datenverlusten zu verringern.
Verwenden Sie Google Cloud Tools wie Cloud Storage, automatisierte Cloud SQL-Sicherungen oder Spanner-Sicherungen, um Sicherungen zu planen und zu verwalten. Verwenden Sie für kritische Anwendungen Lösungen für nahezu kontinuierliche Back-ups wie die Wiederherstellung zu einem bestimmten Zeitpunkt (Point-in-Time Recovery, PITR) für Cloud SQL oder inkrementelle Back-ups für große Datasets.
RPO definieren und überwachen
Legen Sie ein klares RPO basierend auf Ihren Geschäftsanforderungen fest und überwachen Sie die Einhaltung des RPO. Wenn die Sicherungsintervalle das definierte RPO überschreiten, richten Sie mit Cloud Monitoring Benachrichtigungen ein.
Zustand der Sicherung überwachen
Verwenden Sie den Google Cloud Backup- und DR-Dienst oder ähnliche Tools, um den Zustand Ihrer Sicherungen zu verfolgen und zu bestätigen, dass sie an sicheren und zuverlässigen Standorten gespeichert werden. Sorgen Sie dafür, dass die Sicherungen zur Erhöhung der Ausfallsicherheit in mehreren Regionen repliziert werden.
Szenarien über die Sicherung hinaus planen
Kombinieren Sie Sicherungen mit Strategien zur Notfallwiederherstellung wie Active-Active-Failover-Konfigurationen oder regionsübergreifender Replikation, um die Wiederherstellungszeit in extremen Fällen zu verbessern. Weitere Informationen finden Sie im Leitfaden zur Planung der Notfallwiederherstellung.
Gründliche Postmortems durchführen
Dieses Prinzip im Bereich „Zuverlässigkeit“ des Google Cloud Well-Architected Framework enthält Empfehlungen für effektive Postmortems nach Fehlern und Vorfällen.
Dieses Prinzip ist für den Lernbereich Zuverlässigkeit relevant.
Übersicht über die Prinzipien
Eine Post-Mortem-Analyse ist eine schriftliche Aufzeichnung eines Vorfalls, seiner Auswirkungen, der Maßnahmen zur Minimierung oder Behebung des Vorfalls, der Ursachen und der Folgemaßnahmen, um ein erneutes Auftreten des Vorfalls zu verhindern. Ziel einer Postmortem-Analyse ist es, aus Fehlern zu lernen und nicht, anderen die Schuld zu geben.
Das folgende Diagramm zeigt den Workflow einer Post-Mortem-Analyse:
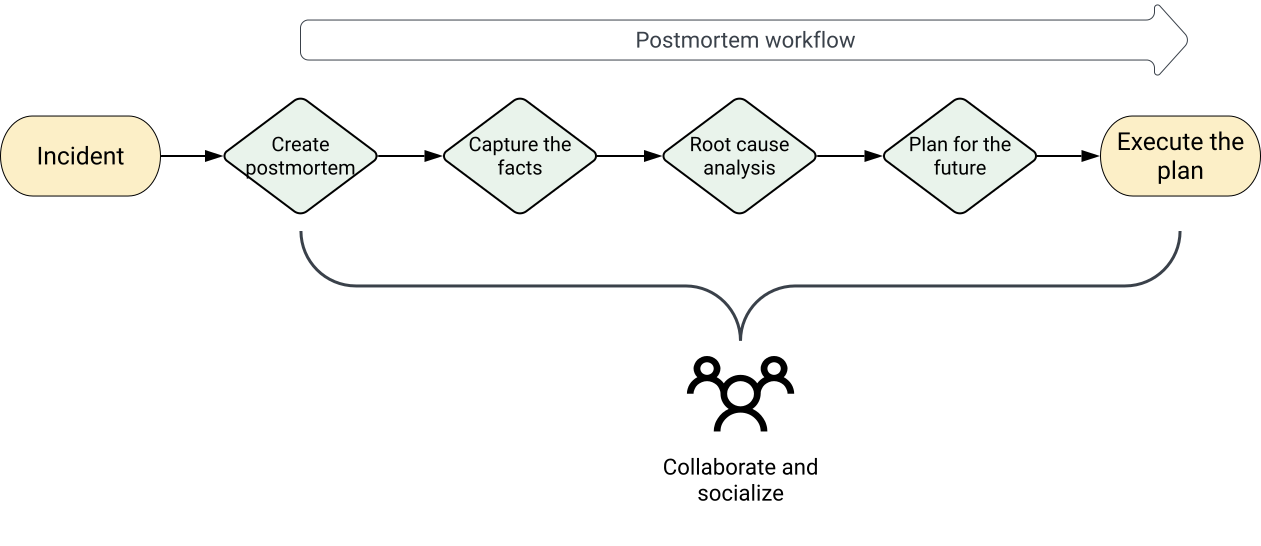
Der Workflow einer Post-Mortem-Analyse umfasst die folgenden Schritte:
- Postmortem erstellen
- Fakten erfassen
- Ursachen ermitteln und analysieren
- Für die Zukunft planen
- Plan ausführen
Führen Sie nach größeren und kleineren Ereignissen wie den folgenden Nachanalysen durch:
- Für Nutzer sichtbare Ausfallzeiten oder Beeinträchtigungen, die einen bestimmten Schwellenwert überschreiten.
- Datenverlust jeglicher Art.
- Eingriffe von Bereitschaftstechnikern, z. B. ein Release-Rollback oder das Umleiten von Traffic.
- Lösungszeiten, die über einem definierten Schwellenwert liegen.
- Monitoringfehler, die in der Regel eine manuelle Erkennung von Vorfällen erfordern.
Empfehlungen
Legen Sie die Kriterien für die Post-Mortem-Analyse fest, bevor ein Vorfall eintritt, damit alle wissen, wann eine Post-Mortem-Analyse erforderlich ist.
Beachten Sie die Empfehlungen in den folgenden Unterabschnitten, um effektive Postmortems durchzuführen.
Postmortems ohne Schuldzuweisung durchführen
Bei effektiven Postmortem-Analysen liegt der Fokus auf Prozessen, Tools und Technologien. Einzelne Personen oder Teams werden nicht beschuldigt. Der Zweck einer Post-Mortem-Analyse besteht darin, Ihre Technologie und Zukunft zu verbessern, nicht darin, herauszufinden, wer schuldig ist. Jeder macht Fehler. Ziel sollte es sein, die Fehler zu analysieren und daraus zu lernen.
Die folgenden Beispiele zeigen den Unterschied zwischen Feedback, das Schuld zuweist, und Feedback ohne Schuldzuweisung:
- Feedback, das Schuldzuweisungen enthält: „Wir müssen das gesamte komplizierte Backend-System neu schreiben! Es ist in den letzten drei Quartalen jede Woche kaputt gegangen und ich bin sicher, dass wir alle es leid sind, die Dinge stückweise zu reparieren. Wenn ich noch einmal benachrichtigt werde, schreibe ich es selbst…“
- Feedback ohne Schuldzuweisung: „Eine Maßnahme zum Neuschreiben des gesamten Back-End-Systems könnte tatsächlich verhindern, dass diese Seiten weiterhin auftreten. Das Wartungshandbuch für diese Version ist ziemlich lang und es ist wirklich schwierig, sich vollständig einzuarbeiten. Ich bin mir sicher, dass unsere zukünftigen On-Call-Engineers uns danken werden!“
Post-Mortem-Bericht für alle Zielgruppen lesbar machen
Bewerten Sie für jede Information, die Sie in den Bericht aufnehmen möchten, ob sie wichtig und notwendig ist, damit die Zielgruppe nachvollziehen kann, was passiert ist. Ergänzende Daten und Erläuterungen können Sie in einen Anhang des Berichts verschieben. Prüfer, die weitere Informationen benötigen, können diese anfordern.
Komplexe oder überentwickelte Lösungen vermeiden
Bevor Sie nach Lösungen für ein Problem suchen, sollten Sie die Bedeutung des Problems und die Wahrscheinlichkeit eines erneuten Auftretens bewerten. Wenn Sie das System komplexer machen, um Probleme zu lösen, die wahrscheinlich nicht noch einmal auftreten, kann dies zu einer erhöhten Instabilität führen.
Postmortem so weit wie möglich verbreiten
Damit Probleme nicht ungelöst bleiben, sollten Sie die Ergebnisse der Post-Mortem-Analyse für ein breites Publikum veröffentlichen und sich von der Führungsebene unterstützen lassen. Der Wert einer Post-Mortem-Analyse ist proportional zu den Erkenntnissen, die nach der Post-Mortem-Analyse gewonnen werden. Wenn mehr Personen aus Vorfällen lernen, sinkt die Wahrscheinlichkeit, dass ähnliche Fehler wiederkehrend auftreten.