


Pilar keandalan dalam Google Cloud Well-Architected Framework memberikan prinsip dan rekomendasi untuk membantu Anda mendesain, men-deploy, dan mengelola workload yang andal di Google Cloud.
Dokumen ini ditujukan untuk cloud architect, developer, platform engineer, administrator, dan site reliability engineer.
Keandalan adalah kemampuan sistem untuk secara konsisten menjalankan fungsi yang diinginkan dalam kondisi yang ditentukan dan mempertahankan layanan tanpa gangguan. Praktik terbaik untuk keandalan mencakup redundansi, desain fault-tolerant, pemantauan, dan proses pemulihan otomatis.
Sebagai bagian dari keandalan, ketahanan adalah kemampuan sistem untuk bertahan dan pulih dari kegagalan atau gangguan yang tidak terduga, sekaligus mempertahankan performa. FiturGoogle Cloud , seperti deployment multi-regional, pencadangan otomatis, dan solusi disaster recovery, dapat membantu Anda meningkatkan ketahanan sistem.
Keandalan penting bagi strategi cloud Anda karena berbagai alasan, termasuk berikut ini:
- Waktu non-operasional minimal: Waktu non-operasional dapat menyebabkan hilangnya pendapatan, penurunan produktivitas, dan rusaknya reputasi. Arsitektur yang tangguh dapat membantu memastikan bahwa sistem dapat terus berfungsi selama kegagalan atau pulih secara efisien dari kegagalan.
- Pengalaman pengguna yang ditingkatkan: Pengguna mengharapkan interaksi yang lancar dengan teknologi. Sistem yang tangguh dapat membantu mempertahankan performa dan ketersediaan yang konsisten, serta memberikan layanan yang andal bahkan selama permintaan tinggi atau masalah yang tidak terduga.
- Integritas data: Kegagalan dapat menyebabkan kehilangan data atau kerusakan data. Sistem yang tangguh menerapkan mekanisme seperti pencadangan, redundansi, dan replikasi untuk melindungi data serta memastikan data tetap akurat dan dapat diakses.
- Kelangsungan bisnis: Bisnis Anda mengandalkan teknologi untuk operasi penting. Arsitektur yang tangguh dapat membantu memastikan kelangsungan setelah kegagalan fatal, yang memungkinkan fungsi bisnis berlanjut tanpa gangguan yang signifikan dan mendukung pemulihan yang cepat.
- Kepatuhan: Banyak industri memiliki persyaratan peraturan untuk ketersediaan sistem dan perlindungan data. Arsitektur yang tangguh dapat membantu Anda memenuhi standar ini dengan memastikan sistem tetap beroperasi dan aman.
- Biaya jangka panjang yang lebih rendah: Arsitektur yang tangguh memerlukan investasi di awal, tetapi ketahanan dapat membantu mengurangi biaya seiring waktu dengan mencegah periode nonaktif yang mahal, menghindari perbaikan reaktif, dan memungkinkan penggunaan resource yang lebih efisien.
Pola pikir organisasi
Untuk membuat sistem Anda andal, Anda memerlukan rencana dan strategi yang mapan. Strategi ini harus mencakup edukasi dan otoritas untuk memprioritaskan keandalan bersama inisiatif lainnya.
Tetapkan ekspektasi yang jelas bahwa seluruh organisasi bertanggung jawab atas keandalan, termasuk pengembangan, pengelolaan produk, operasi, rekayasa platform, dan site reliability engineering (SRE). Bahkan grup yang berfokus pada bisnis, seperti pemasaran dan penjualan, dapat memengaruhi keandalan.
Setiap tim harus memahami target keandalan dan risiko aplikasi mereka. Tim harus bertanggung jawab atas persyaratan ini. Konflik antara keandalan dan pengembangan fitur produk reguler harus diprioritaskan dan dieskalasi sebagaimana mestinya.
Rencanakan dan kelola keandalan secara menyeluruh, di semua fungsi dan tim Anda. Pertimbangkan untuk menyiapkan Cloud Centre of Excellence (CCoE) yang mencakup pilar keandalan. Untuk mengetahui informasi selengkapnya, lihat Mengoptimalkan perjalanan cloud organisasi Anda dengan Cloud Center of Excellence.
Area fokus untuk keandalan
Aktivitas yang Anda lakukan untuk mendesain, men-deploy, dan mengelola sistem yang andal dapat dikategorikan dalam area fokus berikut. Setiap prinsip dan rekomendasi keandalan dalam pilar ini relevan dengan salah satu area fokus ini.
- Penentuan cakupan: Untuk memahami sistem Anda, lakukan analisis mendetail terhadap arsitekturnya. Anda perlu memahami komponen, cara kerja dan interaksinya, cara data dan tindakan mengalir melalui sistem, serta apa yang bisa salah. Mengidentifikasi potensi kegagalan, bottleneck, dan risiko, yang membantu Anda mengambil tindakan untuk memitigasi masalah tersebut.
- Pengamatan: Untuk membantu mencegah kegagalan sistem, terapkan pengamatan dan pemantauan yang komprehensif dan berkelanjutan. Melalui pengamatan ini, Anda dapat memahami tren dan mengidentifikasi potensi masalah secara proaktif.
- Respons: Untuk mengurangi dampak kegagalan, berikan respons yang tepat dan pulihkan secara efisien. Respons otomatis juga dapat membantu mengurangi dampak kegagalan. Meskipun telah direncanakan dan dikontrol, kegagalan masih dapat terjadi.
- Pembelajaran: Untuk membantu mencegah kegagalan berulang, belajarlah dari setiap pengalaman, dan ambil tindakan yang sesuai.
Mengevaluasi workload menggunakan keahlian agen
Untuk memungkinkan agen AI mengevaluasi workload cloud Anda berdasarkan prinsip dan
rekomendasi dalam pilar ini, gunakan
kemampuan
google-cloud-waf-reliability, yang tersedia di repositori Google Agent Skills di GitHub.
Untuk menginstal kemampuan, jalankan perintah berikut di klien atau terminal agen Anda:
npx skills add google/skills --skill google-cloud-waf-reliability
Jika diminta, tentukan agen AI yang ingin Anda instal keterampilannya dan tetapkan cakupan penginstalan (project atau global).
Jika Anda sudah menginstal skill, Anda dapat mengupdatenya ke versi terbaru dengan menjalankan perintah berikut:
npx skills update
Prinsip inti
Rekomendasi dalam pilar keandalan Well-Architected Framework dipetakan ke prinsip-prinsip inti berikut:
- Menentukan keandalan berdasarkan sasaran pengalaman pengguna
- Menetapkan target yang realistis untuk keandalan
- Membangun sistem dengan tingkat ketersediaan tinggi melalui redundansi resource
- Memanfaatkan skalabilitas horizontal
- Mendeteksi potensi kegagalan menggunakan kemampuan observasi
- Mendesain untuk degradasi halus
- Melakukan pengujian untuk pemulihan dari kegagalan
- Melakukan pengujian untuk pemulihan dari kehilangan data
- Melakukan postmortem menyeluruh
Kontributor
Penulis:
- Laura Hyatt | Customer Engineer, FSI
- Jose Andrade | Customer Engineer, SRE Specialist
- Gino Pelliccia | Principal Architect
Kontributor lainnya:
- Andrés-Leonardo Martínez-Ortiz | Technical Program Manager
- Brian Kudzia | Customer Engineer Infrastruktur Perusahaan
- Daniel Lees | Cloud Security Architect
- Filipe Gracio, PhD | Customer Engineer, Spesialis AI/ML
- Gary Harmson | Principal Architect
- Kumar Dhanagopal | Developer Solusi Lintas Produk
- Marwan Al Shawi | Partner Customer Engineer
- Nicolas Pintaux | Customer Engineer, Application Modernization Specialist
- Radhika Kanakam | Program Lead, Google Cloud Well-Architected Framework
- Ryan Cox | Principal Architect
- Samantha He | Technical Writer
- Wade Holmes | Global Solutions Director
- Zach Seils | Networking Specialist
Menentukan keandalan berdasarkan sasaran pengalaman pengguna
Prinsip dalam pilar keandalan Google Cloud Well-Architected Framework ini membantu Anda menilai pengalaman pengguna, lalu memetakan temuan ke sasaran dan metrik keandalan.
Prinsip ini relevan dengan area fokus pencakupan keandalan.
Ringkasan prinsip
Alat kemampuan observasi menyediakan data dalam jumlah besar, tetapi tidak semua data berhubungan langsung dengan dampak pada pengguna. Misalnya, Anda mungkin mengamati penggunaan CPU yang tinggi, operasi server yang lambat, atau bahkan tugas yang error. Namun, jika masalah ini tidak memengaruhi pengalaman pengguna, masalah tersebut tidak termasuk dalam pemadaman layanan.
Untuk mengukur pengalaman pengguna, Anda harus membedakan antara perilaku sistem internal dan masalah yang dihadapi pengguna. Fokus pada metrik seperti rasio keberhasilan permintaan pengguna. Jangan hanya mengandalkan metrik yang berfokus pada server, seperti penggunaan CPU, yang dapat menyebabkan kesimpulan yang menyesatkan tentang keandalan layanan Anda. Keandalan yang sebenarnya berarti pengguna dapat menggunakan aplikasi atau layanan Anda secara konsisten dan efektif.
Rekomendasi
Untuk membantu Anda mengukur pengalaman pengguna secara efektif, pertimbangkan rekomendasi di bagian berikut.
Mengukur pengalaman pengguna
Untuk benar-benar memahami keandalan layanan Anda, prioritaskan metrik yang mencerminkan pengalaman aktual pengguna Anda. Misalnya, ukur rasio keberhasilan kueri pengguna, latensi aplikasi, dan tingkat error.
Idealnya, kumpulkan data ini langsung dari perangkat atau browser pengguna. Jika pengumpulan data langsung ini tidak memungkinkan, alihkan titik pengukuran Anda secara progresif lebih jauh dari pengguna dalam sistem. Misalnya, Anda dapat menggunakan load balancer atau layanan frontend sebagai titik pengukuran. Pendekatan ini membantu Anda mengidentifikasi dan mengatasi masalah sebelum masalah tersebut dapat berdampak signifikan pada pengguna.
Menganalisis perjalanan pengguna
Untuk memahami cara pengguna berinteraksi dengan sistem Anda, Anda dapat menggunakan alat pelacakan seperti Cloud Trace. Dengan mengikuti perjalanan pengguna melalui aplikasi, Anda dapat menemukan bottleneck dan masalah latensi yang mungkin menurunkan pengalaman pengguna. Cloud Trace menangkap data performa mendetail untuk setiap hop dalam arsitektur layanan Anda. Data ini membantu Anda mengidentifikasi dan mengatasi masalah performa secara lebih efisien, yang dapat menghasilkan pengalaman pengguna yang lebih andal dan memuaskan.
Menetapkan target yang realistis untuk keandalan
Prinsip dalam pilar keandalan Google Cloud Well-Architected Framework ini membantu Anda menentukan sasaran keandalan yang secara teknis dapat dicapai untuk workload Anda di Google Cloud.
Prinsip ini relevan dengan area fokus pencakupan keandalan.
Ringkasan prinsip
Rancang sistem Anda agar cukup andal untuk kepuasan pengguna. Mungkin terlihat berlawanan dengan intuisi, tetapi sasaran keandalan 100% sering kali bukan strategi yang paling efektif. Keandalan yang lebih tinggi dapat mengakibatkan biaya yang jauh lebih tinggi, baik dalam hal investasi keuangan maupun potensi batasan pada inovasi. Jika pengguna sudah puas dengan tingkat layanan saat ini, upaya untuk lebih meningkatkan kepuasan mungkin akan menghasilkan laba atas investasi yang rendah. Sebagai gantinya, Anda dapat menggunakan resource dengan lebih baik di tempat lain.
Anda perlu menentukan tingkat keandalan yang membuat pengguna puas, dan menentukan titik saat biaya peningkatan inkremental mulai lebih besar daripada manfaatnya. Saat menentukan tingkat keandalan yang memadai ini, Anda dapat mengalokasikan resource secara strategis dan berfokus pada fitur dan peningkatan yang memberikan nilai lebih besar kepada pengguna.
Rekomendasi
Untuk menetapkan target keandalan yang realistis, pertimbangkan rekomendasi di subbagian berikut.
Menerima beberapa kegagalan dan memprioritaskan komponen
Targetkan ketersediaan tinggi seperti waktu beroperasi 99,99%, tetapi jangan tetapkan target waktu beroperasi 100%. Pahami bahwa beberapa kegagalan tidak dapat dihindari.
Selisih antara waktu beroperasi 100% dan target 99,99% adalah kelonggaran untuk kegagalan. Kesenjangan ini sering disebut anggaran error. Anggaran error dapat membantu Anda mengambil risiko dan berinovasi, yang merupakan hal mendasar bagi bisnis apa pun agar tetap kompetitif.
Prioritaskan keandalan komponen yang paling penting dalam sistem. Terima bahwa komponen yang kurang penting dapat memiliki toleransi kegagalan yang lebih tinggi.
Menyeimbangkan keandalan dan biaya
Untuk menentukan tingkat keandalan yang optimal bagi sistem Anda, lakukan analisis biaya-manfaat yang menyeluruh.
Pertimbangkan faktor-faktor seperti persyaratan sistem, konsekuensi kegagalan, dan toleransi risiko organisasi Anda untuk aplikasi tertentu. Jangan lupa untuk mempertimbangkan metrik disaster recovery, seperti batas waktu pemulihan (RTO) dan toleransi durasi kehilangan data (RPO). Tentukan tingkat keandalan yang dapat diterima dalam anggaran dan batasan lainnya.
Cari cara untuk meningkatkan efisiensi dan mengurangi biaya tanpa mengorbankan fitur keandalan yang penting.
Membangun sistem dengan tingkat ketersediaan tinggi melalui redundansi resource
Prinsip dalam pilar keandalan Google Cloud Well-Architected Framework memberikan rekomendasi untuk merencanakan, membangun, dan mengelola redundansi resource, yang dapat membantu Anda menghindari kegagalan.
Prinsip ini relevan dengan area fokus pencakupan keandalan.
Ringkasan prinsip
Setelah memutuskan tingkat keandalan yang Anda butuhkan, Anda harus mendesain sistem untuk menghindari titik tunggal kegagalan. Setiap komponen penting dalam sistem harus direplikasi di beberapa mesin, zona, dan region. Misalnya, database penting tidak boleh berada di satu region saja, dan server metadata tidak boleh di-deploy di satu zona atau region saja. Dalam contoh tersebut, jika satu-satunya zona atau region mengalami pemadaman layanan, sistem akan mengalami pemadaman layanan global.
Rekomendasi
Untuk membangun sistem redundan, pertimbangkan rekomendasi di subbagian berikut.
Mengidentifikasi domain kegagalan dan mereplikasi layanan
Petakan domain kegagalan sistem Anda, mulai dari VM individual hingga region, dan desain untuk redundansi di seluruh domain kegagalan.
Untuk memastikan ketersediaan tinggi, distribusikan dan replikasi layanan dan aplikasi Anda di beberapa zona dan region. Konfigurasikan sistem untuk failover otomatis guna memastikan bahwa layanan dan aplikasi terus tersedia jika terjadi pemadaman layanan zona atau region.
Untuk contoh arsitektur multi-zona dan multi-region, lihat Mendesain infrastruktur yang andal untuk workload Anda di Google Cloud.
Mendeteksi dan mengatasi masalah dengan cepat
Lacak status domain kegagalan Anda secara terus-menerus untuk mendeteksi dan mengatasi masalah dengan segera.
Anda dapat memantau status layanan Google Cloud saat ini di semua region menggunakan dasborGoogle Cloud Service Health. Anda juga dapat melihat insiden yang relevan dengan project Anda menggunakan Personalized Service Health. Anda dapat menggunakan load balancer untuk mendeteksi kondisi resource dan merutekan traffic secara otomatis ke backend yang responsif. Untuk mengetahui informasi selengkapnya, lihat Ringkasan health check.
Menguji skenario failover
Seperti latihan kebakaran, simulasikan kegagalan secara rutin untuk memvalidasi efektivitas strategi replikasi dan failover Anda.
Untuk mengetahui informasi selengkapnya, lihat Menyimulasikan pemadaman layanan zona untuk MIG regional dan Menyimulasikan kegagalan zona di cluster regional GKE.
Memanfaatkan skalabilitas horizontal
Prinsip dalam pilar keandalan Google Cloud Well-Architected Framework ini memberikan rekomendasi untuk membantu Anda menggunakan skalabilitas horizontal. Dengan menggunakan skalabilitas horizontal, Anda dapat membantu memastikan bahwa workload Anda di Google Cloud dapat diskalakan secara efisien dan mempertahankan performa.
Prinsip ini relevan dengan area fokus pencakupan keandalan.
Ringkasan prinsip
Merancang ulang sistem Anda menjadi arsitektur horizontal. Untuk mengakomodasi pertumbuhan traffic atau data, Anda dapat menambahkan lebih banyak resource. Anda juga dapat menghapus resource saat tidak digunakan.
Untuk memahami nilai penskalaan horizontal, pertimbangkan batasan penskalaan vertikal.
Skenario umum untuk penskalaan vertikal adalah menggunakan database MySQL sebagai database utama dengan data penting. Seiring meningkatnya penggunaan database, diperlukan lebih banyak RAM dan CPU. Pada akhirnya, database akan mencapai batas memori pada mesin host, dan perlu diupgrade. Proses ini mungkin perlu diulang beberapa kali. Masalahnya adalah ada batasan ketat terkait seberapa besar database dapat berkembang. Ukuran VM tidak terbatas. Database dapat mencapai titik saat tidak mungkin lagi menambahkan lebih banyak resource.
Meskipun resource tidak terbatas, VM besar dapat menjadi titik tunggal kegagalan. Masalah apa pun pada VM database utama dapat menyebabkan respons error atau menyebabkan pemadaman layanan di seluruh sistem yang memengaruhi semua pengguna. Hindari titik tunggal kegagalan, seperti yang dijelaskan dalam Membangun sistem dengan tingkat ketersediaan tinggi melalui redundansi resource.
Selain batas penskalaan ini, penskalaan vertikal cenderung lebih mahal. Biaya dapat meningkat secara eksponensial seiring dengan diperolehnya mesin dengan daya komputasi dan memori yang lebih besar.
Sebaliknya, penskalaan horizontal dapat menghemat biaya. Potensi penskalaan horizontal hampir tidak terbatas dalam sistem yang dirancang untuk diskalakan.
Rekomendasi
Untuk beralih dari arsitektur VM tunggal ke arsitektur horizontal multi-mesin, Anda perlu merencanakan dengan cermat dan menggunakan alat yang tepat. Untuk membantu Anda mencapai penskalaan horizontal, pertimbangkan rekomendasi di subbagian berikut.
Menggunakan layanan terkelola
Layanan terkelola menghilangkan kebutuhan untuk mengelola penskalaan horizontal secara manual. Misalnya, dengan grup instance terkelola (MIG) Compute Engine, Anda dapat menambahkan atau menghapus VM untuk menskalakan aplikasi secara horizontal. Untuk aplikasi dalam container, Cloud Run adalah platform serverless yang dapat menskalakan container stateless Anda secara otomatis berdasarkan traffic yang masuk.
Mempromosikan desain modular
Komponen modular dan antarmuka yang jelas membantu Anda menskalakan setiap komponen sesuai kebutuhan, bukan menskalakan seluruh aplikasi. Untuk mengetahui informasi selengkapnya, lihat Mendorong desain modular di pilar pengoptimalan performa.
Menerapkan desain stateless
Desain aplikasi agar bersifat stateless, yang berarti tidak ada data yang disimpan secara lokal. Hal ini memungkinkan Anda menambahkan atau menghapus instance tanpa mengkhawatirkan konsistensi data.
Mendeteksi potensi kegagalan menggunakan kemampuan observasi
Prinsip dalam pilar keandalan Google Cloud Well-Architected Framework ini memberikan rekomendasi untuk membantu Anda mengidentifikasi secara proaktif area tempat error dan kegagalan mungkin terjadi.
Prinsip ini relevan dengan area fokus pengamatan keandalan.
Ringkasan prinsip
Untuk mempertahankan dan meningkatkan keandalan workload Anda di Google Cloud, Anda perlu menerapkan kemampuan observasi yang efektif menggunakan metrik, log, dan trace.
- Metrik adalah pengukuran numerik aktivitas yang ingin Anda lacak untuk aplikasi Anda pada interval waktu tertentu. Misalnya, Anda mungkin ingin melacak metrik teknis seperti rasio permintaan dan rasio error, yang dapat digunakan sebagai indikator tingkat layanan (SLI). Anda mungkin juga perlu melacak metrik bisnis khusus aplikasi seperti pesanan yang dilakukan dan pembayaran yang diterima.
- Log adalah catatan peristiwa diskret yang diberi stempel waktu yang terjadi dalam aplikasi atau sistem. Peristiwa tersebut dapat berupa kegagalan, error, atau perubahan status. Log dapat menyertakan metrik, dan Anda juga dapat menggunakan log untuk SLI.
- Trace merepresentasikan perjalanan satu pengguna atau transaksi melalui sejumlah aplikasi terpisah atau komponen aplikasi. Misalnya, komponen ini dapat berupa microservice. Trace membantu Anda melacak komponen apa yang digunakan dalam perjalanan, di mana bottleneck terjadi, dan berapa lama perjalanan berlangsung.
Metrik, log, dan trace membantu Anda memantau sistem secara berkelanjutan. Pemantauan yang komprehensif membantu Anda mengetahui tempat dan alasan terjadinya error. Anda juga dapat mendeteksi potensi kegagalan sebelum terjadi error.
Rekomendasi
Untuk mendeteksi potensi kegagalan secara efisien, pertimbangkan rekomendasi di subbagian berikut.
Mendapatkan insight yang komprehensif
Untuk melacak metrik utama seperti waktu respons dan tingkat error, gunakan Cloud Monitoring dan Cloud Logging. Alat ini juga membantu Anda memastikan bahwa metrik secara konsisten memenuhi kebutuhan workload Anda.
Untuk membuat keputusan berbasis data, analisis metrik layanan default untuk memahami dependensi komponen dan dampaknya terhadap performa workload secara keseluruhan.
Untuk menyesuaikan strategi pemantauan, buat dan publikasikan metrik Anda sendiri menggunakan Google Cloud SDK.
Melakukan pemecahan masalah proaktif
Terapkan penanganan error yang andal dan aktifkan logging di semua komponen workload Anda di Google Cloud. Aktifkan log seperti log akses Cloud Storage dan Log Aliran VPC.
Saat Anda mengonfigurasi logging, pertimbangkan biaya terkait. Untuk mengontrol biaya logging, Anda dapat mengonfigurasi filter pengecualian pada sink log untuk mengecualikan log tertentu agar tidak disimpan.
Mengoptimalkan pemanfaatan resource
Pantau konsumsi CPU, metrik I/O jaringan, dan metrik I/O disk untuk mendeteksi resource yang kurang disediakan dan disediakan secara berlebihan di layanan seperti GKE, Compute Engine, dan Managed Service untuk Apache Spark. Untuk mengetahui daftar lengkap layanan yang didukung, lihat Ringkasan Cloud Monitoring.
Memprioritaskan pemberitahuan
Untuk pemberitahuan, fokuslah pada metrik yang paling penting, tetapkan nilai minimum yang sesuai untuk meminimalkan kelelahan akibat pemberitahuan (alert fatigue), dan pastikan respons terhadap masalah signifikan dilakukan tepat waktu. Pendekatan yang terarah ini dapat membantu Anda menjaga keandalan workload secara proaktif. Untuk informasi selengkapnya, lihat Ringkasan pemberitahuan.
Mendesain untuk degradasi halus
Prinsip dalam pilar keandalan Google Cloud Well-Architected Framework ini memberikan rekomendasi untuk membantu Anda mendesain workload Google Cloud agar gagal secara halus.
Prinsip ini relevan dengan respons area fokus keandalan.
Ringkasan prinsip
Degradasi halus adalah pendekatan desain saat sistem yang mengalami beban tinggi terus berfungsi, mungkin dengan performa atau akurasi yang berkurang. Degradasi halus memastikan ketersediaan sistem yang berkelanjutan dan mencegah kegagalan total, meskipun sistem tidak bekerja secara optimal. Saat beban kembali ke tingkat yang dapat dikelola, sistem akan melanjutkan fungsi penuh.
Misalnya, selama periode beban tinggi, Google Penelusuran memprioritaskan hasil dari halaman web berperingkat lebih tinggi, yang berpotensi mengorbankan beberapa akurasi. Saat beban menurun, Google Penelusuran akan menghitung ulang hasil penelusuran.
Rekomendasi
Untuk mendesain sistem Anda agar mengalami degradasi halus, pertimbangkan rekomendasi di subbagian berikut.
Menerapkan throttling
Pastikan replika Anda dapat menangani kelebihan beban secara independen dan dapat men-throttle permintaan masuk selama skenario traffic tinggi. Pendekatan ini membantu Anda mencegah kegagalan beruntun yang disebabkan oleh pergeseran traffic berlebih di antara zona.
Gunakan alat seperti Apigee untuk mengontrol frekuensi permintaan API selama periode traffic tinggi. Anda dapat mengonfigurasi aturan kebijakan untuk mencerminkan cara Anda ingin mengurangi permintaan.
Menghapus permintaan berlebih lebih awal
Konfigurasikan sistem Anda untuk menghapus permintaan berlebih di lapisan frontend guna melindungi komponen backend. Menghapus beberapa permintaan akan mencegah kegagalan global dan memungkinkan sistem pulih dengan lebih baik.Dengan pendekatan ini, beberapa pengguna mungkin mengalami error. Namun, Anda dapat meminimalkan dampak pemadaman layanan, berbeda dengan pendekatan seperti pemutusan sirkuit, yang menyebabkan semua traffic dihapus selama kelebihan beban.
Menangani error sebagian dan percobaan ulang
Bangun aplikasi Anda untuk menangani error parsial dan percobaan ulang dengan lancar. Desain ini membantu memastikan bahwa sebanyak mungkin traffic disajikan selama skenario beban tinggi.
Menguji skenario kelebihan beban
Untuk memvalidasi bahwa mekanisme throttle dan penghapusan permintaan berfungsi secara efektif, simulasikan kondisi overload secara rutin di sistem Anda. Pengujian membantu memastikan bahwa sistem Anda siap menghadapi lonjakan traffic di dunia nyata.
Memantau lonjakan traffic
Gunakan alat analisis dan pemantauan untuk memprediksi dan merespons lonjakan traffic sebelum berkembang menjadi kelebihan beban. Deteksi dan respons dini dapat membantu mempertahankan ketersediaan layanan selama periode permintaan tinggi.
Melakukan pengujian untuk pemulihan dari kegagalan
Prinsip dalam pilar keandalan Google Cloud Well-Architected Framework ini memberikan rekomendasi untuk membantu Anda mendesain dan menjalankan pengujian pemulihan jika terjadi kegagalan.
Prinsip ini relevan dengan area fokus pembelajaran keandalan.
Ringkasan prinsip
Untuk memastikan bahwa sistem Anda dapat pulih dari kegagalan, Anda harus menjalankan pengujian secara berkala yang mencakup failover regional, rollback rilis, dan pemulihan data dari cadangan.
Pengujian ini membantu Anda melatih respons terhadap peristiwa yang menimbulkan risiko besar terhadap keandalan, seperti pemadaman layanan di seluruh region. Pengujian ini juga membantu Anda memverifikasi bahwa sistem Anda berperilaku sebagaimana mestinya selama gangguan.
Jika seluruh region mengalami gangguan, Anda harus mengalihkan semua traffic ke region lain. Selama operasi normal workload Anda, saat data diubah, data tersebut perlu disinkronkan dari region utama ke region failover. Anda perlu memverifikasi bahwa data yang direplikasi selalu sangat baru, sehingga pengguna tidak mengalami kehilangan data atau kerusakan sesi. Sistem load balancing juga harus dapat mengalihkan traffic ke region failover kapan saja tanpa gangguan layanan. Untuk meminimalkan periode nonaktif setelah pemadaman layanan regional, engineer operasi juga harus dapat mengalihkan traffic pengguna dari suatu region secara manual dan efisien, dalam waktu sesingkat mungkin. Operasi ini terkadang disebut pengosongan region, yang berarti Anda menghentikan traffic masuk ke region tersebut dan memindahkan semua traffic ke tempat lain.
Rekomendasi
Saat Anda mendesain dan menjalankan pengujian untuk pemulihan kegagalan, pertimbangkan rekomendasi di subbagian berikut.
Menentukan tujuan dan cakupan pengujian
Tentukan dengan jelas apa yang ingin Anda capai dari pengujian. Misalnya, tujuan Anda dapat mencakup hal berikut:
- Validasi batas waktu pemulihan (RTO) dan toleransi durasi kehilangan data (RPO). Untuk mengetahui detailnya, lihat Dasar-dasar perencanaan DR.
- Menilai ketahanan sistem dan fault tolerance dalam berbagai skenario kegagalan.
- Menguji efektivitas mekanisme failover otomatis.
Tentukan komponen, layanan, atau region yang termasuk dalam cakupan pengujian. Cakupan dapat mencakup tingkat aplikasi tertentu seperti frontend, backend, dan database, atau dapat mencakup resource Google Cloud tertentu seperti instance Cloud SQL atau cluster GKE. Cakupan juga harus menentukan dependensi eksternal, seperti API pihak ketiga atau interkoneksi cloud.
Menyiapkan lingkungan untuk pengujian
Pilih lingkungan yang sesuai, sebaiknya lingkungan staging atau sandbox yang mereplikasi penyiapan produksi Anda. Jika Anda melakukan pengujian dalam produksi, pastikan Anda telah menyiapkan langkah-langkah keamanan, seperti pemantauan otomatis dan prosedur rollback manual.
Membuat rencana pencadangan. Ambil snapshot atau cadangan database dan layanan penting untuk mencegah kehilangan data selama pengujian. Pastikan tim Anda siap melakukan intervensi manual jika mekanisme failover otomatis gagal.
Untuk mencegah gangguan pengujian, pastikan peran, kebijakan, dan konfigurasi failover IAM Anda disiapkan dengan benar. Pastikan izin yang diperlukan sudah ada untuk alat dan skrip pengujian.
Beri tahu pemangku kepentingan, termasuk operasi, DevOps, dan pemilik aplikasi, tentang jadwal, cakupan, dan potensi dampak pengujian. Berikan perkiraan linimasa dan perilaku yang diharapkan selama pengujian kepada pemangku kepentingan.
Menyimulasikan skenario kegagalan
Rencanakan dan jalankan kegagalan menggunakan alat seperti Chaos Monkey. Anda dapat menggunakan skrip kustom untuk menyimulasikan kegagalan layanan penting seperti penonaktifan node utama di cluster GKE multi-zona atau instance Cloud SQL yang dinonaktifkan. Anda juga dapat menggunakan skrip untuk menyimulasikan pemadaman layanan jaringan di seluruh region menggunakan aturan firewall atau batasan API berdasarkan cakupan pengujian Anda. Tingkatkan skenario kegagalan secara bertahap untuk mengamati perilaku sistem dalam berbagai kondisi.
Perkenalkan pengujian beban bersama skenario kegagalan untuk mereplikasi penggunaan di dunia nyata selama pemadaman layanan. Uji dampak kegagalan beruntun, seperti perilaku sistem frontend saat layanan backend tidak tersedia.
Untuk memvalidasi perubahan konfigurasi dan menilai ketahanan sistem terhadap kesalahan manusia, uji skenario yang melibatkan kesalahan konfigurasi. Misalnya, jalankan pengujian dengan setelan failover DNS yang salah atau izin IAM yang salah.
Memantau perilaku sistem
Pantau cara load balancer, health check, dan mekanisme lainnya mengalihkan traffic. Gunakan Google Cloud alat seperti Cloud Monitoring dan Cloud Logging untuk menangkap metrik dan peristiwa selama pengujian.
Amati perubahan latensi, tingkat error, dan throughput selama dan setelah simulasi kegagalan, serta pantau dampak performa secara keseluruhan. Identifikasi setiap penurunan atau inkonsistensi dalam pengalaman pengguna.
Pastikan log dibuat dan pemberitahuan dipicu untuk peristiwa penting, seperti pemadaman layanan atau failover. Gunakan data ini untuk memverifikasi efektivitas sistem pemberitahuan dan respons insiden Anda.
Memverifikasi pemulihan terhadap RTO dan RPO Anda
Ukur berapa lama waktu yang diperlukan sistem untuk melanjutkan operasi normal setelah kegagalan, lalu bandingkan data ini dengan RTO yang ditentukan dan dokumentasikan kesenjangan apa pun.
Pastikan integritas dan ketersediaan data sesuai dengan RPO. Untuk menguji konsistensi database, bandingkan snapshot atau cadangan database sebelum dan setelah kegagalan.
Evaluasi pemulihan layanan dan pastikan semua layanan dipulihkan ke kondisi fungsional dengan gangguan pengguna yang minimal.
Mendokumentasikan dan menganalisis hasil
Dokumentasikan setiap langkah pengujian, skenario kegagalan, dan perilaku sistem yang sesuai. Sertakan stempel waktu, log, dan metrik untuk analisis mendetail.
Soroti bottleneck, titik tunggal kegagalan, atau perilaku tak terduga yang diamati selama pengujian. Untuk membantu memprioritaskan perbaikan, kategorikan masalah berdasarkan tingkat keparahan dan dampaknya.
Sarankan peningkatan pada arsitektur sistem, mekanisme failover, atau penyiapan pemantauan. Berdasarkan temuan pengujian, perbarui kebijakan dan playbook failover yang relevan. Mempresentasikan laporan postmortem kepada pemangku kepentingan. Laporan tersebut harus merangkum hasil, pelajaran yang diperoleh, dan langkah berikutnya. Untuk mengetahui informasi selengkapnya, lihat Melakukan postmortem menyeluruh.
Melakukan iterasi dan peningkatan
Untuk memvalidasi keandalan dan ketahanan yang berkelanjutan, rencanakan pengujian berkala (misalnya, setiap tiga bulan).
Jalankan pengujian dalam berbagai skenario, termasuk perubahan infrastruktur, update software, dan peningkatan beban traffic.
Otomatiskan pengujian failover menggunakan pipeline CI/CD untuk mengintegrasikan pengujian keandalan ke dalam siklus proses pengembangan Anda.
Selama postmortem, gunakan masukan dari pemangku kepentingan dan pengguna akhir untuk meningkatkan proses pengujian dan ketahanan sistem.
Melakukan pengujian untuk pemulihan dari kehilangan data
Prinsip dalam pilar keandalan Google Cloud Well-Architected Framework ini memberikan rekomendasi untuk membantu Anda mendesain dan menjalankan pengujian untuk pemulihan dari kehilangan data.
Prinsip ini relevan dengan area fokus pembelajaran keandalan.
Ringkasan prinsip
Untuk memastikan bahwa sistem Anda dapat pulih dari situasi saat data hilang atau rusak, Anda perlu menjalankan pengujian untuk skenario tersebut. Kasus kehilangan data mungkin disebabkan oleh bug software atau beberapa jenis bencana alam. Setelah peristiwa tersebut, Anda perlu memulihkan data dari cadangan dan mengaktifkan kembali semua layanan menggunakan data yang baru dipulihkan.
Sebaiknya gunakan tiga kriteria untuk menilai keberhasilan atau kegagalan jenis pengujian pemulihan ini: integritas data, batas waktu pemulihan (RTO), dan toleransi durasi kehilangan data (RPO). Untuk mengetahui detail tentang metrik RTO dan RPO, lihat Dasar-dasar perencanaan DR.
Tujuan pengujian pemulihan data adalah untuk memverifikasi secara berkala bahwa organisasi Anda dapat terus memenuhi persyaratan kelangsungan bisnis. Selain mengukur RTO dan RPO, pengujian pemulihan data harus mencakup pengujian seluruh stack aplikasi dan semua layanan infrastruktur penting dengan data yang dipulihkan. Hal ini diperlukan untuk mengonfirmasi bahwa seluruh aplikasi yang di-deploy berfungsi dengan benar di lingkungan pengujian.
Rekomendasi
Saat Anda mendesain dan menjalankan pengujian untuk pemulihan dari kehilangan data, pertimbangkan rekomendasi di subbagian berikut.
Memverifikasi konsistensi pencadangan dan menguji proses pemulihan
Anda perlu memverifikasi bahwa cadangan Anda berisi snapshot data yang konsisten dan dapat digunakan, yang dapat Anda pulihkan untuk segera mengembalikan aplikasi ke layanan. Untuk memvalidasi integritas data, siapkan pemeriksaan konsistensi otomatis untuk dijalankan setelah setiap pencadangan.
Untuk menguji cadangan, pulihkan cadangan di lingkungan non-produksi. Untuk memastikan cadangan Anda dapat dipulihkan secara efisien dan data yang dipulihkan memenuhi persyaratan aplikasi, simulasikan skenario pemulihan data secara rutin. Dokumentasikan langkah-langkah untuk pemulihan data, dan latih tim Anda untuk menjalankan langkah-langkah tersebut secara efektif selama terjadi kegagalan.
Menjadwalkan pencadangan rutin dan berkala
Untuk meminimalkan kehilangan data selama pemulihan dan memenuhi target RPO, Anda harus memiliki cadangan terjadwal secara rutin. Tetapkan frekuensi pencadangan yang sesuai dengan RPO Anda. Misalnya, jika RPO Anda adalah 15 menit, jadwalkan pencadangan untuk dijalankan setidaknya setiap 15 menit. Optimalkan interval pencadangan untuk mengurangi risiko kehilangan data.
Gunakan alat seperti Cloud Storage, pencadangan otomatis Cloud SQL, atau pencadangan Spanner untuk menjadwalkan dan mengelola pencadangan. Google Cloud Untuk aplikasi penting, gunakan solusi pencadangan yang hampir berkelanjutan seperti pemulihan point-in-time (PITR) untuk Cloud SQL atau pencadangan inkremental untuk set data besar.
Menentukan dan memantau RPO
Tetapkan RPO yang jelas berdasarkan kebutuhan bisnis Anda, dan pantau kepatuhan terhadap RPO. Jika interval pencadangan melebihi RPO yang ditentukan, gunakan Cloud Monitoring untuk menyiapkan pemberitahuan.
Memantau kondisi cadangan
Gunakan Google Cloud Backup and DR Service atau alat serupa untuk melacak kondisi cadangan Anda dan mengonfirmasi bahwa cadangan tersebut disimpan di lokasi yang aman dan andal. Pastikan cadangan direplikasi di beberapa region untuk meningkatkan ketahanan.
Merencanakan skenario selain pencadangan
Gabungkan pencadangan dengan strategi disaster recovery seperti penyiapan failover aktif-aktif atau replikasi lintas region untuk meningkatkan waktu pemulihan dalam kasus ekstrem. Untuk mengetahui informasi selengkapnya, lihat Panduan perencanaan disaster recovery.
Melakukan postmortem menyeluruh
Prinsip dalam pilar keandalan Google Cloud Well-Architected Framework ini memberikan rekomendasi untuk membantu Anda melakukan postmortem yang efektif setelah kegagalan dan insiden.
Prinsip ini relevan dengan area fokus pembelajaran keandalan.
Ringkasan prinsip
Postmortem adalah catatan tertulis tentang insiden, dampaknya, tindakan yang diambil untuk memitigasi atau menyelesaikan insiden, penyebab utama, dan tindakan lanjutan untuk mencegah insiden terulang kembali. Tujuan postmortem adalah belajar dari kesalahan dan tidak menyalahkan siapa pun.
Diagram berikut menunjukkan alur kerja postmortem:
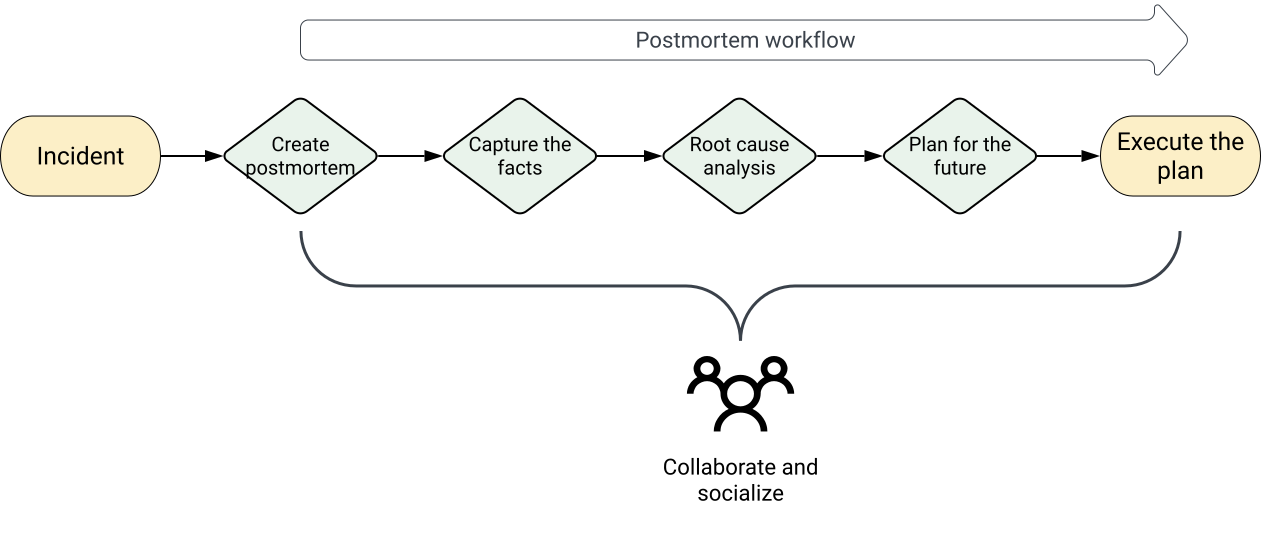
Alur kerja postmortem mencakup langkah-langkah berikut:
- Membuat postmortem
- Mencatat fakta
- Mengidentifikasi dan menganalisis akar masalah
- Rencanakan masa depan
- Menjalankan rencana
Lakukan analisis postmortem setelah peristiwa besar dan peristiwa non-besar seperti berikut:
- Periode nonaktif atau penurunan performa yang terlihat oleh pengguna di luar batas tertentu.
- Kehilangan data dalam bentuk apa pun.
- Intervensi dari engineer yang bertugas, seperti rollback rilis atau pengalihan traffic.
- Waktu penyelesaian di atas batas yang ditentukan.
- Kegagalan pemantauan, yang biasanya menyiratkan penemuan insiden secara manual.
Rekomendasi
Tentukan kriteria postmortem sebelum insiden terjadi agar semua orang tahu kapan postmortem diperlukan.
Untuk melakukan postmortem yang efektif, pertimbangkan rekomendasi dalam subbagian berikut.
Melakukan postmortem tanpa menyalahkan
Postmortem yang efektif berfokus pada proses, alat, dan teknologi, serta tidak menyalahkan individu atau tim. Tujuan analisis post-mortem adalah untuk meningkatkan teknologi dan masa depan Anda, bukan untuk mencari siapa yang bersalah. Semua orang membuat kesalahan. Tujuannya adalah untuk menganalisis kesalahan dan belajar dari kesalahan tersebut.
Contoh berikut menunjukkan perbedaan antara masukan yang menyalahkan dan masukan tanpa menyalahkan:
- Masukan yang menyalahkan: "Kita perlu menulis ulang seluruh sistem backend yang rumit! Sistem ini mengalami kerusakan setiap minggu selama tiga kuartal terakhir dan saya yakin kita semua lelah memperbaikinya sedikit demi sedikit. Serius, kalau saya dipanggil sekali lagi, saya akan menulis ulang sendiri…"
- Masukan tanpa menyalahkan: "Item tindakan untuk menulis ulang seluruh sistem backend mungkin dapat mencegah halaman ini terus terjadi. Manual pemeliharaan untuk versi ini cukup panjang dan sangat sulit untuk dipelajari sepenuhnya. Saya yakin engineer on-call kita di masa mendatang akan berterima kasih kepada kita."
Membuat laporan postmortem dapat dibaca oleh semua audiens yang dituju
Untuk setiap informasi yang ingin Anda sertakan dalam laporan, nilai apakah informasi tersebut penting dan diperlukan untuk membantu audiens memahami apa yang terjadi. Anda dapat memindahkan data dan penjelasan tambahan ke lampiran laporan. Peninjau yang memerlukan informasi lebih lanjut dapat memintanya.
Hindari solusi yang rumit atau terlalu direkayasa
Sebelum Anda mulai mencari solusi untuk suatu masalah, evaluasi seberapa penting masalah tersebut dan kemungkinan terjadinya kembali. Menambahkan kompleksitas ke sistem untuk menyelesaikan masalah yang kemungkinan tidak akan terjadi lagi dapat menyebabkan peningkatan ketidakstabilan.
Membagikan postmortem seluas mungkin
Untuk memastikan bahwa masalah tidak dibiarkan tanpa penyelesaian, publikasikan hasil postmortem kepada audiens yang luas dan dapatkan dukungan dari manajemen. Nilai postmortem sebanding dengan pembelajaran yang terjadi setelah postmortem. Jika makin banyak orang yang belajar dari insiden, kemungkinan kegagalan serupa terulang akan berkurang.