


Este pilar no Google Cloud Well-Architected Framework oferece recomendações para otimizar o desempenho das cargas de trabalho no Google Cloud.
Este documento é destinado a arquitetos, desenvolvedores e administradores que planejam, projetam, implantam e gerenciam cargas de trabalho no Google Cloud.
As recomendações neste pilar podem ajudar sua organização a operar de maneira eficiente, melhorar a satisfação do cliente, aumentar a receita e reduzir custos. Por exemplo, quando o tempo de processamento de back-end de um aplicativo diminui, os usuários têm tempos de resposta mais rápidos, o que pode aumentar a retenção de usuários e a receita.
O processo de otimização de desempenho pode envolver uma compensação entre desempenho e custo. No entanto, otimizar o desempenho pode ajudar você a reduzir custos. Por exemplo, quando a carga aumenta, o escalonamento automático ajuda a fornecer um desempenho previsível, garantindo que os recursos do sistema não sejam sobrecarregados. O escalonamento automático também ajuda a reduzir custos removendo recursos não utilizados durante períodos de baixa carga.
A otimização do desempenho é um processo contínuo, e não uma atividade única. O diagrama a seguir mostra os estágios no processo de otimização de desempenho:
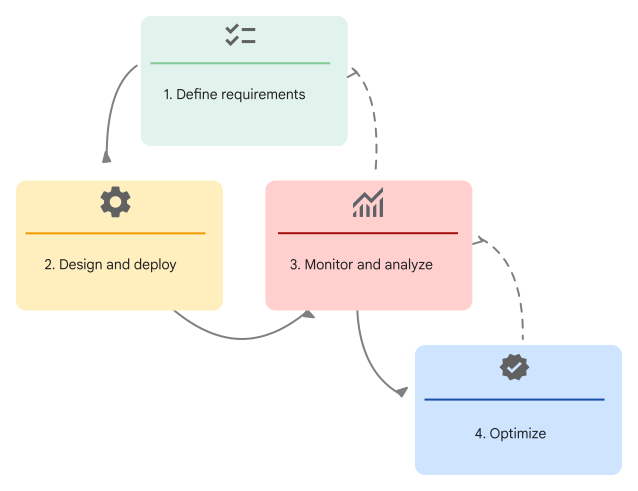
O processo de otimização de desempenho é um ciclo contínuo que inclui as seguintes etapas:
- Defina os requisitos: defina requisitos de desempenho granulares para cada camada da pilha de aplicativos antes de projetar e desenvolver seus aplicativos. Para planejar a alocação de recursos, considere as principais características da carga de trabalho e as expectativas de desempenho.
- Projetar e implantar: use padrões de design elásticos e escalonáveis que podem ajudar a atender aos requisitos de desempenho.
- Monitorar e analisar: monitore o desempenho continuamente usando registros, rastreamento, métricas e alertas.
Otimize: considere possíveis reformulações à medida que seus aplicativos evoluem. Dimensione os recursos de nuvem e use novos recursos para atender aos requisitos de desempenho em constante mudança.
Conforme mostrado no diagrama anterior, continue o ciclo de monitoramento, reavaliação de requisitos e ajuste dos recursos da nuvem.
Para princípios e recomendações de otimização de desempenho específicos para cargas de trabalho de IA e ML, consulte Perspectiva de IA e ML: otimização de desempenho no Well-Architected Framework.
Avaliar cargas de trabalho usando uma habilidade de agente
Para permitir que os agentes de IA avaliem suas cargas de trabalho na nuvem de acordo com os princípios e as
recomendações deste pilar, use a habilidade
google-cloud-waf-performance-optimization, disponível no repositório de habilidades de agentes do Google no GitHub.
Para instalar a habilidade, execute o seguinte comando no cliente ou terminal do seu agente:
npx skills add google/skills --skill google-cloud-waf-performance-optimization
Quando solicitado, especifique os agentes de IA em que você quer instalar a habilidade e defina o escopo da instalação (projeto ou global).
Princípios básicos
As recomendações no pilar de otimização de desempenho do Well-Architected Framework são mapeadas para os seguintes princípios fundamentais:
- Planejar a alocação de recursos
- Aproveite a elasticidade
- Promover o design modular
- Monitoramento contínuo e aprimoramento do desempenho
Colaboradores
Autores:
- Daniel Lees | Arquiteto de segurança do Cloud
- Gary Harmson | Arquiteto principal
- Luis Urena | Engenheiro de relações com desenvolvedores
- Zach Seils | Especialista em rede
Outros colaboradores:
- Filipe Gracio, PhD | Engenheiro de clientes, especialista em IA/ML
- Jose Andrade | Engenheiro de clientes, especialista em SRE
- Kumar Dhanagopal | Desenvolvedor de soluções para vários produtos
- Marwan Al Shawi | Engenheiro de clientes do parceiro
- Nicolas Pintaux | Engenheiro de clientes, especialista em modernização de aplicativos
- Ryan Cox | Arquiteto principal
- Radhika Kanakam | Líder de programa, Google Cloud Well-Architected Framework
- Samantha He | Redatora técnica
- Wade Holmes | Diretor global de soluções
Planejar a alocação de recursos
Este princípio no pilar de otimização de desempenho do Framework de arquitetura doGoogle Cloud fornece recomendações para ajudar você a planejar recursos para suas cargas de trabalho no Google Cloud. Ele enfatiza a importância de definir requisitos granulares antes de projetar e desenvolver aplicativos para implantação ou migração na nuvem.
Visão geral do princípio
Para atender aos requisitos de negócios, é importante definir os requisitos de desempenho dos aplicativos antes do design e do desenvolvimento. Defina esses requisitos da forma mais granular possível para o aplicativo como um todo e para cada camada da pilha de aplicativos. Por exemplo, na camada de armazenamento, é preciso considerar a capacidade de processamento e as operações de E/S por segundo (IOPS) que os aplicativos precisam.
Desde o início, planeje os designs de aplicativos pensando em performance e escalonabilidade. Considere fatores como o número de usuários, o volume de dados e o crescimento potencial ao longo do tempo.
Os requisitos de desempenho para cada carga de trabalho variam e dependem do tipo de carga. Cada carga de trabalho pode conter uma combinação de sistemas e serviços de componentes que têm conjuntos exclusivos de características de desempenho. Por exemplo, um sistema responsável pelo processamento periódico em lote de grandes conjuntos de dados tem demandas de desempenho diferentes de uma solução de área de trabalho virtual interativa. Suas estratégias de otimização precisam atender às necessidades específicas de cada carga de trabalho.
Selecione serviços e recursos que se alinhem às metas de performance de cada carga de trabalho. Para otimizar a performance, não existe uma solução única para todos os casos. Ao otimizar cada carga de trabalho, todo o sistema pode alcançar performance e eficiência ideais.
Considere as seguintes características de carga de trabalho que podem influenciar seus requisitos de desempenho:
- Arquétipo de implantação: o arquétipo de implantação selecionado para um aplicativo pode influenciar sua escolha de produtos e recursos, que determinam o desempenho esperado do aplicativo.
- Posicionamento de recursos: ao selecionar uma Google Cloud região para os recursos do aplicativo, recomendamos que você priorize a baixa latência para os usuários finais, siga as regulamentações de localidade de dados e garanta a disponibilidade dos Google Cloud produtos e serviços necessários.
- Conectividade de rede: escolha serviços de rede que otimizem o acesso a dados e a entrega de conteúdo. Aproveite a rede global, os backbones de alta velocidade, os locais de interconexão e os serviços de armazenamento em cache do Google Cloud.
- Opções de hospedagem de aplicativos: ao selecionar uma plataforma de hospedagem, avalie as vantagens e desvantagens de desempenho de cada opção. Por exemplo, considere plataformas bare metal, máquinas virtuais, contêineres e sem servidor.
- Estratégia de armazenamento: escolha uma estratégia de armazenamento ideal com base nos seus requisitos de performance.
- Configurações de recursos: o tipo de máquina, as IOPS e a capacidade de processamento podem ter um impacto significativo no desempenho. Além disso, no início da fase de design, é preciso considerar os recursos de segurança adequados e o impacto deles nos recursos. Ao planejar recursos de segurança, esteja preparado para acomodar as compensações de desempenho necessárias para evitar efeitos imprevistos.
Recomendações
Para garantir a alocação ideal de recursos, considere as recomendações nas seções a seguir.
Configurar e gerenciar cotas
Verifique se o aplicativo usa apenas os recursos necessários, como memória, armazenamento e capacidade de processamento. A alocação excessiva pode gerar despesas desnecessárias, enquanto a alocação insuficiente pode resultar em degradação do desempenho.
Para acomodar o escalonamento elástico e garantir que recursos adequados estejam disponíveis, monitore regularmente a capacidade das suas cotas. Além disso, acompanhe o uso da cota para identificar possíveis restrições de escalonamento ou problemas de alocação excessiva e tome decisões embasadas sobre a alocação de recursos.
Educar e promover a conscientização
Informe os usuários sobre os requisitos de desempenho e forneça recursos educacionais sobre técnicas eficazes de gerenciamento de desempenho.
Para avaliar o progresso e identificar áreas de melhoria, documente regularmente o desempenho desejado e o desempenho real. Faça um teste de carga no aplicativo para encontrar possíveis pontos de interrupção e entender como escaloná-lo.
Monitorar as métricas de desempenho
Use o Cloud Monitoring para analisar as tendências das métricas de performance, os efeitos dos experimentos, definir alertas para métricas importantes e realizar análises retrospectivas.
O Active Assist é um conjunto de ferramentas que pode fornecer insights e recomendações para ajudar a otimizar a utilização de recursos. Essas recomendações podem ajudar você a ajustar a alocação de recursos e melhorar o desempenho.
Aproveitar a elasticidade
Esse princípio no pilar de otimização de performance do Google Cloud Well-Architected Framework fornece recomendações para ajudar você a incorporar a elasticidade, que é a capacidade de ajustar os recursos de maneira dinâmica com base nas mudanças nos requisitos da carga de trabalho.
A elasticidade permite que diferentes componentes de um sistema sejam escalonados de forma independente. Esse escalonamento direcionado pode ajudar a melhorar o desempenho e a eficiência de custos, alocando recursos exatamente onde são necessários, sem provisionamento excessivo ou insuficiente.
Visão geral do princípio
Os requisitos de desempenho de um sistema influenciam diretamente quando e como ele é escalonado vertical ou horizontalmente. É necessário avaliar a capacidade do sistema e determinar a carga que ele deve processar no valor de referência. Em seguida, determine como você quer que o sistema responda aos aumentos e diminuições na carga.
Quando a carga aumenta, o sistema precisa escalonar horizontalmente, escalonar verticalmente ou ambos. Para o escalonamento horizontal, adicione nós de réplica para garantir que o sistema tenha capacidade geral suficiente para atender ao aumento da demanda. Para escalonamento vertical, substitua os componentes atuais do aplicativo por componentes com mais capacidade, memória e armazenamento.
Quando a carga diminui, o sistema precisa reduzir escala vertical (horizontalmente, verticalmente ou ambos).
Defina as circunstâncias em que o sistema aumenta ou reduz a escala vertical. Planeje o escalonar verticalmente manual dos sistemas para períodos conhecidos de alto tráfego. Use ferramentas como o escalonamento automático, que responde a aumentos ou diminuições na carga.
Recomendações
Para aproveitar a elasticidade, considere as recomendações nas seções a seguir.
Planejar períodos de pico de carga
É preciso planejar um caminho de escalonamento eficiente para eventos conhecidos, como períodos esperados de aumento na demanda dos clientes.
Considere aumentar a escala do sistema antes de períodos conhecidos de alto tráfego. Por exemplo, se você é uma organização de varejo, espera que a demanda aumente durante as vendas sazonais. Recomendamos que você escalonar verticalmente ou escalonar horizontalmente seus sistemas de forma manual antes dessas vendas para garantir que o sistema possa lidar imediatamente com o aumento da carga ou ajustar imediatamente os limites atuais. Caso contrário, o sistema pode levar vários minutos para adicionar recursos em resposta a mudanças em tempo real. A capacidade do aplicativo pode não aumentar com rapidez suficiente e causar atrasos para alguns usuários.
Para eventos desconhecidos ou inesperados, como um aumento repentino na demanda ou no tráfego, é possível usar recursos de escalonamento automático para acionar o escalonamento elástico com base em métricas. Essas métricas podem incluir utilização da CPU, capacidade de veiculação do balanceador de carga, latência e até métricas personalizadas que você define no Cloud Monitoring.
Por exemplo, considere um aplicativo executado em um grupo gerenciado de instâncias (MIG, na sigla em inglês) do Compute Engine. Esse aplicativo exige que cada instância funcione de maneira ideal até que a utilização média da CPU atinja 75%. Neste exemplo, você pode definir uma política de escalonamento automático que cria mais instâncias quando o uso da CPU atinge o limite. Essas instâncias recém-criadas ajudam a absorver a carga, o que garante que a utilização média da CPU permaneça em uma taxa ideal até que o número máximo de instâncias configuradas para o MIG seja atingido. Quando a demanda diminui, a política de escalonamento automático remove as instâncias que não são mais necessárias.
Planeje reservas de slots de recursos no BigQuery ou ajuste os limites para configurações de escalonamento automático no Spanner usando o escalonador automático gerenciado.
Usar o escalonamento preditivo
Se os componentes do sistema incluírem o Compute Engine, avalie se o escalonamento automático preditivo é adequado para sua carga de trabalho. O escalonamento automático preditivo prevê a carga futura com base nas tendências históricas das suas métricas, como o uso da CPU. As previsões são recalculadas a cada poucos minutos, de modo que o escalonador automático adapta rapidamente a previsão a mudanças muito recentes na carga. Sem o escalonamento automático preditivo, um escalonador automático só pode dimensionar um grupo de forma reativa, com base em mudanças observadas em tempo real na carga. O escalonamento automático preditivo funciona com dados em tempo real e dados históricos para responder à carga atual e prevista.
Implementar arquiteturas sem servidor
Considere implementar uma arquitetura sem servidor com serviços inerentemente elásticos, como:
Ao contrário do escalonamento automático em outros serviços que exigem regras de ajuste (por exemplo, o Compute Engine), o escalonamento automático sem servidor é instantâneo e pode reduzir escala vertical para zero recurso.
Usar o modo Autopilot para Kubernetes
Para aplicativos complexos que exigem maior controle sobre o Kubernetes, considere o modo Autopilot no Google Kubernetes Engine (GKE). O modo Autopilot oferece automação e escalonabilidade por padrão. O GKE escalona automaticamente os nós e os recursos com base no tráfego. O GKE gerencia nós, cria novos nós para seus aplicativos e configura upgrades e reparos automáticos.
Promover o design modular
Esse princípio no pilar de otimização de performance do Google Cloud Well-Architected Framework fornece recomendações para ajudar você a promover um design modular. Componentes modulares e interfaces claras podem permitir escalonamento flexível, atualizações independentes e separação futura de componentes.
Visão geral do princípio
Entender as dependências entre os componentes de aplicativo e os componentes do sistema para projetar um sistema escalonável.
O design modular permite flexibilidade e resiliência, independentemente de uma arquitetura monolítica ou de microsserviços ter sido implantada inicialmente. Ao decompor o sistema em módulos bem definidos e independentes com interfaces claras, é possível escalonar componentes individuais para atender a demandas específicas.
O escalonamento direcionado pode ajudar a otimizar o uso de recursos e reduzir custos das seguintes maneiras:
- Provisiona apenas os recursos necessários para cada componente e aloca menos recursos para componentes menos exigentes.
- Adiciona mais recursos durante períodos de alto tráfego para manter a experiência do usuário.
- Remove recursos subutilizados sem comprometer o desempenho.
A modularidade também melhora a manutenção. Unidades menores e independentes são mais fáceis de entender, depurar e atualizar, o que pode levar a ciclos de desenvolvimento mais rápidos e menor risco.
Embora a modularidade ofereça vantagens significativas, é preciso avaliar as possíveis compensações de desempenho. O aumento da comunicação entre os módulos pode introduzir latência e sobrecarga. Busque um equilíbrio entre modularidade e desempenho. Um design altamente modular pode não ser adequado para todos os casos. Quando o desempenho é fundamental, uma abordagem mais acoplada pode ser adequada. O design do sistema é um processo iterativo, em que você revisa e refina continuamente o design modular.
Recomendações
Para promover designs modulares, considere as recomendações nas seções a seguir.
Crie designs com foco em acoplamento flexível
Projete uma arquitetura com acoplamento flexível. Componentes independentes com dependências mínimas podem ajudar você a criar aplicativos escalonáveis e resilientes. Ao planejar os limites dos seus serviços, considere os requisitos de disponibilidade e escalonabilidade. Por exemplo, se um componente tiver requisitos diferentes dos outros, você poderá projetá-lo como um serviço independente. Implemente um plano para falhas graduais em subprocessos ou serviços menos importantes que não afetam o tempo de resposta dos serviços principais.
Projetar para simultaneidade e paralelismo
Projete seu aplicativo para oferecer suporte a várias tarefas simultaneamente, como processar vários pedidos de usuários ou executar jobs em segundo plano enquanto os usuários interagem com seu sistema. Divida tarefas grandes em partes menores que podem ser processadas ao mesmo tempo por várias instâncias de serviço. A simultaneidade de tarefas permite usar recursos como escalonamento automático para aumentar a alocação de recursos em produtos como os seguintes:
Modularidade de equilíbrio para alocação flexível de recursos
Sempre que possível, garanta que cada componente use apenas os recursos necessários (como memória, armazenamento e poder de processamento) para operações específicas. A alocação excessiva de recursos pode resultar em custos desnecessários, enquanto a alocação insuficiente pode comprometer o desempenho.
Use interfaces bem definidas
Garanta que os componentes modulares se comuniquem de maneira eficaz por interfaces claras e padronizadas (como APIs e filas de mensagens) para reduzir o overhead das camadas de tradução ou do tráfego desnecessário.
Usar modelos sem estado
Um modelo sem estado pode ajudar a garantir que você processe cada solicitação ou interação com o serviço de forma independente das solicitações anteriores. Esse modelo facilita a escalonabilidade e a recuperabilidade, porque é possível aumentar, reduzir ou reiniciar o serviço sem perder os dados necessários para solicitações ou processos em andamento.
Escolha tecnologias complementares
Escolha tecnologias que complementem o design modular. Avalie linguagens de programação, frameworks e bancos de dados quanto ao suporte à modularidade.
Para saber mais, acesse os recursos a seguir:
Monitorar e melhorar o desempenho continuamente
Este princípio no pilar de otimização de desempenho do Google Cloud Well-Architected Framework fornece recomendações para ajudar você a monitorar e melhorar o desempenho continuamente.
Depois de implantar os aplicativos, monitore continuamente o desempenho deles usando registros, rastreamento, métricas e alertas. À medida que seus aplicativos crescem e evoluem, é possível usar as tendências nesses pontos de dados para reavaliar seus requisitos de desempenho. Talvez seja necessário reformular algumas partes dos aplicativos para manter ou melhorar o desempenho.
Visão geral do princípio
O processo de melhoria contínua de desempenho requer ferramentas e estratégias de monitoramento robustas. As ferramentas de observabilidade do Cloud podem ajudar você a coletar indicadores principais de desempenho (KPIs), como latência, capacidade de processamento, taxas de erro e utilização de recursos. Os ambientes de nuvem oferecem vários métodos para realizar avaliações de desempenho granulares no aplicativo, na rede e na experiência do usuário final.
Melhorar o desempenho é um esforço contínuo que requer uma abordagem multifacetada. Os seguintes mecanismos e processos principais podem ajudar a melhorar o desempenho:
- Para dar uma direção clara e ajudar a acompanhar o progresso, defina objetivos de performance que se alinhem às suas metas de negócios. Estabeleça metas SMART: específicas, mensuráveis, alcançáveis, relevantes e com prazo determinado.
- Para medir o desempenho e identificar áreas de melhoria, colete métricas de KPI.
- Para monitorar continuamente seus sistemas em busca de problemas, use fluxos de trabalho visualizados em ferramentas de monitoramento. Use técnicas de mapeamento de processos de arquitetura para identificar redundâncias e ineficiências.
- Para criar uma cultura de melhoria contínua, ofereça treinamentos e programas que apoiem o crescimento dos funcionários.
- Para incentivar a melhoria proativa e contínua, incentive seus funcionários e clientes a fornecer feedback constante sobre a performance do aplicativo.
Recomendações
Para promover designs modulares, considere as recomendações nas seções a seguir.
Definir metas e métricas de performance claras
Defina objetivos de performance claros que estejam alinhados às suas metas de negócios. Isso requer uma compreensão profunda da arquitetura do aplicativo e dos requisitos de performance de cada componente do aplicativo.
Priorize a otimização dos componentes mais críticos que influenciam diretamente as funções principais da sua empresa e a experiência do usuário. Para garantir que esses componentes continuem funcionando de maneira eficiente e atendam às suas necessidades de negócios, defina metas de performance específicas e mensuráveis. Essas metas podem incluir tempos de resposta, taxas de erro e limites de utilização de recursos.
Essa abordagem proativa ajuda a identificar e resolver possíveis gargalos, otimizar a alocação de recursos e, por fim, oferecer uma experiência integrada e de alto desempenho para os usuários.
Monitore o desempenho
Monitore continuamente seus sistemas de nuvem para detectar problemas de desempenho e configure alertas para possíveis problemas. O monitoramento e os alertas ajudam a detectar e corrigir problemas antes que eles afetem os usuários. A criação de perfil de aplicativos pode ajudar a identificar gargalos e otimizar o uso de recursos.
Use ferramentas que facilitam a solução de problemas e a otimização de rede. Use o Google Cloud Observability para identificar áreas com alto consumo de CPU, memória ou rede. Esses recursos podem ajudar os desenvolvedores a melhorar a eficiência, reduzir custos e aprimorar a experiência do usuário. O Network Intelligence Center mostra visualizações da topologia da sua infraestrutura de rede e pode ajudar você a identificar caminhos de alta latência.
Incentivar a melhoria contínua
Crie uma cultura de melhoria contínua que beneficie o aplicativo e a experiência do usuário.
Ofereça aos funcionários oportunidades de treinamento e desenvolvimento que aprimorem as habilidades e o conhecimento deles em técnicas de desempenho em serviços de nuvem. Estabeleça uma comunidade de prática (CoP) e ofereça programas de mentoria e treinamento para apoiar o crescimento dos funcionários.
Para evitar o gerenciamento de desempenho reativo e incentivar o gerenciamento de desempenho proativo, incentive o feedback contínuo de funcionários, clientes e partes interessadas. Você pode gamificar o processo rastreando KPIs de desempenho e apresentando essas métricas às equipes com frequência na forma de uma tabela de classificação.
Para entender sua performance e a satisfação do usuário ao longo do tempo, recomendamos que você meça o feedback do usuário de forma quantitativa e qualitativa. A estrutura HEART pode ajudar você a capturar o feedback dos usuários em cinco categorias:
- Felicidade
- Engajamento
- Adoção
- Retenção
- Sucesso na tarefa
Ao usar esse framework, você pode incentivar os engenheiros com feedback baseado em dados, métricas centradas no usuário, insights úteis e uma compreensão clara das metas.