


Une plate-forme de gestion des données et d'analyse d'entreprise fournit une enclave dans laquelle vous pouvez stocker, analyser et manipuler des informations sensibles tout en maintenant les contrôles de sécurité. Vous pouvez utiliser l'architecture de maillage de données d'entreprise pour déployer une plate-forme sur Google Cloud pour la gestion et l'analyse des données. L'architecture est conçue pour fonctionner dans un environnement hybride, où les composants Google Cloud interagissent avec vos composants et processus d'exploitation sur site existants.
L'architecture de maillage de données d'entreprise comprend les éléments suivants :
- Un dépôt GitHub contenant un ensemble de configurations, de scripts et de code Terraform pour créer les éléments suivants :
- Un projet de gouvernance qui vous permet d'utiliser l'implémentation par Google du framework des principaux contrôles de Cloud Data Management Capabilities (CDMC).
- Exemple de plate-forme de données compatible avec les workflows interactifs et de production.
- Un environnement de producteur au sein de la plate-forme de données qui accepte plusieurs domaines de données. Les domaines de données sont des regroupements logiques d'éléments de données.
- Un environnement client au sein de la plate-forme de données qui accepte plusieurs projets clients.
- Un service de transfert de données qui utilise la fédération d'identité de charge de travail et la bibliothèque de chiffrement Tink pour vous aider à transférer des données vers Google Cloud de manière sécurisée.
- Exemple de domaine de données contenant des projets d'ingestion, non confidentiels et confidentiels.
- Exemple de système d'accès aux données qui permet aux consommateurs de données de demander l'accès à des ensembles de données et aux propriétaires de données d'accorder l'accès à ces ensembles de données. L'exemple inclut également un gestionnaire de workflows qui modifie les autorisations IAM de ces ensembles de données en conséquence.
- Un guide de l'architecture, de la conception, des contrôles de sécurité et des processus opérationnels que vous utilisez pour mettre en œuvre cette architecture (ce document).
L'architecture de maillage de données d'entreprise est conçue pour être compatible avec le plan de base de l'entreprise. Le plan de base d'entreprise fournit un certain nombre de services de base sur lesquels cette architecture s'appuie, tels que les réseaux VPC et la journalisation. Vous pouvez déployer cette architecture sans déployer le plan de base d'entreprise si votre environnementGoogle Cloud fournit les fonctionnalités nécessaires.
Ce document est destiné aux architectes cloud, aux data scientists, aux ingénieurs de données et aux architectes de sécurité qui peuvent utiliser l'architecture pour créer et déployer des services de données complets sur Google Cloud. Ce document part du principe que vous connaissez les concepts de maillages de données, Google Cloudde services de données et de mise en œuvre Google Cloud du framework CDMC.
Architecture
L'architecture de maillage de données d'entreprise adopte une approche par couches pour fournir les fonctionnalités d'ingestion, de traitement et de gouvernance des données. L'architecture est destinée à être déployée et contrôlée via un workflow CI/CD. Le schéma suivant montre comment la couche de données déployée par cette architecture est liée aux autres couches de votre environnement.

Ce schéma comprend les éléments suivants :
- L'infrastructureGoogle Cloud vous fournit des fonctionnalités de sécurité telles que le chiffrement au repos et le chiffrement en transit, ainsi que des éléments de base tels que le calcul et le stockage.
- La base d'entreprise fournit une référence de ressources telles que les systèmes d'identité, de mise en réseau, de journalisation, de surveillance et de déploiement qui vous permettent d'adopter Google Cloud pour vos charges de travail de données.
- La couche de données offre diverses fonctionnalités telles que l'ingestion de données, le stockage de données, le contrôle des accès aux données et la gouvernance des données, ainsi que la surveillance et le partage des données.
- La couche d'application représente différentes applications qui utilisent les éléments de la couche de données.
- Le CI/CD fournit les outils nécessaires pour automatiser le provisionnement, la configuration, la gestion et le déploiement de l'infrastructure, des workflows et des composants logiciels. Ces composants vous aident à garantir des déploiements cohérents, fiables et contrôlables, limiter les erreurs manuelles et accélérer le cycle de développement global.
Pour illustrer l'utilisation de l'environnement de données, l'architecture inclut un exemple de workflow de données. L'exemple de workflow de données vous guide à travers les processus suivants : gouvernance des données, ingestion des données, traitement des données, partage des données et consommation des données.
Principales décisions en termes d'architecture
Le tableau suivant récapitule les décisions générales relatives à l'architecture.
| Zone de décision | Décision |
|---|---|
| ArchitectureGoogle Cloud | |
Hiérarchie des ressources |
L'architecture utilise la hiérarchie des ressources du plan de base de l'entreprise. |
Mise en réseau |
L'architecture inclut un exemple de service de transfert de données qui utilise la fédération d'identité de charge de travail et une bibliothèque Tink. |
Rôles et autorisations IAM |
L'architecture inclut des rôles segmentés de producteur de données, de consommateur de données, de gouvernance des données et de plate-forme de données. |
| Services de données courants | |
Métadonnées |
L'architecture utilise Knowledge Catalog pour gérer les métadonnées des données. |
Gestion centralisée des règles |
Pour gérer les règles, l'architecture utilise l'implémentation du framework CDMC par Google Cloud. |
Gestion des accès aux données |
Pour contrôler l'accès aux données, l'architecture inclut un processus indépendant qui oblige les utilisateurs de données à demander l'accès aux éléments de données au propriétaire des données. |
Qualité des données |
L'architecture utilise le moteur de qualité des données Cloud pour définir et exécuter des règles de qualité des données sur des colonnes de table spécifiées, en mesurant la qualité des données en fonction de métriques telles que l'exactitude et l'exhaustivité. |
Sécurité des données |
L'architecture utilise l'ajout de tags, le chiffrement, le masquage, la tokenisation et les contrôles IAM pour assurer la sécurité des données. |
| Domaine de données | |
Environnements de données |
L'architecture comprend trois environnements. Deux environnements (hors production et production) sont des environnements opérationnels pilotés par des pipelines. Un environnement (développement) est un environnement interactif. |
Propriétaires des données |
Les propriétaires de données ingèrent, traitent, exposent et accordent l'accès aux éléments de données. |
Consommateurs de données |
Les consommateurs de données demandent l'accès aux éléments de données. |
| Intégration et opérations | |
Pipelines |
L'architecture utilise les pipelines suivants pour déployer des ressources :
|
Dépôts |
Chaque pipeline utilise un dépôt distinct pour permettre la séparation des responsabilités. |
Flux de processus |
Le processus exige que les modifications apportées à l'environnement de production incluent un demandeur et un approbateur. |
| Cloud Operations | |
Tableaux de données des produits de données |
Le moteur de rapport génère des tableaux de données de produits. |
Cloud Logging |
L'architecture utilise l'infrastructure de journalisation du plan de base de l'entreprise. |
Cloud Monitoring |
L'architecture utilise l'infrastructure de surveillance du plan de base de l'entreprise. |
Identité : mapper des rôles à des groupes
Le maillage de données exploite l'architecture existante de gestion du cycle de vie des identités, d'autorisation et d'authentification du plan de base de l'entreprise. Les rôles ne sont pas directement attribués aux utilisateurs. Les groupes constituent la méthode principale pour attribuer des rôles et des autorisations dans IAM. Les rôles et les autorisations IAM sont attribués lors de la création du projet via le pipeline de base.
Le maillage de données associe des groupes à l'un des quatre domaines clés : infrastructure, gouvernance des données, producteurs de données basés sur un domaine et consommateurs basés sur un domaine.
Les niveaux d'autorisation de ces groupes sont les suivants :
- Le champ d'application des autorisations du groupe d'infrastructure est le maillage de données dans son ensemble.
- Le champ d'application des autorisations des groupes de gouvernance des données est le projet de gouvernance des données.
- Les autorisations des producteurs et des consommateurs basés sur un domaine sont limitées à leur domaine de données.
Les tableaux suivants présentent les différents rôles utilisés dans cette implémentation de maillage de données et les autorisations associées.
Infrastructure
| Groupe | Description | Rôles |
|---|---|---|
|
Administrateurs généraux du maillage de données |
|
Gouvernance des données
| Groupe | Description | Rôles |
|---|---|---|
|
Administrateurs du projet de gouvernance des données |
|
|
Développeurs qui créent et gèrent les composants de gouvernance des données |
Plusieurs rôles sur le projet de gouvernance des données, y compris |
|
Lecteurs d'informations sur la gouvernance des données |
|
|
Administrateurs de sécurité du projet de gouvernance |
|
|
Groupe autorisé à utiliser les types d'aspects |
|
|
Groupe autorisé à utiliser des types d'aspects et à ajouter des aspects |
|
|
Groupe de comptes de service pour les notifications Security Command Center |
Aucune. Il s'agit d'un groupe d'appartenance. Un compte de service est créé avec ce nom et dispose des autorisations nécessaires. |
Producteurs de données basés sur le domaine
| Groupe | Description | Rôles |
|---|---|---|
|
Administrateurs d'un domaine de données spécifique |
|
|
Développeurs qui créent et gèrent des produits de données dans un domaine de données |
Plusieurs rôles sur le projet de domaine de données, y compris |
|
Lecteurs des informations sur le domaine de données |
|
|
Éditeurs d'entrées Knowledge Catalog |
Rôles permettant de modifier les entrées Knowledge Catalog |
|
Intendants de données pour le domaine de données |
Rôles pour gérer les aspects liés aux métadonnées et à la gouvernance des données |
Consommateurs de données basés sur le domaine
| Groupe | Description | Rôles |
|---|---|---|
|
Administrateurs d'un projet client spécifique |
|
|
Développeurs travaillant dans un projet client |
Plusieurs rôles sur le projet client, y compris les rôles |
|
Lecteurs des informations sur le projet client |
|
Structure organisationnelle
Pour différencier les opérations de production des données de production, l'architecture utilise différents environnements pour développer et publier des workflows. Les opérations de production incluent la gouvernance, la traçabilité et la répétabilité d'un workflow, ainsi que l'auditabilité des résultats du workflow. Les données de production désignent les données potentiellement sensibles dont vous avez besoin pour gérer votre organisation. Tous les environnements sont conçus pour disposer de contrôles de sécurité vous permettant d'ingérer et d'exploiter vos données.
Pour aider les data scientists et les ingénieurs, l'architecture inclut un environnement interactif, dans lequel les développeurs peuvent travailler directement avec l'environnement et ajouter des services via un catalogue de solutions sélectionnées. Les environnements opérationnels sont gérés par des pipelines dont l'architecture et la configuration sont codifiées.
Cette architecture utilise la structure organisationnelle du plan de base de l'entreprise comme base pour le déploiement des charges de travail de données. Le schéma suivant montre les dossiers et projets de premier niveau utilisés dans l'architecture de maillage de données d'entreprise.

Le tableau suivant décrit les dossiers et les projets de premier niveau qui font partie de l'architecture.
| Dossier | Composant | Description |
|---|---|---|
|
|
Contient le pipeline de déploiement utilisé pour créer les artefacts de code de l'architecture. |
|
Contient l'infrastructure utilisée par catalogue de services pour déployer des ressources dans l'environnement interactif. |
|
|
Contient toutes les ressources utilisées par l'implémentation du framework CDMC par Google Cloud. |
|
|
|
Contient les projets et les ressources de la plate-forme de données pour développer des cas d'utilisation en mode interactif. |
|
|
Contient les projets et les ressources de la plate-forme de données pour tester les cas d'utilisation que vous souhaitez déployer dans un environnement opérationnel. |
|
|
Contient les projets et les ressources de la plate-forme de données pour le déploiement en production. |
Dossier de la plate-forme de données
Le dossier de la plate-forme de données contient tous les composants du plan de données et certaines ressources CDMC. De plus, le dossier de la plate-forme de données et le projet de gouvernance des données contiennent les ressources CDMC. Le schéma suivant montre les dossiers et les projets déployés dans le dossier de la plate-forme de données.

Chaque dossier de plate-forme de données inclut un dossier d'environnement (production, hors production et développement). Le tableau suivant décrit les dossiers de chaque dossier de plate-forme de données.
| Dossiers | Description |
|---|---|
Producteurs |
Contient les domaines de données. |
Clients |
Contient les projets clients. |
Domaine de données |
Contient les projets associés à un domaine particulier. |
Dossier "producers"
Chaque dossier de producteurs inclut un ou plusieurs domaines de données. Un domaine de données fait référence à un regroupement logique d'éléments de données qui partagent une signification, un objectif ou un contexte métier communs. Les domaines de données vous permettent de catégoriser et d'organiser les éléments de données au sein d'une organisation. Le schéma suivant illustre la structure d'un domaine de données. L'architecture déploie des projets dans le dossier de la plate-forme de données pour chaque environnement.
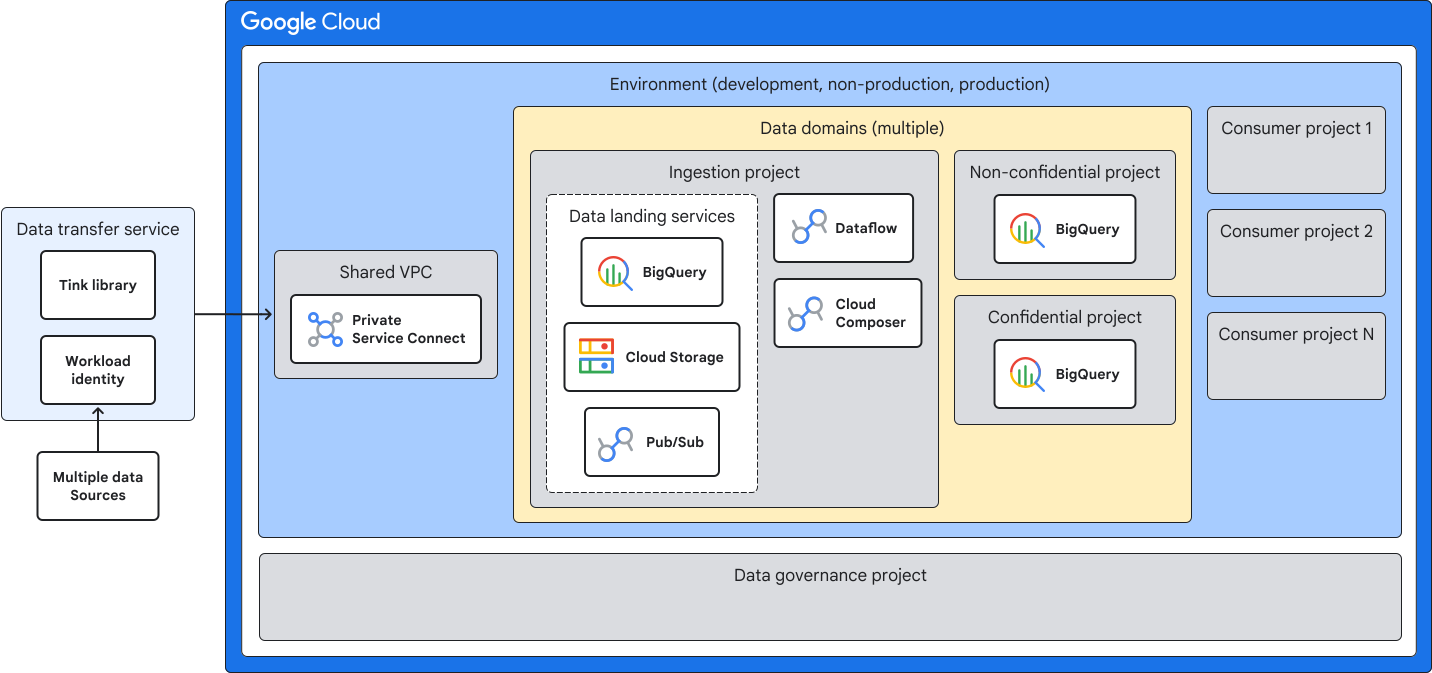
Le tableau suivant décrit les projets déployés dans le dossier de la plate-forme de données pour chaque environnement.
| Projet | Description |
|---|---|
Ingestion |
Le projet d'ingestion ingère les données dans le domaine de données. L'architecture fournit des exemples de diffusion de données dans BigQuery, Cloud Storage et Pub/Sub. Le projet d'ingestion contient également des exemples de Dataflow et de Managed Service pour Apache Airflow que vous pouvez utiliser pour orchestrer la transformation et le déplacement des données ingérées. |
Non confidentiel |
Le projet non confidentiel contient des données qui ont été anonymisées. Vous pouvez masquer, conteneuriser, chiffrer, tokeniser ou obscurcir les données. Utilisez des tags avec stratégie pour contrôler la présentation des données. |
Confidentiel |
Le projet confidentiel contient des données en texte brut. Vous pouvez contrôler l'accès via les autorisations IAM. |
Dossier Consumer
Le dossier client contient des projets clients. Les projets client fournissent un mécanisme permettant de segmenter les utilisateurs de données en fonction de la limite de confiance requise. Chaque projet est attribué à un groupe d'utilisateurs distinct, et le groupe se voit attribuer l'accès aux éléments de données requis projet par projet. Vous pouvez utiliser le projet client pour collecter, analyser et enrichir les données du groupe.
Dossier commun
Le dossier commun contient les services utilisés par différents environnements et projets. Cette section décrit les fonctionnalités ajoutées au dossier commun pour activer le maillage de données d'entreprise.
Architecture CDMC
L'architecture utilise l'architecture CDMC pour la gouvernance des données. Les fonctions de gouvernance des données résident dans le projet de gouvernance des données du dossier commun. Le schéma suivant présente les composants de l'architecture CDMC. Les numéros indiqués dans le schéma représentent les principaux contrôles adressés aux services Google Cloud.

Le tableau suivant décrit les composants de l'architecture CDMC utilisés par l'architecture de maillage de données d'entreprise.
| Composant CDMC | ServiceGoogle Cloud | Description |
|---|---|---|
| Composants d'accès et de cycle de vie | ||
Gestion des clés |
Cloud KMS |
Service qui gère de manière sécurisée les clés de chiffrement qui protègent les données sensibles. |
Gestionnaire d'enregistrements |
Cloud Run |
Application qui conserve des journaux et des enregistrements complets des activités de traitement des données, ce qui permet aux organisations de suivre et d'auditer l'utilisation des données. |
Règle d'archivage |
BigQuery |
Une table BigQuery contenant la règle de stockage des données. |
Droits |
BigQuery |
Une table BigQuery qui stocke des informations sur les personnes autorisées à accéder aux données sensibles. Cette table garantit que seuls les utilisateurs autorisés peuvent accéder à des données spécifiques en fonction de leurs rôles et de leurs droits. |
| Composants d'analyse | ||
Perte de données |
Sensitive Data Protection |
Service utilisé pour inspecter les éléments à la recherche de données sensibles. |
Résultats de la protection contre la perte de données |
BigQuery |
Une table BigQuery qui catalogue les classifications de données au sein de la plate-forme de données. |
Règles |
BigQuery |
Une table BigQuery contenant des pratiques de gouvernance des données cohérentes (par exemple, des types d'accès aux données). |
Exportation de la facturation |
BigQuery |
Une table qui stocke les informations de coût exportées depuis Cloud Billing pour permettre l'analyse des métriques de coût associées aux éléments de données. |
Moteur de qualité des données Cloud |
Cloud Run |
Application qui exécute des contrôles de qualité des données pour les tables et les colonnes. |
Résultats liés à la qualité des données |
BigQuery |
Une table BigQuery qui enregistre les écarts identifiés entre les règles de qualité des données définies et la qualité réelle des éléments de données. |
| Composants de reporting | ||
Programmeur |
Cloud Scheduler |
Service qui contrôle l'exécution de Cloud Data Quality Engine et l'inspection Sensitive Data Protection. |
Moteur de rapport |
Cloud Run |
Application qui génère des rapports permettant de suivre et de mesurer le respect des contrôles du framework CDMC. |
Résultats et éléments |
BigQuery et Pub/Sub |
Un rapport BigQuery sur les écarts ou les incohérences dans les contrôles de gestion des données, tels que des aspects manquants, des classifications incorrectes ou des emplacements de stockage non conformes. |
Exportations de tags |
BigQuery |
Une table BigQuery contenant les informations d'aspect extraites de Knowledge Catalog. |
| Autres composants | ||
Gestion des règles |
Service de règles d'administration |
Service qui définit et applique des restrictions sur l'emplacement géographique de stockage des données. |
Stratégies d'accès basées sur les attributs |
Access Context Manager |
Service qui définit et applique des règles d'accès précises basées sur des attributs, de sorte que seuls les utilisateurs autorisés à partir d'emplacements et d'appareils autorisés puissent accéder aux informations sensibles. |
Métadonnées |
Knowledge Catalog |
Service qui stocke les métadonnées des tables utilisées dans le maillage de données. |
Tag Engine |
Cloud Run |
Une application qui ajoute des aspects aux entrées de table BigQuery dans Knowledge Catalog. |
Rapports CDMC |
Data Studio |
Tableaux de bord permettant à vos analystes de consulter les rapports générés par les moteurs d'architecture CDMC. |
Implémentation de CDMC
Le tableau suivant décrit comment l'architecture met en œuvre les principaux contrôles dans le framework CDMC.
| Exigence de contrôle CDMC | Implémentation |
|---|---|
Le moteur de rapport détecte les éléments de données non conformes et publie les résultats dans un sujet Pub/Sub. Ces résultats sont également chargés dans BigQuery pour créer des rapports à l'aide de Data Studio. |
|
La propriété des données est établie pour les données migrées et générées dans le cloud. |
Knowledge Catalog capture automatiquement les métadonnées techniques de BigQuery. Tag Engine applique des aspects de métadonnées métier tels que le nom du propriétaire et le niveau de sensibilité à partir d'une table de référence, ce qui permet de s'assurer que toutes les données sensibles sont annotées avec les informations du propriétaire à des fins de conformité. Ce processus automatisé permet d'assurer la gouvernance et la conformité des données en identifiant et en étiquetant les données sensibles avec les informations appropriées sur le propriétaire. |
L'approvisionnement et la consommation des données sont régis et soutenus par l'automatisation |
Knowledge Catalog classe les éléments de données en les annotant avec un aspect qui inclut un indicateur |
La souveraineté des données et le transfert des données à l'international sont gérés |
Le service de règles d'administration définit les régions de stockage autorisées pour les éléments de données, et Access Context Manager limite l'accès en fonction de l'emplacement de l'utilisateur. Knowledge Catalog stocke les emplacements de stockage approuvés en tant qu'aspects de métadonnées. Report Engine compare ces aspects à l'emplacement réel des éléments de données dans BigQuery et publie les éventuels écarts sous forme de résultats à l'aide de Pub/Sub. Security Command Center fournit une couche de surveillance supplémentaire en générant des résultats de failles si des données sont stockées ou consultées en dehors des règles définies. |
Les catalogues de données sont mis en œuvre, utilisés et interopérables |
Knowledge Catalog stocke et met à jour les métadonnées techniques de tous les éléments de données BigQuery, créant ainsi un Data Catalog synchronisé en continu. Knowledge Catalog s'assure que toutes les tables et vues nouvelles ou modifiées sont immédiatement ajoutées au catalogue, ce qui permet de maintenir un inventaire à jour des éléments de données. |
Sensitive Data Protection inspecte les données BigQuery et identifie les types d'informations sensibles. Ces résultats sont ensuite classés en fonction d'une table de référence de classification, et le niveau de sensibilité le plus élevé est attribué en tant qu'aspect dans Knowledge Catalog au niveau de la colonne et de la table. Tag Engine gère ce processus en mettant à jour Knowledge Catalog avec des aspects de sensibilité chaque fois que de nouveaux éléments de données sont ajoutés ou que des éléments existants sont modifiés. Ce processus garantit une classification constamment mise à jour des données en fonction de leur sensibilité, que vous pouvez surveiller et signaler à l'aide de Pub/Sub et d'outils de reporting intégrés. |
|
Les droits d'accès aux données sont gérés, appliqués et suivis. |
Les tags avec stratégie BigQuery contrôlent l'accès aux données sensibles au niveau des colonnes, ce qui garantit que seuls les utilisateurs autorisés peuvent accéder à des données spécifiques en fonction du tag avec stratégie qui leur est attribué. IAM gère l'accès global à l'entrepôt de données, tandis que Knowledge Catalog stocke les classifications de sensibilité. Des vérifications régulières sont effectuées pour s'assurer que toutes les données sensibles possèdent des tags avec stratégie correspondants. Les éventuelles anomalies sont signalées à l'aide de Pub/Sub pour correction. |
Les accords de partage de données pour les fournisseurs et les consommateurs sont stockés dans un entrepôt de données BigQuery dédié pour contrôler les objectifs de consommation. Knowledge Catalog étiquette les éléments de données avec les informations du contrat du fournisseur, tandis que les contrats des consommateurs sont associés à des liaisons IAM pour le contrôle des accès. Les libellés de requête appliquent les objectifs de consommation, ce qui oblige les consommateurs à spécifier un objectif valide lorsqu'ils interrogent des données sensibles, qui est validé par rapport à leurs droits d'accès dans BigQuery. Une piste d'audit dans BigQuery suit tous les accès aux données et garantit la conformité avec les accords de partage des données. |
|
Le chiffrement au repos par défaut de Google permet de protéger les données stockées sur le disque. Cloud KMS est compatible avec les clés de chiffrement gérées par le client (CMEK) pour une meilleure gestion des clés. BigQuery implémente le masquage dynamique des données au niveau des colonnes pour l'anonymisation et accepte l'anonymisation au niveau de l'application lors de l'ingestion des données. Knowledge Catalog stocke les aspects des métadonnées pour les techniques de chiffrement et d'anonymisation appliquées aux éléments de données. Des vérifications automatisées permettent de s'assurer que les méthodes de chiffrement et d'anonymisation sont conformes aux règles de sécurité prédéfinies, et que les écarts sont signalés comme des résultats à l'aide de Pub/Sub. |
|
Un cadre relatif à la confidentialité des données est défini et opérationnel |
Knowledge Catalog annote les éléments de données sensibles avec des aspects contenant des informations pertinentes pour l'évaluation de l'impact, telles que l'emplacement du sujet et les liens vers les rapports d'évaluation. Tag Engine applique ces aspects en fonction de la sensibilité des données et d'une table de règles dans BigQuery, qui définit les exigences d'évaluation en fonction de la résidence des données et du sujet. Ce processus automatisé permet de surveiller et de signaler en continu la conformité aux exigences d'évaluation d'impact, en veillant à ce que des analyses d'impact relatives à la protection des données (AIPD) ou des évaluations d'impact sur la protection des données soient effectuées si nécessaire. |
Knowledge Catalog ajoute des libellés aux éléments de données avec des règles de conservation, en spécifiant les durées de conservation et les actions d'expiration (telles que l'archivage ou la suppression définitive). Record Manager automatise l'application de ces règles en supprimant ou en archivant les tables BigQuery en fonction des aspects définis. Cette application garantit le respect des règles de cycle de vie des données et la conformité aux exigences de conservation des données. Les écarts sont détectés et signalés à l'aide de Pub/Sub. |
|
Cloud Data Quality Engine définit et exécute des règles de qualité des données sur des colonnes de table spécifiées, en mesurant la qualité des données en fonction de métriques telles que l'exactitude et l'exhaustivité. Les résultats de ces vérifications, y compris les pourcentages de réussite et les seuils, sont stockés en tant qu'aspects dans Knowledge Catalog. Le stockage de ces résultats permet de surveiller et de créer des rapports en continu sur la qualité des données. Les problèmes ou les écarts par rapport aux seuils acceptables sont publiés en tant que résultats à l'aide de Pub/Sub. |
|
Les principes de gestion des coûts sont établis et appliqués |
Knowledge Catalog stocke les métriques liées aux coûts des éléments de données, telles que les coûts de requête, de stockage et de sortie de données, qui sont calculées à l'aide des informations de facturation exportées de Cloud Billing vers BigQuery. Le stockage des métriques liées aux coûts permet un suivi et une analyse complets des coûts, ce qui garantit le respect des règles de coût et une utilisation efficace des ressources. Les anomalies sont signalées à l'aide de Pub/Sub. |
Les fonctionnalités intégrées de traçabilité des données de Knowledge Catalog suivent la provenance et la traçabilité des éléments de données, en représentant visuellement le flux de données. De plus, les scripts d'ingestion de données identifient et enregistrent la source d'origine des données en tant qu'aspect dans Knowledge Catalog, ce qui améliore la traçabilité des données jusqu'à leur origine. |
Gestion des accès aux données
L'accès aux données de l'architecture est contrôlé par un processus indépendant qui sépare le contrôle opérationnel (par exemple, l'exécution de jobs Dataflow) du contrôle des accès aux données. L'accès d'un utilisateur à un service Google Cloud est défini par un problème environnemental ou opérationnel, et est provisionné et approuvé par un groupe d'ingénierie cloud. L'accès d'un utilisateur aux éléments de données Google Cloud (par exemple, une table BigQuery) est un problème de confidentialité, de réglementation ou de gouvernance. Il est soumis à un accord d'accès entre les parties productrices et consommatrices, et contrôlé par les processus suivants. Le schéma suivant montre comment l'accès aux données est provisionné via l'interaction de différents composants logiciels.

Comme illustré dans le schéma précédent, l'intégration des accès aux données est gérée par les processus suivants :
- Les éléments de données cloud sont collectés et inventoriés par Knowledge Catalog.
- Le gestionnaire de workflow récupère les éléments de données de Knowledge Catalog.
- Les propriétaires de données sont intégrés au gestionnaire de workflows.
La gestion des accès aux données fonctionne comme suit :
- Un consommateur de données demande un asset spécifique.
- Le propriétaire des données de l'élément est alerté de la demande.
- Le propriétaire des données approuve ou refuse la demande.
- Si la demande est approuvée, le gestionnaire de workflow transmet le groupe, l'élément et le tag associé au mappeur IAM.
- Le mappeur IAM traduit les tags du gestionnaire de workflow en autorisations IAM et accorde au groupe spécifié des autorisations IAM pour l'élément de données.
- Lorsqu'un utilisateur souhaite accéder à l'élément de données, IAM évalue l'accès à l'élément Google Cloud en fonction des autorisations du groupe.
- Si l'accès est autorisé, l'utilisateur accède à l'élément de données.
Mise en réseau
Le processus de sécurité des données commence au niveau de l'application source, qui peut se trouver sur site ou dans un autre environnement externe au projetGoogle Cloud cible. Avant tout transfert réseau, cette application utilise la fédération d'identité de charge de travail pour s'authentifier de manière sécurisée auprès des API Google Cloud. À l'aide de ces identifiants, il interagit avec Cloud KMS pour obtenir ou encapsuler les clés nécessaires, puis utilise la bibliothèque Tink pour effectuer le chiffrement initial et l'anonymisation de la charge utile de données sensibles selon des modèles prédéfinis.
Une fois la charge utile de données protégée, elle doit être transférée de manière sécurisée vers le projet d'ingestion Google Cloud . Pour les applications sur site, vous pouvez utiliser Cloud Interconnect ou éventuellement Cloud VPN. Dans le réseauGoogle Cloud , utilisez Private Service Connect pour acheminer les données vers le point de terminaison d'ingestion dans le réseau VPC du projet cible. Private Service Connect permet à l'application source de se connecter aux API Google à l'aide d'adresses IP privées, ce qui garantit que le trafic n'est pas exposé à Internet.
L'intégralité du chemin réseau et les services d'ingestion cibles (Cloud Storage, BigQuery et Pub/Sub) du projet d'ingestion sont sécurisés par un périmètre VPC Service Controls. Ce périmètre applique une limite de sécurité, garantissant que les données protégées provenant de la source ne peuvent être ingérées que dans les servicesGoogle Cloud autorisés au sein de ce projet spécifique.
Journalisation
Cette architecture utilise les fonctionnalités Cloud Logging fournies par le plan de base d'entreprise.
Pipelines
L'architecture de maillage de données d'entreprise utilise une série de pipelines pour provisionner l'infrastructure, l'orchestration, les ensembles de données, les pipelines de données et les composants d'application. Les pipelines de déploiement de ressources de l'architecture utilisent Terraform comme outil d'infrastructure as code (IaC) et Cloud Build comme service CI/CD pour déployer les configurations Terraform dans l'environnement de l'architecture. Le schéma suivant illustre la relation entre les pipelines.

Le pipeline de base et le pipeline d'infrastructure font partie du plan de base de l'entreprise. Le tableau suivant décrit l'objectif des pipelines et les ressources qu'ils provisionnent.
| Pipeline | Provisionné par | Ressources |
|---|---|---|
Pipeline de base |
Amorçage |
|
Pipeline d'infrastructure |
Pipeline de base |
|
Pipeline catalogue de services |
Pipeline d'infrastructure |
|
Pipelines d'artefacts |
Pipeline d'infrastructure |
Les pipelines d'artefacts produisent les différents conteneurs et autres composants de la codebase utilisée par le maillage de données. |
Chaque pipeline possède son propre ensemble de dépôts à partir desquels il extrait le code et les fichiers de configuration. Chaque dépôt dispose d'une séparation des tâches, où les personnes qui envoient et approuvent les déploiements de code opérationnel sont issues de groupes différents.
Déploiement interactif via catalogue de services
Les environnements interactifs sont l'environnement de développement au sein de l'architecture et existent dans le dossier de développement. L'interface principale de l'environnement interactif est catalogue de services, qui permet aux développeurs d'utiliser des modèles préconfigurés pour instancier des services Google. Ces modèles préconfigurés sont appelés modèles de service. Les modèles de service vous aident à appliquer votre stratégie de sécurité, par exemple en rendant le chiffrement CMEK obligatoire, et empêchent également vos utilisateurs d'accéder directement aux API Google.
Le schéma suivant illustre les composants de l'environnement interactif et la manière dont les data scientists déploient les ressources.
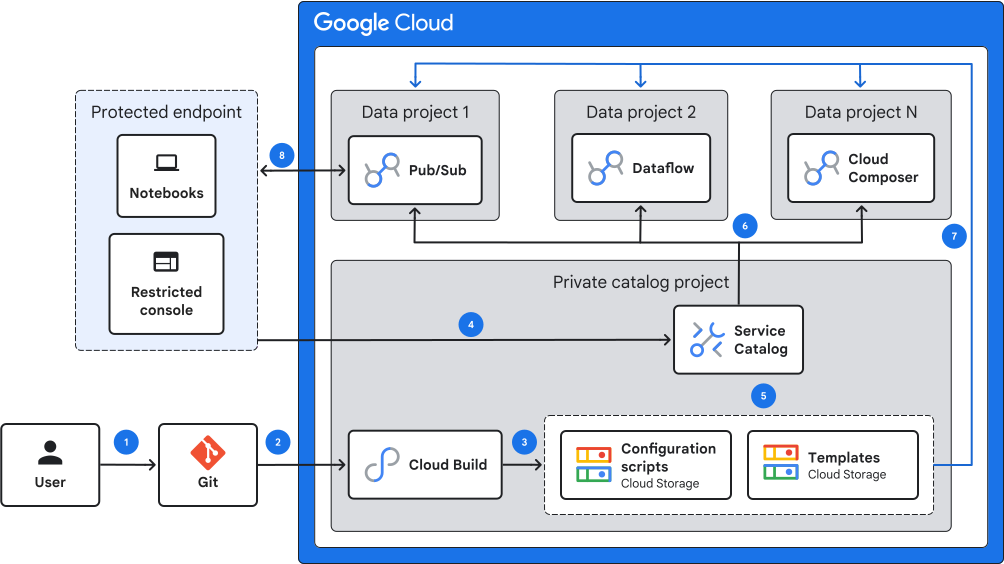
Pour déployer des ressources à l'aide du catalogue de services, procédez comme suit :
- L'ingénieur MLOps place un modèle de ressource Terraform pour Google Clouddans un dépôt Git.
- La commande Git Commit déclenche un pipeline Cloud Build.
- Cloud Build copie le modèle et tous les fichiers de configuration associés dans Cloud Storage.
- L'ingénieur MLOps configure manuellement catalogue de services et catalogue de services. L'ingénieur partage ensuite le catalogue de services avec un projet de service dans l'environnement interactif.
- Le data scientist sélectionne une ressource dans catalogue de services.
- Catalogue de services déploie le modèle dans l'environnement interactif.
- La ressource extrait tous les scripts de configuration nécessaires.
- Le data scientist interagit avec les ressources.
Pipelines d'artefacts
Le processus d'ingestion de données utilise Managed Airflow et Dataflow pour orchestrer le déplacement et la transformation des données dans le domaine de données. Le pipeline d'artefacts crée toutes les ressources nécessaires à l'ingestion des données et les déplace vers l'emplacement approprié pour que les services puissent y accéder. Le pipeline d'artefacts crée les artefacts de conteneur utilisés par l'orchestrateur.
Contrôles de sécurité
L'architecture de maillage de données d'entreprise utilise un modèle de sécurité de défense en profondeur par couches qui inclut les fonctionnalités Google Cloud par défaut, les services Google Cloudet les fonctionnalités de sécurité configurées via le plan de base de l'entreprise. Le diagramme suivant montre la superposition des différentes couches de sécurité pour l'architecture.

Le tableau suivant décrit les contrôles de sécurité associés aux ressources de chaque couche.
| intégrée | Ressource | Contrôle de sécurité |
|---|---|---|
Framework CDMC |
Google Cloud Implémentation du CDMC |
Fournit un framework de gouvernance qui vous aide à sécuriser, gérer et contrôler vos ressources de données. Pour en savoir plus, consultez Framework des principaux contrôles CDMC. |
Déploiement |
Pipeline d'infrastructure |
Fournit une série de pipelines qui déploient l'infrastructure, créent des conteneurs et créent des pipelines de données. L'utilisation de pipelines permet d'assurer l'auditabilité, la traçabilité et la reproductibilité. |
Pipeline d'artefacts |
Déploie divers composants non déployés par le pipeline d'infrastructure. |
|
Modèles Terraform |
Il crée l'infrastructure du système. |
|
Open Policy Agent |
Permet de s'assurer que la plate-forme est conforme aux règles sélectionnées. |
|
Réseau |
Private Service Connect |
Fournit des protections contre l'exfiltration de données autour des ressources de l'architecture au niveau de la couche API et de la couche IP. Vous permet de communiquer avec les API Google Cloud à l'aide d'adresses IP privées afin d'éviter d'exposer le trafic à Internet. |
Réseau VPC avec des adresses IP privées |
Permet de supprimer l'exposition aux menaces sur Internet. |
|
VPC Service Controls |
Aide à protéger les ressources sensibles contre l'exfiltration de données. |
|
Pare-feu |
Protège le réseau VPC contre les accès non autorisés. |
|
Gestion des accès |
Access Context Manager |
Contrôle qui peut accéder à quelles ressources et permet d'éviter toute utilisation non autorisée de vos ressources. |
Fédération d'identité de charge de travail |
Élimine le besoin d'identifiants externes pour transférer des données vers la plate-forme à partir d'environnements sur site. |
|
Knowledge Catalog |
Fournit un index des éléments disponibles pour les utilisateurs. |
|
IAM |
Fournit un accès précis. |
|
Chiffrement |
Cloud KMS |
Vous permet de gérer vos clés de chiffrement et vos secrets, et de protéger vos données grâce au chiffrement au repos et au chiffrement en transit. |
Secrets Manager |
Fournit un magasin de secrets pour les pipelines contrôlés par IAM. |
|
Chiffrement au repos |
Par défaut, Google Cloud chiffre les données au repos. |
|
Chiffrement en transit |
Par défaut, Google Cloud chiffre les données en transit. |
|
Détection |
Security Command Center |
Vous aide à détecter les erreurs de configuration et les activités malveillantes dans votre organisation Google Cloud. |
Architecture continue |
Vérifie en permanence votre organisation Google Cloud par rapport à une série de règles OPA que vous avez définies. |
|
Outil de recommandation IAM |
Analyse les autorisations des utilisateurs et fournit des suggestions sur la réduction des autorisations afin d'appliquer le principe du moindre privilège. |
|
Firewall Insights |
Analyse les règles de pare-feu, identifie les règles de pare-feu trop permissives et suggère des pare-feu plus restrictifs pour vous aider à renforcer votre stratégie de sécurité globale. |
|
Cloud Logging |
Fournit une visibilité sur l'activité du système et permet de détecter les anomalies et les activités malveillantes. |
|
Cloud Monitoring |
Suivre les signaux et événements clés qui peuvent aider à identifier une activité suspecte. |
|
Prévention |
Règles d'administration |
Permet de contrôler et de limiter les actions au sein de votre organisation Google Cloud. |
Workflows
Les sections suivantes décrivent le workflow du producteur de données et le workflow du consommateur de données, en garantissant des contrôles d'accès appropriés en fonction de la sensibilité des données et des rôles des utilisateurs.
Workflow du producteur de données
Le schéma suivant montre comment les données sont protégées lors de leur transfert vers BigQuery.

Le workflow de transfert de données est le suivant :
- Une application intégrée à la fédération d'identité de charge de travail utilise Cloud KMS pour déchiffrer une clé de chiffrement encapsulée.
- L'application utilise la bibliothèque Tink pour anonymiser ou chiffrer les données à l'aide d'un modèle.
- L'application transfère les données vers le projet d'ingestion dans Google Cloud.
- Les données arrivent dans Cloud Storage, BigQuery ou Pub/Sub.
- Dans le projet d'ingestion, les données sont déchiffrées ou désanonymisées à l'aide d'un modèle.
- Les données déchiffrées sont chiffrées ou masquées en fonction d'un autre modèle d'anonymisation, puis placées dans le projet non confidentiel. Les aspects et les tags avec stratégie sont appliqués par Tag Engine, le cas échéant.
- Les données du projet non confidentiel sont transférées vers le projet confidentiel et désanonymisées.
L'accès aux données suivantes est autorisé :
- Les utilisateurs ayant accès au projet confidentiel peuvent accéder à toutes les données brutes en texte brut.
- Les utilisateurs ayant accès au projet non confidentiel peuvent accéder aux données masquées, tokenisées ou chiffrées en fonction des tags avec stratégie associés aux données et de leurs autorisations.
Workflow d'utilisateur de données
Les étapes suivantes décrivent comment un consommateur peut accéder aux données stockées dans BigQuery.
- Le consommateur de données recherche des éléments de données à l'aide de Knowledge Catalog.
- Une fois que le consommateur a trouvé les éléments qu'il recherche, il demande l'accès aux éléments de données.
- Le propriétaire des données décide d'accorder ou non l'accès aux éléments.
- Si le consommateur obtient l'accès, il peut utiliser un notebook et le catalogue de solutions pour créer un environnement dans lequel il peut analyser et transformer les éléments de données.
Conclusion
Le dépôt GitHub fournit des instructions détaillées sur le déploiement du maillage de données surGoogle Cloud après avoir déployé la base d'entreprise. Le processus de déploiement de l'architecture implique de modifier vos dépôts d'infrastructure existants et de déployer de nouveaux composants spécifiques au maillage de données.
Effectuer les actions suivantes :
- Remplissez toutes les conditions préalables, y compris les suivantes :
- Installez Google Cloud CLI, Terraform, Tink, Java et Go.
- Déployez le plan de base de l'entreprise (v4.1).
- Gérez les dépôts locaux suivants :
gcp-data-mesh-foundationsgcp-bootstrapgcp-environmentsgcp-networksgcp-orggcp-projects
- Modifiez le plan de base existant, puis déployez les applications de maillage de données. Pour chaque élément, procédez comme suit :
- Dans votre dépôt cible, consultez la branche
Plan. - Pour ajouter des composants de maillage de données, copiez les fichiers et répertoires pertinents de
gcp-data-mesh-foundationsdans le répertoire de base approprié. Écrasez les fichiers si nécessaire. - Mettez à jour les variables, les rôles et les paramètres du maillage de données dans les fichiers Terraform (par exemple,
*.tfvarset*.tf). Définissez les jetons GitHub en tant que variables d'environnement. - Effectuez les opérations d'initialisation, de planification et d'application Terraform sur chaque dépôt.
- Validez vos modifications, transférez le code vers votre dépôt distant, créez des demandes d'extraction et fusionnez-les dans vos environnements de développement, hors production et de production.
- Dans votre dépôt cible, consultez la branche
Étapes suivantes
- Découvrez l'architecture et les fonctions d'un maillage de données.
- Importer des données depuis Google Cloud dans un entrepôt de données BigQuery sécurisé.
- Mettre en œuvre le framework des principaux contrôles CDMC dans un entrepôt de données BigQuery
- Découvrez le plan de base de l'entreprise.