


Eine Plattform für Datenverwaltung und Analysen auf Unternehmensebene bietet eine Enklave, in der Sie vertrauliche Informationen speichern, analysieren und bearbeiten können, während die Sicherheitskontrollen beibehalten werden. Mit der Data-Mesh-Architektur für Unternehmen können Sie eine Plattform für Datenverwaltung und -analyse in Google Cloud bereitstellen. Die Architektur ist für eine Hybridumgebung konzipiert, in der Google Cloud -Komponenten mit Ihren vorhandenen lokalen Komponenten und Betriebsprozessen interagieren.
Die Architektur des Enterprise Data Mesh umfasst Folgendes:
- Ein GitHub-Repository, das eine Reihe von Terraform-Konfigurationen, Skripts und Code zum Erstellen der folgenden Elemente enthält:
- Ein Governance-Projekt, mit dem Sie die Implementierung des CDMC Key Controls Framework (Cloud Data Management Capabilities) von Google verwenden können.
- Ein Beispiel für eine Datenplattform, die interaktive und Produktionsworkflows unterstützt.
- Eine Erstellerumgebung innerhalb der Datenplattform, die mehrere Datendomains unterstützt. Datenbereiche sind logische Gruppierungen von Datenelementen.
- Eine Nutzerumgebung innerhalb der Datenplattform, die mehrere Nutzerprojekte unterstützt.
- Ein Datenübertragungsdienst, der die Identitätsföderation von Arbeitslasten und die Tink-Verschlüsselungsbibliothek verwendet, um Daten sicher in Google Cloud zu übertragen.
- Ein Beispiel für eine Datendomäne, die Aufnahme-, nicht vertrauliche und vertrauliche Projekte enthält.
- Ein Beispiel für ein Datenzugriffssystem, mit dem Datennutzer Zugriff auf Datasets anfordern und Dateninhaber Zugriff auf diese Datasets gewähren können. Das Beispiel enthält auch einen Workflow-Manager, der die IAM-Berechtigungen dieser Datasets entsprechend ändert.
- Einer Anleitung zu den Architektur-, Design-, Sicherheitskontrollen und Betriebsprozessen, die Sie mit dieser Architektur implementieren (dieses Dokument).
Die Architektur des Enterprise Data Mesh ist mit dem Blueprint für Unternehmensgrundlagen kompatibel. Der Blueprint zu den Unternehmensgrundlagen bietet eine Reihe von Diensten auf Basisebene, auf die diese Architektur basiert, z. B. VPC-Netzwerke und Logging. Sie können diese Architektur bereitstellen, ohne den Blueprint für Unternehmensgrundlagen bereitzustellen, wenn IhreGoogle Cloud -Umgebung die erforderlichen Funktionen bietet.
Dieses Dokument richtet sich an Cloud-Architekten, Data Scientists, Data Engineers und Sicherheitsarchitekten, die mit der Architektur umfassende Datendienste in Google Clouderstellen und bereitstellen können. In diesem Dokument wird davon ausgegangen,dass Sie mit den Konzepten von Data Meshes, Google Cloud-Datendiensten und der Implementierung des CDMC-Frameworks von Google Cloud vertraut sind.
Architektur
Die Enterprise-Data-Mesh-Architektur verfolgt einen mehrschichtigen Ansatz, um die Funktionen für Datenaufnahme, Datenverarbeitung und Governance bereitzustellen. Die Architektur soll über einen CI/CD-Workflow bereitgestellt und gesteuert werden. Das folgende Diagramm zeigt, wie die von dieser Architektur bereitgestellte Datenschicht mit anderen Schichten in Ihrer Umgebung zusammenhängt.
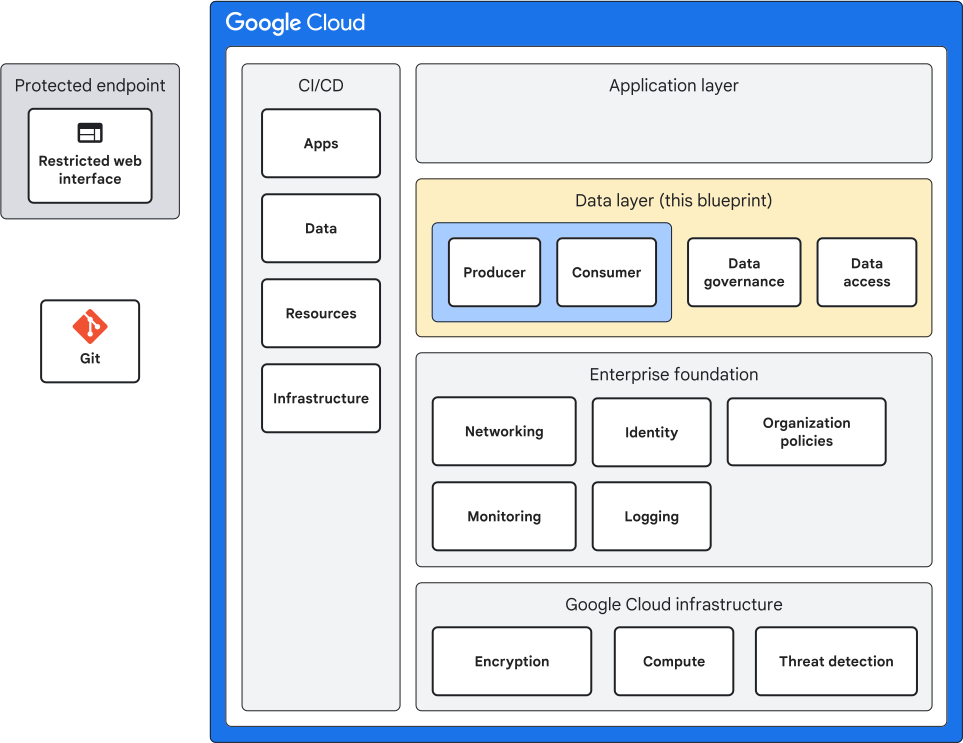
Dieses Diagramm enthält Folgendes:
- Die Google Cloud -Infrastruktur bietet Sicherheitsfunktionen wie Verschlüsselung ruhender Daten und Verschlüsselung während der Übertragung sowie Grundbausteine wie Computing und Speicher.
- Die Unternehmensgrundlage bietet eine Baseline von Ressourcen wie Identitäts-, Netzwerk-, Logging-, Monitoring- und Bereitstellungssystemen, mit denen Sie Google Cloud für Ihre Datenarbeitslasten übernehmen können.
- Die Datenschicht bietet verschiedene Funktionen wie Datenaufnahme, Datenspeicherung, Datenzugriffssteuerung, Data Governance, Datenmonitoring und Datenweitergabe.
- Die Anwendungsebene stellt verschiedene Anwendungen dar, die die Assets der Datenebene verwenden.
- CI/CD bietet die Tools zum Automatisieren der Bereitstellung, Konfiguration, Verwaltung und Bereitstellung von Infrastruktur, Workflows und Softwarekomponenten. Mit diesen Komponenten sorgen Sie für konsistente, zuverlässige und überprüfbare Bereitstellungen und können manuelle Fehler minimieren und den gesamten Entwicklungszyklus beschleunigen.
Zur Veranschaulichung der Verwendung der Datenumgebung enthält die Architektur einen Beispieldatenworkflow. Der Beispiel-Datenworkflow führt Sie durch die folgenden Prozesse: Data Governance, Datenaufnahme, Datenverarbeitung, Datenweitergabe und Datennutzung.
Wichtige Architekturentscheidungen
In der folgenden Tabelle sind die allgemeinen Entscheidungen der Architektur zusammengefasst.
| Entscheidungsbereich | Entscheidung |
|---|---|
| Google Cloud -Architektur | |
Ressourcenhierarchie |
Die Architektur verwendet die Ressourcenhierarchie aus dem Blueprint für Unternehmensgrundlagen. |
Netzwerk |
Die Architektur enthält einen Beispieldienst für die Datenübertragung, der die Identitätsföderation von Arbeitslasten und eine Tink-Bibliothek verwendet. |
Rollen und IAM-Berechtigungen |
Die Architektur umfasst segmentierte Rollen für Datenersteller, Datennutzer, Data Governance und Datenplattformen. |
| Gängige Datendienste | |
Metadaten |
Die Architektur verwendet Knowledge Catalog, um Datenmetadaten zu verwalten. |
Zentrale Richtlinienverwaltung |
Zur Verwaltung von Richtlinien verwendet die Architektur die Implementierung des CDMC-Frameworks von Google Cloud. |
Datenzugriffsverwaltung |
Zur Kontrolle des Zugriffs auf Daten umfasst die Architektur einen unabhängigen Prozess, bei dem Datennutzer den Zugriff auf Daten-Assets beim Dateninhaber anfordern müssen. |
Datenqualität |
In der Architektur wird die Cloud Data Quality Engine verwendet, um Datenqualitätsregeln für bestimmte Tabellenspalten zu definieren und auszuführen. Die Datenqualität wird anhand von Messwerten wie Korrektheit und Vollständigkeit gemessen. |
Datensicherheit |
Die Architektur verwendet Tagging, Verschlüsselung, Maskierung, Tokenisierung und IAM-Steuerelemente, um Datensicherheit zu gewährleisten. |
| Datendomain | |
Datenumgebungen |
Die Architektur umfasst drei Umgebungen. Zwei Umgebungen (Nicht-Produktion und Produktion) sind Betriebsumgebungen, die von Pipelines gesteuert werden. Eine Umgebung (Entwicklung) ist eine interaktive Umgebung. |
Dateninhaber*innen |
Daten-Inhaber nehmen Daten-Assets auf, verarbeiten sie, stellen sie bereit und gewähren Zugriff darauf. |
Datenkonsumenten |
Datennutzer fordern Zugriff auf Daten-Assets an. |
| Onboarding und Vorgänge | |
Pipelines |
In der Architektur werden die folgenden Pipelines zum Bereitstellen von Ressourcen verwendet:
|
Repositories |
Jede Pipeline verwendet ein separates Repository, um die Verantwortlichkeiten zu trennen. |
Prozessablauf |
Der Prozess erfordert, dass Änderungen an der Produktionsumgebung einen Einreicher und einen Genehmiger umfassen. |
| Cloud Operations | |
Scorecards für Datenprodukte |
Die Report Engine generiert Datenprodukt-Scorecards. |
Cloud Logging |
Die Architektur verwendet die Logging-Infrastruktur aus dem Blueprint für Unternehmensgrundlagen. |
Cloud Monitoring |
Die Architektur verwendet die Monitoring-Infrastruktur aus dem Blueprint für Unternehmensgrundlagen. |
Identität: Rollen Gruppen zuordnen
Das Data Mesh nutzt die vorhandene Architektur für Identitätslebenszyklusverwaltung, Autorisierung und Authentifizierung des Blueprints für Unternehmensgrundlagen. Nutzern werden Rollen nicht direkt zugewiesen. Stattdessen sind Gruppen die primäre Methode zum Zuweisen von Rollen und Berechtigungen in IAM. IAM-Rollen und -Berechtigungen werden während der Projekterstellung über die Foundation-Pipeline zugewiesen.
Das Data Mesh verknüpft Gruppen mit einem von vier Schlüsselbereichen: Infrastruktur, Data Governance, domainbasierte Datenproduzenten und domainbasierte Nutzer.
Die Berechtigungsbereiche für diese Gruppen sind:
- Der Berechtigungsumfang der Infrastrukturgruppe ist das gesamte Data Mesh.
- Der Berechtigungsbereich der Data-Governance-Gruppe ist das Data-Governance-Projekt.
- Die Berechtigungen von domainbasierten Erstellern und Nutzern sind auf ihre Datendomain beschränkt.
In den folgenden Tabellen sind die verschiedenen Rollen, die in dieser Data Mesh-Implementierung verwendet werden, und die zugehörigen Berechtigungen aufgeführt.
Infrastruktur
| Gruppe | Beschreibung | Rollen |
|---|---|---|
|
Gesamtadministratoren des Data Mesh |
|
Data Governance
| Gruppe | Beschreibung | Rollen |
|---|---|---|
|
Administratoren des Data-Governance-Projekts |
|
|
Entwickler, die die Data-Governance-Komponenten erstellen und verwalten |
Mehrere Rollen im Data Governance-Projekt, darunter |
|
Leser von Data-Governance-Informationen |
|
|
Sicherheitsadministratoren des Governance-Projekts |
|
|
Gruppe mit Berechtigung zur Verwendung von Aspekttypen |
|
|
Gruppe mit Berechtigung zum Verwenden von Aspekttypen und Hinzufügen von Aspekten |
|
|
Dienstkontogruppe für Security Command Center-Benachrichtigungen |
Keine. Dies ist eine Gruppe für die Mitgliedschaft. Mit diesem Namen wird ein Dienstkonto erstellt, das die erforderlichen Berechtigungen hat. |
Domainbasierte Datenersteller
| Gruppe | Beschreibung | Rollen |
|---|---|---|
|
Administratoren einer bestimmten Datendomain |
|
|
Entwickler, die Datenprodukte innerhalb einer Datendomäne erstellen und verwalten |
Mehrere Rollen im Datendomänenprojekt, einschließlich |
|
Leser der Datendomain-Informationen |
|
|
Bearbeiter von Knowledge Catalog-Einträgen |
Rollen zum Bearbeiten von Knowledge Catalog-Einträgen |
|
Data Stewards für die Datendomain |
Rollen zum Verwalten von Metadaten und Data Governance-Aspekten |
Domainbasierte Datennutzer
| Gruppe | Beschreibung | Rollen |
|---|---|---|
|
Administratoren eines bestimmten Nutzerprojekts |
|
|
Entwickler, die in einem Nutzerprojekt arbeiten |
Mehrere Rollen im Nutzerprojekt, einschließlich |
|
Leser der Informationen zum Nutzerprojekt |
|
Organisationsstruktur
Um zwischen Produktionsvorgängen und Produktionsdaten zu unterscheiden, werden in der Architektur verschiedene Umgebungen zum Entwickeln und Veröffentlichen von Workflows verwendet. Produktionsvorgänge umfassen die Governance, Rückverfolgbarkeit und Wiederholbarkeit eines Workflows sowie die Prüfbarkeit der Ergebnisse des Workflows. Produktionsdaten sind potenziell sensible Daten, die Sie für den Betrieb Ihrer Organisation benötigen. Alle Umgebungen sind mit Sicherheitskontrollen ausgestattet, mit denen Sie Ihre Daten aufnehmen und verarbeiten können.
Um Data Scientists und Engineers zu unterstützen, umfasst die Architektur eine interaktive Umgebung, in der Entwickler direkt mit der Umgebung arbeiten und Dienste über einen ausgewählten Katalog von Lösungen hinzufügen können. Betriebsumgebungen werden über Pipelines gesteuert, die eine codierte Architektur und Konfiguration haben.
Diese Architektur verwendet die Organisationsstruktur des Blueprints für Unternehmensgrundlagen als Basis für die Bereitstellung von Datenarbeitslasten. Das folgende Diagramm zeigt die Ordner und Projekte auf oberster Ebene, die in der Enterprise Data Mesh-Architektur verwendet werden.
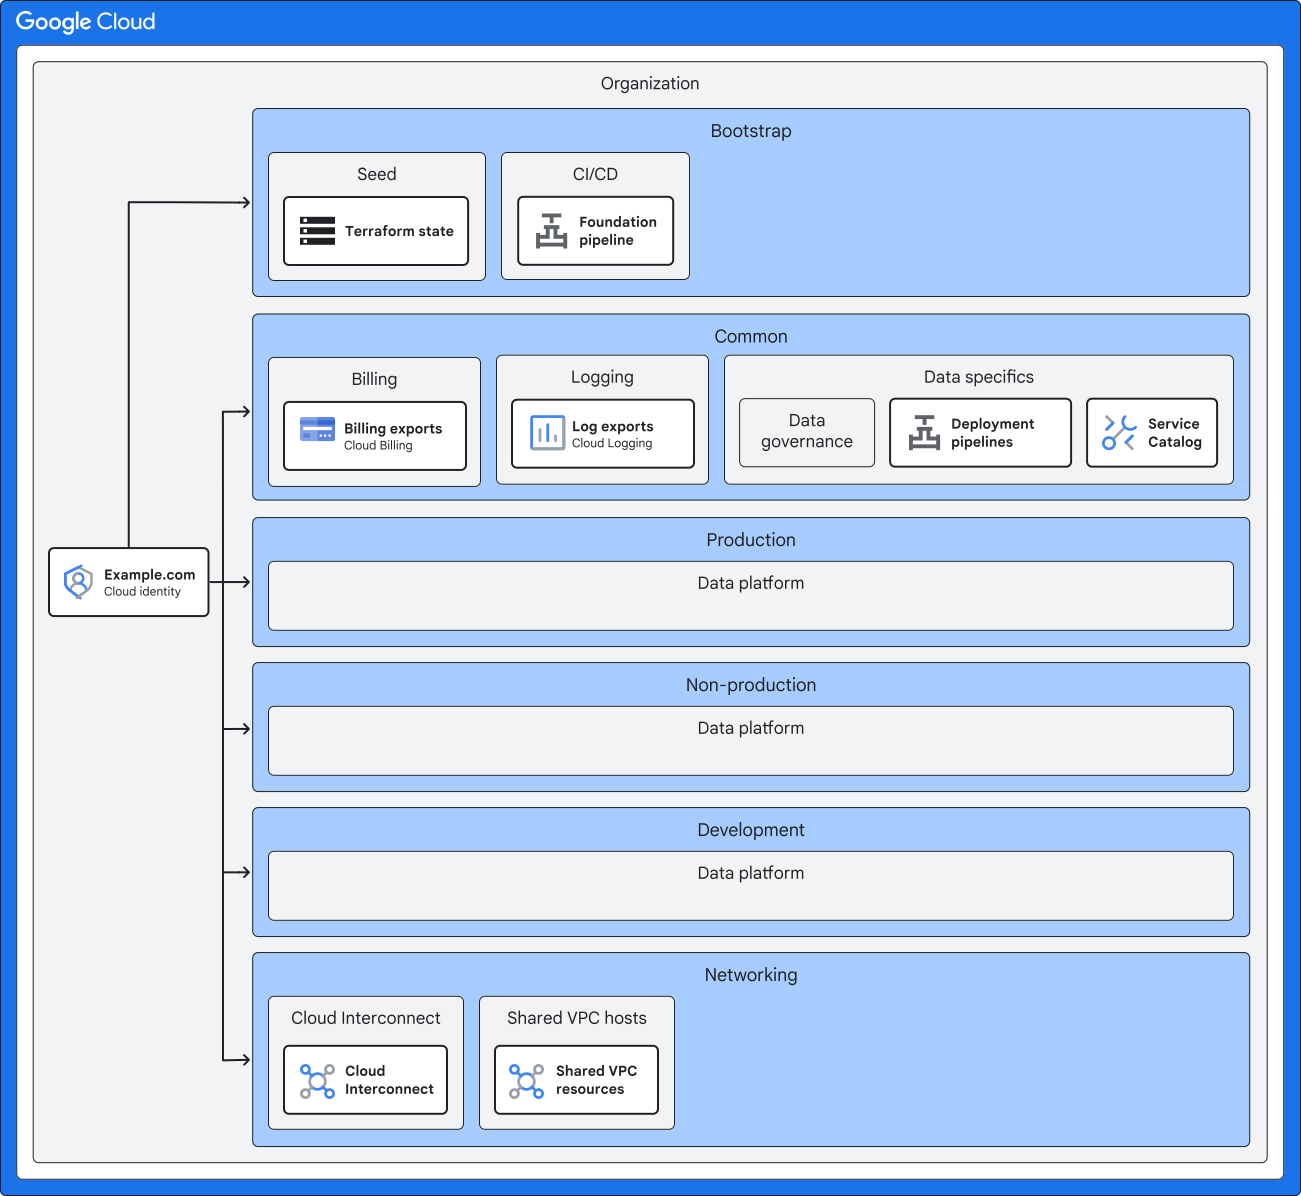
In der folgenden Tabelle werden die übergeordneten Ordner und Projekte beschrieben, die Teil der Architektur sind.
| Ordner | Komponente | Beschreibung |
|---|---|---|
|
|
Enthält die Bereitstellungspipeline, mit der die Codeartefakte der Architektur erstellt werden. |
|
Enthält die Infrastruktur, die von Service Catalog zum Bereitstellen von Ressourcen in der interaktiven Umgebung verwendet wird. |
|
|
Enthält alle Ressourcen, die von der Implementierung des CDMC-Frameworks von Google Cloudverwendet werden. |
|
|
|
Enthält die Projekte und Ressourcen der Datenplattform für die Entwicklung von Anwendungsfällen im interaktiven Modus. |
|
|
Enthält die Projekte und Ressourcen der Datenplattform zum Testen von Anwendungsfällen, die Sie in einer Betriebsumgebung bereitstellen möchten. |
|
|
Enthält die Projekte und Ressourcen der Datenplattform für die Bereitstellung in der Produktion. |
Ordner für Datenplattform
Der Datenplattformordner enthält alle Komponenten der Datenebene und einige der CDMC-Ressourcen. Darüber hinaus enthalten der Datenplattformordner und das Data-Governance-Projekt die CDMC-Ressourcen. Das folgende Diagramm zeigt die Ordner und Projekte, die im Ordner der Datenplattform bereitgestellt werden.
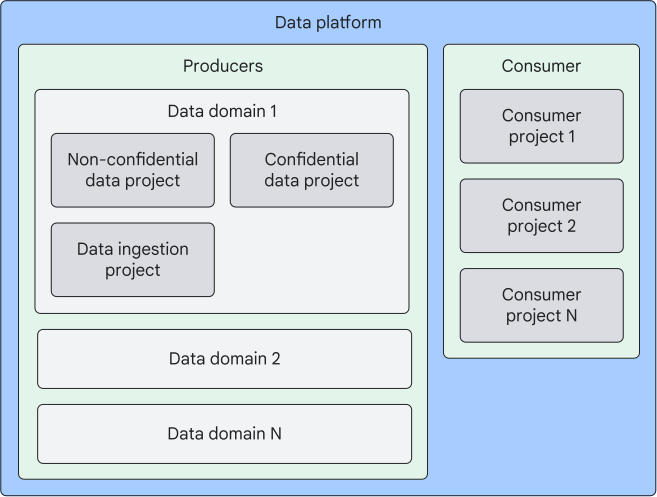
Jeder Datenplattformordner enthält einen Umgebungsordner (Produktion, Nicht-Produktion und Entwicklung). In der folgenden Tabelle werden die Ordner in den einzelnen Datenplattformordnern beschrieben.
| Ordner | Beschreibung |
|---|---|
Produzenten |
Enthält die Datendomains. |
Nutzer |
Enthält die Nutzerprojekte. |
Datendomain |
Enthält die Projekte, die einer bestimmten Domain zugeordnet sind. |
Ordner „Producers“
Jeder Erstellerordner enthält eine oder mehrere Datendomains. Eine Datendomain ist eine logische Gruppierung von Datenelementen, die eine gemeinsame Bedeutung, einen gemeinsamen Zweck oder einen gemeinsamen Geschäftskontext haben. Mit Datendomains können Sie Daten-Assets innerhalb einer Organisation kategorisieren und organisieren. Das folgende Diagramm zeigt die Struktur einer Datendomäne. Die Architektur stellt Projekte im Datenplattformordner für jede Umgebung bereit.
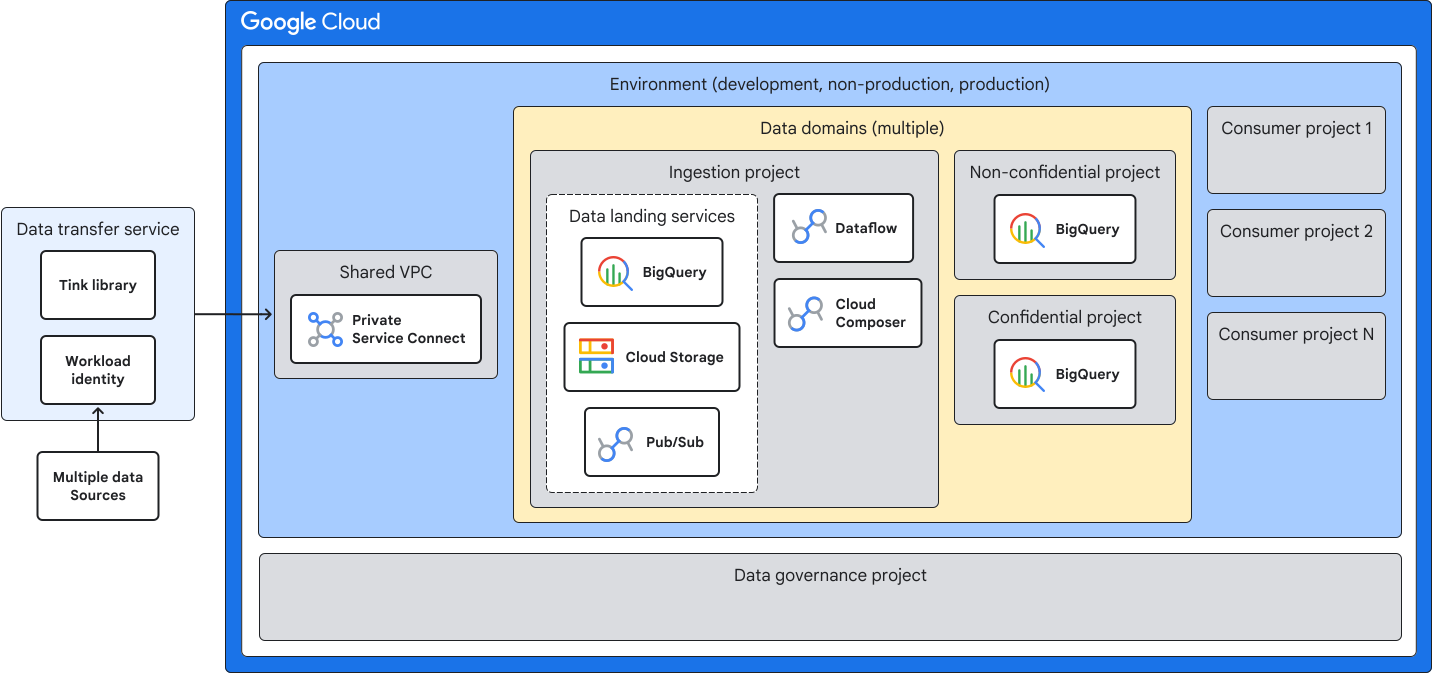
In der folgenden Tabelle werden die Projekte beschrieben, die im Datenplattformordner für jede Umgebung bereitgestellt werden.
| Projekt | Beschreibung |
|---|---|
Aufnahme |
Das Aufnahmeprojekt nimmt Daten in die Datendomäne auf. Die Architektur enthält Beispiele dafür, wie Sie Daten in BigQuery, Cloud Storage und Pub/Sub streamen können. Das Aufnahmeprojekt enthält auch Beispiele für Dataflow und Managed Service for Apache Airflow, mit denen Sie die Transformation und Verschiebung aufgenommener Daten orchestrieren können. |
Nicht vertraulich |
Das nicht vertrauliche Projekt enthält Daten, die de-identifiziert wurden. Sie können Daten maskieren, containerisieren, verschlüsseln, tokenisieren oder verschleiern. Verwenden Sie Richtlinien-Tags, um zu steuern, wie die Daten dargestellt werden. |
Vertraulich |
Das vertrauliche Projekt enthält Klartextdaten. Sie können den Zugriff über IAM-Berechtigungen steuern. |
Ordner „Consumer“
Der Nutzerordner enthält Nutzerprojekte. Nutzerprojekte bieten einen Mechanismus, um Datennutzer anhand ihrer erforderlichen Vertrauensgrenze zu segmentieren. Jedes Projekt wird einer separaten Nutzergruppe zugewiesen und der Gruppe wird projektbezogen Zugriff auf die erforderlichen Daten-Assets gewährt. Sie können das Nutzerprojekt verwenden, um die Daten für die Gruppe zu erfassen, zu analysieren und zu ergänzen.
Allgemeiner Ordner
Der Ordner „common“ enthält die Dienste, die von verschiedenen Umgebungen und Projekten verwendet werden. In diesem Abschnitt werden die Funktionen beschrieben, die dem gemeinsamen Ordner hinzugefügt werden, um das Enterprise Data Mesh zu aktivieren.
CDMC-Architektur
Die Architektur verwendet die CDMC-Architektur für die Data Governance. Die Data-Governance-Funktionen befinden sich im Data-Governance-Projekt im Common-Ordner. Das folgende Diagramm zeigt die Komponenten der CDMC-Architektur. Die Zahlen im Diagramm stellen die Schlüsselkontrollen dar, die mit Diensten von Google Cloudbehandelt werden.

In der folgenden Tabelle werden die Komponenten der CDMC-Architektur beschrieben, die von der Enterprise Data Mesh-Architektur verwendet werden.
| CDMC-Komponente | Google Cloud -Dienst | Beschreibung |
|---|---|---|
| Zugriffs- und Lebenszykluskomponenten | ||
Schlüsselverwaltung |
Cloud KMS |
Ein Dienst, der Verschlüsselungsschlüssel zum Schutz sensibler Daten sicher verwaltet. |
Record Manager |
Cloud Run |
Eine Anwendung, die umfassende Logs und Aufzeichnungen von Datenverarbeitungsaktivitäten führt, damit Organisationen die Datennutzung verfolgen und prüfen können. |
Archivierungsrichtlinie |
BigQuery |
Eine BigQuery-Tabelle, die die Speicherrichtlinie für Daten enthält. |
Berechtigungen |
BigQuery |
Eine BigQuery-Tabelle, in der Informationen darüber gespeichert werden, wer auf sensible Daten zugreifen kann. Diese Tabelle sorgt dafür, dass nur autorisierte Nutzer basierend auf ihren Rollen und Berechtigungen auf bestimmte Daten zugreifen können. |
| Scankomponenten | ||
Datenverlust |
Sensitive Data Protection |
Dienst, der zum Prüfen von Assets auf sensible Daten verwendet wird. |
DLP-Ergebnisse |
BigQuery |
Eine BigQuery-Tabelle, in der Datenklassifizierungen innerhalb der Datenplattform katalogisiert werden. |
Richtlinien |
BigQuery |
Eine BigQuery-Tabelle, die konsistente Data-Governance-Verfahren enthält (z. B. Datenzugriffstypen). |
Abrechnungsexport |
BigQuery |
Eine Tabelle, in der Kosteninformationen gespeichert werden, die aus Cloud Billing exportiert werden, um die Analyse von Kostenmesswerten zu ermöglichen, die mit Daten-Assets verknüpft sind. |
Cloud Data Quality Engine |
Cloud Run |
Eine Anwendung, die Datenqualitätsprüfungen für Tabellen und Spalten ausführt. |
Ergebnisse zur Datenqualität |
BigQuery |
Eine BigQuery-Tabelle, in der erkannte Abweichungen zwischen den definierten Datenqualitätsregeln und der tatsächlichen Qualität der Daten-Assets aufgezeichnet werden. |
| Berichtskomponenten | ||
Planer |
Cloud Scheduler |
Ein Dienst, der steuert, wann die Cloud Data Quality Engine ausgeführt wird und wann die Sensitive Data Protection-Prüfung erfolgt. |
Report Engine |
Cloud Run |
Eine Anwendung, die Berichte generiert, mit denen die Einhaltung der Kontrollen des CDMC-Frameworks verfolgt und gemessen werden kann. |
Ergebnisse und Assets |
BigQuery und Pub/Sub |
Ein BigQuery-Bericht über Abweichungen oder Inkonsistenzen bei den Datenverwaltungs-Steuerelementen, z. B. fehlende Aspekte, falsche Klassifizierungen oder nicht konforme Speicherorte. |
Tags exportieren |
BigQuery |
Eine BigQuery-Tabelle, die extrahierte Aspektinformationen aus Knowledge Catalog enthält. |
| Weitere Komponenten | ||
Richtlinienverwaltung |
Organisationsrichtliniendienst |
Ein Dienst, der Einschränkungen für den geografischen Speicherort von Daten definiert und erzwingt. |
Attributbasierte Zugriffsrichtlinien |
Access Context Manager |
Ein Dienst, der detaillierte, attributbasierte Zugriffsrichtlinien definiert und erzwingt, sodass nur autorisierte Nutzer von zulässigen Standorten und Geräten auf vertrauliche Informationen zugreifen können. |
Metadaten |
Knowledge Catalog |
Ein Dienst, der Metadaten zu den Tabellen speichert, die im Data Mesh verwendet werden. |
Tag Engine |
Cloud Run |
Eine Anwendung, die BigQuery-Tabelleneinträgen in Knowledge Catalog Aspekte hinzufügt. |
CDMC-Berichte |
Data Studio |
Dashboards, mit denen Ihre Analysten Berichte aufrufen können, die von den CDMC-Architektur-Engines generiert wurden. |
CDMC-Implementierung
In der folgenden Tabelle wird beschrieben, wie die Architektur die Schlüsselkontrollen im CDMC-Framework implementiert.
| CDMC-Kontrollanforderung | Implementierung |
|---|---|
Die Report Engine erkennt nicht konforme Daten-Assets und veröffentlicht die Ergebnisse in einem Pub/Sub-Thema. Diese Ergebnisse werden auch in BigQuery geladen, um Berichte mit Data Studio zu erstellen. |
|
Dateninhaberschaft wird sowohl für migrierte als auch für in der Cloud generierte Daten eingerichtet |
Knowledge Catalog erfasst automatisch technische Metadaten aus BigQuery. Die Tag Engine wendet Geschäftsmetadatenaspekte wie den Namen des Inhabers und die Vertraulichkeitsstufe aus einer Referenztabelle an. So wird sichergestellt, dass alle vertraulichen Daten mit Inhaberinformationen für die Compliance annotiert werden. Dieser automatisierte Prozess trägt zur Data Governance und Compliance bei, indem sensible Daten identifiziert und mit den entsprechenden Inhaberinformationen gekennzeichnet werden. |
Datenbeschaffung und -nutzung werden durch Automatisierung gesteuert und unterstützt |
Knowledge Catalog klassifiziert Daten-Assets, indem es sie mit einem Aspekt annotiert, der ein |
Datenhoheit und grenzüberschreitende Datenübertragungen werden verwaltet |
Der Organisationsrichtliniendienst definiert zulässige Speicherregionen für Daten-Assets und Access Context Manager beschränkt den Zugriff basierend auf dem Nutzerstandort. Knowledge Catalog speichert die genehmigten Speicherorte als Metadatenaspekte. Die Report Engine vergleicht diese Aspekte mit dem tatsächlichen Standort der Daten-Assets in BigQuery und veröffentlicht alle Abweichungen als Ergebnisse über Pub/Sub. Security Command Center bietet eine zusätzliche Monitoring-Ebene, indem es Sicherheitslückenergebnisse generiert, wenn Daten außerhalb der definierten Richtlinien gespeichert oder abgerufen werden. |
Datenkataloge werden implementiert und verwendet und sind interoperabel |
Knowledge Catalog speichert und aktualisiert die technischen Metadaten für alle BigQuery-Daten-Assets und erstellt so einen kontinuierlich synchronisierten Data Catalog. Knowledge Catalog sorgt dafür, dass neue oder geänderte Tabellen und Ansichten sofort dem Katalog hinzugefügt werden, sodass ein aktueller Bestand an Daten-Assets erhalten bleibt. |
Sensitive Data Protection prüft BigQuery-Daten und identifiziert sensible Informationstypen. Diese Ergebnisse werden dann anhand einer Klassifizierungsreferenztabelle eingestuft und die höchste Vertraulichkeitsstufe wird als Aspekt in Knowledge Catalog auf Spalten- und Tabellenebene zugewiesen. Tag Engine verwaltet diesen Prozess, indem Knowledge Catalog mit Vertraulichkeitsaspekten aktualisiert wird, wenn neue Daten-Assets hinzugefügt oder vorhandene geändert werden. Dieser Prozess sorgt für eine ständig aktualisierte Klassifizierung von Daten nach Sensibilität, die Sie mit Pub/Sub und integrierten Berichtstools überwachen und melden können. |
|
Datenberechtigungen werden verwaltet, erzwungen und nachverfolgt |
Richtlinien-Tags von BigQuery steuern den Zugriff auf sensible Daten auf Spaltenebene. So wird sichergestellt, dass nur autorisierte Nutzer basierend auf dem ihnen zugewiesenen Richtlinien-Tag auf bestimmte Daten zugreifen können. IAM verwaltet den allgemeinen Zugriff auf das Data Warehouse, während Knowledge Catalog die Vertraulichkeitsklassifizierungen speichert. Es werden regelmäßige Prüfungen durchgeführt, um sicherzustellen, dass alle sensiblen Daten entsprechende Richtlinien-Tags haben. Abweichungen werden über Pub/Sub zur Behebung gemeldet. |
Zugriff, Verwendung und Ergebnisse von Daten nach ethischen Maßstäben werden verwaltet |
Vereinbarungen zur Datenweitergabe für Anbieter und Nutzer werden in einem dedizierten BigQuery-Data-Warehouse gespeichert, um die Verwendungszwecke zu kontrollieren. Knowledge Catalog kennzeichnet Daten-Assets mit den Informationen der Anbietervereinbarung, während Nutzervereinbarungen mit IAM-Bindungen für die Zugriffssteuerung verknüpft sind. Mit Abfragelabels werden Nutzungszwecke erzwungen. Nutzer müssen bei der Abfrage vertraulicher Daten einen gültigen Zweck angeben, der mit ihren Berechtigungen in BigQuery abgeglichen wird. Ein Audit-Trail in BigQuery verfolgt alle Datenzugriffe und sorgt für die Einhaltung der Datenfreigabevereinbarungen. |
Die Standardverschlüsselung ruhender Daten von Google trägt zum Schutz von Daten bei, die auf einem Laufwerk gespeichert sind. Cloud KMS unterstützt kundenverwaltete Verschlüsselungsschlüssel (CMEK) für eine verbesserte Schlüsselverwaltung. BigQuery implementiert die dynamische Datenmaskierung auf Spaltenebene für die De-Identifikation und unterstützt die De-Identifikation auf Anwendungsebene während der Datenaufnahme. Knowledge Catalog speichert Metadatenaspekte für Verschlüsselungs- und De-Identifikationstechniken, die auf Daten-Assets angewendet werden. Durch automatisierte Prüfungen wird sichergestellt, dass die Verschlüsselungs- und De-Identifizierungsmethoden den vordefinierten Sicherheitsrichtlinien entsprechen. Abweichungen werden als Ergebnisse über Pub/Sub gemeldet. |
|
Knowledge Catalog versieht sensible Daten-Assets mit Aspekten, die relevante Informationen für die Folgenabschätzung enthalten, z. B. den Standort des Subjekts und Links zu Bewertungsberichten. Tag Engine wendet diese Aspekte basierend auf der Datensensitivität und einer Richtlinientabelle in BigQuery an, die die Bewertungsanforderungen basierend auf dem Daten- und Subjektstandort definiert. Dieser automatisierte Prozess ermöglicht ein kontinuierliches Monitoring und Berichte zur Einhaltung der Anforderungen an die Folgenabschätzung. So wird sichergestellt, dass Datenschutz-Folgenabschätzungen (DSFA) oder Privatsphäre-Folgenabschätzungen (PIA) bei Bedarf durchgeführt werden. |
|
Knowledge Catalog kennzeichnet Daten-Assets mit Aufbewahrungsrichtlinien und gibt Aufbewahrungszeiträume und Ablaufaktionen (z. B. Archivieren oder Löschen) an. Record Manager automatisiert die Durchsetzung dieser Richtlinien, indem BigQuery-Tabellen anhand der definierten Aspekte dauerhaft gelöscht oder archiviert werden. Diese Durchsetzung gewährleistet die Einhaltung der Datenlebenszyklus-Richtlinien und der Anforderungen an die Datenaufbewahrung. Alle Abweichungen werden mit Pub/Sub erkannt und gemeldet. |
|
Die Cloud Data Quality Engine definiert und führt Datenqualitätsregeln für bestimmte Tabellenspalten aus und misst die Datenqualität anhand von Messwerten wie Korrektheit und Vollständigkeit. Die Ergebnisse dieser Prüfungen, einschließlich der Erfolgsprozentsätze und Schwellenwerte, werden als Aspekte in Knowledge Catalog gespeichert. Durch das Speichern dieser Ergebnisse können Sie die Datenqualität kontinuierlich überwachen und Berichte dazu erstellen. Alle Probleme oder Abweichungen von akzeptablen Schwellenwerten werden als Ergebnisse mit Pub/Sub veröffentlicht. |
|
Die Grundsätze der Kostenverwaltung werden festgelegt und angewendet |
Knowledge Catalog speichert kostenbezogene Messwerte für Daten-Assets, z. B. Abfragekosten, Speicherkosten und Kosten für ausgehenden Datentraffic. Diese werden anhand von Abrechnungsinformationen berechnet, die von Cloud Billing nach BigQuery exportiert werden. Durch das Speichern kostenbezogener Messwerte ist eine umfassende Kostenverfolgung und -analyse möglich. So können Sie die Einhaltung von Kostenrichtlinien und eine effiziente Ressourcennutzung sicherstellen. Anomalien werden über Pub/Sub gemeldet. |
Die integrierten Funktionen zur Datenherkunft von Knowledge Catalog verfolgen die Herkunft von Daten-Assets und stellen den Datenfluss visuell dar. Darüber hinaus identifizieren und erfassen Datenaufnahmeskripts die ursprüngliche Quelle der Daten als Aspekt in Knowledge Catalog, wodurch die Rückverfolgbarkeit der Daten bis zu ihrem Ursprung verbessert wird. |
Datenzugriffsverwaltung
Der Zugriff der Architektur auf Daten wird über einen unabhängigen Prozess gesteuert, der die operative Kontrolle (z. B. das Ausführen von Dataflow-Jobs) von der Datenzugriffssteuerung trennt. Der Zugriff eines Nutzers auf einen Google Cloud -Dienst wird durch ein umgebungs- oder betriebsbezogenes Anliegen definiert und von einer Cloud-Engineering-Gruppe bereitgestellt und genehmigt. Der Zugriff eines Nutzers auf Daten-Assets von Google Cloud (z. B. eine BigQuery-Tabelle) ist ein Datenschutz-, Regulierungs- oder Governance-Problem und unterliegt einer Zugriffsvereinbarung zwischen den produzierenden und konsumierenden Parteien und wird durch die folgenden Prozesse gesteuert. Das folgende Diagramm zeigt, wie der Datenzugriff durch die Interaktion verschiedener Softwarekomponenten bereitgestellt wird.
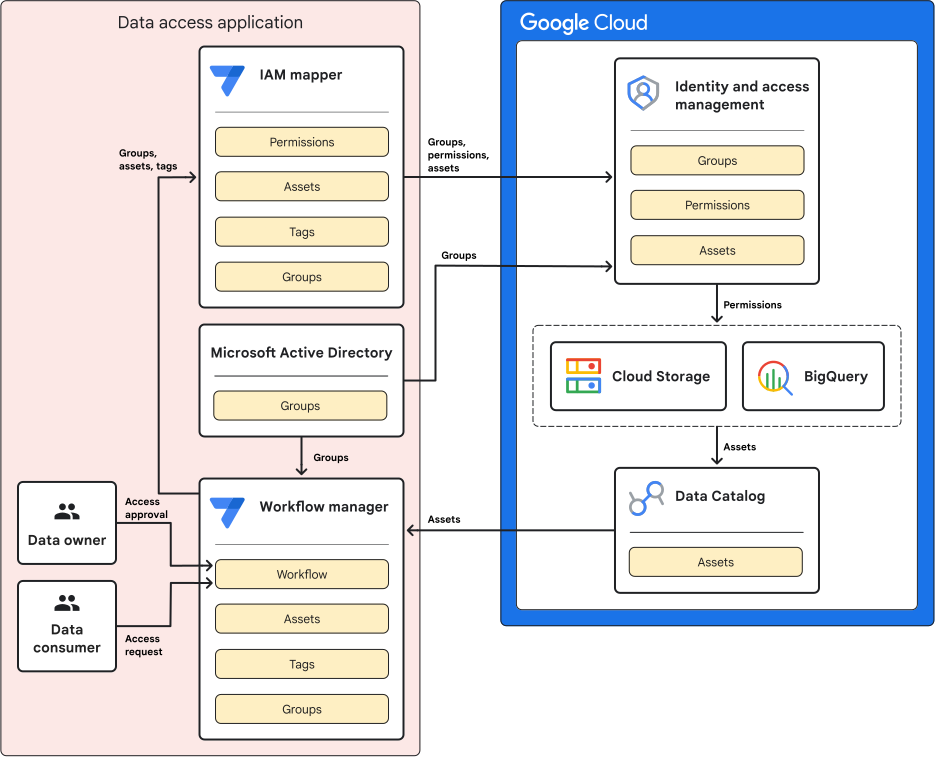
Wie im vorherigen Diagramm dargestellt, wird das Onboarding von Datenzugriffen durch die folgenden Prozesse abgewickelt:
- Cloud-Daten-Assets werden von Knowledge Catalog erfasst und inventarisiert.
- Der Workflow-Manager ruft die Daten-Assets aus dem Knowledge Catalog ab.
- Dateninhaber werden in Workflow Manager aufgenommen.
Die Datenzugriffsverwaltung funktioniert so:
- Ein Datennutzer stellt eine Anfrage für ein bestimmtes Asset.
- Der Dateneigentümer des Assets wird über die Anfrage benachrichtigt.
- Der Dateninhaber genehmigt die Anfrage oder lehnt sie ab.
- Wenn die Anfrage genehmigt wird, übergibt der Workflow-Manager die Gruppe, das Asset und das zugehörige Tag an den IAM-Mapper.
- Der IAM-Mapper übersetzt die Workflow Manager-Tags in IAM-Berechtigungen und gewährt der angegebenen Gruppe IAM-Berechtigungen für das Daten-Asset.
- Wenn ein Nutzer auf das Daten-Asset zugreifen möchte, wertet IAM den Zugriff auf das Asset in Google Cloud anhand der Berechtigungen der Gruppe aus.
- Wenn der Zugriff erlaubt ist, greift der Nutzer auf das Daten-Asset zu.
Netzwerk
Der Datensicherheitsprozess beginnt bei der Quellanwendung, die sich lokal oder in einer anderen Umgebung außerhalb desGoogle Cloud -Zielprojekts befinden kann. Bevor eine Netzwerkübertragung stattfindet, verwendet diese Anwendung die Identitätsföderation von Arbeitslasten, um sich sicher bei Google Cloud APIs zu authentifizieren. Mit diesen Anmeldedaten interagiert es mit Cloud KMS, um die erforderlichen Schlüssel abzurufen oder zu verpacken. Anschließend wird die Tink-Bibliothek verwendet, um die anfängliche Verschlüsselung und De-Identifikation der sensiblen Datennutzlast gemäß vordefinierten Vorlagen durchzuführen.
Nachdem die Datennutzlast geschützt wurde, muss sie sicher in das Aufnahmeprojekt von Google Cloud übertragen werden. Für lokale Anwendungen können Sie Cloud Interconnect oder möglicherweise Cloud VPN verwenden. Verwenden Sie im NetzwerkGoogle Cloud Private Service Connect, um die Daten an den Aufnahmeendpunkt im VPC-Netzwerk des Zielprojekts weiterzuleiten. Mit Private Service Connect kann die Quellanwendung über private IP-Adressen eine Verbindung zu Google APIs herstellen. So wird sichergestellt, dass der Traffic nicht dem Internet ausgesetzt ist.
Der gesamte Netzwerkpfad und die Zielaufnahmedienste (Cloud Storage, BigQuery und Pub/Sub) im Aufnahmeprojekt werden durch einen VPC Service Controls-Perimeter geschützt. Dieser Perimeter erzwingt eine Sicherheitsgrenze, sodass die geschützten Daten aus der Quelle nur in die autorisiertenGoogle Cloud -Dienste innerhalb dieses bestimmten Projekts aufgenommen werden können.
Logging
In dieser Architektur werden die Cloud Logging-Funktionen verwendet, die im Blueprint für Unternehmensgrundlagen bereitgestellt werden.
Pipelines
Die Enterprise Data Mesh-Architektur verwendet eine Reihe von Pipelines, um die Infrastruktur, Orchestrierung, Datasets, Datenpipelines und Anwendungskomponenten bereitzustellen. Die Ressourcenbereitstellungspipelines der Architektur verwenden Terraform als IaC-Tool (Infrastruktur als Code) und Cloud Build als CI/CD-Dienst, um die Terraform-Konfigurationen in der Architekturumgebung bereitzustellen. Das folgende Diagramm zeigt die Beziehung zwischen den Pipelines.
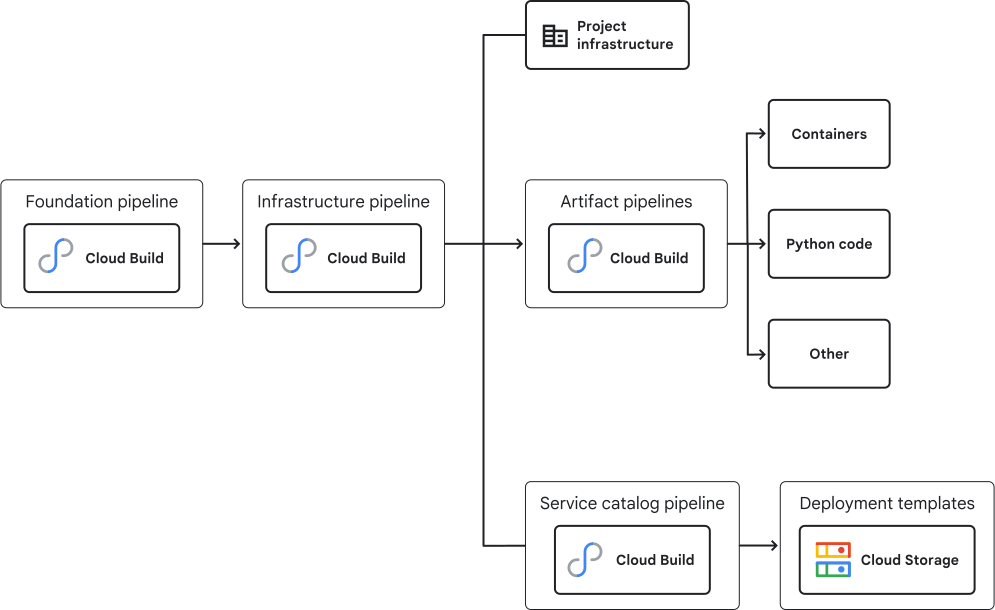
Die Grundlagenpipeline und die Infrastrukturpipeline sind Teil des Blueprints für Unternehmensgrundlagen. In der folgenden Tabelle werden der Zweck der Pipelines und die von ihnen bereitgestellten Ressourcen beschrieben.
| Pipeline | Bereitgestellt von | Ressourcen |
|---|---|---|
Fundament-Pipeline |
Bootstrap |
|
Infrastrukturpipeline |
Fundament-Pipeline |
|
Service Catalog-Pipeline |
Infrastrukturpipeline |
|
Artefaktpipelines |
Infrastrukturpipeline |
Artefaktpipelines erzeugen die verschiedenen Container und anderen Komponenten der Codebasis, die vom Data Mesh verwendet wird. |
Jede Pipeline hat eigene Repositories, aus denen sie Code und Konfigurationsdateien abruft. In jedem Repository gibt es eine Aufgabentrennung, bei der die Einreicher und Genehmiger von Bereitstellungen von operativem Code unterschiedlichen Gruppen angehören.
Interaktive Bereitstellung über Service Catalog
Interaktive Umgebungen sind die Entwicklungsumgebung innerhalb der Architektur und befinden sich im Entwicklungsordner. Die Hauptoberfläche für die interaktive Umgebung ist Service Catalog. Damit können Entwickler vorkonfigurierte Vorlagen verwenden, um Google-Dienste zu instanziieren. Diese vorkonfigurierten Vorlagen werden als Dienstvorlagen bezeichnet. Mit Dienstvorlagen können Sie Ihren Sicherheitsstatus erzwingen, z. B. die CMEK-Verschlüsselung obligatorisch machen, und verhindern, dass Ihre Nutzer direkten Zugriff auf Google APIs haben.
Das folgende Diagramm zeigt die Komponenten der interaktiven Umgebung und wie Data Scientists Ressourcen bereitstellen.
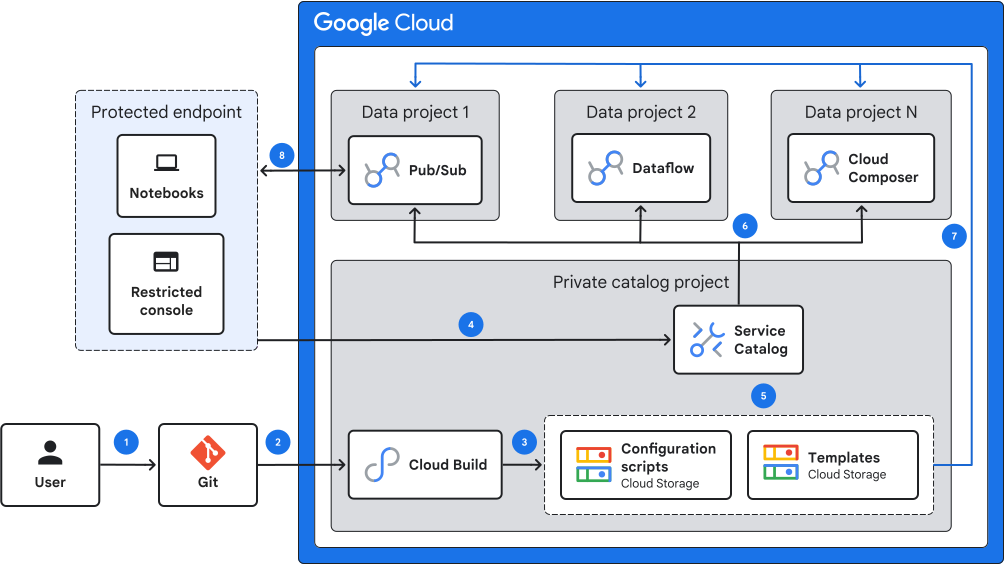
So stellen Sie Ressourcen mit dem Service Catalog bereit:
- Der MLOps-Engineer legt eine Terraform-Ressourcenvorlage für Google Cloudin einem Git-Repository ab.
- Der Git-Commit-Befehl löst eine Cloud Build-Pipeline aus.
- Cloud Build kopiert die Vorlage und alle zugehörigen Konfigurationsdateien in Cloud Storage.
- Der MLOps-Engineer richtet die Service Catalog-Lösungen und den Service Catalog manuell ein. Anschließend gibt der Engineer den Service Catalog für ein Dienstprojekt in der interaktiven Umgebung frei.
- Der Data Scientist wählt eine Ressource aus Service Catalog aus.
- Service Catalog stellt die Vorlage in der interaktiven Umgebung bereit.
- Die Ressource ruft alle erforderlichen Konfigurationsskripts ab.
- Der Data Scientist interagiert mit den Ressourcen.
Artefaktpipelines
Bei der Datenaufnahme werden Managed Airflow und Dataflow verwendet, um die Verschiebung und Transformation von Daten innerhalb der Datendomäne zu orchestrieren. Die Artefaktpipeline erstellt alle erforderlichen Ressourcen für die Datenaufnahme und verschiebt die Ressourcen an den entsprechenden Speicherort, damit die Dienste darauf zugreifen können. Die Artefaktpipeline erstellt die Containerartefakte, die der Orchestrator verwendet.
Sicherheitskontrollen
Die Architektur des Enterprise Data Mesh verwendet ein mehrschichtiges Defense-in-Depth-Sicherheitsmodell, das Standardfunktionen von Google Cloud , Google Cloud-Dienste und Sicherheitsfunktionen umfasst, die über den Blueprint für Unternehmensgrundlagen konfiguriert werden. Das folgende Diagramm zeigt die Schichtung der verschiedenen Sicherheitskontrollen für die Architektur.
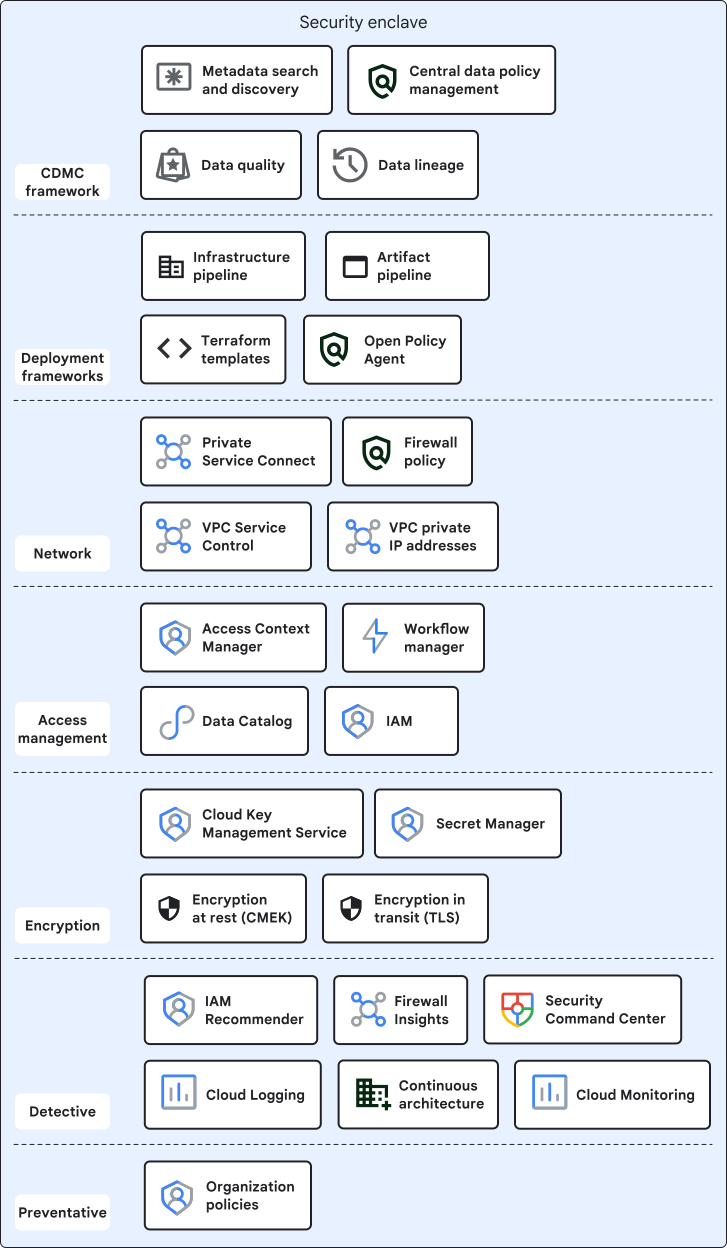
In der folgenden Tabelle werden die Sicherheitskontrollen beschrieben, die den Ressourcen auf den einzelnen Ebenen zugeordnet sind.
| Ebene | Ressource | Sicherheitskontrollen |
|---|---|---|
CDMC-Framework |
Google Cloud CDMC-Implementierung |
Bietet ein Governance-Framework, mit dem Sie Ihre Datenbestände schützen, verwalten und kontrollieren können. Weitere Informationen finden Sie unter CDMC Key Controls Framework. |
Bereitstellung |
Infrastrukturpipeline |
Stellt eine Reihe von Pipelines bereit, die Infrastruktur bereitstellen, Container erstellen und Datenpipelines erstellen. Die Verwendung von Pipelines ermöglicht Prüfbarkeit, Rückverfolgbarkeit und Wiederholbarkeit. |
Artefakt-Pipeline |
Stellt verschiedene Komponenten bereit, die nicht von der Infrastrukturpipeline bereitgestellt werden. |
|
Terraform-Vorlagen |
Baut die Systeminfrastruktur auf. |
|
Open Policy Agent |
Trägt dazu bei, dass die Plattform den ausgewählten Richtlinien entspricht. |
|
Netzwerk |
Private Service Connect |
Bietet Schutz vor Daten-Exfiltration für die Architekturressourcen auf der API- und IP-Ebene. Ermöglicht die Kommunikation mit Google Cloud APIs über private IP-Adressen, sodass Sie keinen Traffic gegenüber dem Internet exponieren. |
VPC-Netzwerk mit privaten IP-Adressen |
Hilft, die Gefährdung durch Bedrohungen aus dem Internet zu beseitigen. |
|
VPC Service Controls |
Schützt sensible Ressourcen vor Daten-Exfiltration. |
|
Firewall |
Schützt das VPC-Netzwerk vor unbefugtem Zugriff. |
|
Zugriffsverwaltung |
Access Context Manager |
Steuert, wer auf welche Ressourcen zugreifen kann, und verhindert den nicht autorisierten Zugriff auf Ihre Ressourcen. |
Workload Identity-Föderation |
Externe Anmeldedaten sind nicht mehr erforderlich, um Daten aus lokalen Umgebungen auf die Plattform zu übertragen. |
|
Knowledge Catalog |
Stellt einen Index der für Nutzer verfügbaren Assets bereit. |
|
IAM |
Ermöglicht detaillierten Zugriff. |
|
Verschlüsselung |
Cloud KMS |
Ermöglicht Ihnen, Ihre Verschlüsselungsschlüssel und Secrets zu verwalten und Ihre Daten durch Verschlüsselung ruhender Daten und Verschlüsselung bei der Übertragung zu schützen. |
Secret Manager |
Stellt einen Secret-Speicher für Pipelines bereit, die von IAM gesteuert werden. |
|
Verschlüsselung ruhender Daten |
Standardmäßig verschlüsselt Google Cloud inaktive Daten. |
|
Verschlüsselung während der Übertragung |
Standardmäßig verschlüsselt Google Cloud Daten bei der Übertragung. |
|
Erkennung |
Security Command Center |
Hilft Ihnen, Fehlkonfigurationen und schädliche Aktivitäten in Ihrer Google Cloud-Organisation zu erkennen. |
Kontinuierliche Architektur |
Prüft Ihre Google Cloud -Organisation kontinuierlich anhand einer Reihe von OPA-Richtlinien, die Sie definiert haben. |
|
IAM Recommender |
Analysiert Nutzerberechtigungen und bietet Vorschläge zur Reduzierung von Berechtigungen, um das Prinzip der geringsten Berechtigung durchzusetzen. |
|
Firewall Insights |
Analysiert Firewallregeln, identifiziert zu moderate Firewallregeln und schlägt restriktivere Firewalls vor, um Ihren allgemeinen Sicherheitsstatus zu verbessern. |
|
Cloud Logging |
Bietet Einblick in die Systemaktivität und hilft bei der Erkennung von Anomalien und schädlichen Aktivitäten. |
|
Cloud Monitoring |
Verfolgt wichtige Signale und Ereignisse, die helfen können, verdächtige Aktivitäten zu erkennen. |
|
Prävention |
Organisationsrichtlinie |
Damit können Sie Aktionen innerhalb Ihrer Organisation steuern und einschränken. Google Cloud |
Workflows
In den folgenden Abschnitten werden die Workflows für Datenersteller und Datennutzer beschrieben. Dabei werden die entsprechenden Zugriffssteuerungen basierend auf der Datensensibilität und den Nutzerrollen berücksichtigt.
Workflow für Datenproduzenten
Das folgende Diagramm zeigt, wie Daten bei der Übertragung an BigQuery geschützt werden.
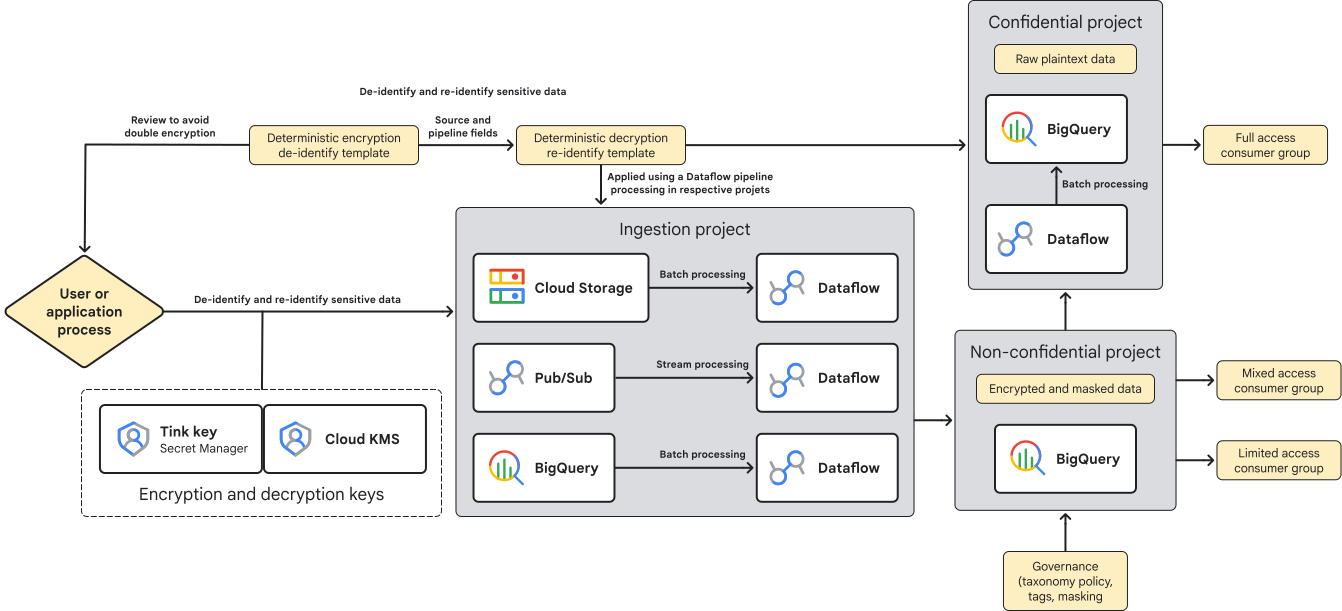
Der Workflow für die Datenübertragung sieht so aus:
- Eine Anwendung, die in die Workload Identity-Föderation eingebunden ist, verwendet Cloud KMS, um einen verpackten Verschlüsselungsschlüssel zu entschlüsseln.
- Die Anwendung verwendet die Tink-Bibliothek, um die Daten mithilfe einer Vorlage zu de-identifizieren oder zu verschlüsseln.
- Die Anwendung überträgt Daten an das Aufnahmeprojekt in Google Cloud.
- Die Daten werden in Cloud Storage, BigQuery oder Pub/Sub bereitgestellt.
- Im Aufnahmeprojekt werden die Daten mithilfe einer Vorlage entschlüsselt oder re-identifiziert.
- Die entschlüsselten Daten werden anhand einer anderen De-Identifikationsvorlage verschlüsselt oder maskiert und dann im nicht vertraulichen Projekt platziert. Aspekte und Richtlinien-Tags werden von Tag Engine nach Bedarf angewendet.
- Daten aus dem nicht vertraulichen Projekt werden in das vertrauliche Projekt übertragen und re-identifiziert.
Der folgende Datenzugriff ist zulässig:
- Nutzer, die Zugriff auf das Confidential-Projekt haben, können auf alle Rohdaten im Klartext zugreifen.
- Nutzer, die Zugriff auf das nicht vertrauliche Projekt haben, können auf maskierte, tokenisierte oder verschlüsselte Daten zugreifen, je nachdem, welche Richtlinien-Tags mit den Daten und ihren Berechtigungen verknüpft sind.
Workflow des Datennutzers
In den folgenden Schritten wird beschrieben, wie ein Nutzer auf Daten zugreifen kann, die in BigQuery gespeichert sind.
- Der Datennutzer sucht mit Knowledge Catalog nach Daten-Assets.
- Nachdem der Nutzer die gewünschten Assets gefunden hat, fordert er Zugriff auf die Datenassets an.
- Der Dateninhaber entscheidet, ob er Zugriff auf die Assets gewährt.
- Wenn der Nutzer Zugriff erhält, kann er ein Notebook und den Lösungskatalog verwenden, um eine Umgebung zu erstellen, in der er die Datenassets analysieren und transformieren kann.
Zusammenfassung
Im GitHub-Repository finden Sie eine detaillierte Anleitung zum Bereitstellen des Data Mesh inGoogle Cloud , nachdem Sie die Enterprise Foundation bereitgestellt haben. Zum Bereitstellen der Architektur müssen Sie Ihre vorhandenen Infrastruktur-Repositories ändern und neue Data Mesh-spezifische Komponenten bereitstellen.
Führen Sie Folgendes aus:
- Erfüllen Sie alle Voraussetzungen, einschließlich der folgenden:
- Installieren Sie die Google Cloud CLI, Terraform, Tink, Java und Go.
- Stellen Sie den Blueprint für Unternehmensgrundlagen (v4.1) bereit.
- Verwalten Sie die folgenden lokalen Repositories:
gcp-data-mesh-foundationsgcp-bootstrapgcp-environmentsgcp-networksgcp-orggcp-projects
- Ändern Sie den vorhandenen Foundation Blueprint und stellen Sie dann die Data Mesh-Anwendungen bereit. Führen Sie für jeden Artikel die folgenden Schritte aus:
- Checken Sie in Ihrem Ziel-Repository den Zweig
Planaus. - Wenn Sie Data Mesh-Komponenten hinzufügen möchten, kopieren Sie die relevanten Dateien und Verzeichnisse aus
gcp-data-mesh-foundationsin das entsprechende Foundation-Verzeichnis. Dateien bei Bedarf überschreiben. - Aktualisieren Sie die Data-Mesh-Variablen, -Rollen und -Einstellungen in den Terraform-Dateien (z. B.
*.tfvarsund*.tf). Legen Sie die GitHub-Tokens als Umgebungsvariablen fest. - Führen Sie die Terraform-Vorgänge „initialize“, „plan“ und „apply“ für jedes Repository aus.
- Führen Sie einen Commit für Ihre Änderungen durch, übertragen Sie den Code per Push in Ihr Remote-Repository, erstellen Sie Pull-Anfragen und führen Sie sie in Ihren Entwicklungs-, Nicht-Produktions- und Produktionsumgebungen zusammen.
- Checken Sie in Ihrem Ziel-Repository den Zweig
Nächste Schritte
- Architektur und Funktionen in einem Data Mesh
- Daten aus Google Cloud in ein gesichertes BigQuery-Data-Warehouse importieren.
- CDMC Key Controls Framework in einem BigQuery-Data-Warehouse implementieren
- Blueprint für Unternehmensgrundlagen