


Dieses Dokument bietet eine allgemeine Architektur für ein bidirektionales Multi-Agenten-KI-System in Echtzeit auf Google Cloud. Das System hilft Nutzern bei technischen Aufgaben, z. B. beim Zusammenbau komplexer Komponenten, bei der Diagnose von Gerätefehlern oder bei komplexen Reparaturverfahren. Das agentische KI-System bietet fundierte technische Anleitung und automatisierte Sicherheitsüberwachung über einen kontinuierlichen, bidirektionalen Stream multimodaler Daten.
Dieses Dokument richtet sich an Architekten, Entwickler und Administratoren, die KI-Infrastruktur und ‑Anwendungen in der Cloud erstellen und verwalten. In diesem Dokument wird davon ausgegangen, dass Sie ein grundlegendes Verständnis von KI-Agenten und ‑Modellen haben. Das Dokument enthält keine spezifischen Anleitungen zum Entwerfen und Programmieren von KI-Agenten.
Im Abschnitt Bereitstellung dieses Dokuments finden Sie Codebeispiele, mit denen Sie lernen können, wie Sie Multi-Agenten-KI-Systeme erstellen und bereitstellen.
Architektur
Das folgende Diagramm zeigt eine allgemeine Ansicht einer Architektur, die ein Multi-Agenten-KI-System verwendet, um bidirektionales multimodales Live-Datenstreaming zu ermöglichen:
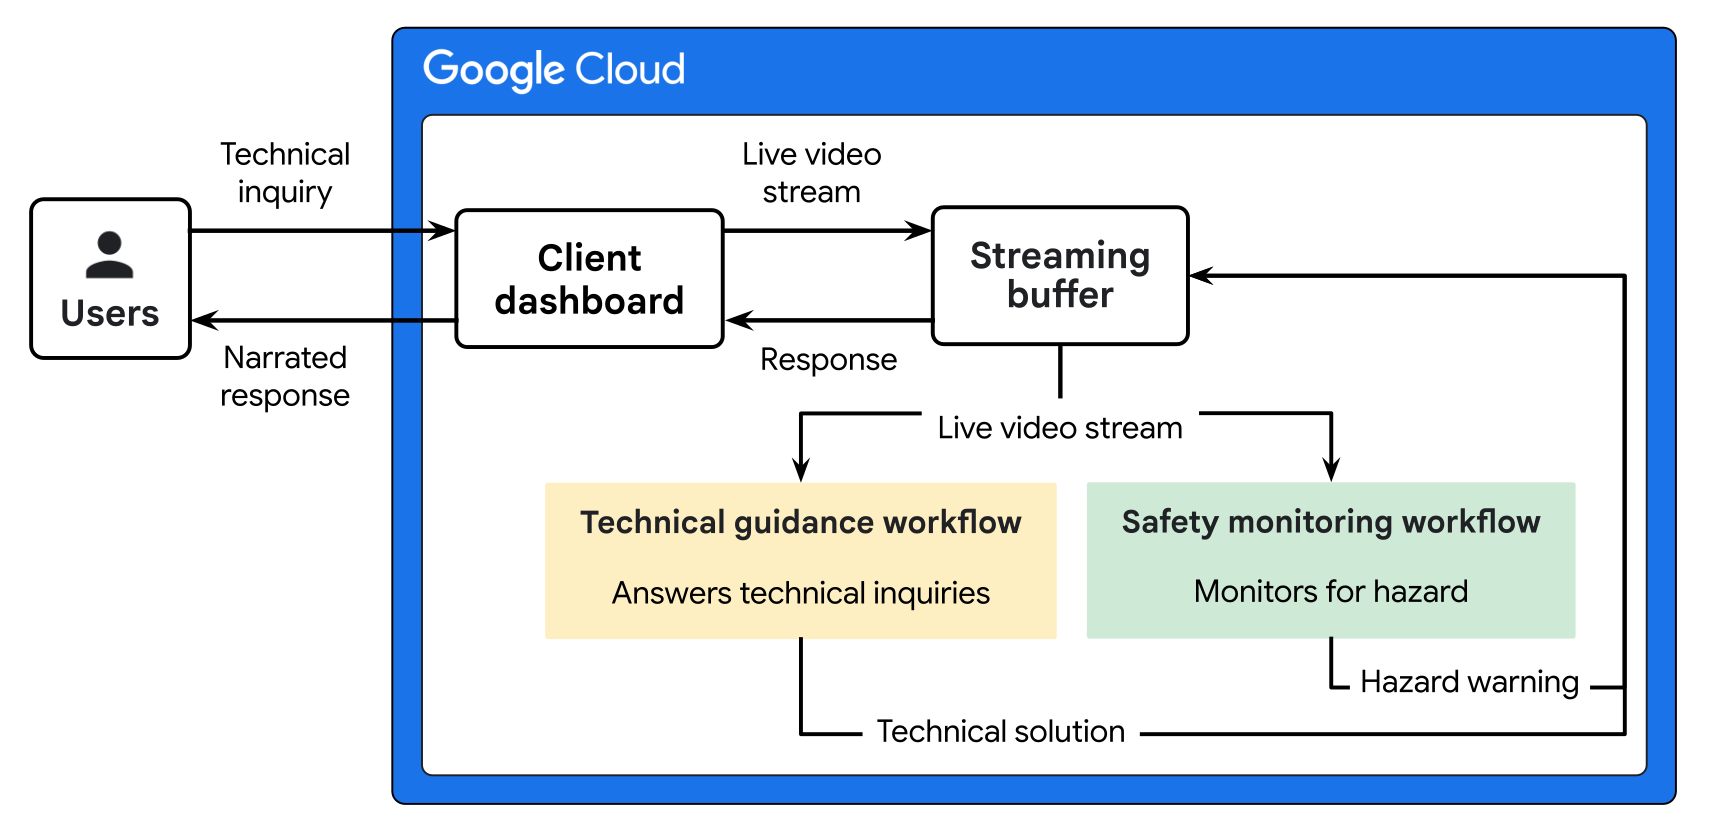
Die Architektur im vorherigen Diagramm umfasst zwei Workflows: technische Anleitung und Sicherheitsmonitoring.
- Der Workflow für technische Unterstützung ermöglicht es Nutzern, in Echtzeit gesprochene Lösungen für komplexe technische Anfragen zu erhalten. In diesem Workflow wird die Gemini Live API verwendet, um multimodale Streams zu verarbeiten und sich mit einem Sub-Agenten abzustimmen, um fundierte Produktinformationen aus der Wissensdatenbank abzurufen.
- Der Workflow zur Sicherheitsüberwachung bietet eine automatisierte Gefahrenerkennung, um die Sicherheit der Nutzer während technischer Verfahren zu gewährleisten. In diesem Workflow wird Gemini verwendet, um Live-Videosegmente zu analysieren, potenzielle Risiken zu identifizieren und sofortige Warnungen über das Client-Dashboard auszulösen.
Die folgenden Tabs enthalten Architekturdiagramme, die die Workflows für technische Anleitung und Sicherheitsmonitoring zeigen:
Workflow für technische Anleitung
Das folgende Diagramm zeigt eine detaillierte Architektur für einen Workflow mit technischer Anleitung.
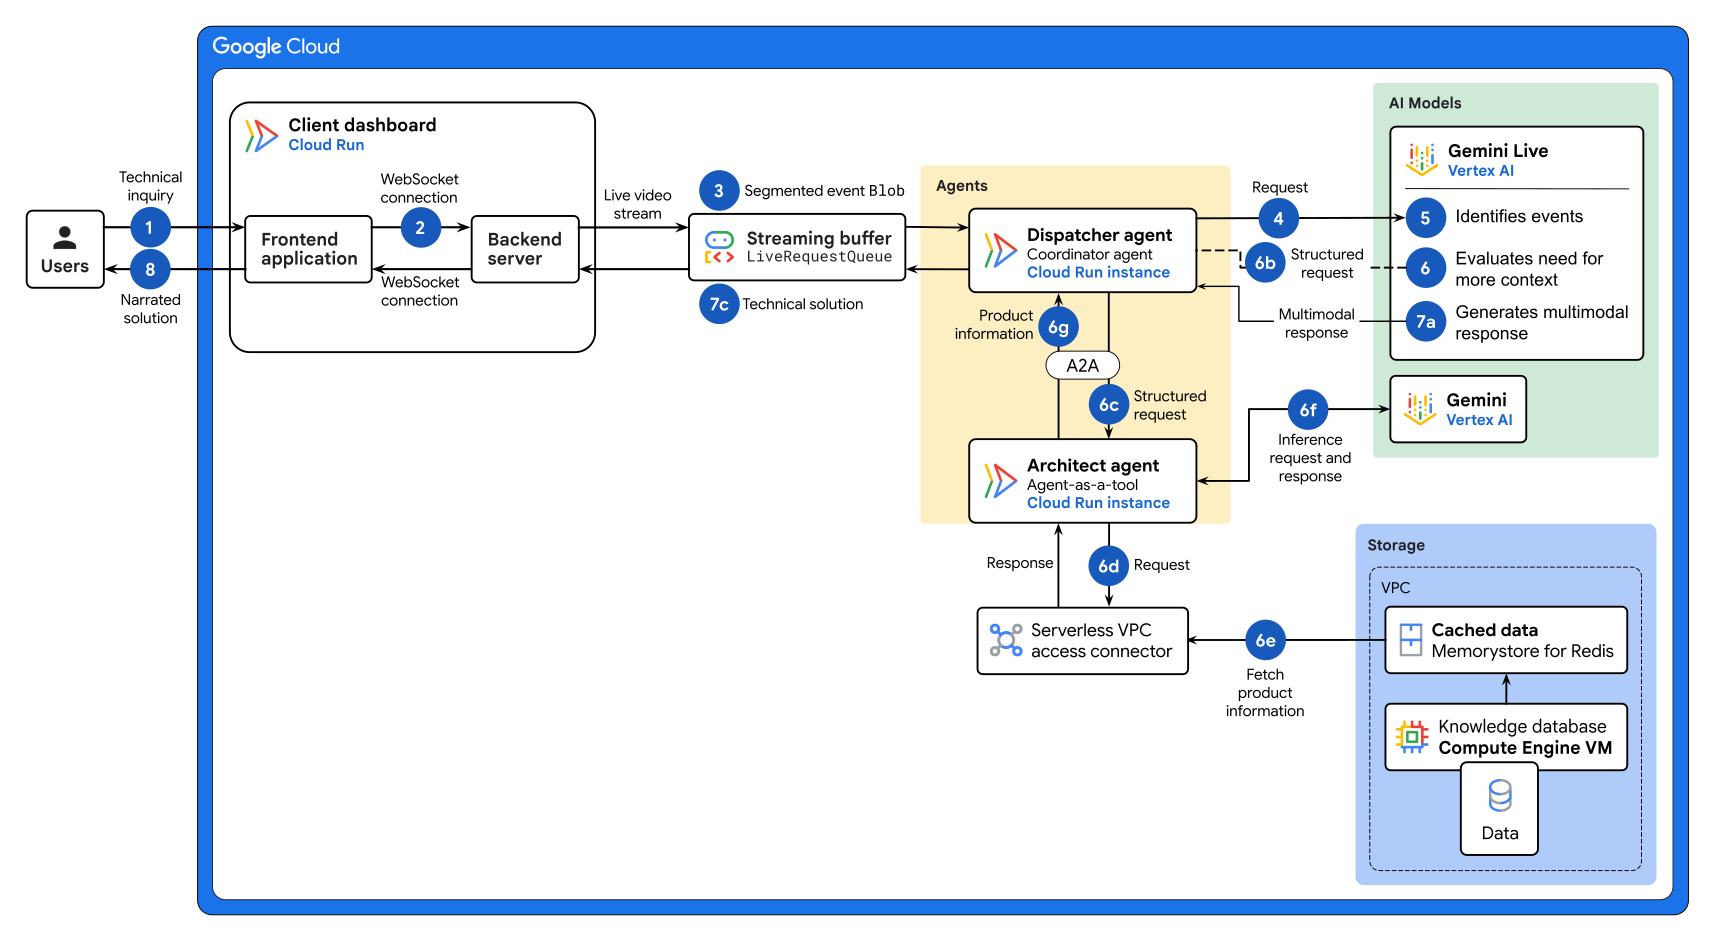
Das obige Diagramm zeigt den folgenden Datenfluss:
-
Ein Nutzer startet eine Sitzung, indem er über das Client-Dashboard eine gesprochene technische Anfrage stellt. Ein Techniker könnte beispielsweise seine Kamera auf ein Steuerfeld richten und fragen: „Hilfe, was bedeutet diese blinkende rote Fehlerleuchte?“
-
Das Client-Dashboard stellt eine nichtflüchtige WebSocket-Verbindung zwischen dem Frontend- und dem Backend-Server her.
-
WebSocket-Nachrichten verpacken die Rohmultimediadaten in
Blob-Objekte. Die ADK-Komponente (Agent Development Kit)LiveRequestQueuestreamt die Eingabedaten kontinuierlich an den Dispatcher-Agenten. -
Der Dispatcher-Agent erkennt Audio- oder visuelle Befehle, die technische Unterstützung erfordern, und sendet den Eingabestream an die Gemini Live API.
-
Das Gemini Live-Modell sucht in den Rohdaten nach Ereignissen. Ereignisse sind Audio-Keywords wie „zusammenbauen“ oder „Hilfe“ oder visuelle Hinweise wie Handgesten.
Gemini wertet jedes Ereignis aus, um festzustellen, ob es für die Anfrage des Nutzers relevant ist. Eine Handgeste oder Füllwörter sind beispielsweise möglicherweise nicht relevant, daher verarbeitet Gemini diese Ereignisse nicht.
-
Für jedes relevante Ereignis aktiviert Gemini Funktionsaufrufe, um zu prüfen, ob zusätzlicher Kontext erforderlich ist. Je nachdem, ob zusätzlicher Kontext erforderlich ist, sendet entweder Gemini oder ein Architekten-Agent eine Antwort an den Dispatcher-Agenten zurück.
-
Wenn mehr Kontext erforderlich ist, sucht Gemini in der Agentenkarte des Architekten nach Informationen, um die Anfrage zu strukturieren.
-
Gemini sendet eine strukturierte Anfrage an den Dispatcher-Agenten. Die Anfrage enthält Ereignisdetails wie Produkttyp, Modellnummer, Ereignistyp und Attribute.
-
Der Dispatcher-Agent verwendet das Agent2Agent-Protokoll (A2A), um die strukturierte Anfrage an den Architekten-Agenten zu senden.
-
Der Architekt-Agent sendet die Anfrage über einen Connector für serverlosen VPC-Zugriff . Mit dem Connector kann der Agent sicher auf Ressourcen im VPC-Netzwerk (Virtual Private Cloud) zugreifen, das für die Speicherressourcen in dieser Architektur verwendet wird.
-
Der Connector für serverlosen VPC-Zugriff interagiert mit den im Cache gespeicherten Daten, die in Memorystore for Redis Cluster gespeichert sind. Wenn die Daten nicht in der im Cache gespeicherten Ebene verfügbar sind, interagiert der Architekten-Agent mit den Compute Engine-Instanzen, die die Wissensdatenbank hosten.
-
Der Architekt-Agent empfängt die Produktinformationen aus dem Datencache oder der Wissensdatenbank. Der Architektur-Agent sendet die Produktinformationen an Gemini, um eine Antwort zu generieren. Beispiel: „Fehlercode 3B: Lüfterstörung. Empfohlene Maßnahme: Prüfe, ob etwas im Weg ist.“
Der Architekt-Agent sendet die Produktinformationen an den Dispatcher-Agenten zurück.
Wenn kein weiterer Kontext erforderlich ist, generiert Gemini direkt eine Antwort auf die Anfrage des Nutzers.
-
-
Der Dispatcher-Agent empfängt die Antwort von Gemini oder vom Architect-Agenten und generiert eine multimodale Antwort:
-
Verwendet das Gemini Live-Modell und die ADK-
run_live-Schleife, um eine multimodale Antwort zu generieren, die die technische Lösung enthält. -
Speichert die Antwort als
Blob-Objekt. -
Sendet die technische Lösung über den Streamingpuffer und die persistente WebSocket-Verbindung, um die technische Lösung an das Client-Dashboard zu senden.
-
-
Das Client-Dashboard extrahiert die
Blob-Daten aus der technischen Lösung, um sofortige gesprochene Anleitungen bereitzustellen, und aktualisiert die Benutzeroberfläche mit relevanten Transkriptionen. Die Anfrageschleife wird abgeschlossen, während der aktive bidirektionale Stream beibehalten wird.
Workflow für Sicherheitsmonitoring
Das folgende Diagramm zeigt eine detaillierte Architektur für einen Workflow zur Sicherheitsüberwachung.
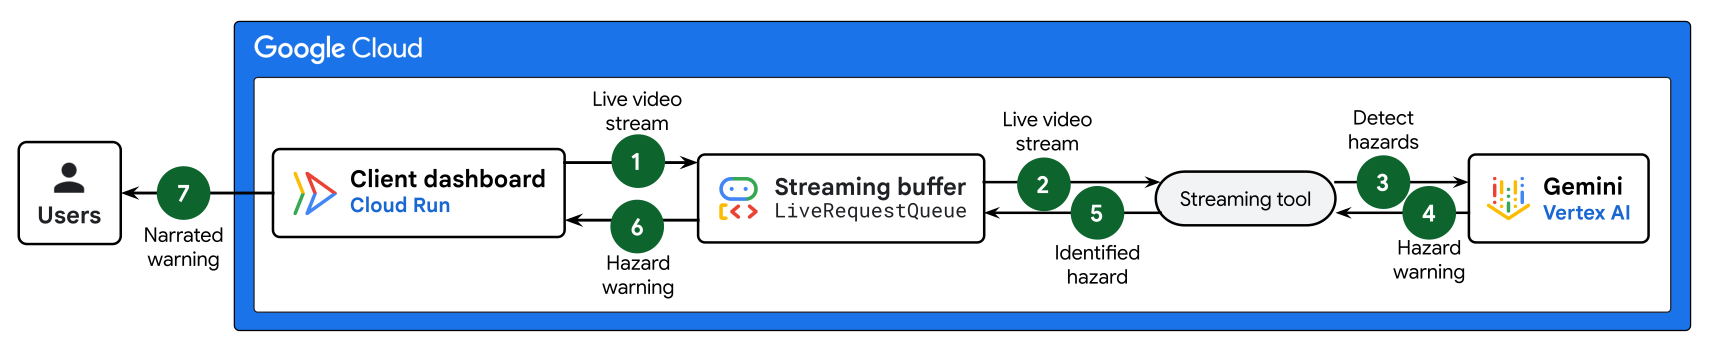
Das obige Diagramm zeigt den folgenden Datenfluss:
- Das Client-Dashboard stellt eine persistente WebSocket-Verbindung zwischen dem Frontend und dem Backend-Server her, um den Live-Videostream zu beobachten. Die WebSocket-Nachricht verpackt diese Multimedia-Rohdaten in
Blob-Objekte und sendet sie kontinuierlich mit der ADK-KomponenteLiveRequestQueuean den Streamingpuffer. - Der Streamingpuffer leitet den Eingabestream an ein Streamingtool weiter, das in einer kontinuierlichen Hintergrundschleife ausgeführt wird, um Gefahren im Videoframe zu erkennen.
- Das Streaming-Tool sendet den neuesten Videoframe aus dem Streaming-Zwischenspeicher an Gemini.
- Gemini sucht in den Videoframes nach Gefahren wie hellem Licht oder Dampf.
- Wenn keine Gefahr erkannt wird, passiert nichts.
- Wenn eine Gefahr erkannt wird, generiert Gemini eine multimodale Antwort mit dem Gefahrentyp, den Attributen und dem Standort und speichert sie als
Blob-Objekt. Gemini sendet die Antwort mit der Gefahrenwarnung an das Streaming-Tool zurück.
- Das Streaming-Tool leitet die Antwort mit der Gefahrenwarnung an den Streaming-Zwischenspeicher weiter.
- Der Streamingpuffer verwendet die persistente WebSocket-Verbindung, um die Antwort mit der Gefahrenwarnung an das Client-Dashboard zu senden.
- Das Client-Dashboard extrahiert die
Blob-Daten aus der Antwort auf die Gefahrenwarnung, um sofortige gesprochene Anweisungen zu geben, und aktualisiert die Benutzeroberfläche mit relevanten Transkriptionen. Damit wird die Anfrageschleife abgeschlossen, während der aktive bidirektionale Stream beibehalten wird.
Verwendete Produkte
In dieser Referenzarchitektur werden die folgenden Produkte und Tools von Google Cloud verwendet:
- Cloud Run ist eine serverlose Computing-Plattform, mit der Sie Container direkt auf der skalierbaren Infrastruktur von Google ausführen können.
- Gemini: Eine Familie von multimodalen KI-Modellen, die von Google entwickelt wurden.
- Gemini Enterprise Agent Platform: Eine umfassende Plattform, mit der Sie KI-Agenten auf Unternehmensniveau erstellen, skalieren, verwalten und optimieren können.
- Agent Development Kit (ADK): Eine Reihe von Tools und Bibliotheken zum Entwickeln, Testen und Bereitstellen von KI-Agenten.
- Agent2Agent-Protokoll (A2A): Ein offenes Protokoll, das die Kommunikation und Interoperabilität zwischen Agenten unabhängig von ihrer Programmiersprache und Laufzeit ermöglicht.
- Serverloser VPC-Zugriff: Ein Dienst, mit dem Ihre serverlosen Umgebungen eine Verbindung zu Ressourcen in einem Virtual Private Cloud-Netzwerk herstellen können.
- Virtual Private Cloud (VPC): Ein virtuelles System, das globale, skalierbare Netzwerkfunktionen für Ihre Google Cloud -Arbeitslasten bietet. VPC umfasst VPC-Netzwerk-Peering, Private Service Connect, Zugriff auf private Dienste und freigegebene VPC.
- Memorystore for Redis Cluster: Ein vollständig verwalteter In-Memory-Datenspeicherdienst für Redis.
- Compute Engine: Ein sicherer und anpassbarer Computing-Dienst, mit dem Sie virtuelle Maschinen in der Infrastruktur von Google erstellen und ausführen können.
Informationen zur Auswahl alternativer Komponenten für Ihr agentisches KI-System, einschließlich Framework, Agent Runtime, Tools, Speicher und Designmuster, finden Sie unter Komponenten für die agentische KI-Architektur auswählen.
Anwendungsfall
Diese Referenzarchitektur ist für Anwendungsfälle konzipiert, die die Echtzeitsynthese kontinuierlicher, bidirektionaler multimodaler Datenstreams erfordern. Im Folgenden finden Sie Beispiele für Anwendungsfälle für die in diesem Dokument beschriebene Architektur:
- Industrielle Fertigung und Wartung vor Ort: Ermöglichen Sie die Reparatur komplexer Maschinen per Sprachbefehl, indem Sie Technikern einen KI-Assistenten zur Verfügung stellen, der Live-Audio und -Video von Smart Glasses verarbeitet. Der Techniker spricht mit dem KI-Assistenten, um die Schaltpläne der Maschine abzurufen. Der KI-Assistent verwendet einen internen Datenbank-Agenten, der auf die Produktdokumentation zugreift, um fundierte Reparatur- und Montageanleitungen zu erstellen. Ein gleichzeitiges Hintergrund-Vision-Tool überwacht den bidirektionalen Stream, um den Techniker proaktiv vor mechanischen Gefahren oder falschen Montageschritten zu warnen.
- Technischer Support per Fernzugriff: Verbessern Sie die Ergebnisse der Fehlerbehebung für Kunden, indem Sie Nutzern die Möglichkeit geben, einen Live-Kamerafeed ihres Smartphones mit einem multimodalen agentischen KI-System zu teilen. Die bidirektionale Streaming-Architektur unterstützt eine dynamische Unterhaltung, bei der das System die Hardware in Echtzeit beobachtet. Wenn ein Hintergrundprozess für die visuelle Erkennung eine fehlerhafte Verbindung erkennt, z. B. ein Kabel im falschen Anschluss, verwendet das System den Stream mit niedriger Latenz, um den Nutzer sofort mit Korrekturhinweisen zu unterbrechen.
Designaspekte
In diesem Abschnitt werden Designfaktoren, Best Practices und Empfehlungen beschrieben, die Sie berücksichtigen sollten, wenn Sie diese Referenzarchitektur verwenden, um eine Topologie zu entwickeln, die Ihren spezifischen Anforderungen an Sicherheit, Betrieb, Kosten und Leistung entspricht.
Die Anleitung in diesem Abschnitt ist nicht vollständig. Weitere Informationen zu Designfaktoren und Best Practices sowie Empfehlungen zum Erstellen und Bereitstellen eines Multi-Agenten-KI-Systems finden Sie unter Multi-Agenten-KI-System in Google Cloud.
Sicherheit, Datenschutz und Compliance
Um die besonderen Sicherheitsrisiken von KI-Agenten zu minimieren, empfiehlt Google einen Ansatz, der deterministische Sicherheitskontrollen mit dynamischen, logikbasierten Abwehrmechanismen kombiniert:
- Menschliche Kontrolle: Integrieren Sie einen Human-in-the-Loop-Workflow in geschäftskritische Systeme, damit menschliche Prüfer die Ausgaben überprüfen und die Aktionen des KI-Agenten genehmigen, überschreiben oder pausieren können.
- Agent Identity: Weisen Sie jedem KI-Agenten eine arbeitslastgebundene Identität zu, um die Zugriffssteuerung nach dem Prinzip der geringsten Berechtigung durchzusetzen und Anmeldedaten für externe Tools zentral zu verwalten.
- Agent Gateway: Erzwingen Sie die Governance für eingehenden und ausgehenden Traffic, Standardzugriffsrichtlinien für die Ablehnung und die Inline-Prüfung von Prompts und Tools mit Model Armor.
Agent Registry: Prüfen Sie, ob KI-Agenten nur eine Verbindung zu genehmigten Sub-Agenten und MCP-Tools herstellen.
Sicherheit für eingehenden Traffic der Anwendung: Um den Zugriff auf die Anwendung zu steuern, deaktivieren Sie die Standard-URL
run.appdes Frontend-Cloud Run-Dienstes und richten Sie einen regionalen externen Application Load Balancer ein. Zusätzlich zum Load Balancing des eingehenden Traffics zur Anwendung übernimmt der Load Balancer die Verwaltung von SSL-Zertifikaten. Für zusätzlichen Schutz können Sie Google Cloud Armor-Sicherheitsrichtlinien verwenden, um Anfragefilterung, DDoS-Schutz und Ratenbegrenzung für den Dienst bereitzustellen.WebSocket-Sicherheit: Schützen Sie sensible multimodale Daten wie Stimmabdrücke und Videos, indem Sie für alle bidirektionalen WebSocket-Verbindungen die TLS-Verschlüsselung erzwingen.
Sichere A2A-Kommunikation:
- Verwenden Sie authentifizierte erweiterte Agent-Karten, um die A2A-Kommunikation zu sichern.
- OIDC-Identitätstokens (OpenID Connect) an Anfragen anhängen Mit den OIDC-Identitätstokens können Sie mit Identity and Access Management (IAM) prüfen, ob nur autorisierte Agenten auf die Daten zugreifen.
Betriebliche Effizienz
Damit Ihre Agent-Konfigurationen Ihren Anforderungen an die betriebliche Effizienz entsprechen, sollten Sie die folgenden Empfehlungen beachten:
- Skripts für Kontrollschleifen: Schreiben Sie System-Prompts für bidirektionale Live-Agenten als strikte Zustandsautomaten-Verhaltensschleifen und nicht nur als Persönlichkeitsrichtlinien. Der System-Prompt sollte den Agenten explizit anweisen, still zu bleiben, bis er ausgelöst wird. Sie sollte kurze, handlungsorientierte Antworten erzwingen, damit die Sprachinteraktion prägnant und natürlich ist.
- Trennung von Zuständigkeiten: Verwenden Sie ein spezielles Tool für das Hintergrund-Streaming, um Videofeeds unabhängig vom primären Agenten zu überwachen. Der Root-Agent in der Architektur ist bidirektional und kann seine eigene Sprachausgabe sofort unterbrechen, um diese wichtigen Sicherheitshinweise an den Nutzer zu senden. Wenn ein einzelner Agent einen Videofeed ständig überwachen muss, kann dies zu kognitiver Überlastung und Halluzinationen führen.
Kostenoptimierung
Beachten Sie die folgenden Empfehlungen, damit Ihre Agentenkonfigurationen Ihren Kostenanforderungen entsprechen:
- Kosten für die Datenaufnahme: Um die Tokenkosten zu senken und eine Erschöpfung des Kontextfensters zu verhindern, sollten Sie ein Frame-Sampling mit niedriger Frequenz verwenden, z. B. 2 Bilder pro Sekunde, und alle Daten in Base64-JPEG-Dateien komprimieren.
- Kostengünstige Prompts: Die Länge Ihrer Prompts (Eingabe) und die generierten Antworten (Ausgabe) wirken sich direkt auf die Leistung und die Kosten aus. Schreiben Sie Prompts, die kurz und direkt sind und ausreichend Kontext bieten. Entwerfen Sie Ihre Prompts so, dass Sie prägnante Antworten vom Modell erhalten. Verwenden Sie beispielsweise Formulierungen wie „Fasse in zwei Sätzen zusammen“ oder „Liste drei wichtige Punkte auf“. Weitere Informationen finden Sie in den Best Practices für das Prompt-Design.
Leistungsoptimierung
Damit Ihre Agentenkonfigurationen Ihren Leistungsanforderungen entsprechen, sollten Sie die folgenden Empfehlungen beachten:
- Asynchrones Zwischenspeichern: Verwenden Sie einen threadsicheren, asynchronen FIFO-Zwischenspeicher (First-In-First-Out), um eingehende Audio- und Videopakete von der Inferenz-Engine des Modells zu entkoppeln. Dieser Zwischenspeicher fungiert als Multiplexer, der dafür sorgt, dass das System auf Unterbrechungen durch den Nutzer reagiert, ohne dass die Benutzeroberfläche bei rechenintensiven Vorgängen einfriert.
- In-Memory-Caching: Um Lesegeschwindigkeiten von weniger als einer Millisekunde zu erreichen, verwenden Sie eine In-Memory-Memorystore for Redis Cluster-Datenbank für den Schematresor des Architekten-Agents. Diese Implementierung minimiert die Latenz, verhindert Pausen bei Sprachinteraktionen in Echtzeit und bietet eine skalierbare zentrale Datenquelle.
- Ressourcenzuweisung: Konfigurieren Sie je nach Leistungsanforderungen die Speicherlimits und CPU-Limits, die dem Cloud Run-Dienst zugewiesen werden sollen.
Bereitstellung
Wenn Sie eine Beispielimplementierung dieser Architektur bereitstellen möchten, probieren Sie die folgenden Codelabs aus:
- Codelab: ADK-Agent für bidirektionales Streaming erstellen: Erstellen Sie ein agentisches KI-System mit einem einzelnen Agenten, das einen Live-Videostream verarbeitet, um bestimmte Nutzergesten zu erkennen.
- Codelab für bidirektionales Multi-Agenten-System in Echtzeit: Erstellen Sie ein Multi-Agenten-KI-System, das bidirektionales Streaming für Sprach- und Videointeraktionen in Echtzeit verwendet. Das System umfasst ein proaktives Streaming-Tool für kontinuierliches Sicherheitsmonitoring.
Nächste Schritte
- Informationen zum Starten und Verwalten von Live-Sitzungen
- Einführung in das ADK-Toolkit für die Gemini Live API
- (Video) Echtzeit-Sprach-KI-Agenten mit ADK und der Gemini Live API erstellen
- KI-Agenten in Cloud Run hosten
- Informationen zum Auswählen der Architekturkomponenten für agentische KI
- Sehen Sie sich die Lernressourcen zum Erstellen und Bereitstellen von Agenten auf Unternehmensniveau mit Gemini Enterprise Agent Ready (GEAR) an.
- Weitere Architekturleitfäden für agentische KI
- Eine Übersicht über Architekturprinzipien und Empfehlungen, die speziell für KI- und ML-Arbeitslasten in Google Cloudgelten, finden Sie im Well-Architected Framework unter KI- und ML-Perspektive.
- Weitere Referenzarchitekturen, Diagramme und Best Practices finden Sie im Cloud-Architekturcenter.
Beitragende
Autor*innen:
- Christina Lin | Developer Relations Engineer Manager
- Samantha He | Technical Writer
Weitere Beitragende:
- Kumar Dhanagopal | Cross-Product Solution Developer
- Olivier Bourgeois | Developer Relations Engineer