


Nosso Serviço de avaliação de IA generativa oferece ferramentas de nível empresarial para uma avaliação de modelos de IA generativa objetiva e baseada em dados. Ele oferece suporte e informações para várias tarefas de desenvolvimento, como migrações de modelos, edição de comandos e ajuste de detalhes.
Recursos do serviço de avaliação de IA generativa
O recurso que define o serviço de avaliação de IA generativa é a capacidade de usar instruções adaptáveis, um conjunto de testes de aprovação ou reprovação personalizados para cada comando individual. As instruções de avaliação são semelhantes aos testes de unidade no desenvolvimento de software e visam melhorar o desempenho do modelo em várias tarefas.
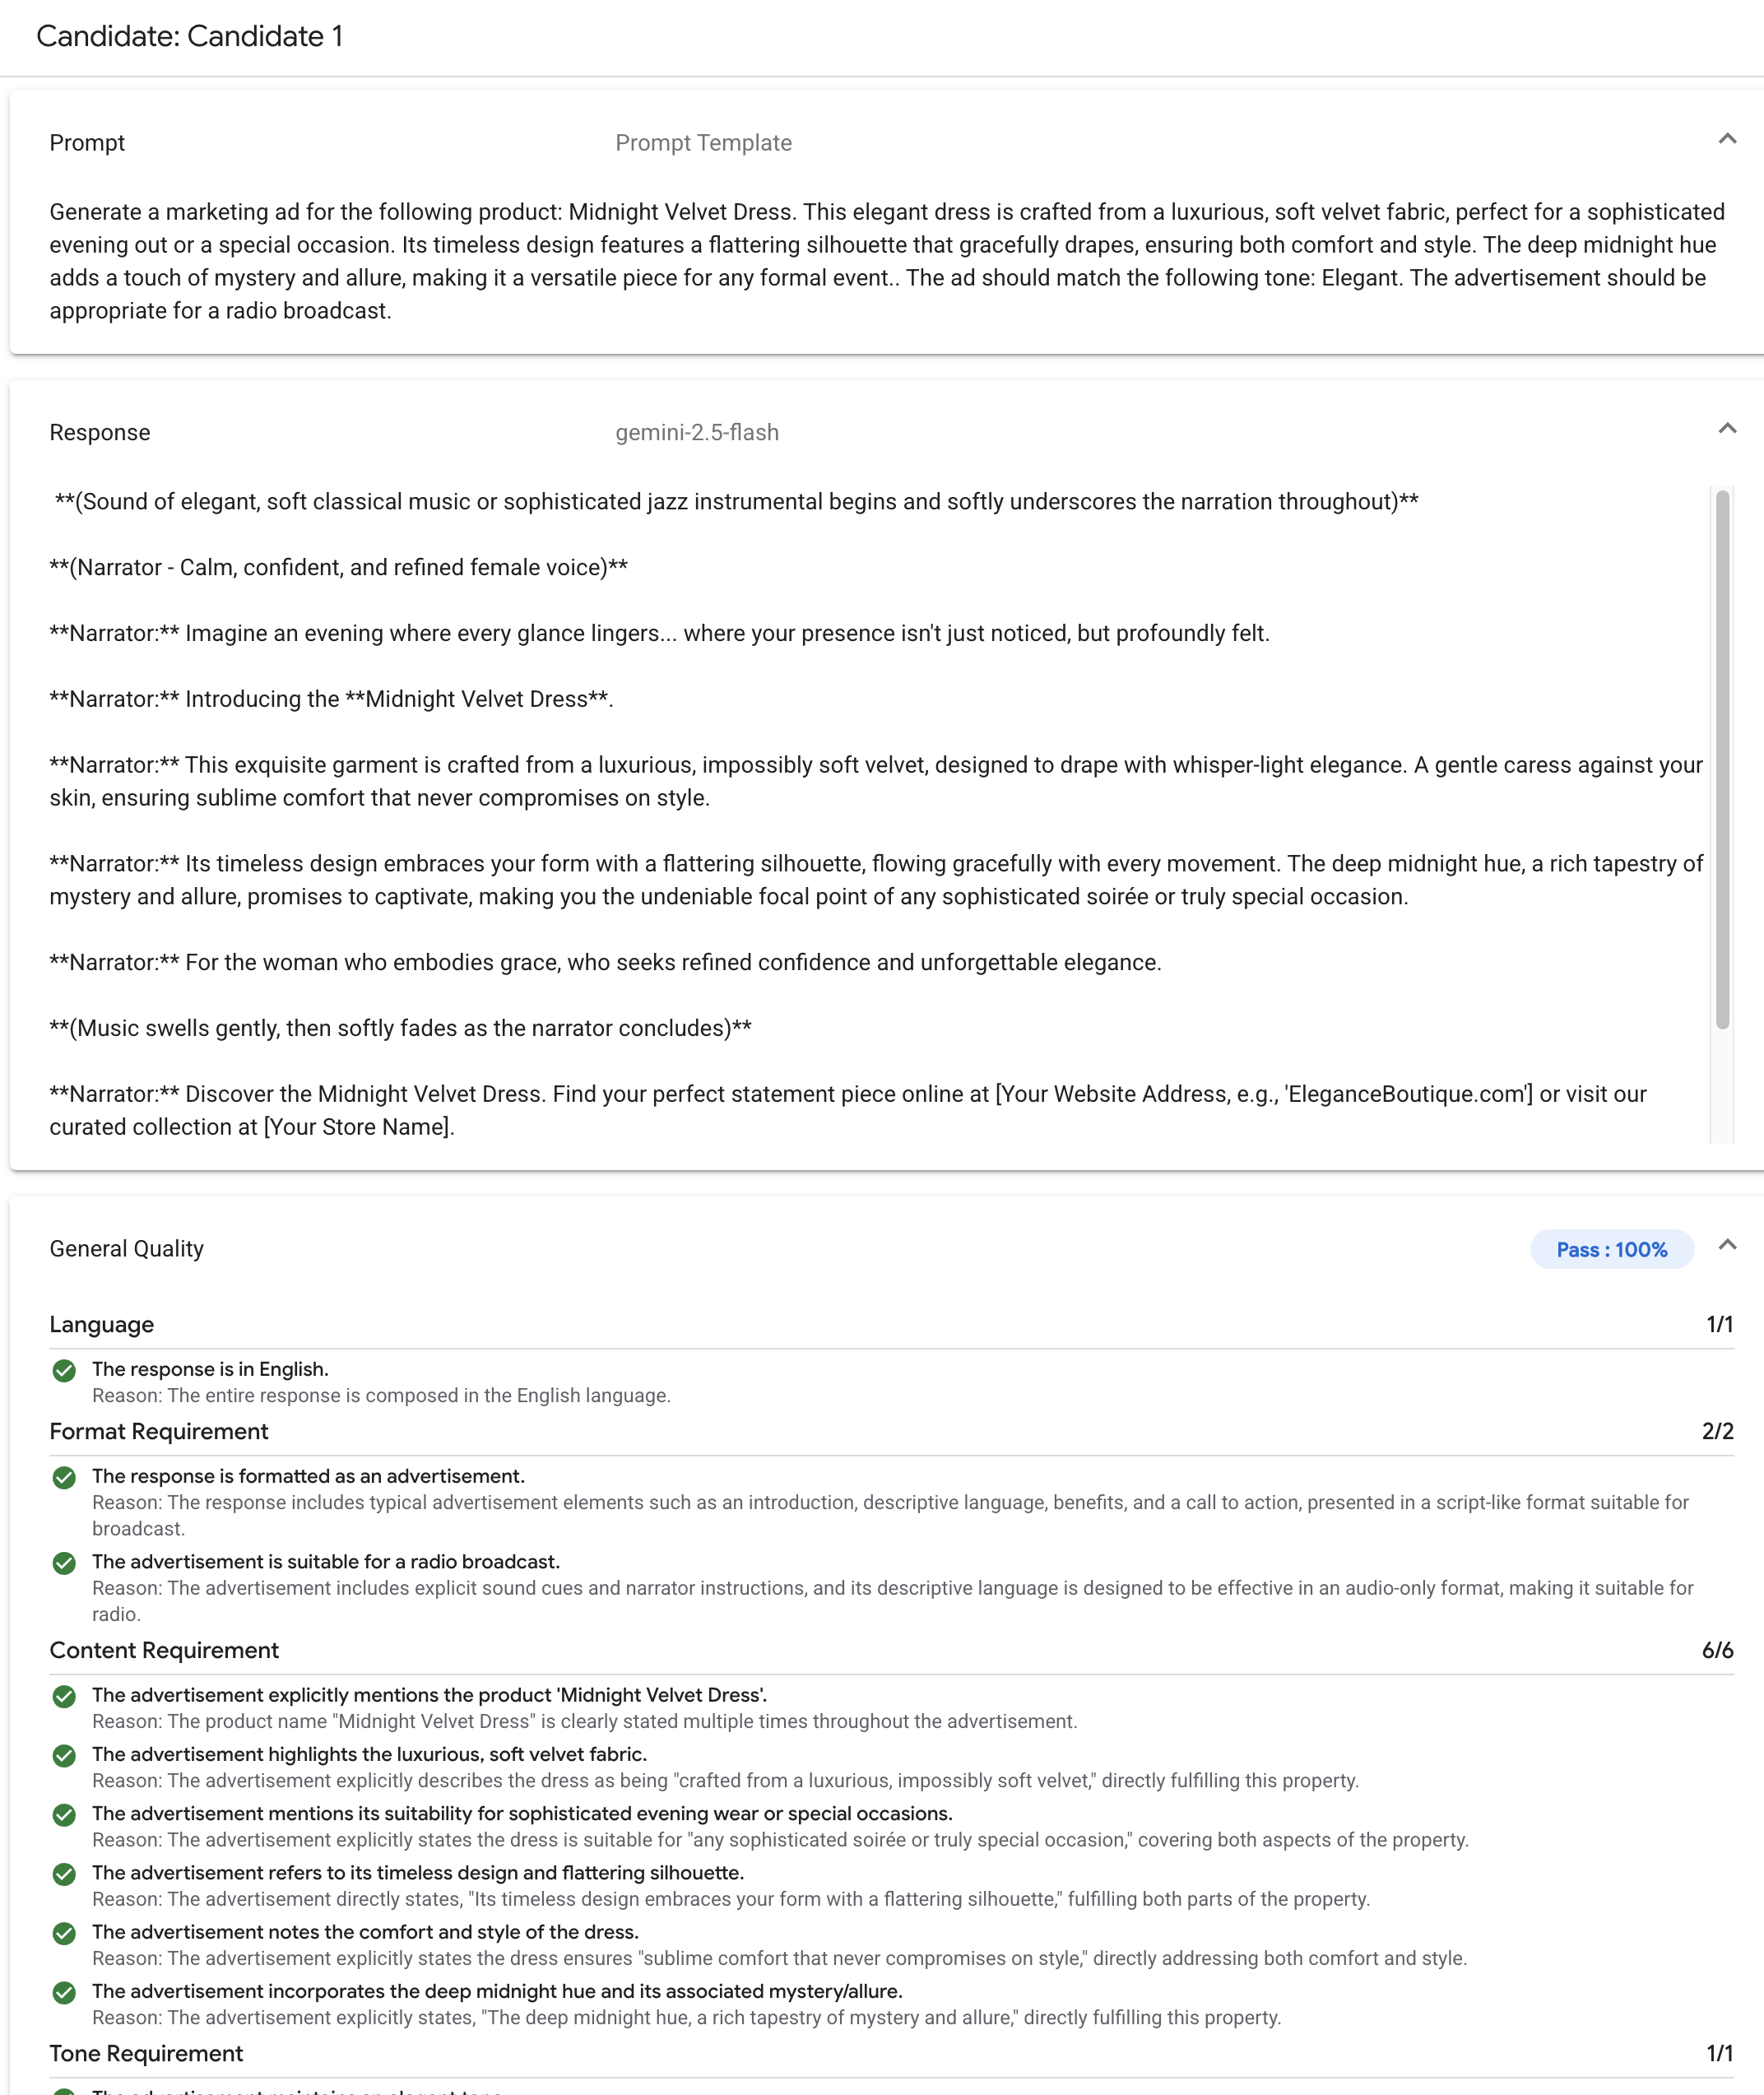
O serviço de avaliação de IA generativa é compatível com os seguintes métodos de avaliação comuns:
Rubricas adaptáveis (recomendado): gera um conjunto exclusivo de rubricas de aprovação ou reprovação para cada comando no conjunto de dados.
Rubricas estáticas: aplique um conjunto fixo de critérios de pontuação em todos os comandos.
Métricas baseadas em computação: use algoritmos determinísticos, como
ROUGEouBLEU, quando houver informações empíricas disponíveis.Funções personalizadas: defina sua própria lógica de avaliação em Python para requisitos especializados.
Geração de conjuntos de dados de avaliação
É possível criar um conjunto de dados de avaliação usando os seguintes métodos:
Faça upload de um arquivo com instâncias completas de comandos ou forneça um modelo de comando com um arquivo correspondente de valores de variáveis para preencher os comandos.
Faça amostras diretamente dos registros de produção para avaliar o uso real do modelo.
Use a geração de dados sintéticos para gerar um grande número de exemplos consistentes para qualquer modelo de comando.
Interfaces compatíveis
É possível definir e executar as avaliações usando as seguintes interfaces:
Console doGoogle Cloud : uma interface do usuário da Web que fornece um fluxo de trabalho guiado de ponta a ponta. Gerencie seus conjuntos de dados, execute avaliações e analise relatórios interativos e visualizações. Consulte Realizar avaliação usando o console.
SDK para Python: execute avaliações de forma programática e renderize comparações de modelos lado a lado diretamente no ambiente do Colab ou do Jupyter. Consulte Realizar avaliação usando o cliente de IA generativa no SDK da Agent Platform.
Casos de uso
O serviço de avaliação de IA generativa permite que você veja o desempenho de um modelo em tarefas específicas e de acordo com seus critérios exclusivos, fornecendo insights valiosos que não podem ser derivados de classificações públicas e comparativos de mercado gerais. Isso ajuda em tarefas de desenvolvimento importantes, como:
Migrações de modelos: compare as versões dos modelos para entender as diferenças de comportamento e ajustar os comandos e as configurações de acordo.
Encontrar o melhor modelo: faça comparações diretas entre os modelos do Google e de terceiros com seus dados para estabelecer um valor de referência de desempenho e identificar o mais adequado para seu caso de uso.
Melhoria de comandos: use os resultados da avaliação para orientar seus esforços de personalização. Executar uma avaliação novamente cria um ciclo de feedback rápido, fornecendo feedback imediato e quantificável sobre as mudanças.
Ajuste de modelos: avalie a qualidade de um modelo ajustado aplicando critérios de avaliação consistentes a cada execução.
Avaliação de agentes: avalie o desempenho de um agente usando métricas específicas, como traces de agentes e qualidade de resposta.
Fluxo de trabalho de avaliação
Para concluir uma avaliação, geralmente é necessário seguir estas etapas:
Criar um conjunto de dados de avaliação: monte um conjunto de dados de instâncias de comandos que reflitam seu caso de uso específico. Você pode incluir respostas de referência (informações empíricas) se planeja usar métricas baseadas em computação.
Defina as métricas de avaliação: escolha as métricas que você quer usar para medir o desempenho do modelo.
Gerar respostas do modelo: selecione um ou mais modelos para gerar respostas para seu conjunto de dados. O SDK da Agent Platform é compatível com qualquer modelo que possa ser chamado por
LiteLLM, enquanto o console é compatível com os modelos do Gemini.Executar a avaliação: execute o job de avaliação, que avalia as respostas de cada modelo em relação às métricas selecionadas.
Interpretar os resultados: analise as pontuações agregadas e as respostas individuais para avaliar o desempenho do modelo.
Métricas de avaliação
Confira a seguir os principais conceitos relacionados às métricas de avaliação:
Rubricas: os critérios para avaliar a resposta de um modelo ou aplicativo de LLM.
Métricas: uma pontuação que mede a saída do modelo em relação às rubricas de classificação.
O serviço de avaliação de IA generativa oferece as seguintes categorias de métricas:
Métricas baseadas em instruções: incorporam LLMs aos fluxos de trabalho de avaliação para analisar a qualidade das respostas do modelo. As avaliações baseadas em rubricas são adequadas para uma variedade de tarefas, especialmente qualidade de escrita, segurança e seguimento de instruções, que geralmente são difíceis de avaliar com algoritmos determinísticos.
Instruções adaptáveis (recomendado): as instruções são geradas dinamicamente para cada comando, como testes de unidade. As respostas são avaliadas com um conjunto exclusivo de testes de aprovação ou reprovação para cada comando no conjunto de dados. As rubricas mantêm a avaliação relevante para a tarefa solicitada e visam fornecer resultados objetivos, explicáveis e consistentes.
As instruções adaptáveis costumam ser a maneira mais rápida de começar as avaliações, garantindo que cada uma seja relevante para a tarefa específica que está sendo avaliada.
Rubricas estáticas: as rubricas são definidas explicitamente, e a mesma rubrica é aplicada a todos os comandos. As respostas são avaliadas com o mesmo conjunto de avaliadores numéricos baseados em pontuação. Uma única pontuação numérica (como de 1 a 5) por comando. Use rubricas estáticas quando uma avaliação for necessária em uma dimensão muito específica ou quando a mesma rubrica for necessária em todos os comandos.
Métricas baseadas em computação: avaliam as respostas com algoritmos determinísticos, geralmente usando informações empíricas. Uma pontuação numérica (como 0,0 a 1,0) por comando. Quando as informações empíricas estão disponíveis e podem ser combinadas com um método determinista.
Métricas de função personalizada (somente SDK da Agent Platform): defina sua própria métrica usando uma função do Python.
Exemplo de rubricas adaptativas
O processo de avaliação de cada comando usa um sistema de duas etapas:
Geração de rubricas: primeiro, o serviço analisa seu comando e gera uma lista de testes específicos e verificáveis (as rubricas) que uma boa resposta precisa atender.
Validação de rubrica: depois que o modelo gera uma resposta, o serviço a avalia em relação a cada rubrica, fornecendo um veredito claro de
PassouFaile uma justificativa.
O resultado final é uma taxa de aprovação agregada e um detalhamento de quais critérios o modelo atendeu, fornecendo insights úteis para diagnosticar problemas e medir melhorias.
Ao passar de pontuações subjetivas de alto nível para resultados de testes granulares e objetivos, é possível adotar um ciclo de desenvolvimento orientado por avaliação e aplicar as práticas recomendadas de engenharia de software ao processo de criação de aplicativos de IA generativa.
O exemplo a seguir mostra exemplos de rubricas adaptativas que foram geradas para um conjunto de comandos:
Comando do usuário: Write a four-sentence summary of the provided article about renewable energy, maintaining an optimistic tone.
Para esse comando, a etapa de geração de rubricas pode produzir as seguintes rubricas:
Rubrica 1: a resposta é um resumo do artigo fornecido.
Critério 2: a resposta tem exatamente quatro frases.
Rubrica 3: a resposta mantém um tom otimista.
Seu modelo pode produzir a seguinte resposta: The article highlights significant growth in solar and wind power. These advancements are making clean energy more affordable. The future looks bright for renewables. However, the report also notes challenges with grid infrastructure.
Durante a validação da rubrica, o serviço de avaliação de IA generativa avalia a resposta em relação a cada rubrica:
Rubrica 1: a resposta é um resumo do artigo fornecido.
Veredito:
PassMotivo: a resposta resume com precisão os pontos principais.
Critério 2: a resposta tem exatamente quatro frases.
Veredito:
PassMotivo: a resposta é composta por quatro frases distintas.
Rubrica 3: a resposta mantém um tom otimista.
Veredito:
FailMotivo: a frase final apresenta um ponto negativo, o que prejudica o tom otimista.
A taxa de aprovação final para essa resposta é de 66,7%. Para comparar dois modelos, avalie as respostas deles em relação a esse mesmo conjunto de testes gerados e compare as taxas gerais de aprovação.
Primeiros passos com as avaliações
Comece a usar as avaliações pelo console.
Como alternativa, o código a seguir mostra como concluir uma avaliação com o cliente de IA generativa no SDK da plataforma de agentes:
from vertexai import Client
from vertexai import types
import pandas as pd

client = Client(project=PROJECT_ID, location=LOCATION)

# Create an evaluation dataset
prompts_df = pd.DataFrame({
    "prompt": [
        "Write a simple story about a dinosaur",
        "Generate a poem about Agent Platform",
    ],
})

# Get responses from one or multiple models
eval_dataset = client.evals.run_inference(model="gemini-2.5-flash", src=prompts_df)

# Define the evaluation metrics and run the evaluation job
eval_result = client.evals.evaluate(
    dataset=eval_dataset,
    metrics=[types.RubricMetric.GENERAL_QUALITY]
)

# View the evaluation results
eval_result.show()
O serviço de avaliação de IA generativa oferece duas interfaces do SDK da Agent Platform:
Cliente de IA generativa no SDK da Agent Platform (recomendado) (pré-lançamento)
from vertexai import clientO cliente da GenAI é a interface mais recente e recomendada para avaliação, acessada pela classe unificada Client. Ele é compatível com todos os métodos de avaliação e foi projetado para fluxos de trabalho que incluem comparação de modelos, visualização em notebook e insights para personalização de modelos.
Módulo de avaliação no SDK da Agent Platform (GA)
from vertexai.evaluation import EvalTaskO módulo de avaliação é a interface mais antiga, mantida para compatibilidade com versões anteriores de fluxos de trabalho, mas que não está mais em desenvolvimento ativo. Ele é acessado pela classe
EvalTask. Esse método é compatível com as métricas padrão de LLM como juiz e baseadas em computação, mas não com métodos de avaliação mais recentes, como rubricas adaptativas.
Regiões compatíveis
O serviço de avaliação de IA generativa está disponível nas seguintes regiões:
Iowa (
us-central1)Carolina do Sul (
us-east1)Norte da Virgínia (
us-east4)Columbus, Ohio (
us-east5)Dallas, Texas (
us-south1)Oregon (
us-west1)Las Vegas, Nevada (
us-west4)Varsóvia, Polônia (
europe-central2)Finlândia (
europe-north1)Madri, Espanha (
europe-southwest1)Bélgica (
europe-west1)Países Baixos (
europe-west4)Milão, Itália (
europe-west8)Paris, França (
europe-west9)Global (
global)
Notebooks disponíveis
| Links de notebooks | Descrição |
|---|---|
| Introdução: avaliação rápida de IA generativa | Apresenta o serviço de avaliação de IA generativa. |
| Como avaliar modelos de terceiros com o serviço de avaliação de IA generativa | Demonstra como usar o **SDK da Agent Platform** para avaliar vários tipos de modelos de terceiros, incluindo modelos acessados por API (como OpenAI, Anthropic), modelo como serviço (MaaS) do Model Garden da Gemini Enterprise Agent Platform e endpoints de Bring Your Own Model (BYOM). |
| Migração de modelos com o serviço de avaliação de IA generativa | Mostra como usar o **SDK da Agent Platform** para o serviço de avaliação de IA generativa para comparar dois modelos próprios (como o Gemini 2.0 Flash e o Gemini 2.5 Flash). Ele destaca o uso de métricas adaptáveis predefinidas com base em rubricas e como os resultados da avaliação podem orientar a otimização de comandos. Recursos importantes, como avaliação de vários candidatos, visualização no notebook e avaliação em lote assíncrona, também são abordados. |
| Avaliar a qualidade da criação de imagens a partir de texto com o serviço de avaliação de IA generativa | Mostra como usar o SDK da Vertex AI para o serviço de avaliação de IA generativa para avaliar a qualidade das imagens generativas com base em comandos de texto. Ele demonstra o uso da métrica Gecko predefinida, adaptativa e baseada em critérios. |
| Avaliar a qualidade de texto para vídeo com o serviço de avaliação de IA generativa | Mostra como usar o **SDK da Agent Platform** para o serviço de avaliação de IA generativa para avaliar a qualidade dos vídeos gerados com base em comandos de texto. Ele demonstra o uso da métrica Gecko predefinida, adaptativa e baseada em critérios. |