


Mit Objektkontext-Anreicherungen können Sie automatisch strukturierte Metadaten generieren, ohne benutzerdefinierte Pipelines für maschinelles Lernen erstellen zu müssen. Bei Objektkontext-Anreicherungen werden die vortrainierten Modelle für maschinelles Lernen von Google direkt auf Ihre gespeicherten Objekte angewendet, damit Sie Ihre unstrukturierten Daten im großen Maßstab durchsuchen, kuratieren und verwalten können.
Informationen zum Generieren von Metadaten für Ihre Objekte finden Sie unter Objektkontext-Anreicherungen konfigurieren.
Funktionsweise
Für die Verwendung von Objektkontext-Anreicherungen arbeiten Sie mit den folgenden Teilen des Systems:
- Funktionskonfiguration (
FeatureConfig): Sie erstellen eine Funktionskonfiguration, um anzugeben, welche Buckets oder Projekte von Cloud Storage überwacht werden. - Modelle für maschinelles Lernen: In Ihrer Konfiguration wählen Sie die Modelle aus, die Sie anwenden möchten, z. B. Modelle, die Objekte erkennen, Bilder labeln, Gesichter analysieren oder PDF-Dokumente kategorisieren.
- Objektkontext-Anreicherungen (Metadaten): Cloud Storage scannt Ihre Objekte asynchron und wertet infrage kommende Objekte mit den von Ihnen ausgewählten Modellen aus. Cloud Storage hängt die resultierenden Metadaten dann direkt als Objektkontexte an Ihre Objekte an.
Nachdem Cloud Storage die Anreicherungsmetadaten an Ihre Objekte angehängt hat, können Sie die Metadaten verwenden. Sie können einzelne Objektkontext-Anreicherungen prüfen oder Storage Insights-Datasets verwenden, um Metadaten für Millionen von Objekten mit SQL in BigQuery zu analysieren.
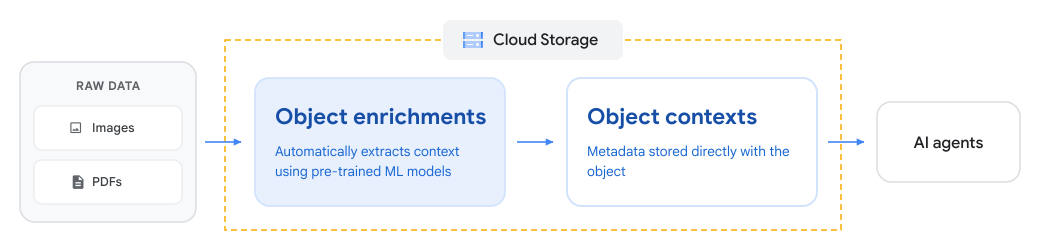
Das folgende Diagramm zeigt, wie Cloud Storage Objektkontext-Anreicherungen verwendet, um Kontext aus unstrukturierten Daten zu extrahieren und als Objektkontexte für nachgelagerte KI- und Analyse-Workflows zu speichern:
Unterstützte Modelle
Wenn Sie eine Funktionskonfiguration erstellen, wählen Sie die Modelle für maschinelles Lernen aus, die am besten zu Ihren Daten und Analysezielen passen. Cloud Storage wertet infrage kommende Objekte mit den von Ihnen ausgewählten Modellen aus und generiert strukturierte Metadaten unter contexts.custom.
In der Tabelle „Unterstützte Modelle“ sind die einzelnen Modelle, die erkannten Elemente und die Beispielausgabedaten aufgeführt. Detaillierte Schemadefinitionen und Kontextschlüssel finden Sie unter Unterstützte Modelle und Schemas.
| Modell | Beschreibung | Beispielausgabedaten |
|---|---|---|
| Objekterkennung | Erkennt mehrere Objekte in einem Bild und gibt ihre Positionen und rechteckigen Begrenzungen an. | Produkt, Tier, Person |
| Bild-Labeling | Erkennt und extrahiert Informationen zu Entitäten in einem Bild aus einer Vielzahl von Kategorien, z. B. Objekte, Orte und Aktivitäten. | Landschaft, Stadt, Nacht |
| Gesichtserkennung | Erkennt Gesichter in Bildern, einschließlich Begrenzungspolygone, Gesichtsmerkmale (Augen, Nase, Mund), Ausrichtungswinkel und Wahrscheinlichkeiten für Gesichtsausdrücke. | Anzahl der Gesichter, Roll- und Neigungswinkel |
| Erkennung von Inhalten mit anstößigem Inhalt | Bewertet Bilder auf sensible oder unangemessene Inhalte, einschließlich Material für Erwachsene oder gewaltverherrlichende Inhalte. | Wahrscheinlichkeitsbewertungen für Inhalte für Erwachsene und gewaltverherrlichende Inhalte |
| PDF-Klassifizierung | Klassifiziert PDF-Dokumente anhand ihres Inhalts in Standardkategorien für Unternehmen und Branchen. | Finanzen, Steuern, Rechnung (Kategorien und Bewertungen) |
Anwendungsfälle
Mit Objektkontext-Anreicherungen können Sie die Verwaltung unstrukturierter Daten optimieren und Objekte für die folgenden nachgelagerten Analyse- und KI-Workflows vorbereiten:
- Unstrukturierte Objekte organisieren und katalogisieren: Klassifizieren Sie automatisch Sammlungen von PDF-Dokumenten (z. B. Rechnungen, Kontoauszüge und Steuer formulare) und Bildern. Mit diesen Klassifizierungen können Sie durchsuchbare Data Catalogs für Ihre Buckets erstellen, ohne benutzerdefinierten Code schreiben zu müssen.
- KI-Agenten fundieren und Suche verbessern: Wandeln Sie unstrukturierte Dokument repositorys in strukturierte Wissensdatenbanken um. Sie können Dokumentkategorien und Bildlabels verwenden, um die Suche bei der Retrieval-Augmented Generation (RAG) zu verbessern und Ihre generativen KI-Anwendungen zu fundieren.
- Daten für generative KI auswählen und vorbereiten: Unterscheiden Sie zwischen Dokumenttypen, um eine geschichtete Stichprobenerhebung durchzuführen, bevor Sie Inhalte an große Sprachmodelle (Large Language Models, LLMs) oder zur manuellen Überprüfung weiterleiten.
- Datasets für das Training von Modellen für maschinelles Lernen kuratieren: Filtern und segmentieren Sie Bilder und Dokumente nach Taxonomie oder visuellen Labels, um domänenspezifische Trainingsdatasets für die Feinabstimmung von Modellen zusammenzustellen.
- Nach sensiblen oder anstößigen Inhalten suchen: Prüfen Sie automatisch hochgeladene Bilder auf unangemessene Inhalte, um Ihre Richtlinien zur Inhaltsmoderation und Sicherheit zu unterstützen.
- Multimodale Prompts verbessern: Übergeben Sie strukturierte Metadaten wie Begrenzungs rahmen und Dokumentkategorien als Kontext, wenn Sie multimodale Modelle wie Gemini verwenden.
- Datenarchitekturen vereinfachen: Eliminieren Sie benutzerdefinierte Aufnahmepipelines und Recheninfrastruktur, indem Sie Metadaten direkt in Cloud Storage generieren.
Metadaten abfragen und analysieren
Cloud Storage hängt Objektkontext-Anreicherungen direkt als Objektkontexte an Ihre Objekte an. Je nach Umfang und Workflow können Sie auf diese Metadaten auf folgende Weise zugreifen und sie analysieren:
- Einzelne Objekte prüfen: Verwenden Sie die Google Cloud Console oder die Cloud Storage APIs, um Anreicherungen für bestimmte Objekte zu prüfen. Eine Anleitung finden Sie unter Objektkontext-Anreicherungen verwalten.
- Im großen Maßstab mit SQL analysieren: Mit Storage Insights-Datasets können Sie
Metadaten für Millionen oder Milliarden von Objekten direkt nach
BigQuery exportieren. Nachdem Storage Insights die Metadaten exportiert hat, können Sie die
object_contexts_catalog_viewAnsicht mit Standard-SQL abfragen. Sie können beispielsweise nach Labels suchen, nach Kategorie filtern oder Objekte mit hohen Konfidenzwerten finden.
Informationen zu den ersten Schritten mit SQL-Abfragen und Beispielrezepten finden Sie unter Objektkontext-Anreicherungen in BigQuery analysieren.
Überlegungen und Einschränkungen
Bevor Sie Objektkontext-Anreicherungen konfigurieren, sollten Sie die folgenden betrieblichen Überlegungen berücksichtigen:
Verarbeitungsstandort
Objektkontext-Anreicherungen verarbeiten Daten an drei geografischen Standorten: us, eu und asia. Beachten Sie bei der Auswahl eines Verarbeitungsstandorts Folgendes:
- Compliance: Achten Sie darauf, dass der von Ihnen ausgewählte Verarbeitungsstandort Ihren Anforderungen an die Einhaltung von Vorschriften und die Datenhoheit entspricht.
- Leistung: Wählen Sie den Verarbeitungsstandort aus, der der Speicherregion Ihres Buckets am nächsten liegt.
- Kosten: Konfigurieren Sie nur einen Verarbeitungsstandort für jeden Bucket und jedes Modell, um doppelte Gebühren zu vermeiden. Wenn Sie mehrere Standorte für denselben Bucket und dasselbe Modell konfigurieren, verarbeitet Cloud Storage Ihre Objekte an jedem Standort und stellt Ihnen jede Ausführung in Rechnung.
Verarbeitung und Leistung
Beachten Sie die folgenden Einschränkungen für Inhaltstypen, Objektgrößen und Verarbeitungszeitpläne:
Asynchrone Verarbeitung: Cloud Storage verarbeitet Objekte asynchron.
Größenlimit für Objekte: Objekte (sowohl Bilder als auch PDFs) dürfen maximal 20 MiB groß oder kleiner sein.
Unterstützte Inhaltstypen: Cloud Storage verwendet das
Content-TypeMetadaten-Feld, das für ein Objekt festgelegt ist, um zu bestimmen, ob es ausgewertet werden soll. Wenn ein Objekt einen ungültigen oder fehlendenContent-Typehat, verarbeitet Cloud Storage das Objekt nicht, auch wenn die zugrunde liegenden Daten ein gültiges Bild oder eine gültige PDF-Datei sind. Damit Cloud Storage das Objekt verarbeitet, aktualisieren Sie dieContent-Type-Metadaten auf einen der folgenden unterstützten Typen:- Bilder: BMP, GIF, ICO, JPEG, PNG, TIFF und WEBP.
- Dokumente: PDF (
application/pdf).
Nicht unterstützte Funktionen
Objektkontext-Anreicherungen sind mit den folgenden Bucket-Typen und Vorgängen nicht kompatibel:
- Verschieben von Buckets: Objektkontext-Anreicherungen sind mit dem Verschieben von Buckets nicht kompatibel. Entfernen Sie den Bucket aus Ihren Funktionskonfigurationen, bevor Sie ihn verschieben.
- Nicht unterstützte Bucket-Typen: Sie können Objektkontext-Anreicherungen nicht für Rapid-Buckets oder Buckets aktivieren, für die der hierarchische Namespace aktiviert ist.
Konfigurations- und Bereichsverwaltung
Wenn Sie Ziel-Buckets in Ihren Funktionskonfigurationen definieren und verwalten, gelten die folgenden Anforderungen:
- Bucket-Bereich: Geben Sie in Ihrer Funktionskonfiguration genaue Bucket-Namen an. Cloud Storage unterstützt keine regulären Ausdrücke oder Platzhaltermuster.
- Bucket-Lebenszyklus: Cloud Storage fügt neu erstellte, neu erstellte oder verschobene Buckets nicht automatisch zu vorhandenen Konfigurationen hinzu. Sie müssen Ihre Funktionskonfiguration aktualisieren, um diese Buckets einzubeziehen.
Kosten und Sicherheit
Beachten Sie die folgenden betrieblichen Details zu Verschlüsselungsschlüsseln und Gebühren für den Datenzugriff:
- Vom Kunden bereitgestellte Schlüssel (Customer-Supplied Encryption Keys, CSEK): Objektkontext-Anreicherungen unterstützen keine Objekte, die mit vom Kunden bereitgestellten Verschlüsselungsschlüsseln verschlüsselt wurden.
- Speicherzugriff und Autoclass: Um Metadaten zu generieren, liest Objektkontext-Anreicherungen Ihre Objektdaten. Für diese Lesevorgänge fallen die Standardgebühren für den Datenzugriff an. Wenn für Ihren Bucket Autoclass aktiviert ist, lösen diese Lesevorgänge außerdem Übergänge der Speicherklasse aus.
Preise
Für die Verwendung von Objektkontext-Anreicherungen fallen Gebühren für die Modellinferenz, die Metadatenspeicherung, Datenzugriffsvorgänge und die Netzwerknutzung an. Weitere Informationen finden Sie unter Preise.
Überwachen und Fehler beheben
Mit den folgenden Ressourcen können Sie den Fortschritt der Metadatengenerierung verfolgen und Probleme bei der Konfiguration von Objektkontext-Anreicherungen beheben:
- Vorgänge überwachen: Informationen zum Verfolgen ausstehender Objekte, der Anzahl der Modellausführungen und des Verarbeitungsstatus in Cloud Monitoring finden Sie unter Messwerte für Objektkontext-Anreicherungen überwachen.
- Probleme beheben: Wenn Anreicherungen fehlen oder Berechtigungs fehler auftreten, finden Sie weitere Informationen unter Fehlerbehebung bei Objektkontext-Anreicherungen.
Nächste Schritte
- Objektkontext-Anreicherungen konfigurieren.
- Objektkontext-Anreicherungen in BigQuery analysieren.
- Objektkontext-Anreicherungen verwalten.
- Unterstützte Modelle und Schemas ansehen.
- Die JSON API-Ressource
featureConfigsansehen. - Informationen zu Objektkontexten.