


בדף הזה מוסבר איך לזהות שינויים במהירות ההרצה של שאילתות, לבדוק תוכניות הרצה של שאילתות ולציין אינדקס אחר לשאילתות עתידיות, אם צריך.
קבלת הפרופיל המפורט של שאילתה בפורמט JSON באמצעות ה-API בארכיטקטורת REST
כברירת מחדל, כשמריצים שאילתה, ה-API מחזיר רק את תוצאות ההצהרה.
הסיבה לכך היא שהמדיניות queryMode מוגדרת לערך NORMAL. כדי לכלול נתונים סטטיסטיים מפורטים של הביצוע בתוצאות השאילתה, מגדירים את queryMode ל-PROFILE.
יצירת סשן
לפני שמעדכנים את מצב השאילתה, יוצרים סשן שמייצג ערוץ תקשורת עם שירות מסד הנתונים של Spanner.
- נכנסים לדף
projects.instances.databases.sessions.create. מציינים את מזהה הפרויקט, מזהה המכונה ומזהה מסד הנתונים בפורמט הבא:
projects/PROJECT_ID/instances/INSTANCE_ID/databases/DATABASE_IDלוחצים על Execute. התשובה מציגה את הסשן שיצרתם בפורמט הבא:
projects/PROJECT_ID/instances/INSTANCE_ID/databases/DATABASE_ID/sessions/SESSION_IDהשתמשו בסשן הזה כדי ליצור פרופיל לשאילתה בשלב הבא. הסשן נשאר פעיל עד שעה בין שימושים עוקבים, לפני ש-Spanner מוחק אותו.
מידע נוסף על השימוש בסשנים זמין במאמר סשנים.
יצירת פרופיל לשאילתה
הפעלת מצב PROFILE לשאילתה.
- נכנסים לדף
projects.instances.databases.sessions.executeSql. בשדה session, מזינים את מזהה הסשן שיצרתם בשלב יצירת סשן:
projects/PROJECT_ID/instances/INSTANCE_ID/databases/DATABASE_ID/sessions/SESSION_IDבשדה Request body, משתמשים בערך הבא:
{ "sql": "SQL_QUERY", "queryMode": "PROFILE" }לוחצים על Execute. התשובה כוללת את תוצאות השאילתה, תוכנית לביצוע השאילתה ואת הנתונים הסטטיסטיים של ביצוע השאילתה.
פתרון בעיות בשימוש באינדקסים
כשמשתמשים בשאילתות SQL כדי לחפש נתונים, Spanner משתמש באופן אוטומטי באינדקסים משניים שיש סיכוי גבוה שיאחזרו את הנתונים בצורה יעילה יותר. עם זאת, במקרים מסוימים Spanner עשוי לבחור אינדקס שגורם לשאילתות להיות איטיות יותר. כתוצאה מכך, יכול להיות שחלק מהשאילתות ירוצו לאט מהצפוי.
זיהוי שינויים במהירות הביצוע של שאילתות
סביר להניח שתראו שינוי במהירות הביצוע של השאילתה אחרי שתבצעו את אחד מהשינויים הבאים:
- שינוי משמעותי של כמות גדולה של נתונים קיימים שיש להם אינדקס משני.
- הוספה, שינוי או הסרה של אינדקס משני.
אתם יכולים להשתמש בכמה כלים שונים כדי לזהות שאילתה ספציפית ש-Spanner מריץ לאט מהרגיל:
- תובנות לגבי שאילתות ונתונים סטטיסטיים של שאילתות.
מדדים ספציפיים לאפליקציה שאתם מתעדים ומנתחים באמצעות Cloud Monitoring. לדוגמה, אתם יכולים לעקוב אחרי המדד Count of queries כדי לראות את מספר השאילתות במכונה לאורך זמן, ולבדוק באיזו גרסה של הכלי לאופטימיזציה של שאילתות נעשה שימוש כדי להריץ שאילתה.
כלי מעקב בצד הלקוח שמודדים את ביצועי האפליקציה.
נתונים סטטיסטיים של Optimizer למסדי נתונים חדשים שנוצרו
כששולחים שאילתות למסדי נתונים חדשים שנוצרו עם נתונים שהוכנסו או יובאו לאחרונה, יכול להיות ש-Spanner לא יבחר את האינדקסים המתאימים ביותר, כי לכלי לאופטימיזציה של שאילתות נדרשים עד שלושה ימים כדי לאסוף נתונים סטטיסטיים באופן אוטומטי. כדי לייעל את השימוש באינדקס של מסד נתונים חדש ב-Spanner לפני כן, אפשר ליצור חבילת נתונים סטטיסטיים חדשה באופן ידני.
בדיקת הסכימה
אחרי שמוצאים את השאילתה שהאטה, בודקים את הצהרת ה-SQL של השאילתה ומזהים את הטבלאות שבהן ההצהרה משתמשת ואת העמודות שהיא מאחזרת מהטבלאות האלה.
לאחר מכן, מאתרים את האינדקסים המשניים שקיימים בטבלאות האלה. בודקים אם אחד מהאינדקסים כולל את העמודות שאתם שולחים אליהן שאילתות. אם כן, Spanner יכול להשתמש באחד מהאינדקסים כדי לעבד את השאילתה.
- אם יש אינדקסים רלוונטיים, השלב הבא הוא למצוא את האינדקס שבו Spanner השתמש בשאילתה.
אם אין אינדקסים רלוונטיים, משתמשים בפקודה
gcloud spanner operations
list
כדי לבדוק אם לאחרונה הסרתם אינדקס רלוונטי:gcloud spanner operations list \ --instance=INSTANCE \ --database=DATABASE \ --filter="@TYPE:UpdateDatabaseDdlMetadata"אם הסרתם אינדקס רלוונטי, יכול להיות שהשינוי הזה השפיע על ביצועי השאילתה. מוסיפים את האינדקס המשני בחזרה לטבלה. אחרי ש-Spanner מוסיף את האינדקס, מריצים שוב את השאילתה ובודקים את הביצועים שלה. אם הביצועים לא משתפרים, השלב הבא הוא למצוא את האינדקס שבו Spanner השתמש בשאילתה.
אם לא הסרתם אינדקס רלוונטי, בחירת האינדקס לא גרמה לנסיגה בביצועי השאילתה. חפשו שינויים אחרים בנתונים או בדפוסי השימוש שעשויים להשפיע על הביצועים.
איך למצוא את האינדקס ששימש לשאילתה
כדי לברר באיזה אינדקס Spanner משתמש כדי לעבד שאילתה, אפשר להציג את תוכנית הביצוע של השאילתה במסוף Google Cloud :
נכנסים לדף Instances של Spanner במסוףGoogle Cloud .
לוחצים על שם המכונה שרוצים לשלוח אליה שאילתה.
בתפריט הניווט, בוחרים את מסד הנתונים שרוצים לשלוח אליו שאילתה ולוחצים על Spanner Studio.
מזינים את השאילתה שרוצים לבדוק.
בתפריט Run query, בוחרים באפשרות Explanation only. Spanner מציג את התוכנית לביצוע השאילתה.
מחפשים לפחות אחד מהאופרטורים הבאים בתוכנית לביצוע השאילתה:
- סריקת טבלה
- סריקת אינדקס
- Cross apply או distributed cross apply
בקטעים הבאים מוסברת המשמעות של כל אופרטור.
אופרטור סריקת טבלה
האופרטור table scan מציין ש-Spanner לא השתמש באינדקס משני:
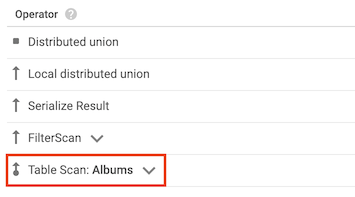
לדוגמה, נניח שבטבלה Albums אין אינדקסים משניים, ואתם מריצים את השאילתה הבאה:
SELECT AlbumTitle FROM Albums WHERE STARTS_WITH(AlbumTitle, "Now");
מכיוון שאין אינדקסים לשימוש, התוכנית לביצוע השאילתה כוללת אופרטור לסריקת טבלה.
אופרטור סריקת אינדקס
האופרטור index scan מציין ש-Spanner השתמש באינדקס משני כשהוא עיבד את השאילתה:
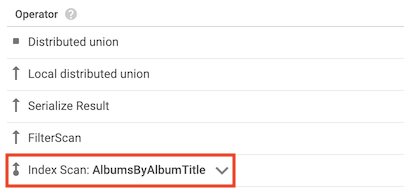
לדוגמה, נניח שמוסיפים אינדקס לטבלה Albums:
CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
ואז מריצים את השאילתה הבאה:
SELECT AlbumTitle FROM Albums WHERE STARTS_WITH(AlbumTitle, "Now");
האינדקס AlbumsByAlbumTitle מכיל את AlbumTitle, שהיא העמודה היחידה שהשאילתה בוחרת. כתוצאה מכך, התוכנית לביצוע השאילתה כוללת אופרטור של סריקת אינדקס.
אופרטור של החלה צולבת
במקרים מסוימים, Spanner משתמש באינדקס שמכיל רק חלק מהעמודות שהשאילתה בוחרת. כתוצאה מכך, Spanner צריך לצרף את האינדקס למסד הנתונים הטבלאי.
כשמתרחש איחוד מהסוג הזה, התוכנית לביצוע השאילתה כוללת אופרטור cross apply או distributed cross apply עם הקלטים הבאים:
- אופרטור סריקת אינדקס של אינדקס בטבלה
- אופרטור סריקת טבלה לטבלה שבבעלותה האינדקס
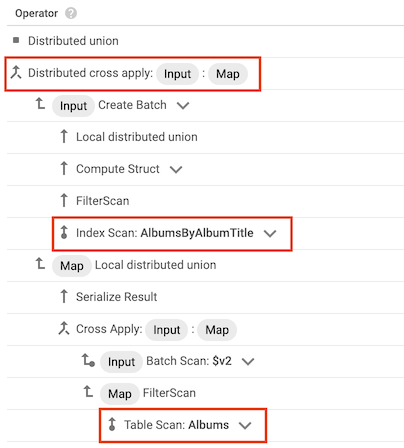
לדוגמה, נניח שמוסיפים אינדקס לטבלה Albums:
CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
ואז מריצים את השאילתה הבאה:
SELECT * FROM Albums WHERE STARTS_WITH(AlbumTitle, "Now");
האינדקס AlbumsByAlbumTitle מכיל את AlbumTitle, אבל השאילתה בוחרת את כל העמודות בטבלה, ולא רק את AlbumTitle. כתוצאה מכך, התוכנית לביצוע השאילתה כוללת אופרטור מבוזר של החלה צולבת, עם סריקת אינדקס של AlbumsByAlbumTitle וסריקת טבלה של Albums כקלט.
בחירת אינדקס אחר
אחרי שמוצאים את האינדקס שבו Spanner השתמש בשאילתה, מנסים להריץ את השאילתה עם אינדקס אחר, או על ידי סריקה של מסד הנתונים הטבלאי במקום להשתמש באינדקס. כדי לציין את האינדקס, מוסיפים לשאילתה את ההוראה FORCE_INDEX.
אם מצאתם גרסה מהירה יותר של השאילתה, עדכנו את האפליקציה כך שתשתמש בגרסה המהירה יותר.
הנחיות לבחירת אינדקס
כדי להחליט איזה אינדקס לבדוק עבור השאילתה, אפשר להשתמש בהנחיות הבאות:
אם השאילתה עומדת באחד מהקריטריונים האלה, נסו להשתמש במסד הנתונים הטבלאי במקום באינדקס משני:
- השאילתה בודקת שוויון עם תחילית של המפתח הראשי של מסד הנתונים הטבלאי (לדוגמה,
SELECT * FROM Albums WHERE SingerId =
1
). - מספר גדול של שורות עומד בתנאי הפרדיקטים של השאילתה (לדוגמה,
SELECT * FROM Albums WHERE AlbumTitle != "There Is No Album With This
Title"
). - השאילתה משתמשת במסד נתונים טבלאי שמכיל רק כמה מאות שורות.
- השאילתה בודקת שוויון עם תחילית של המפתח הראשי של מסד הנתונים הטבלאי (לדוגמה,
אם השאילתה מכילה פרדיקט סלקטיבי מאוד (לדוגמה,
REGEXP_CONTAINS,STARTS_WITH,<,<=,>,>=או!=), נסו להשתמש באינדקס שכולל את אותן עמודות שבהן אתם משתמשים בפרדיקט.
בדיקת השאילתה המעודכנת
משתמשים במסוף Google Cloud כדי לבדוק את השאילתה המעודכנת ולראות כמה זמן לוקח לעבד אותה.
אם השאילתה כוללת פרמטרים של שאילתה, ופרמטר שאילתה מסוים מקושר לערכים מסוימים בתדירות גבוהה יותר מאשר לאחרים, קשרו את פרמטר השאילתה לאחד מהערכים האלה בבדיקות. לדוגמה, אם השאילתה כוללת פרדיקט כמו WHERE country = @countryId, וכמעט כל השאילתות מקשרות את @countryId לערך US, קשרו את @countryId ל-US בבדיקות הביצועים. הגישה הזו עוזרת לבצע אופטימיזציה לשאילתות שאתם מריצים בתדירות הגבוהה ביותר.
כדי לבדוק את השאילתה המעודכנת במסוף Google Cloud , פועלים לפי השלבים הבאים:
נכנסים לדף Instances של Spanner במסוףGoogle Cloud .
לוחצים על שם המכונה שרוצים לשלוח אליה שאילתה.
בתפריט הניווט, לוחצים על מסד הנתונים שרוצים לשלוח אליו שאילתה ואז על Spanner Studio.
מזינים את השאילתה שרוצים לבדוק, כולל ההוראה
FORCE_INDEX, ולוחצים על Run query.במסוף Google Cloud נפתחת הכרטיסייה Results table ומוצגות תוצאות השאילתה, כולל משך הזמן שלקח לשירות Spanner לעבד את השאילתה.
המדד הזה לא כולל מקורות אחרים של זמן אחזור, כמו הזמן שלקח למסוף Google Cloud לפרש ולהציג את תוצאות השאילתה.
ויסות נתונים (throttle) של שאילתות
במהלך הרצת השאילתה, Spanner יכול לווסת את השאילתות בכמה מקומות.
זמן ההמתנה של הלקוח והעיכוב בתור של השרת הם שני המדדים העיקריים של ויסות הנתונים.
זמן ההמתנה של הלקוח
זמן ההמתנה של הלקוח מייצג את משך הזמן שלקוח Spanner ממתין עד שהאפליקציה תצרוך את התוצאות. זה מצביע על כך שהלקוח לא יכול לעבד את התוצאות באותה מהירות שבה Spanner מייצר אותן. כדי לפתור את הבעיה, צריך לשפר את הביצועים של האפליקציה שצורכת את הנתונים, או לשמור את כל התוצאות במאגר נתונים זמני באפליקציית הלקוח ולעבד אותן אחרי שהשאילתה מסתיימת.
עיכוב בתור של השרת
עיכוב בתור של השרת מתרחש כששרת העיבוד מעכב את תזמון הרצת השאילתה. בחלונית Query summary, בודקים את המדד Server queue delay. אם המדד לא מופיע, לא היה עיכוב בשרת.
העיכוב הזה יכול להצביע על כך שהשרתים שמריצים את השאילתה עמוסים. כדי לבדוק אם יש נקודה חמה, עיינו בקטע איתור נקודות חמות במסד הנתונים. כדי לפתור בעיות בנקודות חמות, עיינו במאמר פתרון בעיות בנקודות חמות באמצעות נתונים סטטיסטיים של פיצולים חמים.
נתונים שהשתנו לאחרונה
שינויים בנתוני הטבלה יכולים להשפיע על ביצועי השאילתה.
חבילת נתונים סטטיסטיים לא עדכנית
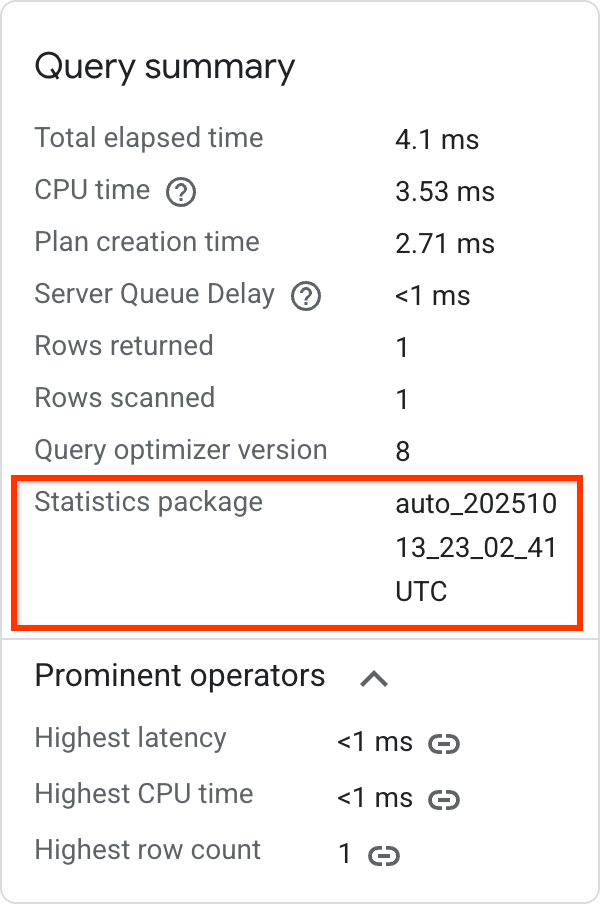
אם כלי האופטימיזציה משתמש בחבילת נתונים סטטיסטיים מיושנת, יכול להיות שהוא יבחר בתוכנית לא אופטימלית. בקטע Query summary אתם יכולים לבדוק את חבילת הנתונים הסטטיסטיים.
אם החבילה ישנה או חסרה, מריצים את הפקודה ANALYZE כדי לוודא שהנתונים הסטטיסטיים של הכלי לאופטימיזציה מעודכנים.
מידע נוסף זמין במאמר חבילות סטטיסטיקה.
שינויים בתוכן של הטבלה
ביצועי השאילתה תלויים בנתונים שהשאילתה מעבדת. הדרך הכי טובה לטפל בבעיה בביצועי השאילתה תלויה באופן שבו הנתונים השתנו:
- הטיה בהתפלגות הערכים: חבילת הנתונים הסטטיסטיים מתעדת את ההטיה הזו, אבל הכלי לאופטימיזציה של שאילתות יכול להשתמש במידע הזה רק כשמשתמשים בערכים מילוליים בשאילתה.
- שינוי משמעותי במספר השורות: בודקים אם הפרדיקטים מסננים את השורות בצורה מספקת ככל שהטבלה גדלה.
- הטיה בגודל הערך: הטיה בגודל הערכים היא בעייתית בשילוב עם פרדיקטים סקלריים יקרים (לדוגמה, ביצוע פרדיקט
LIKEעל ערךSTRINGשמכיל מחרוזות גדולות).
כדי לקבל תובנות נוספות על ביצוע השאילתה, אפשר להשתמש ב-API בארכיטקטורת REST.