


במסד נתונים של Spanner, המערכת יוצרת באופן אוטומטי אינדקס לכל מפתח ראשי של טבלה. לדוגמה, לא צריך לעשות שום דבר כדי להוסיף לאינדקס את המפתח הראשי של Singers, כי הוא מתווסף לאינדקס באופן אוטומטי.
אפשר גם ליצור אינדקסים משניים לעמודות אחרות. הוספת אינדקס משני בעמודה מייעלת את חיפוש הנתונים בעמודה הזו. לדוגמה, אם אתם צריכים לחפש במהירות אלבום לפי שם, כדאי ליצור אינדקס משני ב-AlbumTitle, כדי ש-Spanner לא יצטרך לסרוק את כל הטבלה.
אם החיפוש בדוגמה הקודמת מתבצע בטרנזקציית קריאה-כתיבה, החיפוש היעיל יותר גם מונע נעילות של הטבלה כולה, ומאפשר הוספות ועדכונים בו-זמניים לטבלה בשורות מחוץ לטווח החיפוש של AlbumTitle.
בנוסף ליתרונות שהם מביאים לחיפושים, אינדקסים משניים יכולים גם לעזור ל-Spanner לבצע סריקות בצורה יעילה יותר, ולאפשר סריקות של אינדקסים במקום סריקות של טבלאות מלאות.
בכל אינדקס משני, Spanner מאחסן את הנתונים הבאים:
- כל עמודות המפתח ממסד הנתונים הטבלאי
- כל העמודות שנכללות באינדקס
- כל העמודות שצוינו בסעיף האופציונלי
STORING(מסדי נתונים בניב GoogleSQL) או בסעיףINCLUDE(מסדי נתונים בניב PostgreSQL) של הגדרת האינדקס.
עם הזמן, Spanner מנתח את הטבלאות כדי לוודא שהאינדקסים המשניים משמשים לשאילתות המתאימות.
הוספת אינדקס משני
הזמן הכי יעיל להוסיף אינדקס משני הוא כשיוצרים את הטבלה. כדי ליצור טבלה ואת האינדקסים שלה בו-זמנית, שולחים ל-Spanner את הצהרות ה-DDL של הטבלה החדשה ושל האינדקסים החדשים בבקשה אחת.
ב-Spanner, אפשר גם להוסיף אינדקס משני חדש לטבלה קיימת בזמן שמסד הנתונים ממשיך לשרת את התנועה. כמו כל שינוי אחר בסכימה ב-Spanner, הוספת אינדקס למסד נתונים קיים לא דורשת להעביר את מסד הנתונים למצב אופליין, ולא נועלת עמודות או טבלאות שלמות.
בכל פעם שמוסיפים אינדקס חדש לטבלה קיימת, Spanner ממלא את האינדקס באופן אוטומטי כדי לשקף תצוגה עדכנית של הנתונים שנוסף להם אינדקס. Spanner מנהל את תהליך המילוי הזה בשבילכם, והתהליך פועל ברקע באמצעות משאבי צומת בעדיפות נמוכה. מהירות המילוי החוזר של האינדקס מותאמת למשאבי הצומת המשתנים במהלך יצירת האינדקס, והמילוי החוזר לא משפיע באופן משמעותי על הביצועים של מסד הנתונים.
יצירת אינדקס יכולה להימשך בין כמה דקות לכמה שעות. יצירת אינדקס היא עדכון סכימה, ולכן היא כפופה לאותן מגבלות ביצועים כמו כל עדכון סכימה אחר. הזמן שנדרש ליצירת אינדקס משני תלוי בכמה גורמים:
- גודל מערך הנתונים
- קיבולת המחשוב של המכונה
- העומס על המכונה
כדי לראות את ההתקדמות של תהליך מילוי החוסרים באינדקס, עיינו בקטע ההתקדמות.
חשוב לזכור שאם משתמשים בעמודה commit timestamp כחלק הראשון של האינדקס המשני, יכולות להיווצר נקודות חמות וביצועי הכתיבה עלולים להיפגע.
משתמשים בהצהרה CREATE INDEX כדי להגדיר אינדקס משני בסכימה. הנה כמה דוגמאות:
כדי להוסיף לאינדקס את כל Singers במסד הנתונים לפי השם הפרטי ושם המשפחה שלהם:
GoogleSQL
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
PostgreSQL
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
כדי ליצור אינדקס של כל Songs במסד הנתונים לפי הערך של SongName:
GoogleSQL
CREATE INDEX SongsBySongName ON Songs(SongName);
PostgreSQL
CREATE INDEX SongsBySongName ON Songs(SongName);
כדי להוסיף לאינדקס רק את השירים של זמר מסוים, משתמשים במשפט INTERLEAVE IN כדי להוסיף את האינדקס לטבלה Singers:
GoogleSQL
CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName),
    INTERLEAVE IN Singers;
PostgreSQL
CREATE INDEX SongsBySingerSongName ON Songs(SingerId, SongName)
    INTERLEAVE IN Singers;
כדי להוסיף לאינדקס רק את השירים באלבום מסוים:
GoogleSQL
CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;
PostgreSQL
CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName)
    INTERLEAVE IN Albums;
כדי להוסיף לאינדקס בסדר יורד של SongName:
GoogleSQL
CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC),
    INTERLEAVE IN Albums;
PostgreSQL
CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC)
    INTERLEAVE IN Albums;
שימו לב שההערה הקודמת של DESC רלוונטית רק ל-SongName. כדי להוסיף לאינדקס בסדר יורד של מפתחות אינדקס אחרים, צריך להוסיף גם להם הערות באמצעות DESC: SingerId DESC, AlbumId DESC.
חשוב גם לזכור שהמילה PRIMARY_KEY שמורה ואי אפשר להשתמש בה כשם של אינדקס. זה השם שניתן לאינדקס המדומה שנוצר כשיוצרים טבלה עם מפרט מפתח ראשי.
לפרטים נוספים ולשיטות מומלצות לבחירת אינדקסים משולבים ולא משולבים, ראו בחירה בין אינדקסים משולבים וגלובליים, אפשרויות אינדקס ושימוש באינדקס משולב בעמודה שהערך שלה עולה או יורד באופן מונוטוני.
אינדקסים ו-Interleaving
אפשר לשלב אינדקסים של Spanner עם טבלאות אחרות כדי למקם שורות אינדקס יחד עם שורות של טבלה אחרת. בדומה לטבלאות משולבות ב-Spanner, עמודות המפתח הראשי של ההורה של האינדקס חייבות להיות קידומת של העמודות שנוסף להן אינדקס, והן צריכות להתאים לסוג ולסדר המיון. בניגוד לטבלאות משולבות, אין צורך בהתאמה של שמות העמודות. כל שורה באינדקס משולב מאוחסנת פיזית יחד עם שורת ההורה המשויכת.
לדוגמה, נבחן את הסכימה הבאה:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo PROTO<Singer>(MAX)
) PRIMARY KEY (SingerId);

CREATE TABLE Albums (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  AlbumTitle   STRING(MAX),
  PublisherId  INT64 NOT NULL
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE TABLE Songs (
  SingerId     INT64 NOT NULL,
  AlbumId      INT64 NOT NULL,
  TrackId      INT64 NOT NULL,
  PublisherId  INT64 NOT NULL,
  SongName     STRING(MAX)
) PRIMARY KEY (SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE TABLE Publishers (
  Id            INT64 NOT NULL,
  PublisherName STRING(MAX)
) PRIMARY KEY (Id);
כדי להוסיף לאינדקס את כל ה-Singers במסד הנתונים לפי השם הפרטי ושם המשפחה שלהם, צריך ליצור אינדקס. כך מגדירים את האינדקס SingersByFirstLastName:
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
כדי ליצור אינדקס של Songs ב-(SingerId, AlbumId, SongName), אפשר לבצע את הפעולות הבאות:
CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName);
אפשר גם ליצור אינדקס שמשולב עם ישות אב של Songs, כמו בדוגמה הבאה:
CREATE INDEX SongsBySingerAlbumSongName
    ON Songs(SingerId, AlbumId, SongName),
    INTERLEAVE IN Albums;
בנוסף, אפשר ליצור אינדקס של Songs ב-(PublisherId, SingerId, AlbumId, SongName) שמשולב עם טבלה שהיא לא ישות אב של Songs, כמו Publishers. שימו לב שהמפתח הראשי של הטבלה Publishers (id) הוא לא קידומת של העמודות שנוספו לאינדקס בדוגמה הבאה. זה עדיין מותר כי ל-Publishers.Id ול-Songs.PublisherId יש את אותו סוג, סדר מיון וערך null.
CREATE INDEX SongsByPublisherSingerAlbumSongName
    ON Songs(PublisherId, SingerId, AlbumId, SongName),
    INTERLEAVE IN Publishers;
בחירה בין אינדקסים משולבים לגלובליים
כשיוצרים אינדקס משני ב-Spanner, מגדירים אותו כאינדקס גלובלי (אינדקס ברירת המחדל, לא משולב) או כאינדקס משולב. בחירת סוג האינדקס האופטימלי היא קריטית לביצועי הקריאה והכתיבה.
השוואת אינדקסים
| תכונה | אינדקס משולב | מדד גלובלי |
|---|---|---|
| מיקום האחסון | ממוקמת באותו פיצול (עץ שורות) כמו שורת ההורה. | מאוחסנים בטבלת שורש נפרדת, שאפשר לפצל בלי קשר למסד הנתונים הטבלאי. |
| הדרישות העיקריות | המפתח הראשי של טבלת ההורה חייב להיות קידומת של מפתחות האינדקס. | אין הגבלות על מפתחות האינדקס. |
| תקורה של כתיבה | נמוכה. כשמשלבים טבלה בטבלת אב של מסד הנתונים הטבלאי, העדכונים בדרך כלל מקומיים לפיצול, וכך נמנעים מאישורי עסקה בשני שלבים בין פיצולים. אם משלבים בטבלה שהיא לא אב קדמון, התקורה של הכתיבה גבוהה יותר כי יכול להיות שהעדכונים ידרשו טרנזקציות מבוזרות. | גבוה יותר. עדכונים מתפרסים לעיתים קרובות על פני פיצולים שונים, ולכן נדרשות טרנזקציות מבוזרות. |
| מתאים במיוחד בשביל | שאילתות שמוגבלות לישות אם אחת – לדוגמה, "חיפוש תמונות של המשתמש USER_NAME". | שאילתות שמחפשות בכל מסד הנתונים, למשל "חיפוש משתמש לפי אימייל". |
למה בדרך כלל עדיף להשתמש באינדקסים משולבים
במסד נתונים מבוזר כמו Spanner, אחסון ועיבוד נתונים באופן מקומי הם המפתח לביצועים. בדרך כלל עדיף להשתמש באינדקסים משולבים כי הם שומרים על אחסון ועיבוד נתונים באופן מקומי:
- קריאות יעילות: אם השאילתות תמיד מסננות לפי מזהה של ישות אם, אינדקס משולב מאפשר ל-Spanner לענות על השאילתה על ידי סריקה של הפיצול שמכיל את ישות האם, במקום להתייעץ עם כמה פיצולים.
- כתיבה יעילה: כשמעדכנים שורה בטבלה, Spanner צריך לעדכן גם את האינדקסים המשניים שלה. אם משתמשים באינדקס גלובלי, סביר להניח שרשומת האינדקס נמצאת בפיצול שונה מהשורה הבסיסית. כך Spanner נאלץ לבצע טרנזקציה מבוזרת (אישור בשני שלבים) בין פיצולים, מה שמגדיל את זמן האחזור ואת השימוש ב-CPU. אם אינדקס משולב משולב באב קדמון של מסד הנתונים הטבלאי, הרשומה באינדקס מאוחסנת באותו פיצול כמו השורה במסד הנתונים הטבלאי, כך שהכתיבה היא פעולה מקומית.
מדריך לקבלת החלטות
כדי לבחור את סוג האינדקס האופטימלי לתרחיש לדוגמה, השתמשו בהנחיות הבאות:
מתי כדאי להשתמש באינדקס משולב
מומלץ להשתמש באינדקס משולב אם מתקיים לפחות אחד מהתנאים הבאים:
- השאילתות תמיד כוללות מסנן במפתח הראשי של טבלת ההורה, לדוגמה
WHERE UserId = @userId AND .... - באופן טבעי, אפשר להשתמש בעמודות המפתח הראשי של טבלת ההורה כקידומת למפתחות האינדקס.
- אתם רוצים לצמצם את זמן האחזור של הכתיבה ואת התקורה של המעבד (CPU) בתחזוקת האינדקס.
לדוגמה:
-- Indexing albums by title for a specific singer
CREATE INDEX AlbumsBySingerTitle ON Albums(SingerId, AlbumTitle),
  INTERLEAVE IN Singers;
מתי כדאי להשתמש באינדקס גלובלי
כדאי להשתמש באינדקס גלובלי אם מתקיים לפחות אחד מהתנאים הבאים:
- אתם צריכים לשלוח שאילתות על נתונים בכל מסד הנתונים בלי לסנן לפי ישות אם – לדוגמה, חיפוש גלובלי.
- העמודות שרוצים להוסיף לאינדקס לא חולקות קידומת עם טבלת הורה כלשהי.
לדוגמה:
-- Indexing all albums globally by title. For example, for a global search catalog.
CREATE INDEX AlbumsByTitle ON Albums(AlbumTitle);
בדיקת ההתקדמות של מילוי האינדקס
המסוף
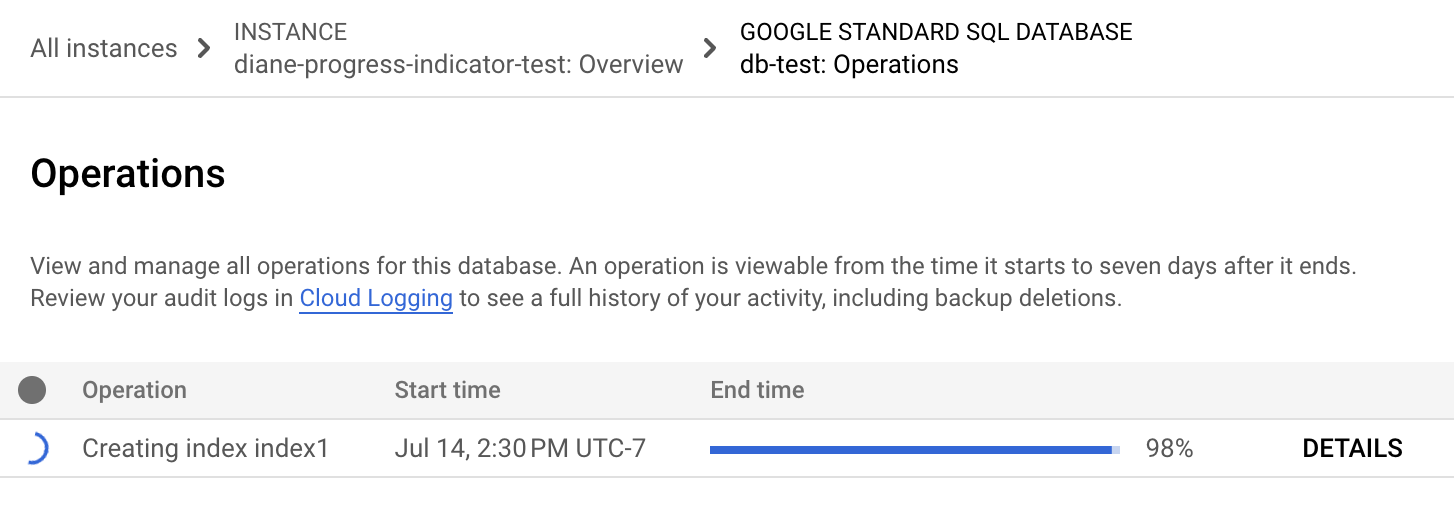
בתפריט הניווט של Spanner, לוחצים על הכרטיסייה Operations. בדף Operations מוצגת רשימה של הפעולות שפועלות.
מוצאים את פעולת המילוי החוזר ברשימה. אם היא עדיין פועלת, מחוון ההתקדמות בעמודה End time מציג את אחוז הפעולה שהושלמה, כפי שמוצג בתמונה הבאה:
gcloud
כדי לבדוק את התקדמות הפעולה, משתמשים ב-gcloud spanner operations describe.
משיגים את מזהה הפעולה:
gcloud spanner operations list --instance=INSTANCE-NAME \
--database=DATABASE-NAME --type=DATABASE_UPDATE_DDL
מחליפים את מה שכתוב בשדות הבאים:
- INSTANCE-NAME בשם של מכונת Spanner.
- DATABASE-NAME בשם של מסד הנתונים.
הערות לגבי השימוש:
כדי להגביל את הרשימה, מציינים את הדגל
--filter. לדוגמה:- הפקודה
--filter="metadata.name:example-db"מציגה רק את הפעולות במסד נתונים ספציפי. - השדה
--filter="error:*"מפרט רק את פעולות הגיבוי שנכשלו.
למידע על תחביר המסנן, ראו מסנני נושאים של gcloud. למידע על סינון פעולות גיבוי, ראו את השדה
filterב-ListBackupOperationsRequest.- הפקודה
הדגל
--typeלא תלוי אותיות רישיות.
הפלט אמור להיראות כך:
OPERATION_ID     STATEMENTS                                                                                          DONE   @TYPE
_auto_op_123456  CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)                                 False  UpdateDatabaseDdlMetadata
                CREATE INDEX SongsBySingerAlbumSongName ON Songs(SingerId, AlbumId, SongName), INTERLEAVE IN Albums
_auto_op_234567                                                                                                      True   CreateDatabaseMetadata
מריצים את
gcloud spanner operations describe:gcloud spanner operations describe \ --instance=INSTANCE-NAME \ --database=DATABASE-NAME \ projects/PROJECT-NAME/instances/INSTANCE-NAME/databases/DATABASE-NAME/operations/OPERATION_ID
מחליפים את מה שכתוב בשדות הבאים:
- INSTANCE-NAME: השם של מכונת Spanner.
- DATABASE-NAME: השם של מסד הנתונים ב-Spanner.
- PROJECT-NAME: שם הפרויקט.
- OPERATION-ID: מזהה הפעולה שרוצים לבדוק.
בקטע
progressבפלט מוצג אחוז ההשלמה של הפעולה. הפלט אמור להיראות כך:done: true ... progress: - endTime: '2021-01-22T21:58:42.912540Z' progressPercent: 100 startTime: '2021-01-22T21:58:11.053996Z' - progressPercent: 67 startTime: '2021-01-22T21:58:11.053996Z' ...
REST v1
משיגים את מזהה הפעולה:
  gcloud spanner operations list --instance=INSTANCE-NAME

  --database=DATABASE-NAME --type=DATABASE_UPDATE_DDL
מחליפים את מה שכתוב בשדות הבאים:
- INSTANCE-NAME בשם של מכונת Spanner.
- DATABASE-NAME בשם של מסד הנתונים.
לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הנתונים הבאים:
- PROJECT-ID: מזהה הפרויקט.
- INSTANCE-ID: מזהה המכונה.
- DATABASE-ID: מזהה מסד הנתונים.
- OPERATION-ID: מזהה הפעולה.
ה-method של ה-HTTP וכתובת ה-URL:
GET https://spanner.googleapis.com/v1/projects/PROJECT-ID/instances/INSTANCE-ID/databases/DATABASE-ID/operations/OPERATION-ID
כדי לשלוח את הבקשה צריך להרחיב אחת מהאפשרויות הבאות:
אתם אמורים לקבל תגובת JSON שדומה לזו:
{
...
    "progress": [
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:27.366688Z",
        "endTime": "2023-05-27T00:52:30.184845Z"
      },
      {
        "progressPercent": 100,
        "startTime": "2023-05-27T00:52:30.184845Z",
        "endTime": "2023-05-27T00:52:40.750959Z"
      }
    ],
...
  "done": true,
  "response": {
    "@type": "type.googleapis.com/google.protobuf.Empty"
  }
}
ב-gcloud וב-REST, אפשר לראות את ההתקדמות של כל הצהרת מילוי חוסרים באינדקס בקטע progress. לכל הצהרה במערך ההצהרות יש שדה תואם במערך ההתקדמות. הסדר של מערך ההתקדמות הזה תואם לסדר של מערך ההצהרות. כשהם זמינים, השדות startTime, progressPercent ו-endTime מאוכלסים בהתאם.
שימו לב שהפלט לא מציג זמן משוער לסיום תהליך המילוי החוזר.
אם הפעולה נמשכת יותר מדי זמן, אתם יכולים לבטל אותה. מידע נוסף זמין במאמר ביטול יצירת אינדקס.
תרחישים שבהם אפשר לראות את התקדמות המילוי החוזר של האינדקס
יש כמה תרחישים שונים שבהם אתם יכולים להיתקל כשאתם מנסים לבדוק את ההתקדמות של מילוי חוסרים באינדקס. הצהרות ליצירת אינדקסים שדורשות מילוי חוסרים באינדקס הן חלק מפעולות של עדכון סכימה, ויכולות להיות כמה הצהרות שהן חלק מפעולה של עדכון סכימה.
התרחיש הראשון הוא הפשוט ביותר, שבו הצהרת יצירת האינדקס היא ההצהרה הראשונה בפעולת עדכון הסכימה. ההצהרה ליצירת אינדקס היא ההצהרה הראשונה, ולכן היא הראשונה שעוברת עיבוד וביצוע בגלל סדר הביצוע.
השדה startTime של הצהרת יצירת האינדקס יתמלא מיד בשעת ההתחלה של פעולת עדכון הסכימה. לאחר מכן, השדה progressPercent של הצהרת יצירת האינדקס מאוכלס כשההתקדמות של מילוי האינדקס היא מעל 0%. לבסוף, השדה endTime מאוכלס אחרי שההצהרה נשלחת.
התרחיש השני הוא כשההצהרה ליצירת אינדקס היא לא ההצהרה הראשונה בפעולת העדכון של הסכימה. בגלל סדר הביצוע, שדות שקשורים להצהרה על יצירת אינדקס לא יתמלאו עד שההצהרות הקודמות יבוצעו.
בדומה לתרחיש הקודם, אחרי שההצהרות הקודמות בוצעו, השדה startTime של הצהרת יצירת האינדקס מאוכלס קודם, ואחריו השדה progressPercent. לבסוף, השדה endTime מאוכלס אחרי שההצהרה מסתיימת.
ביטול יצירת האינדקס
אפשר להשתמש ב-Google Cloud CLI כדי לבטל את יצירת האינדקס. כדי לאחזר רשימה של פעולות לעדכון סכימה במסד נתונים של Spanner, משתמשים בפקודה gcloud spanner operations list וכוללים את האפשרות --filter:
gcloud spanner operations list \
    --instance=INSTANCE \
    --database=DATABASE \
    --filter="@TYPE:UpdateDatabaseDdlMetadata"
מוצאים את הערך של OPERATION_ID לפעולה שרוצים לבטל, ואז משתמשים בפקודה gcloud spanner operations cancel כדי לבטל אותה:
gcloud spanner operations cancel OPERATION_ID \
    --instance=INSTANCE \
    --database=DATABASE
הצגת אינדקסים קיימים
כדי לראות מידע על אינדקסים קיימים במסד נתונים, אתם יכולים להשתמש במסוףGoogle Cloud או ב-Google Cloud CLI:
המסוף
נכנסים לדף Instances של Spanner במסוף Google Cloud .
לוחצים על השם של המכונה שרוצים לראות.
בחלונית הימנית, לוחצים על מסד הנתונים שרוצים להציג ואז על הטבלה שרוצים להציג.
לוחצים על הכרטיסייה Indexes. במסוף Google Cloud מוצגת רשימה של אינדקסים.
אופציונלי: כדי לקבל פרטים על אינדקס, כמו העמודות שהוא כולל, לוחצים על שם האינדקס.
gcloud
משתמשים בפקודה gcloud spanner databases ddl describe:
    gcloud spanner databases ddl describe DATABASE \
        --instance=INSTANCE
ה-CLI של gcloud מדפיס את הצהרות שפת הגדרת הנתונים (DDL) כדי ליצור את הטבלאות והאינדקסים של מסד הנתונים. ההצהרות CREATE
INDEX מתארות את האינדקסים הקיימים. לדוגמה:
--- |-
CREATE TABLE Singers (
SingerId INT64 NOT NULL,
FirstName STRING(1024),
LastName STRING(1024),
SingerInfo BYTES(MAX),
) PRIMARY KEY(SingerId)
---
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName)
שאילתה עם אינדקס ספציפי
בקטעים הבאים מוסבר איך לציין אינדקס בהצהרת SQL ובממשק הקריאה של Spanner. בדוגמאות שבקטעים האלה, אנחנו מניחים שהוספתם עמודה בשם MarketingBudget לטבלה Albums ויצרתם אינדקס בשם AlbumsByAlbumTitle:
GoogleSQL
CREATE TABLE Albums (
  SingerId         INT64 NOT NULL,
  AlbumId          INT64 NOT NULL,
  AlbumTitle       STRING(MAX),
  MarketingBudget  INT64,
) PRIMARY KEY (SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
PostgreSQL
CREATE TABLE Albums (
  SingerId         BIGINT NOT NULL,
  AlbumId          BIGINT NOT NULL,
  AlbumTitle       VARCHAR,
  MarketingBudget  BIGINT,
  PRIMARY KEY (SingerId, AlbumId)
) INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);
ציון אינדקס בהצהרת SQL
כשמשתמשים ב-SQL כדי לשלוח שאילתה לטבלה ב-Spanner, המערכת משתמשת באופן אוטומטי באינדקסים שיכולים לייעל את השאילתה. לכן לא צריך לציין אינדקס לשאילתות SQL. עם זאת, בשאילתות שחשובות לעומס העבודה, Google ממליצה להשתמש בהוראות FORCE_INDEX בהצהרות ה-SQL כדי לקבל ביצועים עקביים יותר.
במקרים מסוימים, יכול להיות ש-Spanner יבחר אינדקס שיגרום לעלייה בזמן האחזור של השאילתה. אם פעלתם לפי [השלבים לפתרון בעיות של רגרסיות בביצועים][troubleshooting-query-performance-regressions] והחלטתם לנסות אינדקס אחר לשאילתה, אתם יכולים לציין את האינדקס כחלק מהשאילתה.
כדי לציין אינדקס בהצהרת SQL, משתמשים ברמז FORCE_INDEX כדי לספק הוראת אינדקס. התחביר של הוראות האינדקס הוא:
GoogleSQL
FROM MyTable@{FORCE_INDEX=MyTableIndex}
PostgreSQL
FROM MyTable /*@ FORCE_INDEX = MyTableIndex */
אפשר גם להשתמש בהוראת אינדקס כדי להורות ל-Spanner לסרוק את מסד הנתונים הטבלאי במקום להשתמש באינדקס:
GoogleSQL
FROM MyTable@{FORCE_INDEX=_BASE_TABLE}
PostgreSQL
FROM MyTable /*@ FORCE_INDEX = _BASE_TABLE */
אתם יכולים להשתמש בהוראת אינדקס כדי להורות ל-Spanner לסרוק אינדקס בטבלה עם סכימות בעלות שם:
GoogleSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME@{FORCE_INDEX="NAMED_SCHEMA_NAME.TABLE_INDEX_NAME"}
PostgreSQL
FROM NAMED_SCHEMA_NAME.TABLE_NAME /*@ FORCE_INDEX = TABLE_INDEX_NAME */
בדוגמה הבאה מוצגת שאילתת SQL שמציינת אינדקס:
GoogleSQL
SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums@{FORCE_INDEX=AlbumsByAlbumTitle}
    WHERE AlbumTitle >= "Aardvark" AND AlbumTitle < "Goo";
PostgreSQL
SELECT AlbumId, AlbumTitle, MarketingBudget
    FROM Albums /*@ FORCE_INDEX = AlbumsByAlbumTitle */
    WHERE AlbumTitle >= 'Aardvark' AND AlbumTitle < 'Goo';
הוראת אינדקס עשויה לאלץ את מעבד השאילתות של Spanner לקרוא עמודות נוספות שנדרשות לשאילתה אבל לא מאוחסנות באינדקס.
מעבד השאילתות מאחזר את העמודות האלה על ידי צירוף האינדקס ומסד הנתונים הטבלאי. כדי להימנע מהאיחוד הנוסף הזה, אפשר להשתמש בסעיף STORING (מסדי נתונים בניב GoogleSQL) או בסעיף INCLUDE (מסדי נתונים בניב PostgreSQL) כדי לאחסן את העמודות הנוספות באינדקס.
בדוגמה הקודמת, העמודה MarketingBudget לא מאוחסנת באינדקס, אבל שאילתת ה-SQL בוחרת את העמודה הזו. כתוצאה מכך, Spanner צריך לחפש את העמודה MarketingBudget במסד הנתונים הטבלאי, ואז לצרף אותה לנתונים מהאינדקס כדי להחזיר את תוצאות השאילתה.
Spanner מציג שגיאה אם בהוראת האינדקס יש אחת מהבעיות הבאות:
- האינדקס לא קיים.
- האינדקס נמצא במסד נתונים טבלאי אחר.
- בשאילתה חסר ביטוי סינון נדרש של
NULLלאינדקסNULL_FILTERED.
בדוגמאות הבאות מוסבר איך לכתוב ולהריץ שאילתות שמאחזרות את הערכים של AlbumId, AlbumTitle ו-MarketingBudget באמצעות האינדקס AlbumsByAlbumTitle:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
צריך לציין אינדקס בממשק הקריאה
כשמשתמשים בממשק הקריאה של Spanner ורוצים ש-Spanner ישתמש באינדקס, צריך לציין את האינדקס. ממשק הקריאה לא בוחר את האינדקס באופן אוטומטי.
בנוסף, האינדקס חייב להכיל את כל הנתונים שמופיעים בתוצאות השאילתה, חוץ מעמודות שהן חלק מהמפתח הראשי. המגבלה הזו קיימת כי ממשק הקריאה לא תומך בצירופים בין האינדקס לבין מסד הנתונים הטבלאי. אם אתם צריכים לכלול עמודות אחרות בתוצאות השאילתה, יש לכם כמה אפשרויות:
- משתמשים במשפט
STORINGאוINCLUDEכדי לאחסן את העמודות הנוספות באינדקס. - שולחים שאילתה בלי לכלול את העמודות הנוספות, ואז משתמשים במפתחות הראשיים כדי לשלוח שאילתה נוספת שקוראת את העמודות הנוספות.
Spanner מחזיר ערכים מהאינדקס בסדר המיון עולה לפי מפתח האינדקס. כדי לאחזר ערכים בסדר יורד, מבצעים את השלבים הבאים:
מוסיפים הערה למפתח האינדקס עם
DESC. לדוגמה:CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle DESC);ההערה
DESCחלה על מפתח אינדקס יחיד. אם האינדקס כולל יותר ממפתח אחד, ואתם רוצים שתוצאות השאילתה יופיעו בסדר יורד על סמך כל המפתחות, צריך לכלול הערתDESCלכל מפתח.אם פעולת הקריאה מציינת טווח מפתחות, צריך לוודא שגם טווח המפתחות הוא בסדר יורד. במילים אחרות, הערך של מפתח ההתחלה חייב להיות גדול מהערך של מפתח הסיום.
בדוגמה הבאה אפשר לראות איך לאחזר את הערכים של AlbumId ו-AlbumTitle באמצעות האינדקס AlbumsByAlbumTitle:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
יצירת אינדקס לסריקות של אינדקס בלבד
אפשר גם להשתמש בסעיף STORING (למסדי נתונים בניב GoogleSQL) או בסעיף INCLUDE (למסדי נתונים בניב PostgreSQL) כדי לאחסן עותק של עמודה באינדקס. היתרון של סוג האינדקס הזה הוא שהוא מאפשר לבצע שאילתות וקריאות באמצעות האינדקס, אבל הוא דורש נפח אחסון נוסף:
- שאילתות SQL שמשתמשות באינדקס ובוחרות עמודות שמאוחסנות בסעיף
STORINGאוINCLUDEלא דורשות צירוף נוסף למסד הנתונים הטבלאי. - קריאות ל-
read()שמשתמשות באינדקס יכולות לקרוא עמודות שמאוחסנות על ידי המשפטSTORING/INCLUDE.
לדוגמה, נניח שיצרתם גרסה חלופית של AlbumsByAlbumTitle שמאחסנת עותק של העמודה MarketingBudget באינדקס (שימו לב לסעיף STORING או INCLUDE המודגש):
GoogleSQL
CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);
PostgreSQL
CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) INCLUDE (MarketingBudget);
באינדקס הישן AlbumsByAlbumTitle, Spanner צריך לאחד את האינדקס עם מסד הנתונים הטבלאי, ואז לאחזר את העמודה ממסד הנתונים הטבלאי. באינדקס החדש AlbumsByAlbumTitle2, Spanner קורא את העמודה ישירות מהאינדקס, וזה יעיל יותר.
אם אתם משתמשים בממשק הקריאה במקום ב-SQL, האינדקס החדש AlbumsByAlbumTitle2 מאפשר לכם גם לקרוא את העמודה MarketingBudget ישירות:
C++
C#
Go
Java
Node.js
PHP
Python
Ruby
שינוי אינדקס
אפשר להשתמש בהצהרה ALTER INDEX כדי להוסיף עמודות לאינדקס קיים או להסיר עמודות. הפעולה הזו יכולה לעדכן את רשימת העמודות שמוגדרת בסעיף STORING (מסדי נתונים בניב GoogleSQL) או בסעיף INCLUDE (מסדי נתונים בניב PostgreSQL) כשיוצרים את האינדקס. אי אפשר להשתמש בהצהרה הזו כדי להוסיף עמודות למפתח האינדקס או להסיר ממנו עמודות. לדוגמה, במקום ליצור אינדקס חדש AlbumsByAlbumTitle2, אפשר להשתמש ב-ALTER INDEX כדי להוסיף עמודה ל-AlbumsByAlbumTitle, כמו בדוגמה הבאה:
GoogleSQL
ALTER INDEX AlbumsByAlbumTitle ADD STORED COLUMN MarketingBudget
PostgreSQL
ALTER INDEX AlbumsByAlbumTitle ADD INCLUDE COLUMN MarketingBudget
כשמוסיפים עמודה חדשה לאינדקס קיים, Spanner משתמש בתהליך מילוי ברקע. בזמן שהמילוי החוזר מתבצע, העמודה באינדקס לא ניתנת לקריאה, ולכן יכול להיות שלא תראו את השיפור הצפוי בביצועים. אפשר להשתמש בפקודה gcloud spanner operations כדי להציג את רשימת הפעולות הממושכות ולראות את הסטטוס שלהן.
מידע נוסף זמין במאמר תיאור הפעולה.
אפשר גם להשתמש בביטול פעולה כדי לבטל פעולה שמתבצעת.
אחרי שהמילוי החוזר מסתיים, Spanner מוסיף את העמודה לאינדקס. ככל שהאינדקס גדל, השאילתות שמשתמשות בו עשויות להיות איטיות יותר.
בדוגמה הבאה אפשר לראות איך מסירים עמודה מאינדקס:
GoogleSQL
ALTER INDEX AlbumsByAlbumTitle DROP STORED COLUMN MarketingBudget
PostgreSQL
ALTER INDEX AlbumsByAlbumTitle DROP INCLUDE COLUMN MarketingBudget
אינדקס של ערכי NULL
כברירת מחדל, Spanner מוסיף לאינדקס ערכי NULL. לדוגמה, נזכיר את ההגדרה של האינדקס SingersByFirstLastName בטבלה Singers:
CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);
כל השורות של Singers נוספות לאינדקס, גם אם FirstName או LastName, או שניהם, הם NULL.
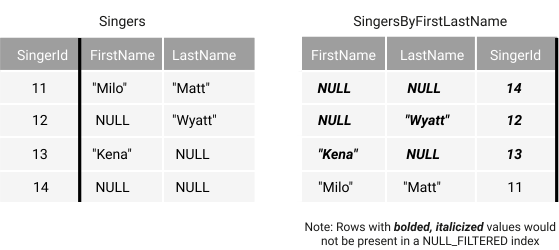
כשערכי NULL נוספים לאינדקס, אפשר לבצע שאילתות SQL וקריאות יעילות בנתונים שכוללים ערכי NULL. לדוגמה, אפשר להשתמש בהצהרת שאילתת SQL הזו כדי למצוא את כל ה-Singers עם NULL FirstName:
GoogleSQL
SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastName} AS s
    WHERE s.FirstName IS NULL;
PostgreSQL
SELECT s.SingerId, s.FirstName, s.LastName
    FROM Singers /* @ FORCE_INDEX = SingersByFirstLastName */ AS s
    WHERE s.FirstName IS NULL;
סדר המיון של ערכי NULL
Spanner ממיין את NULL כערך הקטן ביותר לכל סוג נתון. בעמודה בסדר עולה (ASC), הערכים של NULL ממוינים קודם. בעמודה בסדר יורד (DESC), הערכים של NULL ממוינים בסוף.
השבתת ההוספה לאינדקס של ערכי NULL
GoogleSQL
כדי להשבית את ההוספה לאינדקס של ערכי null, מוסיפים את מילת המפתח NULL_FILTERED להגדרת האינדקס. אינדקסים מסוג NULL_FILTERED שימושיים במיוחד להוספה לאינדקס של עמודות דלילות, שבהן רוב השורות מכילות ערך NULL. במקרים כאלה, האינדקס NULL_FILTERED יכול להיות קטן בהרבה ויעיל יותר לתחזוקה מאשר אינדקס רגיל שכולל ערכי NULL.
הנה הגדרה חלופית של SingersByFirstLastName שלא מוסיפה לאינדקס ערכים של NULL:
CREATE NULL_FILTERED INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName);
מילת המפתח NULL_FILTERED חלה על כל עמודות המפתח של האינדקס. אי אפשר לציין סינון של NULL על בסיס כל עמודה בנפרד.
PostgreSQL
כדי לסנן שורות עם ערכי null בעמודה אחת או יותר שנוספו לאינדקס, משתמשים בפרדיקט WHERE COLUMN IS NOT NULL.
אינדקסים עם סינון ערכי Null שימושיים במיוחד להוספה לאינדקס של עמודות דלילות, שבהן רוב השורות מכילות ערך NULL. במקרים כאלה, האינדקס שמסונן לפי ערכי null יכול להיות קטן בהרבה ויעיל יותר לתחזוקה מאשר אינדקס רגיל שכולל ערכי NULL.
הנה הגדרה חלופית של SingersByFirstLastName שלא מוסיפה לאינדקס ערכים של NULL:
CREATE INDEX SingersByFirstLastNameNoNulls
    ON Singers(FirstName, LastName)
    WHERE FirstName IS NOT NULL
    AND LastName IS NOT NULL;
סינון של ערכי NULL מונע מ-Spanner להשתמש בהם בחלק מהשאילתות. לדוגמה, Spanner לא משתמש באינדקס בשאילתה הזו, כי האינדקס משמיט את כל השורות של Singers שבהן LastName הוא NULL. כתוצאה מכך, השימוש באינדקס ימנע מהשאילתה להחזיר את השורות הנכונות:
GoogleSQL
FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = "John";
PostgreSQL
FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John';
כדי ש-Spanner יוכל להשתמש באינדקס, צריך לשכתב את השאילתה כך שהיא לא תכלול את השורות שלא נכללות באינדקס:
GoogleSQL
SELECT FirstName, LastName
    FROM Singers@{FORCE_INDEX=SingersByFirstLastNameNoNulls}
    WHERE FirstName = 'John' AND LastName IS NOT NULL;
PostgreSQL
SELECT FirstName, LastName
    FROM Singers /*@ FORCE_INDEX = SingersByFirstLastNameNoNulls */
    WHERE FirstName = 'John' AND LastName IS NOT NULL;
שדות פרוטוקול של אינדקס
אפשר להשתמש בעמודות שנוצרו כדי להוסיף לאינדקס שדות במאגרי אחסון לפרוטוקולים שמאוחסנים בעמודות PROTO, כל עוד השדות שנוספים לאינדקס משתמשים בסוגי הנתונים הפרימיטיביים או בסוגי הנתונים של ENUM.
אם מגדירים אינדקס בשדה של הודעת פרוטוקול, אי אפשר לשנות או להסיר את השדה הזה מהסכימה של הפרוטוקול. מידע נוסף זמין במאמר עדכונים לסכימות שמכילות אינדקס בשדות פרוטו.
הדוגמה הבאה היא של הטבלה Singers עם עמודה של הודעת פרוטו SingerInfo. כדי להגדיר אינדקס בשדה nationality של PROTO, צריך ליצור עמודה שנוצרה ונשמרה:
GoogleSQL
CREATE PROTO BUNDLE (googlesql.example.SingerInfo, googlesql.example.SingerInfo.Residence);

CREATE TABLE Singers (
  SingerId INT64 NOT NULL,
  ...
  SingerInfo googlesql.example.SingerInfo,
  SingerNationality STRING(MAX) AS (SingerInfo.nationality) STORED
) PRIMARY KEY (SingerId);
הוא כולל את ההגדרה הבאה של סוג ה-proto googlesql.example.SingerInfo:
GoogleSQL
package googlesql.example;

message SingerInfo {
optional string    nationality = 1;
repeated Residence residence   = 2;

  message Residence {
    required int64  start_year   = 1;
    optional int64  end_year     = 2;
    optional string city         = 3;
    optional string country      = 4;
  }
}
לאחר מכן מגדירים אינדקס בשדה nationality של הפרוטוקול:
GoogleSQL
CREATE INDEX SingersByNationality ON Singers(SingerNationality);
שאילתת ה-SQL הבאה קוראת נתונים באמצעות האינדקס הקודם:
GoogleSQL
SELECT s.SingerId, s.FirstName
FROM Singers AS s
WHERE s.SingerNationality = "English";
הערות:
- אפשר להשתמש בהוראת אינדקס כדי לגשת לאינדקסים בשדות של עמודות מאגר האחסון לפרוטוקולים.
- אי אפשר ליצור אינדקס בשדות חוזרים של מאגר אחסון לפרוטוקולים.
עדכונים לסכימות שמכילות אינדקס בשדות פרוטו
אם מגדירים אינדקס בשדה של הודעת פרוטוקול, אי אפשר לשנות או להסיר את השדה הזה מהסכימה של הפרוטוקול. הסיבה לכך היא שאחרי שמגדירים את האינדקס, בדיקת הסוג מתבצעת בכל פעם שהסכימה מתעדכנת. Spanner מתעד את פרטי הסוג של כל השדות בנתיב שמשמשים בהגדרת האינדקס.
אינדקסים ייחודיים
אפשר להצהיר על אינדקסים בתור UNIQUE. אינדקסים מסוג UNIQUE מוסיפים אילוץ לנתונים שנוסף להם אינדקס, שאוסר על רשומות כפולות למפתח אינדקס נתון.
האילוץ הזה נאכף על ידי Spanner בזמן אישור העסקה.
באופן ספציפי, כל טרנזקציה שגורמת ליצירת כמה רשומות אינדקס לאותו מפתח תיכשל.
אם טבלה מכילה נתונים שהם לא UNIQUE, הניסיון ליצור בה אינדקס UNIQUE ייכשל.
הערה לגבי אינדקסים מסוג UNIQUE NULL_FILTERED
אינדקס UNIQUE NULL_FILTERED לא אוכף את הייחודיות של מפתח האינדקס אם לפחות אחד מחלקי המפתח של האינדקס הוא NULL.
לדוגמה, נניח שיצרתם את הטבלה והאינדקס הבאים:
GoogleSQL
CREATE TABLE ExampleTable (
  Key1 INT64 NOT NULL,
  Key2 INT64,
  Key3 INT64,
  Col1 INT64,
) PRIMARY KEY (Key1, Key2, Key3);

CREATE UNIQUE NULL_FILTERED INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1);
PostgreSQL
CREATE TABLE ExampleTable (
  Key1 BIGINT NOT NULL,
  Key2 BIGINT,
  Key3 BIGINT,
  Col1 BIGINT,
  PRIMARY KEY (Key1, Key2, Key3)
);

CREATE UNIQUE INDEX ExampleIndex ON ExampleTable (Key1, Key2, Col1)
    WHERE Key1 IS NOT NULL
    AND Key2 IS NOT NULL
    AND Col1 IS NOT NULL;
בשתי השורות הבאות ב-ExampleTable יש ערכים זהים למפתחות האינדקס המשניים Key1, Key2 ו-Col1:
1, NULL, 1, 1
1, NULL, 2, 1
מכיוון שהערך של Key2 הוא NULL והאינדקס מסונן לפי ערכי null, השורות לא יופיעו באינדקס ExampleIndex. הם לא מוכנסים לאינדקס, ולכן האינדקס לא ידחה אותם בגלל הפרת הייחודיות ב-(Key1, Key2,
Col1).
אם רוצים שהאינדקס יאכוף את הייחודיות של ערכי ה-tuple (Key1, Key2, Col1), צריך להוסיף ל-Key2 הערה עם NOT NULL בהגדרת הטבלה, או ליצור את האינדקס בלי לסנן ערכי null.
יצירת אינדקס על סמך ביטוי סקלרי
אינדקס ביטויים מאפשר ליצור אינדקס שמבוסס על ביטוי סקלרי שחל על עמודה אחת או יותר בטבלה. זה יתרון כי לא צריך ליצור ולתחזק עמודה ייעודית שנוצרה בטבלה רק למטרות הוספה לאינדקס.
אינדקסים בעמודות שנוצרו ואינדקסים של ביטויים יכולים להיות שימושיים להוספת שדות ספציפיים לאינדקס בתוך עמודת JSON. אתם יכולים ליצור אינדקס על ערך שחולץ מאובייקט JSON, וכך לאפשר לאופטימיזציית השאילתות לבצע ביעילות חיפושים על סמך הערך הזה.
בדוגמה הזו, עמודה שנוצרה בשם VenueCity, שמבוססת על השדה city ב-JSON, נוצרת רק כדי למקם אותה באינדקס:
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON,
  VenueCity STRING AS (JSON_VALUE(VenueData.address.city))
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(VenueCity);
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB,
  VenueCity VARCHAR GENERATED ALWAYS AS (VenueData -> 'address' ->> 'city')
);

CREATE INDEX VenuesByCity ON Venues(VenueCity);
כדי לעשות את זה בצורה יעילה יותר, אתם יכולים להגדיר את האינדקס ישירות, ו-Spanner יטפל במנגנון הבסיסי באופן משתמע:
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues((JSON_VALUE(VenueData.address.city)));
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueData JSONB
);

CREATE INDEX VenuesByCity ON Venues((VenueData -> 'address' ->> 'city'));
בשני המקרים, השאילתה יכולה להשתמש באינדקס VenuesByCity כדי לפעול מהר יותר:
GoogleSQL
SELECT Id
FROM Venues
WHERE JSON_VALUE(VenueData.address.city) = 'Seattle';
PostgreSQL
SELECT Id
FROM Venues
WHERE VenueData -> 'address' ->> 'city' = 'Seattle';
אינדקסים של ביטויים יכולים לכלול עמודות שהן שילוב של ביטויים והפניות ישירות לעמודות. כך יותר שאילתות יכולות להשתמש באינדקס כדי לפעול מהר יותר.
GoogleSQL
CREATE TABLE Venues (
  Id INT64 NOT NULL,
  VenueName STRING(MAX),
  VenueData JSON
) PRIMARY KEY (Id);

CREATE INDEX VenuesByCity ON Venues(
  VenueName,
  (JSON_VALUE(VenueData.address.city)),
  (JSON_VALUE(VenueData.address.state))
);
PostgreSQL
CREATE TABLE Venues (
  Id BIGINT NOT NULL PRIMARY KEY,
  VenueName VARCHAR,
  VenueData JSONB
);

CREATE INDEX VenuesIdx ON Venues(
  VenueName,
  (VenueData -> 'address' ->> 'city'),
  (VenueData -> 'address' ->> 'state'),
);
הסרת אינדקס
כדי להסיר אינדקס משני מהסכימה, משתמשים בהצהרה DROP INDEX.
כדי למחוק את האינדקס שנקרא SingersByFirstLastName:
DROP INDEX SingersByFirstLastName;
אינדקס לסריקה מהירה יותר
כש-Spanner צריך לבצע סריקת טבלה (במקום חיפוש באינדקס) כדי לאחזר ערכים מעמודה אחת או יותר, אפשר לקבל תוצאות מהר יותר אם קיים אינדקס לעמודות האלה, ובסדר שצוין בשאילתה. אם אתם מבצעים לעיתים קרובות שאילתות שדורשות סריקות, כדאי ליצור אינדקסים משניים כדי שהסריקות האלה יתבצעו בצורה יעילה יותר.
במיוחד אם אתם צריכים ש-Spanner יסרוק לעיתים קרובות את המפתח הראשי של טבלה או אינדקס אחר בסדר הפוך, תוכלו להגביר את היעילות באמצעות אינדקס משני שמגדיר במפורש את הסדר שנבחר.
לדוגמה, השאילתה הבאה תמיד מחזירה תוצאה מהירה, למרות ש-Spanner צריך לסרוק את Songs כדי למצוא את הערך הנמוך ביותר של SongId:
SELECT SongId FROM Songs LIMIT 1;
SongId הוא המפתח הראשי של הטבלה, שמאוחסן (כמו כל המפתחות הראשיים) בסדר עולה. Spanner יכול לסרוק את האינדקס של המפתח הזה ולמצוא את התוצאה הראשונה במהירות.
עם זאת, בלי עזרה של אינדקס משני, השאילתה הבאה לא תחזיר תוצאות כל כך מהר, במיוחד אם Songs מכיל הרבה נתונים:
SELECT SongId FROM Songs ORDER BY SongId DESC LIMIT 1;
למרות ש-SongId הוא המפתח הראשי של הטבלה, ל-Spanner אין דרך לאחזר את הערך הגבוה ביותר של העמודה בלי לבצע סריקה מלאה של הטבלה.
הוספת האינדקס הבא תאפשר לשאילתה הזו להחזיר תוצאות מהר יותר:
CREATE INDEX SongIdDesc On Songs(SongId DESC);
אם האינדקס הזה קיים, Spanner משתמש בו כדי להחזיר תוצאה לשאילתה השנייה הרבה יותר מהר.
המאמרים הבאים
- מידע ולמידה על שיטות מומלצות ל-SQL ב-Spanner
- להבין את תוכניות ההרצה של שאילתות ב-Spanner.
- איך פותרים בעיות של רגרסיה בביצועים של שאילתות SQL