


סקירה כללית
בדף הזה מוסברים המושגים שקשורים לתוכניות להרצת שאילתות, ואיך Spanner משתמש בהן כדי להריץ שאילתות בסביבה מבוזרת. במאמר איך Spanner מריץ שאילתות מוסבר איך לאחזר תוכנית ביצוע של שאילתה ספציפית באמצעות מסוףGoogle Cloud . אתם יכולים גם להציג דגימות של תוכניות היסטוריות לביצוע שאילתות כדי להשוות את ביצועי השאילתות לאורך זמן. מידע נוסף זמין במאמר תוכניות לביצוע שאילתה לדוגמה.
ב-Spanner משתמשים בהצהרות SQL דקלרטיביות כדי להריץ שאילתות על מסדי הנתונים. הצהרות SQL מגדירות מה המשתמש רוצה, בלי לציין איך לקבל את התוצאות. תוכנית הרצת שאילתה היא קבוצת השלבים לקבלת התוצאות. יכולות להיות כמה דרכים לקבל את התוצאות של הצהרת SQL מסוימת. הכלי לאופטימיזציה של שאילתות ב-Spanner מעריך תוכניות ביצוע שונות ובוחר את התוכנית היעילה ביותר. לאחר מכן, Spanner משתמש בתוכנית הביצוע כדי לאחזר את התוצאות. תוכניות הביצוע תומכות במסדי נתונים בניב GoogleSQL ובמסדי נתונים בניב PostgreSQL.
למידע נוסף על הכלי לאופטימיזציה של שאילתות, קראו את הסקירה הכללית על הכלי לאופטימיזציה של שאילתות.
מבחינה רעיונית, תוכנית ביצוע היא עץ של אופרטורים יחסיים. כל אופרטור קורא שורות מהקלט שלו ומפיק שורות פלט. התוצאה של האופרטור ברמה הבסיסית (root) של הביצוע מוחזרת כתוצאה של שאילתת ה-SQL.
לדוגמה, נבחן את השאילתה הבאה:
SELECT s.SongName FROM Songs AS s;
השאילתה הזו יוצרת תוכנית להרצת שאילתה שאפשר להציג באופן חזותי כך:
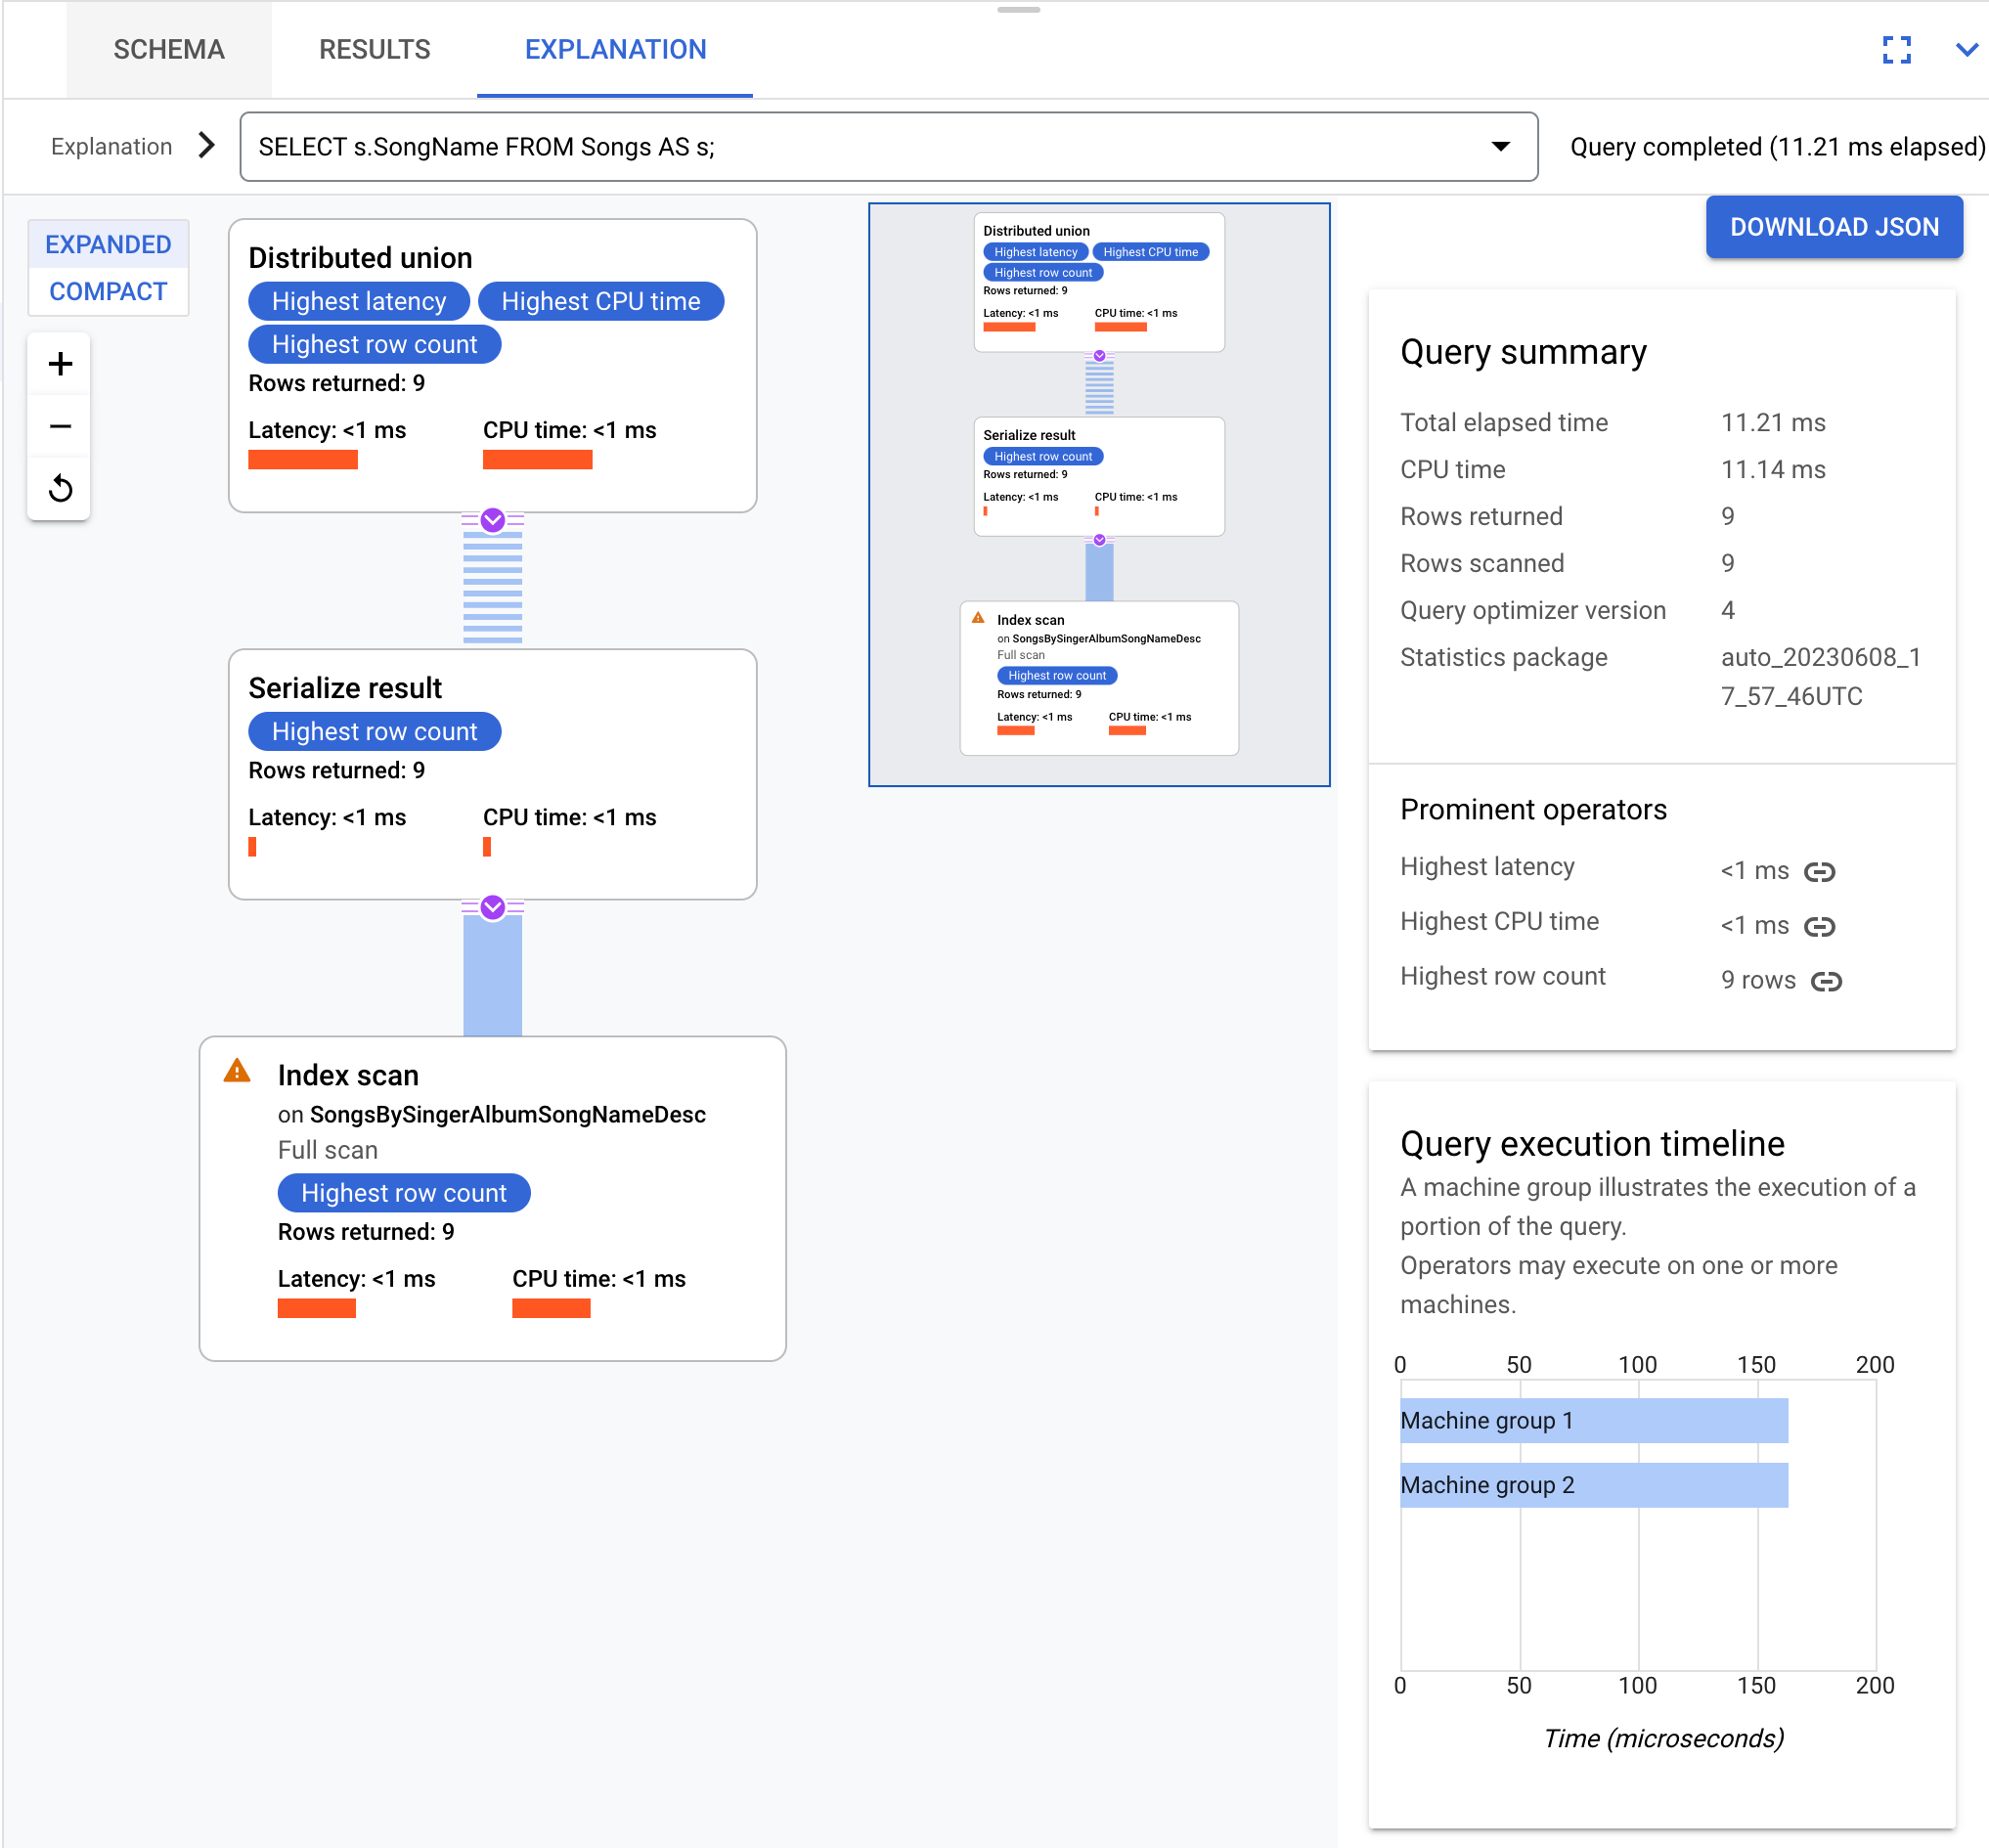
בדוגמה הזו, Spanner מבצע את התוכנית לביצוע השאילתה מלמעלה למטה, והנתונים זורמים מלמטה למעלה. האופרטור
distributed union
מבוצע ראשון. הקווים הכחולים המקווקווים מציינים שהמפעיל הזה יכול לבצע שיחה מרחוק. בין אם באופן מקומי או מרחוק, הוא מפעיל את האופרטור serialize result וממשיך במורד העץ. כשהאופרטור table scan יוצר שורה, הוא מחזיר מיד את השליטה לאופרטור serialize result. התהליך הזה נמשך עד שהשאילתה סורקת את כל השורות.
השאילתות ותוכניות הביצוע בדף הזה מבוססות על הסכימה הבאה של מסד הנתונים:
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
כדי להוסיף נתונים לטבלאות האלה, אפשר להשתמש בפקודות הבאות של שפת הטיפול בנתונים (DML):
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
קשה להשיג תוכניות ביצוע יעילות כי Spanner מחלק את הנתונים לפיצולים. הפיצולים יכולים לזוז באופן עצמאי, ו-Spanner יכול להקצות אותם לשרתים שונים, שיכולים להיות במיקומים פיזיים שונים. כדי להעריך תוכניות הרצה בנתונים מבוזרים, Spanner מבצע את המשימות הבאות:
- מריץ תוכניות משנה באופן מקומי בשרתים שבהם הנתונים מאוחסנים.
- מתזמר ומצרף כמה הפעלות מרחוק עם גיזום הפצה אגרסיבי.
כדי להפעיל את המודל הזה, Spanner משתמש באופרטור distributed union, יחד עם הווריאציות שלו distributed cross apply ו-distributed outer apply.
איך Spanner מריץ שאילתות
מבחינה רעיונית, ביצוע השאילתה זורם מלמעלה למטה, ותוצאות השאילתה זורמות מלמטה למעלה. התרשים הבא מציג את התבנית הזו:
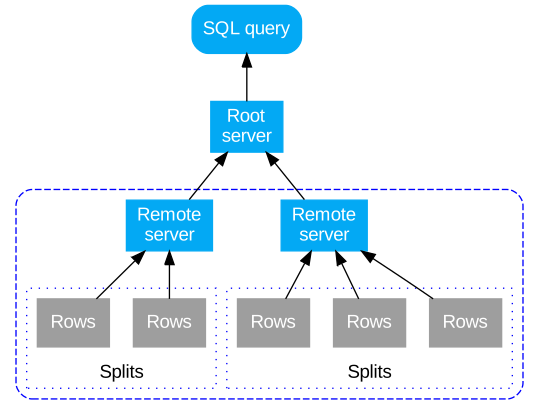
Spanner מקמפל שאילתת SQL לתוכנית ביצוע. כדי לצמצם את מספר הדילוגים לנתונים ששלחתם לגביהם שאילתה, Spanner בוחר שרת שורש ראשוני ושולח את התוכנית לשרת הזה. שרת הבסיס מבצע את הפעולות הבאות:
- מפעיל את הביצוע מרחוק של תוכניות משנה, אם יש צורך.
- ממתין לתוצאות מההרצות מרחוק.
- מטפל בכל שלבי ההרצה המקומית שנותרו, כמו צבירת תוצאות.
- החזרת תוצאות השאילתה.
שרת מרוחק שמקבל תוכנית משנה פועל כשרת בסיס של תוכנית המשנה שלו, לפי אותו מודל של שרת הבסיס העליון. מודל ההרצה הזה יוצר עץ של הרצות מרחוק.
מדדי ביצועים מרכזיים
הכלי להמחשה חזותית של תוכנית לביצוע שאילתה ב-Spanner Studio מציג מדדי סיכום של ביצוע השאילתה. מדדי הסיכום מייצגים את המדדים המצטברים מכל האופרטורים הבודדים שהופעלו במהלך השאילתה. בטבלה הבאה מתוארים מדדי הביצועים העיקריים:
| מדד | תיאור |
|---|---|
| הזמן הכולל שחלף | הזמן הכולל שנדרש להרצת השאילתה. |
| זמן CPU (מעבד) | משך הזמן הכולל של ה-CPU בכל השרתים שמעורבים בהרצת השאילתה. מכיוון שחלקים מסוימים של ביצוע השאילתה יכולים להתבצע במקביל, זמן ה-CPU יכול להיות גדול יותר מהזמן הכולל שחלף. |
תוכניות לביצוע שאילתות שנדגמו
תוכניות דגימה של שאילתות ב-Spanner מאפשרות לכם לראות דגימות של תוכניות היסטוריות לביצוע שאילתות, ולהשוות את הביצועים של שאילתה לאורך זמן. תוכניות דגימה לביצוע שאילתות לא זמינות לכל השאילתות. יכול להיות ש-Spanner ידגום רק שאילתות שצורכות הרבה משאבי מעבד (CPU). Spanner שומר דוגמאות של תוכניות לביצוע שאילתות למשך 30 יום. כדי למצוא דוגמאות לתוכניות לביצוע שאילתות בדף Query insights במסוףGoogle Cloud , קראו את המאמר הצגת דוגמאות לתוכניות לביצוע שאילתות.
המבנה של תוכנית דגימה לביצוע שאילתה זהה לזה של תוכנית רגילה לביצוע שאילתה. למידע נוסף על האופן שבו אפשר להבין תוכניות לביצוע שאילתה ולהשתמש בהן כדי לנפות באגים בשאילתות, ראו סיור בכלי להמחשה חזותית של תוכניות לביצוע שאילתות.
תרחישי שימוש נפוצים עבור תוכניות לביצוע שאילתות שנדגמו
תרחישים נפוצים לדוגמה לתוכניות דגימה של שאילתות:
- צפייה בשינויים בתוכנית לביצוע שאילתה בגלל שינויים בסכימה (לדוגמה, הוספה או הסרה של אינדקס).
- שינויים בתוכנית לביצוע שאילתה בגלל עדכון גרסה של הכלי לאופטימיזציה.
- צפייה בשינויים בתוכנית לביצוע שאילתה בגלל נתונים סטטיסטיים חדשים של כלי האופטימיזציה.
Spanner אוסף את הנתונים הסטטיסטיים האלה באופן אוטומטי כל שלושה ימים, ואפשר גם לעדכן אותם ידנית באמצעות הפקודה
ANALYZE.
אם ביצועי השאילתות משתנים באופן משמעותי לאורך זמן, או אם אתם רוצים לשפר את הביצועים, עיינו בשיטות המומלצות ל-SQL כדי לבנות הצהרות שאילתה אופטימליות שיעזרו ל-Spanner למצוא תוכניות ביצוע יעילות.
דפוסים נפוצים
הדוגמאות הבאות ממחישות דפוסים נפוצים בתוכניות ביצוע של Spanner.
שאילתות צבירה
שאילתת צבירה מיישמת לוגיקה של GROUP BY.
לדוגמה, השאילתה הבאה מחשבת את מספר השירים לפי זמר:
SELECT s.SingerId, COUNT(*) AS SongCount
FROM Songs AS s
WHERE s.SingerId < 100
GROUP BY s.SingerId;
אלה התוצאות:
+----------+-----------+
| SingerId | SongCount |
+----------+-----------+
|        3 |         1 |
|        2 |         8 |
+----------+-----------+
באופן עקרוני, זו תוכנית הביצוע:
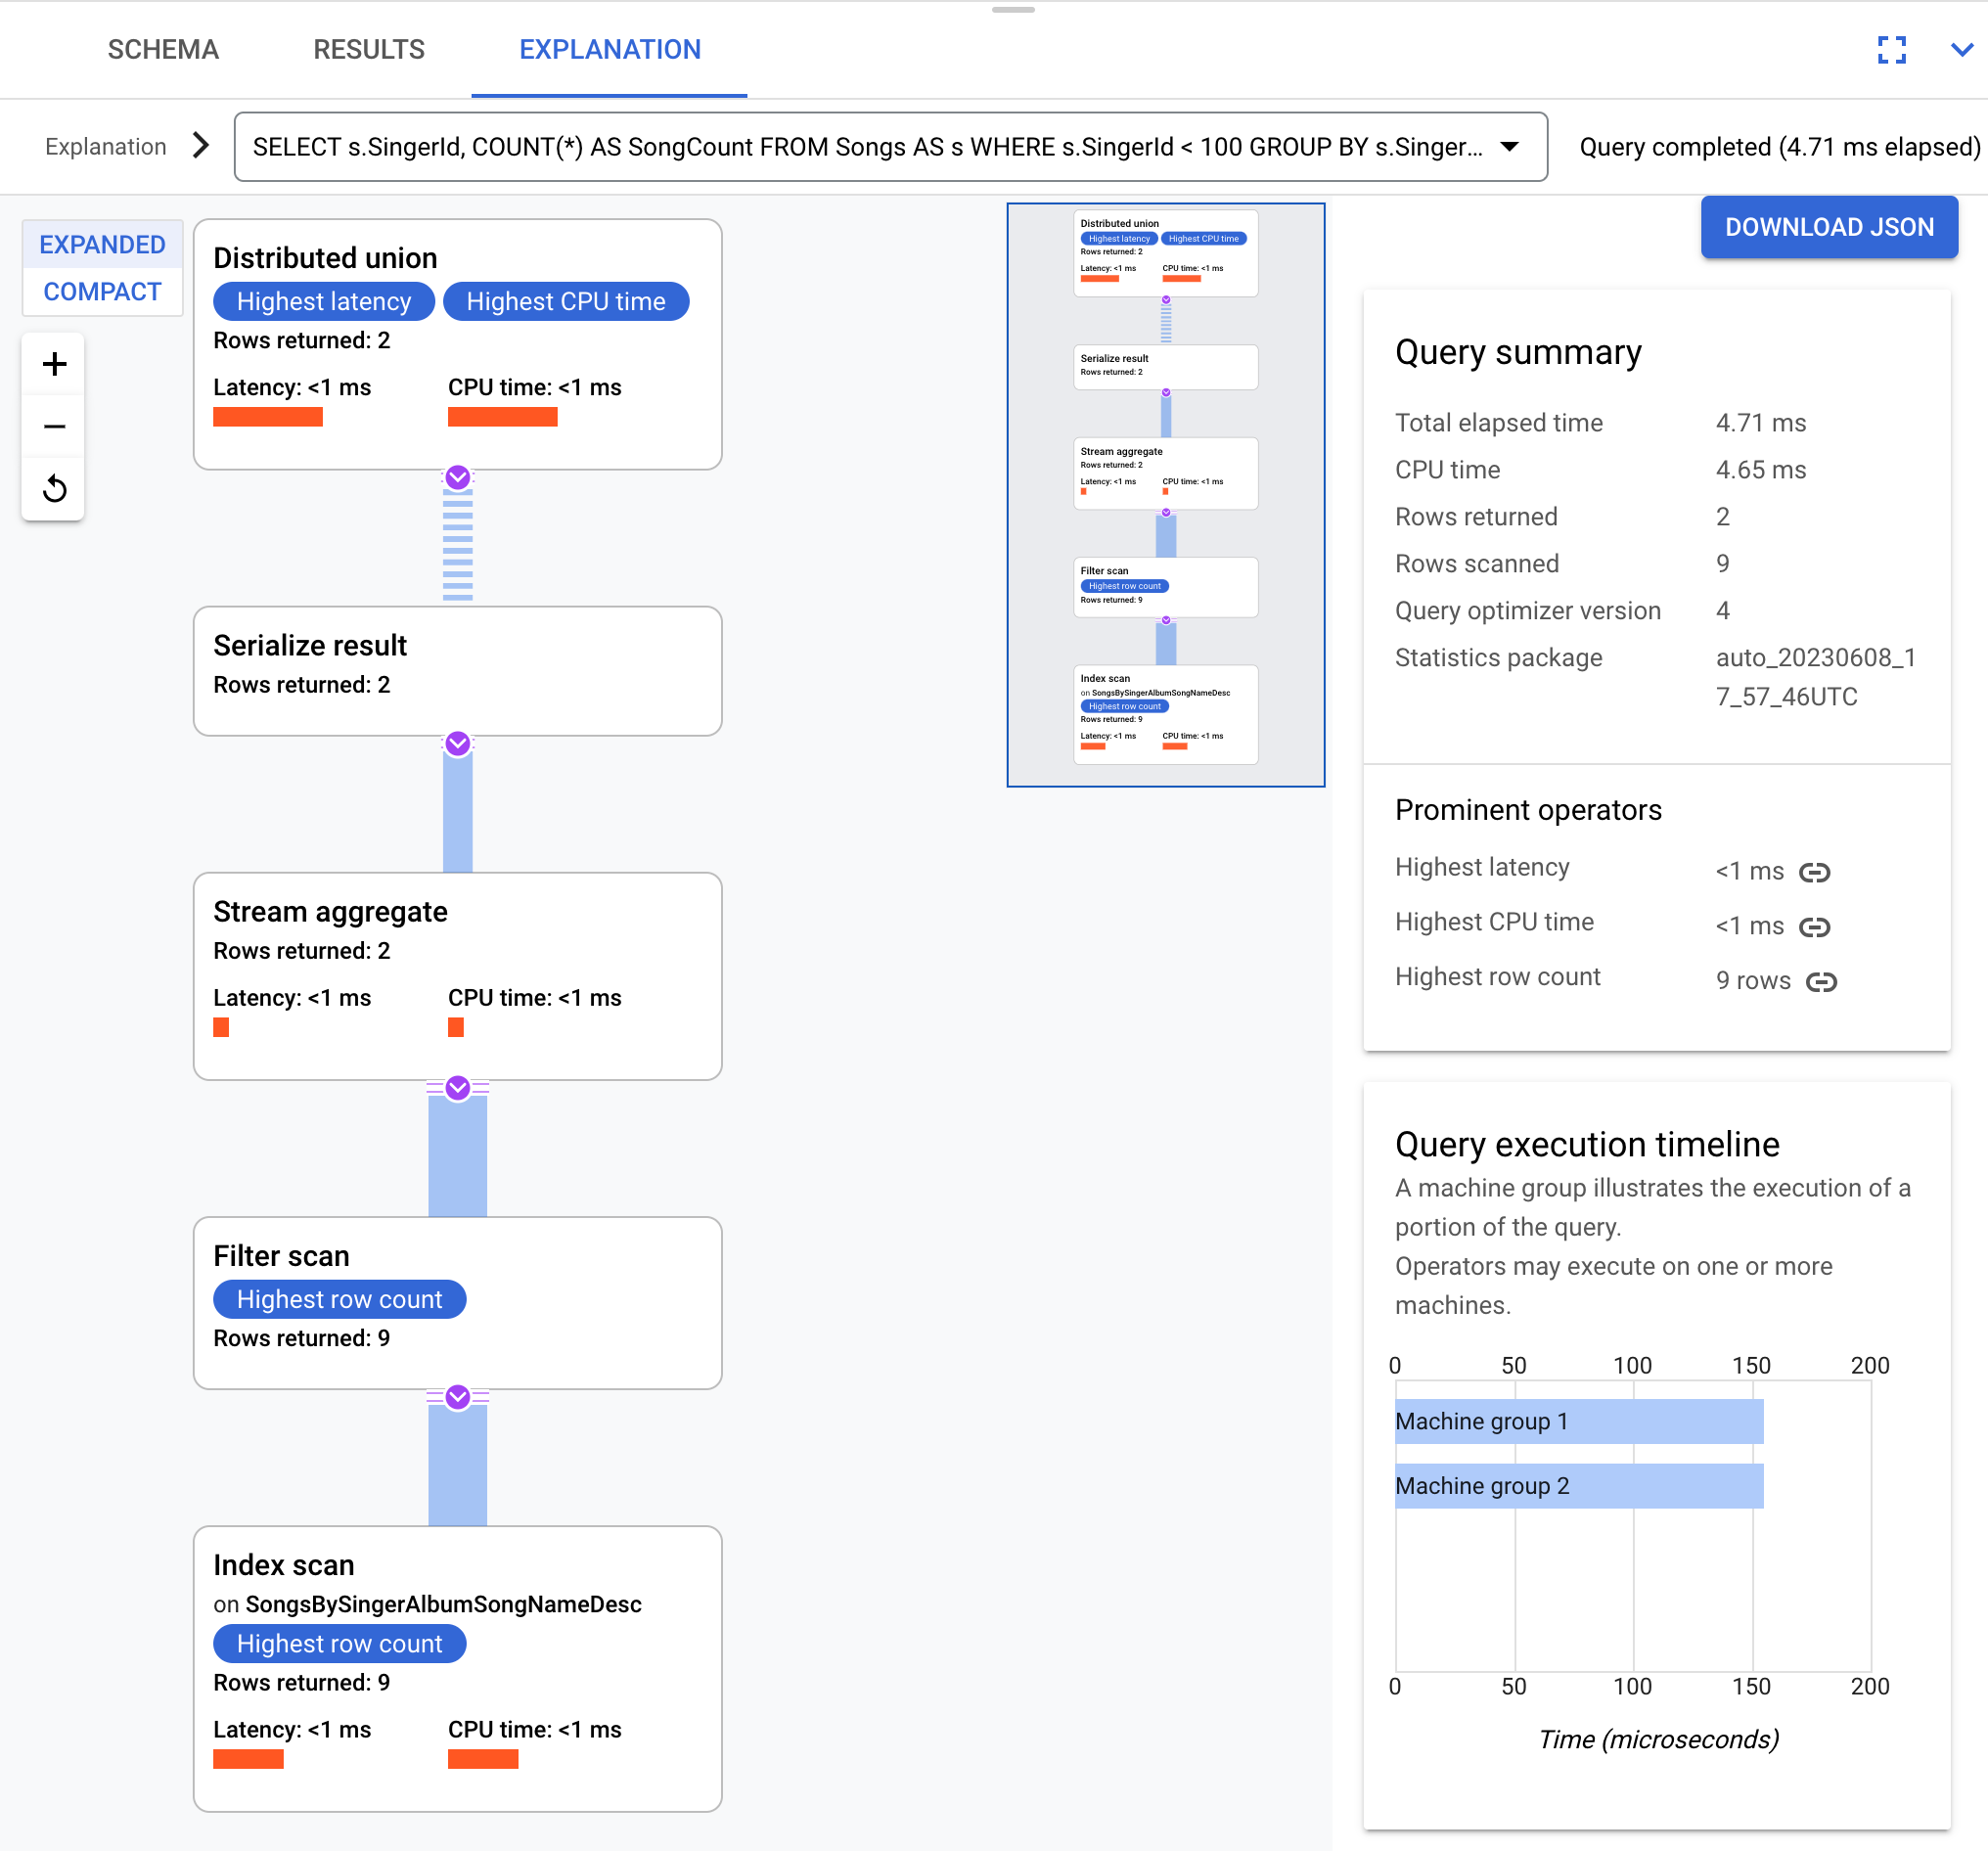
Spanner שולח את תוכנית הביצוע לשרת בסיס (root) שמתאם את ביצוע השאילתה ומפיץ תוכניות משנה מרחוק.
תוכנית הביצוע הזו מתחילה באופרטור distributed union שמפיץ תוכניות משנה לשרתים מרוחקים שהפיצולים שלהם עומדים בתנאי SingerId < 100. אחרי שהסריקה של הפיצולים הנפרדים מסתיימת, האופרטור stream aggregate צובר שורות כדי לקבל את הספירות לכל SingerId. האופרטור serialize result מבצע סריאליזציה של התוצאה. בסיום, distributed union משלב את כל התוצאות ומחזיר את תוצאות השאילתה.
מידע נוסף על צבירות זמין במאמר אופרטורים של צבירה.
שאילתות צירוף באותו מיקום
בטבלאות משולבות, Spanner מאחסן פיזית שורות קשורות ביחד. שאילתת איחוד (join) באותו מיקום היא שאילתת איחוד בין טבלאות משולבות. שאילתות JOIN עם מיקום משותף יכולות לשפר את הביצועים בהשוואה לשאילתות JOIN שדורשות אינדקסים או שאילתות back join.
לדוגמה, נבחן את השאילתה הבאה:
SELECT al.AlbumTitle, so.SongName
FROM Albums AS al, Songs AS so
WHERE al.SingerId = so.SingerId AND
      al.AlbumId = so.AlbumId;
השאילתה הזו מניחה שהטבלה Songs משולבת בטבלה Albums.
אלה התוצאות:
+-----------------------+--------------------------+
| AlbumTitle            | SongName                 |
+-----------------------+--------------------------+
| Nothing To Do With Me | Not About The Guitar     |
| Green                 | The Second Time          |
| Green                 | Starting Again           |
| Green                 | Nothing Is The Same      |
| Green                 | Let's Get Back Together  |
| Green                 | I Knew You Were Magic    |
| Green                 | Blue                     |
| Green                 | 42                       |
| Terrified             | Fight Story              |
+-----------------------+--------------------------+
זו תוכנית ההרצה:
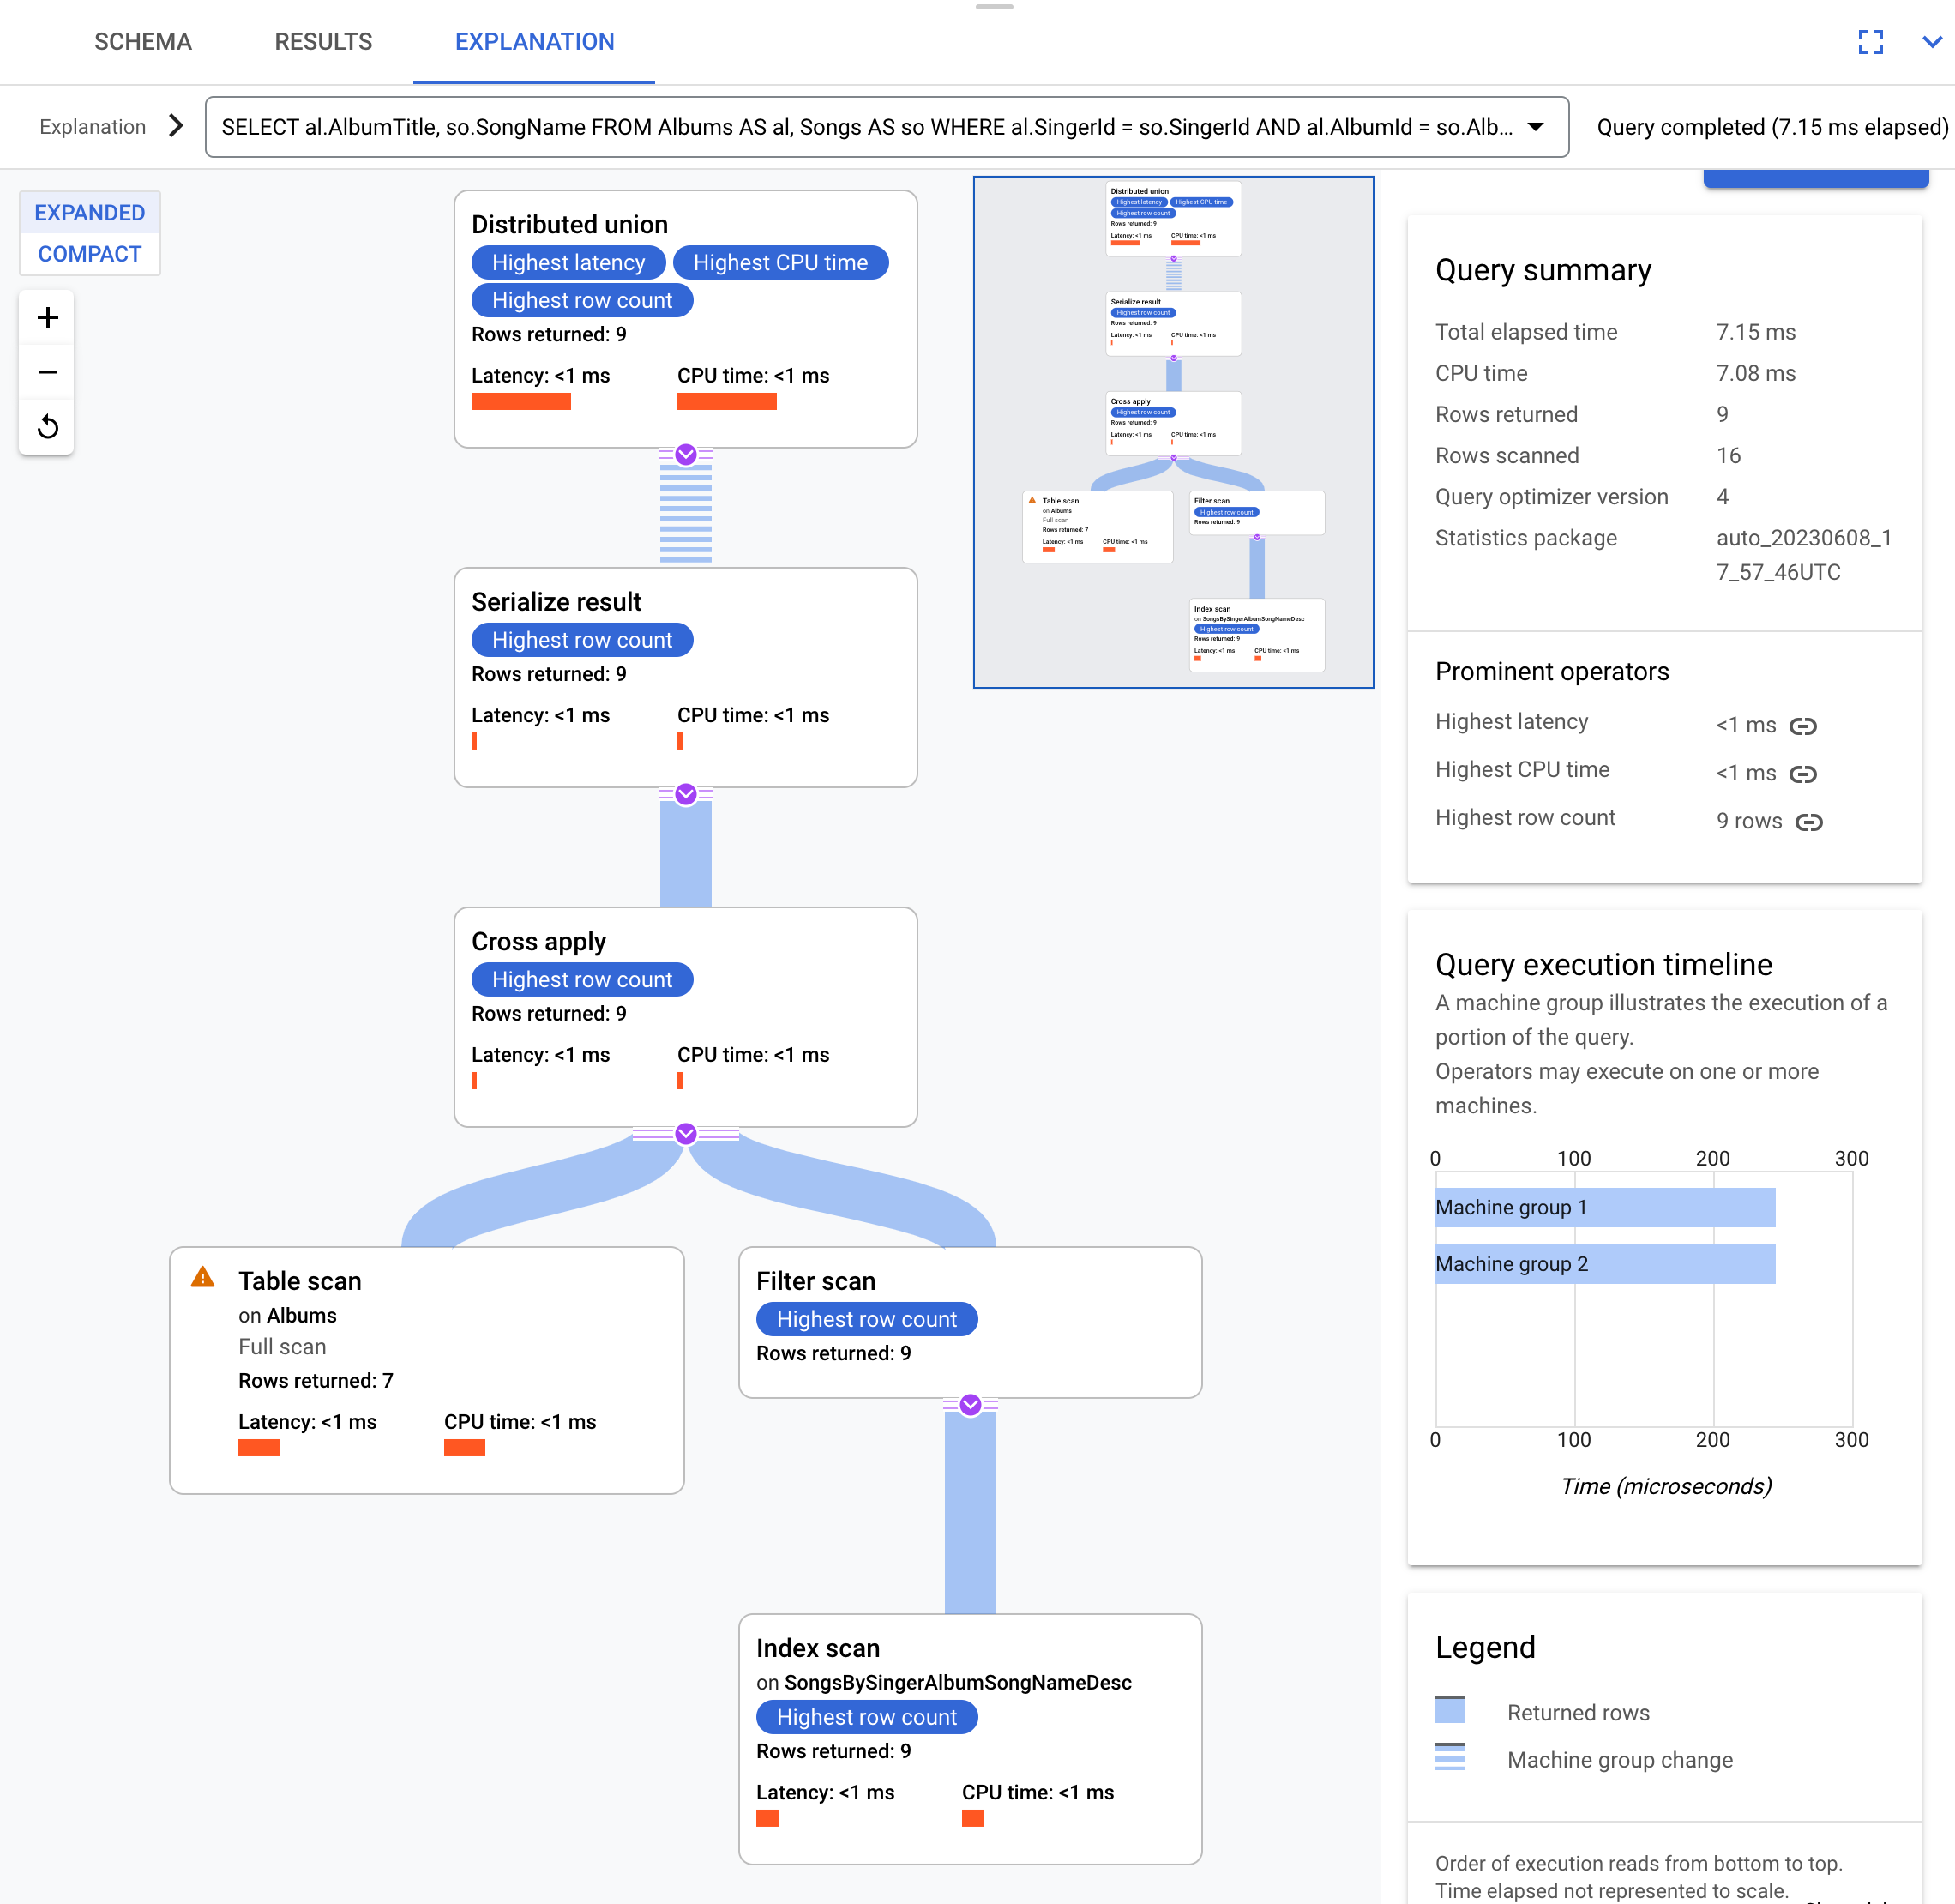
תוכנית הביצוע הזו מתחילה באופרטור distributed union שמפיץ תוכניות משנה לשרתים מרוחקים, שמכילים פיצולים של הטבלה Albums. מכיוון ש-Songs משולב ב-Albums, כל שרת מרוחק מבצע את כל תוכנית המשנה באופן מקומי, בלי לבצע איחוד בין שרתים שונים.
תוכניות המשנה מכילות אופרטור cross apply. כל אופרטור cross apply מבצע table scan בטבלה Albums כדי לאחזר את SingerId, AlbumId ו-AlbumTitle. לאחר מכן, האופרטור cross apply ממפה את הפלט מסריקת הטבלה לפלט מסריקת האינדקס באינדקס SongsBySingerAlbumSongNameDesc.
האינדקס הזה כפוף למסנן, שמחייב שהערך של SingerId באינדקס יהיה זהה לערך של SingerId בפלט של סריקת הטבלה. כל אופרטור cross apply שולח את התוצאות שלו לאופרטור serialize result, שמבצע סריאליזציה של הנתונים של AlbumTitle ו-SongName ומחזיר את התוצאות לאיחודים המבוזרים המקומיים. האיחוד המבוזר צובר תוצאות מהאיחודים המבוזרים המקומיים ומחזיר אותן כתוצאת השאילתה.
שאילתות של אינדקס ושאילתות של back join
בדוגמה הקודמת השתמשנו בצירוף של שתי טבלאות, כשאחת מהן משולבת בשנייה. אם שתי טבלאות, או טבלה ואינדקס, לא משולבות, תוכניות הביצוע מורכבות יותר ופחות יעילות.
נניח שיצרתם אינדקס באמצעות הפקודה הבאה:
CREATE INDEX SongsBySongName ON Songs(SongName);
כדי להשתמש באינדקס הזה בשאילתה, בוחרים אחת מהאפשרויות הבאות של ניב מסד הנתונים:
GoogleSQL
SELECT s.SongName, s.Duration
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName, s.Duration
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
אלה התוצאות:
+----------+----------+
| SongName | Duration |
+----------+----------+
| Blue     |      238 |
+----------+----------+
זו תוכנית ההרצה:
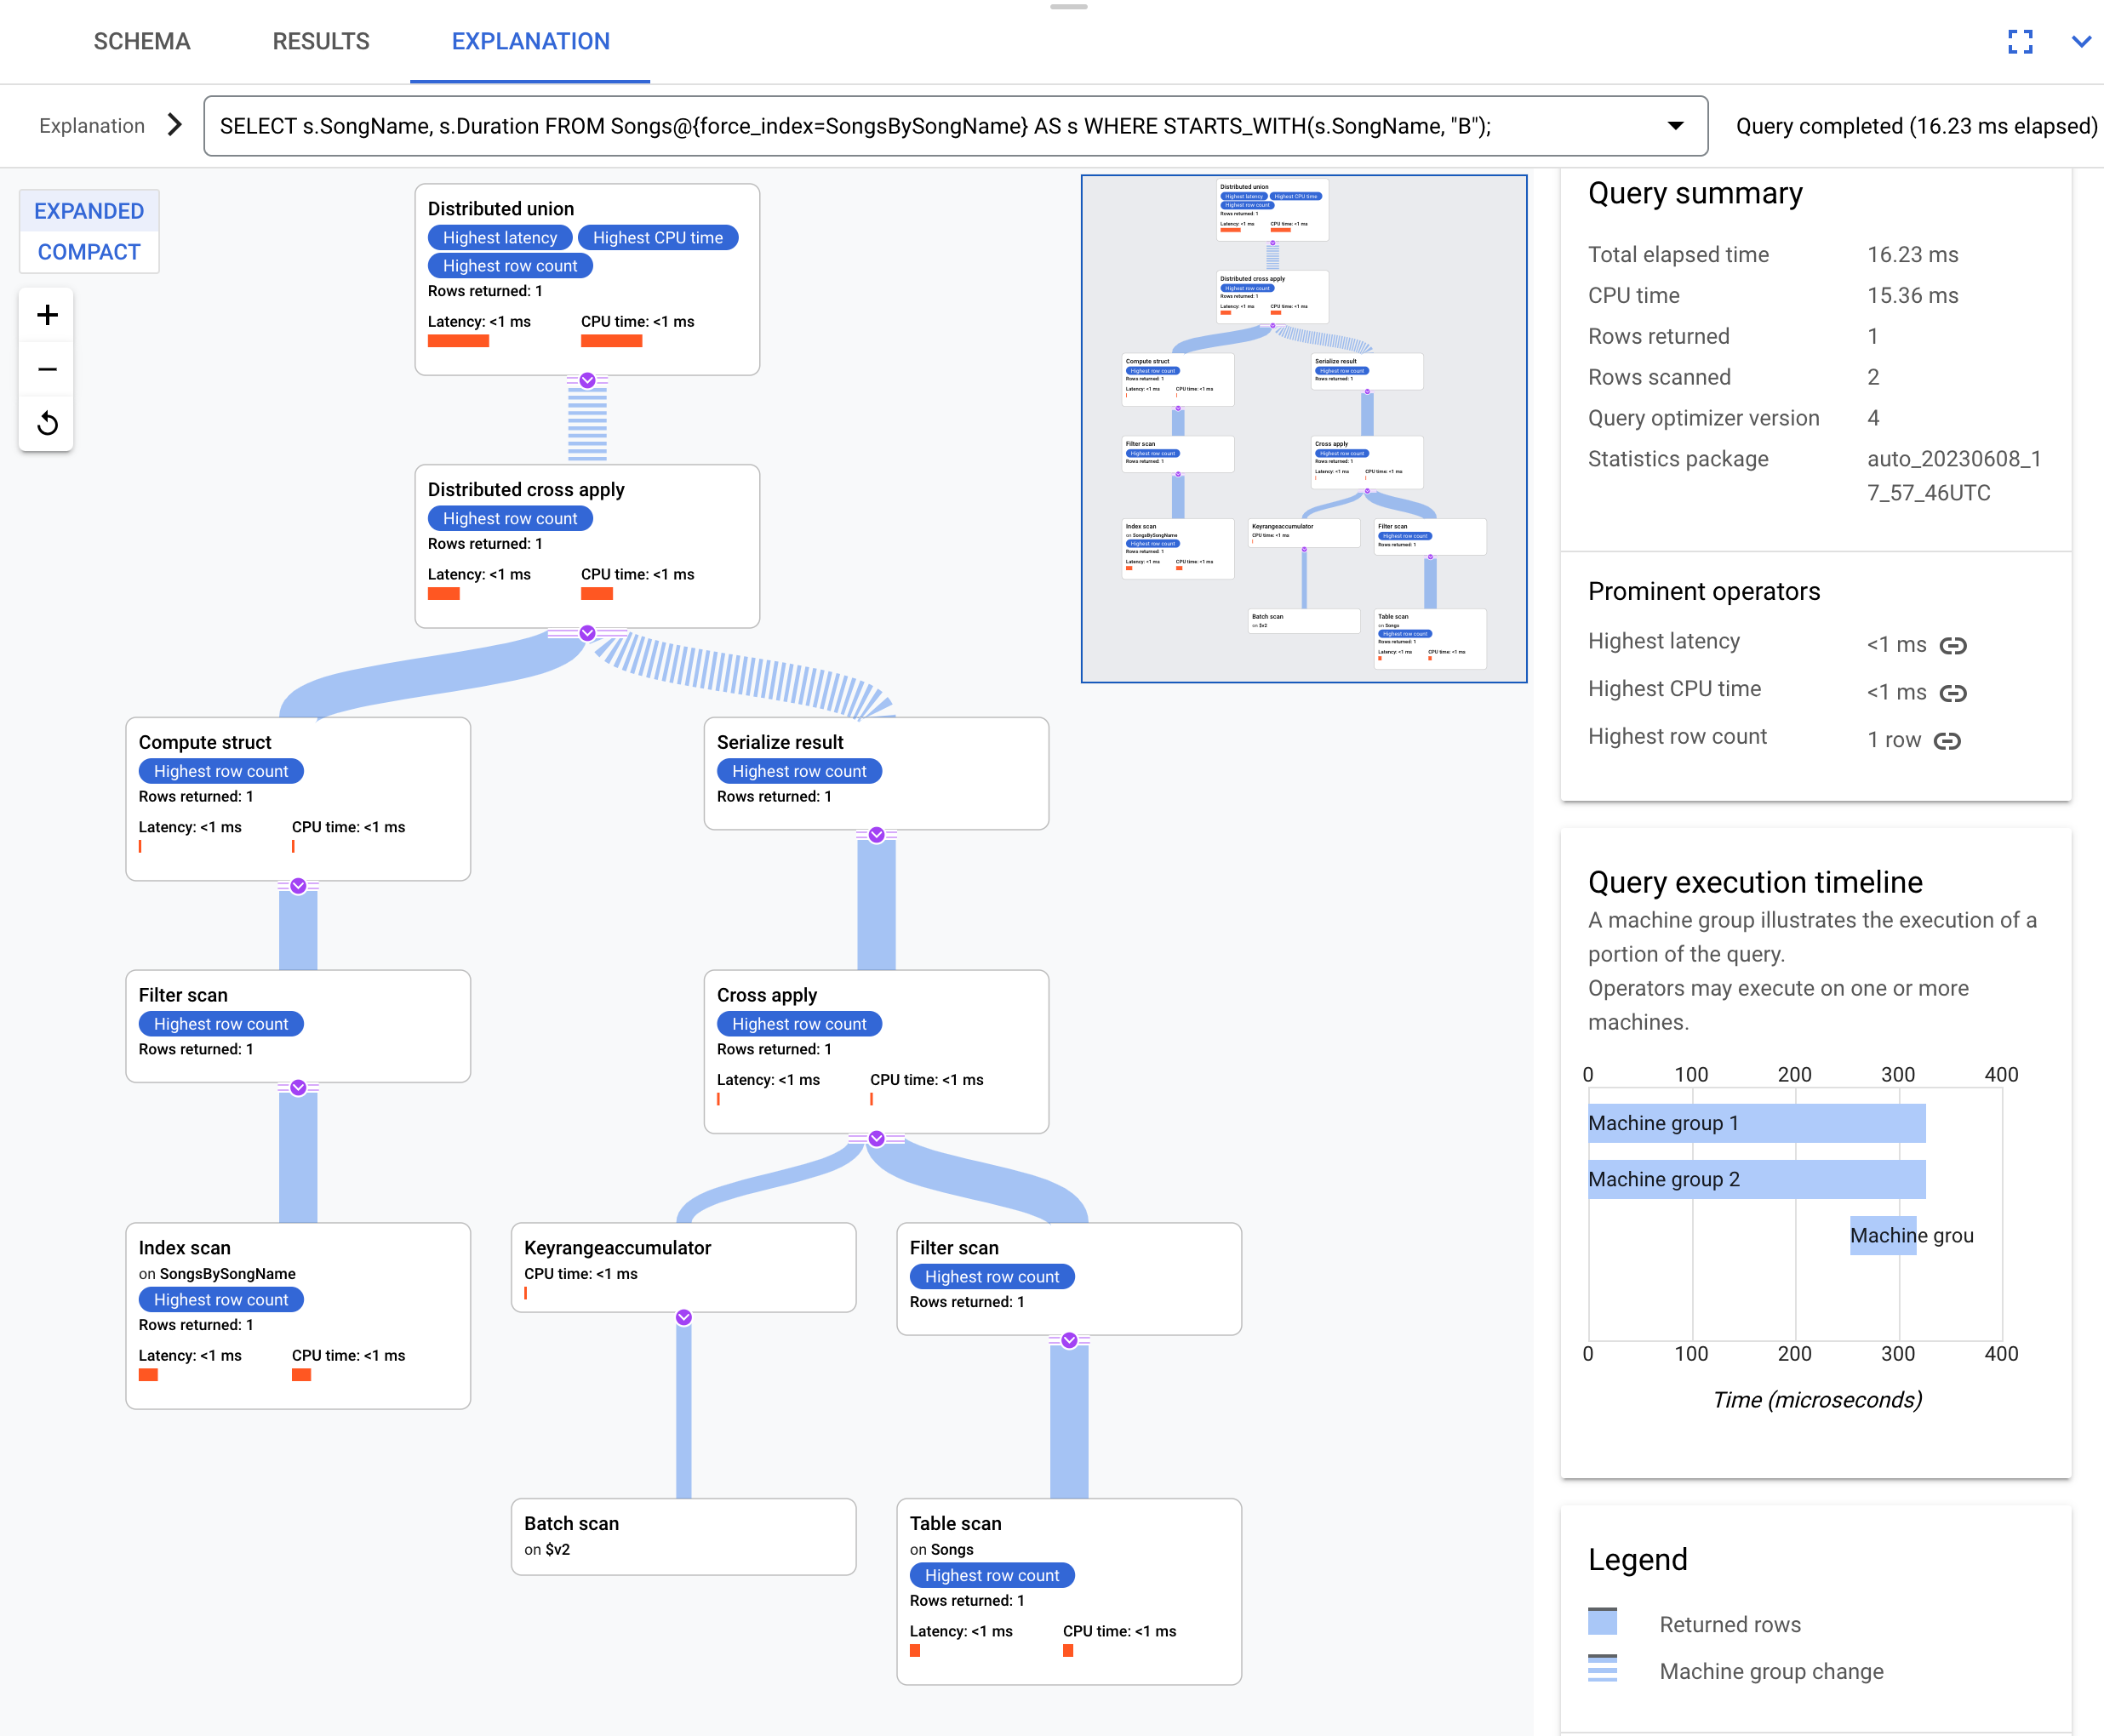
תוכנית הביצוע שנוצרת היא מורכבת כי האינדקס SongsBySongName לא מכיל את העמודה Duration. כדי לקבל את הערך של Duration, Spanner מבצע איחוד חוזר של התוצאות שנוספו לאינדקס עם הטבלה Songs. זוהי פעולת JOIN, אבל היא לא ממוקמת באותו מקום כי הטבלה Songs והאינדקס הגלובלי SongsBySongName לא משולבים. אם הנתונים לא נמצאים באותו מיקום, Spanner מבצע אופטימיזציות כדי להאיץ את הביצוע. האופטימיזציות האלה הופכות את תוכנית הביצוע למורכבת יותר מהדוגמה הקודמת של איחוד באותו מיקום.
האופרטור העליון הוא distributed cross apply. צד הקלט של האופרטור הזה מקבל קבוצות של שורות מהאינדקס SongsBySongName שעומדות בתנאי STARTS_WITH(s.SongName, "B"). לאחר מכן, האופרטור distributed cross apply ממפה את הקבוצות האלה לשרתים מרוחקים שמכילים פיצולים עם הנתונים של Duration. כדי לאחזר את העמודה Duration, השרתים המרוחקים מבצעים סריקה של הטבלה. הסריקה הזו משתמשת בתנאי הסינון Condition:($Songs_key_TrackId' = $batched_Songs_key_TrackId), שמצרף את TrackId מהטבלה Songs לעמודות TrackId של השורות שנאספו מהאינדקס SongsBySongName.
Spanner צובר את התוצאות לתשובה הסופית של השאילתה.
בצד הקלט של האופרטור distributed cross apply יש צמד distributed union או local distributed union כדי להעריך שורות מהאינדקס שעומדות בתנאי של הפרדיקט STARTS_WITH.
כדאי לשקול שאילתה קצת שונה שלא בוחרת את העמודה s.Duration:
GoogleSQL
SELECT s.SongName
FROM Songs@{force_index=SongsBySongName} AS s
WHERE STARTS_WITH(s.SongName, "B");
PostgreSQL
SELECT s.SongName
FROM Songs /*@ force_index=SongsBySongName */ AS s
WHERE STARTS_WITH(s.SongName, "B");
בתוכנית ההפעלה הבאה אפשר לראות שהשאילתה הזו משתמשת באינדקס באופן מלא:
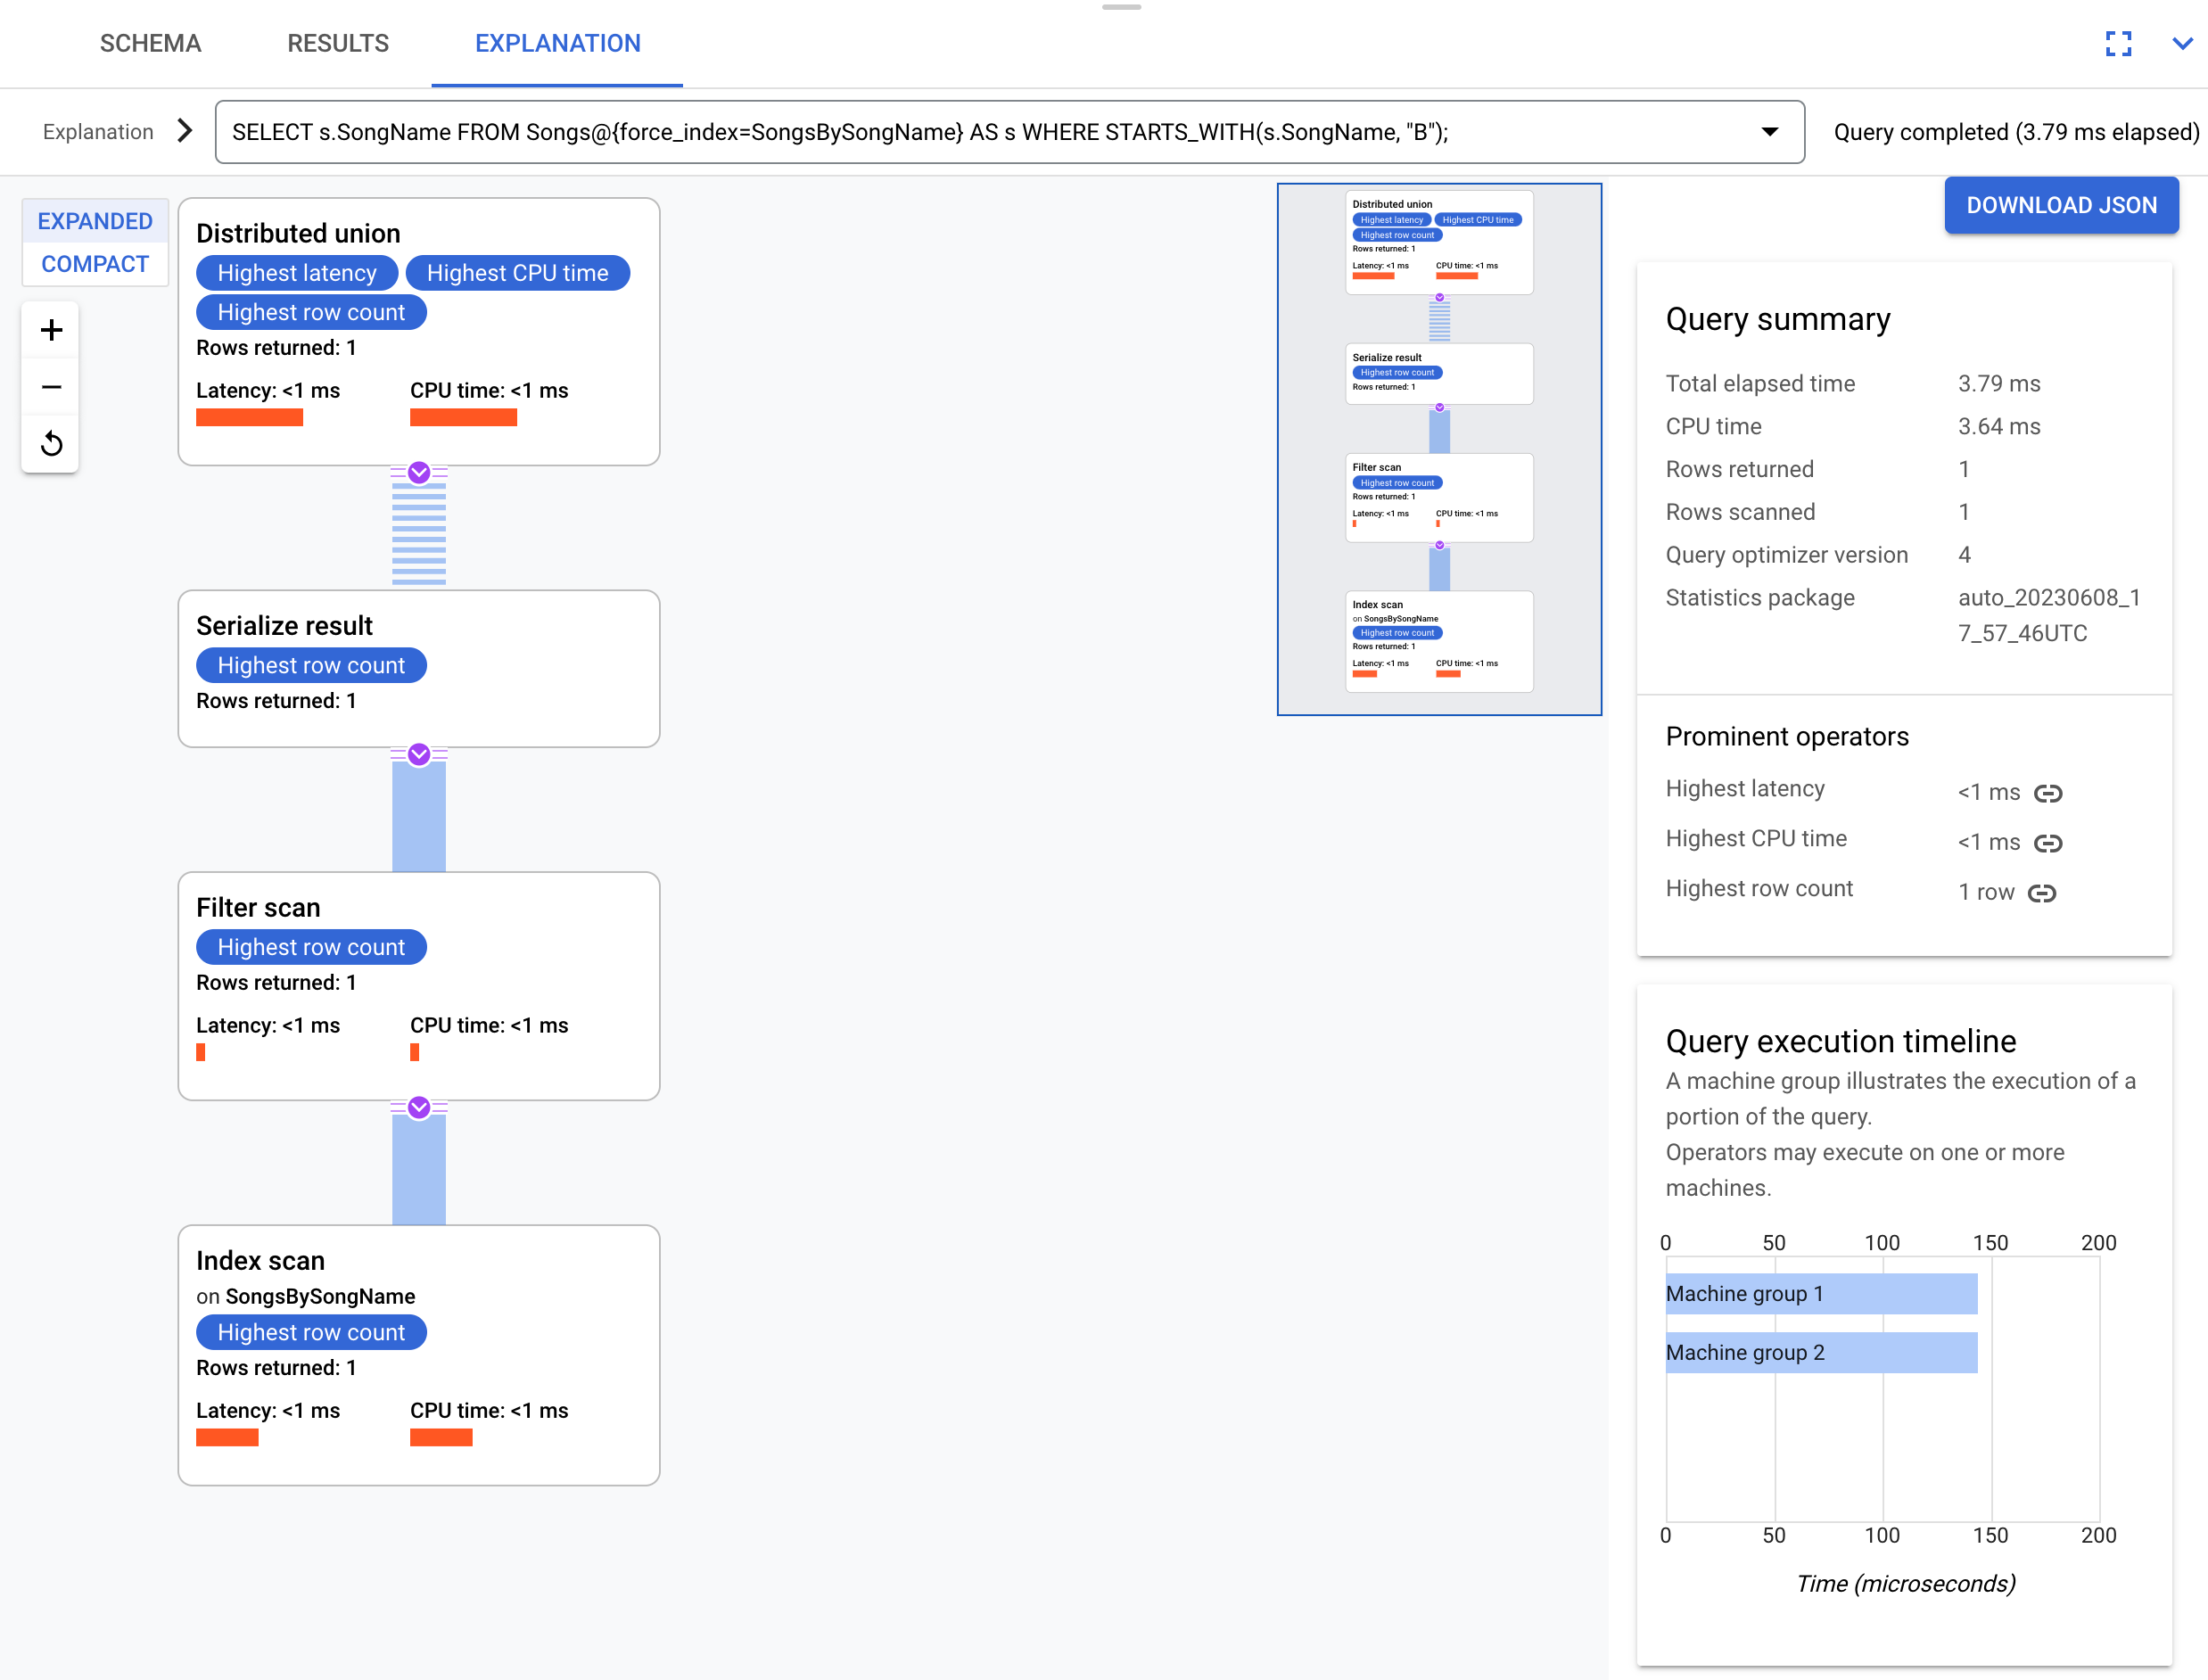
תוכנית הביצוע לא דורשת back join כי האינדקס מכיל את כל העמודות שהשאילתה מבקשת.
סריקה רציפה לעומת חיפושים מפוזרים
קריאה של טווח שורות רציף מהירה משמעותית מקריאה של אותו מספר שורות מפוזרות.
לדוגמה, השאילתה הבאה מסכמת את משך הזמן של שירים של קבוצת זמרים מסוימת. השאילתה הזו מבצעת חיפושים לכל מזהה זמר שצוין. כדי לראות כמה חיפושים בוצעו בשאילתה, אפשר לעיין בנתון הסטטיסטי Seek count.
SELECT SUM(Duration)
FROM Songs
WHERE SingerId IN (1, 3, 9, 10, 15);
עם זאת, אם תבנו את השאילתה כך שתקרא רצף רציף של מזהי זמרים, תוכלו לשפר את הביצועים על ידי ביצוע קריאה רציפה של הטבלה Songs. הטבלה Songs מכילה את SingerId כחלק מהמפתח הראשי שלה.
SELECT SUM(Duration)
FROM Songs
WHERE SingerId BETWEEN 1 AND 5;
ההבדל הזה רלוונטי כשבוחרים שיטת איחוד וכשמקבלים החלטות לגבי עיצוב הסכימה, כמו בחירת מפתח ראשי. למידע נוסף על בחירת שיטת איחוד, ראו איך איחודים פועלים עם סריקות.
שיתוף איחודים מבוזרים
לכל טבלה או אינדקס בשאילתה חייב להיות אופרטור מבוזר תואם.
האופרטור הזה הוא distributed union או distributed apply. אם שתי טבלאות או שני אינדקסים משולבים באותו הורה, יכול להיות שהאופטימיזציה של השאילתות תשתמש באופרטור distributed union אחד לשתי הטבלאות או לשני האינדקסים.
המאמרים הבאים
- מידע על אופרטורים להרצת שאילתות
- מידע ולמידה על הכלי לאופטימיזציה של שאילתות ב-Spanner
- איך מנהלים את הכלי לאופטימיזציה של שאילתות