


אתם יכולים להשתמש בהקצאת משאבים דינמית (DRA) כדי להקצות מעבדי GPU לעומסי העבודה שלכם ב-Google Kubernetes Engine (GKE). במאמר הזה מוסבר מהו DRA, איך משתמשים ב-DRA ב-GKE ומהם היתרונות של השימוש ב-DRA.
המסמך הזה מיועד לתפקידים הבאים:
- אדמינים של פלטפורמות שרוצים לצמצם את המורכבות והתקורה של הגדרת תשתית עם מכשירי חומרה ייעודיים.
- מפעילי אפליקציות ומהנדסי מערכות מידע שמריצים עומסי עבודה כמו AI/ML או מחשוב עתיר ביצועים (HPC).
כדאי להכיר את הנושאים הבאים:
מבוא ל-DRA
DRA הוא פיצ'ר מובנה של Kubernetes שמאפשר לבקש, להקצות ולשתף באופן גמיש חומרה באשכול בין קבוצות Pod וקונטיינרים. ה-DRA משפר את חוויית ההקצאה של חומרה מצורפת, כמו מאיצים, בכך שהוא מאפשר לספקי מכשירים ולמנהלי פלטפורמות להצהיר על מחלקות של מכשירים שאפשר לבקש ולהקצות. מפעילי אפליקציות יכולים לבקש הגדרות ספציפיות למכשירים במחלקות האלה, ואז לבקש את ההגדרות האלה בעומסי העבודה שלהם. Kubernetes ו-GKE מנהלים את התזמון של Pod, את ההקצאות של הצמתים ואת ההקצאה של המכשירים על סמך בקשות לעומסי עבודה.
לדוגמה, אדמין של פלטפורמה יכול להגדיר סוג מכשיר שיש בו רק כרטיסי GPU מסוג NVIDIA A100. מפעילים של אפליקציות יכולים לסנן את המכשירים בקטגוריית המכשירים הזו על סמך דרישות עומס העבודה, למשל סינון של זיכרון GPU בנפח של 80 GB לפחות. כשמפעיל האפליקציה פורס עומס עבודה שמבקש את ההגדרה המסוננת, GKE ממקם את ה-Pods בצמתים שעומדים בקריטריונים שנבחרו. בדוגמה הזו, מערכת GKE מוצאת צמתים עם מעבדי GPU מסוג A100 (80 GB) שזמינים. מפעיל האפליקציה לא צריך לבחור צמתים ספציפיים או הגדרות מכשיר ספציפיות במניפסט של עומס העבודה.
היתרונות של DRA
בלי DRA, הקצאת מכשירי חומרה ב-Kubernetes מסתמכת על פלאגינים של מכשירים. כדי לצרף משאבי חומרה ל-Pods באמצעות פלאגינים של מכשירים, משתמשים בתוויות של צמתים כדי להציב Pods בצמתים ספציפיים. בנוסף, כדי להקצות את כל המשאבים של צומת לפוד אחד, צריך לבקש את המספר המדויק של המכשירים שמחוברים לצמתים.
ב-DRA, הקצאת מכשירים ל-Pods דומה להקצאת אמצעי אחסון. אתם מגדירים מחלקות של מכשירים, מבקשים מכשירים במחלקות האלה ואז מקצים את המכשירים המבוקשים לעומסי עבודה. ה-DRA מספק ממשק הרבה יותר גמיש לסינון מכשירים לפי עומס העבודה והצרכים העסקיים. לגישת ה-DRA, שבה משתמשים בביטויים ובתבניות כדי לתבוע חומרה ולתזמן Pods, יש את היתרונות הבאים:
- הקצאת מכשירים באופן הצהרתי: אדמינים של פלטפורמות יכולים להגדיר מכשירים לסוגים ספציפיים של עומסי עבודה או צוותים.
- מורכבות מופחתת בין צוותים: כשמנהלי פלטפורמה מקצים צמתים עם הגדרות חומרה מיוחדות, מפעילים של אפליקציות לא צריכים לדעת אילו צמתים כוללים הגדרות ספציפיות. אדמינים של פלטפורמות לא צריכים להוסיף תוויות לצמתים או להעביר למפעילים מידע על צמתים ומכשירים ספציפיים.
- מורכבות מופחתת למפתחים: מערכת Kubernetes מתזמנת את ה-Pods על סמך הגדרת מכשיר הבדיקה הווירטואלי שאליה מתבצעת הפניה. מפעילי האפליקציות לא צריכים לבחור צמתים ספציפיים בעומסי העבודה שלהם, וגם לא צריכים לוודא שכל Pod מבקש בדיוק את מספר המכשירים שמחוברים לצמתים האלה.
- ניהול תשתית ריכוזי: מנהלי פלטפורמות יכולים להגדיר באופן ריכוזי הגדרות חומרה שעומדות בדרישות עסקיות ספציפיות. לדוגמה, מנהל פלטפורמה יכול להצהיר על הגדרה עם ביצועים גבוהים שכוללת מעבדי GPU מסוג H100, לצד הגדרה קטנה של הסקת מסקנות שכוללת מעבדי GPU מסוג Tesla T4.
- בחירת חומרה גמישה: אתם יכולים להשתמש בביטויי CEL כדי לסנן מכשירים עם מאפיינים ספציפיים. השימוש בביטויים מאפשר לסנן מכשירים שמתאימים לעומסי עבודה ספציפיים.
מתי כדאי להשתמש ב-DRA
הסיבה העיקרית לשימוש ב-DRA ב-GKE היא הגמישות שבה אפשר לבקש מכשירים לעומסי עבודה. אתם יכולים לכתוב מניפסט פעם אחת ולפרוס את עומס העבודה באשכולות שונים עם סוגי מכשירים שונים, בלי לשנות את המניפסט. הגמישות הזו אידיאלית לתרחישים לדוגמה כמו:
- שיפור הגמישות, היעילות והזמינות של קיבולת המחשוב של ה-GPU: כדי לעבד עומסי עבודה שזקוקים לגישה לחומרת GPU, אפשר להשתמש ב-DRA כדי לבקש כל GPU שזמין באשכול, במקום לציין דגם GPU. אם לעומסי העבודה האלה יש דרישות ספציפיות לזיכרון GPU (VRAM), אתם יכולים לבקש כל GPU באשכול שיש לו כמות מינימלית של זיכרון. סוג הבקשה הגמישה הזה מרחיב את קבוצת צמתי ה-GPU שעומס עבודה יכול לפעול בהם, וכך מצמצם את הסיכון לכך שעומס העבודה לא יתוזמן בגלל משאבים לא זמינים.
אופטימיזציה של זמינות הצמתים במהלך שינוי קנה המידה: מספר המכשירים שעומס העבודה דורש עשוי להשתנות בהתאם לגורמים כמו סוג המכשיר והיכולות שלו. אתם יכולים להשתמש ב-ComputeClasses של GKE כדי להציב פודים מואצים במאגרי צמתים ספציפיים, בהתאם לזמינות המכשירים. אחר כך אפשר להגדיר את ה-Pods כך שיקבלו את המכשירים בכל צומת שבו GKE מציב את ה-Pods.
שימוש ב-DRA עם ComputeClasses מאפשר לכם לצמצם את הסיכון של עומסי עבודה לא מתוזמנים, וגם עוזר לכם להריץ עומסי עבודה על חומרה שעברה אופטימיזציה.
הסברים על המונחים
ב-Kubernetes בקוד פתוח ובספקי Kubernetes מנוהלים כמו GKE, משתמשים בסוגים הבאים של ממשקי API של DRA:
- ResourceSlice
- ב-ResourceSlice מפורטים מכשירי חומרה אחד או יותר באשכול שהצמתים יכולים לגשת אליהם. לדוגמה, בצומת שיש לו גישה ל-GPU יחיד, ה-ResourceSlice מפרט את ה-GPU ואת שם הצומת. מנהלי ההתקנים של DRA בכל צומת יוצרים ResourceSlices. המתזמן של Kubernetes משתמש ב-ResourceSlices כדי להחליט אילו מכשירים להקצות כדי לענות על בקשות של עומסי עבודה.
- DeviceClass
-
DeviceClass מגדיר קטגוריה של מכשירים, כמו GPUs, שאפשר לבקש עבור עומסי עבודה.
חלק ממנהלי ההתקנים של המכשירים מספקים DeviceClasses מובנים, כמו
gpu.nvidia.comDeviceClass עבור GPU של NVIDIA. אדמינים של הפלטפורמה יכולים גם ליצור DeviceClasses בהתאמה אישית שמגדירים תצורות ספציפיות של מכשירים. - ResourceClaim
-
בעזרת ResourceClaim, פוד או משתמש יכולים לבקש משאבי חומרה על ידי סינון לפי פרמטרים מסוימים ב-DeviceClass. כשעומס עבודה מפנה ל-ResourceClaim, Kubernetes מקצה מכשירים שתואמים לפרמטרים שצוינו ב-ResourceClaim הזה.
לדוגמה, נניח שאתם יוצרים ResourceClaim ל-GPU אחד מסוג A100 (40GB) ואז פורסים עומס עבודה שבוחר את ה-ResourceClaim הזה. Kubernetes מקצה GPU מסוג A100 (40 GB) שזמין ל-ResourceClaim ומתזמן את ה-Pod שלכם בצומת שיכול לגשת ל-GPU הזה.
- ResourceClaimTemplate
-
ResourceClaimTemplate מגדיר תבנית ש-Pods יכולים להשתמש בה כדי ליצור באופן אוטומטי ResourceClaim חדש לכל Pod. תבניות ResourceClaimTemplates שימושיות כשרוצים להקצות כמה עומסי עבודה שזקוקים לגישה להגדרות דומות של מכשירים, במיוחד כשמשתמשים בבקר עומסי עבודה כמו Deployments או StatefulSets.
מפעילי האפליקציות פורסים את ResourceClaimTemplates ואז מפנים לתבניות בעומסי העבודה. Kubernetes יוצר ResourceClaims לכל Pod על סמך התבנית שצוינה, מקצה מכשירים ומתזמן את ה-Pods. כשמפסיקים את השימוש ב-Pods, Kubernetes מנקה את ה-ResourceClaims המתאימים.
למידע נוסף על סוגי DRA API, ראו טרמינולוגיה של DRA.
איך פועלת ההגדרה "הקצאת משאבים דינמית" (DRA)
השימוש ב-DRA באשכולות ובעומסי העבודה דומה לשימוש ב-StorageClasses, ב-PersistentVolumeClaims וב-PersistentVolumes כדי להקצות נפחים באופן דינמי ל-Pods.
בתרשים הבא מוצגים השלבים שמנהלי אשכולות ומפעילי אפליקציות מבצעים כדי להקצות מכשירים באמצעות DRA:
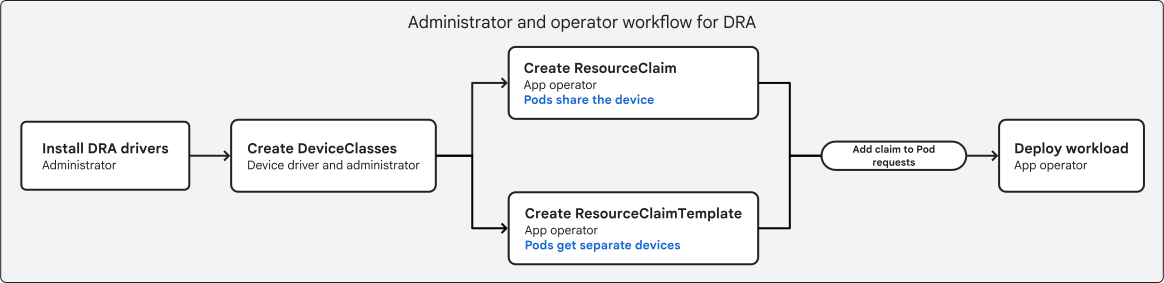
בתרשים הזה, מנהלי האשכולות ומפעילי האפליקציות מבצעים את הפעולות הבאות:
- מנהלי אשכולות מתקינים מנהלי התקנים שתומכים ב-DRA בצמתים.
- מנהלי אשכולות יוצרים DeviceClasses שמסננים חומרה שעומדת בדרישות ספציפיות, כמו כל ה-GPU עם יותר מ-40GB זיכרון. בחלק מהמכשירים יכולות להיות גם DeviceClasses מובנות.
- מפעילי אפליקציות יוצרים ResourceClaimTemplates או ResourceClaims שמבקשים הגדרות של מכשירים. תרחיש השימוש העיקרי לכל סוג של תלונה הוא:
- האובייקט ResourceClaim מאפשר לכמה פודים לשתף גישה לאותו מכשיר.
- ResourceClaimTemplate מאפשר לכמה Pods לגשת למכשירים נפרדים ודומים על ידי יצירה אוטומטית של ResourceClaims לכל Pod.
- אופרטורים של אפליקציות מוסיפים את ResourceClaimTemplates או ResourceClaims למניפסטים של עומסי העבודה שלהם.
- מפעילי האפליקציה פורסים את עומס העבודה.
כשפורסים עומס עבודה שמפנה אל ResourceClaimTemplate או אל ResourceClaim, Kubernetes מבצע את שלבי התזמון הבאים:
- אם עומס העבודה מפנה אל ResourceClaimTemplate, Kubernetes יוצר אובייקט
ResourceClaimחדש לכל מופע של עומס העבודה (לדוגמה, כל רפליקה ב-Deployment). - מתזמן Kubernetes משתמש ב-ResourceSlices באשכול כדי להקצות מכשירים זמינים שעומדים בדרישות לכל ResourceClaim של Pod.
- המתזמן ממקם כל Pod בצומת שיש לו גישה למכשירים שהוקצו ל-ResourceClaim של ה-Pod.
- ה-
kubeletבצומת היעד קורא למנהל ההתקן של ה-DRA בצומת כדי לצרף את החומרה שהוקצתה ל-Pod, כדי למלא את בקשת המשאבים שלו.
מתי להשתמש ב-ResourceClaims וב-ResourceClaimTemplates
אפשר להשתמש ב-ResourceClaims או ב-ResourceClaimTemplates כדי לציין ל-Kubernetes שאתם רוצים מכשירים שעומדים בדרישות ספציפיות. כשמפנים אל ResourceClaim ב-Pod, Kubernetes מקצה מכשירים למשאב ה-API המתאים ResourceClaim בשרת ה-API של Kubernetes. ההקצאה הזו מתבצעת בין אם יצרתם את ResourceClaim או ש-Kubernetes יצר את ResourceClaim מ-ResourceClaimTemplate.
אם יוצרים ResourceClaim ואז מפנים אליו בכמה Pods, כל ה-Pods האלה יכולים לגשת למכשירים ש-Kubernetes מקצה ל-ResourceClaim הזה. לדוגמה, גישה משותפת כזו יכולה לקרות אם מפנים אל ResourceClaim ספציפי במניפסט של פריסה שיש לו כמה עותקים. עם זאת, אם המכשירים שהוקצו לא מוגדרים לשיתוף על ידי כמה תהליכים, הגישה המשותפת הזו למכשירים בין Pods עלולה לגרום להתנהגות לא מכוונת.
כדי להקצות מכשירים נפרדים ל-Pods, אפשר להשתמש ב-ResourceClaimTemplate, שהיא תבנית ש-Kubernetes משתמש בה כדי ליצור באופן אוטומטי ResourceClaims נפרדים. לדוגמה, אם מפנים ל-ResourceClaimTemplate ב-Deployment שיש לו כמה רפליקות, Kubernetes יוצר ResourceClaim נפרד לכל Pod משוכפל. כתוצאה מכך, כל Pod מקבל מכשיר משלו שהוקצה לו, במקום לחלוק את הגישה למכשיר עם Pods אחרים. ה-ResourceClaims שנוצרים אוטומטית קשורים למשך החיים של ה-Pod התואם, ונמחקים כשה-Pod מסתיים. אם יש לכם פודים עצמאיים שצריכים גישה להגדרות מכשיר דומות, אתם יכולים להשתמש ב-ResourceClaimTemplate כדי להקצות מכשירים לכל פוד בנפרד.
בטבלה הבאה מתוארים כמה הבדלים בין יצירה ידנית של ResourceClaims לבין יצירה של ResourceClaims על ידי Kubernetes מ-ResourceClaimTemplate:
| ResourceClaims שנוצרו באופן ידני | תלונות על הפרת זכויות יוצרים שנוצרו באופן אוטומטי |
|---|---|
| בניהול שלכם | מנוהל על ידי Kubernetes |
| מאפשר גישה לאותם מכשירים מכמה תרמילים | נותן גישה למכשירים מ-Pod אחד |
| קיים באשכול באופן עצמאי מ-Pods | הם קשורים למחזור החיים של ה-Pod המתאים |
| אידיאלי לכמה עומסי עבודה שצריכים לשתף מכשיר ספציפי | מתאים למספר עומסי עבודה שצריכים גישה עצמאית למכשיר |
השוואה בין DRA לבין הקצאת מכשירים ידנית
הקצאת מכשירים מחוברים באמצעות DRA דומה להקצאה דינמית של PersistentVolumes. ב-Kubernetes יש גם תמיכה בהקצאת מכשירים באמצעות פלאגינים למכשירים. השיטה הזו כוללת את השלבים הבאים:
- אדמין של אשכול יוצר צמתים עם מכשירים מצורפים, כמו יחידות GPU.
- מנהל האשכול מעביר מידע על צמתים ספציפיים והמכשירים שמחוברים אליהם למפעילי עומסי העבודה.
- מפעיל של עומס עבודה מבקש מכשירים במניפסט של עומס העבודה באופן הבא:
- בוחרים צומת עם הגדרת המכשיר הנדרשת, כמו מודל ה-GPU, באמצעות השדה
nodeSelector. - מציינים את מספר המכשירים המדויק שהקונטיינרים צריכים לצרוך באמצעות השדה
resourcesבמפרט ה-Pod.
- בוחרים צומת עם הגדרת המכשיר הנדרשת, כמו מודל ה-GPU, באמצעות השדה
בשיטת ההקצאה הידנית הזו, מפעילי האפליקציות ומנהלי האשכולות צריכים לתקשר ביניהם לגבי הצמתים או מאגרי הצמתים הספציפיים שיש להם הגדרות מסוימות של מכשירים. הם צריכים לתאם את בקשות עומסי העבודה כך שיתאימו למכשירים בצמתים, אחרת הפריסה תיכשל. לעומת זאת, ב-DRA אפשר להשתמש בביטויים כדי לסנן מכשירים בצורה גמישה על סמך מאפיינים, ומפעילי עומסי העבודה לא צריכים לדעת את ההגדרות המדויקות של הצמתים באשכול.
בטבלה הבאה מוצגת השוואה בין DRA לבין תוספים למכשירים:
| DRA | הקצאה ידנית |
|---|---|
| בחירת מכשירים גמישה באמצעות ביטויי CEL | בחירת צומת ספציפי באמצעות בוררים ובקשות משאבים |
| החלטות תזמון שמתקבלות על ידי Kubernetes | החלטות לגבי תזמון שהמפעיל מקבל באמצעות בוררי צמתים |
| סינון המכשירים נפרד מיצירת עומס העבודה | צריך לבצע סינון מכשירים במניפסט של עומס העבודה |
| סינון מכשירים מרוכז ושיעורים לפי צרכים, בניהול של מנהלי הפלטפורמה | סינון מכשירים מבודדים לפי אופרטורים של אפליקציות |
| מפעילי האפליקציות לא צריכים לדעת את קיבולת הצומת, את פרטי התווית של הצומת או את דגמי המכשירים המחוברים לכל צומת | מפעילי האפליקציות צריכים לדעת לאילו צמתים מחוברים דגמים ספציפיים וכמויות מסוימות של מכשירים מסוימים. |
התאמה אוטומטית של התשתית (autoscaling) ו-DRA
כדי לשנות באופן אוטומטי את מספר הצמתים במאגר צמתים במצב רגיל, משתמשים ב-Cluster Autoscaler. אתם יכולים להפעיל את המידרוג האוטומטי של אשכולות בכל מאגר צמתים שנוצר באופן ידני, כולל מאגרי צמתים עם מנהלי התקנים של DRA.
במאגרי צמתים שמשתמשים ב-DRA, ניצול המכשיר משפיע על האופן שבו Cluster Autoscaler מוסיף ומסיר צמתים במאגר צמתים. כדי לחשב את ניצול המכשיר במאגר צמתים, הכלי Cluster Autoscaler מתחשב בגורמים הבאים:
- כל המכשירים במאגר משאבים צריכים להיות מקומיים לצומת ספציפי. אם ל-ResourceSlice יש מאגר של מכשירים שמחוברים לכמה צמתים, מידרוג אוטומטי של אשכולות מתעלם מהמכשירים האלה.
- לכל המכשירים במאגר הצמתים יש חשיבות זהה והם זהים.
- למכשירי DRA יש עדיפות גבוהה יותר מאשר למעבד (CPU) או לזיכרון. במאגרי צמתים של DRA, המידרוג האוטומטי של האשכול מתעלם מהשימוש במעבד ובזיכרון.
הגורמים האלה יכולים להוביל לכך שתבחינו בהתנהגות שונה של הקטנת הקיבולת במאגרי צמתים של DRA בהשוואה למאגרי צמתים אחרים.
מכשירי GKE נתמכים ל-DRA
בטבלה הבאה מתוארים המכשירים שאפשר להקצות לעומסי עבודה באמצעות DRA ב-GKE:
| מכשירים שנתמכים ב-DRA | |
|---|---|
| GPUs | כל סוג GPU שזמין במיקום שלכם. מידע נוסף זמין במאמר מיקומי GPU. |
| ממשקי רשת | ממשקי רשת מסוגים שונים, כמו ממשקים עם תמיכה ב-RDMA, על ידי התקנת מנהל ההתקן המנוהל של DRANET. מידע נוסף זמין במאמר הקצאת משאבי רשת באמצעות DRANET שמנוהל על ידי GKE. |
מגבלות
המגבלות הבאות חלות כשמשתמשים ב-DRA:
מצב הפעולה: DRA זמין רק באשכולות במצב רגיל.
סוג המאיץ: DRA ב-GKE תומך רק במעבדי GPU.
GPUs:
- אי אפשר להשתמש במעבדי GPU עם שיתוף זמן, במעבדי GPU עם כמה מופעים במקביל או ב-Multi-Process Service (MPS).
- בצמתים שמשתמשים במנהלי ההתקנים של DRA GPU, אי אפשר להשתמש בחבילת המדדים המנוהלת של NVIDIA Data Center GPU Manager (DCGM) כדי לשלוח מדדי DCGM ל-Cloud Monitoring.
- הדרייבר של ה-GPU עבור DRA הוא בבעלות NVIDIA, ולא בבעלות GKE. מידע נוסף זמין במאמרי העזרה של NVIDIA.
ממשקי רשת: ראו מגבלות במאמר "הקצאת משאבי רשת באמצעות DRANET בניהול GKE".
התאמה אוטומטית לעומס:
- אם אתם מתקינים מנהלי התקנים של DRA של צד שלישי, כדי להשתמש ב-cluster autoscaler צריך להיות לפחות צומת אחד במאגרי הצמתים. כדי למנוע ממאגרי צמתים שמשתמשים במנהלי התקנים של צד שלישי לצמצם את הפעולה לאפס צמתים, צריך להגדיר את המספר המינימלי של הצמתים ל-
1לפחות. - יכול להיות שהמידרוג האוטומטי של האשכול לא יפעל כמו שצריך עם מנהלי התקנים של DRA של צד שלישי. אם אתם משתמשים במנהלי התקנים של צד שלישי, ודאו שהם מפרסמים מידע רק על מכשירים מקומיים לצמתים ספציפיים.
- ב-DaemonSets במאגרי צמתים עם התאמה אוטומטית לעומס שמשתמשים ב-ResourceClaim סטטי כדי לשתף גישה למכשירים בין Pods, ההתאמה האוטומטית לעומס תומכת בעד 128 Pods של DaemonSet. כדי לעקוף את ההגבלה הזו, אפשר לבצע אחת מהפעולות הבאות:
- כדי למנוע ממאגר הצמתים לגדול ליותר מ-128 צמתים, מגדירים את המספר המקסימלי של צמתים.
- משתמשים בשדה
adminAccess(בטא) ב-ResourceClaim, שמאפשר ל-DaemonSet לגשת למכשירים שנמצאים בשימוש.
- אם הפודים מפנים ל-ResourceClaims ויש להם PriorityClass שמגדיר את מדיניות ההפסקה הזמנית ל-
PreemptLowerPriority, יכול להיות שזמן הטעינה של ההתאמה האוטומטית לעומס יתארך. PreemptLowerPriorityהיא מדיניות ההפקעה שמוגדרת כברירת מחדל ל-PriorityClass, לכן צריך לוודא שב-PriorityClasses השדהpreemptionPolicyמוגדר במפורש ל-Never. מידע נוסף מופיע במאמר בנושא PriorityClass שלא מאפשר קדימה.
- אם אתם מתקינים מנהלי התקנים של DRA של צד שלישי, כדי להשתמש ב-cluster autoscaler צריך להיות לפחות צומת אחד במאגרי הצמתים. כדי למנוע ממאגרי צמתים שמשתמשים במנהלי התקנים של צד שלישי לצמצם את הפעולה לאפס צמתים, צריך להגדיר את המספר המינימלי של הצמתים ל-
מיומנויות מומלצות להבנה ולשימוש ב-DRA
בקטע הזה מפורטות המלצות לאדמינים של פלטפורמות או למפעילים של אפליקציות שרוצים להשתמש ב-DRA כדי להקצות מכשירים לעומסי עבודה. ה-DRA משנה באופן משמעותי את השיטה שבה מבקשים מכשירים מחוברים, גם ב-GKE וגם ב-Kubernetes. כדי ליהנות מתרחישי שימוש מתקדמים יותר, כמו חלופות בין מכשירים או סינון ובחירה של מכשירים ברמה מפורטת, כדאי לפעול לפי ההנחיות הבאות:
למידה של CEL: באמצעות DRA, אתם יכולים להשתמש בביטויי CEL כדי לבצע סינון מפורט של מכשירים בבקשות להקצאת משאבים וב-DeviceClasses. מקורות המידע הבאים יכולים לעזור לכם ללמוד את CEL:
מידע על ComputeClasses ב-GKE: אפשר להשתמש ב-ComputeClasses עם DRA כדי לענות על צרכים עסקיים כמו הקצאת VM במודל Spot להרצת עומסי עבודה של הסקת מסקנות שמבקשים יחידות GPU חסכוניות. אפשר להיעזר במקורות המידע הבאים כדי לקבל מידע על ComputeClasses: