


É possível usar a alocação dinâmica de recursos (DRA, na sigla em inglês) para alocar GPUs às cargas de trabalho do Google Kubernetes Engine (GKE). Este documento explica os fundamentos da DRA, como usá-la no GKE e os benefícios de usar a DRA.
Este documento é destinado às seguintes funções:
- Administradores de plataforma que querem reduzir a complexidade e o overhead da configuração de infraestrutura com dispositivos de hardware especializados.
- Operadores de apps e engenheiros de dados que executam cargas de trabalho como IA/ML ou computação de alto desempenho (HPC).
Você já precisa estar familiarizado com o seguinte:
Introdução à DRA
A DRA é um recurso integrado do Kubernetes que permite solicitar, alocar e compartilhar hardware de maneira flexível no cluster entre pods e contêineres. A DRA melhora a experiência de alocação de hardware anexado, como aceleradores, permitindo que fornecedores de dispositivos e administradores de plataforma declarem classes de dispositivos que podem ser solicitados e alocados. Os operadores de apps podem solicitar configurações de dispositivos específicos nessas classes e, em seguida, solicitar essas configurações nas cargas de trabalho. O Kubernetes e o GKE gerenciam o agendamento de pods, as atribuições de nós e a alocação de dispositivos com base nas solicitações de carga de trabalho.
Por exemplo, um administrador de plataforma pode definir uma classe de dispositivo que tenha apenas GPUs NVIDIA A100. Os operadores de apps podem filtrar os dispositivos nessa classe com base nos requisitos de carga de trabalho, como filtrar um mínimo de 80 GB de memória de GPU. Quando o operador do app implanta uma carga de trabalho que solicita a configuração filtrada, o GKE coloca os pods em nós que atendem aos critérios selecionados. Neste exemplo, o GKE encontra nós que têm GPUs A100 (80 GB) disponíveis. O operador do app não precisa selecionar nós ou configurações de dispositivos específicos no manifesto da carga de trabalho.
Benefícios da DRA
Sem a DRA, a alocação de dispositivos de hardware no Kubernetes depende de plug-ins de dispositivo. Para anexar recursos de hardware a pods usando plug-ins de dispositivo, use rótulos de nós para colocar pods em nós específicos. Além disso, para dedicar os recursos de um nó inteiro a um único pod, solicite o número exato de dispositivos anexados aos nós.
Com a DRA, a alocação de dispositivos para pods é semelhante à alocação de volumes para armazenamento. Você define classes de dispositivos, solicita dispositivos nessas classes e atribui os dispositivos solicitados às cargas de trabalho. A DRA oferece uma superfície significativamente mais extensível para filtrar dispositivos com base nas necessidades de carga de trabalho e de negócios. A abordagem da DRA de usar expressões e modelos para reivindicar hardware e programar pods tem os seguintes benefícios:
- Alocação declarativa de dispositivos: os administradores de plataforma podem definir configurações de dispositivos para tipos específicos de cargas de trabalho ou equipes.
- Complexidade reduzida entre equipes: quando os administradores de plataforma provisionam nós com configurações de hardware especializadas, os operadores de apps não precisam saber quais nós têm configurações específicas. Os administradores de plataforma não precisam rotular nós nem comunicar informações sobre nós e dispositivos específicos aos operadores.
- Complexidade reduzida do desenvolvedor: o Kubernetes programa pods com base na configuração do dispositivo referenciado. Os operadores de apps não precisam selecionar nós específicos nas cargas de trabalho e não precisam garantir que cada pod solicite exatamente o número de dispositivos anexados a esses nós.
- Gerenciamento centralizado de infraestrutura: os administradores de plataforma podem definir configurações de hardware centralmente que atendam a requisitos de negócios específicos. Por exemplo, um administrador de plataforma pode declarar uma configuração de alto desempenho que tenha GPUs H100 junto com uma pequena configuração de inferência que tenha GPUs Tesla T4.
- Seleção de hardware flexível: é possível usar expressões CEL para filtrar dispositivos que tenham atributos específicos. O uso de expressões oferece a flexibilidade de filtrar dispositivos ideais para cargas de trabalho específicas.
Quando usar a DRA
O principal motivo para usar a DRA no GKE é a flexibilidade com que você pode solicitar dispositivos para cargas de trabalho. É possível escrever um manifesto uma vez e implantar a carga de trabalho em clusters diferentes com tipos de dispositivos diferentes sem precisar mudar o manifesto. Essa flexibilidade é ideal para casos de uso como os seguintes:
- Melhorar a capacidade de obtenção de GPU: para cargas de trabalho que precisam de acesso ao hardware da GPU , é possível usar a DRA para solicitar qualquer GPU disponível no cluster , em vez de precisar especificar um modelo de GPU. Se essas cargas de trabalho tiverem requisitos específicos de memória de GPU (VRAM), é possível solicitar qualquer GPU no cluster que tenha uma quantidade mínima de memória. Esse tipo de solicitação flexível expande o conjunto de nós de GPU em que uma carga de trabalho pode ser executada, o que reduz o risco de a carga de trabalho não ser programada devido a recursos indisponíveis.
Otimizar a disponibilidade de nós durante o escalonamento: a quantidade de dispositivos que uma carga de trabalho exige pode mudar dependendo de fatores como o tipo de dispositivo e os recursos dele. É possível usar GKE ComputeClasses para colocar pods acelerados em pools de nós específicos com base na disponibilidade do dispositivo. Em seguida, é possível configurar os pods para reivindicar os dispositivos em qualquer nó em que o GKE os coloque.
O uso da DRA com ComputeClasses permite minimizar o risco de cargas de trabalho não programadas e também ajuda a executar cargas de trabalho em hardware otimizado.
Terminologia
O Kubernetes de código aberto e provedores gerenciados do Kubernetes, como o GKE, usam os seguintes tipos de API DRA principais:
- ResourceSlice
- Uma ResourceSlice lista um ou mais dispositivos de hardware no cluster que os nós podem acessar. Por exemplo, em um nó que pode acessar uma única GPU, a ResourceSlice lista a GPU e o nome do nó. Os drivers de dispositivo DRA em cada nó criam ResourceSlices. O programador do Kubernetes usa ResourceSlices para decidir quais dispositivos alocar para atender às solicitações de carga de trabalho.
- DeviceClass
-
Uma DeviceClass define uma categoria de dispositivos, como GPUs, que estão disponíveis para solicitação de cargas de trabalho.
Alguns drivers de dispositivo fornecem DeviceClasses integradas, como a DeviceClass
gpu.nvidia.compara GPUs NVIDIA. Os administradores de plataforma também podem criar DeviceClasses personalizadas que definem configurações de dispositivos específicos. - ResourceClaim
-
Uma ResourceClaim permite que um pod ou um usuário solicite recursos de hardware filtrando determinados parâmetros em uma DeviceClass. Quando uma carga de trabalho referencia uma ResourceClaim, o Kubernetes atribui dispositivos que correspondem aos parâmetros especificados a essa ResourceClaim.
Por exemplo, considere um cenário em que você cria uma ResourceClaim para uma GPU A100 (40 GB) e implanta uma carga de trabalho que seleciona essa ResourceClaim. O Kubernetes atribui uma GPU A100 (40 GB) disponível à ResourceClaim e programa o pod em um nó que pode acessar essa GPU.
- ResourceClaimTemplate
-
Um ResourceClaimTemplate define um modelo que os pods podem usar para criar automaticamente novas ResourceClaims por pod. Os ResourceClaimTemplates são úteis quando você tem várias cargas de trabalho que precisam de acesso a configurações de dispositivos semelhantes, especialmente ao usar um controlador de carga de trabalho como implantações ou StatefulSets.
Os operadores de apps implantam ResourceClaimTemplates e referenciam os modelos em cargas de trabalho. O Kubernetes cria ResourceClaims para cada pod com base no modelo especificado, aloca dispositivos e programa os pods. Quando os pods são encerrados, o Kubernetes limpa as ResourceClaims correspondentes.
Para mais informações sobre os tipos de API DRA, consulte a terminologia da DRA.
Como a DRA funciona
O uso da DRA em clusters e cargas de trabalho é um processo semelhante ao uso de StorageClasses, PersistentVolumeClaims e PersistentVolumes para provisionar volumes dinamicamente para pods.
O diagrama a seguir mostra as etapas que os administradores de cluster e os operadores de apps seguem para alocar dispositivos usando a DRA:
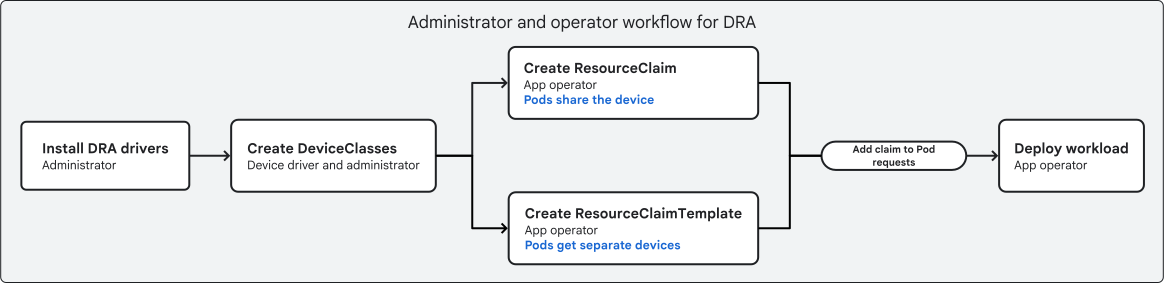
Neste diagrama, os administradores de cluster e os operadores de apps fazem o seguinte:
- Os administradores de cluster instalam drivers de dispositivo que oferecem suporte à DRA nos nós.
- Os administradores de cluster criam DeviceClasses que filtram hardware que atende a requisitos específicos, como todas as GPUs com mais de 40 GB de memória. Alguns dispositivos também podem incluir DeviceClasses integradas.
- Os operadores de aplicativos criam ResourceClaimTemplates ou ResourceClaims que solicitam configurações de dispositivos. O caso de uso principal para cada tipo de reivindicação é o seguinte:
- Uma ResourceClaim permite que vários pods compartilhem o acesso ao mesmo dispositivo.
- Um ResourceClaimTemplate permite que vários pods acessem dispositivos separados e semelhantes, gerando automaticamente ResourceClaims por pod.
- Os operadores de aplicativos adicionam os ResourceClaimTemplates ou ResourceClaims aos manifestos de carga de trabalho.
- Os operadores de aplicativos implantam a carga de trabalho.
Quando você implanta uma carga de trabalho que referencia um ResourceClaimTemplate ou uma ResourceClaim, o Kubernetes executa as seguintes etapas de programação:
- Se a carga de trabalho referencia um ResourceClaimTemplate, o Kubernetes cria um novo objeto
ResourceClaimpara cada instância da carga de trabalho (por exemplo, cada réplica em uma implantação). - O programador do Kubernetes usa as ResourceSlices no cluster para alocar dispositivos disponíveis e qualificados para a ResourceClaim de cada pod.
- O programador coloca cada pod em um nó que tem acesso aos dispositivos alocados para a ResourceClaim do pod.
- O
kubeletno nó de destino chama o driver DRA no nó para anexar o hardware alocado ao pod para atender à solicitação de recurso.
Quando usar ResourceClaims e ResourceClaimTemplates
É possível usar ResourceClaims ou ResourceClaimTemplates para indicar ao Kubernetes que você quer dispositivos que atendam a requisitos específicos. Quando uma ResourceClaim é referenciada em um pod, o Kubernetes aloca dispositivos para o recurso de API ResourceClaim correspondente no servidor da API Kubernetes. Essa alocação acontece independentemente de você ter criado a ResourceClaim ou o Kubernetes ter criado a ResourceClaim de um ResourceClaimTemplate.
Se você criar uma ResourceClaim e referenciá-la em vários pods, todos esses pods poderão acessar os dispositivos que o Kubernetes aloca para essa ResourceClaim. Por exemplo, esse acesso compartilhado pode acontecer se você referenciar uma ResourceClaim específica em um manifesto de implantação que tenha várias réplicas. No entanto, se os dispositivos alocados não estiverem configurados para serem compartilhados por vários processos, esse acesso a dispositivos compartilhados entre pods poderá resultar em um comportamento indesejado.
Para alocar dispositivos separados para pods, é possível usar um ResourceClaimTemplate, que é um modelo que o Kubernetes usa para criar automaticamente ResourceClaims individuais. Por exemplo, se você referenciar um ResourceClaimTemplate em uma implantação que tenha várias réplicas, o Kubernetes criará uma ResourceClaim separada para cada pod replicado. Como resultado, cada pod recebe o próprio dispositivo alocado em vez de compartilhar o acesso ao dispositivo com outros pods. Essas ResourceClaims geradas automaticamente estão vinculadas ao ciclo de vida do pod correspondente e são excluídas quando o pod é encerrado. Se você tiver pods independentes que precisam de acesso a configurações de dispositivos semelhantes, use um ResourceClaimTemplate para alocar dispositivos para cada pod separadamente.
A tabela a seguir descreve algumas diferenças entre a criação manual de ResourceClaims e a criação de ResourceClaims pelo Kubernetes a partir de um ResourceClaimTemplate:
| ResourceClaims criadas manualmente | ResourceClaims criadas automaticamente |
|---|---|
| Gerenciado por você | Gerenciadas pelo Kubernetes |
| Fornece acesso aos mesmos dispositivos de vários pods | Fornece acesso a dispositivos de um único pod |
| Existe no cluster independentemente dos pods | Vinculado ao ciclo de vida do pod correspondente |
| Ideal para várias cargas de trabalho que precisam compartilhar um dispositivo específico | Ideal para várias cargas de trabalho que precisam de acesso independente ao dispositivo |
Comparação da DRA com a alocação manual de dispositivos
A DRA torna a alocação de dispositivos anexados uma experiência semelhante ao provisionamento dinâmico de PersistentVolumes. O Kubernetes também oferece suporte à alocação de dispositivos usando plug-ins de dispositivo. Esse método envolve as seguintes etapas:
- Um administrador de cluster cria nós que têm dispositivos anexados, como GPUs.
- O administrador do cluster comunica informações sobre nós específicos e os dispositivos anexados aos operadores de carga de trabalho.
- Um operador de carga de trabalho solicita dispositivos no manifesto da carga de trabalho da seguinte maneira:
- Selecione um nó que tenha a configuração de dispositivo necessária, como o modelo de GPU, usando um campo
nodeSelector. - Especifique o número exato de dispositivos para os contêineres consumirem usando o campo
resourcesna especificação do pod.
- Selecione um nó que tenha a configuração de dispositivo necessária, como o modelo de GPU, usando um campo
Esse método de alocação manual exige que os operadores de aplicativos e os administradores de cluster se comuniquem sobre quais nós ou pools de nós específicos têm determinadas configurações de dispositivos. Eles precisam coordenar as solicitações de carga de trabalho para corresponder aos dispositivos nos nós ou a implantação falha. Em comparação, a DRA permite usar expressões para filtrar dispositivos de maneira flexível com base em atributos e não exige que os operadores de carga de trabalho conheçam a configuração exata dos nós no cluster.
A tabela a seguir compara a DRA com plug-ins de dispositivo:
| DRA | Alocação manual |
|---|---|
| Seleção flexível de dispositivos usando expressões CEL | Seleção de nós específicos usando seletores e solicitações de recursos |
| Decisões de programação feitas pelo Kubernetes | Decisões de programação feitas pelo operador usando seletores de nós |
| A filtragem de dispositivos é separada da criação de carga de trabalho | A filtragem de dispositivos precisa ser feita no manifesto da carga de trabalho |
| Filtragem centralizada de dispositivos e classes baseadas em necessidades, gerenciadas por administradores de plataforma | Filtragem isolada de dispositivos por operadores de aplicativos |
| Os operadores de apps não precisam saber a capacidade do nó, as informações do rótulo do nó, ou os modelos de dispositivo anexados para cada nó | Os operadores de apps precisam saber quais nós têm modelos e quantidades específicos de determinados dispositivos anexados. |
DRA e escalonamento automático de infraestrutura
Para ajustar automaticamente o número de nós em um pool de nós do modo padrão, use o escalonador automático de clusters. É possível ativar o escalonador automático de clusters em pools de nós criados manualmente, incluindo pools de nós que têm drivers DRA.
Para pools de nós que usam a DRA, a utilização do dispositivo afeta como o escalonador automático de clusters adiciona e remove nós em um pool de nós. Para calcular a utilização do dispositivo em um pool de nós, o escalonador automático de clusters considera os seguintes fatores:
- Todos os dispositivos em um pool de recursos precisam ser locais para um nó específico. Se uma ResourceSlice tiver um pool de dispositivos anexados a vários nós, o escalonador automático de clusters vai ignorar esses dispositivos.
- Todos os dispositivos no pool de nós são igualmente importantes e idênticos.
- Os dispositivos DRA têm maior prioridade do que a CPU ou a memória. Em pools de nós DRA, o escalonador automático de clusters ignora o uso de CPU e memória.
Esses fatores podem significar que você percebe um comportamento de redução diferente em pools de nós DRA do que em outros pools de nós.
Dispositivos do GKE com suporte para DRA
A tabela a seguir descreve os dispositivos que podem ser alocados para cargas de trabalho com DRA no GKE:
| Dispositivos com suporte para DRA | |
|---|---|
| GPUs | Qualquer tipo de GPU disponível no seu local. Para mais informações, veja locais de GPU. |
| Interfaces de rede | Vários tipos de interfaces de rede, como interfaces compatíveis com RDMA, instalando o driver DRANET gerenciado. Para mais informações, consulte Alocar recursos de rede usando o DRANET gerenciado pelo GKE. |
Limitações
As seguintes limitações se aplicam ao uso da DRA:
Modo de operação: a DRA está disponível apenas em clusters do modo padrão.
Tipo de acelerador: a DRA no GKE oferece suporte apenas a GPUs.
GPUs:
- Não é possível usar GPUs de compartilhamento de tempo, GPUs de várias instâncias ou o Multi-Process Service (MPS).
- Para nós que usam os drivers de GPU DRA, não é possível usar o pacote de métricas gerenciado do NVIDIA Data Center GPU Manager (DCGM) para enviar métricas do DCGM ao Cloud Monitoring.
- O driver de GPU para DRA é de propriedade da NVIDIA, não do GKE. Para mais informações, consulte a documentação da NVIDIA.
Interfaces de rede: consulte Limitações em "Alocar recursos de rede usando o DRANET gerenciado pelo GKE".
Escalonamento automático:
- Para drivers DRA de terceiros instalados, o escalonador automático de clusters exige que os pools de nós tenham pelo menos um nó. Para
evitar que os pools de nós que usam drivers de terceiros sejam escalonados para zero
nós, defina o
número mínimo de nós
como pelo menos
1. - O escalonador automático de clusters pode não funcionar corretamente com drivers DRA de terceiros. Se você usar drivers de terceiros, verifique se eles publicam informações apenas para dispositivos locais de nós específicos.
- Para DaemonSets em pools de nós com escalonamento automático que usam uma ResourceClaim estática para compartilhar o acesso ao dispositivo entre pods, o escalonamento automático oferece suporte a até 128 pods DaemonSet. Para evitar essa limitação, siga um destes procedimentos:
- Impeça que o pool de nós seja escalonado para mais de 128 nós definindo o número máximo de nós.
- Use o
adminAccesscampo (Beta), na ResourceClaim, que permite que o DaemonSet acesse dispositivos que estão em uso.
- Se os pods referenciarem ResourceClaims e tiverem uma PriorityClass que define a política de preempção como
PreemptLowerPriority, a latência de escalonamento automático poderá aumentar.PreemptLowerPriorityé a política de preempção padrão para PriorityClass. Portanto, verifique se as PriorityClasses definem explicitamente o campopreemptionPolicycomoNever. Para mais informações, consulte PriorityClass não preemptiva.
- Para drivers DRA de terceiros instalados, o escalonador automático de clusters exige que os pools de nós tenham pelo menos um nó. Para
evitar que os pools de nós que usam drivers de terceiros sejam escalonados para zero
nós, defina o
número mínimo de nós
como pelo menos
Habilidades recomendadas para entender e usar a DRA
Esta seção fornece recomendações para administradores de plataforma ou operadores de apps que querem usar a DRA para alocar dispositivos para cargas de trabalho. A DRA muda significativamente o método de solicitação de dispositivos anexados, tanto no GKE quanto no Kubernetes. Para aproveitar casos de uso mais avançados, como substituto entre dispositivos ou filtragem e seleção de dispositivos refinados, considere as seguintes orientações:
Aprenda CEL: com a DRA, é possível usar expressões CEL para realizar a filtragem refinada de dispositivos nas solicitações de alocação de recursos e nas DeviceClasses. Os recursos a seguir podem ajudar você a aprender CEL:
Saiba mais sobre as ComputeClasses no GKE: é possível usar ComputeClasses com a DRA para atender às necessidades de negócios, como provisionar VMs do Spot para executar cargas de trabalho de inferência que solicitam GPUs econômicas. Os recursos a seguir ajudam você a aprender sobre ComputeClasses:
A seguir
- Prepare sua infraestrutura do GKE para cargas de trabalho DRA
- Alocar dispositivos dinamicamente para cargas de trabalho com DRA