


אתם יכולים להשתמש בהקצאת משאבים דינמית (DRA) כדי להקצות GPU לעומסי העבודה שלכם ב-Google Kubernetes Engine (GKE). במאמר הזה מוסבר מהו DRA, איך משתמשים ב-DRA ב-GKE ומהם היתרונות של השימוש ב-DRA.
המסמך הזה מיועד לתפקידים הבאים:
- אדמינים של פלטפורמות שרוצים לצמצם את המורכבות והתקורה של הגדרת תשתית עם מכשירי חומרה ייעודיים.
- מפעילים של אפליקציות ומהנדסי נתונים שמריצים עומסי עבודה כמו AI/ML או מחשוב עתיר ביצועים (HPC).
חשוב להכיר את הנושאים הבאים:
מבוא ל-DRA
DRA היא תכונה מובנית של Kubernetes שמאפשרת לכם לבקש, להקצות ולשתף חומרה בצורה גמישה באשכול בין קבוצות Pod וקונטיינרים. התכונה DRA משפרת את חוויית ההקצאה של חומרה מצורפת, כמו מאיצים, בכך שהיא מאפשרת לספקי מכשירים ולמנהלי פלטפורמות להצהיר על סוגים של מכשירים שאפשר לבקש ולהקצות. מפעילים של אפליקציות יכולים לבקש הגדרות ספציפיות למכשירים במסגרת הסיווגים האלה, ואז לבקש את ההגדרות האלה בעומסי העבודה שלהם. Kubernetes ו-GKE מנהלים את התזמון של Pod, את ההקצאות של הצמתים ואת ההקצאה של המכשירים על סמך בקשות לעומסי עבודה.
לדוגמה, אדמין של פלטפורמה יכול להגדיר סוג מכשיר שיש בו רק כרטיסי GPU מסוג NVIDIA A100. מפעילים של אפליקציות יכולים לסנן את המכשירים בקטגוריית המכשירים הזו על סמך דרישות עומס העבודה, למשל סינון של זיכרון GPU בנפח של 80GB לפחות. כשמפעיל האפליקציה פורס עומס עבודה שמבקש את ההגדרה המסוננת, GKE מציב את ה-Pods בצמתים שעומדים בקריטריונים שנבחרו. בדוגמה הזו, מערכת GKE מוצאת צמתים עם מעבדי GPU מסוג A100 (80 GB) שזמינים. מפעיל האפליקציה לא צריך לבחור צמתים ספציפיים או הגדרות מכשיר ספציפיות במניפסט של עומס העבודה.
היתרונות של DRA
בלי DRA, הקצאת מכשירי חומרה ב-Kubernetes מסתמכת על תוספים למכשירים. כדי לצרף משאבי חומרה ל-Pods באמצעות תוספים למכשירים, משתמשים בתוויות של צמתים כדי למקם את ה-Pods בצמתים ספציפיים. בנוסף, כדי להקצות את כל המשאבים של צומת מסוים ל-Pod יחיד, צריך לבקש את המספר המדויק של המכשירים שמחוברים לצמתים.
ב-DRA, הקצאת מכשירים ל-Pods דומה להקצאת אמצעי אחסון. אתם מגדירים סוגים של מכשירים, מבקשים מכשירים מהסוגים האלה ואז מקצים את המכשירים המבוקשים לעומסי עבודה. עם DRA יש לכם משטח הרבה יותר גמיש לסינון מכשירים לפי עומס העבודה והצרכים העסקיים. הגישה של DRA לשימוש בביטויים ובתבניות כדי לתבוע חומרה ולתזמן Pods מציעה את היתרונות הבאים:
- הקצאת מכשירים הצהרתית: אדמינים של פלטפורמות יכולים להגדיר תצורות של מכשירים לסוגים ספציפיים של עומסי עבודה או צוותים.
- מורכבות מופחתת בין צוותים: כשמנהלי פלטפורמה מקצים צמתים עם הגדרות חומרה מיוחדות, מפעילים של אפליקציות לא צריכים לדעת אילו צמתים כוללים הגדרות ספציפיות. אדמינים של פלטפורמות לא צריכים להוסיף תוויות לצמתים או להעביר למפעילים מידע על צמתים ומכשירים ספציפיים.
- פחות מורכבות למפתחים: מערכת Kubernetes מתזמנת קבוצות Pod על סמך הגדרת המכשיר שאליה מתבצעת ההפניה. מפעילים של אפליקציות לא צריכים לבחור צמתים ספציפיים בעומסי העבודה שלהם, ולא צריכים לוודא שכל Pod מבקש בדיוק את מספר המכשירים שמצורפים לצמתים האלה.
- ניהול ריכוזי של התשתית: אדמינים של הפלטפורמה יכולים להגדיר באופן ריכוזי תצורות חומרה שעונות על דרישות עסקיות ספציפיות. לדוגמה, אדמין בפלטפורמה יכול להצהיר על תצורה לביצועים גבוהים עם כרטיסי H100 GPU, לצד תצורה קטנה להסקת מסקנות עם כרטיסי Tesla T4 GPU.
- בחירת חומרה גמישה: אפשר להשתמש בביטויי CEL כדי לסנן מכשירים עם מאפיינים ספציפיים. שימוש בביטויים מאפשר גמישות בסינון מכשירים שמתאימים לעומסי עבודה ספציפיים.
מתי כדאי להשתמש ב-DRA
הסיבה העיקרית לשימוש ב-DRA ב-GKE היא הגמישות שמאפשרת לבקש מכשירים לעומסי עבודה. אתם יכולים לכתוב מניפסט פעם אחת ולפרוס את עומס העבודה לאשכולות שונים עם סוגים שונים של מכשירים בלי שתצטרכו לשנות את המניפסט. הגמישות הזו אידיאלית לתרחישי שימוש כמו אלה:
- שיפור הגמישות, היעילות והזמינות של קיבולת המחשוב של ה-GPU: כדי לעבד עומסי עבודה שזקוקים לגישה לחומרת GPU, אפשר להשתמש ב-DRA כדי לבקש כל GPU שזמין באשכול, במקום לציין דגם GPU. אם לעומסי העבודה האלה יש דרישות ספציפיות לגבי זיכרון GPU (VRAM), אתם יכולים לבקש כל GPU באשכול שיש לו כמות מינימלית של זיכרון. סוג הבקשה הגמישה הזה מרחיב את קבוצת צמתי ה-GPU שעומס עבודה יכול לפעול בהם, וכך מצמצם את הסיכון לכך שעומס העבודה לא יתוזמן בגלל משאבים לא זמינים.
אופטימיזציה של זמינות הצמתים במהלך שינוי הגודל: כמות המכשירים שנדרשת לעומס עבודה עשויה להשתנות בהתאם לגורמים כמו סוג המכשיר והיכולות שלו. אתם יכולים להשתמש ב-GKE ComputeClasses כדי למקם Pods מואצים במאגרי צמתים ספציפיים על סמך זמינות המכשיר. אחר כך אפשר להגדיר את ה-Pods כך שיקבלו את המכשירים בכל צומת שבו GKE מציב את ה-Pods.
שימוש ב-DRA עם ComputeClasses מאפשר לצמצם את הסיכון לעומסי עבודה לא מתוזמנים, וגם עוזר להריץ עומסי עבודה על חומרה שעברה אופטימיזציה.
הסברים על המונחים
ספקי Kubernetes בקוד פתוח וספקי Kubernetes מנוהלים כמו GKE משתמשים בסוגי ה-API הבאים של DRA:
- ResourceSlice
- ב-ResourceSlice מפורטים מכשירי חומרה אחד או יותר באשכול שהצמתים יכולים לגשת אליהם. לדוגמה, בצומת שיש לו גישה ל-GPU יחיד, ה-ResourceSlice מפרט את ה-GPU ואת שם הצומת. מנהלי ההתקנים של DRA בכל צומת יוצרים ResourceSlices. מתזמן Kubernetes משתמש ב-ResourceSlices כדי להחליט אילו מכשירים להקצות כדי לענות על בקשות לעומס עבודה.
- DeviceClass
-
DeviceClass מגדיר קטגוריה של מכשירים, כמו GPUs, שאפשר לבקש עבור עומסי עבודה.
חלק ממנהלי ההתקנים של המכשירים מספקים DeviceClasses מובנים, כמו
gpu.nvidia.comDeviceClass עבור GPU של NVIDIA. אדמינים של הפלטפורמה יכולים גם ליצור DeviceClasses בהתאמה אישית שמגדירים תצורות ספציפיות של מכשירים. - ResourceClaim
-
משאב ResourceClaim מאפשר ל-Pod או למשתמש לבקש משאבי חומרה על ידי סינון פרמטרים מסוימים בתוך DeviceClass. כשעומס עבודה מפנה ל-ResourceClaim, Kubernetes מקצה ל-ResourceClaim הזה מכשירים שתואמים לפרמטרים שצוינו.
לדוגמה, נניח שאתם יוצרים ResourceClaim עבור GPU אחד מסוג A100 (40 GB) ואז פורסים עומס עבודה שבוחר את ה-ResourceClaim הזה. Kubernetes מקצה GPU מסוג A100 (40 GB) שזמין ל-ResourceClaim ומתזמן את ה-Pod שלכם בצומת שיכול לגשת ל-GPU הזה.
- ResourceClaimTemplate
-
ResourceClaimTemplate מגדיר תבנית ש-Pods יכולים להשתמש בה כדי ליצור באופן אוטומטי ResourceClaim חדש לכל Pod. תבניות ResourceClaim שימושיות כשצריך לתת לכמה עומסי עבודה גישה להגדרות דומות של מכשירים, במיוחד כשמשתמשים בבקר עומסי עבודה כמו Deployments או StatefulSets.
מפעילים של אפליקציות פורסים ResourceClaimTemplates ואז מפנים לתבניות בעומסי עבודה. Kubernetes יוצר ResourceClaims לכל Pod על סמך התבנית שצוינה, מקצה מכשירים ומתזמן את ה-Pods. כשמפסיקים את השימוש ב-Pods, Kubernetes מנקה את ה-ResourceClaims המתאימים.
מידע נוסף על סוגי DRA API זמין במאמר בנושא טרמינולוגיה של DRA.
איך DRA עובד
השימוש ב-DRA באשכולות ובעומסי העבודה דומה לתהליך של הקצאת נפח אחסון באופן דינמי ל-Pods באמצעות StorageClasses, PersistentVolumeClaims ו-PersistentVolumes.
בתרשים הבא מוצגים השלבים שמנהלי אשכולות ומפעילים של אפליקציות מבצעים כדי להקצות מכשירים באמצעות DRA:
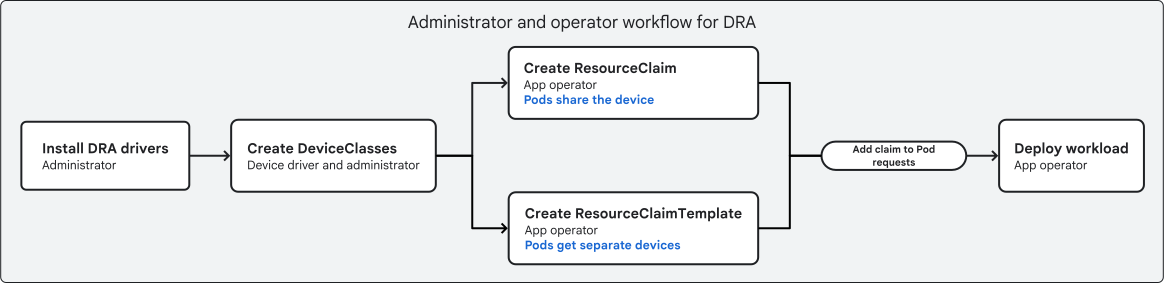
בתרשים הזה, אדמינים של אשכולות ומפעילים של אפליקציות מבצעים את הפעולות הבאות:
- אדמינים של אשכולות מתקינים מנהלי התקנים של מכשירים שתומכים ב-DRA בצמתים.
- אדמינים של אשכולות יוצרים DeviceClasses שמסננים חומרה שעומדת בדרישות ספציפיות, כמו כל ה-GPU עם יותר מ-40 GB של זיכרון. יכול להיות שחלק מהמכשירים יכללו גם DeviceClasses מובנים.
- מפעילים של אפליקציות יוצרים ResourceClaimTemplates או ResourceClaims שמבקשים הגדרות של מכשירים. תרחיש השימוש העיקרי לכל סוג של תביעה הוא כדלקמן:
- האובייקט ResourceClaim מאפשר לכמה פודים לשתף גישה לאותו מכשיר.
- תבנית ResourceClaim מאפשרת לכמה פודים לגשת למכשירים נפרדים דומים על ידי יצירה אוטומטית של ResourceClaim לכל פוד.
- אופרטורים של אפליקציות מוסיפים את ResourceClaimTemplates או ResourceClaims למניפסטים של עומסי העבודה שלהם.
- מפעילים של אפליקציות פורסים את עומס העבודה.
כשפורסים עומס עבודה שמפנה אל ResourceClaimTemplate או אל ResourceClaim, Kubernetes מבצע את שלבי התזמון הבאים:
- אם עומס העבודה מפנה אל ResourceClaimTemplate, Kubernetes יוצר אובייקט
ResourceClaimחדש לכל מופע של עומס העבודה (לדוגמה, לכל עותק משוכפל ב-Deployment). - מתזמן Kubernetes משתמש ב-ResourceSlices באשכול כדי להקצות מכשירים זמינים שעומדים בדרישות לכל ResourceClaim של Pod.
- מתזמן העבודה ממקם כל Pod בצומת שיש לו גישה למכשירים שהוקצו ל-ResourceClaim של ה-Pod.
- השדה
kubeletבצומת היעד קורא למנהל ההתקן של DRA בצומת כדי לצרף את החומרה שהוקצתה ל-Pod, וכך למלא את בקשת המשאבים שלו.
מתי כדאי להשתמש ב-ResourceClaims וב-ResourceClaimTemplates
אפשר להשתמש ב-ResourceClaims או ב-ResourceClaimTemplates כדי לציין ל-Kubernetes שרוצים מכשירים שעומדים בדרישות ספציפיות. כשמפנים אל ResourceClaim ב-Pod, Kubernetes מקצה מכשירים למשאב ה-API המתאים ResourceClaim בשרת ה-API של Kubernetes. ההקצאה הזו מתבצעת בין אם יצרתם את ResourceClaim או ש-Kubernetes יצר אותו מ-ResourceClaimTemplate.
אם יוצרים ResourceClaim ואז מפנים אליו בכמה פודים, כל הפודים האלה יכולים לגשת למכשירים ש-Kubernetes מקצה ל-ResourceClaim הזה. לדוגמה, גישה משותפת כזו יכולה לקרות אם מפנים אל ResourceClaim ספציפי במניפסט של פריסה שיש לו כמה עותקים. עם זאת, אם המכשירים שהוקצו לא מוגדרים לשיתוף בין כמה תהליכים, הגישה למכשיר המשותף בין ה-Pods עלולה להוביל להתנהגות לא צפויה.
כדי להקצות מכשירים נפרדים ל-Pods, אפשר להשתמש ב-ResourceClaimTemplate, שהיא תבנית ש-Kubernetes משתמש בה כדי ליצור באופן אוטומטי ResourceClaims נפרדים. לדוגמה, אם מפנים אל ResourceClaimTemplate בפריסת Deployment שיש לה כמה רפליקות, Kubernetes יוצר ResourceClaim נפרד לכל Pod משוכפל. כתוצאה מכך, כל Pod מקבל מכשיר משלו שהוקצה לו, במקום לחלוק את הגישה למכשיר עם Pods אחרים. ה-ResourceClaims שנוצרים אוטומטית קשורים למשך החיים של ה-Pod התואם, ונמחקים כשה-Pod מסתיים. אם יש לכם פודים עצמאיים שצריכים גישה להגדרות מכשיר דומות, אתם יכולים להשתמש ב-ResourceClaimTemplate כדי להקצות מכשירים לכל פוד בנפרד.
בטבלה הבאה מפורטים כמה הבדלים בין יצירה ידנית של ResourceClaim לבין יצירה של ResourceClaim על ידי Kubernetes מ-ResourceClaimTemplate:
| ResourceClaims שנוצרו באופן ידני | ResourceClaims שנוצרו באופן אוטומטי |
|---|---|
| בניהול שלכם | מנוהל על ידי Kubernetes |
| מאפשר גישה לאותם מכשירים מכמה תרמילים | גישה למכשירים מתוך Pod יחיד |
| קיים באשכול באופן עצמאי מ-Pods | הם קשורים למחזור החיים של ה-Pod המתאים |
| האפשרות הזו אידיאלית למספר עומסי עבודה שצריכים לחלוק מכשיר ספציפי | אידיאלי למספר עומסי עבודה שזקוקים לגישה עצמאית למכשיר |
השוואה בין הקצאת מכשירים דינמית לבין הקצאת מכשירים ידנית
ה-DRA מאפשר להקצות מכשירים מצורפים באופן דומה להקצאה דינמית של PersistentVolumes. ב-Kubernetes יש גם תמיכה בהקצאת מכשירים באמצעות תוספי מכשירים. השיטה הזו כוללת את השלבים הבאים:
- אדמין של אשכול יוצר צמתים עם מכשירים מצורפים, כמו יחידות GPU.
- האדמין של האשכול מעביר למפעילים של עומסי עבודה מידע על צמתים ספציפיים ועל המכשירים שמחוברים אליהם.
- מפעיל של עומס עבודה מבקש מכשירים במניפסט של עומס העבודה באופן הבא:
- בוחרים צומת עם הגדרת המכשיר הנדרשת, כמו דגם ה-GPU, באמצעות השדה
nodeSelector. - כדי לציין את המספר המדויק של המכשירים שהקונטיינרים צריכים להשתמש בהם, צריך להשתמש בשדה
resourcesבמפרט ה-Pod.
- בוחרים צומת עם הגדרת המכשיר הנדרשת, כמו דגם ה-GPU, באמצעות השדה
בשיטה הזו של הקצאה ידנית, מפעילים של אפליקציות ואדמינים של אשכולות צריכים לתקשר ביניהם כדי לדעת אילו צמתים או מאגרי צמתים ספציפיים כוללים הגדרות מסוימות של מכשירים. הם צריכים לתאם את בקשות עומס העבודה כך שיתאימו למכשירים בצמתים, אחרת הפריסה תיכשל. לעומת זאת, DRA מאפשרת להשתמש בביטויים כדי לסנן באופן גמיש מכשירים על סמך מאפיינים, ולא דורשת מאופרטורים של עומסי עבודה לדעת את ההגדרה המדויקת של הצמתים באשכול.
בטבלה הבאה מוצגת השוואה בין DRA לבין תוספים למכשירים:
| DRA | הקצאה ידנית |
|---|---|
| בחירת מכשירים גמישה באמצעות ביטויי CEL | בחירה ספציפית של צומת באמצעות סלקטורים ובקשות משאבים |
| החלטות התזמון שמתקבלות על ידי Kubernetes | החלטות לגבי תזמון שמתקבלות על ידי האופרטור באמצעות סלקטורים של צמתים |
| סינון מכשירים הוא תהליך נפרד מיצירת עומס עבודה | סינון המכשירים צריך להתבצע במניפסט של עומס העבודה |
| סינון מכשירים מרוכז וסיווג לפי צרכים, בניהול של אדמינים בפלטפורמה | סינון מכשירים מבודדים לפי אופרטורים של אפליקציות |
| מפעילים של אפליקציות לא צריכים לדעת את קיבולת הצומת, את פרטי התווית של הצומת, או את דגמי המכשירים שמחוברים לכל צומת | מפעילי האפליקציה צריכים לדעת באילו צמתים יש מודלים ספציפיים וכמה מכשירים מסוימים מחוברים אליהם. |
התאמה אוטומטית של התשתית (autoscaling) ו-DRA
כדי לשנות באופן אוטומטי את מספר הצמתים במאגר צמתים במצב רגיל, משתמשים ב-Cluster Autoscaler. אפשר להפעיל את התכונה 'שינוי גודל אוטומטי של אשכולות' בכל מאגר צמתים שנוצר באופן ידני, כולל מאגרי צמתים שיש להם מנהלי התקנים של DRA.
במאגרי צמתים שמשתמשים ב-DRA, ניצול המכשיר משפיע על האופן שבו Cluster Autoscaler מוסיף ומסיר צמתים במאגר צמתים. כדי לחשב את ניצול המכשיר במאגר צמתים, הכלי Cluster Autoscaler מתחשב בגורמים הבאים:
- כל המכשירים במאגר משאבים צריכים להיות מקומיים לצומת ספציפי. אם ל-ResourceSlice יש מאגר של מכשירים שמחוברים לכמה צמתים, המערכת לשינוי גודל האשכול באופן אוטומטי מתעלמת מהמכשירים האלה.
- לכל המכשירים במאגר הצמתים יש חשיבות זהה והם זהים.
- למכשירים עם DRA יש עדיפות גבוהה יותר מאשר למעבד או לזיכרון. במאגרי צמתים של DRA, המידרוג האוטומטי של האשכול מתעלם משימוש במעבד ובזיכרון.
הגורמים האלה יכולים להוביל לכך שתבחינו בהתנהגות שונה של הקטנת הקיבולת במאגרי צמתים של DRA בהשוואה למאגרי צמתים אחרים.
מכשירי GKE נתמכים ל-DRA
בטבלה הבאה מתוארים המכשירים שאפשר להקצות לעומסי עבודה באמצעות DRA ב-GKE:
| מכשירים נתמכים ל-DRA | |
|---|---|
| יחידות GPU | כל סוג GPU שזמין במיקום שלכם. מידע נוסף זמין במאמר בנושא מיקומי GPU. |
| ממשקי רשת | סוגים שונים של ממשקי רשת, כמו ממשקים עם יכולת RDMA, על ידי התקנת הדרייבר המנוהל DRANET. מידע נוסף זמין במאמר הקצאת משאבי רשת באמצעות DRANET מנוהל של GKE. |
מגבלות
המגבלות הבאות חלות כשמשתמשים ב-DRA:
מצב הפעולה: DRA זמין רק באשכולות במצב רגיל.
סוג המאיץ: DRA ב-GKE תומך רק במעבדי GPU.
GPUs:
- אי אפשר להשתמש ב-GPU עם שיתוף זמן, ב-GPU עם כמה מופעים במקביל או ב-Multi-Process Service (MPS).
- בצמתים שמשתמשים במנהלי ההתקנים של ה-GPU של DRA, אי אפשר להשתמש בחבילת המדדים המנוהלת של NVIDIA Data Center GPU Manager (DCGM) כדי לשלוח מדדי DCGM ל-Cloud Monitoring.
- הדרייבר של ה-GPU עבור DRA הוא בבעלות NVIDIA, ולא בבעלות GKE. מידע נוסף זמין במאמרי העזרה של NVIDIA.
ממשקי רשת: מידע על מגבלות מופיע במאמר בנושא הקצאת משאבי רשת באמצעות DRANET מנוהל ב-GKE.
שינוי גודל אוטומטי:
- במקרה של מנהלי התקנים של DRA מצד שלישי שאתם מתקינים, כלי ה-Autoscaler של האשכול דורש שלמאגרי הצמתים יהיה לפחות צומת אחד. כדי למנוע את ההתאמה של מאגרי צמתים שמשתמשים במנהלי התקנים של צד שלישי לאפס צמתים, צריך להגדיר את המספר המינימלי של הצמתים ל-
1לפחות. - יכול להיות שהמידרוג האוטומטי של האשכול לא יפעל כמו שצריך עם מנהלי התקנים של DRA של צד שלישי. אם אתם משתמשים במנהלי התקנים של צד שלישי, ודאו שהם מפרסמים מידע רק על מכשירים שנמצאים באופן מקומי בצמתים ספציפיים.
- ב-DaemonSets במאגרי צמתים עם התאמה אוטומטית לעומס שמשתמשים ב-ResourceClaim סטטי כדי לשתף גישה למכשיר בין Pods, ההתאמה האוטומטית לעומס תומכת בעד 128 DaemonSet Pods. כדי לעקוף את ההגבלה הזו, אפשר לבצע אחת מהפעולות הבאות:
- כדי למנוע את הגדלת מספר הצמתים במאגר הצמתים ליותר מ-128, מגדירים את המספר המקסימלי של הצמתים.
- משתמשים בשדה
adminAccess(בטא) ב-ResourceClaim, שמאפשר ל-DaemonSet לגשת למכשירים שנמצאים בשימוש.
- אם הפודים מפנים ל-ResourceClaims ויש להם PriorityClass שמגדיר את מדיניות הקדימות ל-
PreemptLowerPriority, יכול להיות שזמן האחזור של שינוי הגודל האוטומטי יתארך. PreemptLowerPriorityהיא מדיניות ברירת המחדל של קדימות ההשתלטות על המשאבים ב-PriorityClass, לכן חשוב לוודא ששדהpreemptionPolicyמוגדר במפורש ל-Neverב-PriorityClass. מידע נוסף מופיע במאמר בנושא PriorityClass שלא מאפשר קדימה.
- במקרה של מנהלי התקנים של DRA מצד שלישי שאתם מתקינים, כלי ה-Autoscaler של האשכול דורש שלמאגרי הצמתים יהיה לפחות צומת אחד. כדי למנוע את ההתאמה של מאגרי צמתים שמשתמשים במנהלי התקנים של צד שלישי לאפס צמתים, צריך להגדיר את המספר המינימלי של הצמתים ל-
מיומנויות מומלצות להבנה ולשימוש ב-DRA
בקטע הזה מפורטות המלצות לאדמינים של פלטפורמות או למפעילים של אפליקציות שרוצים להשתמש ב-DRA כדי להקצות מכשירים לעומסי עבודה. ה-DRA משנה באופן משמעותי את השיטה שבה מבקשים מכשירים מצורפים, גם ב-GKE וגם ב-Kubernetes. כדי ליהנות מתרחישי שימוש מתקדמים יותר, כמו מעבר אוטומטי בין מכשירים מקושרים למכשיר אחר או סינון ובחירה של מכשירים ברמת דיוק גבוהה, כדאי לפעול לפי ההנחיות הבאות:
לומדים על CEL: באמצעות DRA, אפשר להשתמש בביטויי CEL כדי לבצע סינון מדויק של מכשירים בבקשות להקצאת משאבים וב-DeviceClasses. מקורות המידע הבאים יכולים לעזור לכם ללמוד על CEL:
מידע על ComputeClasses ב-GKE: אפשר להשתמש ב-ComputeClasses עם DRA כדי לענות על צרכים עסקיים כמו הקצאת מכונות וירטואליות מסוג Spot להרצת עומסי עבודה של הסקת מסקנות שמבקשים יחידות GPU חסכוניות. אפשר להיעזר במקורות המידע הבאים כדי לקבל מידע על ComputeClasses: