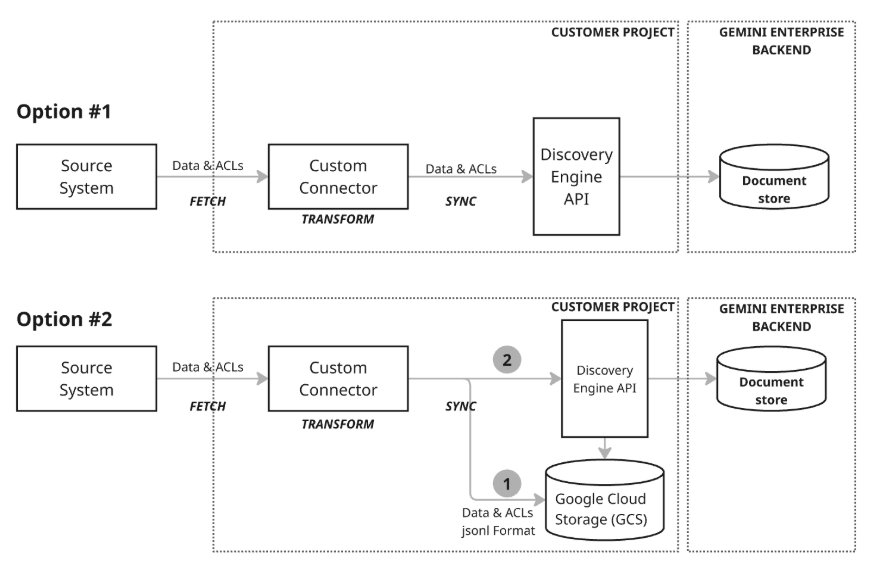
Com os conectores personalizados, você pode integrar fontes de dados externas que não fazem parte da biblioteca de conectores padrão do Gemini Enterprise, tornando os dados exclusivos da sua organização pesquisáveis e acessíveis usando linguagem natural, com tecnologia do Gemini e da inteligência de pesquisa avançada do Google. O conector personalizado interage diretamente com a API Discovery Engine, que permite o armazenamento, a indexação e a pesquisa inteligente de dados. O conector converte as informações de origem no formato de documento padronizado baseado em JSON (estruturando o conteúdo, os metadados e as listas de controle de acesso (ACLs)) e garante que esses dados sejam organizados em repositórios de dados. Esses armazenamentos funcionam como repositórios lógicos, idealmente representando um único formato de documento, cada um com seu próprio índice da Pesquisa e configurações dedicados.
Como funcionam os conectores personalizados
Os conectores personalizados usam um pipeline de dados automatizado para realizar três ações principais: buscar, transformar e sincronizar. Esse processo garante que os dados externos sejam preparados e enviados corretamente para o Gemini Enterprise.
Busca: o conector extrai dados, incluindo documentos, metadados e permissões, do sistema externo usando as APIs, os bancos de dados ou os formatos de arquivo dele.
Transformação: o conector converte dados brutos no formato de documento do Discovery Engine, estrutura o conteúdo e os metadados e atribui um ID exclusivo globalmente a cada documento. Para controles de acesso, é possível usar diretamente identidades reconhecidas pelo Google ou o mapeamento de identidade para usuários externos ou grupos personalizados.
Sincronização: o conector faz upload dos documentos para os repositórios de dados do Gemini Enterprise e os mantém atualizados por meio de jobs programados. A sincronização de dados é realizada usando um repositório de dados criado para uma entidade. Para mais informações sobre como criar um repositório de dados, consulte Processo de criação de repositório de dados. Escolha um modo de sincronização com base nas suas necessidades: Incremental adiciona e atualiza dados, enquanto Completo substitui todo o conjunto de dados.
ACLs e mapeamento de identidade
Para gerenciar o acesso no nível do documento, escolha entre dois métodos: ACLs puras ou mapeamento de identidade, dependendo do formato de identidade usado pelos dados.
ACLs puras (AclInfo): esse método é usado quando a fonte de dados usa identidades baseadas em e-mail reconhecidas por (Google Cloud). Essa abordagem é ideal para definir diretamente quem tem acesso.
Mapeamento de identidade: esse método é usado quando a fonte de dados usa nomes de usuário, IDs legados ou outros sistemas de identidade externos:
Ele estabelece uma associação clara e individual entre grupos de identidade externos (por exemplo, EXT1) e usuários ou grupos internos do provedor de identidade (IDP) (por exemplo,
IDPUser1@example.com).Ele permite que o sistema entenda e aplique controles de acesso baseados em grupos do sistema de origem, o que é útil quando uma API retorna rótulos de grupo sem associações completas de usuários ou para escalonar ACLs de maneira eficiente sem listar milhares de usuários por documento.
O processo de mapeamento de identidade requer a resolução de todas as estruturas de identidade aninhadas ou hierárquicas em uma lista simples de mapeamentos diretos, normalmente em um formato JSON especificado.
Use IDs de grupo de identidade externa exclusivos (por exemplo, EXT1) para identidades externas para manter a integridade do sistema. Para mais informações e exemplos, consulte Mapear identidades externas.
Processo de criação de repositório de dados
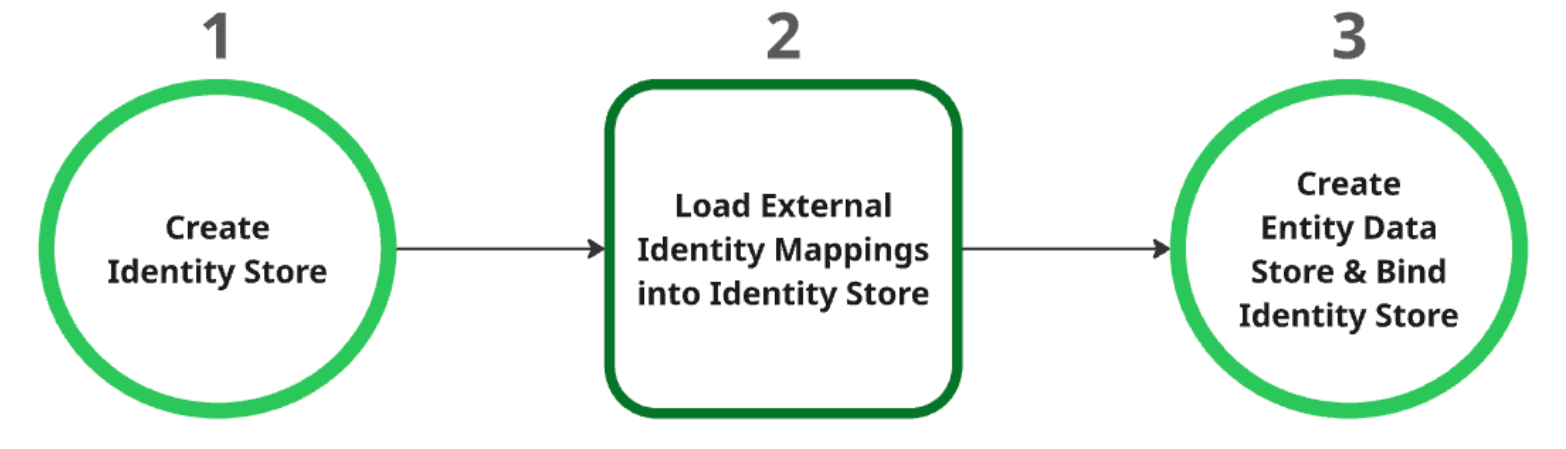
Crie o repositório de identidades: ele funciona como o recurso pai de todos os mapeamentos de identidade. Após a criação, as configurações do provedor de identidade (IDP) para envolvidos no projeto são buscadas automaticamente. Para mais informações, consulte Recuperar ou criar um repositório de identidades.
Carregar mapeamentos de identidade externa no repositório de identidades: depois de criar o repositório de identidades, carregue os dados de identidade externa nele. Para mais informações, consulte Ingerir o mapeamento de identidade no repositório de identidades.
Criar e vincular o repositório de dados de entidade: o repositório de dados de entidade só pode ser criado depois que o repositório de identidades for criado e os mapeamentos de identidade forem carregados. É necessário vincular o repositório de identidades ao repositório de dados da entidade durante a criação. Para mais informações sobre como criar um repositório de dados de entidade, consulte Criar repositório de dados.
Sincronização de dados
Há dois modelos de arquitetura diferentes para sincronizar dados:
Modelo de arquitetura 1: upsert incremental: a abordagem de upsert incremental é mais adequada para cenários em que os dados são transmitidos e exigem atualizações em tempo real. O conector usa a API Discovery Engine para realizar upserts (inserção ou atualização de dados) eficientes e incrementais, chamando as funções apropriadas com pequenas mudanças conforme elas ocorrem. Esse foco em tamanhos mínimos de alteração e atraso mínimo mantém o armazenamento de documentos altamente atualizado, mesmo com dados que mudam rapidamente.
Modelo de arquitetura 2: sincronização abrangente com o Google Cloud Storage: essa abordagem recomendada oferece um conjunto abrangente de recursos de gerenciamento de dados e alta flexibilidade. Ele oferece suporte a sincronizações completas, que permitem a inserção, atualização e exclusão de dados em todo o conjunto de dados, e sincronizações incrementais, que lidam apenas com inserções e atualizações enviando mudanças. Isso torna a abordagem robusta para uma ampla gama de necessidades de dados, principalmente para gerenciar operações de dados maiores ou mais complexas. Esse modelo usa um processo de preparo (etapa 1 no diagrama) em que o conector primeiro grava os dados no Google Cloud Storage (GCS) e, em seguida, usa a API Discovery Engine para atualizar o repositório de documentos chamando as funções de importação necessárias do local de preparo do GCS.
Os conectores personalizados são flexíveis o suficiente para oferecer suporte a uma arquitetura híbrida, permitindo que você implemente upserts incrementais para dados que mudam rapidamente e sincronização abrangente para atualizações ou exclusões completas de dados programadas.