מחברים בהתאמה אישית מאפשרים לכם לשלב מקורות נתונים חיצוניים שלא נכללים בספריית המחברים הרגילה של Gemini Enterprise. כך אתם יכולים לחפש בנתונים הייחודיים של הארגון שלכם ולגשת אליהם באמצעות שפה טבעית, בעזרת Gemini וטכנולוגיית החיפוש המתקדמת של Google. המחבר המותאם אישית יוצר אינטראקציה ישירות עם Discovery Engine API, שמאפשר אחסון נתונים, הוספה לאינדקס ויכולות חיפוש חכמות. המחבר ממיר את המידע מהמקור לפורמט מסמך סטנדרטי שמבוסס על JSON (מבנה התוכן, המטא-נתונים ורשימות בקרת הגישה (ACL)) ומוודא שהנתונים האלה מאורגנים במאגרי נתונים. המאגרים האלה פועלים כמאגרים לוגיים, ובאופן אידיאלי מייצגים פורמט מסמך יחיד, לכל אחד מהם יש אינדקס חיפוש והגדרות ייעודיים משלו.
איך פועלים מחברים בהתאמה אישית
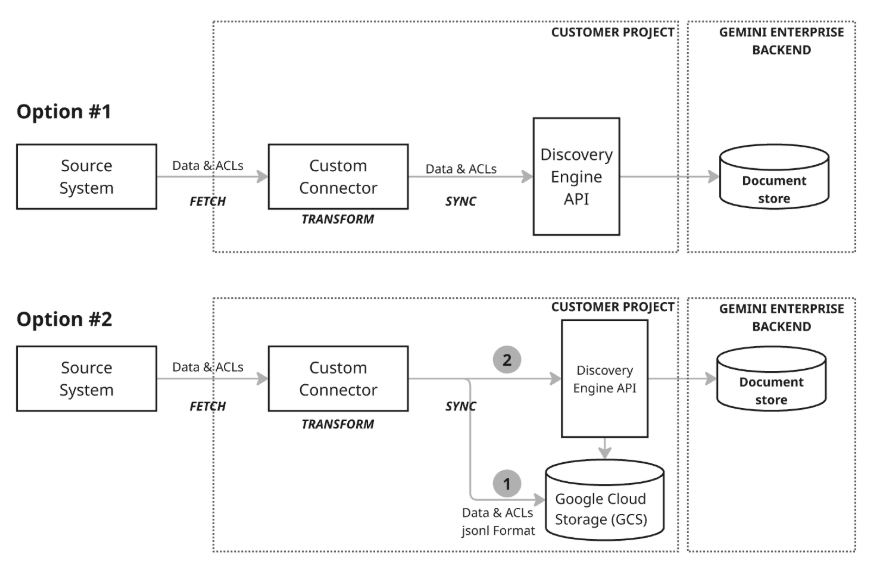
מחברים בהתאמה אישית משתמשים בפייפליין נתונים אוטומטי כדי לבצע שלוש פעולות עיקריות: אחזור, המרה וסנכרון. התהליך הזה מבטיח שהנתונים החיצוניים מוכנים ומועלים ל-Gemini Enterprise בצורה נכונה.
אחזור: המחבר שולף נתונים, כולל מסמכים, מטא-נתונים והרשאות, ממערכת חיצונית באמצעות ממשקי ה-API, מסדי הנתונים או פורמטי הקבצים שלה.
התמרה: המחבר ממיר נתונים גולמיים לפורמט המסמך של Discovery Engine, מארגן את התוכן והמטא-נתונים ומקצה מזהה ייחודי גלובלי לכל מסמך. כדי להגדיר בקרת גישה, אתם יכולים להשתמש ישירות בזהויות ש-Google מזהה, או במיפוי זהויות למשתמשים חיצוניים או לקבוצות בהתאמה אישית.
סנכרון: המחבר מעלה את המסמכים למאגרי הנתונים של Gemini Enterprise ומעדכן אותם באמצעות משימות מתוזמנות. סנכרון הנתונים מתבצע באמצעות מאגר נתונים שנוצר בשביל ישות. מידע נוסף על יצירת מאגר נתונים זמין במאמר תהליך היצירה של מאגר נתונים. בוחרים מצב סנכרון בהתאם לצרכים: מצטבר מוסיף ומעדכן נתונים, ומלא מחליף את כל מערך הנתונים.
רשימות ACL ומיפוי זהויות
כדי לנהל את הגישה ברמת המסמך, בוחרים בין שתי שיטות – רשימות ACL טהורות או מיפוי זהויות, בהתאם לפורמט הזהות שבו משתמשים בנתונים.
רשימות ACL טהורות (AclInfo): השיטה הזו משמשת כשמקור הנתונים משתמש בזהויות שמבוססות על אימייל ומוכרות על ידי (Google Cloud). הגישה הזו אידיאלית להגדרה ישירה של מי שיש לו גישה.
מיפוי זהויות: השיטה הזו משמשת כשמקור הנתונים משתמש בשמות משתמשים, במזהים מדור קודם או במערכות זהויות חיצוניות אחרות:
הוא יוצר שיוך ברור של אחד לאחד בין קבוצות זהויות חיצוניות (למשל, EXT1) לבין משתמשים או קבוצות של ספק זהויות (IDP) פנימי (למשל,
IDPUser1@example.com).היא מאפשרת למערכת להבין ולהחיל אמצעי בקרת גישה שמבוססים על קבוצות ממערכת המקור. זה שימושי כש-API מחזיר תוויות של קבוצות בלי חברויות מלאות של משתמשים, או כדי לשנות ביעילות את קנה המידה של רשימות ACL בלי לרשום אלפי משתמשים לכל מסמך.
בתהליך מיפוי הזהויות, צריך להמיר את כל מבני הזהויות המקוננים או ההיררכיים לרשימה שטוחה של מיפויים ישירים, בדרך כלל בפורמט JSON שצוין.
כדי לשמור על תקינות המערכת, השתמשו במזהים ייחודיים של קבוצות זהויות חיצוניות (למשל, EXT1) לזהויות חיצוניות. מידע נוסף ודוגמאות זמינים במאמר מיפוי זהויות חיצוניות.
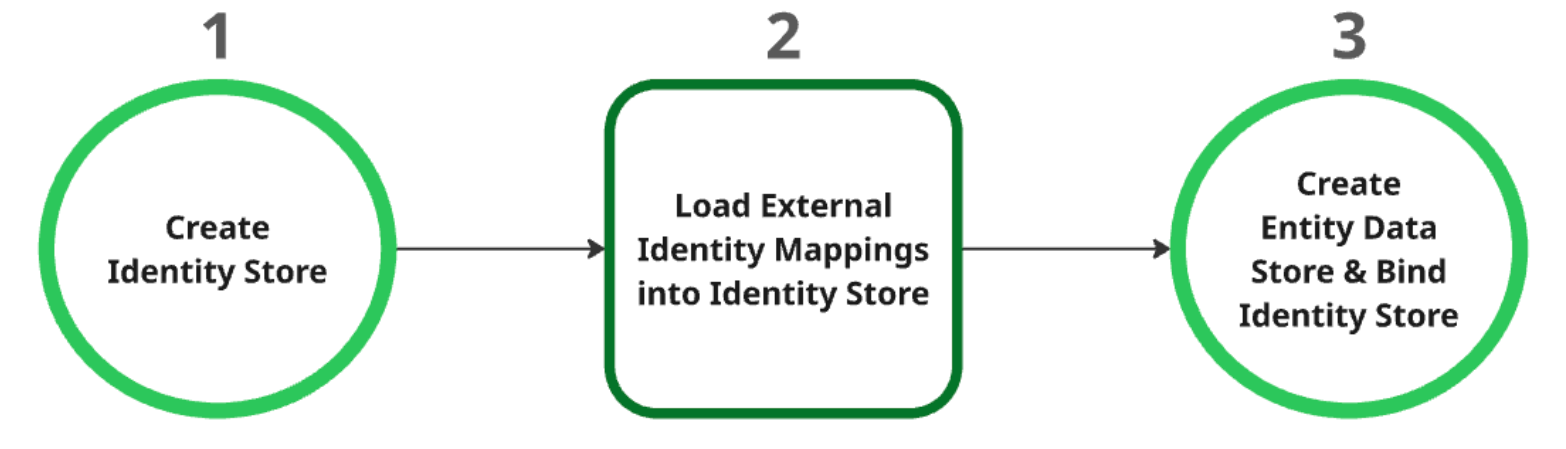
תהליך היצירה של מאגר נתונים
יוצרים את מאגר הזהויות: המאגר הזה משמש כמשאב הורה לכל מיפויי הזהויות. אחרי שיוצרים את הפרויקט, ההגדרות של ספק הזהויות (IDP) ברמת הפרויקט נשלפות באופן אוטומטי. מידע נוסף זמין במאמר אחזור או יצירה של מאגר זהויות.
טעינת מיפויים של זהויות חיצוניות למאגר הזהויות: אחרי שיוצרים את מאגר הזהויות, טוענים אליו את נתוני הזהויות החיצוניות. מידע נוסף זמין במאמר הטמעת מיפוי זהויות במאגר הזהויות.
יצירה וקישור של מאגר נתוני הישויות: אפשר ליצור את מאגר נתוני הישויות רק אחרי שמאגר הזהויות נוצר בהצלחה ומיפויי הזהויות נטענו. אתם צריכים לקשר את מאגר הזהויות למאגר נתוני הישויות במהלך היצירה שלו. מידע נוסף על יצירת מאגר נתונים של ישויות זמין במאמר יצירת מאגר נתונים.
סנכרון נתונים
יש שני מודלים שונים של ארכיטקטורה לסנכרון נתונים:
מודל ארכיטקטורה 1: עדכון או הוספה (upsert) מצטברים: הגישה של עדכון או הוספה מצטברים מתאימה במיוחד לתרחישים שבהם הנתונים מועברים בסטרימינג ונדרשים עדכונים בזמן אמת. המחבר משתמש ב-Discovery Engine API כדי לבצע עדכונים או הוספות (upsert) מצטברים ויעילים, על ידי קריאה לפונקציות המתאימות עם שינויים קטנים כשהם מתרחשים. ההתמקדות הזו בגודל שינוי מינימלי ובעיכוב מינימלי שומרת על עדכניות גבוהה של מאגר המסמכים, גם כשהנתונים משתנים במהירות.
מודל ארכיטקטורה 2: סנכרון מקיף עם Google Cloud Storage: הגישה המומלצת הזו מציעה קבוצה מקיפה של תכונות לניהול נתונים וגמישות רבה. הוא תומך בסנכרונים מלאים, שמאפשרים להוסיף, לעדכן ולמחוק נתונים בכל קבוצת הנתונים, ובסנכרונים מצטברים, שבהם רק מוסיפים ומעדכנים נתונים על ידי שליחת שינויים. הגישה הזו מתאימה למגוון רחב של צורכי נתונים, במיוחד לניהול פעולות נתונים גדולות או מורכבות יותר. המודל הזה משתמש בתהליך של שלב ביניים (שלב 1 בתרשים) שבו המחבר כותב קודם את הנתונים ב- Google Cloud Storage (GCS), ואז משתמש ב-Discovery Engine API כדי לעדכן את מאגר המסמכים על ידי קריאה לפונקציות הייבוא הנדרשות ממיקום ה-GCS בשלב הביניים.
מחברים בהתאמה אישית הם גמישים מספיק כדי לתמוך בארכיטקטורה היברידית, שמאפשרת לכם להטמיע עדכון או הוספה (upsert) מצטברים לנתונים שמשתנים במהירות, וסנכרון מקיף לעדכונים או למחיקות מתוזמנים של נתונים מלאים.