


בדף הזה מוסבר איך ליצור מחבר בהתאמה אישית.
לפני שמתחילים
לפני שמתחילים, חשוב לוודא שהתנאים הבאים מתקיימים:
מתקינים ומפעילים את ה-CLI של gcloud. מוודאים שהפרויקט מאומת.
מתקינים את ספריות Python הנדרשות:
pip install google-cloud-discoveryengine requestsמקבלים גישה של אדמין ב-Discovery Engine לפרויקט ב- Google Cloud .
משיגים פרטי כניסה למקור הנתונים של הצד השלישי (כמו מפתחות API או אימות של מסד נתונים).
יוצרים תוכנית ברורה למיפוי נתונים. המיפוי צריך לכלול את השדות שצריך להוסיף לאינדקס ואת האופן שבו בקרת הגישה מיוצגת, כולל זהויות של צד שלישי.
יצירת מחבר בסיסי
בקטע הזה מוסבר איך ליצור מחבר בהתאמה אישית בשפה שבחרתם. העקרונות והתבניות שמוצגים כאן חלים על כל מערכת חיצונית. כדי ליצור מחבר בסיסי, פשוט מתאימים את הקריאות ל-API ואת טרנספורמציות הנתונים למקור הספציפי בשפה שבחרתם.
אחזור נתונים
כדי להתחיל, מאחזרים נתונים ממקור הנתונים של הצד השלישי. בדוגמה הזו אנחנו מראים איך לאחזר פוסטים באמצעות עימוד. בסביבות ייצור, מומלץ להשתמש בגישת סטרימינג לקבוצות נתונים גדולות. כך אפשר למנוע בעיות בזיכרון שעלולות להתרחש כשכל הנתונים נטענים בבת אחת.
Python
    from typing import List
    import requests

    def fetch_posts(base_url: str, per_page: int = 15) -> List[dict]:
        #Fetch all posts from the given site.#
        url = base_url.rstrip("/") + "/wp-json/wp/v2/posts"
        posts: List[dict] = []
        page = 1
        while True:
            resp = requests.get(
                url,
                params={"page": page, "per_page": per_page},
                # headers={"Authorization": "Bearer YOUR_API_KEY"}, # Add auth if needed
            )
            resp.raise_for_status()
            batch = resp.json()
            posts.extend(batch)
            if len(batch) < per_page:
                break
            page += 1
        return posts
טרנספורמציה של נתונים
כדי להמיר את נתוני המקור לפורמט המסמך של Discovery Engine, צריך להגדיר את המבנה שלהם כמו בדוגמה הבאה של המטען הייעודי (payload). אפשר לכלול כמה צמדי מפתח/ערך שרוצים. לדוגמה, אתם יכולים לכלול את התוכן המלא כדי לבצע חיפוש מקיף. לחלופין, אפשר לכלול שדות מובְנים לחיפוש לפי מאפיינים, או שילוב של שניהם.
Python
    from typing import List
    import json
    from google.cloud import discoveryengine_v1 as discoveryengine

    def convert_posts_to_documents(posts: List[dict]) -> List[discoveryengine.Document]:
        # Convert WP posts into Discovery Engine Document messages.
        docs: List[discoveryengine.Document] = []
        for post in posts:
            payload = {
                "title": post.get("title", {}).get("rendered"),
                "body": post.get("content", {}).get("rendered"),
                "url": post.get("link"),
                "author": post.get("author"),
                "categories": post.get("categories"),
                "tags": post.get("tags"),
                "date": post.get("date"),
            }
            doc = discoveryengine.Document(
                id=str(post["id"]),
                json_data=json.dumps(payload),
            )
            docs.append(doc)
        return docs
אחזור או יצירה של מאגר זהויות
כדי לנהל זהויות וקבוצות של משתמשים לצורך בקרת גישה, צריך לאחזר או ליצור מאגר זהויות. הפונקציה הזו מאחזרת מאגר זהויות קיים לפי המזהה, הפרויקט והמיקום שלו. אם מאגר הזהויות לא קיים, המערכת יוצרת ומחזירה מאגר זהויות חדש וריק.
Python
    from google.cloud import discoveryengine_v1 as discoveryengine

    def get_or_create_ims_data_store(
        project_id: str,
        location: str,
        identity_mapping_store_id: str,
    ) -> discoveryengine.DataStore:
      """Get or create a DataStore."""
      # Initialize the client
      client_ims = discoveryengine.IdentityMappingStoreServiceClient()
      # Construct the parent resource name
      parent_ims = client_ims.location_path(project=project_id, location=location)

      try:
        # Create the request object
        name = f"projects/{project_id}/locations/{location}/identityMappingStores/{identity_mapping_store_id}"
        request = discoveryengine.GetIdentityMappingStoreRequest(
            name=name,
        )
        return client_ims.get_identity_mapping_store(request=request)
      except:
        # Create the IdentityMappingStore object (it can be empty for basic creation)
        identity_mapping_store = discoveryengine.IdentityMappingStore()
        # Create the request object
        request = discoveryengine.CreateIdentityMappingStoreRequest(
            parent=parent_ims,
            identity_mapping_store=identity_mapping_store,
            identity_mapping_store_id=identity_mapping_store_id,
        )
        return client_ims.create_identity_mapping_store(request=request)
הפונקציה get_or_create_ims_data_store משתמשת במשתני המפתח הבאים:
-
project_id: מזהה הפרויקט ב- Google Cloud . -
location: המיקום של מאגר מיפוי הזהויות ב- Google Cloud . -
identity_mapping_store_id: מזהה ייחודי של מאגר הזהויות. -
client_ims: מופע של discoveryengine.IdentityMappingStoreServiceClient שמשמש לאינטראקציה עם ה-API של מאגר הזהויות. -
parent_ims: שם המשאב של מיקום ההורה, שנוצר באמצעות client_ims.location_path. -
name: שם המשאב המלא של מאגר מיפוי הזהויות, שמשמש ל-GetIdentityMappingStoreRequest.
הטמעת מיפוי זהויות במאגר הזהויות
כדי לטעון רשומות של מיפוי זהויות למאגר הזהויות שצוין, משתמשים בפונקציה הזו. היא מקבלת רשימה של רשומות מיפוי זהויות ומתחילה פעולת ייבוא מוטבעת. השלב הזה חיוני כדי ליצור את הקשרים בין המשתמשים, הקבוצות והזהויות החיצוניות שנדרשים לבקרת גישה ולהתאמה אישית.
Python
Python
from google.cloud import discoveryengine_v1 as discoveryengine

def load_ims_data(
    ims_store: discoveryengine.DataStore,
    id_mapping_data: list[discoveryengine.IdentityMappingEntry],
) -> discoveryengine.DataStore:
  """Get the IMS data store."""
  # Initialize the client
  client_ims = discoveryengine.IdentityMappingStoreServiceClient()

  #  Create the InlineSource object
  inline_source = discoveryengine.ImportIdentityMappingsRequest.InlineSource(
      identity_mapping_entries=id_mapping_data
  )

  # Create the main request object
  request_ims = discoveryengine.ImportIdentityMappingsRequest(
      identity_mapping_store=ims_store.name,
      inline_source=inline_source,
  )

  try:
    # Create the InlineSource object, which holds your list of entries
    operation = client_ims.import_identity_mappings(
        request=request_ims,
    )
    result = operation.result()
    return result

  except Exception as e:
    print(f"IMS Load Error: {e}")
    return None
הפונקציה load_ims_data משתמשת במשתני המפתח הבאים:
-
ims_store: האובייקט discoveryengine.DataStore שמייצג את מאגר מיפוי הזהויות שאליו ייטענו הנתונים. -
id_mapping_data: רשימה של אובייקטים מסוג discoveryengine.IdentityMappingEntry, שכל אחד מהם מכיל זהות חיצונית ואת מזהה המשתמש או הקבוצה התואם. -
result: ערך החזרה מסוג discoveryengine.DataStore.
יצירת מאגר נתונים
כדי להשתמש במחבר בהתאמה אישית, צריך להפעיל מאגר נתונים לתוכן. משתמשים ב-default_collection למחברים בהתאמה אישית. הפרמטר IndustryVertical מתאים אישית את ההתנהגות של מאגר הנתונים לתרחישים ספציפיים לדוגמה. GENERIC מתאים לרוב התרחישים. עם זאת, אתם יכולים לבחור ערך אחר לתחום מסוים, כמו MEDIA או HEALTHCARE_FHIR. מגדירים את השם המוצג ומאפיינים אחרים בהתאם לדרישות ולמוסכמות מתן השמות של הפרויקט.
Python
from google.cloud import discoveryengine_v1 as discoveryengine

def get_or_create_data_store(
    project_id: str,
    location: str,
    display_name: str,
    data_store_id: str,
    identity_mapping_store: str,
) -> discoveryengine.DataStore:
  """Get or create a DataStore."""
  client = discoveryengine.DataStoreServiceClient()
  ds_name = client.data_store_path(project_id, location, data_store_id)
  try:
    result = client.get_data_store(request={"name": ds_name})
    return result
  except:
    parent = client.collection_path(project_id, location, "default_collection")
    operation = client.create_data_store(
        request={
            "parent": parent,
            "data_store": discoveryengine.DataStore(
                display_name=display_name,
                acl_enabled=True,
                industry_vertical=discoveryengine.IndustryVertical.GENERIC,
                identity_mapping_store=identity_mapping_store,
            ),
            "data_store_id": data_store_id,
        }
    )
    result = operation.result()
    return result
הפונקציה get_or_create_data_store משתמשת במשתני המפתח הבאים:
-
project_id: מזהה הפרויקט ב- Google Cloud . -
location: המיקום של מאגר הנתונים ב- Google Cloud . -
display_name: השם המוצג של מאגר הנתונים, שקריא לאנשים. -
data_store_id: מזהה ייחודי של מאגר הנתונים. -
identity_mapping_store: שם המשאב של מאגר מיפוי הזהויות שרוצים לקשר. -
result: ערך החזרה מסוג discoveryengine.DataStore.
העלאת מסמכים בתוך השורה
כדי לשלוח מסמכים ישירות ל-Discovery Engine, משתמשים בהעלאה בתוך השורה. השיטה הזו משתמשת במצב עדכון מצטבר כברירת מחדל, ואין בה תמיכה במצב עדכון מלא. במצב מצטבר, מסמכים חדשים מתווספים ומסמכים קיימים מתעדכנים, אבל מסמכים שכבר לא נמצאים במקור לא נמחקים. מצב התאמה מלאה מסנכרן את מאגר הנתונים עם נתוני המקור, כולל מחיקת מסמכים שכבר לא קיימים במקור.
עדכון מצטבר מתאים למערכות כמו CRM, שבהן יש שינויים קטנים ותכופים בנתונים. במקום לסנכרן את כל מסד הנתונים, אתם יכולים לשלוח רק שינויים ספציפיים, וכך להפוך את התהליך למהיר ויעיל יותר.
השיטה המומלצת היא לבצע סנכרון מלא ראשוני, ואחריו סנכרונים מצטברים בתדירות גבוהה יותר.
Python
    from typing import List
    from google.cloud import discoveryengine_v1 as discoveryengine

    def upload_documents_inline(
        project_id: str,
        location: str,
        data_store_id: str,
        branch_id: str,
        documents: List[discoveryengine.Document],
    ) -> discoveryengine.ImportDocumentsMetadata:
        """Inline import of Document messages."""
        client = discoveryengine.DocumentServiceClient()
        parent = client.branch_path(
            project=project_id,
            location=location,
            data_store=data_store_id,
            branch=branch_id,
        )
        request = discoveryengine.ImportDocumentsRequest(
            parent=parent,
            inline_source=discoveryengine.ImportDocumentsRequest.InlineSource(
                documents=documents,
            ),
        )
        operation = client.import_documents(request=request)
        operation.result()
        result = operation.metadata
        return result
הפונקציה upload_documents_inline משתמשת במשתני המפתח הבאים:
-
project_id: מזהה הפרויקט ב- Google Cloud . -
location: המיקום של מאגר הנתונים ב- Google Cloud . -
data_store_id: המזהה של מאגר הנתונים. -
branch_id: המזהה של הסניף במאגר הנתונים (בדרך כלל "0"). -
documents: רשימה של אובייקטים מסוג discoveryengine.Document להעלאה. -
result: ערך החזרה מסוג discoveryengine.ImportDocumentsMetadata.
השדה uri באובייקט discoveryengine.Document משמש כדי להצביע על מקור התוכן שהוטמע, כבייטים גולמיים או כ-URI ב- Google Cloud Storage. הוא שונה מה-URI של תוכן המקור של הצד השלישי. צריך להגדיר את ה-URI של תוכן המקור של הצד השלישי כשדה בתוך המטען הייעודי (payload) של json_data במסמך. לדוגמה, בפונקציה convert_posts_to_documents, השדה url ב-payload משמש למטרה הזו.
אימות המחבר
כדי לוודא שהמחבר פועל כמו שצריך, מבצעים הרצת בדיקה כדי לוודא שזרימת הנתונים מהמקור אל Discovery Engine תקינה.
Python
    from google.cloud import discoveryengine_v1 as discoveryengine
    from google.api_core import exceptions as gcp_exceptions

    SITE = "https://altostrat.com"
    PROJECT_ID = "ucs-3p-connectors-testing"
    LOCATION = "global"
    IDENTITY_MAPPING_STORE_ID = "your-unique-ims-id17" # A unique ID for your new store
    DATA_STORE_ID = "my-acl-ds-id1"
    BRANCH_ID = "0"

    posts = fetch_posts(SITE)
    docs = convert_posts_to_documents(posts)
    print(f"Fetched {len(posts)} posts and converted to {len(docs)} documents.")

    try:
      # Step #1: Retrieve an existing identity mapping store or create a new identity mapping store
      ims_store = get_or_create_ims_data_store(PROJECT_ID, LOCATION, IDENTITY_MAPPING_STORE_ID)
      print(f"STEP #1: IMS Store Retrieval/Creation: {ims_store}")

      RAW_IDENTITY_MAPPING_DATA = [
          discoveryengine.IdentityMappingEntry(
              external_identity="external_id_1",
              user_id="testuser1@example.com",
          ),
          discoveryengine.IdentityMappingEntry(
              external_identity="external_id_2",
              user_id="testuser2@example.com",
          ),
          discoveryengine.IdentityMappingEntry(
              external_identity="external_id_2",
              group_id="testgroup1@example.com",
          )
      ]

      # Step #2: Load IMS Data
      response = load_ims_data(ims_store, RAW_IDENTITY_MAPPING_DATA)
      print(
          "\nStep #2: Load Data in IMS Store successful.", response
      )

      # Step #3: Create Entity Data Store & Bind IMS Data Store
      data_store =  get_or_create_data_store(PROJECT_ID, LOCATION, "my-acl-datastore", DATA_STORE_ID, ims_store.name)
      print("\nStep #3: Entity Data Store Create Result: ", data_store)

      metadata = upload_documents_inline(
          PROJECT_ID, LOCATION, DATA_STORE_ID, BRANCH_ID, docs
      )
      print(f"Uploaded {metadata.success_count} documents inline.")

    except gcp_exceptions.GoogleAPICallError as e:
      print(f"\n--- API Call Failed ---")
      print(f"Server Error Message: {e.message}")
      print(f"Status Code: {e.code}")

    except Exception as e:
      print(f"An error occurred: {e}")
מוודאים שקוד המחבר משתמש במשתני המפתח הבאים:
-
SITE: כתובת ה-URL הבסיסית של מקור הנתונים של הצד השלישי. -
PROJECT_ID: מזהה הפרויקט ב- Google Cloud . -
LOCATION: המיקום של המשאבים ב- Google Cloud . -
IDENTITY_MAPPING_STORE_ID: מזהה ייחודי של מאגר מיפוי הזהויות. -
DATA_STORE_ID: מזהה ייחודי של מאגר הנתונים. -
BRANCH_ID: המזהה של ההסתעפות במאגר הנתונים. -
posts: מאחסן את הפוסטים שנשלפו מהמקור של הצד השלישי. docs: המסמכים שהומרו נשמרים בפורמט discoveryengine.Document.-
ims_store: האובייקט discoveryengine.DataStore שאוחזר או נוצר למיפוי זהויות. -
RAW_IDENTITY_MAPPING_DATA: רשימה של אובייקטים מסוג discoveryengine.IdentityMappingEntry.
הפלט אמור להיראות כך:
Shell
  Fetched 20 posts and converted to 20 documents.
  STEP #1: IMS Store Retrieval/Creation: "projects/ <Project Number>/locations/global/identityMappingStores/your-unique-ims-id17"
  Step #2: Load Data in IMS Store successful.
  Step #3: Entity Data Store Create Result: "projects/ <Project Number>/locations/global/collections/default_collection/dataStores/my-acl-ds-id1"
  display_name: "my-acl-datastore"
  industry_vertical: GENERIC
  create_time {
    seconds: 1760906997
    nanos: 192641000
  }
  default_schema_id: "default_schema"
  acl_enabled: true
  identity_mapping_store: "projects/ <Project Number>/locations/global/identityMappingStores/your-unique-ims-id17".
  Uploaded 20 documents inline.
בשלב הזה אפשר גם לראות את מאגר הנתונים במסוף Google Google Cloud :
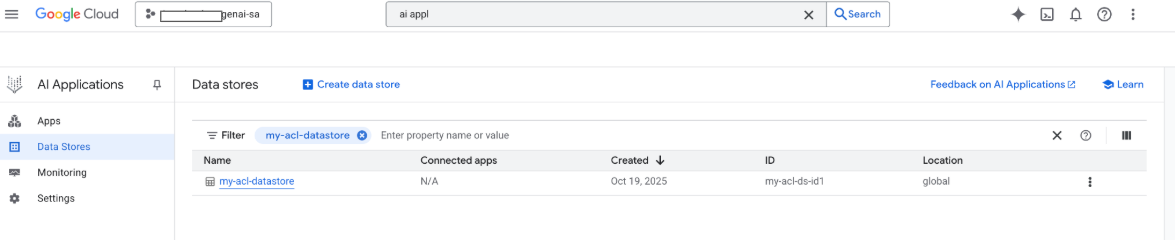
כשמבצעים חיפוש, המערכת משתמשת בשדות מהמטען הייעודי (payload) לצורך החיפוש, ובשדה ה-URI של המטען הייעודי לצורך ציטוטים. שלושת שדות הנכס העיקריים ש-Gemini Enterprise מזהה הם title, description ו-uri. לשדות המסמכים התואמים יכולים להיות שמות שונים, ואפשר למפות אותם באמצעות האפשרות Schema -> Edit במסוף Google Cloud .
יצירת מחבר עם העלאה ל- Google Cloud Storage
ייבוא מוטבע מתאים לפיתוח, אבל מחברים בסביבת הייצור צריכים להשתמש ב- Google Cloud Storage כדי לשפר את יכולת ההתאמה לעומס (scalability) ולאפשר מצב התאמה מלא. הגישה הזו מטפלת ביעילות בקבוצות נתונים גדולות ותומכת במחיקה אוטומטית של מסמכים שכבר לא קיימים במקור הנתונים של הצד השלישי.
המרת מסמכים ל-JSONL
כדי להכין מסמכים לייבוא בכמות גדולה ל-Discovery Engine, צריך להמיר אותם לפורמט JSON Lines.
Python
    from typing import List
    from google.cloud import discoveryengine_v1 as discoveryengine

    def convert_documents_to_jsonl(
        documents: List[discoveryengine.Document],
    ) -> str:
        """Serialize Document messages to JSONL."""
        return "\n".join(
            discoveryengine.Document.to_json(doc, indent=None)
            for doc in documents
        ) + "\n"
הפונקציה convert_documents_to_jsonl משתמשת במשתנה הבא:
-
documents: רשימה של אובייקטים מסוג discoveryengine.Document להמרה.
העלאה אל Google Cloud Storage
כדי לאפשר ייבוא יעיל בכמות גדולה, צריך להעביר את הנתונים ל- Google Cloud Storage.
Python
    from google.cloud import storage

    def upload_jsonl_to_gcs(jsonl: str, bucket_name: str, blob_name: str) -> str:
        """Upload JSONL content to Google Cloud Storage."""
        client = storage.Client()
        bucket = client.bucket(bucket_name)
        blob = bucket.blob(blob_name)
        blob.upload_from_string(jsonl, content_type="application/json")
        return f"gs://{bucket_name}/{blob_name}"
הפונקציה upload_jsonl_to_gcs משתמשת במשתני המפתח הבאים:
jsonl: תוכן המחרוזת בפורמט JSONL שרוצים להעלות.-
bucket_name: השם של קטגוריית האחסון ב- Google Cloud . -
blob_name: השם של ה-blob (האובייקט) בקטגוריה שצוינה.
ייבוא מ- Google Cloud Storage עם התאמה מלאה
כדי לבצע סנכרון נתונים מלא באמצעות מצב התאמה מלאה, צריך להשתמש בשיטה הזו. כך אפשר לוודא שמאגר הנתונים משקף בדיוק את מקור הנתונים של הצד השלישי, ומסיר באופן אוטומטי מסמכים שכבר לא קיימים.
כשמייבאים מ- Google Cloud Storage, חשוב לשים לב למגבלות הבאות:
- בקשת ייבוא אחת יכולה להכיל עד 100 קבצים, או 100,000 קבצים אם הפרמטר
dataSchemaמוגדר לערךcontent. כל קובץ יכול להיות בגודל של עד 2GB, או 100MB אם הפרמטר
dataSchemaמוגדר כ-content.
Python
    from google.cloud import discoveryengine_v1 as discoveryengine

    def import_documents_from_gcs(
        project_id: str,
        location: str,
        data_store_id: str,
        branch_id: str,
        gcs_uri: str,
    ) -> discoveryengine.ImportDocumentsMetadata:
        """Bulk-import documents from Google Cloud Storage with FULL reconciliation mode."""
        client = discoveryengine.DocumentServiceClient()
        parent = client.branch_path(
            project=project_id,
            location=location,
            data_store=data_store_id,
            branch=branch_id,
        )
        gcs_source = discoveryengine.GcsSource(input_uris=[gcs_uri])
        request = discoveryengine.ImportDocumentsRequest(
            parent=parent,
            gcs_source=gcs_source,
            reconciliation_mode=
                discoveryengine.ImportDocumentsRequest
                .ReconciliationMode.FULL,
        )
        operation = client.import_documents(request=request)
        operation.result()
        return operation.metadata
הפונקציה import_documents_from_gcs משתמשת במשתני המפתח הבאים:
-
project_id: מזהה הפרויקט ב- Google Cloud . -
location: המיקום של מאגר הנתונים ב- Google Cloud . -
data_store_id: המזהה של מאגר הנתונים. -
branch_id: המזהה של הסניף במאגר הנתונים (בדרך כלל "0"). -
gcs_uri: ה-URI של Google Cloud Storage שמפנה לקובץ ה-JSONL.
Test Google Cloud Storage upload
כדי לאמת את תהליך העבודה של הייבוא מבוסס-האחסון של Google Cloud , מריצים את הפקודה הבאה:
Python
  BUCKET = "your-existing-bucket"
  BLOB = "path-to-any-blob/wp/posts.jsonl"
  SITE = "https://altostrat.com"
  PROJECT_ID = "ucs-3p-connectors-testing"
  LOCATION = "global"
  IDENTITY_MAPPING_STORE_ID = "your-unique-ims-id17" # A unique ID for your new store
  DATA_STORE_ID = "your-data-store-id"
  BRANCH_ID = "0"
  posts = fetch_posts(SITE)
  docs = convert_posts_to_documents(posts)
  print(f"Fetched {len(posts)} posts and converted to {len(docs)} documents.")
  jsonl_payload = convert_documents_to_jsonl(docs)
  gcs_uri = upload_jsonl_to_gcs(jsonl_payload, BUCKET, BLOB)
  print("Uploaded to:", gcs_uri)

  metadata = import_documents_from_gcs(
      PROJECT_ID, LOCATION, DATA_STORE_ID, BRANCH_ID, gcs_uri
  )
  print(f"Imported: {metadata.success_count} documents")
המשתנים העיקריים הבאים משמשים לבדיקת ההעלאה ל- Google Cloud Storage:
-
BUCKET: השם של קטגוריית האחסון ב- Google Cloud . -
BLOB: הנתיב ל-blob בתוך הקטגוריה. -
SITE: כתובת ה-URL הבסיסית של מקור הנתונים של הצד השלישי. -
PROJECT_ID: מזהה הפרויקט ב- Google Cloud . LOCATION: המיקום של המשאבים (למשל, global). Google Cloud-
IDENTITY_MAPPING_STORE_ID: מזהה ייחודי של מאגר מיפוי הזהויות. -
DATA_STORE_ID: מזהה ייחודי של מאגר הנתונים. -
BRANCH_ID: המזהה של הסניף במאגר הנתונים (בדרך כלל "0"). -
jsonl_payload: המסמכים שהומרו לפורמט JSONL. -
gcs_uri: ה-URI ב- Google Cloud Storage של קובץ ה-JSONL שהועלה.
הפלט אמור להיראות כך:
Shell
    Fetched 20 posts and converted to 20 documents.
    Uploaded to: gs://alex-de-bucket/wp/posts.jsonl
    Imported: 20 documents
ניהול הרשאות
כדי לנהל את הגישה ברמת המסמך בסביבות ארגוניות, Gemini Enterprise תומך ברשימות של בקרת גישה (ACL) ובמיפוי זהויות, שעוזרים להגביל את התוכן שהמשתמשים יכולים לראות.
הפעלת רשימות ACL במאגר הנתונים
כדי להפעיל רשימות ACL כשיוצרים את מאגר הנתונים, מריצים את הפקודה הבאה:
Python
  # get_or_create_data_store()
  "data_store": discoveryengine.DataStore(
      display_name=data_store_id,
      industry_vertical=discoveryengine.IndustryVertical.GENERIC,
      acl_enabled=True, # ADDED
  )
הוספת רשימות ACL למסמכים
כדי לחשב את AclInfo ולכלול אותו בהמרת המסמכים, מריצים את הפקודה הבאה:
Python
  # convert_posts_to_documents()
  doc = discoveryengine.Document(
      id=str(post["id"]),
      json_data=json.dumps(payload),
      acl_info=discoveryengine.Document.AclInfo(
          readers=[{
              "principals": [
                  {"user_id": "baklavainthebalkans@gmail.com"},
                  {"user_id": "cloudysanfrancisco@gmail.com"}
              ]
          }]
      ),
  )
הגדרת התוכן כגלוי לכולם
כדי להפוך מסמך לנגיש לכולם, מגדירים את השדה readers באופן הבא:
Python
readers=[{"idp_wide": True}]
אימות רשימות ACL
כדי לוודא שהגדרות ה-ACL פועלות כמו שצריך, כדאי לבדוק את הדברים הבאים:
חפשו כמשתמש שאין לו גישה למסמך.
בודקים את מבנה המסמך שהועלה ב-Cloud Storage ומשווים אותו למסמך לדוגמה.
JSON
  {
    "id": "108",
    "jsonData": "{...}",
    "aclInfo": {
      "readers": [
        {
          "principals": [
            { "userId": "baklavainthebalkans@gmail.com" },
            { "userId": "cloudysanfrancisco@gmail.com" }
          ],
          "idpWide": false
        }
      ]
    }
  }
שימוש במיפוי זהויות
כדאי להשתמש במיפוי זהויות בתרחישים הבאים:
מקור הנתונים של הצד השלישי משתמש ב-Google Identity
אתם רוצים להפנות לקבוצות בהתאמה אישית (למשל, wp-admins) במקום למשתמשים ספציפיים
ה-API מחזיר רק שמות של קבוצות
אתם צריכים לקבץ משתמשים באופן ידני כדי להרחיב את הפעילות או לשמור על עקביות
המערכת של הצד השלישי מטמיעה רשימות ACL באמצעות קבוצות שלא מבוססות על ספק זהויות, ואתם רוצים לכבד את רשימות ה-ACL האלה באמצעות מאגר הנתונים בהתאמה אישית ב-Gemini Enterprise.
כדי למפות זהויות, פועלים לפי השלבים הבאים:
- יוצרים ומקשרים את מאגר נתוני הזהויות.
מייבאים זהויות חיצוניות (לדוגמה,
external_group:wp-admins). לא כוללים אתexternal_group: prefixכשמייבאים, לדוגמה:JSON
{ "externalIdentity": "wp-admins", "userId": "user@example.com" }בפרטי ה-ACL של המסמך, מגדירים את מזהה הישות החיצונית ב-
principal identifier. כשמפנים לקבוצות בהתאמה אישית, משתמשים בקידומתexternal_group:בשדהgroupId.הקידומת
external_group:נדרשת למזהי קבוצות בפרטי ה-ACL של המסמך במהלך הייבוא, אבל לא משתמשים בה כשמייבאים זהויות למאגר המיפוי. מסמך לדוגמה עם מיפוי זהויות:JSON
  {
    "id": "108",
    "aclInfo": {
      "readers": [
        {
          "principals": [
            {
              "userId": "cloudysanfrancisco@gmail.com"
            },
            {
              "groupId": "external_group:wp-admins"
            }
          ]
        }
      ]
    },
    "structData": {
      "id": 108,
      "date": "2025-04-24T18:16:04",
      ...
    }
  }
המאמרים הבאים
- כדי לספק ממשק משתמש לשליחת שאילתות לגבי הנתונים, יוצרים אפליקציה ב-Gemini Enterprise ומקשרים אותה למאגר הנתונים הקיים של המחבר בהתאמה אישית.