


Neste documento, descrevemos como acessar as métricas geradas pelo app do Gemini Enterprise. Elas fornecem insights sobre o desempenho e a integridade do aplicativo.
É possível conferir a telemetria de métricas usando o Metrics Explorer ou diretamente em agentes individuais usando a guia Observabilidade do agente.
Principais conceitos
Nesta seção, apresentamos os principais conceitos relacionados à observabilidade no Gemini Enterprise.
| Conceito | Descrição |
|---|---|
| Métricas | As métricas são medições numéricas que os sistemas coletam ao longo do tempo. Essas medições representam o desempenho, a utilização de recursos ou o comportamento de um sistema. Os engenheiros usam métricas para monitorar a integridade do sistema, identificar tendências e acionar alertas. |
| Métricas no escopo do agente | Métricas que medem a atividade de um agente individual, como as sessões, as interações de conversação e as invocações de ferramentas. Eles estão listados no tipo de recurso Agente do Gemini Enterprise e são coletados apenas quando a configuração de observabilidade Ativar instrumentação de traces e registros do OpenTelemetry está ativada para esse agente. |
| Métricas no escopo do app | Métricas que medem todo o tráfego de um app, em vez de um único agente, como a contagem de solicitações e a latência de ponta a ponta. Elas são listadas no tipo de recurso Mecanismo do Gemini Enterprise, em que Mecanismo é o nome da API de um app do Gemini Enterprise, e são coletadas independentemente das configurações de observabilidade. |
Antes de começar
Verifique se você tem os seguintes itens:
O papel de administrador do Gemini Enterprise ou o papel de usuário corporativo do Gemini Enterprise no console do Google Cloud .
Um app da Web do Gemini Enterprise. Para saber como criar um novo app, consulte Criar um app.
Para acessar o Metrics Explorer, é preciso ter o papel de Leitor do Monitoring (
roles/monitoring.viewer).Ative a configuração de observabilidade Ativar a instrumentação de traces e registros do OpenTelemetry. Dependendo do tipo de agente, ative essa opção nas configurações do app (para o agente Core Assistant) ou na guia Configuração do agente (para agentes criados por funcionários do Workflow Builder e agentes do Deep Research). Para mais informações, consulte Gerenciar configurações de observabilidade. Essa configuração é necessária para as métricas com escopo de agente. As métricas com escopo de app, listadas no tipo de recurso Gemini Enterprise Engine, são coletadas sem ele.
Retenção de dados
As métricas geradas pelo app Gemini Enterprise são armazenadas no
Cloud Monitoring no seu projeto do Google Cloud , e a retenção delas é regida
pelo Cloud Monitoring. As métricas do Gemini Enterprise são publicadas com o prefixo discoveryengine.googleapis.com/, que se enquadra no nível "todas as outras métricas doGoogle Cloud " e é retido por 6 semanas por padrão. Os dados
mais antigos que o período de armazenamento são excluídos automaticamente. Para ver os valores de retenção oficiais
e mais atuais, consulte
Retenção de dados na documentação
Cotas e limites do Cloud Monitoring.
Acessar métricas no Metrics Explorer
Para acessar as métricas, siga estas etapas:
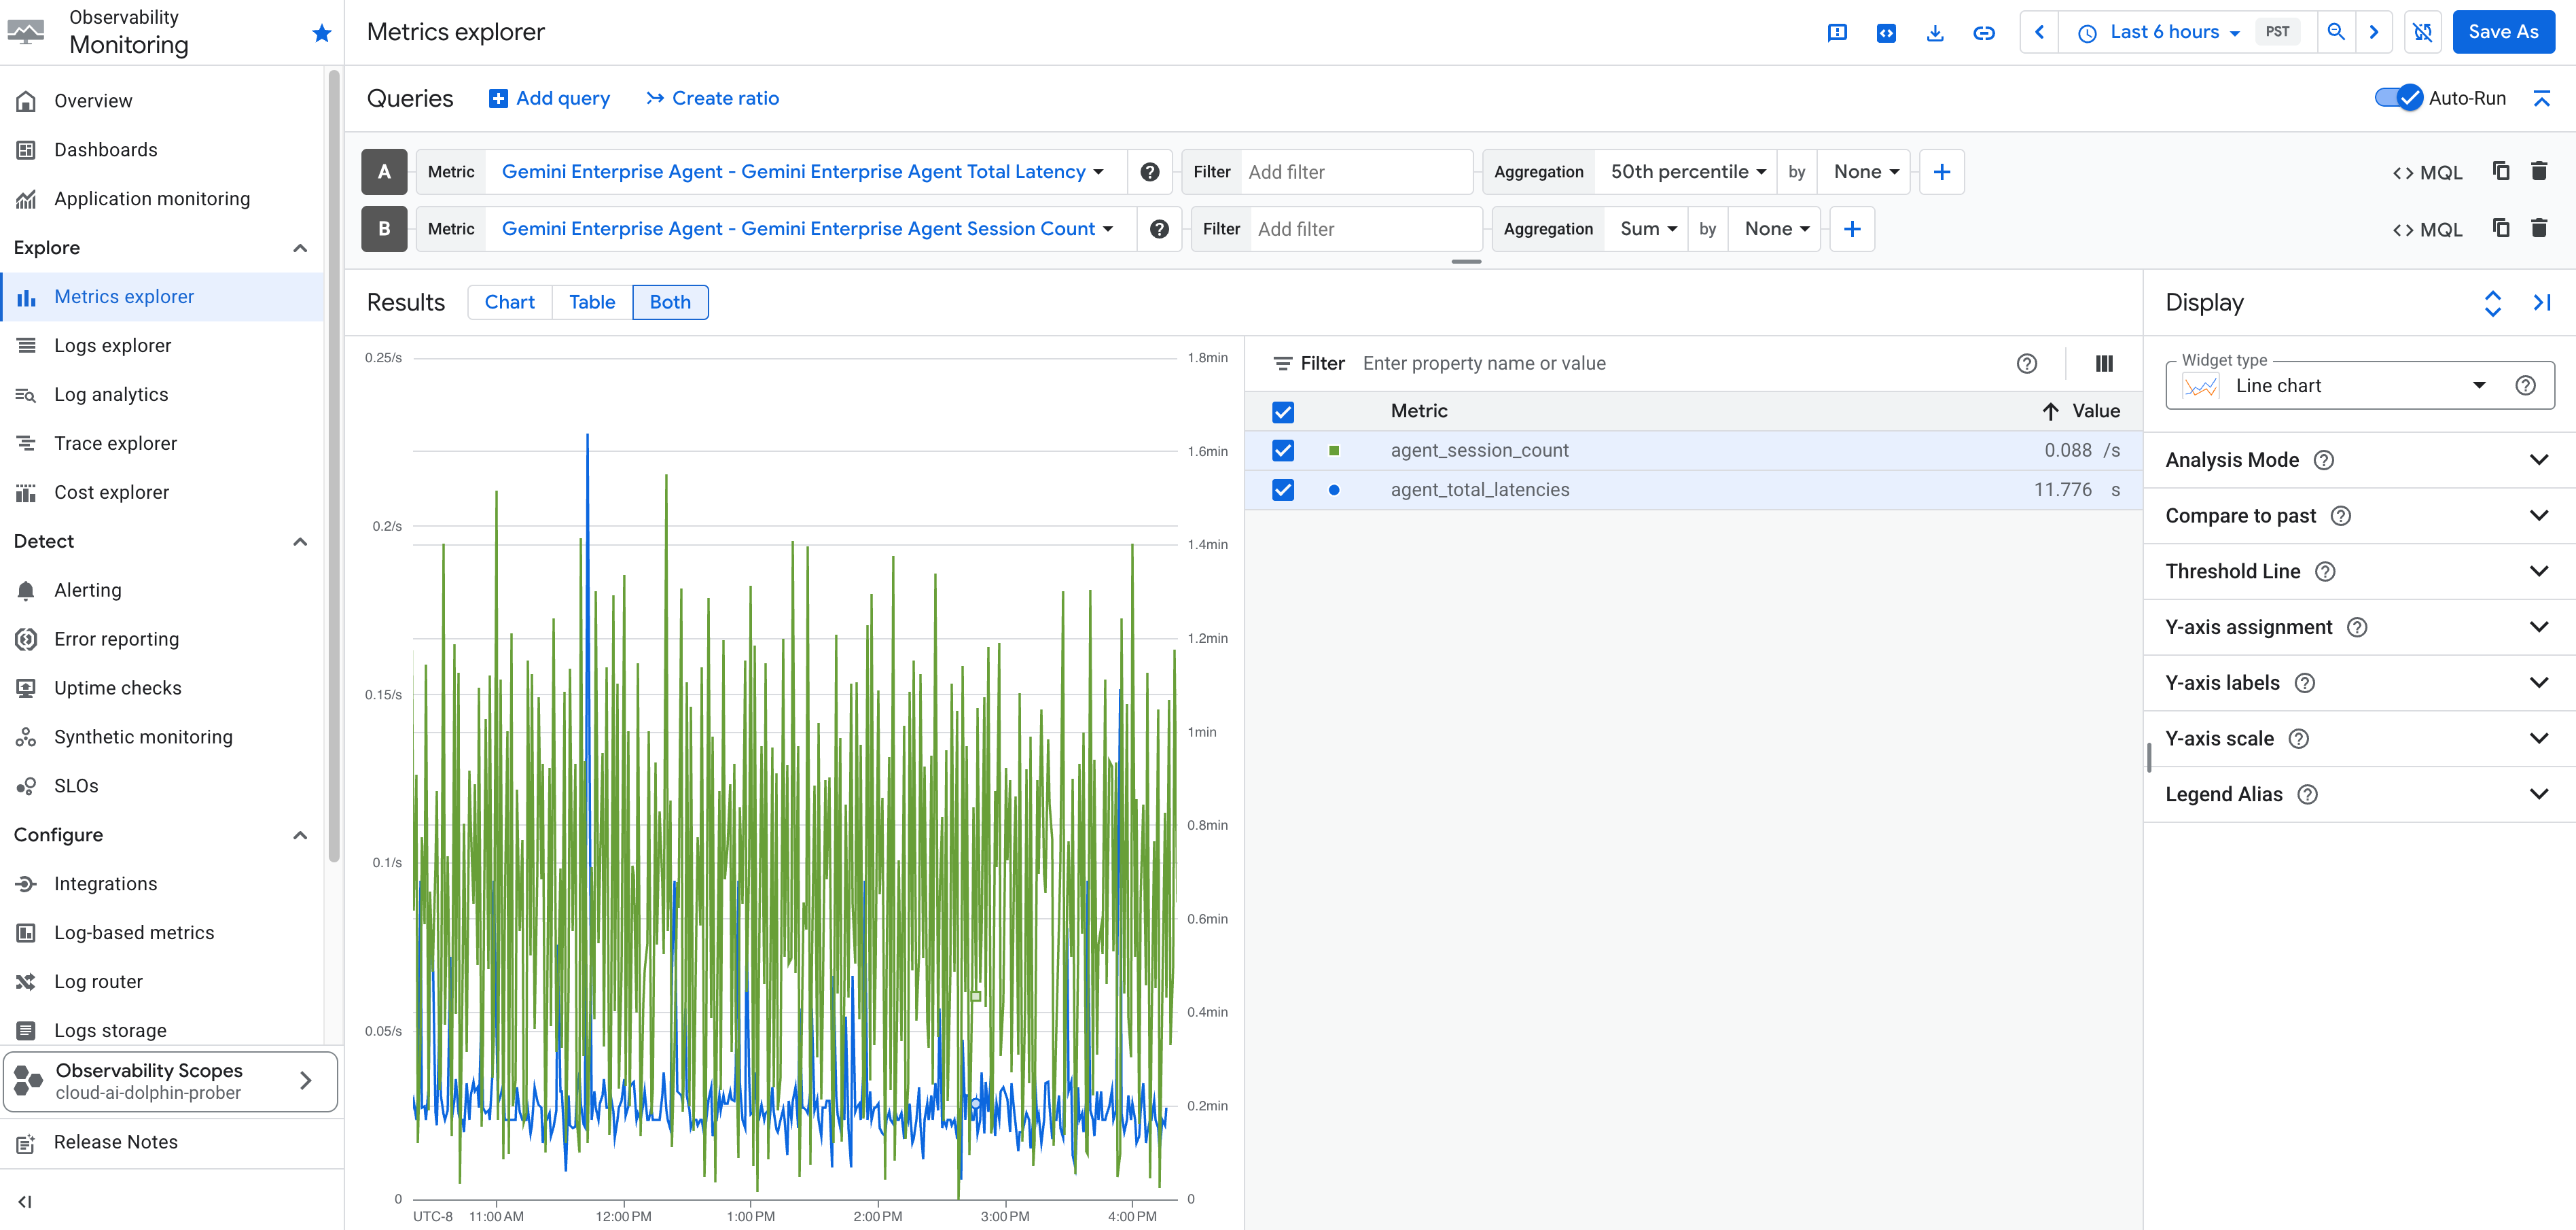
No console do Google Cloud , acesse a página do Metrics Explorer.
Selecione o projeto do Google Cloud em que o app do Gemini Enterprise foi criado.
Clique em Selecionar uma métrica para abrir uma barra de pesquisa.
Na barra de pesquisa, procure as seguintes métricas:
Nome da métrica Descrição Agente do Gemini Enterprise: contagem de sessões do agente do Gemini Enterprise O número de sessões processadas pelo agente do Gemini Enterprise. Agente do Gemini Enterprise: contagem de ferramentas do agente do Gemini Enterprise O número de vezes que as ferramentas foram invocadas pelo agente do Gemini Enterprise. Agente do Gemini Enterprise: contagem de turnos do agente do Gemini Enterprise O número de turnos de conversa nas sessões do agente do Gemini Enterprise. Agente do Gemini Enterprise: latência total do agente do Gemini Enterprise A latência total das respostas do agente do Gemini Enterprise. Agente do Gemini Enterprise: latência total da ferramenta do agente do Gemini Enterprise A latência total incorrida pelas execuções de ferramentas no agente do Gemini Enterprise. Gemini Enterprise DataConnector - Contagem de solicitações do Gemini Enterprise DataConnector A contagem total de solicitações feitas aos conectores de dados do Gemini Enterprise (também chamados de repositórios de dados no console do Google Cloud ). Gemini Enterprise DataConnector - Latências de solicitação do Gemini Enterprise DataConnector (Beta) A latência das solicitações feitas aos conectores de dados do Gemini Enterprise (também chamados de repositórios de dados no console do Google Cloud ) em milissegundos. Mecanismo do Gemini Enterprise: contagem de solicitações do mecanismo do Gemini Enterprise O número total de solicitações recebidas pelo seu app do Gemini Enterprise, em todo o tráfego para o app, em vez de um único agente. Detalhado por método de API, código de resposta gRPC canônico, classe de código de resposta, tipo de consulta e modelo. Mecanismo do Gemini Enterprise: latência total de solicitações do mecanismo do Gemini Enterprise A distribuição da latência de solicitação de ponta a ponta do seu app do Gemini Enterprise. Registrada para cada solicitação, incluindo as que retornam um erro. Mecanismo do Gemini Enterprise: latência do tempo até a primeira resposta do mecanismo do Gemini Enterprise A distribuição da latência entre o recebimento de uma solicitação e o streaming do primeiro token de resposta. Registrado apenas para solicitações que produzem pelo menos um token de resposta. Mecanismo do Gemini Enterprise: latência do tempo até o primeiro token do mecanismo do Gemini Enterprise A distribuição da latência entre o recebimento de uma solicitação e o streaming do primeiro token, seja ele parte do processo de pensamento do modelo ou uma resposta final. Registrado apenas para solicitações que produzem pelo menos um token de streaming. Selecione a métrica que você quer analisar e clique em Aplicar.
Se quiser, defina outros filtros de rótulo, elementos de agregação e ajuste o período.
Acessar métricas para agentes
Também é possível ver painéis de métricas operacionais, específicas de ferramentas e de sessão diretamente para agentes individuais na guia Observabilidade do agente no console do Google Cloud .
Para acessar as métricas de um agente:
- No console do Google Cloud , acesse seu app e clique em Agentes.
- Selecione o agente que você quer inspecionar e clique na guia Observabilidade.
A guia Observabilidade fornece telemetria operacional importante dividida em quatro visualizações: Visão geral, Ferramentas, Latência e Taxa de erro.
Métricas de visão geral
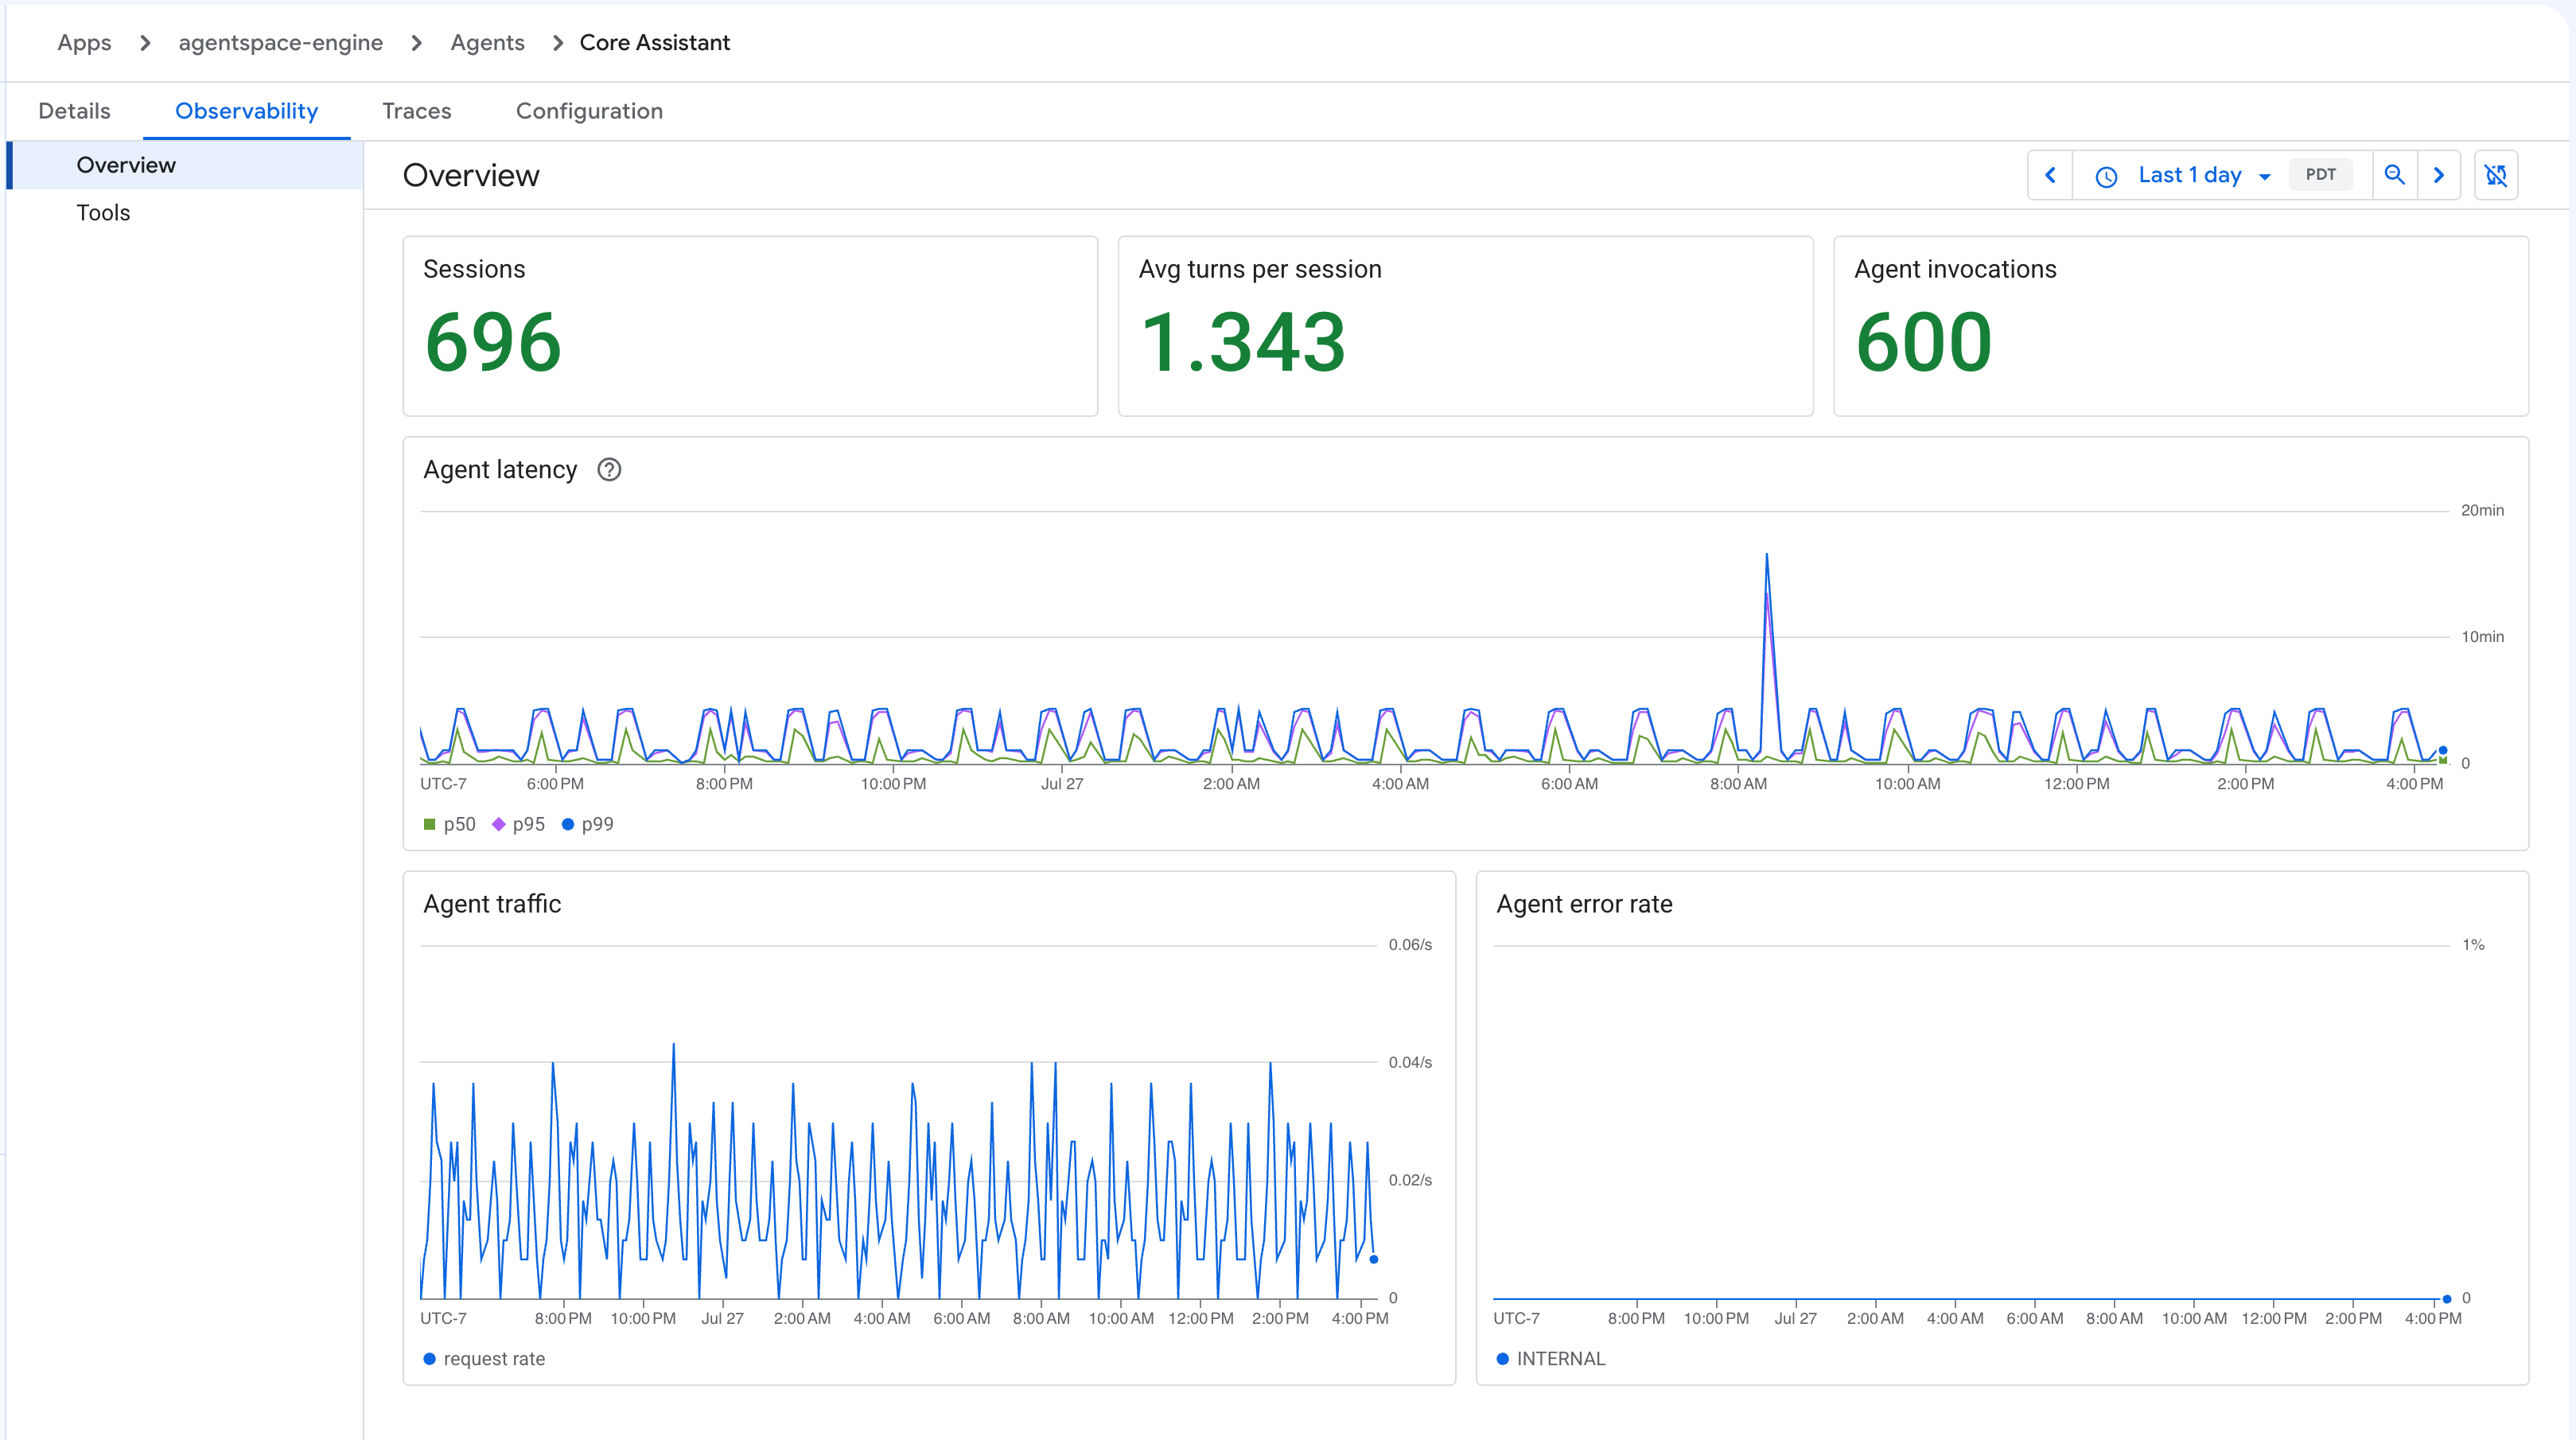
Essa visualização oferece um painel que resume os dados padrão de integridade da sessão e do agente, incluindo:
- Sessões: contagem total de sessões de usuários.
- Tempo médio por sessão: tempo médio decorrido durante uma sessão.
- Invocações do agente: total de vezes que o agente foi chamado.
- Latência do agente: latência ao longo do tempo e métricas específicas.
- Tráfego do agente: volume de solicitações de entrada.
- Taxa de erros do agente: porcentagem de invocações de agente com falha.
Métricas de ferramentas
Essa visualização se concentra especificamente no uso e na latência das ferramentas conectadas ao seu agente, incluindo:
- Total de chamadas: número de solicitações de execução de ferramentas.
- Duração P95 por ferramenta: a latência do 95º percentil das execuções, categorizada por ferramenta.
- Contagem de chamadas por ferramenta: contagem total de chamadas dividida entre diferentes ferramentas.
- Taxa de erros por ferramenta: a taxa de falha das execuções por ferramenta.
- Taxa de "nenhuma chamada de ferramenta": a taxa em que as interações não acionaram nenhuma execução de ferramenta.
Métricas de latência
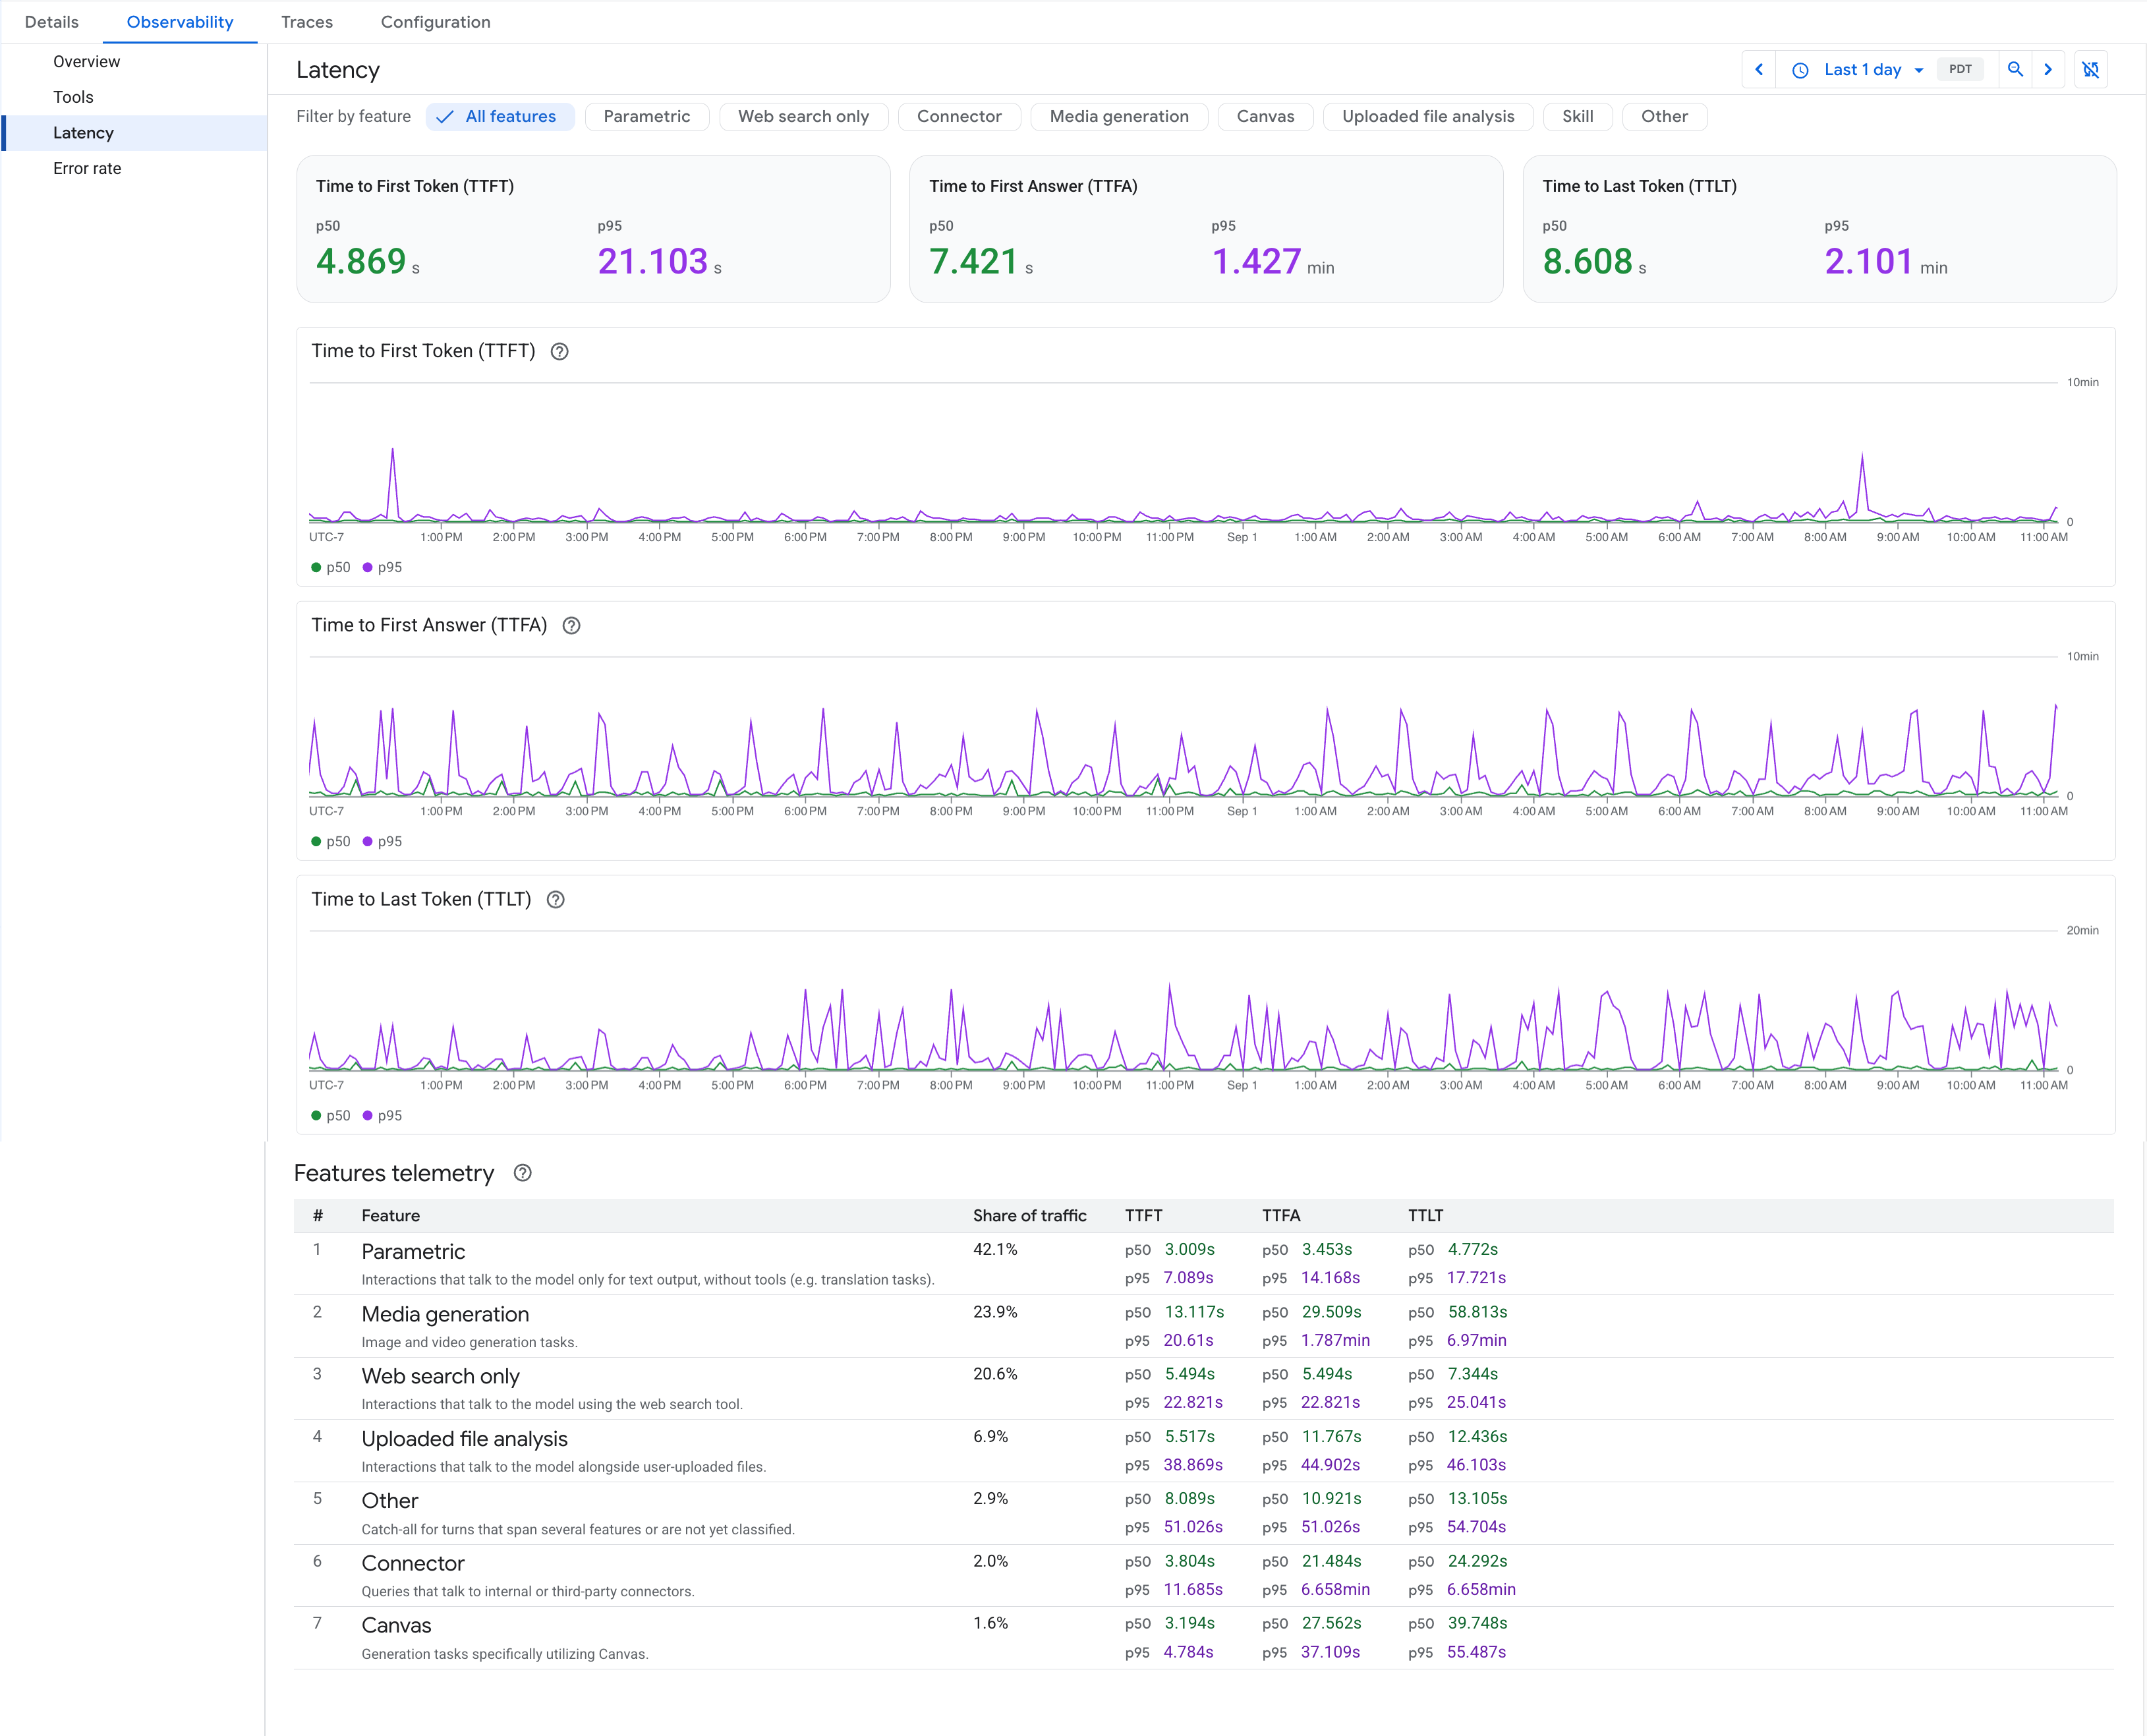
Essa visualização mostra a latência de resposta do agente. Cada métrica é mostrada como um card de resumo p50 e p95 para o período selecionado e como um gráfico de série temporal que mostra as tendências ao longo do tempo. Também é possível filtrar as métricas de latência por recurso. A visualização mostra as seguintes métricas:
- Tempo até o primeiro token (TTFT): a latência entre o recebimento de uma solicitação e a transmissão do primeiro token, seja ele parte do processo de pensamento do modelo ou da resposta.
- Tempo até a primeira resposta (TTFA): a latência entre o recebimento de uma solicitação e o streaming do primeiro token de resposta, que é o primeiro token que não faz parte do raciocínio do modelo. Se o agente chamar uma ferramenta depois de começar a responder, a medição será reiniciada. Assim, o TTFA reflete quando a resposta que o usuário lê começou a ser transmitida, não qualquer narração intermediária.
- Tempo até o último token (TTLT): a latência entre o recebimento de uma solicitação e o streaming do último token, que é quando a resposta é concluída.
Filtrar métricas de latência por recurso
Um recurso é o tipo de interação que uma rodada representa, como uma pesquisa na Web ou uma geração de imagens. Filtre as métricas de latência por recurso para ver quais tipos de interação são mais lentos e evitar que um recurso lento distorça a latência geral.
Para filtrar as métricas de latência por recurso:
- Na guia Observabilidade do agente, clique na visualização Latência.
- Clique em Filtrar por recurso.
- Selecione o recurso que você quer inspecionar.
Os cards de resumo e os gráficos de série temporal mostram apenas as curvas desse recurso.
Para comparar todos os recursos de uma só vez, use a tabela Telemetria de recursos, que lista o seguinte para cada recurso:
- Parcela de tráfego: a porcentagem de turnos atribuída ao recurso.
- TTFT, TTFA e TTLT: a latência p50 e p95 do recurso.
É possível filtrar usando os seguintes recursos:
- Paramétricas: interações que enviam solicitações ao modelo apenas para saída de texto, sem ferramentas, como tarefas de tradução.
- Geração de mídia: tarefas de geração de imagens e vídeos.
- Somente pesquisa na Web: interações que enviam solicitações ao modelo usando a ferramenta de pesquisa na Web.
- Análise de arquivos enviados por upload: interações que enviam solicitações ao modelo junto com arquivos enviados pelo usuário.
- Conector: consultas que enviam solicitações para conectores internos ou de terceiros.
- Canvas: tarefas de geração que usam o Canvas.
- Skill: interações que invocam uma skill.
- Outros: inclui os turnos que abrangem vários recursos ou que ainda não foram classificados.
Métricas de taxa de erro
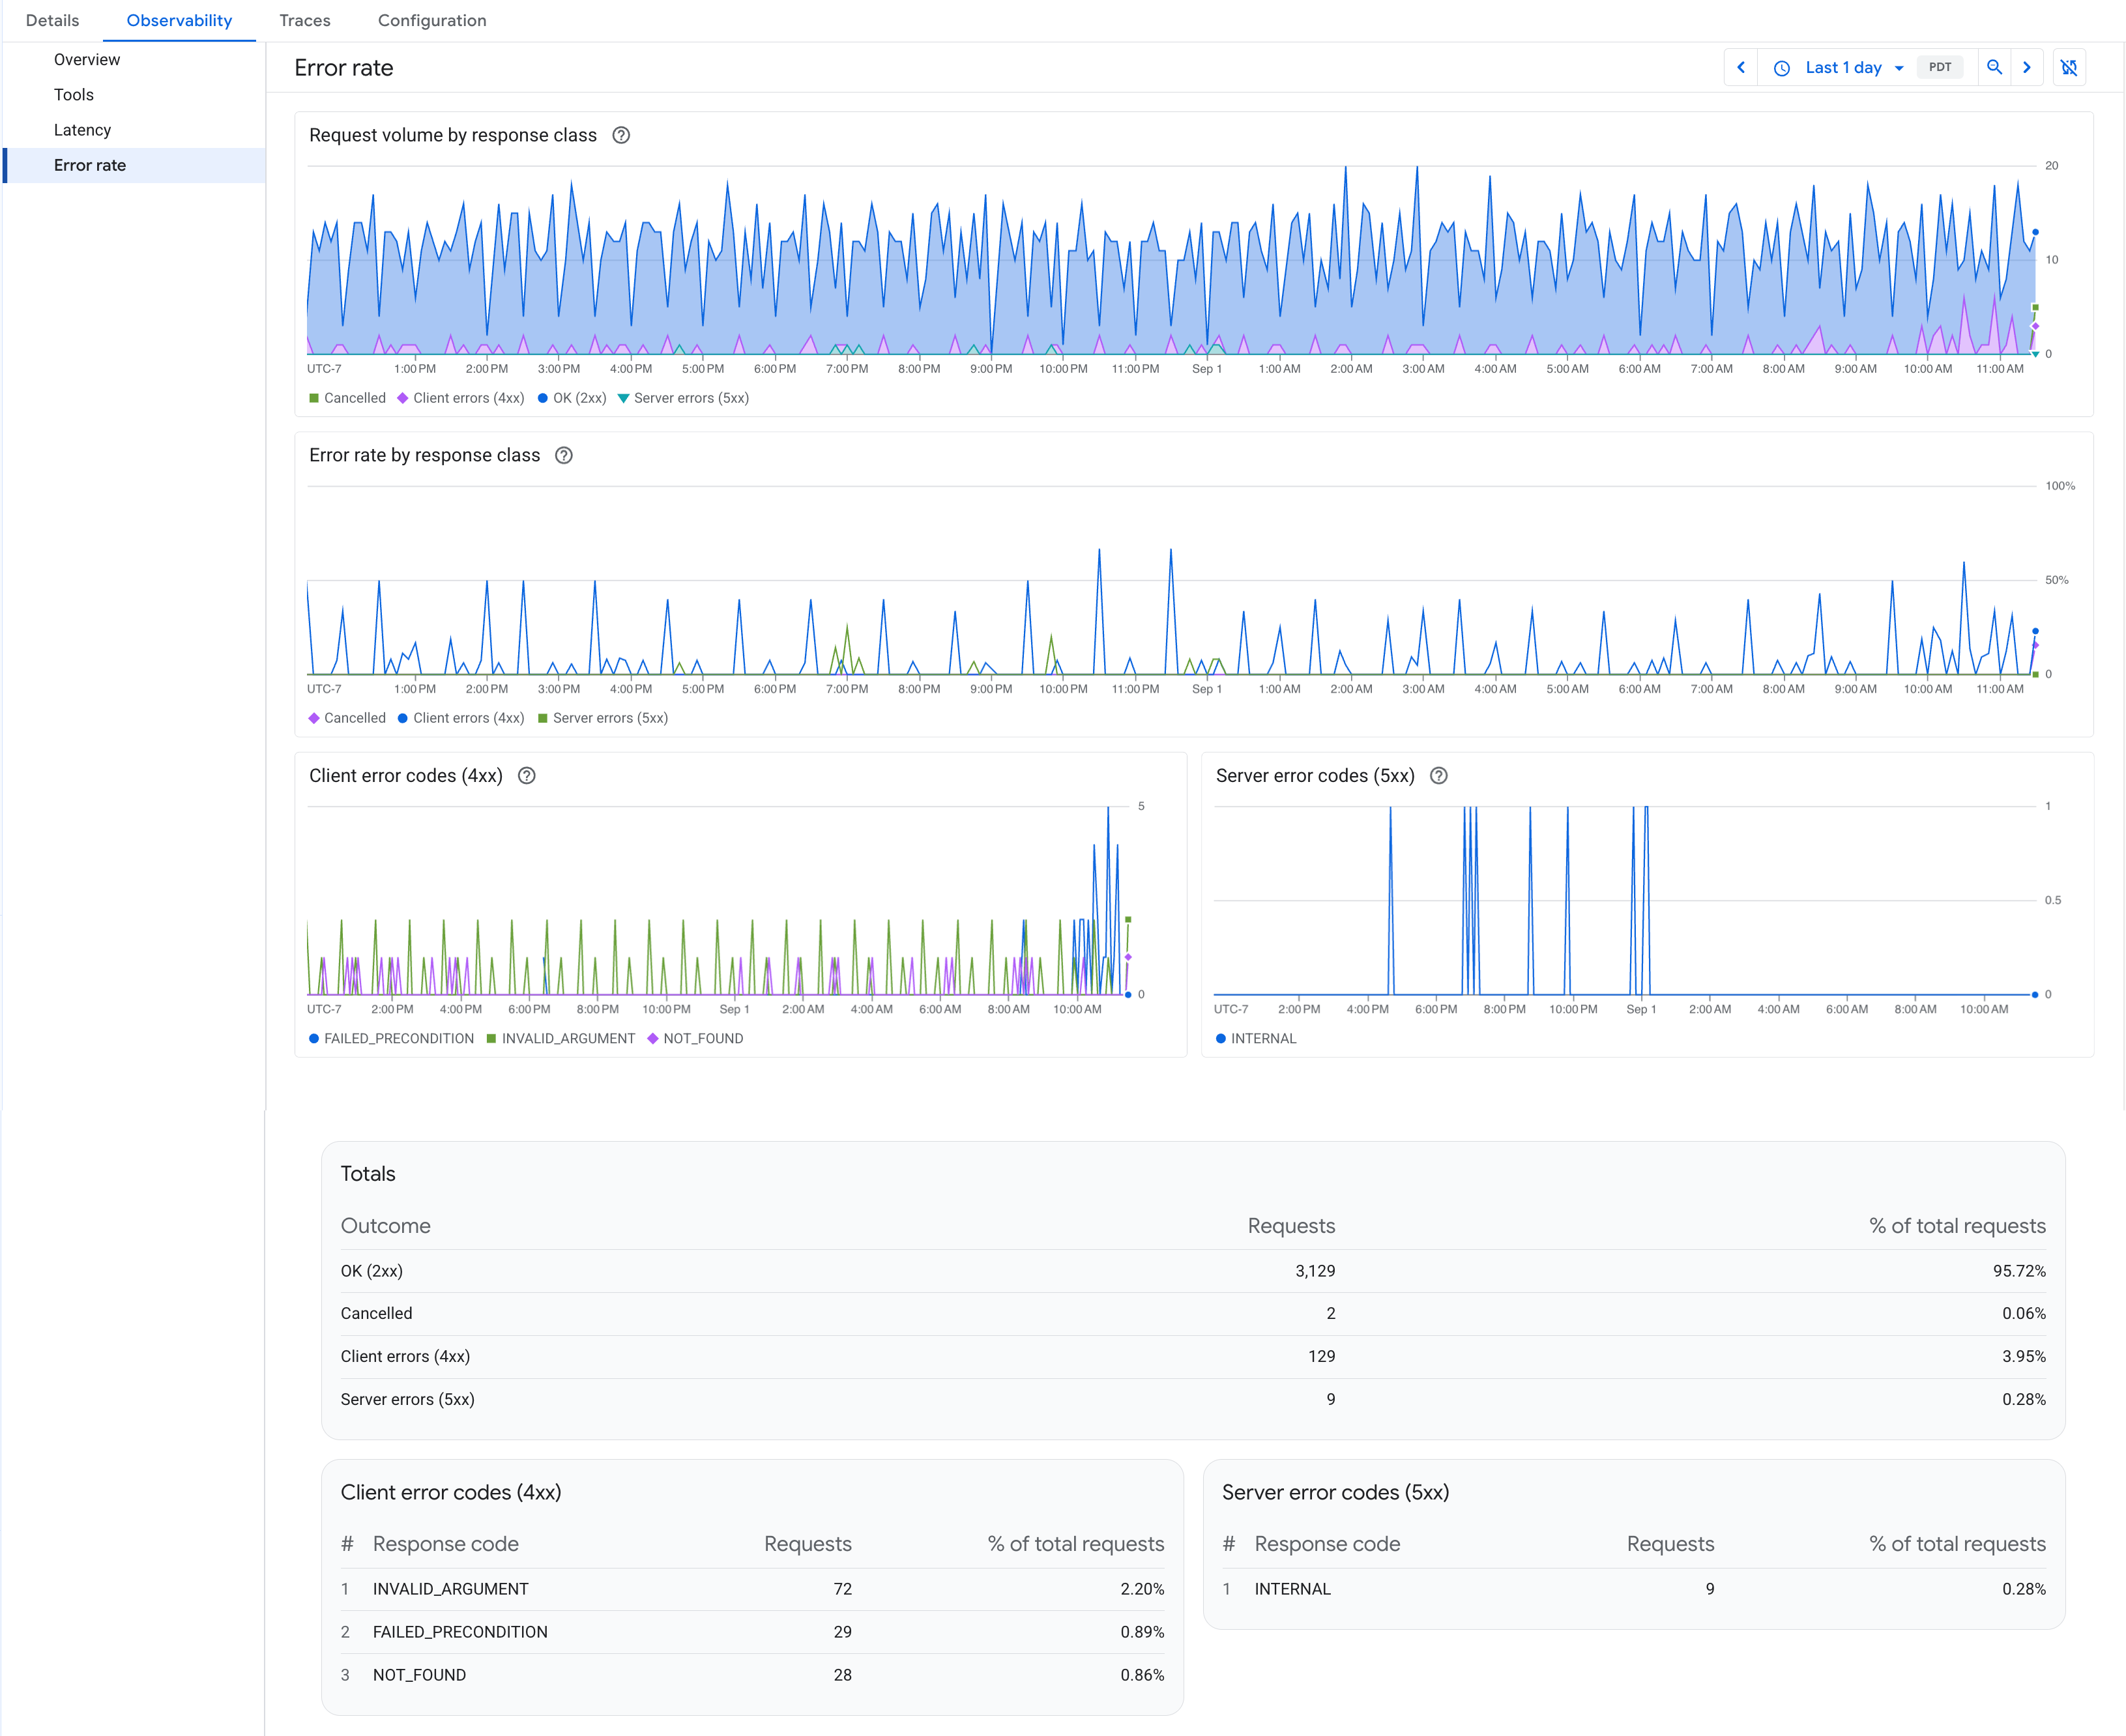
Essa visualização mostra como as solicitações do agente são resolvidas, agrupadas por classe de resposta: OK (2xx), Erros do cliente (4xx), Erros de servidor (5xx) e Cancelado. Ele inclui:
- Volume de solicitações por classe de resposta: contagem de solicitações de entrada ao longo do tempo, empilhadas por classe de resposta.
- Taxa de erros por classe de resposta: a porcentagem de solicitações que falharam ao longo do tempo, dividida por classe de resposta.
- Códigos de erro do cliente (4xx) e Códigos de erro do servidor (5xx): os
códigos de resposta gRPC canônicos individuais ao longo do tempo, como
INVALID_ARGUMENTouINTERNAL, para que você possa identificar quais erros específicos geram um pico. - Totais: o número de solicitações e a porcentagem do total de solicitações para cada resultado no período selecionado, com tabelas separadas que classificam os códigos de erro individuais do cliente e do servidor.
A seguir
- Criar painéis com as métricas do Gemini Enterprise. Para mais informações, consulte Criar e gerenciar painéis personalizados.
- Criar alertas quando as métricas ultrapassarem um limite. Para mais informações, consulte Criar políticas de alertas de limite de métrica.
- Para desativar o rastreamento do Metrics Explorer, consulte Desativar as configurações de observabilidade.