


כשפורסים משאבים ב-Compute Engine, בוחרים את האזור והתחום שבהם המשאבים יתארחו. ההחלטה הזו קובעת איפה הנתונים שלכם יאוחסנו ויעובדו, ומשפיעה באופן ישיר על האמינות, זמן האחזור, העלות וטביעת הרגל הסביבתית של האפליקציה.
במדריך הזה מפורטים קריטריונים ושיטות מומלצות לבחירת אזורים וזונים ב- Google Cloudלעומסי העבודה שלכם.
הסברים על המונחים
אזור: מיקום גיאוגרפי עצמאי שמחולק לתחומים (בדרך כלל שלושה או יותר). הצבת משאבים באזורים שונים מספקת אי-תלות בכשלים ותוכנית התאוששות מאסון (DR) גיאוגרפית.
תחום: אזור פריסה בתוך אזור. לאזורים יש חיבורי רשת עם רוחב פס גבוה וזמן אחזור קצר לאזורים אחרים באותו מחוז. Google Cloud מתכננת אזורים כדי לצמצם כשלים קשורים שנגרמים מאירועים בתשתית הפיזית, כמו הפסקות חשמל, קירור או רשת.
אזור AI: אזור ייעודי שמופרד גיאוגרפית מאזורים רגילים, ומספק קיבולת GPU ו-TPU בצפיפות גבוהה לאימון בקנה מידה גדול ולהסקת מסקנות באצווה. אזורי AI חולקים תשתית עם אזור הורה ייעודי, וצריך להפעיל את החשיפה של אזור ה-AI. מידע נוסף זמין במאמר אזורי AI.
זמן הלוך ושוב (RTT): הזמן שלוקח לשלוח חבילת IP ולקבל את האישור.
מתי לבחור את האזורים והתחומים
כבר בשלב הארכיטקטורה, החליטו כמה אזורים ותחומים של Compute Engine אתם צריכים ובאילו מהם להשתמש. כדאי להביא בחשבון את השיקולים הבאים:
- עקביות ויצירת רפליקות של נתונים: בארכיטקטורות עם כמה אזורים נדרשים מנגנונים לסנכרון או לפיצול של נתונים בין מרחקים גיאוגרפיים.
- השלכות על העלות: תמחור המשאבים והחיובים על העברת נתונים בין אזורים משתנים בהתאם למיקום.
- תקורה של העברה: העברה של עומסי עבודה ונתונים פעילים בין אזורים היא מורכבת מבחינה תפעולית, וגורמת לזמן השבתה או לעלויות של תעבורת נתונים יוצאת.
גורמים שצריך להביא בחשבון כשבוחרים אזורים ותחומים (zones)
כשמתכננים את הפריסה, כדאי להביא בחשבון את הגורמים העיקריים הבאים:
זמינות גבוהה וסבילות לכשלים
- כדי לשרוד הפסקות זמניות בשירות באזורים מסוימים: כדאי לפרוס את המכונות בכמה אזורים בתוך אזור אחד, כך שאם אזור אחד מושבת, האחרים נשארים זמינים.
- אם יש לכם צרכים קריטיים לעסק של תוכנית התאוששות מאסון (DR): בחרו אזור משני לפריסת שירותי גיבוי או רפליקות במספר אזורים.
זמן האחזור של המשתמשים ושל הרשת
- כשהמשתמשים מרוכזים באזור גיאוגרפי מסוים: בוחרים אזור שקרוב אליהם גיאוגרפית כדי לצמצם את זמן ה-RTT.
- כשאתם משרתים בסיס משתמשים גלובלי ממיקום אחד: בחרו אזור בארה"ב, כי בדרך כלל האזורים האלה מציעים את הקישוריות הגלובלית הטובה ביותר.
- אם יש לכם סביבה היברידית ארגונית: בחרו את האזור לפי זמן האחזור הקצר ביותר למערכות המקומיות שמחוברות באמצעות Cloud Interconnect או Cloud VPN.
זמינות של סדרות מכונות להאצה של בינה מלאכותית (AI) ולמידת מכונה (ML)
- כשצריך סדרת מכונות ספציפית: בוחרים את אזורי היעד רק אחרי שמוודאים שסדרת המכונות הנדרשת (כמו C4, C3, N4 או M3) נתמכת בהם.
- כשמריצים עומסי עבודה של אימון AI ו-ML: בוחרים אזורים שתומכים בסדרות של מכונות שעברו אופטימיזציה למאיצים (כמו A4 עם מעבדי GPU מסוג NVIDIA B200 או A3 עם מעבדי GPU מסוג NVIDIA H200/H100) או יחידות TPU (כמו TPU v6e או TPU v5p). לאימון בקנה מידה גדול, כדאי לבחור אזורים עם אזורי AI ייעודיים או להשתמש במתזמן משימות לפריסת workload דינמית (DWS) כדי להבטיח קיבולת מראש.
- כשמריצים עומסי עבודה של הסקת מסקנות בזמן אמת: כדי למנוע זמן אחזור בין אזורים לשירותים בקצה העורפי, כדאי לתת עדיפות לאזורים רגילים שקרובים לבסיס המשתמשים באמצעות מכונות שעברו אופטימיזציה להסקת מסקנות (כמו G2 עם מעבדי GPU מסוג NVIDIA L4) במקום לאזורי AI.
תמחור ועלויות של העברת נתונים
- כשרוצים לצמצם את עלויות הרשת: כדאי לבחור באפשרות לשמור את התקשורת בתוך אזור אחד (ללא עלות) או בתוך אותו אזור (בעלות מינימלית), כי מעבר לאזורים שונים כרוך בעלויות גבוהות יותר של העברת נתונים בין אזורים.
מיקום משותף עם שירותים אחרים
- כשאתם מסתמכים על שירותים אחרים של Google Cloud (כמו Spanner, Cloud SQL, BigQuery או Cloud Storage): כדאי למקם את משאבי Compute Engine באותו אזור שבו נמצאים השירותים האלה, כדי למנוע זמן אחזור בין השירותים ולבטל את החיובים על תעבורת נתונים יוצאת בין אזורים.
מכסות וקיבולת של משאבים
- כשמתכננים השקה: בוחרים אזורים שבהם אימתתם וביקשתם מראש מכסה מספיקה של משאבים אזוריים ושל משאבים של תחום מוגדר.
אחוז האנרגיה נטולת הפחמן (CFE%)
- כשרוצים לתעדף קיימוּת: בוחרים אזור עם אחוז CFE גבוה יותר כדי לצמצם את טביעת הרגל הפחמנית הכוללת של האפליקציה.
בחירת מיקום אוטומטית
ב-Compute Engine יש מנגנונים מובְנים לבחירה אוטומטית של אזורים אופטימליים, על סמך הקיבולת והזמינות בזמן אמת:
- מסוףGoogle Cloud (האזור Any): כשיוצרים מכונה במסוףGoogle Cloud , בוחרים באפשרות Any בבורר האזורים. מערכת Compute Engine מקצה אוטומטית את המכונה באזור עם קיבולת מספיקה לסוג המכונה שנבחר.
- קבוצות אזוריות של מופעי מכונות מנוהלים (MIG): מגדירים את ה-MIG האזורי עם צורת הפצה מטורגטת (
ANY,BALANCEDאוANY_SINGLE_ZONE) כדי לאפשר ל-MIG לפרוס באופן אוטומטי מכונות באזורים זמינים. - API ליצירת מכונות בכמות גדולה: כשיוצרים כמה מכונות בו-זמנית, משתמשים בנקודת קצה אזורית עם ה-API ליצירה בכמות גדולה כדי להפיץ באופן אוטומטי מכונות בין אזורים עם קיבולת זמינה.
דפוסי פריסה גלובליים
בהתאם לדרישות שלכם לגבי זמן אחזור וגמישות, בחרו אחד מהמודלים הבאים של ארכיטקטורה:
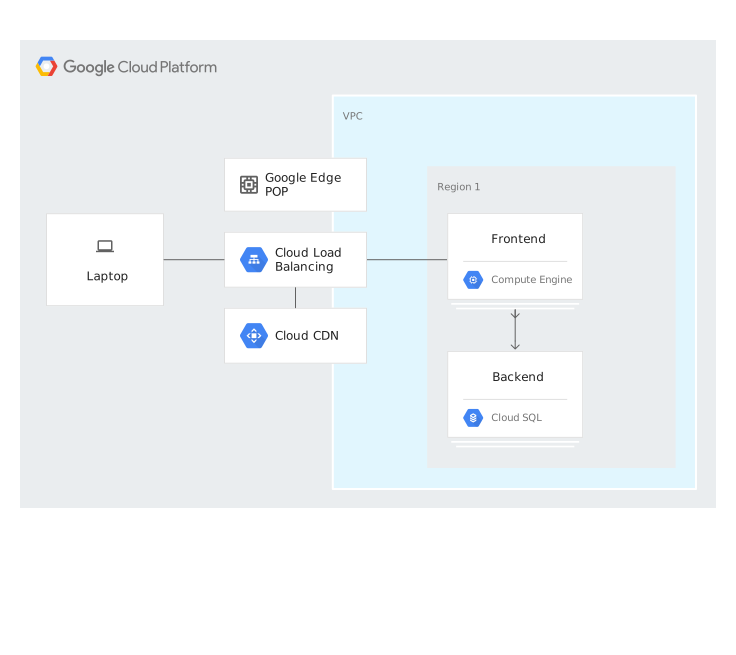
תבנית 1: פריסה באזור אחד
פורסים את החזית והבק-אנד של האפליקציה באזור אחד בכמה תחומים.
- הכי מתאים ל: אפליקציות עם סבילות בינונית לזמן אחזור, כלים פנימיים של הארגון או עומסי עבודה עם מסדי נתונים מרכזיים של טרנזקציות.
- אופטימיזציה: שילוב עם Cloud Load Balancing ו-Cloud CDN כדי לסיים סשנים של SSL/TCP בנקודות נוכחות (PoP) בקצה הרשת, ולשמור במטמון נכסים סטטיים קרוב למשתמשים.
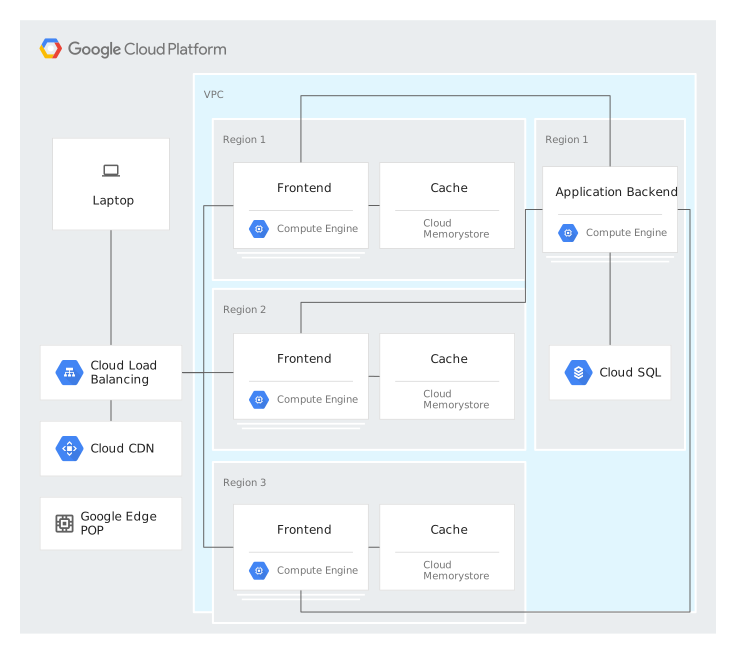
תבנית 2: חזית מבוזרת עם קצה עורפי מרוכז
פריסת שרתי ממשק משתמש בכמה אזורים גיאוגרפיים שקרובים למשתמשים, תוך שמירה על קצה עורפי ומסד נתונים מרכזיים באזור אחד.
- הכי מתאים ל: אפליקציות שמטפלות בעיקר בבקשות קריאה, משתמשות במטמון אגרסיבי בקצה או בחזית, או מעבדות כתיבה באופן אסינכרוני.
- אופטימיזציה: משתמשים ב-Cloud CDN כדי לשמור במטמון נכסים סטטיים, וב-Memorystore כדי לשמור במטמון נתונים שניגשים אליהם לעיתים קרובות באותו אזור של ממשק המשתמש.
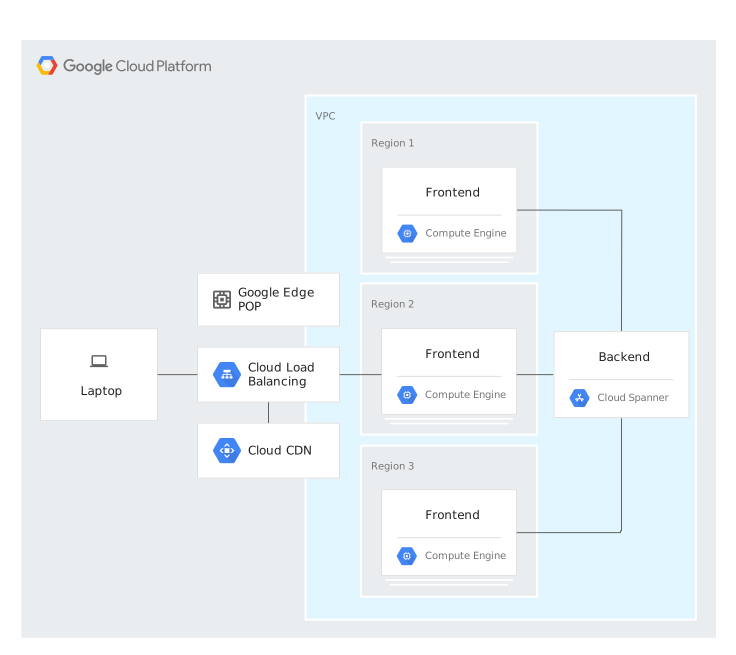
תבנית 3: חזית וקצה עורפי מבוזרים במספר אזורים
פריסת שירותים של Full Stack לקצה הקדמי ולקצה העורפי בכמה אזורים.
- הכי מתאים ל: אפליקציות עם קצב העברת נתונים גבוה שמופצות ברחבי העולם ודורשות זמן אחזור מינימלי בכל העולם.
- אחסון נתונים: השתמשו במסדי נתונים שמופצים באופן גלובלי, כמו הגדרות של Spanner במספר אזורים או מיקומים של Cloud Storage בשני אזורים או במספר אזורים, כדי לספק יכולות קריאה וכתיבה מקומיות סינכרוניות בין יבשות.
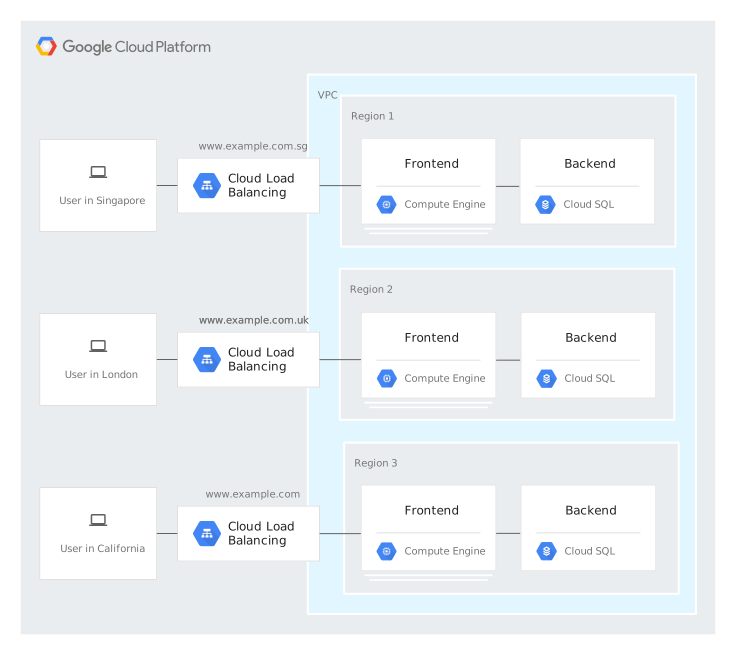
תבנית 4: כמה אפליקציות אזוריות במקביל
להריץ מחסניות אפליקציות עצמאיות לחלוטין באזורים שונים, ולנתב את המשתמשים למחיצה המקומית שלהם עם סנכרון נתונים מינימלי בין האזורים.
- הכי מתאים: לפלטפורמות SaaS עם כמה דיירים, לחנויות קמעונאיות במספר אזורים עם מלאי בחנות מקומית או לעולמות של משחקים מרובי משתתפים בזמן אמת.
- אחסון נתונים: שימוש ב-Cloud SQL כדי לספק מסדי נתונים של PostgreSQL, SQL Server ו-MySQL בכל אזור.
אופטימיזציה ומדידה של זמן האחזור
לא משנה באיזה מודל פריסה אתם משתמשים, אתם יכולים להשתמש בשיטות הבאות כדי לצמצם את זמן האחזור אצל משתמשי הקצה:
- שימוש ברשתות במסלול פרימיום: במסלול פרימיום (ברירת המחדל), תעבורת הנתונים מנותבת דרך תשתית הסיבים הגלובלית הפרטית של Google, ולא דרך האינטרנט הציבורי. כך זמן האחזור קצר יותר ויש פחות אובדן מנות.
- סגירת חיבורים בנקודת הקצה: משתמשים במאזני עומסים חיצוניים של אפליקציות וב-Cloud CDN כדי לסגור לחיצות יד בפרוטוקול TLS ולספק תוכן שנשמר במטמון מנקודת הקצה PoP שהכי קרובה למשתמש.
- הטמעת שמירה במטמון הזיכרון: הציבו אשכולות של Memorystore for Redis או Memcached באותו אזור שבו נמצאים משאבי המחשוב שלכם, כדי למנוע סבבי תקשורת חוזרים ונשנים עם מסד הנתונים.
- מדידת זמן האחזור בעולם האמיתי:
- משתמשים ב-VPC Flow Logs כדי לבדוק את זמני הלוך ושוב של TCP בין לקוחות למכונות.
- מפעילים את האפשרות Custom Request Headers במאזן העומסים כדי לתעד את נתוני ה-RTT והמיקום הגיאוגרפי של הלקוח.
- שימוש במדדים של Cloud Monitoring למאזני עומסים (
frontend_tcp_rttו-backend_latencies).
רשימת משימות מפורטת לבחירה
כדי לבחור את האזור והתחום, אתם יכולים להיעזר ברשימת המשימות הבאה:
- תכנון קיבולת: משתמשים במצב תזמון של מתזמן משימות לפריסת workload דינמית (DWS) כדי ליצור מקומות שמורים לעתיד שניתן לחזות, או במצב התחלה גמישה (Flex-start) כדי ליצור משימות באצווה בתור. משתמשים ב-Capacity Advisor במסוף כדי לגלות ולתכנן את הקיבולת.
- קביעת דרישות התאימות ומיקום הנתונים: מוודאים שהאזורים המועמדים עומדים בכללי הרגולציה וריבונות הנתונים הרלוונטיים.
- בחירת אזורים ראשיים על סמך ריכוז המשתמשים: הציבו את השירותים באזורים שבהם זמן ה-RTT החציוני לבסיס המשתמשים העיקרי שלכם הוא הנמוך ביותר.
- תכנון לעמידות:
- בכל אזור שנבחר, פזרו את המכונות בין שניים או שלושה אזורים לפחות.
- לעומסי עבודה קריטיים, הגדירו אזור משני ליתירות כשל.
- הערכת המחירים והקיימוּת: אם כמה אזורים עומדים בקריטריונים הטכניים, משווים בין מחירי המשאבים ואחוזי האנרגיה נטולת הפחמן (CFE%) כדי לבחור את האזור המתאים.
סיכום של השיטות המומלצות
| קטגוריה | שיטה מומלצת |
|---|---|
| עמידות וזמינות גבוהה | כדי להגן מפני הפסקות זמניות בשירות בתשתית, כדאי לפזר את המכונות בשלושה אזורים לפחות. פריסה באזור משני לצורך התאוששות מאסון (DR) באזורים שונים. |
| בחירת אזור אוטומטית | כדי לבחור באופן אוטומטי אזורים עם קיבולת זמינה, אתם יכולים להשתמש באפשרות Any (כלשהו) במסוף, בצורות של הפצה אזורית של קבוצות MIG או ב-Bulk Instance Creation API. |
| עומסי עבודה של AI ו-ML | לאימון בקנה מידה גדול, בחרו אזורים עם אזורי AI ייעודיים או השתמשו במתזמן משימות לפריסת workload דינמית (DWS) כדי לתזמן את הקיבולת של ה-GPU וה-TPU. להסקת מסקנות בזמן אמת, פורסים סדרות מכונות שעברו אופטימיזציה להסקת מסקנות (כמו G2) באזורים רגילים שקרובים למשתמשים. |
| אופטימיזציה של זמן האחזור | שימוש ברשתות במסלול פרימיום, באיזון עומסים חיצוני של אפליקציות וב-Cloud CDN כדי לסיים סשנים ולשמור נכסים במטמון בנקודות הנוכחות (PoP) של Google בקצה הרשת. |
| ניהול העלויות | כדי להימנע מחיובים על תעבורת נתונים יוצאת ברשת בין אזורים, כדאי לשמור על תקשורת פנימית בתוך אותו אזור או אזור גיאוגרפי. |
| קיימוּת | כדי לצמצם את ההשפעה על הסביבה, כדאי לתת עדיפות לאזורים עם אחוזים גבוהים יותר של אנרגיה נטולת פחמן (CFE%). |
המאמרים הבאים
- האזורים והתחומים הזמינים של Compute Engine
- איך מתכננים מערכות חסינות ב- Google Cloud
- מידע ולמידה על אופטימיזציה של זמן האחזור של האפליקציה באמצעות Cloud Load Balancing
- Google Cloud טביעות הרגל הפחמניות ואחוזי ה-CFE של האזורים
לאדריכלים שבוחרים אזורים לעומסי עבודה של AI/ML:
- מידע על אזורי AI לעומסי עבודה של GPU ו-TPU
- זמינות של דגמי GPU לפי אזור ו-zone
- זמינות של TPU לפי אזור ותחום
- מידע על מתזמן משימות לפריסת workload דינמית (DWS)