


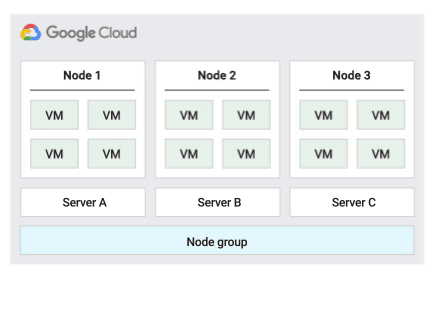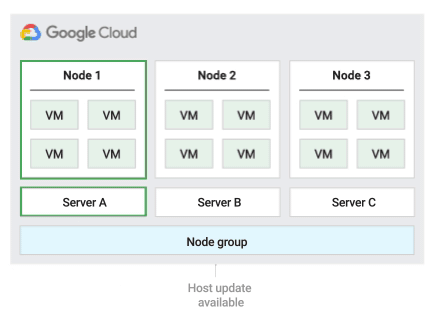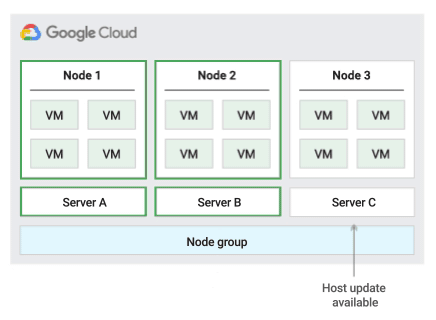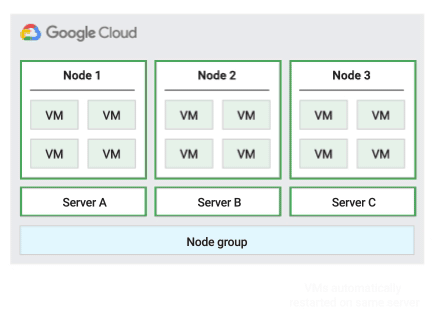
דיירות יחידה מספקת גישה בלעדית לצומת לדייר יחיד (sole-tenant), שרת פיזי של Compute Engine שמיועד לאירוח של המכונות הווירטואליות של הפרויקט שלכם בלבד. אפשר להשתמש בשרתים לדייר יחיד (sole-tenant) כדי להפריד פיזית את המכונות הווירטואליות ממכונות וירטואליות בפרויקטים אחרים, או כדי לקבץ את המכונות הווירטואליות באותה חומרה של מארח, כמו שמוצג בדיאגרמה הבאה. אפשר גם ליצור קבוצת שרתים לדייר יחיד (sole-tenant) ולציין אם רוצים לשתף אותה עם פרויקטים אחרים או עם כל הארגון.
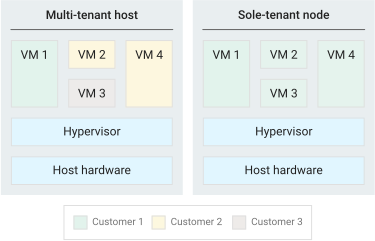
מכונות וירטואליות שפועלות בשרתים לדייר יחיד יכולות להשתמש באותם תכונות של Compute Engine כמו מכונות וירטואליות אחרות, כולל תזמון שקוף ואחסון בלוקים, אבל עם שכבת בידוד נוספת של חומרה. כדי לתת לכם שליטה מלאה על המכונות הווירטואליות בשרת הפיזי, כל צומת של שרת לדייר יחיד שומר על מיפוי של אחד לאחד לשרת הפיזי שמגבה את הצומת.
בשרת לדייר יחיד (sole-tenant) אפשר להקצות כמה מכונות וירטואליות בסוגי מכונות בגדלים שונים, וכך להשתמש ביעילות במשאבים הבסיסיים של חומרת המארח הייעודי. בנוסף, אם אתם בוחרים לא לשתף את החומרה המארחת עם פרויקטים אחרים, אתם יכולים לעמוד בדרישות האבטחה או התאימות באמצעות עומסי עבודה שדורשים בידוד פיזי מעומסי עבודה או ממכונות וירטואליות אחרות. אם עומס העבודה שלכם דורש שכירות בלעדית רק באופן זמני, אתם יכולים לשנות את השכירות של המכונה הווירטואלית לפי הצורך.
שרתים לדייר יחיד (sole-tenant) יכולים לעזור לכם לעמוד בדרישות של חומרה ייעודית בתרחישים של החברה מביאה את הרישיון שלה (BYOL), שבהם נדרשים רישיונות לכל ליבה או לכל מעבד. כשמשתמשים בשרתים לדייר יחיד (sole-tenant), יש לכם גישה מסוימת לחומרה הבסיסית, שמאפשרת לכם לעקוב אחרי השימוש בליבה ובמעבד. כדי לעקוב אחרי השימוש הזה, Compute Engine מדווח על המזהה של השרת הפיזי שבו מתוזמנת מכונה וירטואלית. לאחר מכן, באמצעות Cloud Logging, תוכלו לראות את היסטוריית השימוש בשרת של מכונה וירטואלית.
כדי לייעל את השימוש בחומרה של המארח, אפשר לבצע את הפעולות הבאות:
באמצעות מדיניות תחזוקה ניתנת להגדרה של המארח, אתם יכולים לקבוע את ההתנהגות של מכונות וירטואליות של דייר יחיד בזמן שהמארח שלהן עובר תחזוקה. אתם יכולים לציין מתי יתבצעו פעולות תחזוקה, ולקבוע אם המכונות הווירטואליות יישארו קשורות לשרת פיזי ספציפי או יועברו לצמתים אחרים של דייר יחיד בקבוצת צמתים.
שיקולים שקשורים לעומס העבודה
סוגי עומסי העבודה הבאים יכולים להפיק תועלת משימוש בשרתים לדייר יחיד (sole-tenant):
עומסי עבודה של גיימינג עם דרישות ביצועים
עומסי עבודה בתחום הפיננסים או הבריאות עם דרישות אבטחה ותאימות
עומסי עבודה ב-Windows עם דרישות רישוי
עומסי עבודה של למידת מכונה, עיבוד נתונים או רינדור תמונות. לעומסי העבודה האלה, כדאי להזמין מראש מעבדי GPU.
עומסי עבודה שנדרשות בהם יותר פעולות קלט/פלט בשנייה (IOPS) וזמן אחזור נמוך יותר, או עומסי עבודה שמשתמשים באחסון זמני בצורה של מטמונים, מרחב עיבוד או נתונים בעלי ערך נמוך. לעומסי העבודה האלה, כדאי להזמין מראש דיסקים מסוג Local SSD.
תבניות של צמתים
תבנית צומת היא משאב אזורי שמגדיר את המאפיינים של כל צומת בקבוצת צמתים. כשיוצרים קבוצת צמתים מתבנית צומת, המאפיינים של תבנית הצומת מועתקים לכל צומת בקבוצת הצמתים, בלי אפשרות לשנות אותם.
כשיוצרים תבנית צומת, צריך לציין את סוג הצומת. כשיוצרים תבנית צומת, אפשר לציין תוויות של שיוך לצומת. אפשר לציין תוויות של שיוך (affinity) לצומת רק בתבנית צומת. אי אפשר לציין תוויות של שיוך צומת לקבוצת צמתים.
סוגי הצמתים
כשמגדירים תבנית צומת, מציינים את סוג הצומת שרוצים להחיל על כל הצמתים בקבוצת הצמתים שנוצרה על סמך תבנית הצומת. סוג השרת לדייר יחיד, שאליו יש הפניה בתבנית הצומת, מציין את הכמות הכוללת של ליבות vCPU וזיכרון לצמתים שנוצרו בקבוצות צמתים שמשתמשות בתבנית הזו. לדוגמה, לסוג הצומת n2-node-80-640 יש 80 ליבות vCPU וזיכרון בנפח 640GB.
המכונות הווירטואליות שמוסיפים לשרת לדייר יחיד (sole-tenant) צריכות להיות מאותו סוג מכונה כמו סוג הצומת שמציינים בתבנית הצומת. לדוגמה, n2
סוגי צמתים של דייר יחיד תואמים רק למכונות וירטואליות שנוצרו עם n2
סוג המכונה. אפשר להוסיף מכונות וירטואליות לשרת לדייר יחיד (sole-tenant) עד שהכמות הכוללת של מעבדי ה-vCPU או הזיכרון חורגת מהקיבולת של השרת.
כשיוצרים קבוצת צמתים באמצעות תבנית צומת, כל צומת בקבוצת הצמתים יורש את המפרטים של סוג הצומת של תבנית הצומת. סוג הצומת חל על כל צומת בודד בקבוצת צמתים, ולא על כל הצמתים בקבוצה באופן אחיד. לכן, אם יוצרים קבוצת צמתים עם שני צמתים ששניהם מסוג הצומת n2-node-80-640, לכל צומת מוקצים 80 יחידות vCPU ו-640GB זיכרון.
בהתאם לדרישות של עומס העבודה, אתם יכולים למלא את הצומת בכמה מכונות וירטואליות קטנות יותר שפועלות בסוגי מכונות בגדלים שונים, כולל מכונות עם קונפיגורציה מוגדרת (predefined), מכונות בהתאמה אישית ומכונות עם זיכרון מורחב. כשהצומת מלא, אי אפשר לתזמן מכונות וירטואליות נוספות באותו צומת.
בטבלה הבאה מוצגים סוגי הצמתים הזמינים. כדי לראות רשימה של סוגי הצמתים שזמינים לפרויקט, מריצים את הפקודה gcloud compute sole-tenancy node-types list או יוצרים בקשת REST של nodeTypes.list.
| סוג הצומת | מעבד מידע | vCPU | GB | vCPU:GB | שקעים | Cores:Socket | סה"כ ליבות | מספר המכונות הווירטואליות המקסימלי שמותר |
|---|---|---|---|---|---|---|---|---|
a2-highgpu-node-96-680 |
Cascade Lake | 96 | 680 | 1:7.08 | 2 | 24 | 48 | 8 |
a2-megagpu-node-96-1360 |
Cascade Lake | 96 | 1360 | 1:14.17 | 2 | 24 | 48 | 1 |
a2-ultragpu-node-96-1360-lssd 1 |
Cascade Lake | 96 | 1360 | 1:14.17 | 2 | 24 | 48 | 1 |
a3-highgpu-node-208-1872-lssd 1 |
Sapphire Rapids | 208 | 1872 | 1:9 | 2 | 56 | 112 | 8 |
a3-megagpu-node-208-1872-lssd 1 |
Sapphire Rapids | 208 | 1872 | 1:9 | 2 | 56 | 112 | 1 |
c2-node-60-240 |
Cascade Lake | 60 | 240 | 1:4 | 2 | 18 | 36 | 15 |
c3-node-176-352 |
Sapphire Rapids | 176 | 352 | 1:2 | 2 | 48 | 96 | 44 |
c3-node-176-704 |
Sapphire Rapids | 176 | 704 | 1:4 | 2 | 48 | 96 | 44 |
c3-node-176-704-lssd |
Sapphire Rapids | 176 | 704 | 1:4 | 2 | 48 | 96 | 40 |
c3-node-176-1408 |
Sapphire Rapids | 176 | 1408 | 1:8 | 2 | 48 | 96 | 44 |
c3d-node-360-708 |
AMD EPYC Genoa | 360 | 708 | 1:2 | 2 | 96 | 192 | 34 |
c3d-node-360-1440 |
AMD EPYC Genoa | 360 | 1440 | 1:4 | 2 | 96 | 192 | 40 |
c3d-node-360-2880 |
AMD EPYC Genoa | 360 | 2880 | 1:8 | 2 | 96 | 192 | 40 |
c4-node-192-384 |
Emerald Rapids | 192 | 384 | 1:2 | 2 | 60 | 120 | 26 |
c4-node-192-720 |
Emerald Rapids | 192 | 720 | 1:3.75 | 2 | 60 | 120 | 26 |
c4-node-192-1488 |
Emerald Rapids | 192 | 1,488 | 1:7.75 | 2 | 60 | 120 | 26 |
c4a-node-72-144 |
Google Axion | 72 | 144 | 1:2 | 1 | 80 | 80 | 22 |
c4a-node-72-288 |
Google Axion | 72 | 288 | 1:4 | 1 | 80 | 80 | 22 |
c4a-node-72-576 |
Google Axion | 72 | 576 | 1:8 | 1 | 80 | 80 | 36 |
c4d-node-384-720 |
AMD EPYC Turin | 384 | 720 | 1:2 | 2 | 128 | 256 | 24 |
c4d-node-384-1488 |
AMD EPYC Turin | 384 | 1488 | 1:4 | 2 | 128 | 256 | 25 |
c4d-node-384-3024 |
AMD EPYC Turin | 384 | 3024 | 1:8 | 2 | 128 | 256 | 25 |
c4n-node-192-384 |
Emerald Rapids | 192 | 384 | 1:2 | 2 | 60 | 120 | 26 |
c4n-node-192-720 |
Emerald Rapids | 192 | 720 | 1:3.75 | 2 | 60 | 120 | 26 |
c4n-node-192-1488 |
Emerald Rapids | 192 | 1,488 | 1:7.75 | 2 | 60 | 120 | 26 |
g2-node-96-384 |
Cascade Lake | 96 | 384 | 1:4 | 2 | 28 | 56 | 8 |
g4-node-384-1440 |
AMD EPYC Turin | 384 | 1440 | 1:3.75 | 2 | 96 | 192 | 64 |
g2-node-96-432 |
Cascade Lake | 96 | 432 | 1:4.5 | 2 | 28 | 56 | 8 |
h3-node-88-352 |
Sapphire Rapids | 88 | 352 | 1:4 | 2 | 48 | 96 | 1 |
h4d-node-192-720 |
AMD EPYC Turin | 192 | 720 | 1:4 | 2 | 128 | 256 | 1 |
h4d-node-192-1488 |
AMD EPYC Turin | 192 | 1488 | 1:8 | 2 | 128 | 256 | 1 |
h4d-node-192-3024 |
AMD EPYC Turin | 192 | 3024 | 1:16 | 2 | 128 | 256 | 1 |
h4d-node-192-3024-lssd |
AMD EPYC Turin | 192 | 3024 | 1:16 | 2 | 128 | 256 | 1 |
m1-node-96-1433 |
Skylake | 96 | 1433 | 1:14.93 | 2 | 28 | 56 | 1 |
m1-node-160-3844 |
Broadwell E7 | 160 | 3844 | 1:24 | 4 | 22 | 88 | 4 |
m2-node-416-8832 |
Cascade Lake | 416 | 8832 | 1:21.23 | 8 | 28 | 224 | 1 |
m2-node-416-11776 |
Cascade Lake | 416 | 11776 | 1:28.31 | 8 | 28 | 224 | 2 |
m3-node-128-1952 |
אגם קפוא | 128 | 1952 | 1:15.25 | 2 | 36 | 72 | 2 |
m3-node-128-3904 |
אגם קפוא | 128 | 3904 | 1:30.5 | 2 | 36 | 72 | 2 |
m4-node-224-2976 |
Emerald Rapids | 224 | 2976 | 1:13.3 | 2 | 60 | 120 | 12 |
m4-node-224-5952 |
Emerald Rapids | 224 | 5952 | 1:26.7 | 2 | 60 | 120 | 1 |
n1-node-96-624 |
Skylake | 96 | 624 | 1:6.5 | 2 | 28 | 56 | 96 |
n2-node-80-640 |
Cascade Lake | 80 | 640 | 1:8 | 2 | 24 | 48 | 80 |
n2-node-128-864 |
Ice Lake | 128 | 864 | 1:6.75 | 2 | 36 | 72 | 128 |
n2d-node-224-896 |
AMD EPYC Milan | 224 | 896 | 1:4 | 2 | 64 | 128 | 108 |
n2d-node-224-1792 |
AMD EPYC Milan | 224 | 1792 | 1:8 | 2 | 64 | 128 | 112 |
n4-node-224-1372 |
Emerald Rapids | 224 | 1372 | 1:6 | 2 | 60 | 120 | 90 |
n4a-node-96-624 |
Google Axion | 96 | 624 | 1:6.5 | 1 | 96 | 96 | 72 |
1סוגי צמתים עם SSD מקומי: הסיומת -lssd מציינת שדיסקים של SSD מקומי מחוברים לצומת. בסוגי הצמתים A3 High, A3 Mega ו-A2 Ultra, כברירת מחדל מצורפים גם דיסקים מסוג Local SSD אם לא מציינים סיומת. כדי להקצות את סוגי הצמתים האלה בלי דיסקים של SSD מקומי, צריך להשתמש בסיומת -nolssd (לדוגמה, a3-megagpu-node-208-1872-nolssd או a2-ultragpu-node-96-1360-nolssd).
למידע על המחירים של סוגי הצמתים האלה, ראו תמחור של שרתים לדייר יחיד (sole-tenant).
כל הצמתים מאפשרים לתזמן מכונות וירטואליות בצורות שונות. צומתי n הם צמתים למטרות כלליות, שבהם אפשר לתזמן מכונות עם סוג מכונה בהתאמה אישית. במאמר המלצות לסוגי מכונות תוכלו לקרוא המלצות לבחירת סוג הצומת.
למידע על ביצועים, ראו פלטפורמות של מעבדים.
קבוצות של צמתים והקצאת מכונות וירטואליות
כדי להקצות מכונות וירטואליות בשרתים לדייר יחיד (sole-tenant), מבצעים את המשימות הבאות לפי הסדר:
- יוצרים תבנית של שרת לדייר יחיד.
- יצירת קבוצת שרתים לדייר יחיד
- הקצאת מכונות וירטואליות בשרתים לדייר יחיד.
קבוצת צמתים היא קבוצה הומוגנית של שרתי לדייר יחיד (sole-tenant) באזור ספציפי. קבוצות צמתים מקבלות בירושה מאפיינים מתבנית הצומת שעליה הן מבוססות, ויכולות להכיל כמה מכונות וירטואליות מאותה סדרת מכונות שפועלות על סוגי מכונות בגדלים שונים, כל עוד לסוג המכונה יש 2 או יותר יחידות vCPU.
כשיוצרים קבוצת צמתים, מציינים את מדיניות התחזוקה של המארח, את הגדרות השיתוף ואת הגודל. קבוצת צמתים יכולה להכיל אפס צמתים או יותר. אתם יכולים לנהל את הגודל של קבוצת הצמתים באופן ידני, או להפעיל שינוי גודל אוטומטי כדי לשנות את הגודל באופן אוטומטי בהתאם לעומס העבודה.
אחרי שיוצרים קבוצת צמתים, אפשר להקצות מכונות וירטואליות לצמתים ספציפיים בקבוצה. כדי לשלוט בצורה פרטנית במיקום של מכונות וירטואליות, אפשר להשתמש בתוויות של קירבה לצומת. אחרי ההקצאה, אפשר גם להשתמש בתוויות משאבים כדי לארגן ולנהל את המכונות הווירטואליות למטרות כמו חיוב או מלאי.
מדיניות התחזוקה של המארח
בהתאם לתרחישי הרישוי ולעומסי העבודה, יכול להיות שתרצו להגביל את מספר הליבות הפיזיות שבהן משתמשות המכונות הווירטואליות. המדיניות לגבי תחזוקת המארח שתבחרו עשויה להיות תלויה, למשל, בדרישות הרישוי או התאימות שלכם, או שתרצו לבחור מדיניות שתאפשר לכם להגביל את השימוש בשרתים פיזיים. בכל המדיניות הזו, המכונות הווירטואליות שלכם נשארות בחומרה ייעודית.
כשמקצים מכונות וירטואליות בצמתים של דייר יחיד, אפשר לבחור מבין שלוש האפשרויות הבאות של מדיניות תחזוקת המארח, שמאפשרות לקבוע אם ואיך Compute Engine מבצע מיגרציה פעילה של מכונות וירטואליות במהלך אירועים במארח, שמתרחשים בערך כל 4 עד 6 שבועות. במהלך התחזוקה, המערכת של Compute Engine מעבירה את כל המכונות הווירטואליות במארח כקבוצה אחת, באמצעות מיגרציה פעילה, לצומת אחר של דייר יחיד. עם זאת, במקרים מסוימים המערכת של Compute Engine עשויה לפצל את המכונות הווירטואליות לקבוצות קטנות יותר, ולהעביר כל קבוצה קטנה של מכונות וירטואליות לצמתים נפרדים של דייר יחיד באמצעות מיגרציה פעילה.
מדיניות ברירת המחדל לתחזוקת מארחים
זו מדיניות ברירת המחדל לתחזוקת מארחים, ומכונות וירטואליות בקבוצות של צמתים שמוגדרות עם המדיניות הזו פועלות לפי התנהגות התחזוקה המסורתית של מכונות וירטואליות שאינן של דייר יחיד. כלומר, בהתאם להגדרת התחזוקה במארח של המכונה הווירטואלית, המכונות הווירטואליות עוברות במיגרציה פעילה לצומת חדש של שרת לדייר יחיד בקבוצת הצמתים לפני אירוע תחזוקה במארח, ובצומת החדש של השרת לדייר יחיד פועלות רק המכונות הווירטואליות של הלקוח.
המדיניות הזו מתאימה במיוחד לרישיונות לכל משתמש או לכל מכשיר, שנדרשת בהם מיגרציה פעילה במהלך אירועים במארח. ההגדרה הזו לא מגבילה את העברת המכונות הווירטואליות למאגר קבוע של שרתים פיזיים, והיא מומלצת לעומסי עבודה כלליים ללא דרישות לשרתים פיזיים, שלא דורשים רישיונות קיימים.
מכיוון שהמכונות הווירטואליות עוברות במיגרציה פעילה לכל שרת בלי להתחשב בשיוך הקיים של השרת למדיניות הזו, המדיניות הזו לא מתאימה לתרחישים שבהם נדרש צמצום השימוש בליבות פיזיות במהלך אירועים במארח.
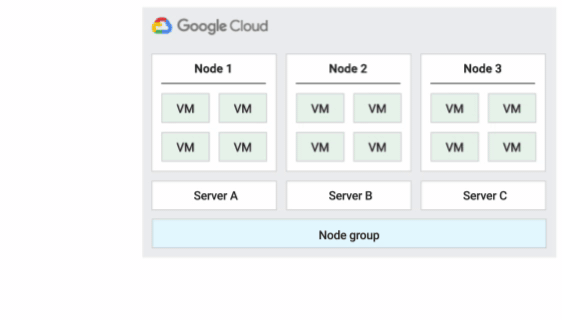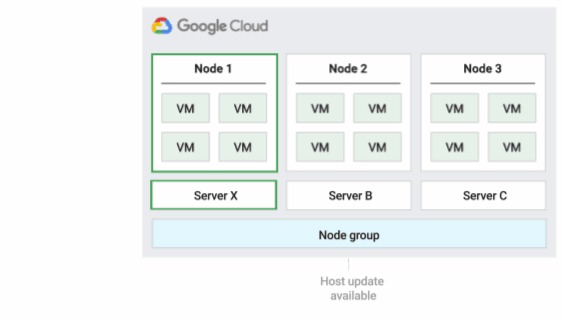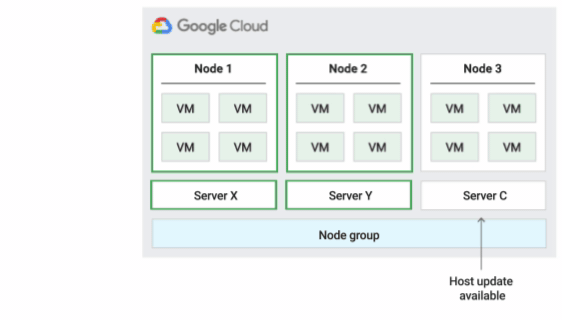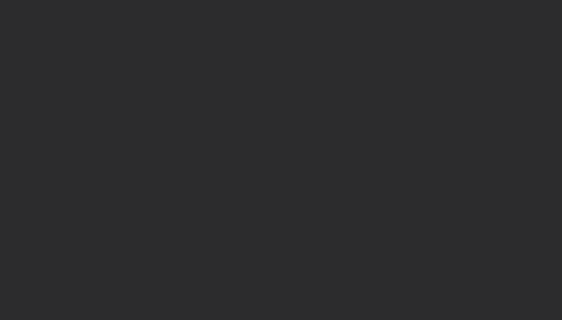
באיור הבא מוצגת אנימציה של מדיניות תחזוקת המארחים Default.
מכונות וירטואליות שלא תומכות במיגרציה פעילה
במכונות וירטואליות שלא תומכות במיגרציה פעילה (כמו חלק מה-Confidential VMs), במהלך אירוע תחזוקה של המארח, Compute Engine מקצה שרת חדש לדייר יחיד (sole-tenant), מסיים את המכונות הווירטואליות בצומת הישן ואז מפעיל אותן מחדש באופן אוטומטי בצומת החדש. ההפרעה למכונה הווירטואלית דומה להפעלה מחדש רגילה.
אם במארח אחד פועלות גם מכונות וירטואליות שתומכות במיגרציה פעילה וגם מכונות וירטואליות שלא תומכות במיגרציה פעילה, במהלך אירוע תחזוקה המכונות הווירטואליות שתומכות במיגרציה פעילה עוברות למארח חדש, והמכונות הווירטואליות האחרות מסתיימות ומופעלות מחדש.
כדי למזער את זמן ההשבתה, מגדירים את מדיניות התחזוקה של שרת לדייר יחיד (sole-tenant) לערך Default ומגדירים את המכונות הווירטואליות כך שהן יופסקו במהלך תחזוקת המארח עם הפעלה מחדש אוטומטית (onHostMaintenance=TERMINATE ו-automaticRestart=true).
מדיניות תחזוקת המארח "הפעלה מחדש במקום"
כשמשתמשים במדיניות הזו לתחזוקת המארח, המכונות הווירטואליות ב-Compute Engine מפסיקות לפעול במהלך אירועים במארח, ואז מופעלות מחדש באותו שרת פיזי אחרי האירוע במארח. כשמשתמשים במדיניות הזו, צריך להגדיר את ההגדרה on host maintenance של המכונה הווירטואלית לערך TERMINATE.
המדיניות הזו מתאימה במיוחד לעומסי עבודה עמידים בכשלים, שיכולים לחוות כשעה של זמן השבתה במהלך אירועים במארח, לעומסי עבודה שצריכים להישאר באותו שרת פיזי, לעומסי עבודה שלא נדרשת להם מיגרציה פעילה, או אם יש לכם רישיונות שמבוססים על מספר ליבות או מעבדים פיזיים.
באמצעות המדיניות הזו, אפשר להקצות את המכונה לקבוצת הצמתים באמצעות node-name, node-group-name או תווית של שיוך לצומת.
אם יש לכם מכונות וירטואליות שלא תומכות במיגרציה פעילה, השתמשו במדיניות הפעלה מחדש במקום רק אם אתם צריכים שיוך לשרת פיזי. אחרת, השתמשו במדיניות Default כדי לצמצם את זמן ההשבתה.
באיור הבא מוצגת אנימציה של מדיניות התחזוקה Restart in place.
העברה בתוך מדיניות תחזוקת מארח של קבוצת צמתים
כשמשתמשים במדיניות הזו לתחזוקת מארחים, מערכת Compute Engine מבצעת מיגרציה פעילה של מכונות וירטואליות בתוך קבוצה בגודל קבוע של שרתים פיזיים במהלך אירועים במארח. כך אפשר להגביל את מספר השרתים הפיזיים הייחודיים שבהם נעשה שימוש במכונה הווירטואלית.
המדיניות הזו מתאימה במיוחד לעומסי עבודה בזמינות גבוהה עם רישיונות שמבוססים על מספר הליבות או המעבדים הפיזיים, כי במדיניות התחזוקה הזו, כל צומת לדייר יחיד בקבוצה מוצמד לקבוצה קבועה של שרתים פיזיים, בניגוד למדיניות ברירת המחדל שמאפשרת להעביר מכונות וירטואליות לכל שרת.
המדיניות הזו מסתמכת על מיגרציה פעילה כדי להעביר מכונות וירטואליות לצומתי holdback, ולכן אי אפשר להשתמש בה במכונות וירטואליות שלא תומכות במיגרציה פעילה. אם אי אפשר להעביר את המכונות הווירטואליות שלכם במיגרציה פעילה, ואין לכם רישיונות תוכנה שדורשים שיוך לשרת פיזי בתוך קבוצת צמתים (כמו Windows Server BYOL), אין תועלת בשימוש במדיניות הזו ותחויבו בעלות של הצמתים השמורים.
אם המדיניות הזו מוגדרת, אי אפשר להקצות מכונה וירטואלית לצומת ספציפי או להעביר אותה ידנית במיגרציה פעילה לצומת ספציפי באמצעות תווית השיוך node-name. אתם יכולים להשתמש בכל תוויות שיוך מותאמות אישית עבור מכונות וירטואליות, כל עוד אתם מציינים גם את התווית node-group-name ולא את התווית node-name.
כדי לוודא שיש מספיק קיבולת למיגרציה פעילה, Compute Engine שומר צומת אחד לכל 20 צמתים שאתם שומרים. באיור הבא מוצגת אנימציה של מדיניות התחזוקה של המארח Migrate within node group.
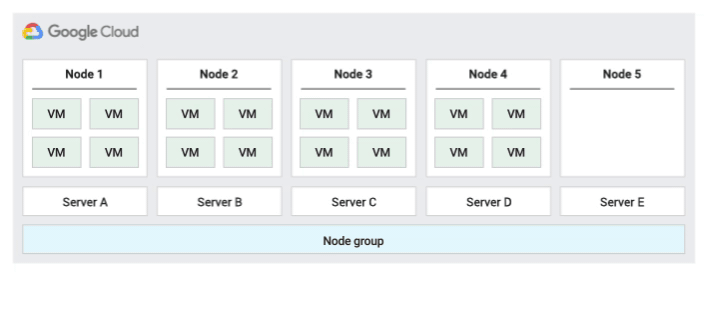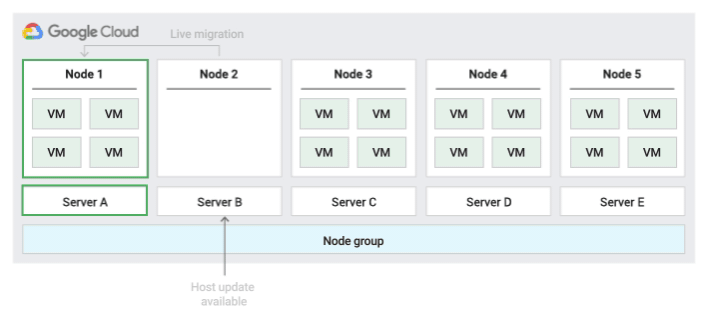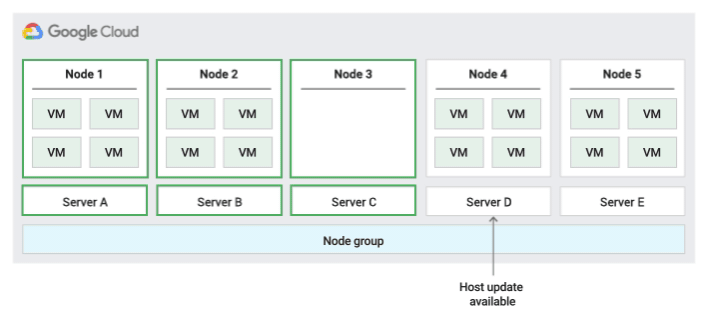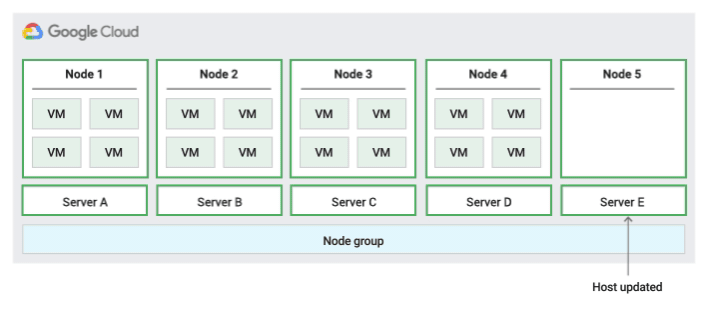
בטבלה הבאה מוצג מספר הצמתים ש-Compute Engine שומר כהחזקה, בהתאם למספר הצמתים שאתם שומרים לקבוצת הצמתים.
| סה"כ צמתים בקבוצה | צומתי Holdback ששמורים למיגרציה פעילה |
|---|---|
| 1 | לא רלוונטי. צריך להזמין לפחות 2 צמתים. |
| 2 עד 20 | 1 |
| 21 עד 40 | 2 |
| 41 עד 60 | 3 |
| 61 עד 80 | 4 |
| 81 עד 100 | 5 |
כדי לבצע העברות בשידור חי, המדיניות הזו דורשת שיהיה לפחות צומת אחד ריק בכל זמן נתון. אם תנסו למחוק את הצומת הריק היחיד בקבוצה, הפעולה תיכשל ותופיע השגיאה insufficient holdback. כדי לאחד מכונות וירטואליות למספר קטן יותר של צמתים ולמחוק צמתים ריקים מיותרים, צריך לעצור ולהפעיל מחדש את המכונות הווירטואליות בצמתים עם מעט מכונות וירטואליות, או לבצע מיגרציה פעילה ידנית של המכונות הווירטואליות לקבוצת הצמתים.
הצמדת מכונה לכמה קבוצות של צמתים
אפשר להצמיד מכונה לכמה קבוצות של צמתים באמצעות node-group-name
תווית השיוך
בתנאים הבאים:
- המכונה שרוצים להצמיד משתמשת במדיניות ברירת המחדל לתחזוקת המארח (Migrate VM instance).
- מדיניות התחזוקה של המארח בכל קבוצות הצמתים שאתם רוצים להצמיד אליהן את המכונה היא העברה בתוך קבוצת צמתים. אם תנסו להצמיד מכונה לקבוצות של צמתים עם מדיניות שונה לתחזוקת מארחים, הפעולה תיכשל ותופיע הודעת שגיאה.
לדוגמה, אם רוצים להצמיד מכונת test-node לשתי קבוצות צמתים node-group1 ו-node-group2, צריך לוודא את הדברים הבאים:
- מדיניות התחזוקה של המארח
test-nodeהיא Migrate VM instance. - מדיניות התחזוקה של המארח של
node-group1ו-node-group2היא העברה בתוך קבוצת צמתים.
חלונות זמן לתחזוקה
אם אתם מנהלים עומסי עבודה, למשל מסדי נתונים שעברו כוונון עדין, שעלולים להיות רגישים להשפעה של העברה חיה על הביצועים, תוכלו לקבוע מתי תתחיל התחזוקה בקבוצת צמתים של דייר יחיד. כדי לעשות זאת, צריך לציין חלון זמן לתחזוקה כשיוצרים את קבוצת הצמתים. אי אפשר לשנות את חלון הזמן לתחזוקה אחרי שיוצרים את קבוצת הצמתים.
חלונות זמן לתחזוקה הם בלוקים של 4 שעות שבהם אפשר לציין מתי Google מבצעת תחזוקה בצמתים שלכם עם דייר יחיד. חלון הזמן לתחזוקה מגדיר מתי אפשר להתחיל את תחזוקת הצומת, ואז מפעיל פעולות של מיגרציה פעילה או סיום והפעלה מחדש ברמת ה-VM. אירועי תחזוקה מתרחשים בערך פעם ב-4 עד 6 שבועות.
חלון זמן לתחזוקה חל על כל המכונות הווירטואליות בקבוצת השרתים לדייר יחיד (sole-tenant), והוא מציין רק מתי התחזוקה מתחילה. אין הבטחה שהתחזוקה תסתיים במהלך חלון הזמן לתחזוקה, ואין הבטחה לגבי התדירות שבה התחזוקה מתבצעת. אי אפשר להגדיר חלונות זמן לתחזוקה בקבוצות צמתים שמוגדרת בהן מדיניות התחזוקה Migrate within node group.
הדמיה של אירוע תחזוקה של מארח
אתם יכולים לדמות אירוע תחזוקה של מארח כדי לבדוק איך עומסי העבודה שפועלים בשרתים לדייר יחיד (sole-tenant) מתנהגים במהלך אירוע תחזוקה של מארח. כך אפשר לראות את ההשפעות של מדיניות התחזוקה של המארח של מכונת ה-VM עם הדייר היחיד על האפליקציות שפועלות במכונות ה-VM.
שגיאות שקשורות למארח
במקרה של כשל חמור ונדיר בחומרה של המארח – מארח עם דייר יחיד או מארח עם כמה דיירים – מערכת Compute Engine מבצעת את הפעולות הבאות:
הוצאה משימוש של השרת הפיזי והמזהה הייחודי שלו.
הפעולה מבטלת את הגישה של הפרויקט לשרת הפיזי.
החלפת החומרה שנכשלה בשרת פיזי חדש עם מזהה ייחודי חדש.
העברת המכונות הווירטואליות מהחומרה שנכשלה לצומת החלופי.
הפעלה מחדש של המכונות הווירטואליות המושפעות, אם הגדרתם אותן להפעלה מחדש אוטומטית.
זיקה (affinity) ואנטי-זיקה של צומת
שרתים לדייר יחיד (sole-tenant) מוודאים שהמכונות הווירטואליות שלכם לא חולקות מארח עם מכונות וירטואליות מפרויקטים אחרים, אלא אם אתם משתמשים בקבוצות של שרתים לדייר יחיד (sole-tenant) משותפים. בקבוצות משותפות של שרתים לדייר יחיד, פרויקטים אחרים בארגון יכולים להקצות מכונות וירטואליות באותו מארח. עם זאת, יכול להיות שתרצו לקבץ כמה עומסי עבודה יחד באותו שרת לדייר יחיד (sole-tenant), או לבודד את עומסי העבודה זה מזה בשרתים שונים. לדוגמה, כדי לעמוד בדרישות מסוימות של תאימות, יכול להיות שתצטרכו להשתמש בתוויות שיוך כדי להפריד בין עומסי עבודה רגישים לבין עומסי עבודה לא רגישים.
כשיוצרים מכונה וירטואלית, מבקשים דייר יחיד על ידי ציון של שיוך לצומת או אי-שיוך לצומת, תוך התייחסות לתווית אחת או יותר של שיוך לצומת. כשיוצרים תבנית צומת, מציינים תוויות בהתאמה אישית של שיוך לצומת, ו-Compute Engine כולל באופן אוטומטי כמה תוויות שיוך כברירת מחדל בכל צומת. כשמציינים שיוך כשיוצרים מכונה וירטואלית, אפשר לתזמן את המכונות הווירטואליות יחד בצומת ספציפי או בצמתים ספציפיים בקבוצת צמתים. כשמציינים אנטי-אפיניות כשיוצרים מכונה וירטואלית, אפשר לוודא שמכונות וירטואליות מסוימות לא מתוזמנות יחד באותו צומת או באותם צמתים בקבוצת צמתים.
תוויות של שיוך לצומת הן צמדי מפתח/ערך שמוקצים לצמתים, והן עוברות בירושה מתבנית של צומת. תוויות של קהלים עם תחום עניין משותף מאפשרות לכם:
- שליטה באופן ההקצאה של מכונות וירטואליות (VM) לצמתים.
- הגדרת האופן שבו מוקצים צמתים למופעי מכונות וירטואליות שנוצרו מתבנית, כמו אלה שנוצרו על ידי קבוצת מופעי מכונה מנוהלים.
- לקבץ מכונות וירטואליות רגישות בצמתים ספציפיים או בקבוצות של צמתים, בנפרד ממכונות וירטואליות אחרות.
תוויות שיוך כברירת מחדל
Compute Engine מקצה לכל צומת את תוויות השיוך הבאות כברירת מחדל:
- תווית לשם של קבוצת הצמתים:
- מפתח:
compute.googleapis.com/node-group-name - ערך: שם קבוצת הצמתים.
- מפתח:
- תווית לשם הצומת:
- מפתח:
compute.googleapis.com/node-name - ערך: השם של הצומת הספציפי.
- מפתח:
- תווית לפרויקטים שקבוצת הצמתים משותפת איתם:
- מקש:
compute.googleapis.com/project - ערך: מזהה הפרויקט שמכיל את קבוצת הצמתים.
- מקש:
תוויות של קהלים בהתאמה אישית עם תחום עניין משותף
אפשר ליצור תוויות בהתאמה אישית של העדפת צומת כשיוצרים תבנית צומת. תוויות הקרבה האלה מוקצות לכל הצמתים בקבוצות הצמתים שנוצרו מתבנית הצומת. אחרי שיוצרים קבוצת צמתים, אי אפשר להוסיף עוד תוויות של קהל בהתאמה אישית עם תחום עניין משותף לצמתים בקבוצה.
למידע על השימוש בתוויות של זיקה, ראו הגדרת זיקה של צומת.
תמחור
כדי לעזור לכם לצמצם את העלות של צומתי Sole-Tenant, ב-Compute Engine יש הנחות תמורת התחייבות לשימוש (CUD) והנחות על שימוש קבוע (SUD). הערה: על חיובים על שימוש בפרימיום של דיירות יחידה אפשר לקבל רק הנחות גמישות תמורת התחייבות לשימוש (CUD) והנחות על שימוש בר קיימא (SUD), אבל לא הנחות תמורת התחייבות לשימוש במשאבים.
מכיוון שאתם כבר מחויבים על ה-vCPU והזיכרון של השרתים לדייר יחיד, אתם לא משלמים תוספת על המכונות הווירטואליות שאתם יוצרים בצמתים האלה.
אם אתם מקצים שרתי לדייר יחיד (sole-tenant) עם יחידות GPU או דיסקים מקומיים של SSD, אתם מחויבים על כל יחידות ה-GPU או הדיסקים המקומיים של SSD בכל שרת לדייר יחיד (sole-tenant) שאתם מקצים. הפרמיה על שימוש בשרת לדייר יחיד (sole-tenant) מבוססת רק על ה-vCPU והזיכרון שבהם אתם משתמשים עבור השרת לדייר יחיד (sole-tenant), ולא כוללת יחידות GPU או דיסקים מקומיים של SSD.
למידע נוסף, ראו תמחור של שרתי לדייר יחיד (sole-tenant).
זמינות
שרתים לדייר יחיד (sole-tenant) זמינים באזורים נבחרים. כדי לוודא זמינות גבוהה, תזמנו מכונות וירטואליות בשרתים לדייר יחיד באזורים שונים.
לפני שמשתמשים במעבדי GPU או בדיסקים מסוג SSD מקומי בשרתים לדייר יחיד (sole-tenant), צריך לוודא שיש מספיק מכסה של מעבדי GPU או של SSD מקומי בתחום (zone) שבו אתם שומרים את המשאב.
ב-Compute Engine יש תמיכה במעבדים גרפיים בסוגי הצמתים לדייר יחיד
n1,g2,g4,a2-highgpu,a2-megagpu,a2-ultragpu,a3-highgpuו-a3-megagpuשנמצאים באזורים עם תמיכה במעבדים גרפיים. בטבלה הבאה מוצגים סוגי ה-GPU שאפשר לצרף לצומתיn1, g2,g4, a2ו-a3, ומספר יחידות ה-GPU שצריך לצרף כשיוצרים את תבנית הצומת.סוג ה-GPU כמות ה-GPU סוג השרת לדייר יחיד (sole-tenant) NVIDIA A100 40GB 8 a2-highgpuNVIDIA A100 40GB 16 a2-megagpuNVIDIA A100 80GB 8 a2-ultragpuNVIDIA H100 8 a3-highgpuNVIDIA H100 8 a3-megagpuNVIDIA L4 8 g2NVIDIA RTX PRO 6000 8 g4NVIDIA P4 4 n1NVIDIA T4 4 n1NVIDIA V100 8 n1Compute Engine תומך בדיסקים מקומיים מסוג SSD ב
n1,n2,n2d,g2,g4,a2-ultragpu,a3-highgpuוa3-megagpuבסוגי צמתים של דייר יחיד שמשמשים באזורים שתומכים בסדרות המכונות האלה.
הגבלות
אי אפשר להשתמש במכונות וירטואליות עם דייר יחיד בסדרות ובסוגי המכונות הבאים: T2D, T2A, E2, C2D, A3 Ultra, A3 Edge, A4, A4X, או מכונות Bare Metal.
במכונות וירטואליות עם דייר יחיד אי אפשר לציין פלטפורמת CPU מינימלית.
אי אפשר להעביר מכונה וירטואלית לשרת לדייר יחיד (sole-tenant) אם במכונה הווירטואלית הזו מצוינת פלטפורמת CPU מינימלית. כדי להעביר מכונה וירטואלית לשרת לדייר יחיד (sole-tenant), הסירו את המפרט של פלטפורמת ה-CPU המינימלית על ידי הגדרתו לאוטומטי לפני עדכון תוויות השיוך לצומת של המכונה הווירטואלית.
שרתים לדייר יחיד לא תומכים במכונות וירטואליות זמניות שניתנות להפסקה.
מידע על המגבלות של שימוש בדיסקים של SSD מקומי בצמתים של דייר יחיד מופיע במאמר שמירת נתונים ב-SSD מקומי.
במאמר המגבלות של מיגרציה פעילה מוסבר איך השימוש במעבדים גרפיים משפיע על מיגרציה פעילה.
Confidential VMs שלא תומכות במיגרציה פעילה, ההתנהגות וההגבלות שונות בשלושת הסוגים של מדיניות התחזוקה של צומתי Sole-Tenant. מידע נוסף זמין במאמרים בנושא מדיניות תחזוקה של מארחים ופתרון בעיות במיגרציה פעילה עבור Confidential VMs.
בשרתים לדייר יחיד (sole-tenant) עם GPUs אין תמיכה במכונות וירטואליות בלי GPUs.
רק צמתים של דייר יחיד מסוג N1, N2, N2D ו-N4 תומכים בהקצאת יתר של מעבדי CPU.
מכונות וירטואליות מסוג C3, C3D, C4, C4A, C4D, G4, N4 ו-M4 מתוזמנות בהתאמה לארכיטקטורת ה-NUMA הבסיסית של שרת לדייר יחיד (sole-tenant). תזמון של צורות מלאות וצורות של מכונות וירטואליות מסוג sub-NUMA באותו הצומת עלול להוביל לפיצול, כך שלא ניתן להריץ צורה גדולה יותר, בעוד שאפשר להריץ כמה צורות קטנות יותר שסך דרישות המשאבים שלהן זהה.
בשרתים לדייר יחיד מסוג C3 ו-C4, היחס בין ה-vCPU לזיכרון במכונות הווירטואליות צריך להיות זהה ליחס בסוג השרת. לדוגמה, אי אפשר להציב מכונה וירטואלית מסוג
c3-standardבשרת מסוג-highmem.אי אפשר לעדכן את מדיניות התחזוקה בקבוצת צמתים פעילה.
המאמרים הבאים
איך מקצים יותר מדי מעבדים (CPU) למכונות וירטואליות של דיירים יחידים
מומלץ לעיין בשיטות המומלצות לשימוש בצמתים עם דייר יחיד להפעלת עומסי עבודה של מכונות וירטואליות.