


Menggunakan Agen Data Engineering untuk membangun dan memodifikasi pipeline data
Agen Data Engineering di BigQuery dan Dataform memungkinkan Anda membangun, mengubah, dan mengelola pipeline data untuk memuat dan memproses data di BigQuery. Anda dapat menggunakan perintah bahasa alami untuk membuat pipeline data dari berbagai sumber data atau menyesuaikan pipeline data yang ada agar sesuai dengan kebutuhan data engineering Anda.
Agen ini menghasilkan dan mengatur kode pipeline data langsung dalam repositori Dataform dan beroperasi di ruang kerja Dataform, sehingga pipeline Dataform otomatis tersedia untuk agen. Anda juga dapat berinteraksi dengan agen menggunakan Data Engineering Agent API, yang menggunakan protokol A2A. Untuk contoh perintah yang dapat Anda gunakan, lihat Contoh perintah.
Batasan
Agen Data Engineering memiliki batasan berikut:
- Agen Data Engineering tidak mendukung perintah bahasa alami untuk
jenis file berikut:
- Notebook
- Persiapan data
- Agen Data Engineering tidak dapat menjalankan pipeline. Anda harus meninjau dan menjalankan atau menjadwalkan pipeline.
- Agen Data Engineering tidak dapat menelusuri link web atau URL apa pun yang diberikan melalui petunjuk atau perintah langsung.
- Saat mengimpor file dalam
file petunjuk agen,
sintaksis impor
@hanya mendukung jalur yang diawali dengan./,/, atau huruf. - Fitur pratinjau data hanya didukung untuk tabel, deklarasi, atau kueri dengan flag
hasOutputyang ditetapkan ketrue. - Agen Data Engineering tunduk pada batasan umum teknologi AI.
- Saat membuat pipeline di tabel eksternal Apache Iceberg yang dikelola oleh katalog runtime Lakehouse (sebelumnya BigLake metastore), semua batasan katalog runtime Lakehouse berlaku. Terutama, agen tidak dapat menghasilkan mutasi tulis (seperti
INSERT,UPDATE,DELETE, atauMERGE) atau pernyataan DDL (sepertiCREATE TABLEatauDROP TABLE) pada tabel Iceberg. Untuk mengetahui informasi selengkapnya, lihat Konsep endpoint katalog REST Apache Iceberg.
Sebelum memulai
Sebelum menggunakan Agen Data Engineering, lakukan langkah-langkah di bagian ini.
Mengaktifkan Gemini di BigQuery
Pastikan Gemini in BigQuery diaktifkan untuk projectGoogle Cloud Anda. Untuk mengetahui informasi selengkapnya, lihat Menyiapkan Gemini di BigQuery.
Mengaktifkan API yang diperlukan
console
Aktifkan API berikut di konsol Google Cloud untuk project Google Cloud yang Anda gunakan dengan Conversational Analytics API, jika belum diaktifkan.
Mengaktifkan Gemini Data Analytics API
gcloud
Untuk mengaktifkan Gemini Data Analytics API, Gemini for Google Cloud
API, dan BigQuery API, jika belum diaktifkan, gunakan
Google Cloud CLI dan jalankan perintah
gcloud services enable berikut:
gcloud services enable geminidataanalytics.googleapis.com --project=PROJECT_ID
gcloud services enable cloudaicompanion.googleapis.com --project=PROJECT_ID
gcloud services enable bigquery.googleapis.com --project=PROJECT_ID
Ganti PROJECT_ID dengan project ID Google Cloud Anda.
Peran yang diperlukan
Untuk mendapatkan izin yang Anda perlukan untuk menggunakan Agen Data Engineering, minta administrator untuk memberi Anda peran IAM berikut pada project:
- Dataform Code Editor (
roles/dataform.codeEditor) - BigQuery Job User (
roles/bigquery.jobUser) - Gemini Data Analytics Stateless Chat User (
roles/geminidataanalytics.dataAgentStatelessUser)
Untuk mengetahui informasi selengkapnya tentang pemberian peran, lihat Mengelola akses ke project, folder, dan organisasi.
Peran yang telah ditetapkan ini berisi izin
geminidataanalytics.locations.useDataEngineeringAgent,
yang diperlukan untuk
menggunakan Agen Data Engineering.
Anda mungkin juga bisa mendapatkan izin ini dengan peran khusus atau peran bawaan lainnya.
Untuk mengetahui detail tentang peran yang diperlukan untuk mengkueri tabel Apache Iceberg, lihat Peran yang diperlukan untuk dukungan Apache Iceberg Lakehouse.
Prasyarat integrasi Knowledge Catalog
Untuk mendapatkan izin yang
diperlukan untuk mengintegrasikan Agen Data Engineering dengan Knowledge Catalog,
minta administrator untuk memberi Anda
peran IAM Dataplex Catalog Editor (roles/dataplex.catalogEditor) di project.
Untuk mengetahui informasi selengkapnya tentang cara memberikan peran, lihat Mengelola akses ke project, folder, dan organisasi.
Peran yang telah ditetapkan ini berisi izin
geminidataanalytics.locations.useDataEngineeringAgent,
yang diperlukan untuk
mengintegrasikan Agen Data Engineering dengan Knowledge Catalog.
Anda mungkin juga bisa mendapatkan izin ini dengan peran khusus atau peran bawaan lainnya.
Jika Anda menggunakan akun layanan kustom untuk menjalankan pipeline, Anda harus memberikan peran Dataplex Catalog Editor (roles/dataplex.catalogEditor) pada project atau grup entri @bigquery.
Selain itu, Anda harus mengaktifkan Dataplex API.
Mengenkripsi data dengan kunci Cloud Key Management Service
Anda dapat mengenkripsi data di tingkat set data atau project dengan kunci Cloud Key Management Service default yang dikelola pelanggan di BigQuery. Untuk mengetahui informasi selengkapnya, lihat Menetapkan kunci default set data dan Menetapkan kunci default project.
Anda dapat mengenkripsi kode pipeline di level project dengan menetapkan kunci Cloud Key Management Service Dataform default.
Mengonfigurasi perimeter Kontrol Layanan VPC
Jika menggunakan Kontrol Layanan VPC, Anda harus mengonfigurasi perimeter untuk melindungi Dataform, BigQuery, dan Conversational Analytics API. Untuk mengetahui informasi selengkapnya, lihat Dataform, BigQuery, dan Conversational Analytics API.
Membuat pipeline data dengan Agen Data Engineering
Untuk menggunakan Agen Data Engineering di BigQuery, pilih salah satu opsi berikut:
Pipeline BigQuery
Anda dapat menggunakan Agen Data Engineering di antarmuka pipeline BigQuery dengan melakukan hal berikut:
Buka halaman BigQuery.
Di editor kueri, klik arrow_drop_down Create new > Pipeline.
Di antarmuka pipeline, klik Ask agent.
Di kolom Ask agent, masukkan perintah bahasa alami untuk membuat pipeline data—misalnya:
  Create dimension tables for a taxi trips star schema from
  new_york_taxi_trips.tlc_green_trips_2022. Generate surrogate keys and all
  the descriptive attributes.
Setelah Anda memasukkan perintah, klik Kirim.
Agen Data Engineering membuat pipeline data berdasarkan perintah Anda.
Agen Data Engineering membuat draf usulan pipeline data. Anda dapat mengklik node pipeline untuk meninjau kueri SQLX yang dihasilkan. Untuk menerapkan pipeline data yang disarankan agen, klik Apply.
Dataform
Anda dapat menggunakan Agen Data Engineering di Dataform dengan melakukan hal berikut:
Buka Dataform.
Pilih repositori.
Pilih atau buat ruang kerja pengembangan.
Di ruang kerja, klik Ask Agent.
Di perintah Ask agent yang muncul, masukkan perintah bahasa alami untuk membuat pipeline data—misalnya:
  Create dimension tables for a taxi trips star schema from
  new_york_taxi_trips.tlc_green_trips_2022. Generate surrogate keys and all
  the descriptive attributes.
Setelah Anda memasukkan perintah, klik Kirim.
Setelah perintah Anda dikirim, Agen Data Engineering akan membuat pipeline data dan mengubah file SQLX Dataform berdasarkan perintah Anda. Agen akan menerapkan perubahan ini langsung ke file ruang kerja Anda.
Mengedit pipeline data
Untuk mengedit pipeline data, klik Ask agent, lalu masukkan perintah yang menyarankan perubahan pada pipeline data.

Tinjau perubahan yang diusulkan oleh Agen Data Engineering, lalu klik Terapkan untuk menerapkan perubahan.
Anda juga dapat mengedit kueri SQLX secara manual dengan memilih node pipeline, lalu mengklik Open.
Meninjau pipeline data
Anda dapat mengklik node pipeline di pipeline data yang dibuat oleh Agen Data Engineering untuk meninjaunya.
- Tab Configuration menampilkan kueri SQLX yang dihasilkan yang terkait dengan node.
- Tab Pratinjau data menampilkan tabel input dan output file. Anda dapat melihat pratinjau transformasi data melalui node ini dengan mengklik Run task untuk menjalankan tugas dengan atau tanpa dependensi.
Memecahkan masalah error pipeline data
Jika Anda mengalami error saat membuat pipeline data, selesaikan semua prasyarat untuk menjalankan Agen Data Engineering.
Error dalam pipeline Anda muncul sebagai operasi eksekusi yang gagal di tab Executions. Untuk menggunakan Agen Data Engineering guna menjalankan analisis akar masalah dan mendapatkan rekomendasi pemecahan masalah, lakukan hal berikut:
Di tab Executions, klik status eksekusi yang gagal, lalu klik Investigate.
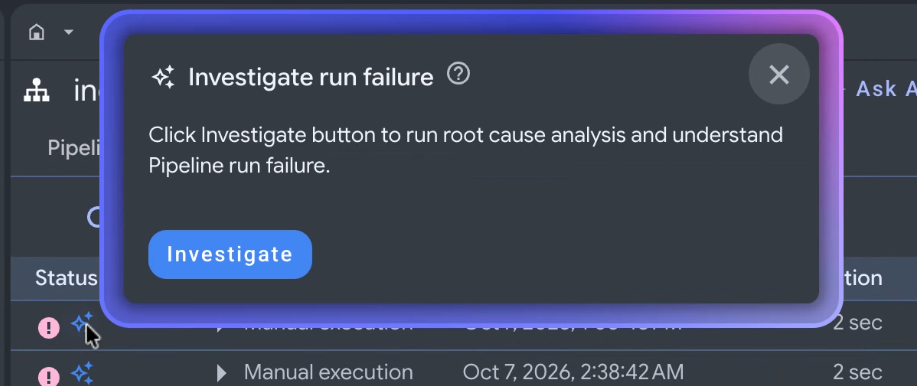
Panel Ask agent akan terbuka dengan permintaan yang meminta agen untuk melakukan analisis penyebab utama untuk operasi yang gagal.
Tinjau laporan pemecahan masalah dari agen.
Laporan pemecahan masalah mencakup informasi selengkapnya tentang error dalam proses pembuatan pipeline. Anda dapat meminta agen untuk memperbaiki error pipeline ini berdasarkan laporan.
Membuat petunjuk agen
Petunjuk agen adalah petunjuk natural language untuk Agen Data Engineering yang memungkinkan Anda menyimpan petunjuk persisten sehingga agen mengikuti serangkaian aturan kustom yang telah ditetapkan sebelumnya. Gunakan petunjuk agen jika Anda ingin hasil agen konsisten di seluruh organisasi—misalnya, dengan konvensi penamaan atau untuk menerapkan panduan gaya.
Anda dapat membuat file konteks GEMINI.MD sebagai file petunjuk agen untuk Agen Data Engineering. Anda dapat membuat file petunjuk agen untuk digunakan di ruang kerja lokal, atau Anda dapat menggunakan file petunjuk yang sama di beberapa pipeline data dengan repositori eksternal.
Untuk membuat petunjuk agen, lakukan hal berikut:
- Di bagian Ask agent, klik Pipeline instructions.
- Di panel Instructions for pipeline, klik Create instructions file.
Dalam file
GEMINI.MDyang muncul, masukkan petunjuk Anda dalam bahasa alami.Contoh berikut menunjukkan file petunjuk agen dengan beberapa aturan:
  1. All event-specific tables MUST be prefixed with `cs_event_`.
  2. The primary key for any player activity table is a composite key of `player_id` and `event_timestamp_micros`.
  3. Filter out any player actions where `mana_spent` is greater than `max_mana_pool`. This is considered a data anomaly.
Klik Simpan.
Untuk mengetahui informasi tentang cara terbaik menyusun file petunjuk agen, lihat Praktik terbaik dengan file petunjuk agen.
Memuat petunjuk agen dari repositori eksternal
Untuk menggunakan kembali serangkaian petunjuk agen di beberapa pipeline data, tautkan repositori eksternal:
- Di bagian Ask agent, klik Pipeline instructions.
- Di bagian External repository, pilih Use instructions from external repository.
- Di kolom yang disediakan, tentukan repositori yang berisi petunjuk agen yang ingin Anda gunakan dengan pipeline data.
- Klik Simpan.
Contoh perintah
Bagian berikut memberikan contoh perintah yang dapat Anda gunakan dengan Agen Data Engineering untuk mengembangkan pipeline data Anda.
Menggabungkan data yang ada ke dalam tabel baru
Dengan perintah ini, Agen Data Engineering menggunakan skema dan sampel untuk menyimpulkan pengelompokan data berdasarkan kunci. Agen biasanya menyiapkan konfigurasi tabel baru dengan deskripsi tabel dan kolom.
  Create a daily sales report from the
  bigquery-public-data.thelook_ecommerce.order_items table into a
  reporting.daily_sales_aggregation table.
Membuat kolom turunan baru dan menambahkan pemeriksaan kualitas data ke tabel baru
Perintah ini menunjukkan cara menambahkan tabel dan kolom, serta menentukan pemeriksaan kualitas ke tabel secara bersamaan:
  Create a new table named staging.products from
  bigquery-public-data.thelook_ecommerce.products and add a calculated column
  named gross_profit, which is the retail_price minus the cost.


  Also, add the following assertions: ID must not be null and must be unique.
  The retail_price must be greater than or equal to the cost. The department
  column can only contain 'Men' or 'Women'.
Membuat UDF sebagai bagian dari definisi model
Agen Data Engineering juga dapat menyiapkan DDL untuk membuat fungsi yang ditentukan pengguna (UDF). Meskipun agen tidak akan benar-benar membuat UDF, Anda dapat membuat UDF dengan menjalankan pipeline data. UDF ini dapat digunakan dalam definisi model di pipeline data Anda.
  Create a user-defined function (UDF) named get_age_group that takes an integer
  age as input and returns a string representing the age group ('Gen Z',
  'Millennial', 'Gen X', 'Baby Boomer').


  Use this UDF on the age column from the
  bigquery-public-data.thelook_ecommerce.users table to create a new view called
  reporting.user_age_demographics that includes user_id, age, and the calculated
  age_group.
Praktik terbaik
Untuk meningkatkan hasil saat bekerja dengan Agen Data Engineering dan Dataform, sebaiknya lakukan hal berikut:
Gunakan petunjuk agen untuk permintaan umum. Jika Anda biasanya menerapkan teknik tertentu, atau jika Anda sering melakukan koreksi yang sama pada agen, gunakan petunjuk agen sebagai lokasi terpusat untuk menyimpan petunjuk dan permintaan umum.
Manfaatkan rencana agen. Rencana agen dapat membantu menguraikan tugas pipeline yang kompleks. Rencana agen juga dapat menunjukkan asumsi dan niat agen, jadi sebaiknya tinjau rencana tersebut untuk memastikan agen diberikan konteks yang benar.
Setelah meninjau rencana, Anda dapat mengedit rencana dengan memberikan masukan dan perubahan kepada Agen Data Engineering. Contoh:
In the plan, ensure that all of the intermediate tables are views.
Dalam beberapa kasus, sebaiknya minta agen untuk membuat rencana yang tidak memerlukan persetujuan eksplisit Anda. Tindakan membuat rencana agen memaksa Agen Data Engineering untuk menguraikan tindakannya, yang sering kali menghasilkan hasil yang lebih baik. Anda dapat memaksa agen untuk membuat rencana dan menjalankannya secara otomatis. Contoh:
Create a plan for a pipeline that finds the
top N pick up and drop off locations in NYC. You have my explicit pre-approval
to go ahead and execute this plan.
Tulis dengan jelas. Nyatakan permintaan Anda dengan jelas dan hindari penggunaan kata-kata yang tidak jelas. Jika memungkinkan, berikan sumber data sumber dan tujuan saat memberikan perintah, seperti yang ditunjukkan dalam contoh berikut:
  Extract data from the sales.customers table in the us_west_1 region, and load
  it into the reporting.dim_customers table in BigQuery. Match the schema of the
  destination table.
Berikan permintaan langsung dan tercakup. Ajukan pertanyaan satu per satu, dan buat perintah tetap ringkas. Untuk perintah dengan lebih dari satu pertanyaan, perinci setiap bagian pertanyaan yang berbeda untuk meningkatkan kejelasan, seperti yang ditunjukkan dalam contoh berikut:
  1. Create a new table named staging.events_cleaned. Use raw.events as the
     source. This new table should filter out any records where the user_agent
     matches the pattern '%bot%'. All original columns should be included.

  2. Next, create a table named analytics.user_sessions. Use
     staging.events_cleaned as the source. This table should calculate the
     duration for each session by grouping by session_id and finding the
     difference between the MAX(event_timestamp) and MIN(event_timestamp).
Berikan petunjuk yang jelas dan tekankan istilah-istilah penting. Anda dapat menambahkan penekanan pada istilah atau konsep utama dalam perintah dan memberi label persyaratan tertentu sebagai penting, seperti yang ditunjukkan dalam contoh berikut:
  When creating the staging.customers table, it is *VERY IMPORTANT* that you
  transform the email column from the source table bronze.raw_customers.
  Coalesce any NULL values in the email column to an empty string ''.
Tentukan urutan operasi. Untuk tugas yang berurutan, susun perintah Anda dalam daftar, dengan item yang tercantum dibagi menjadi langkah-langkah kecil yang terfokus, seperti yang ditunjukkan dalam contoh berikut:
  Create a pipeline with the following steps:
  1. Extract data from the ecomm.orders table.
  2. Join the extracted data with the marts.customers table on customer_id.
  3. Load the final result into the reporting.customer_orders table.
Sempurnakan dan lakukan iterasi. Terus coba berbagai frasa dan pendekatan untuk melihat mana yang memberikan hasil terbaik. Jika agen menghasilkan SQL yang tidak valid atau kesalahan lainnya, pandu agen dengan contoh atau dokumentasi publik.
  The previous query was incorrect because it removed the timestamp. Please
  correct the SQL. Use the TIMESTAMP_TRUNC function to truncate the
  event_timestamp to the nearest hour, instead of casting it as a DATE. For
  example: TIMESTAMP_TRUNC(event_timestamp, HOUR).