


En este documento, se describe una arquitectura de referencia que te ayuda a crear un mecanismo de exportación de registros listo para producción, escalable y tolerante a errores que transmite registros y eventos de tus recursos en Google Cloud a Splunk. Splunk es una herramienta de análisis popular que ofrece una plataforma unificada de seguridad y observabilidad. De hecho, puedes exportar los datos de registro a Splunk Enterprise o a Splunk Cloud Platform. Si eres administrador, también puedes usar esta arquitectura para operaciones de TI o casos de uso de seguridad.
En esta arquitectura de referencia, se da por sentado que una jerarquía de recursos es similar al siguiente diagrama. Todos los Google Cloud registros de recursos de los niveles de organización, carpeta y proyecto se recopilan en un receptor agregado. Luego, el receptor agregado envía estos registros a una canalización de exportación de registros, que los procesa y los exporta a Splunk.

Arquitectura
En el siguiente diagrama, se muestra la arquitectura de referencia que debes usar cuando implementas esta solución. En este diagrama, se muestra cómo fluyen los datos de registro de Google Cloud a Splunk.

Esta arquitectura incluye los siguientes componentes:
- Cloud Logging: Para iniciar el proceso, Cloud Logging recopila los registros en un receptor de registros agregado a nivel de la organización y envía los registros a Pub/Sub.
- Pub/Sub: Luego, el servicio de Pub/Sub crea un solo tema y una sola suscripción para los registros, y reenvía los registros a la canalización principal de Dataflow.
- Dataflow: Esta arquitectura de referencia incluye dos canalizaciones de Dataflow:
- Canalización principal de Dataflow: En el centro del proceso, la canalización principal de Dataflow es una canalización de transmisión de Pub/Sub a Splunk que extrae registros de la suscripción a Pub/Sub y los envía a Splunk.
- Canalización secundaria de Dataflow: Paralela a la canalización de Dataflow principal, la canalización de Dataflow secundaria es una canalización de transmisión de Pub/Sub a Pub/Sub para volver a reproducir mensajes si falla una entrega.
- Splunk: Al final del proceso, Splunk Enterprise o Splunk Cloud Platform actúan como un recopilador de eventos HTTP (HEC) y reciben los registros para un análisis más detallado. Puedes implementar Splunk de forma local, en Google Cloud como SaaS o a través de un enfoque híbrido.
Caso de uso
Esta arquitectura de referencia usa un enfoque basado en la nube y en la transmisión. En este método basado en envíos, usas la plantilla de Dataflow de Pub/Sub a Splunk para transmitir registros a un recopilador de eventos HTTP de Splunk (HEC). La arquitectura de referencia también se analiza la planificación de la capacidad de canalización de Dataflow y cómo manejar las posibles fallas de entrega cuando hay problemas transitorios de las redes o de los servidores.
Si bien esta arquitectura de referencia se enfoca en los registros de Google Cloud , se puede usar la misma arquitectura para exportar otros datos de Google Cloud , como los cambios de recursos en tiempo real y los hallazgos de seguridad. Si integras los registros de Cloud Logging, puedes continuar usando los servicios de socios existentes, como Splunk, como solución de estadísticas de registros unificada.
El método basado en envíos para transmitir datos de Google Cloud a Splunk tiene las siguientes ventajas:
- Servicio administrado. Como servicio administrado, Dataflow mantiene los recursos necesarios en Google Cloud para las tareas de procesamiento de datos, como la exportación de registros.
- Carga de trabajo distribuida. Este método te permite distribuir cargas de trabajo entre varios trabajadores para el procesamiento paralelo, por lo que no hay un solo punto de falla.
- Seguridad. Debido a que Google Cloud envía tus datos a Splunk HEC, no hay ninguna carga de mantenimiento y seguridad asociada con la creación y administración de claves de cuentas de servicio.
- Ajuste de escala automático. El servicio de Dataflow ajusta de forma automática la cantidad de trabajadores en respuesta a las variaciones en el volumen de registros entrante y en las tareas pendientes.
- Tolerancia a errores. Si hay problemas transitorios del servidor o de la red, el método basado en la transmisión automática intenta volver a enviar los datos al HEC de Splunk de forma automática. También admite temas no procesados (también conocidos como temas de mensajes no entregados) para cualquier mensaje de registro que no se pueda entregar para evitar la pérdida de datos.
- Simplicidad. Evitas la sobrecarga de administración y el costo de ejecutar uno o más reenviadores pesados en Splunk.
Esta arquitectura de referencia se aplica a empresas en muchas industrias verticales, incluidas las reguladas, como los servicios farmacéuticos y financieros. Cuando eliges exportar tus datos de Google Cloud a Splunk, puedes hacerlo por los siguientes motivos:
- Análisis empresariales
- Operaciones de TI
- Supervisión del rendimiento de las aplicaciones
- Operaciones de seguridad
- Cumplimiento
Alternativas de diseño
Un método alternativo para exportar registros a Splunk es extraerlos deGoogle Cloud. En este método basado en extracciones, debes usar las APIs de Google Cloud para recuperar los datos a través del complemento de Splunk para Google Cloud. Puedes elegir usar el método basado en extracción en las siguientes situaciones:
- Tu implementación de Splunk no ofrece un extremo de HEC de Splunk.
- Tu volumen de registros es bajo.
- Deseas exportar y analizar métricas de Cloud Monitoring, objetos de Cloud Storage, metadatos de la API de Cloud Resource Manager, datos de Facturación de Cloud o registros de bajo volumen.
- Ya administras uno o más reenviadores pesados en Splunk.
- Usas el administrador de datos de entradas alojado para Splunk Cloud.
Además, ten en cuenta las consideraciones adicionales que surgen cuando usas este método basado en la extracción:
- Un solo trabajador controla la carga de trabajo de la transferencia de datos, que no ofrece capacidades de ajuste automático de escala.
- En Splunk, el uso de un reenviador pesado para extraer datos puede provocar un único punto de falla.
- El método basado en extracción requiere que crees y administres las claves de la cuenta de servicio que usas para configurar el complemento de Splunk para Google Cloud.
Antes de usar el complemento de Splunk, las entradas de registro primero deben enrutarse a Pub/Sub con un receptor de registros. Para crear un receptor de registros con un tema de Pub/Sub como destino, consulta cómo crear un receptor.
Asegúrate de otorgar el rol de publicador de Pub/Sub (roles/pubsub.publisher) a la identidad de escritor del receptor en ese destino del tema de Pub/Sub. Para obtener más
información sobre cómo configurar los permisos de destino del receptor, consulta
Establece permisos de destino.
Para habilitar el complemento de Splunk, sigue estos pasos:
- En Splunk, sigue las instrucciones de Splunk para instalar el complemento de Splunk para Google Cloud.
- Crea una suscripción de extracción de Pub/Sub para el tema de Pub/Sub al que se enrutan los registros, si aún no tienes una.
- Crea una cuenta de servicio.
- Crea una clave de cuenta de servicio para la cuenta de servicio que acabas de crear.
- Otorga los roles de visualizador de Pub/Sub (
roles/pubsub.viewer) y suscriptor de Pub/Sub (roles/pubsub.subscriber) a la cuenta de servicio para permitir que la cuenta reciba mensajes de la suscripción a Pub/Sub. En Splunk, sigue las instrucciones de Splunk para configurar una entrada de Pub/Sub nueva en el complemento de Splunk para Google Cloud.
Los mensajes de Pub/Sub de la exportación de registros aparecen en Splunk.
Para verificar que el complemento funcione, sigue estos pasos:
- En Cloud Monitoring, abre el Explorador de métricas.
- En el menú Recursos, selecciona
pubsub_subscription. - En las categorías de Métrica, selecciona
pubsub/subscription/pull_message_operation_count. - Supervisa la cantidad de operaciones de extracción de mensajes durante uno o dos minutos.
Consideraciones del diseño
Los siguientes lineamientos pueden ayudarte a desarrollar una arquitectura que cumpla con los requisitos de seguridad, privacidad, cumplimiento, eficiencia operativa, confiabilidad, tolerancia a errores, rendimiento y optimización de costos de la organización.
Security, privacy, and compliance
En las siguientes secciones, se describen las consideraciones de seguridad para esta arquitectura de referencia:
- Usa direcciones IP privadas para proteger las VMs que admiten la canalización de Dataflow
- Habilite el Acceso privado a Google
- Restringe el tráfico de entrada de HEC de Splunk a las direcciones IP conocidas que usa Cloud NAT
- Almacena el token HEC de Splunk en Secret Manager
- Crea una cuenta de servicio de trabajador personalizada de Dataflow para seguir las prácticas recomendadas sobre privilegios mínimos
- Configura la validación SSL para un certificado de la AC raíz interno si usas una CA privada
Usa direcciones IP privadas para proteger las VMs que admiten la canalización de Dataflow
Debes restringir el acceso a las VMs de trabajador que se usan en la canalización de Dataflow. Para restringir el acceso, implementa estas VMs con direcciones IP privadas. Sin embargo, estas VMs también deben poder usar HTTPS para transmitir los registros exportados a Splunk y acceder a Internet. Para proporcionar este acceso HTTPS, necesitas una puerta de enlace de Cloud NAT que asigne automáticamente direcciones IP de Cloud NAT a las VMs que las necesitan. Asegúrate de asignar la subred que contiene las VMs a la puerta de enlace de Cloud NAT.
Habilite el Acceso privado a Google
Cuando creas una puerta de enlace de Cloud NAT, el Acceso privado a Google se habilita de forma automática. Sin embargo, para permitir que los trabajadores de Dataflow con direcciones IP privadas accedan a las direcciones IP externas que usan las APIs y los servicios de Google Cloud, también debes habilitar de forma manual el Acceso privado a Google para la subred.
Restringe el tráfico de entrada de HEC de Splunk a las direcciones IP conocidas que usa Cloud NAT
Si deseas restringir el tráfico de HEC de Splunk a un subconjunto de direcciones IP conocidas, puedes reservar direcciones IP estáticas y asignarlas manualmente a la puerta de enlace de Cloud NAT. Según tu implementación de Splunk, puedes configurar las reglas de firewall de entrada de HEC de Splunk con estas direcciones IP estáticas. Para obtener más información sobre Cloud NAT, consulta Configura y administra la traducción de direcciones de red con Cloud NAT.
Almacena el token HEC de Splunk en Secret Manager
Cuando implementas la canalización de Dataflow, puedes pasar el valor del token de una de las siguientes maneras:
- Texto simple
- Texto cifrado encriptado con una clave de Cloud Key Management Service
- Versión del Secret encriptada y administrada por Secret Manager
En esta arquitectura de referencia, usarás la opción de Secret Manager, ya que ofrece la forma menos compleja y más eficiente de proteger tu token de HEC de Splunk. Esta opción también evita la filtración del token de HEC de Splunk desde la consola de Dataflow o los detalles del trabajo.
Un Secret de Secret Manager contiene una colección de versiones de Secrets. Cada versión de Secret almacena los datos reales del Secret, como el token de HEC de Splunk. Si luego eliges rotar tu token de HEC de Splunk como una medida de seguridad adicional, puedes agregar el token nuevo como una versión nueva del secreto a este secreto. Para obtener información general sobre la rotación de secretos, consulta Acerca de los programas de rotación.
Crea una cuenta de servicio de trabajador personalizada de Dataflow para seguir las prácticas recomendadas privilegio mínimo
Los trabajadores de la canalización de Dataflow usan la cuenta de servicio de trabajador de Dataflow para acceder a los recursos y ejecutar operaciones. De forma predeterminada, los trabajadores usan la cuenta de servicio predeterminada de Compute Engine del proyecto como la cuenta de servicio del trabajador, lo que les otorga permisos amplios para todos los recursos del proyecto. Sin embargo, para ejecutar trabajos de Dataflow en producción, te recomendamos que crees una cuenta de servicio personalizada con un conjunto mínimo de roles y permisos. Luego, puedes asignar esta cuenta de servicio personalizada a los trabajadores de tu canalización de Dataflow.
En el siguiente diagrama, se enumeran los roles obligatorios que debes asignar a una cuenta de servicio para permitir que los trabajadores de Dataflow ejecuten un trabajo de Dataflow correctamente.
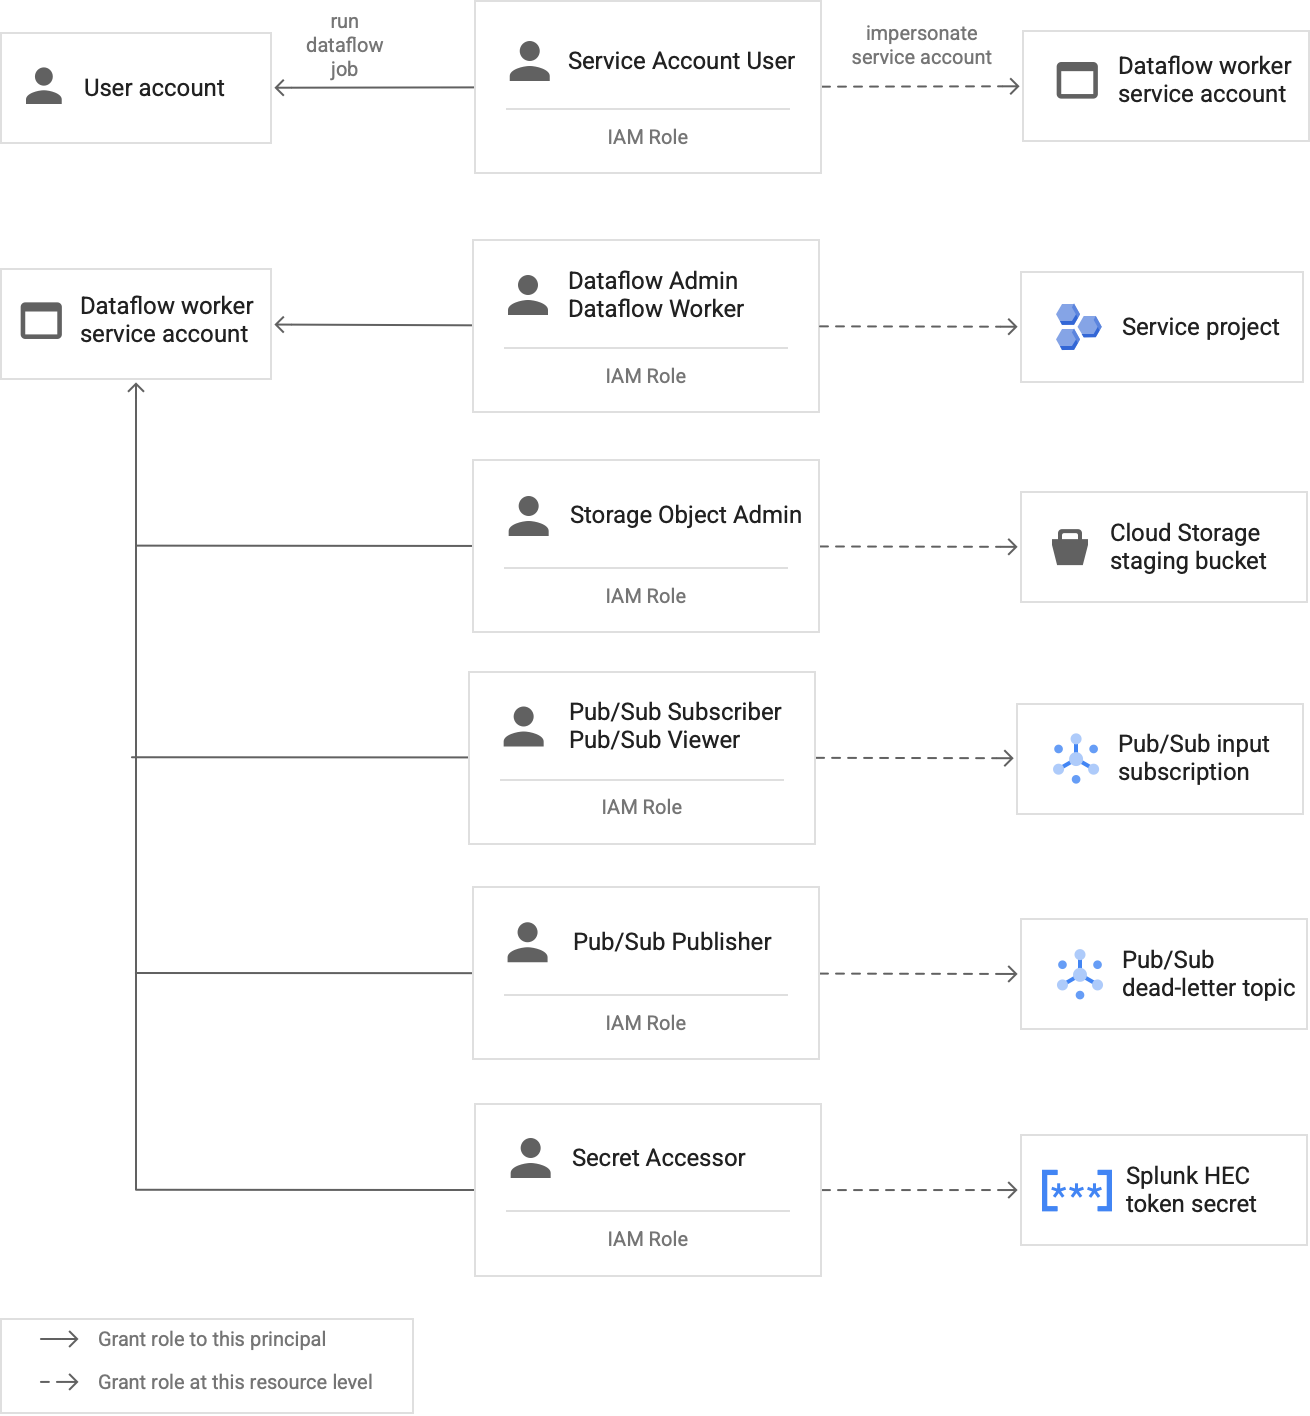
Como se muestra en el diagrama, debes asignar los siguientes roles a la cuenta de servicio para tu trabajador de Dataflow:
- Administrador de Dataflow
- Trabajador de Dataflow
- Administrador de objetos de Storage
- Suscriptor de Pub/Sub
- Visualizador de Pub/Sub
- Publicador de Pub/Sub
- Descriptor de acceso a secretos
Configura la validación SSL con un certificado de CA raíz interno si usas una CA privada
De forma predeterminada, la canalización de Dataflow usa el almacén de confianza predeterminado del trabajador de Dataflow para validar el certificado SSL para el extremo del HEC de Splunk. Si usas una autoridad certificadora (CA) privada para firmar un certificado SSL que usa el extremo del HEC de Splunk, puedes importar tu certificado de CA raíz interno al almacén de confianza. Luego, los trabajadores de Dataflow pueden usar el certificado importado para la validación del certificado SSL.
Puedes usar e importar tu propio certificado de CA raíz para las implementaciones de Splunk con certificados autofirmados o firmados de forma privada. También puedes inhabilitar por completo la validación de SSL solo para fines internos de desarrollo y pruebas. Este método de CA raíz interna funciona mejor para las implementaciones internas de Splunk que no están orientadas a Internet.
Para obtener más información, consulta los parámetros de la plantilla de Pub/Sub a Splunk Dataflow
rootCaCertificatePath y disableCertificateValidation.
Eficiencia operativa
En las secciones siguientes, se describen las consideraciones de eficiencia operativa para esta arquitectura de referencia:
Usa UDF para transformar registros o eventos en tránsito
La plantilla de Pub/Sub a Splunk Dataflow admite funciones definidas por el usuario (UDF) para la transformación personalizada de eventos. Los casos de uso de ejemplo incluyen enriquecer registros con campos adicionales, ocultar algunos campos sensibles o filtrar registros no deseados. UDF te permite cambiar el formato de salida de la canalización de Dataflow sin tener que volver a compilar ni mantener el código de la plantilla. Esta arquitectura de referencia usa una UDF para controlar los mensajes que la canalización no puede entregar a Splunk.
Vuelve a reproducir mensajes no procesados
En ocasiones, la canalización recibe errores de entrega y no intenta volver a entregar el mensaje. En este caso, Dataflow envía estos mensajes no procesados a un tema no procesado, como se muestra en el siguiente diagrama. Después de corregir la causa raíz de la falla de entrega, puedes volver a reproducir los mensajes no procesados.
En los siguientes pasos, se describe el proceso que se muestra en el diagrama anterior:
- La canalización de entrega principal de Pub/Sub a Splunk reenvía automáticamente los mensajes que no se pueden entregar al tema sin procesar para que el usuario los investigue.
El operador o el ingeniero de confiabilidad de sitios (SRE) investiga los mensajes con errores en la suscripción sin procesar. El operador soluciona los problemas y corrige la causa raíz de la falla de entrega. Por ejemplo, corregir una configuración incorrecta del token de HEC podría permitir que se entreguen los mensajes.
El operador activa la canalización de reproducción de mensajes con errores. Esta canalización de Pub/Sub a Pub/Sub (destacada en la sección punteada del diagrama anterior) es una canalización temporal que mueve los mensajes con errores de la suscripción no procesada al tema del receptor de registros original.
La canalización principal de entrega vuelve a procesar los mensajes con errores anteriores. Este paso requiere que la canalización use una UDF para la detección y decodificación correctas de las cargas útiles de mensajes con errores. El siguiente código es una función de ejemplo que implementa esta lógica de decodificación condicional, incluido un recuento de intentos de entrega con fines de seguimiento:
// If the message has already been converted to a Splunk HEC object
// with a stringified obj.event JSON payload, then it's a replay of
// a previously failed delivery.
// Unnest and parse the obj.event. Drop the previously injected
// obj.attributes such as errorMessage and timestamp
if (obj.event) {
 try {
   event = JSON.parse(obj.event);
   redelivery = true;
 } catch(e) {
   event = obj;
 }
} else {
 event = obj;
}

// Keep a tally of delivery attempts
event.delivery_attempt = event.delivery_attempt || 1;
if (redelivery) {
 event.delivery_attempt += 1;
}
Confiabilidad y tolerancia a errores
En cuanto a la confiabilidad y la tolerancia a errores, la siguiente tabla, Tabla 1, enumera algunos posibles errores de entrega de Splunk. En la tabla, también se enumeran los
atributos de errorMessage correspondientes que la canalización registra con cada
mensaje antes de reenviarlos al tema sin procesar.
Tabla 1: Tipos de errores de entrega de Splunk
| Tipo de error de entrega | ¿La canalización se reintenta de forma automática? | Atributo de ejemplo errorMessage |
|---|---|---|
Error de red transitorio |
Sí |
o
|
Error 5xx del servidor de Splunk |
Sí |
|
Error 4xx del servidor de Splunk |
No |
|
El servidor de Splunk está fuera de servicio |
No |
|
El certificado SSL de Splunk no es válido |
No. |
|
Error de sintaxis de JavaScript en la función definida por el usuario (UDF) |
No |
|
En algunos casos, la canalización aplica
la retirada exponencial y,
de forma automática, intenta volver a entregar el mensaje. Por ejemplo, cuando el servidor de Splunk genera un código de error 5xx, la canalización debe volver a entregar el mensaje. Estos códigos de error se producen cuando el extremo de HEC de Splunk está sobrecargado.
También podría haber un problema persistente que impida que se envíe un mensaje al extremo de HEC. En el caso de estos problemas persistentes, la canalización no intenta volver a entregar el mensaje. A continuación, se muestran ejemplos de problemas persistentes:
- Un error de sintaxis en la función UDF.
- Un token de HEC no válido que hace que el servidor de Splunk genere una respuesta de servidor “Prohibido”
4xx.
Rendimiento y optimización de costos
Con respecto al rendimiento y la optimización de costos, debes determinar el tamaño máximo y la capacidad de procesamiento de tu canalización de Dataflow. Debes calcular el valor correcto y los valores de capacidad de procesamiento para que tu canalización pueda controlar el volumen máximo de registros diarios (GB por día) y la tasa de mensajes de registro (eventos por segundo, o EPS) desde la suscripción Pub/Sub ascendente.
Debes seleccionar los valores de tamaño y capacidad de procesamiento para que el sistema no incurra en ninguno de los siguientes problemas:
- Retrasos causados por la acumulación o la limitación de mensajes.
- Costos adicionales por el aprovisionamiento excesivo de una canalización
Después de realizar los cálculos de tamaño y capacidad de procesamiento, puedes usar los resultados para configurar una canalización óptima que equilibre el rendimiento y el costo. Para configurar la capacidad de tu canalización, usa los siguientes parámetros:
- Las marcas Tipo de máquina y Cantidad de máquinas son parte del comando de gcloud que implementa el trabajo de Dataflow. Estas marcas te permiten definir el tipo y la cantidad de VMs que se usarán.
- Los parámetros Paralelismo y Recuento de lotes forman parte de la plantilla de Dataflow de Pub/Sub a Splunk. Estos parámetros son importantes para aumentar los EPS y, al mismo tiempo, evitar sobrecargar el extremo de HEC de Splunk.
En las siguientes secciones, se explican estos parámetros de configuración. Cuando corresponda, en estas secciones también se proporcionan fórmulas y cálculos de ejemplo que usan cada fórmula. Estos ejemplos de cálculos y valores resultantes suponen una organización con las siguientes características:
- Genera 1 TB de registros por día.
- Tiene un tamaño promedio de mensajes de 1 KB.
- Tiene una tasa de mensajes máxima y constante dos veces la tasa promedio.
Debido a que tu entorno de Dataflow es único, sustituye los valores de ejemplo por los de tu propia organización a medida que avanzas por los pasos.
Tipo de máquina
Práctica recomendada: Configura la
marca --worker-machine-type como n2-standard-4 para
seleccionar un tamaño de máquina que proporcione la mejor relación entre rendimiento y costo.
Debido a que el tipo de máquina n2-standard-4 puede manejar 12,000 EPS, te recomendamos que uses este tipo de máquina como modelo de referencia para todos los trabajadores de Dataflow.
Para esta arquitectura de referencia, establece la marca --worker-machine-type en un valor de n2-standard-4.
Cantidad de máquinas
Práctica recomendada: Configura la marca --max-workers para controlar la cantidad máxima de trabajadores necesarios para controlar los EPS esperados.
El ajuste de escala automático de Dataflow permite que el servicio cambie de forma adaptable la cantidad de trabajadores que se usan para ejecutar la canalización de transmisión cuando hay cambios en el uso de recursos y la carga. Para evitar el aprovisionamiento excesivo durante el ajuste de escala automático, te
recomendamos que definas siempre la cantidad máxima de máquinas virtuales que se
usan como trabajadores de Dataflow. Debes definir la cantidad máxima de
máquinas virtuales con la marca --max-workers cuando implementas la
canalización de Dataflow.
Para quitar el almacenamiento del estado de la canalización de las VMs de trabajador y reducir los costos de almacenamiento, usa Streaming Engine de Dataflow. Para habilitar Streaming Engine de Dataflow en tu proyecto, configura
la marca --enableStreamingEngine.
Para determinar la cantidad máxima de trabajadores que necesitas para tu canalización, usa las siguientes fórmulas en secuencia:
Determina el promedio de eventos por segundo (EPS) con la siguiente fórmula:
\( {AverageEventsPerSecond}\simeq\frac{TotalDailyLogsInTB}{AverageMessageSizeInKB}\times\frac{10^9}{24\times3600} \)Cálculo de ejemplo: Dados los valores de ejemplo de 1 TB de registros por día con un tamaño de mensaje promedio de 1 KB, esta fórmula genera un valor EPS promedio de 11.5 KB de EPS.
Determina los EPS máximos sostenidos con la siguiente fórmula, en la que el multiplicador N representa la naturaleza de ráfagas del registro:
\( {PeakEventsPerSecond = N \times\ AverageEventsPerSecond} \)Cálculo de ejemplo: Con un valor de ejemplo de N=2 y un valor promedio de EPS de 11.5k que calculaste en el paso anterior, esta fórmula genera un valor máximo de EPS continuo de 23,000 EPS.
Determina la cantidad máxima requerida de CPU virtuales con la siguiente fórmula:
\( {maxCPUs = ⌈PeakEventsPerSecond / 3k ⌉} \)Cálculo de ejemplo: Con el valor máximo de EPS continuo de 23 000 que calculaste en el paso anterior, esta fórmula genera un máximo de ⌈23 000 / 3⌉ = 8 núcleos de CPU virtuales.
Determina la cantidad máxima de trabajadores de Dataflow con la siguiente fórmula:
\( maxNumWorkers = ⌈maxCPUs / 4 ⌉ \)Ejemplo de cálculo: Con el valor máximo de CPUs virtuales de ejemplo de 8 que se calculó en el paso anterior, esta fórmula [8/4] genera un número máximo de 2 para un
n2-standard-4tipo de máquina.
En este ejemplo, establecerías la marca --max-workers en un valor de 2
según el conjunto anterior de cálculos de ejemplo. Sin embargo, recuerda usar tus propios valores y cálculos únicos cuando implementes esta arquitectura de referencia en tu entorno.
Paralelismo
Práctica recomendada: Configura el parámetro parallelism en la plantilla de Pub/Sub a Splunk Dataflow para que sea el doble de la cantidad de CPUs virtuales que usa la cantidad máxima de trabajadores de Dataflow.
El parámetro parallelism ayuda a maximizar la cantidad de conexiones de HEC de Splunk
paralelas, lo que, a su vez, maximiza la tasa de EPS de tu canalización.
El valor predeterminado de parallelism de 1 inhabilita el paralelismo y limita la
tasa de salida. Debes anular este parámetro de configuración predeterminado para tener en cuenta de 2 a 4 conexiones paralelas por CPU virtual, con la cantidad máxima de trabajadores implementados. Como regla general, para calcular el valor de anulación de este parámetro de configuración, multiplica la cantidad máxima de trabajadores de Dataflow por la cantidad de CPU virtuales por trabajador y, luego, duplica este valor.
Para determinar la cantidad total de conexiones paralelas al HEC de Splunk en todos los trabajadores de Dataflow, usa la siguiente fórmula:
Cálculo de ejemplo: con el ejemplo de CPUs virtuales de 8 que se calculó antes para el recuento de máquinas, esta fórmula genera la cantidad de conexiones paralelas para que sean 8 x 2 = 16.
En este ejemplo, establecerías el parámetro parallelism en un valor de 16
según el cálculo del ejemplo anterior. Sin embargo, recuerda usar tus propios valores y cálculos únicos cuando implementes esta arquitectura de referencia en tu entorno.
Recuento de lotes
Práctica recomendada: Para permitir que el HEC de Splunk procese eventos en lotes en lugar de uno a la vez, establece el parámetro batchCount en un valor entre 10 y 50 eventos o solicitudes para registros
Configurar el recuento de lotes ayuda a aumentar los EPS y reducir la carga en el
extremo de HEC de Splunk. Este parámetro combina varios eventos en un solo lote
para un procesamiento más eficiente. Te recomendamos que configures el parámetro batchCount
en un valor entre 10 y 50 eventos o solicitudes para registros, siempre que el retraso máximo
de almacenamiento en búfer de dos segundos sea aceptable.
Debido a que el tamaño promedio del mensaje de registro es de 1 KB en este ejemplo, te recomendamos que agrupes al menos 10 eventos por solicitud. Para este ejemplo, establecerías el parámetro batchCount en un valor de 10. Sin embargo, recuerda usar tus propios
valores y cálculos únicos cuando implementes esta arquitectura de referencia en
tu entorno.
Para obtener más información sobre estas recomendaciones de optimización del rendimiento y los costos, consulta Planifica tu canalización de Dataflow.
¿Qué sigue?
- Para obtener una lista completa de los parámetros de la plantilla de Dataflow de Pub/Sub a Splunk, consulta la documentación de Dataflow de Pub/Sub a Splunk.
- Para que las plantillas de Terraform correspondientes te ayuden a implementar esta
arquitectura de referencia, consulta el
repositorio de GitHub
terraform-splunk-log-export. Incluye un panel de Cloud Monitoring precompilado para supervisar tu canalización de Dataflow de Splunk. - Para obtener más información sobre las métricas personalizadas y el registro de Dataflow de Splunk para ayudarte a supervisar y solucionar problemas de las canalizaciones de Dataflow de Splunk, consulta este blog Nuevas funciones de observabilidad para las canalizaciones de transmisión de Splunk Dataflow.
- Para obtener más información sobre las arquitecturas de referencia, los diagramas y las prácticas recomendadas, explora Cloud Architecture Center.