


In diesem Dokument wird eine Referenzarchitektur vorgestellt, mit der Sie die Infrastruktur für eine generative KI-Anwendung mit Retrieval Augmented Generation (RAG) mithilfe von Gemini Enterprise und der Gemini Enterprise Agent Platform entwerfen können. In dieser Referenzarchitektur wird gezeigt, wie Sie verwaltete Dienste verwenden und einen einzelnen KI-Agenten bereitstellen, um einen End-to-End-RAG-Datenfluss zu ermöglichen. Gemini Enterprise dient als einheitliche Plattform für die Orchestrierung von KI-Agenten im gesamten Unternehmen. Die Agent Platform beschleunigt die Entwicklung und Bereitstellung benutzerdefinierter Agenten und bietet verwaltete Datenspeicher, um das effiziente Abrufen für RAG zu erleichtern.
Dieses Dokument richtet sich an Architekten, Entwickler und Administratoren von generativen KI-Anwendungen. In diesem Dokument werden grundlegende Kenntnisse der Konzepte von KI, maschinellem Lernen (ML) und Large Language Model (LLM) vorausgesetzt. Dieses Dokument bietet keine Anleitung zum Entwerfen und Entwickeln einer generativen KI-Anwendung. Informationen zum Entwerfen einer Anwendung finden Sie unter Generative KI-Anwendung entwickeln.
Architektur
Das folgende Diagramm zeigt eine allgemeine Ansicht der Architektur, die in diesem Dokument vorgestellt wird:

Die Architektur im vorherigen Diagramm besteht aus zwei Subsystemen: Datenaufnahme und Bereitstellung.
- Das Subsystem für die Datenaufnahme nimmt Daten aus externen Quellen auf und bereitet sie für die Verwendung in RAG vor. Das Subsystem generiert Einbettungen für die aufgenommenen Daten und verwendet sie, um einen durchsuchbaren Vektorindex in einem verwalteten Datenspeicher zu erstellen und zu verwalten.
- Das Subsystem für die Bereitstellung enthält die Frontend- und Backend-Dienste der generativen KI-Anwendung.
- Der Frontend-Dienst verarbeitet den Anfrage-Antwort-Fluss mit Anwendungsnutzern und leitet Anfragen an den Backend-Dienst weiter.
- Der Backend-Dienst verwendet Gemini Enterprise und die Agent Platform, um Ihren KI-Agenten zu erstellen und bereitzustellen, der den RAG-Prozess orchestriert. Bei diesem Prozess werden die indexierten Vektordaten verwendet, um Antworten zu generieren, die kontextbezogen sind und den Sicherheitsfiltern für Responsible AI entsprechen.
Im folgenden Diagramm sehen Sie eine detaillierte Ansicht der Architektur:
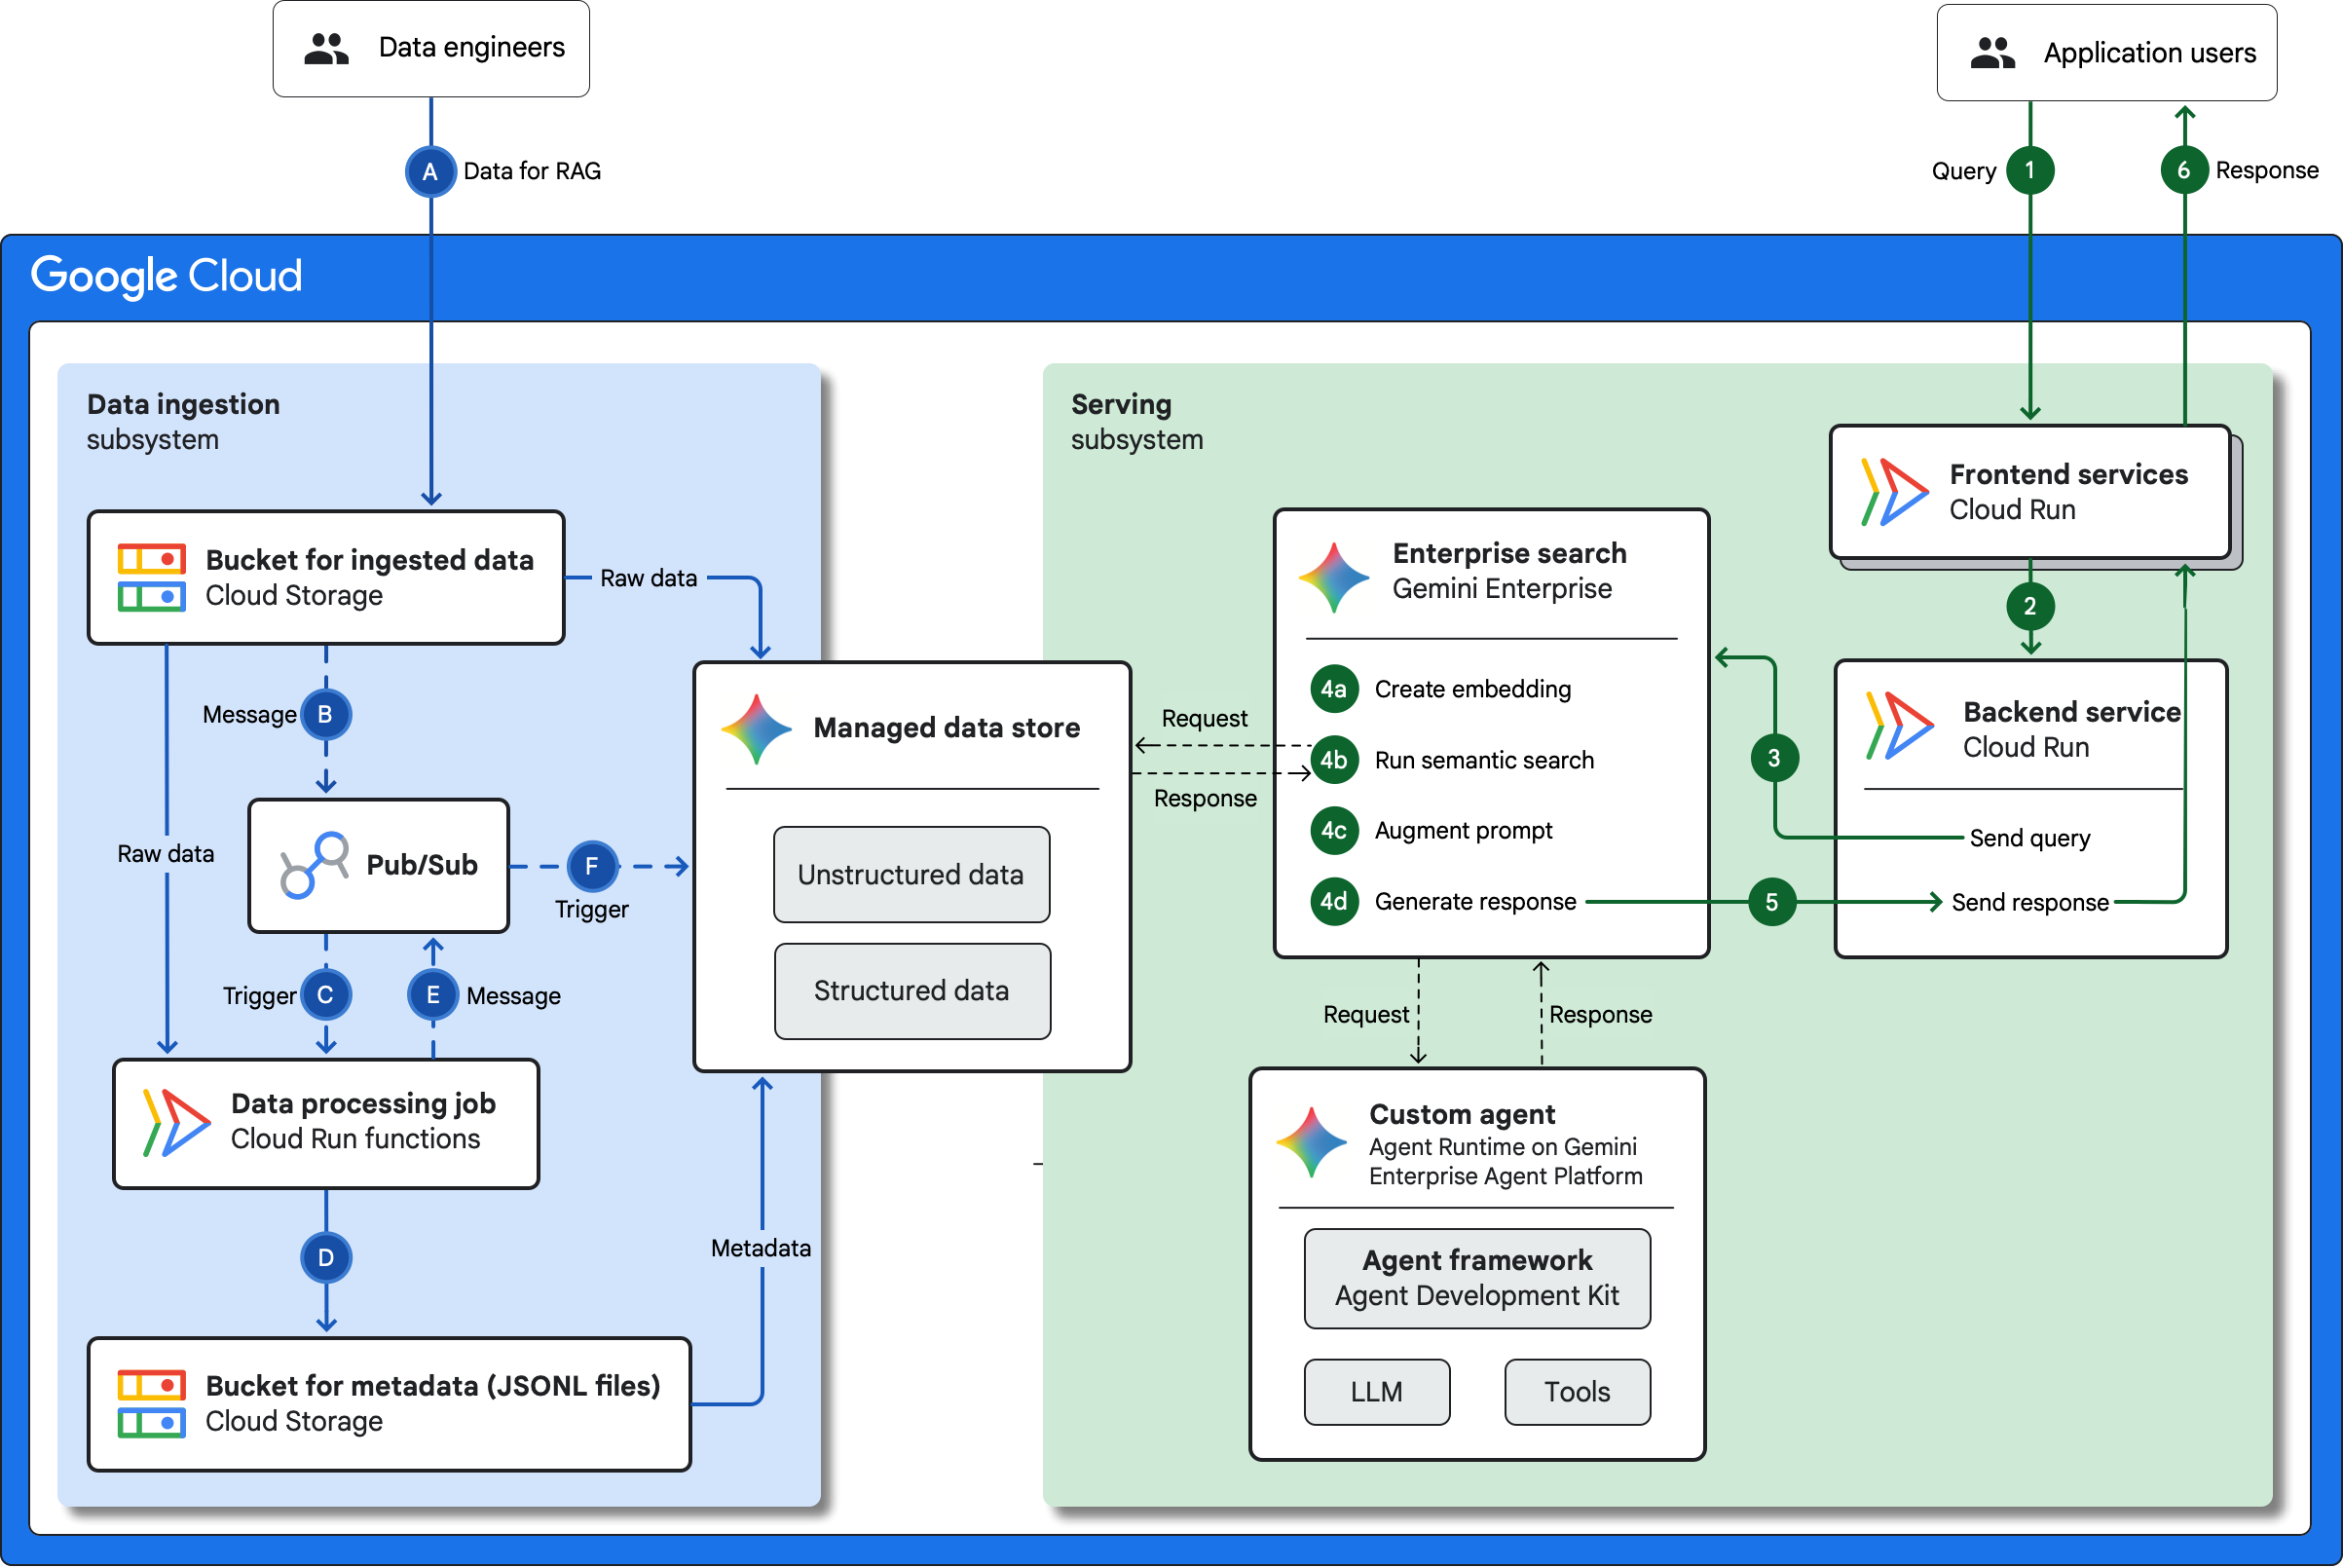
In den folgenden Abschnitten wird der Datenfluss in jedem Subsystem des vorherigen Architekturdiagramms beschrieben.
Subsystem für die Datenaufnahme
Das Subsystem für die Datenaufnahme nimmt Daten aus externen Quellen auf und bereitet sie für RAG vor. Folgende Schritte sind im Ablauf der Datenaufnahme und -vorbereitung erforderlich:
- Data Engineers laden Daten aus externen Quellen in einen Cloud Storage-Bucket hoch. Die externen Quellen können Anwendungen, Datenbanken oder Streamingdienste sein.
- Nach Abschluss veröffentlicht Cloud Storage eine Nachricht in einem Pub/Sub-Thema.
- Das Pub/Sub-Thema löst einen Verarbeitungsjob aus, der in Cloud Run Functions ausgeführt wird.
- Cloud Run Functions verarbeitet die Rohdaten, indem die Metadaten als JSON Lines-Dateien (JSONL) generiert und gespeichert werden. Die JSONL-Dateien werden in einem separaten Cloud Storage-Bucket gespeichert.
- Nach Abschluss veröffentlicht Cloud Run Functions eine Nachricht in einem Pub/Sub-Thema.
- Das Pub/Sub-Thema löst eine nachgelagerte Cloud Run-Funktion aus, die die Methode
documents.importder Discovery Engine API aufruft, um einen Importjob im verwalteten Datenspeicher in Gemini Enterprise zu starten. Der Importjob ruft die aufgenommenen Rohdaten und Metadaten aus den Cloud Storage-Buckets ab und parst und zerlegt die Daten für einen effizienten Abruf während der Bereitstellung. Gemini Enterprise generiert automatisch Vektoreinbettungen, ohne dass eine Konfiguration erforderlich ist.
Subsystem für die Bereitstellung
Das Subsystem für die Bereitstellung verarbeitet den Anfrage-Antwort-Fluss zwischen der generativen KI-Anwendung und ihren Nutzern. Folgende Schritte sind im Bereitstellungsablauf erforderlich:
- Ein Anwendungsnutzer sendet eine Abfrage über einen der Cloud Run-Frontend-Dienste. Sie können diese Dienste für verschiedene Anwendungsfälle anpassen, z. B. für eine Chatbot-Benutzeroberfläche, eine Suchseite oder eine mobile Anwendung.
- Der Frontend-Dienst empfängt die Abfrage und leitet sie an einen zentralen Cloud Run-Backend-Dienst weiter. Dieses Backend bietet einen einzigen, einheitlichen Endpunkt, der alle verschiedenen Frontend-Clients unterstützt. Der Backend-Dienst führt auch die erforderliche Vorverarbeitung durch, die das Erstellen von Filtern für die Suchanfrage umfassen kann. Bei diesem Ansatz bleibt die Logik für die Front-Ends transparent.
- Der Backend-Dienst sendet die vorbereitete Anfrage an Gemini Enterprise. Dazu wird der Gemini Enterprise API-Endpunkt verwendet, um den RAG-Workflow zu starten.
- Zur Verarbeitung der Abfrage verwendet Gemini Enterprise die Enterprise-Suche und den benutzerdefinierten Agenten, um die folgenden Aufgaben auszuführen:
- Erstellen Sie eine Einbettung der Nutzeranfrage.
- Führen Sie eine semantische Suche in den indexierten Daten im verwalteten Datenspeicher durch, um die relevantesten Informationen zu finden.
- Ergänzen Sie die ursprüngliche Abfrage mit den abgerufenen Daten aus dem verwalteten Datenspeicher, um einen detaillierten, kontextbezogenen Prompt zu erstellen.
- Generieren Sie eine endgültige Antwort basierend auf dem erweiterten Prompt.
- Gemini Enterprise sendet die generierte Antwort an den Cloud Run-Backend-Dienst.
- Der Backend-Dienst gibt die endgültige Antwort an den Frontend-Dienst zurück, der die ursprüngliche Anfrage gesendet hat. Der Frontend-Dienst präsentiert dem Anwendungsnutzer die Antwort.
Verwendete Produkte
In dieser Referenzarchitektur werden die folgenden Produkte von Google Cloud verwendet:
- Gemini Enterprise: Eine vollständig verwaltete, sichere Plattform zum Bereitstellen und Verwalten von KI-Agenten in einem Unternehmen.
- Gemini Enterprise Agent Platform: Eine umfassende Plattform, mit der Sie KI-Agenten auf Unternehmensniveau erstellen, skalieren, verwalten und optimieren können.
- Agent Runtime auf der Gemini Enterprise Agent Platform: Eine Plattform, mit der Sie KI-Agenten in der Produktion ausführen, verwalten und skalieren können.
- Cloud Run ist eine serverlose Computing-Plattform, mit der Sie Container direkt auf der skalierbaren Infrastruktur von Google ausführen können.
- Cloud Run Functions: Eine serverlose Computing-Plattform, mit der Sie zweckgebundene Funktionen direkt in Google Cloudausführen können.
- Pub/Sub: Ein asynchroner, skalierbarer Messaging-Dienst, der Dienste entkoppelt, die Nachrichten von Diensten erzeugen, die diese Nachrichten verarbeiten.
- Cloud Storage: Ein kostengünstiger, unbegrenzter Objektspeicher für verschiedene Datentypen. Auf Daten kann von innerhalb und außerhalb von Google Cloudzugegriffen werden. Sie werden zu Redundanzzwecken über Standorte hinweg repliziert.
Anwendungsfälle
Diese Architektur ist für Unternehmensszenarien konzipiert, in denen Ihre generative KI-Anwendung Zugriff auf die aktuellsten Informationen benötigt und ein tiefes, kontextbezogenes Verständnis erfordert, um genaue Antworten zu liefern.
Die Architektur umfasst ein benutzerdefiniertes Datenaufnahmesubsystem, um zwei wichtige Unternehmensanforderungen zu erfüllen:
- Datenverfügbarkeit in Echtzeit: Die ereignisgesteuerte Pipeline verarbeitet neue Daten, sobald sie in Ihrer Organisation verfügbar sind, z. B. einen neuen Produktleitfaden oder einen aktualisierten Bericht. Die Pipeline stellt die Informationen auch in Ihrem verwalteten Datenspeicher zur Verfügung. Dieses Design trägt dazu bei, die Veraltung von Informationen zu verringern, da die Verzögerung zwischen Datenverfügbarkeit und -nutzung minimiert wird.
- Erweiterte kontextbezogene Suche: Mit dem benutzerdefinierten Verarbeitungsjob kann Ihre Organisation ihre eigene Geschäftslogik anwenden, um Daten mit wertvollen Metadaten anzureichern. Die Cloud Run-Funktion kann jedes Dokument mit bestimmten Attributen wie Produktlinie, Autor, Standort oder Dokumenttyp taggen. Diese umfangreichen Metadaten helfen dem Agenten, die Suche einzugrenzen und präzisere, kontextbezogene Antworten zu liefern.
RAG ist eine effektive Technik, um die Qualität der von einem LLM generierten Ausgabe zu verbessern. In diesem Abschnitt finden Sie Beispiele für Anwendungsfälle, in denen Sie RAG-fähige generative KI-Anwendungen verwenden können.
Personalisierte Produktempfehlungen
Eine Online-Shopping-Website verwendet möglicherweise einen LLM-gestützten Chatbot, um Kunden bei der Suche nach Produkten oder bei der Hilfe beim Einkaufen zu unterstützen. Die Fragen eines Nutzers können mithilfe von Verlaufsdaten zum Kaufverhalten des Nutzers und zu Website-Interaktionsmustern erweitert werden. Die Daten können Nutzerrezensionen und -feedback enthalten, die in einem unstrukturierten Datenspeicher oder suchbezogenen Messwerten, die in einem Webanalyse-Data-Warehouse gespeichert werden. Die erweiterte Frage kann dann vom LLM verarbeitet werden, um personalisierte Antworten zu generieren, die für den Nutzer ansprechender und ansprechender sind.
Klinische Unterstützungssysteme
Ärzte in Krankenhäusern müssen Gesundheitsinformationen von Patienten prüfen und zusammenfassen, um fundierte Entscheidungen über die Behandlung zu treffen. Eine generative KI-Anwendung, die ein medizinisches Foundation Model wie MedGemma verwendet, kann Ärzten helfen, klinische Notizen zusammenzufassen und medizinischen Kontext zu prüfen. Die von der Anwendung generierten Antworten können auf historischen Patientenakten basieren, indem die Prompts mit Daten aus der EHR-Datenbank (Electronic Health Record) des Krankenhauses oder aus einer externen Wissensdatenbank wie PubMed in Beziehung gesetzt werden:
Effiziente Rechtsforschung
Mit der generativen KI-basierten Rechtsforschung können Anwälte große Mengen von Gesetzen und Fallgesetzen schnell abfragen, um relevante Prädikate zu ermitteln oder komplexe rechtliche Konzepte zusammenzufassen. Das Ergebnis einer solchen Forschungsarbeit kann durch die Erweiterung der Aufforderungen eines Anwalts mit Daten aus dem proprietären Korpus von Verträgen, früheren rechtlichen Mitteilungen und internen Fallaufzeichnungen der Anwaltskanzlei ergänzt werden. Durch diesen Designansatz werden Antworten generiert, die für das Fachgebiet relevant sind, auf das der Anwalt spezialisiert ist.
Designalternativen
In diesem Abschnitt werden alternative Designansätze vorgestellt, die Sie für Ihre RAG-fähige generative KI-Anwendung in Google Cloudin Betracht ziehen können.
Alternativen zur KI-Infrastruktur
Eine Liste von Architekturleitfäden zum Entwerfen und Bereitstellen von generativen KI-Anwendungen mit RAG in Google Cloudfinden Sie unter Generative KI mit RAG.
Optionen für das Anwendungshosting
In der in diesem Dokument dargestellten Architektur ist Cloud Run der Host für die generative KI-Anwendung und die Datenverarbeitung. Cloud Run ist eine vollständig verwaltete Plattform, die sich an Entwickler richtet. Sie können Ihre Anwendung auch in der Agent Runtime auf der Gemini Enterprise Agent Platform, in Google Kubernetes Engine-Clustern (GKE) oder auf Compute Engine-VMs bereitstellen.
Berücksichtigen Sie bei der Auswahl eines Anwendungshosts die folgenden Kompromisse zwischen Konfigurationsflexibilität und Verwaltungsaufwand:
- Mit der serverlosen Cloud Run-Option stellen Sie Ihre benutzerdefinierten Dienste in einer vorkonfigurierten, verwalteten Umgebung bereit. Zum Hosten der Frontend-Dienste und der benutzerdefinierten Backend-Logik für die Vorverarbeitung von Anfragen muss diese Architektur die Möglichkeit bieten, benutzerdefinierte Anwendungen bereitzustellen.
- Mit der Option „Agent Runtime“ verwenden Sie eine vollständig verwaltete Plattform, die für die Bereitstellung von Agenten entwickelt wurde. Agent Runtime reduziert den Verwaltungsaufwand und bietet eine enge Integration in Gemini Enterprise.
- Bei Compute Engine-VMs und GKE-Containern sind Sie für die Verwaltung der zugrunde liegenden Rechenressourcen verantwortlich, haben aber mehr Konfigurationsflexibilität und ‑kontrolle.
Weitere Informationen zur Auswahl eines geeigneten Anwendungshostingdienstes finden Sie in den folgenden Dokumenten:
Weitere Infrastrukturoptionen
Informationen zu anderen Infrastrukturoptionen, unterstützten Modellen und Fundierungstechniken, die Sie für generative KI-Anwendungen inGoogle Cloudverwenden können, finden Sie unter Modelle und Infrastruktur für Ihre generative KI-Anwendung auswählen.
Designaspekte
Dieser Abschnitt enthält eine Anleitung zum Entwickeln einer RAG-fähigen generativen KI-Architektur in Google Cloud , die Ihre spezifischen Anforderungen an Sicherheit und Compliance, Zuverlässigkeit, Kosten und Leistung erfüllt. Die Anleitung in diesem Abschnitt ist nicht vollständig. Abhängig von den spezifischen Anforderungen Ihrer generativen KI-Anwendung und der von Ihnen verwendeten Produkte und Features von Google Cloud müssen Sie möglicherweise zusätzliche Designfaktoren und Kompromisse berücksichtigen.
Eine Übersicht über Architekturprinzipien und Empfehlungen, die speziell für KI- und ML-Arbeitslasten in Google Cloudgelten, finden Sie im Well-Architected Framework unter KI- und ML-Perspektive.
Sicherheit, Datenschutz und Compliance
In diesem Abschnitt werden Designüberlegungen und Empfehlungen für das Entwerfen einer Topologie in Google Cloud beschrieben, die die Sicherheits- und Compliance-Anforderungen Ihrer Arbeitslast erfüllt.
Sicherheitsgrundsätze und Empfehlungen speziell für KI- und ML-Arbeitslasten finden Sie im Well-Architected Framework unter KI- und ML-Perspektive: Sicherheit.
Agent Platform
Die Agent Platform unterstützt Sicherheitskontrollen von Google Cloud, mit denen Sie Ihre Anforderungen an Datenstandort, Datenverschlüsselung, Netzwerksicherheit und Access Transparency erfüllen können. Weitere Informationen erhalten Sie in dieser Dokumentation:
- Sicherheitskontrollen für Dienste für maschinelles Lernen
- Sicherheitseinstellungen für generative KI
- Agent Platform und keine Datenaufbewahrung
- Access Transparency für Gemini Enterprise aktivieren
- Compliance- und Sicherheitseinstellungen für Gemini Enterprise
- Compliance bei Gemini Enterprise
- Datenlöschung in Google Cloud
Generative KI-Modelle können schädliche Antworten erzeugen, insbesondere wenn sie explizit dazu aufgefordert werden. Um die Sicherheit zu erhöhen und potenziellen Missbrauch zu minimieren, können Sie Inhaltsfilter konfigurieren, die als Barrieren für schädliche Antworten dienen. Weitere Informationen finden Sie unter Sicherheits- und Inhaltsfilter.
Cloud Run
Standardmäßig verschlüsselt Cloud Run Daten mitGoogle-owned and Google-managed encryption keys. Zum Schutz Ihrer Container mit von Ihnen kontrollierten Schlüsseln können Sie kundenverwaltete Verschlüsselungsschlüssel (Customer-Managed Encryption Keys, CMEKs) verwenden. Weitere Informationen finden Sie unter Kundenverwaltete Verschlüsselungsschlüssel verwenden.
Damit nur autorisierte Container-Images in Cloud Run bereitgestellt werden, können Sie die Binärautorisierung verwenden.
Cloud Run unterstützt Sie dabei, die Anforderungen an den Datenstandort zu erfüllen. Ihre Cloud Run-Funktionen werden in der ausgewählten Region ausgeführt.
Cloud Storage
Standardmäßig verschlüsselt Cloud Storage die gespeicherten Daten mit Google-owned and Google-managed encryption keys. Bei Bedarf können Sie CMEKs oder Ihre eigenen Schlüssel verwenden, die Sie mithilfe einer externen Verwaltungsmethode wie vom Kunden bereitgestellte Verschlüsselungsschlüssel (Customer-Supplied Encryption Keys, CSEKs) verwalten. Weitere Informationen finden Sie unter Datenverschlüsselungsoptionen.
Cloud Storage bietet Ihnen zwei Systeme, um Nutzern die Berechtigung zum Zugriff auf Ihre Buckets und Objekte zu erteilen: Identity and Access Management (IAM) und Access Control Lists (ACLs). In den meisten Fällen empfehlen wir die Verwendung von IAM, mit dem Sie Berechtigungen auf Bucket- und Projektebene erteilen können. Weitere Informationen finden Sie unter Zugriffssteuerung.
Die Daten, die Sie über Cloud Storage in das Datenaufnahmesubsystem laden, können sensible Daten enthalten. Mit Sensitive Data Protection können Sie sensible Daten ermitteln, klassifizieren und de-identifizieren. Weitere Informationen finden Sie unter Sensitive Data Protection mit Cloud Storage verwenden.
Cloud Storage unterstützt Sie dabei, die Anforderungen an den Datenstandort zu erfüllen. Cloud Storage speichert oder repliziert Daten in der von Ihnen angegebenen Region.
Pub/Sub
Standardmäßig verschlüsselt Pub/Sub alle Nachrichten, sowohl im inaktiven Zustand als auch bei der Übertragung, mitGoogle-owned and Google-managed encryption keys. Pub/Sub unterstützt die Verwendung von CMEKs für die Nachrichtenverschlüsselung auf Anwendungsebene. Weitere Informationen finden Sie unter Nachrichtenverschlüsselung konfigurieren.
Wenn Sie Anforderungen an den Datenstandort haben, können Sie Richtlinien für den Nachrichtenspeicher konfigurieren, um sicherzustellen, dass Nachrichtendaten an bestimmten Standorten gespeichert werden.
Zuverlässigkeit
In diesem Abschnitt werden Designüberlegungen und Empfehlungen zum Erstellen und Betreiben einer zuverlässigen Infrastruktur für Ihre Bereitstellung in Google Cloudbeschrieben.
Zuverlässigkeitsprinzipien und Empfehlungen speziell für KI- und ML-Arbeitslasten finden Sie im Well-Architected Framework unter KI- und ML-Perspektive: Zuverlässigkeit.
Agent Platform
Die Agent Platform unterstützt den Datenstandort im Ruhezustand. Die Agent Platform speichert Ihre Quelldaten, einschließlich der Daten für RAG im verwalteten Datenspeicher, am von Ihnen ausgewähltenGoogle Cloud Standort. Diese Trennung von Verarbeitung und Speicherung ist ein grundlegender Aspekt dafür, wie die Plattform sowohl hohe Zuverlässigkeit als auch Compliance bietet.
Cloud Run
Cloud Run ist ein regionaler Dienst, der zustandslose Dienstinstanzen automatisch auf mehrere Zonen innerhalb einer Region verteilt und ein Load Balancing durchführt. Wenn ein Zonenausfall auftritt, werden Cloud Run-Dienste und Cloud Run-Funktionen ohne Unterbrechung weiter ausgeführt. Um sich vor regionalen Ausfällen zu schützen, können Sie Cloud Run-Dienste in mehreren Regionen hinter einem globalen externen Application Load Balancer bereitstellen. Weitere Informationen finden Sie unter Traffic aus mehreren Regionen bereitstellen.
Im Datenaufnahmesubsystem können bei ereignisgesteuerten Cloud Run-Funktionen vorübergehende Fehler auftreten oder aufgrund der mindestens einmaligen Übermittlung doppelte Ereignisse empfangen werden. Beachten Sie die folgenden Best Practices, um diese Szenarien zuverlässig zu bewältigen:
- Entwerfen Sie idempotente Funktionen, damit die erneute Verarbeitung eines Ereignisses dasselbe Ergebnis liefert, ohne dass doppelte Datensätze erstellt werden.
- Konfigurieren Sie Wiederholungsversuche für ereignisgesteuerte Funktionen mit exponentiellem Backoff für den Pub/Sub-Trigger, um vorübergehende Downstream-Fehler zu beheben.
- Konfigurieren Sie ein Pub/Sub-Thema für unzustellbare Nachrichten, um Nachrichten, die wiederholt nicht verarbeitet werden können, für eine separate Prüfung und Wiederholung zu isolieren.
Cloud Storage
Sie können Cloud Storage-Buckets an einem von drei Standorttypen erstellen: regional, biregional oder multiregional. Daten in regionalen Buckets werden von Cloud Storage synchron über mehrere Zonen innerhalb einer Region repliziert. Für eine höhere Verfügbarkeit können Sie biregionale oder multiregionale Buckets verwenden, bei denen Cloud Storage Daten asynchron über Regionen hinweg repliziert. Achten Sie darauf, dass Ihre Auswahl den Compliance-Anforderungen entspricht.
Kostenoptimierung
Dieser Abschnitt enthält Anleitungen zur Optimierung der Kosten für die Einrichtung und den Betrieb einer Google Cloud -Topologie, die Sie mithilfe dieser Referenzarchitektur erstellen.
Prinzipien und Empfehlungen zur Kostenoptimierung, die speziell für KI- und ML-Arbeitslasten gelten, finden Sie im Well-Architected Framework unter KI- und ML-Perspektive: Kostenoptimierung.
Agent Platform
Das zugrunde liegende KI-Modell, das der Agent aufruft, kann sich direkt auf die Kosten für die Verwendung dieses Agenten auswirken. Die Preise werden anhand der Anzahl der Eingabe- und Ausgabetokens für jede Anfrage berechnet. Weitere Informationen finden Sie unter Kontingente und Systemlimits für Generative AI on Agent Platform und im Google Cloud -Preisrechner.
Informationen dazu, wie Sie die Anzahl der Tokens minimieren können, um die Kosten zu senken, finden Sie in der Übersicht zum Kontext-Caching.
Cloud Run
Beachten Sie die folgenden Empfehlungen, um die Kosten Ihrer Cloud Run-Dienste und Cloud Run-Funktionen zu optimieren:
- Abrechnungseinstellungen: Wählen Sie eine geeignete Abrechnungseinstellung basierend auf Ihrem Traffic-Muster aus. Verwenden Sie die anfragebasierte Abrechnung (Standard) für sporadische oder unregelmäßige Arbeitslasten, z. B. ereignisgesteuerte Cloud Run-Funktionen in der Datenaufnahmepipeline, damit Sie nur für CPU und Arbeitsspeicher bezahlen, während Anfragen verarbeitet werden. Für Cloud Run-Dienste mit gleichmäßigem, vorhersehbarem Traffic sollten Sie die instanzbasierte Abrechnung in Betracht ziehen. Dabei entfällt die Gebühr pro Anfrage und es wird ein niedrigerer Preis pro Sekunde für die Rechenleistung berechnet.
- CPU, Arbeitsspeicher und Nebenläufigkeit: Beginnen Sie mit den Standardzuweisungen für CPU und Arbeitsspeicher und passen Sie das CPU-Limit und das Arbeitsspeicherlimit basierend auf der überwachten Auslastung an. Passen Sie die maximale Anzahl gleichzeitiger Anfragen pro Instanz so an, dass weniger Instanzen gleichzeitige E/A-gebundene Anfragen verarbeiten können (z. B. Warten auf Modell- oder API-Antworten).
- Limits für die Instanzskalierung: Konfigurieren Sie die maximale Anzahl von Instanzen, um die Skalierungskosten bei unerwarteten Trafficspitzen zu begrenzen, und wägen Sie die Mindestanzahl von Instanzen gegen die Latenzanforderungen für Kaltstarts ab.
- Rabatte für zugesicherte Nutzung: Wenn Sie die Rechenanforderungen Ihrer Cloud Run-Arbeitslasten vorhersagen können, können Sie die Kosten mit Rabatten für zugesicherte Nutzung in Cloud Run senken.
Weitere Informationen finden Sie unter Best Practices für kostenoptimierte Cloud Run-Dienste.
Cloud Storage
Wählen Sie für den Cloud Storage-Bucket, den Sie zum Laden von Daten in das Datenaufnahme-Subsystem verwenden, eine geeignete Speicherklasse basierend auf den Anforderungen an die Datenaufbewahrung und die Zugriffshäufigkeit Ihrer Arbeitslasten aus. Sie können beispielsweise die Speicherklasse Standard auswählen und die Verwaltung des Objektlebenszyklus verwenden, um die Speicherkosten zu steuern. Die Verwaltung des Objektlebenszyklus führt automatisch ein Downgrade von Objekten auf eine kostengünstigere Speicherklasse durch oder löscht Objekte basierend auf den von Ihnen festgelegten Bedingungen.
Leistungsoptimierung
In diesem Abschnitt werden Designüberlegungen und Empfehlungen zum Entwerfen einer Topologie in Google Cloud beschrieben, die die Leistungsanforderungen Ihrer Arbeitslasten erfüllt.
Prinzipien und Empfehlungen zur Leistungsoptimierung, die speziell für KI- und ML-Arbeitslasten gelten, finden Sie im Well-Architected Framework unter KI- und ML-Perspektive: Leistungsoptimierung.
Gemini Enterprise
Um die Latenz während der Bereitstellung zu reduzieren, können Sie Antworten streamen, indem Sie Modellantworten senden, bevor der Agent die vollständige Ausgabe generiert. Dies ermöglicht die Echtzeitverarbeitung der Ausgabe und Sie können Ihre Benutzeroberfläche sofort aktualisieren und andere gleichzeitige Aufgaben ausführen. Streaming verbessert die wahrgenommene Reaktionsfähigkeit und sorgt für eine interaktivere Nutzererfahrung. Weitere Informationen finden Sie unter Suchergebnisse mit StreamAssist abrufen.
Wenn Sie benutzerdefinierte ADK-Agenten (Agent Development Kit) in Agent Runtime erstellen und registrieren, sollten Sie sequenzielle Multi-Agenten-Hops, Tool-Roundtrips und redundante Zusammenfassungsdurchläufe minimieren, um die End-to-End-Turn-Latenz zu reduzieren. Weitere Informationen finden Sie unter Best Practices für Leistung und Zuverlässigkeit.
Cloud Run
Passen Sie die CPU- und Arbeitsspeicherzuweisungen für Ihre Cloud Run-Dienste und Cloud Run Functions-Funktionen an die Leistungsanforderungen der Arbeitslast an. Wenn Sie die Kaltstartlatenz beim Skalieren von null reduzieren möchten, aktivieren Sie den CPU-Boost beim Start, um während des Starts der Containerinstanz vorübergehend zusätzliche CPU bereitzustellen, oder konfigurieren Sie Mindestinstanzen, um Instanzen einsatzbereit zu halten. Weitere Informationen finden Sie unter CPU-Limits für Dienste konfigurieren und Arbeitsspeicherlimits für Dienste konfigurieren.
Cloud Storage
Zum Hochladen großer Dateien können Sie eine Methode namens parallele zusammengesetzte Uploads verwenden. Bei dieser Strategie wird die große Datei in Blöcke unterteilt. Sie laden die Blöcke parallel in Cloud Storage hoch und Cloud Storage setzt die Daten dann in Google Cloudwieder zusammen. Parallele zusammengesetzte Uploads können schneller sein als reguläre Uploadvorgänge, wenn Sie über ausreichende Netzwerkbandbreite und Laufwerksgeschwindigkeit verfügen. Diese Strategie hat jedoch einige Einschränkungen und Auswirkungen auf die Kosten. Weitere Informationen finden Sie unter Parallele zusammengesetzte Uploads.
Bereitstellung
Verwenden Sie das Terraform-Beispiel, das auf GitHub verfügbar ist, um diese Referenzarchitektur bereitzustellen. Weitere Informationen finden Sie unter RAG-Infrastruktur für generative KI-Anwendungen mit Gemini Enterprise und Agent Platform.
Nächste Schritte
- So teilt Gemini Enterprise Dokumente für RAG in Blöcke auf
- KI-Apps und -Agents in Cloud Run hosten
- Best Practices für verantwortungsbewusste KI und Sicherheitsfilter der Agent Platform
- Prompting-Strategien für LLMs
- Eine Übersicht über Architekturprinzipien und Empfehlungen, die speziell für KI- und ML-Arbeitslasten in Google Cloudgelten, finden Sie im Well-Architected Framework unter KI- und ML-Perspektive.
- Weitere Referenzarchitekturen, Diagramme und Best Practices finden Sie im Cloud-Architekturcenter.
Beitragende
Autor: Samantha He | Technical Writer
Weitere Beitragende:
- Deepak Michael | Networking Specialist Customer Engineer
- Kumar Dhanagopal | Cross-Product Solution Developer
- Mark Schlagenhauf | Technical Writer, Netzwerk
- Victor Moreno | Product Manager, Cloud Networking
- Yehia Elshater | Field Solutions Architect, Generative KI, Google Cloud
- Paarth Mahajan | Network Specialist, Google Cloud