


本文說明在 Google Cloud中,如何運用 AI 為零售應用程式生成個人化產品推薦的高階架構。
本文適用對象包括架構師、開發人員和管理員,他們在雲端建構及管理零售業的生成式 AI 應用程式。本文假設您對生成式 AI 有基本瞭解。
架構
下圖顯示的架構使用 AI 模型,根據點擊流指標的洞察資料,生成個人化產品推薦。
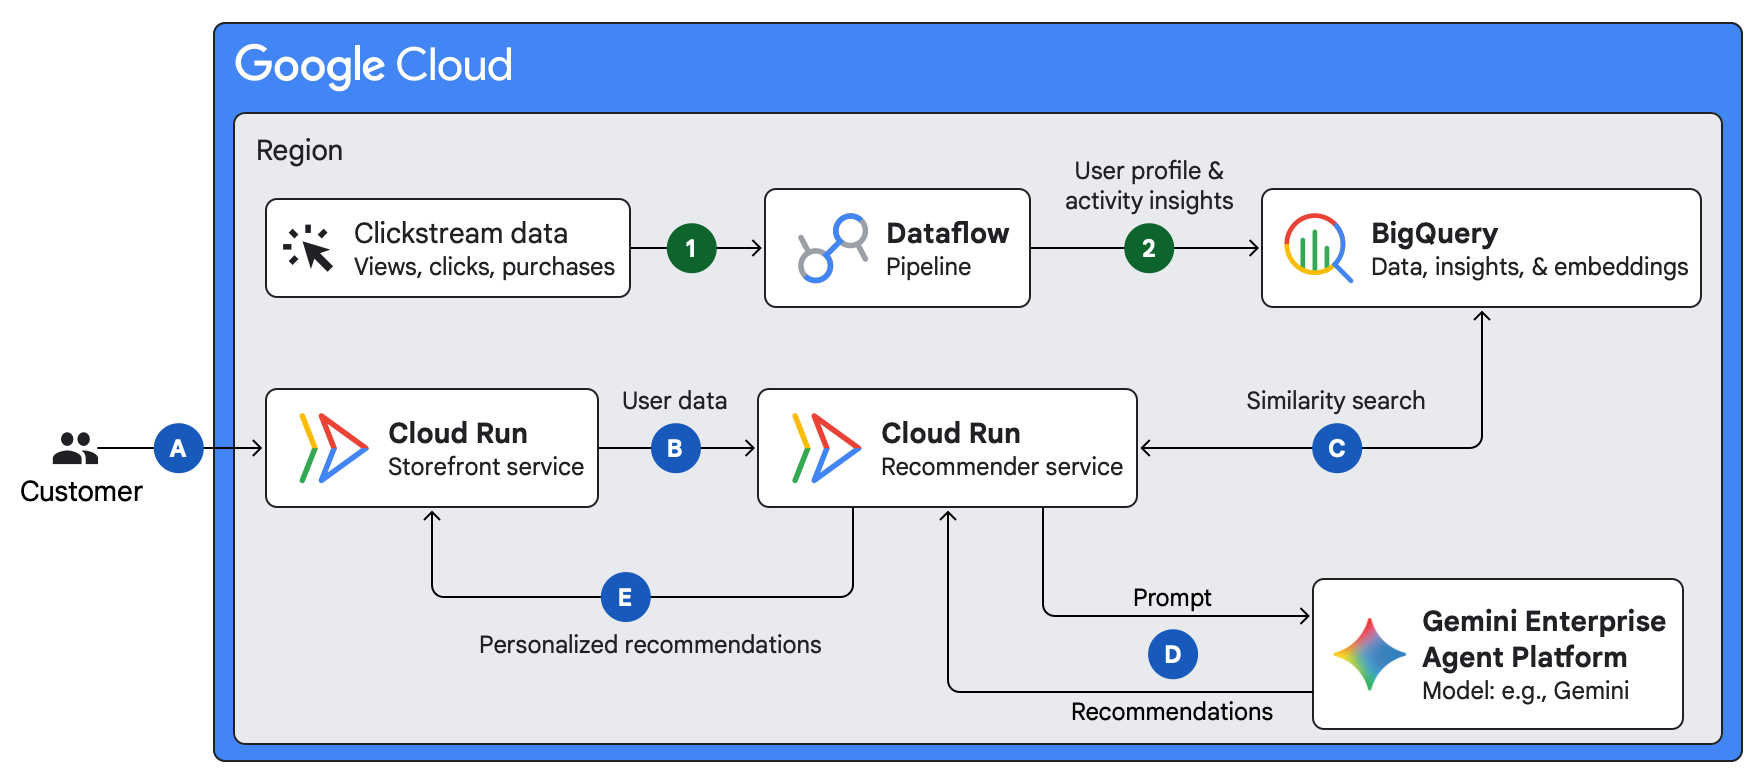
架構圖顯示下列流程:
- 擷取及處理使用者資料:
- 點擊流資料 (例如網頁瀏覽、點擊和購買) 會上傳至 Dataflow 管道。
- Dataflow 會處理資料並衍生洞察資訊,例如使用者個人資料和偏好設定。Dataflow 接著會將資料、洞察和向量嵌入儲存在 BigQuery。
- 生成及提供產品建議:
- 客戶造訪公司的店面,也就是這個架構中的 Cloud Run 服務。
- 店面服務會將訪客的資料傳送至在 Cloud Run 上執行的推薦工具服務。
- 推薦服務會在 BigQuery 執行向量相似度搜尋,並擷取訪客個人資料和偏好設定的相關資料。
- 推薦服務會將訪客的個人資料和偏好設定資料傳送至 Gemini Enterprise Agent Platform,並提示生成產品推薦。在 Agent Platform 上,Gemini 模型會生成為訪客量身打造的產品推薦。
- 推薦工具服務會將產品推薦傳送至店面服務,然後顯示推薦。
如要最佳化成本和效能,請在店面服務和推薦工具服務之間新增快取。推薦服務會檢查快取中的訪客資料。如果快取不含相關資料,服務會在 BigQuery 執行向量相似度搜尋。如要設定快取,您可以使用 Memorystore,或使用 Cloud CDN 設定負載平衡器。
使用的產品
這個範例架構使用下列 Google Cloud 產品:
- Cloud Run:無伺服器運算平台,可讓您直接在 Google 可擴充的基礎架構上執行容器。
- Gemini Enterprise Agent Platform:全方位平台,可建構、擴充、管理及最佳化企業級 AI 代理。
- BigQuery:企業資料倉儲,內建機器學習、地理空間分析和商業智慧等功能,可協助您管理及分析資料。
- Dataflow:這項服務整合串流與批次資料處理功能,可大規模處理資料。
設計須知
本節說明設計因素、最佳做法和建議,符合Google Cloud Well-Architected Framework。使用這個參考架構開發拓撲時,請考量這項資訊,確保拓撲符合您在安全性、可靠性、成本最佳化、作業效率和效能方面的特定需求。
安全性、隱私權和法規遵循
為保護客戶資料,並滿足 Google Cloud的安全性、隱私權和法規遵循要求,請考慮下列建議:
- 如要篩選提示詞和建議回覆,找出提示詞注入、越獄活動和有害內容,請使用 Model Armor。
- 如要檢查點擊串流資料、使用者個人資料和提示中的個人識別資訊 (PII),並進行去識別化,請使用 Sensitive Data Protection。
可靠性
如要緩衝突發的點擊串流流量,並將店面事件產生器與 Dataflow 管道分離,請透過 Pub/Sub 擷取使用者事件。在 Pub/Sub 中緩衝事件,有助於防止在流量高峰或管道更新期間遺失資料。
成本最佳化
如果提示詞共用重複的系統指令或產品目錄脈絡,請在 Agent Platform 使用脈絡快取,降低輸入詞元成本。
提升作業效率
在 Google Cloud中建構及維護推薦管道時,如要降低營運負擔,請考慮下列選項:
- 如果偏好代管零售推薦服務,而非自訂管道,可以考慮使用 Gemini Enterprise for Customer Experience 的 AI Commerce Search。AI Commerce Search 會直接根據產品目錄和點擊流事件,訓練及提供個人化推薦模型。
- 如要在來源資料變更時,自動在 BigQuery 中生成及重新整理嵌入,請使用自主嵌入生成功能。
效能最佳化
為滿足Google Cloud店面訪客的低延遲服務需求,建議您採取下列做法:
- 如要加快 BigQuery 大型資料表的相似度查詢速度,請建立向量索引,用於近似最鄰近 (ANN) 搜尋。
- 如要在高店面並行情況下,提供低延遲的線上相似度服務,建議使用向量搜尋。
- 部署 Memorystore 進行快取時,請使用 Memorystore for Valkey 或 Memorystore for Redis Cluster,而非已淘汰的 Memcached 引擎。如要以不到一毫秒的延遲時間提供語意查詢,您也可以使用 Memorystore for Valkey 的向量搜尋。
部署作業
如要在 Google Cloud 中試用零售工作負載的生成式 AI 應用程式,請使用下列程式碼範例:
後續步驟
- 探索更多生成式 AI 架構指南。
- 如要概略瞭解 Google Cloud中 AI 和機器學習工作負載專屬的架構原則和建議,請參閱 Well-Architected Framework 中的「AI 和機器學習觀點」一文。
- 如要查看更多參考架構、圖表和最佳做法,請瀏覽 Cloud Architecture Center。
貢獻者
作者:Kumar Dhanagopal | 跨產品解決方案開發人員
其他貢獻者:
- Amina Mansour | 全球開發人員關係與策略內容技術負責人
- Megan O'Keefe | 開發人員服務代表
- Samantha He | 技術撰稿人
- Shir Meir Lador | 開發人員關係工程經理