


Neste documento, descrevemos uma arquitetura de alto nível para usar a IA na geração de recomendações personalizadas de produtos para um aplicativo de varejo no Google Cloud.
O público-alvo deste documento inclui arquitetos, desenvolvedores e administradores que criam e gerenciam aplicativos de IA generativa na nuvem para o setor de varejo. O documento pressupõe que você tenha um entendimento básico de IA generativa.
Arquitetura
O diagrama a seguir mostra uma arquitetura que usa um modelo de IA para gerar recomendações de produtos personalizadas com base em insights de métricas de clickstream.
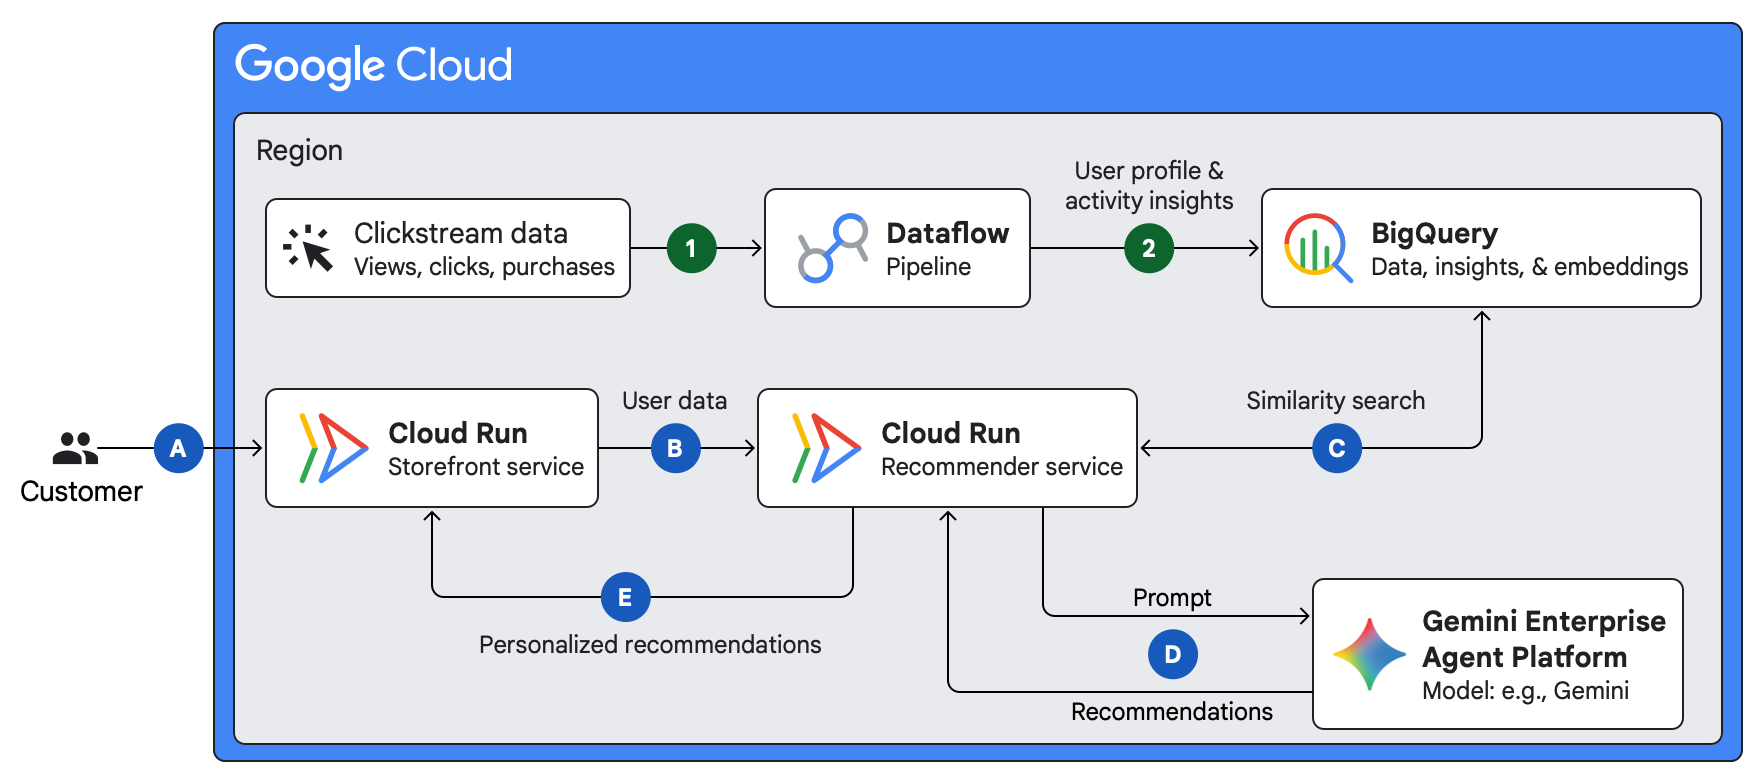
A arquitetura mostra os seguintes fluxos:
- Ingerir e processar dados do usuário:
- Os dados de sequência de cliques, como visualizações de página, cliques e compras, são enviados para um pipeline do Dataflow.
- O Dataflow processa os dados e gera insights, como perfis e preferências de usuários. Em seguida, o Dataflow armazena os dados, insights e embeddings de vetor no BigQuery.
- Gerar e veicular recomendações de produtos:
- Um cliente visita a vitrine da empresa, que é um serviço do Cloud Run nessa arquitetura.
- O serviço de vitrine envia os dados do visitante para um serviço de recomendação que é executado no Cloud Run.
- O serviço de recomendação realiza uma pesquisa de similaridade vetorial no BigQuery e recupera dados sobre o perfil e as preferências do visitante.
- O serviço de recomendação envia os dados de perfil e preferências do visitante para a Gemini Enterprise Agent Platform, com um comando para gerar recomendações de produtos. Na Agent Platform, um modelo do Gemini gera recomendações de produtos personalizadas para o visitante.
- O serviço de recomendação envia as recomendações de produtos para o serviço de vitrine, que as exibe.
Para otimizar o custo e o desempenho, adicione um cache entre o serviço de vitrine e o serviço de recomendação. O serviço de recomendação verifica o cache em busca de dados do visitante. Se o cache não tiver dados relevantes, o serviço vai realizar uma pesquisa de similaridade de vetor no BigQuery. Para configurar o cache, use o Memorystore ou configure um balanceador de carga com o Cloud CDN.
Produtos usados
Este exemplo de arquitetura usa os seguintes produtos do Google Cloud :
- Cloud Run: uma plataforma de computação sem servidor que permite executar contêineres diretamente na infraestrutura escalonável do Google.
- Gemini Enterprise Agent Platform: uma plataforma abrangente que permite criar, escalonar, governar e otimizar agentes de IA de nível empresarial.
- BigQuery: um data warehouse corporativo que ajuda a gerenciar e analisar seus dados com recursos integrados, como análise geoespacial de machine learning e Business Intelligence.
- Dataflow: um serviço que fornece processamento unificado de dados de streaming e em lote em larga escala.
Considerações sobre o design
Nesta seção, descrevemos fatores de design, práticas recomendadas e recomendações de acordo com o Google Cloud Well-Architected Framework. Considere essas informações ao usar essa arquitetura de referência para desenvolver uma topologia que atenda aos seus requisitos específicos de segurança, confiabilidade, otimização de custos, eficiência operacional e desempenho.
segurança, privacidade e conformidade
Para ajudar a proteger os dados do cliente e atender aos requisitos de segurança, privacidade e conformidade no Google Cloud, considere as seguintes recomendações:
- Para analisar comandos e respostas de recomendação em busca de injeção de comandos, tentativas de jailbreak e conteúdo nocivo, use o Model Armor.
- Para inspecionar e desidentificar informações de identificação pessoal (PII) em dados de clickstream, perfis de usuário e comandos, use a Proteção de Dados Sensíveis.
Confiabilidade
Para armazenar em buffer o tráfego de clickstream em picos e separar os produtores de eventos da vitrine do pipeline do Dataflow, faça a ingestão de eventos do usuário pelo Pub/Sub. O armazenamento em buffer de eventos no Pub/Sub ajuda a evitar a perda de dados durante picos de tráfego ou atualizações de pipeline.
Otimização de custos
Para reduzir os custos de tokens de entrada quando os comandos compartilham instruções de sistema repetidas ou contexto de catálogo de produtos, use o armazenamento em cache de contexto na Plataforma de Agentes.
Eficiência operacional
Para reduzir a sobrecarga operacional ao criar e manter o pipeline de recomendação no Google Cloud, considere as seguintes opções:
- Se você preferir um serviço gerenciado de recomendação de varejo em vez de um pipeline personalizado, considere a AI Commerce Search no Gemini Enterprise for Customer Experience. A AI Commerce Search treina e disponibiliza modelos de recomendação personalizados diretamente do seu catálogo de produtos e eventos de clickstream.
- Para gerar e atualizar embeddings automaticamente no BigQuery quando os dados de origem mudarem, use a geração autônoma de embeddings.
Otimização de desempenho
Para atender aos requisitos de veiculação de baixa latência para visitantes da vitrine em Google Cloud, considere as seguintes recomendações:
- Para acelerar as consultas de similaridade em tabelas grandes no BigQuery, crie um índice vetorial para a pesquisa de vizinho mais próximo aproximado (ANN, na sigla em inglês).
- Para veiculação de similaridade on-line de baixa latência em alta simultaneidade de vitrine, considere a Pesquisa vetorial.
- Ao implantar o Memorystore para armazenamento em cache, use o Memorystore for Valkey ou o Memorystore for Redis Cluster em vez do mecanismo Memcached descontinuado. Para exibir consultas semânticas com latência de menos de um milissegundo, use também a pesquisa vetorial no Memorystore for Valkey.
Implantação
Para testar aplicativos de IA generativa em cargas de trabalho do Google Cloud para varejo, use os seguintes exemplos de código:
- Recomendações de varejo multimodais.
- Exemplos de código de IA generativa para casos de uso de varejo.
A seguir
- Confira mais guias de arquitetura de IA generativa.
- Para uma visão geral dos princípios e recomendações de arquitetura específicos para cargas de trabalho de IA e ML no Google Cloud, consulte a perspectiva de IA e ML no Well-Architected Framework.
- Para mais arquiteturas de referência, diagramas e práticas recomendadas, confira a Central de arquitetura do Cloud.
Colaboradores
Autor: Kumar Dhanagopal | Desenvolvedor de soluções de vários produtos
Outros colaboradores:
- Amina Mansour | Líder técnica, Relações globais com desenvolvedores e conteúdo estratégico
- Megan O'Keefe | Mediadora de desenvolvedores
- Samantha He | Redatora técnica
- Shir Meir Lador | Gerente de engenharia de relações com desenvolvedores