


Este documento apresenta uma arquitetura de alto nível para um aplicativo que usa IA para gerar podcasts com base em entradas de áudio.
O público-alvo deste documento inclui arquitetos, desenvolvedores e administradores que criam e gerenciam aplicativos de IA generativa na nuvem para os setores de mídia e marketing. No documento, pressupomos que você tenha uma compreensão básica da IA generativa.
A seção Implantação deste documento fornece exemplos de código para cargas de trabalho de IA generativa que envolvem formatos de entrada e saída multimodais.
Arquitetura
O diagrama a seguir mostra uma arquitetura para um aplicativo de produtor de podcast no Google Cloud. O aplicativo usa IA para gerar podcasts com base em arquivos de áudio, como comentários ao vivo de um evento esportivo.
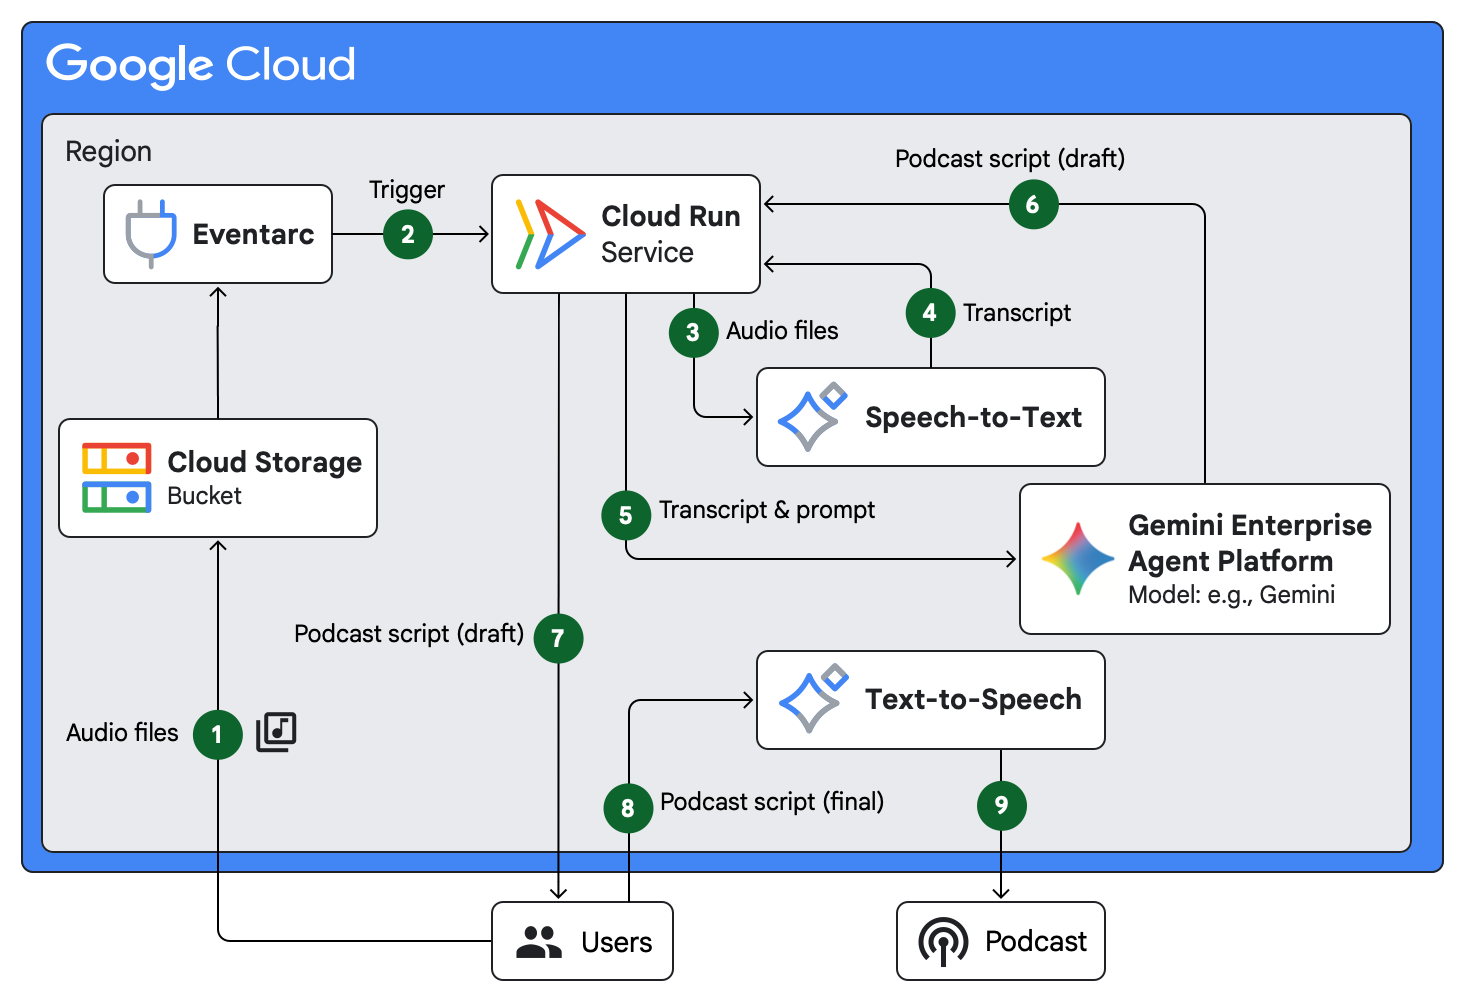
A arquitetura mostra o seguinte fluxo:
- Um usuário faz upload de arquivos de áudio para um bucket do Cloud Storage.
- O Eventarc aciona um serviço do Cloud Run.
- O serviço do Cloud Run envia os arquivos de áudio para o Speech-to-Text.
- A Speech-to-Text produz transcrições com carimbo de data/hora dos arquivos de áudio.
O serviço do Cloud Run envia as transcrições para a Gemini Enterprise Agent Platform, com um comando para gerar um roteiro para um podcast.
Por exemplo, o comando pode ser para gerar um roteiro de um podcast de 15 minutos sobre os destaques de um evento esportivo com base em determinadas palavras-chave no comentário.
Um modelo do Gemini na Agent Platform gera um rascunho de um roteiro de podcast.
O serviço do Cloud Run envia o rascunho do script para o usuário.
O usuário revisa e edita o rascunho do script e envia o script final para a Text-to-Speech.
A Text-to-Speech produz um arquivo de áudio de podcast.
Produtos usados
Este exemplo de arquitetura usa os seguintes produtos do Google Cloud :
- Speech-to-Text: uma API que usa as tecnologias de reconhecimento de fala do Google para transcrever áudio em texto.
- Gemini Enterprise Agent Platform: uma plataforma abrangente que permite criar, escalonar, governar e otimizar agentes de IA de nível empresarial.
- Text-to-Speech: uma API para criar fala humana sintética e com som natural a partir de texto.
- Cloud Storage: um repositório de objetos de baixo custo e sem limite para diversos tipos de dados. Os dados podem ser acessados de dentro e fora do Google Cloude são replicados entre locais para redundância.
- Cloud Run: uma plataforma de computação sem servidor que permite executar contêineres diretamente na infraestrutura escalonável do Google.
- Eventarc: uma solução sem servidor para rotear de forma assíncrona mensagens acionadas por eventos.
Considerações sobre o design
Nesta seção, descrevemos fatores de design, práticas recomendadas e recomendações de acordo com o Google Cloud Well-Architected Framework. Considere essas informações ao usar essa arquitetura de referência para desenvolver uma topologia que atenda aos seus requisitos específicos de segurança, confiabilidade, otimização de custos e eficiência operacional.
segurança, privacidade e conformidade
Para ajudar a proteger sua carga de trabalho de geração de podcasts e atender aos requisitos de privacidade e conformidade, considere as seguintes recomendações:
- Para verificar comandos, transcrições e scripts de podcast em busca de injeção de comandos, tentativas de jailbreak e conteúdo nocivo, use o Model Armor. Para detectar e encobrir informações de identificação pessoal (PII) em transcrições e rascunhos de scripts antes da síntese, use a Proteção de Dados Sensíveis.
- Para seguir o princípio de privilégio mínimo, atribua contas de serviço dedicadas do Identity and Access Management (IAM) ao gatilho do Eventarc e ao serviço do Cloud Run. Para restringir o acesso à rede a autores de chamadas e revisores autorizados, configure os controles de entrada do Cloud Run e exija a autenticação do IAM.
Confiabilidade
Para garantir um processamento confiável para comentários em formato longo e síntese de podcasts, considere as seguintes recomendações:
- Para transcrever gravações de comentários longos de maneira confiável, considere o processamento em lote assíncrono. Para mais informações, consulte Transcrever arquivos de áudio longos em texto.
- Para sintetizar episódios completos, divida os scripts em segmentos menores ou use a Síntese de Áudio Longo e armazene o áudio de saída no Cloud Storage.
- Como o Eventarc tenta novamente as entregas não confirmadas, o processamento síncrono de mídia de vários minutos em um gerenciador HTTP do Cloud Run pode causar tempos limite e trabalho duplicado. Para separar a entrega de eventos do processamento de longa duração, orquestre tarefas de várias etapas com o Workflows ou execute cargas de trabalho em lote em jobs do Cloud Run.
Otimização de custos
Para otimizar o custo de geração de scripts e sintetização de áudio de podcast, considere as seguintes recomendações:
- Quando os scripts de podcast não exigirem geração imediata, use a inferência em lote na plataforma de agentes. A inferência em lote processa grandes cargas de trabalho de transcrição de forma assíncrona a um custo menor do que a inferência on-line padrão.
- Para reduzir os custos de síntese na produção de podcasts em grande volume, escolha um modelo adequado com base nos seus requisitos na plataforma de agentes.
Eficiência operacional
Para simplificar o pipeline multimodal e a produção de áudio com vários locutores, considere as seguintes recomendações:
- Para simplificar o pipeline quando você não precisa de recursos especializados da Speech-to-Text, transmita URIs de áudio do Cloud Storage diretamente para o Gemini na plataforma de agentes. Com a compreensão de áudio multimodal, o Gemini pode analisar arquivos de áudio longos com compreensão de carimbo de data/hora e rascunhar scripts de podcast em uma única etapa. Mantenha a Speech-to-Text com modelos de transcrição especializados quando sua carga de trabalho exigir diarização de locutor em lote ou adaptação de modelo para nomes específicos de domínio.
- Para produzir podcasts de conversação com vários apresentadores sem ajustes complexos de SSML, use o Gemini TTS na plataforma de agentes. Se o aplicativo chamar a Text-to-Speech diretamente, você também poderá usar o Gemini TTS ou outras vozes de conversação para controle de voz natural. Para mais informações, consulte Vozes e idiomas compatíveis.
Implantação
Para testar o uso de produtos do Google Cloud em cargas de trabalho que envolvem formatos de entrada e saída multimodais, como áudio e texto, use os seguintes exemplos de código:
- Gerar uma transcrição de uma entrevista em áudio.
- Gerar um podcast com vários locutores usando o Gemini e a API Text-to-Speech.
- Gravar áudio e gerar uma tradução.
A seguir
- Confira mais guias de arquitetura de IA generativa.
- Para uma visão geral dos princípios e recomendações de arquitetura específicos para cargas de trabalho de IA e ML no Google Cloud, consulte a perspectiva de IA e ML no Well-Architected Framework.
- Para mais arquiteturas de referência, diagramas e práticas recomendadas, confira a Central de arquitetura do Cloud.
Colaboradores
Autor: Kumar Dhanagopal | Desenvolvedor de soluções de vários produtos
Outros colaboradores:
- Amina Mansour | Líder técnica, Relações globais com desenvolvedores e conteúdo estratégico
- Megan O'Keefe | Mediadora de desenvolvedores
- Samantha He | Redatora técnica
- Shir Meir Lador | Gerente de engenharia de relações com desenvolvedores