


Google Cloud Well-Architected Framework:金融服务 (FS) 视角中的本文档简要介绍了在 Google Cloud中设计、部署和运行可靠 FS 工作负载的原则和建议。本文档探讨了如何将高级可靠性实践和可观测性集成到架构蓝图中。本文档中的建议与 Well-Architected Framework 的可靠性核心保持一致。
对于金融机构而言,可靠且有弹性的基础设施既是业务需求,也是监管要求。为确保Google Cloud 中的 FS 工作负载可靠,您必须了解并缓解潜在故障点、冗余部署资源并规划恢复。运营弹性是可靠性的结果。它是指吸收、适应中断并从中恢复的能力。运营韧性可帮助金融服务组织满足严格的监管要求。这也有助于避免给客户带来无法容忍的伤害。
Google Cloud 中可靠性的关键基础组件是区域、可用区以及云资源的各种位置范围:可用区级、区域级、多区域级、全球级。您可以通过使用托管式服务、分配资源、实现高可用性模式和自动执行流程来提高可用性。
法规要求
金融服务组织必须遵守监管机构(例如美国的联邦储备系统、欧盟的欧洲银行管理局和英国的审慎监管局)制定的严格可靠性规定。全球监管机构都强调运营弹性,这对于金融稳定和消费者保护至关重要。运营弹性是指抵御中断、有效恢复和维持关键服务的能力。这需要采用统一的方法来管理技术风险和对第三方的依赖。
大多数司法管辖区的监管要求都有以下共同主题:
- 网络安全和技术弹性:加强对网络威胁的防御,确保 IT 系统的弹性。
- 第三方风险管理:管理与向信息和通信技术 (ICT) 提供商外包服务相关的风险。
- 业务连续性和突发事件响应:制定稳健的计划,以便在中断期间维持关键运营并有效恢复。
- 保护金融稳定:确保更广泛的金融体系的健全性和稳定性。
本文档中的可靠性建议与以下核心原则相对应:
优先考虑多可用区和多区域部署
对于关键金融服务应用,我们建议您使用多区域拓扑,该拓扑至少分布在两个区域,并且每个区域内有三个可用区。此方法对于应对可用区和区域服务中断非常重要。法规通常会规定这种方法,因为如果一个可用区或区域发生故障,大多数司法管辖区都会认为第二个可用区发生严重中断是可能的结果。其理由是,当一个位置发生故障时,另一个位置可能会收到异常高的额外流量。
请考虑以下建议,以增强对可用区和区域服务中断的弹性:
- 优先选择位置范围更广的资源。尽可能使用区域级资源(而非可用区级资源),并使用多区域级或全球级资源(而非区域级资源)。这种方法有助于避免使用备份来恢复操作。
- 在每个区域中,利用三个可用区,而不是两个。为了处理故障切换,请将容量超额预配为估算值的三分之一以上。
- 通过实施主动-主动部署(如以下示例)来最大限度地减少手动恢复步骤:
- Spanner 等分布式数据库提供内置的冗余和跨区域同步功能。
- Cloud SQL 的高可用性功能提供了一种接近双活的拓扑,其中包含跨可用区的只读副本。它在区域之间提供接近于 0 的恢复点目标 (RPO)。
- 使用 Cloud DNS 跨区域分布用户流量,并在每个区域中部署区域级负载均衡器。全球负载均衡器是您可以根据要求和关键性考虑的另一个选项。如需了解详情,请参阅多区域部署的全球负载均衡的优势和风险。
- 如需存储数据,请使用 Spanner 和 Cloud Storage 等多区域服务。
消除单点故障
将资源分布在不同位置,并使用冗余资源,以防止任何单点故障 (SPOF) 影响整个应用堆栈。
请考虑以下建议,以避免单点故障:
- 避免仅部署单个应用服务器或数据库。
- 使用托管式实例组 (MIG) 确保自动重新创建失败的虚拟机。
- 通过实施负载均衡,在可用资源之间均匀分配流量。
- 对数据库(例如 Cloud SQL)使用高可用性配置。
- 通过使用区域级永久性磁盘进行同步复制,提高数据可用性。
如需了解详情,请参阅在 Google Cloud中为工作负载设计可靠的基础设施。
了解和管理汇总可用性
请注意,系统的整体或汇总可用性受系统每个层级或组件的可用性影响。应用堆栈中的层级数与堆栈的总体可用性具有反向关系。请考虑以下有关管理汇总可用性的建议:
使用公式 tier1_availability × tier2_availability × tierN_availability 计算多层式堆栈的总体可用性。
下图展示了由四项服务组成的多层系统的总可用性计算:
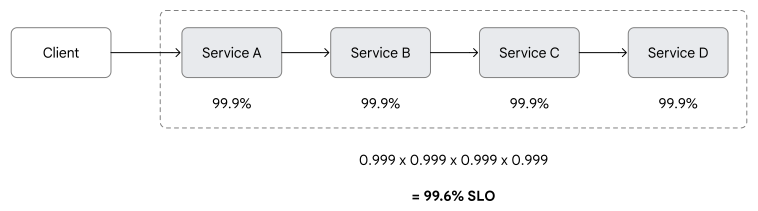
在上图中,每个层级中的服务都提供 99.9% 的可用性,但系统的总体可用性较低,为 99.6% (0.999 × 0.999 × 0.999 × 0.999)。一般来说,多层式堆栈的总体可用性低于提供最低可用性的层级的可用性。
在可行的情况下,选择并行化而非链式调用。对于并行化服务,端到端可用性高于每个单独服务的可用性。
下图展示了使用链式和并行化方法部署的两个服务 A 和 B:
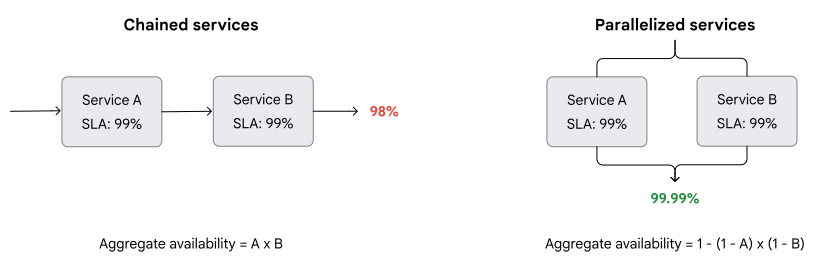
在前面的示例中,两项服务的 SLA 均为 99%,这会导致以下汇总可用性,具体取决于实现方法:
- 链式服务的总体可用性仅为 98% (.99 × .99)。
- 并行化服务可产生更高的总可用性 (99.99%),因为每个服务都独立运行,并且单个服务不受其他服务的可用性影响。聚合并行化服务的公式为 1 − (1 − A) × (1 − B)。
选择 Google Cloud 具有正常运行时间 SLA 的服务,这些服务可帮助您满足应用栈所需的整体正常运行时间水平。
在设计架构时,请考虑可用性、运营复杂性、延迟时间和费用之间的权衡。增加可用性“9”的数量通常会增加费用,但这样做有助于您满足监管要求。
例如,99.9% 的可用性(三个 9)意味着在 24 小时内可能停机 86 秒。相比之下,99%(两个 9)意味着同一时间段内的停机时间为 864 秒,是三个 9 可用性停机时间的 10 倍。
对于关键金融服务,架构选项可能有限。不过,确定可用性要求并准确计算可用性至关重要。执行此类评估有助于您评估设计决策对架构和预算的影响。
实施强大的灾难恢复策略
针对不同的灾难场景(包括可用区级和区域级服务中断)制定明确的计划。通过明确定义的灾难恢复 (DR) 策略,您可以从中断中恢复并恢复正常运营,同时最大限度地减少影响。
DR 和高可用性 (HA) 是不同的概念。对于云部署,灾难恢复通常适用于多区域部署,而高可用性适用于区域级部署。这些部署原型支持不同的复制机制。
- HA:默认情况下,许多托管式服务在单个区域内的可用区之间提供同步复制。此类服务支持零或接近零的恢复时间目标 (RTO) 和恢复点目标 (RPO)。此支持可让您创建没有任何 SPOF 的主动-主动部署拓扑。
- 灾难恢复:对于跨两个或更多区域部署的工作负载,如果您不使用多区域或全球服务,则必须定义复制策略。复制策略通常是异步的。 仔细评估此类复制对关键应用的 RTO 和 RPO 的影响。确定故障切换所需的手动或半自动操作。
对于金融机构,您对故障切换区域的选择可能会受到有关数据主权和数据驻留的法规的限制。如果您需要跨两个区域的主动-主动拓扑,我们建议您选择代管式多区域服务(例如 Spanner 和 Cloud Storage),尤其是在数据复制至关重要时。
请考虑以下建议:
- 使用托管式多区域存储服务来存储数据。
- 为永久性磁盘中的数据创建快照,并将快照存储在多区域位置。
- 使用可用区级或区域级资源时,请设置数据复制,将数据复制到其他区域。
- 定期测试灾难恢复计划,验证其是否有效。
- 请注意 RTO 和 RPO,以及它们与您所在管辖区的金融法规规定的影响容忍度的相关性。
如需了解详情,请参阅针对云基础设施服务中断设计灾难恢复架构。
利用托管式服务
尽可能使用托管式服务,以充分利用内置的备份、高可用性和可伸缩性功能。请考虑以下有关使用托管式服务的建议:
- 在 Google Cloud中使用托管式服务。它们提供由服务等级协议 (SLA) 支持的高可用性。它们还提供内置备份机制和弹性功能。
- 对于数据管理,请考虑使用 Cloud SQL、Cloud Storage 和 Spanner 等服务。
- 对于计算和应用托管,请考虑使用 Compute Engine 托管式实例组 (MIG) 和 Google Kubernetes Engine (GKE) 集群。区域 MIG 和 GKE 区域级集群能够灵活应对可用区服务中断。
- 如需提高应对区域级服务中断的弹性,请使用代管式多区域服务。
- 确定具有独特特征的服务是否需要退出计划,并制定所需的计划。FCA、PRA 和 EBA 等金融监管机构要求,如果与云服务提供商的关系终止,公司必须制定数据检索和运营连续性的策略和应急计划。公司必须在签订云合同之前评估退出可行性,并且必须保持在不中断运营的情况下更换提供商的能力。
- 验证您选择的服务是否支持将数据导出为 CSV、Parquet 和 Avro 等开放格式。验证服务是否基于开放技术,例如 GKE 对 Open Container Initiative (OCI) 格式或 Managed Service for Apache Airflow 的支持。
自动执行基础架构预配和恢复流程
Automation 有助于最大限度地减少人为错误,并有助于减少响应突发事件所需的时间和资源。使用自动化技术有助于确保更快地从故障中恢复,并获得更一致的结果。请考虑以下建议,以自动预配和恢复资源:
- 使用 Terraform 等基础设施即代码 (IaC) 工具,最大限度地减少人为错误。
- 通过自动执行故障切换流程来减少人工干预。自动化响应也有助于减少故障的影响。例如,您可以使用 Eventarc 或 Workflows 自动触发补救措施,以响应通过审核日志观察到的问题。
- 在故障切换期间,使用自动扩缩功能增加云资源的容量。
- 通过采用平台工程,在服务部署期间,在整个云拓扑中自动应用政策和护栏,以满足监管要求。