


Una plataforma de administración y análisis de datos empresariales proporciona un enclave en el que puedes almacenar, analizar y manipular información sensible mientras mantienes los controles de seguridad. Puedes usar la arquitectura de malla de datos empresarial para implementar una plataforma en Google Cloud para la administración y el análisis de datos. La arquitectura está diseñada para funcionar en un entorno híbrido, en el que los componentes de Google Cloud interactúan con tus componentes locales y procesos operativos existentes.
La arquitectura de malla de datos empresariales incluye lo siguiente:
- Un repositorio de GitHub
que contiene un conjunto de opciones de configuración, secuencias de comandos y código de Terraform para compilar
lo siguiente:
- Un proyecto de administración de datos que te permite usar la implementación de Google del framework de controles clave de Cloud Data Management Capabilities (CDMS).
- Un ejemplo de plataforma de datos que admite flujos de trabajo interactivos y de producción
- Un entorno de productor dentro de la plataforma de datos que admite varios dominios de datos. Los dominios de datos son agrupaciones lógicas de elementos de datos.
- Un entorno de consumidor dentro de la plataforma de datos que admite varios proyectos de consumidor.
- Es un servicio de transferencia de datos que usa la federación de identidades para cargas de trabajo y la biblioteca de encriptación Tink para ayudarte a transferir datos a Google Cloud de manera segura.
- Un ejemplo de dominio de datos que contiene proyectos de transferencia, no confidenciales y confidenciales.
- Un ejemplo de un sistema de acceso a los datos que permite que los consumidores de datos soliciten acceso a los conjuntos de datos y que los propietarios de los datos otorguen acceso a esos conjuntos de datos. En el ejemplo, también se incluye un administrador de flujos de trabajo que cambia los permisos de IAM de esos conjuntos de datos según corresponda.
- Una guía sobre la arquitectura, el diseño, los controles de seguridad y los procesos operativos que usas con esta arquitectura para implementar (este documento).
La arquitectura de malla de datos empresarial está diseñada para ser compatible con el plano de bases empresarial. El plano de base empresarial proporciona una serie de servicios de nivel base en los que se basa esta arquitectura, como las redes de VPC y el registro. Puedes implementar esta arquitectura sin implementar el plano de bases empresariales si tu entorno deGoogle Cloud proporciona la funcionalidad necesaria.
Este documento está dirigido a arquitectos de la nube, científicos de datos, ingenieros de datos y arquitectos de seguridad que pueden usar la arquitectura para compilar e implementar servicios de datos integrales en Google Cloud. En este documento,se supone que conoces los conceptos de mallas de datos, Google Cloud servicios de datos y la implementación de Google Cloud del framework de CDMC.
Arquitectura
La arquitectura de malla de datos empresarial adopta un enfoque por capas para proporcionar las capacidades que permiten la transferencia de datos, el procesamiento de datos y la administración. La arquitectura está diseñada para implementarse y controlarse a través de un flujo de trabajo de CI/CD. En el siguiente diagrama, se muestra cómo la capa de datos que implementa esta arquitectura se relaciona con otras capas de tu entorno.
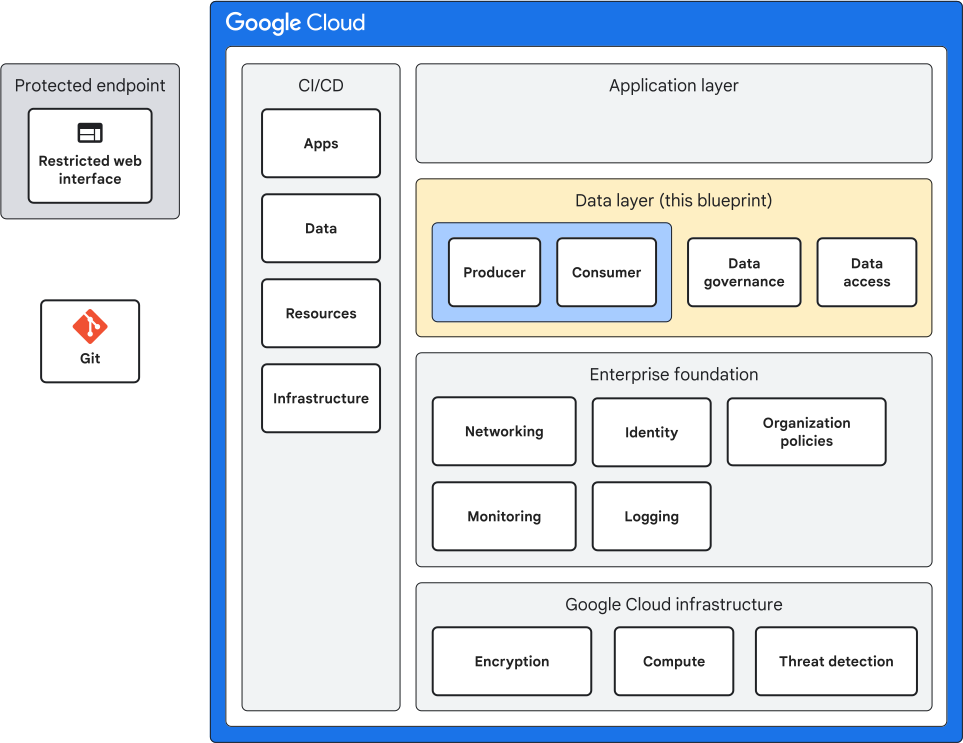
En este diagrama, se incluye lo siguiente:
- La infraestructura deGoogle Cloud proporciona funciones de seguridad, como la encriptación en reposo y la encriptación en tránsito, así como componentes básicos, como el procesamiento y el almacenamiento.
- La base empresarial proporciona un modelo de referencia de recursos, como los sistemas de identidad, herramientas de redes, registro, implementación y supervisión que te permiten adoptar Google Cloud para tus cargas de trabajo de datos.
- La capa de datos proporciona varias capacidades, como la transferencia de datos, el almacén de datos, el control de acceso a los datos, la administración de datos, la supervisión y el uso compartido de datos.
- La capa de aplicación representa varias aplicaciones diferentes que usan los recursos de la capa de datos.
- La CI/CD proporciona las herramientas para automatizar el aprovisionamiento, la configuración, la administración y la implementación de infraestructura, flujos de trabajo y componentes de software. Estos componentes te ayudan a garantizar implementaciones coherentes, confiables y auditables, a minimizar los errores manuales y a acelerar el ciclo de desarrollo general.
Para mostrar cómo se usa el entorno de datos, la arquitectura incluye un flujo de trabajo de datos de muestra. El flujo de trabajo de muestra de datos te guía por los siguientes procesos: administración de datos, transferencia de datos, procesamiento de datos, uso compartido de datos y consumo de datos.
Decisiones arquitectónicas clave
En la siguiente tabla, se resumen las decisiones de alto nivel de la arquitectura.
| Área de decisión | Decisión |
|---|---|
| Arquitectura deGoogle Cloud | |
Jerarquía de recursos |
La arquitectura usa la jerarquía de recursos del plano de bases empresariales. |
Redes |
La arquitectura incluye un servicio de transferencia de datos de ejemplo que usa la federación de identidades para cargas de trabajo y una biblioteca de Tink. |
Roles y permisos de IAM |
La arquitectura incluye roles segmentados de productor de datos, consumidor de datos, administración de datos y plataforma de datos. |
| Servicios de datos comunes | |
Metadatos |
La arquitectura usa Knowledge Catalog para administrar los metadatos de los datos. |
Administración central de políticas |
Para administrar las políticas, la arquitectura usa la implementación de Google Clouddel framework de CDMC. |
Administración de acceso a los datos |
Para controlar el acceso a los datos, la arquitectura incluye un proceso independiente que requiere que los consumidores de datos soliciten acceso a los recursos de datos al propietario de los datos. |
Calidad de los datos |
La arquitectura usa el motor de calidad de los datos de Cloud para definir y ejecutar reglas de calidad de los datos en columnas de tablas especificadas, lo que mide la calidad de los datos en función de métricas como la exactitud y la integridad. |
Seguridad de los datos |
La arquitectura usa etiquetado, encriptación, enmascaramiento, asignación de tokens y controles de IAM para proporcionar seguridad de los datos. |
| Dominio de datos | |
Entornos de datos |
La arquitectura incluye tres entornos. Dos entornos (no de producción y de producción) son entornos operativos que se controlan mediante canalizaciones. Un entorno (desarrollo) es un entorno interactivo. |
Propietarios de datos |
Los propietarios de datos transfieren, procesan, exponen y otorgan acceso a los recursos de datos. |
Consumidores de datos |
Los consumidores de datos solicitan acceso a los recursos de datos. |
| Incorporación y operaciones | |
Canalizaciones |
La arquitectura usa las siguientes canalizaciones para implementar recursos:
|
Repositorios |
Cada canalización usa un repositorio independiente para permitir la segregación de responsabilidades. |
Flujo de proceso |
El proceso requiere que los cambios en el entorno de producción incluyan un remitente y un responsable de aprobación. |
| Cloud Operations | |
Cuadros de evaluación de productos de datos |
El motor de informes genera cuadros de evaluación de productos de datos. |
Cloud Logging |
La arquitectura usa la infraestructura de registro del plano de bases empresariales. |
Cloud Monitoring |
La arquitectura usa la infraestructura de supervisión del plano de bases empresariales. |
Identidad: Asigna roles a grupos
La malla de datos aprovecha la arquitectura existente de administración del ciclo de vida de las identidades, autorización y autenticación del plano de bases empresariales. A los usuarios no se les asignan roles directamente. En su lugar, los grupos son el método principal de asignación de roles y permisos en IAM. Los roles y los permisos de IAM se asignan durante la creación del proyecto a través de la canalización de base.
La malla de datos asocia grupos con una de las cuatro áreas clave: infraestructura, administración de datos, productores de datos basados en dominios y consumidores basados en dominios.
Los permisos de estos grupos son los siguientes:
- El permiso del grupo de infraestructura es la malla de datos en su totalidad.
- El alcance de los permisos de los grupos de administración de datos es el proyecto de administración de datos.
- Los permisos de los productores y consumidores basados en dominios se limitan a su dominio de datos.
En las siguientes tablas, se muestran los diversos roles que se usan en esta implementación de malla de datos y sus permisos asociados.
Infraestructura
| Grupo | Descripción | Funciones |
|---|---|---|
|
Administradores generales de la malla de datos |
|
Administración de datos
| Grupo | Descripción | Funciones |
|---|---|---|
|
Administradores del proyecto de administración de datos |
|
|
Desarrolladores que crean y mantienen los componentes de administración de datos |
Múltiples roles en el proyecto de administración de datos, incluidos
|
|
Lectores de información de administración de datos |
|
|
Administradores de seguridad del proyecto de administración |
|
|
Grupo con permiso para usar tipos de aspectos |
|
|
Grupo con permiso para usar tipos de aspectos y agregar aspectos |
|
|
Grupo de cuentas de servicio para las notificaciones de Security Command Center |
Ninguno Este es un grupo para la membresía, y se crea una cuenta de servicio con este nombre, que tiene los permisos necesarios. |
Productores de datos basados en dominios
| Grupo | Descripción | Funciones |
|---|---|---|
|
Administradores de un dominio de datos específico |
|
|
Desarrolladores que compilan y mantienen productos de datos dentro de un dominio de datos |
Múltiples roles en el proyecto de dominio de datos, incluidos
|
|
Lectores de la información del dominio de datos |
|
|
Editores de entradas de Knowledge Catalog |
Roles para editar entradas de Knowledge Catalog |
|
Administradores de datos para el dominio de datos |
Roles para administrar los metadatos y los aspectos de la administración de datos |
Consumidores de datos basados en dominios
| Grupo | Descripción | Funciones |
|---|---|---|
|
Administradores de un proyecto de consumidor específico |
|
|
Desarrolladores que trabajan en un proyecto de consumidor |
Múltiples roles en el proyecto del consumidor, incluidos
los roles de |
|
Lectores de la información del proyecto de consumidor |
|
Estructura organizativa
Para diferenciar entre las operaciones de producción y los datos de producción, la arquitectura usa diferentes entornos para desarrollar y lanzar flujos de trabajo. Las operaciones de producción incluyen la administración, la trazabilidad y la repetibilidad de un flujo de trabajo, y la auditabilidad de los resultados del flujo de trabajo. Los datos de producción hacen referencia a los datos posiblemente sensibles que necesitas para dirigir tu organización. Todos los entornos están diseñados para tener controles de seguridad que te permitan transferir y operar tus datos.
Para ayudar a los científicos de datos y a los ingenieros, la arquitectura incluye un entorno interactivo, en el que los desarrolladores pueden trabajar con el entorno directamente y agregar servicios a través de un catálogo seleccionado de soluciones. Los entornos operativos se controlan a través de canalizaciones que tienen una arquitectura y una configuración codificadas.
Esta arquitectura usa la estructura organizativa del plano de bases empresarial como base para implementar cargas de trabajo de datos. En el siguiente diagrama, se muestran las carpetas y los proyectos de nivel superior que se usan en la arquitectura de malla de datos empresarial.
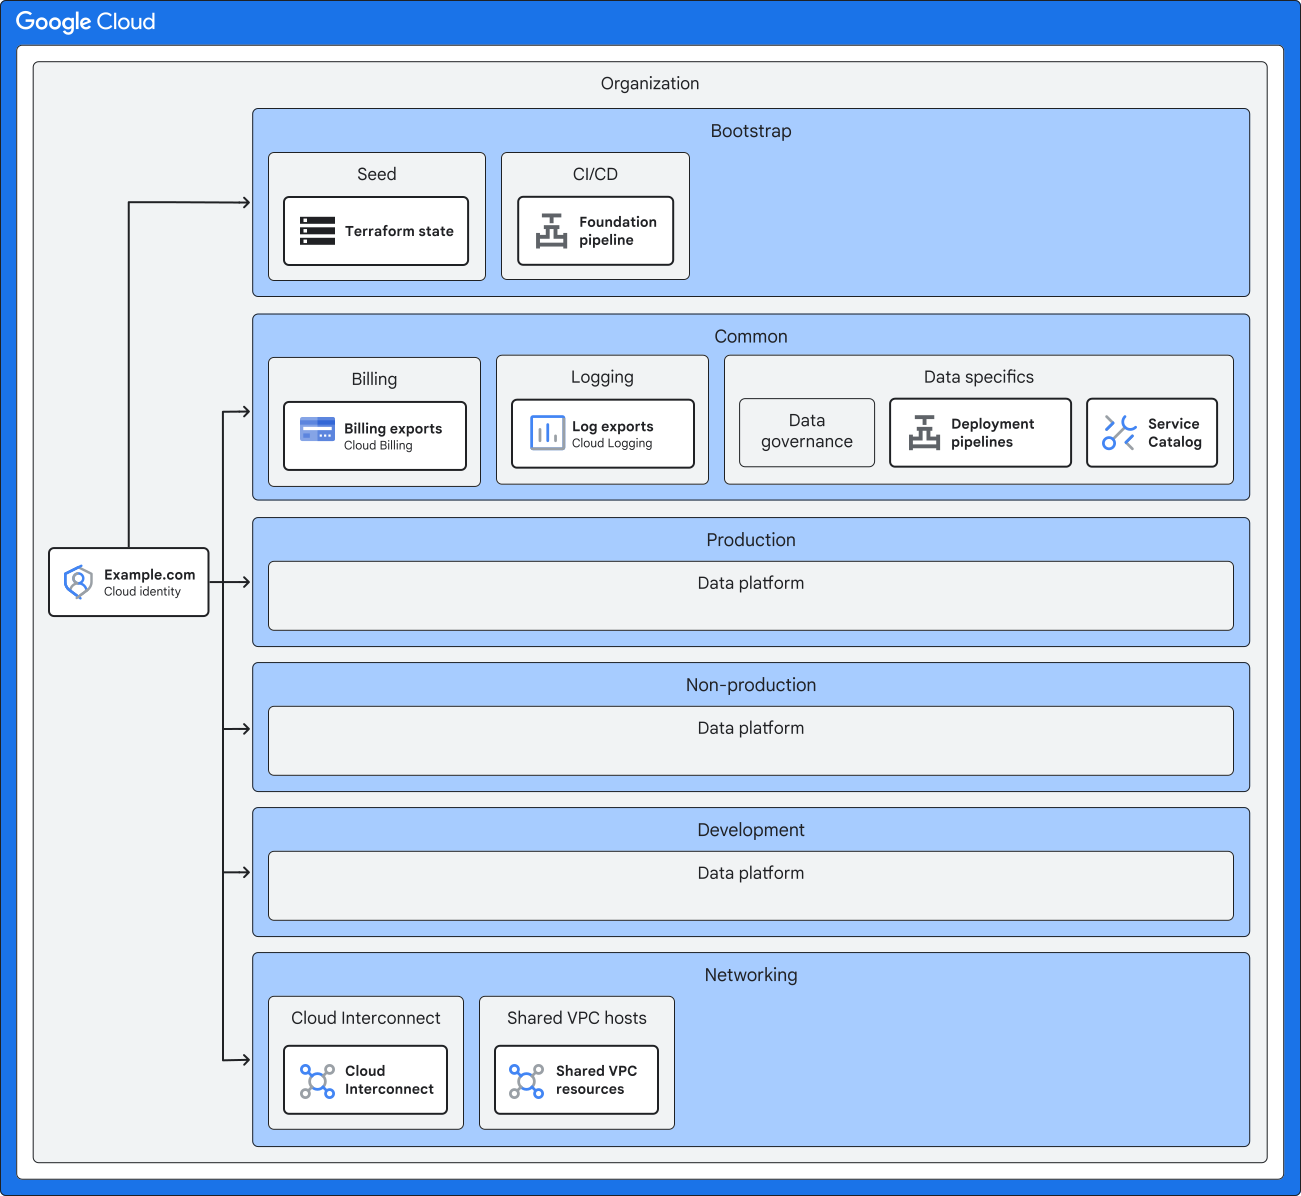
En la siguiente tabla, se describen las carpetas y los proyectos de nivel superior que forman parte de la arquitectura.
| Carpeta | Componente | Descripción |
|---|---|---|
|
|
Contiene la canalización de implementación que se usa para compilar los artefactos de código de la arquitectura. |
|
Contiene la infraestructura que usa el catálogo de servicios para implementar recursos en el entorno interactivo. |
|
|
Contiene todos los recursos que usa la implementación de Google Clouddel framework de CDMC. |
|
|
|
Contiene los proyectos y recursos de la plataforma de datos para desarrollar casos de uso en modo interactivo. |
|
|
Contiene los proyectos y recursos de la plataforma de datos para probar los casos de uso que deseas implementar en un entorno operativo. |
|
|
Contiene los proyectos y recursos de la plataforma de datos para la implementación en producción. |
Carpeta de la plataforma de datos
La carpeta de la plataforma de datos contiene todos los componentes del plano de datos y algunos de los recursos de CDMC. Además, la carpeta de la plataforma de datos y el proyecto de administración de datos contienen los recursos de CDMC. En el siguiente diagrama, se muestran las carpetas y los proyectos que se implementan en la carpeta de la plataforma de datos.
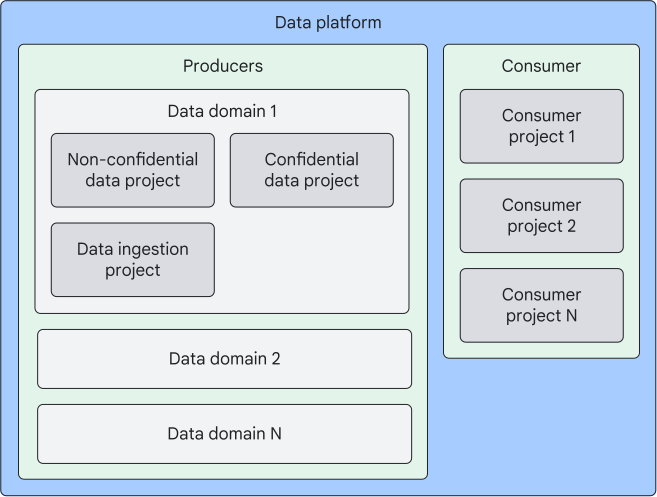
Cada carpeta de plataforma de datos incluye una carpeta de entorno (producción, no producción y desarrollo). En la siguiente tabla, se describen las carpetas dentro de cada carpeta de plataforma de datos.
| Carpetas | Descripción |
|---|---|
Productores |
Contiene los dominios de datos. |
Consumidores |
Contiene los proyectos de consumidor. |
Dominio de datos |
Contiene los proyectos asociados con un dominio en particular. |
Carpeta de productores
Cada carpeta de productores incluye uno o más dominios de datos. Un dominio de datos se refiere a una agrupación lógica de elementos de datos que comparten un significado, un propósito o un contexto empresarial comunes. Los dominios de datos te permiten categorizar y organizar los recursos de datos dentro de una organización. En el siguiente diagrama, se muestra la estructura de un dominio de datos. La arquitectura implementa proyectos en la carpeta de la plataforma de datos para cada entorno.
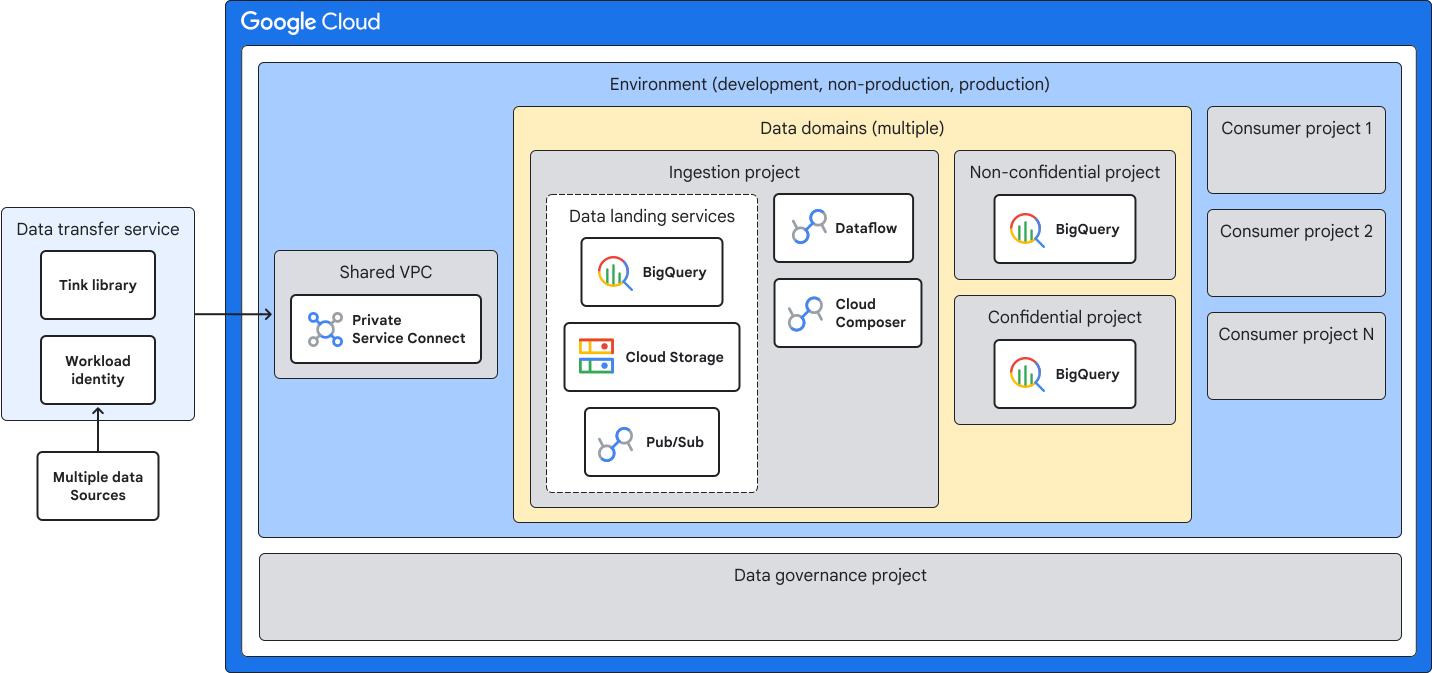
En la siguiente tabla, se describen los proyectos que se implementan en la carpeta de la plataforma de datos para cada entorno.
| Proyecto | Descripción |
|---|---|
Transferencia |
El proyecto de transferencia transfiere datos al dominio de datos. La arquitectura proporciona ejemplos de cómo puedes transmitir datos a BigQuery, Cloud Storage y Pub/Sub. El proyecto de transferencia también contiene ejemplos de Dataflow y Managed Service para Apache Airflow que puedes usar para organizar la transformación y el movimiento de los datos transferidos. |
No confidencial |
El proyecto no confidencial contiene datos que se desidentificaron. Puedes enmascarar, alojar en contenedores, encriptar, asignar tokens o ofuscar datos. Usa etiquetas de política para controlar cómo se presentan los datos. |
Confidencial |
El proyecto confidencial contiene datos en texto simple. Puedes controlar el acceso a través de los permisos de IAM. |
Carpeta de consumidor
La carpeta de consumidor contiene proyectos de consumidor. Los proyectos de consumidor proporcionan un mecanismo para segmentar a los usuarios de datos según el límite de confianza que se requiere. Cada proyecto se asigna a un grupo de usuarios independiente y se le asigna acceso a los recursos de datos requeridos proyecto por proyecto. Puedes usar el proyecto de consumidor para recopilar, analizar y aumentar los datos del grupo.
Carpeta común
La carpeta común contiene los servicios que usan diferentes entornos y proyectos. En esta sección, se describen las capacidades que se agregan a la carpeta común para habilitar la malla de datos empresariales.
Arquitectura de CDMC
La arquitectura usa la arquitectura de CDMC para la administración de datos. Las funciones de administración de datos residen en el proyecto de administración de datos en la carpeta común. En el siguiente diagrama, se muestran los componentes de la arquitectura de CDMC. Los números en el diagrama representan los controles clave que se abordan con los servicios de Google Cloud.
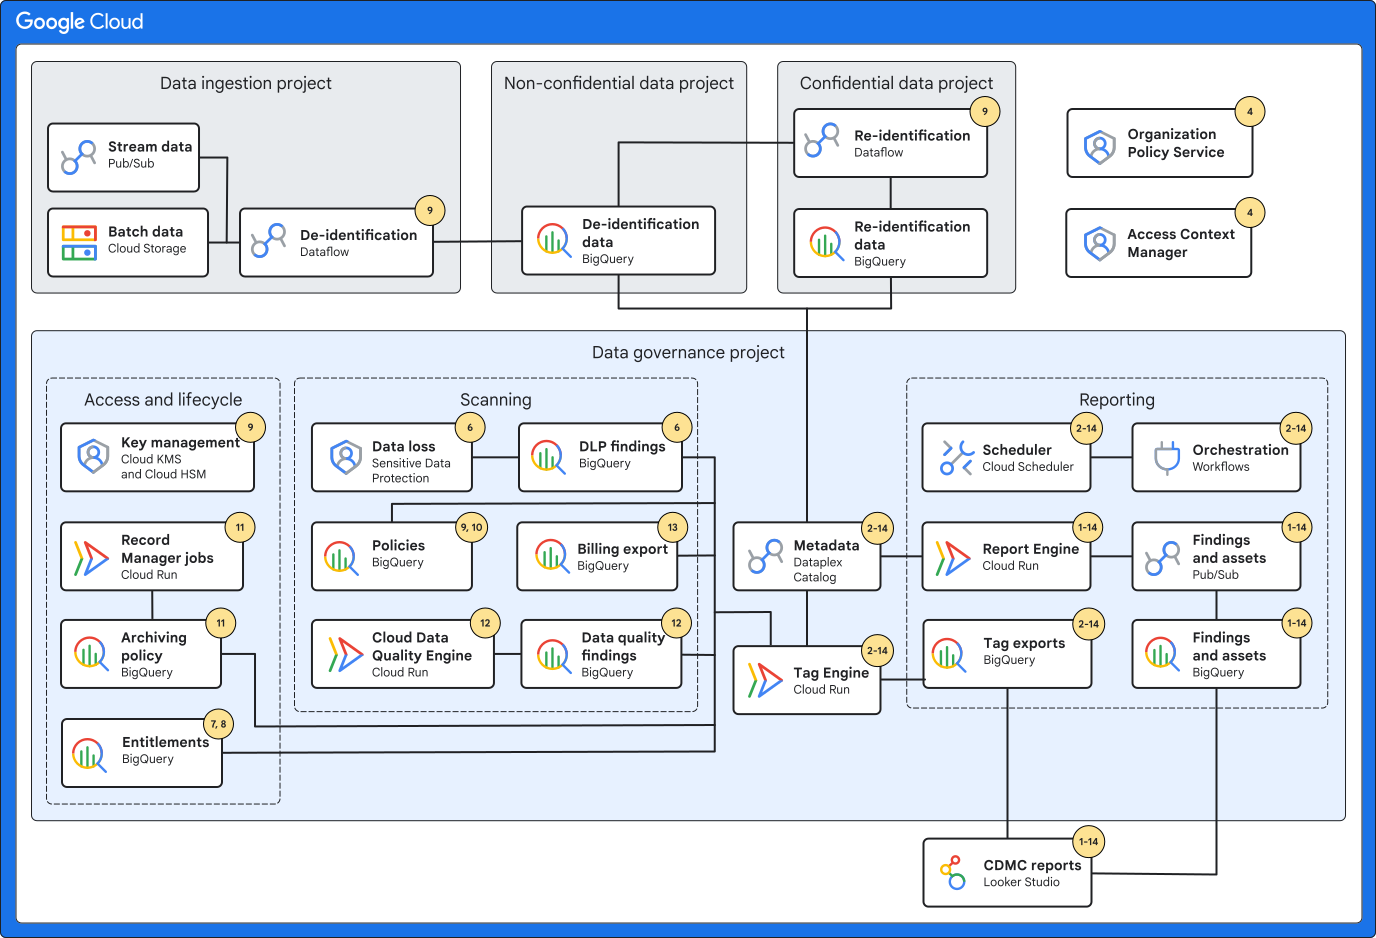
En la siguiente tabla, se describen los componentes de la arquitectura de CDMC que usa la arquitectura de malla de datos empresarial.
| Componente de CDMC | Servicio deGoogle Cloud | Descripción |
|---|---|---|
| Componentes de acceso y ciclo de vida | ||
Administración de claves |
Cloud KMS |
Es un servicio que administra de forma segura las claves de encriptación que protegen los datos sensibles. |
Administrador de registros |
Cloud Run |
Es una aplicación que mantiene registros completos de las actividades de procesamiento de datos, lo que garantiza que las organizaciones puedan hacer un seguimiento y auditar el uso de los datos. |
Política de archivado |
BigQuery |
Es una tabla de BigQuery que contiene la política de almacenamiento de datos. |
Autorizaciones |
BigQuery |
Una tabla de BigQuery que almacena información sobre quién puede acceder a los datos sensibles. Esta tabla garantiza que solo los usuarios autorizados puedan acceder a datos específicos según sus roles y privilegios. |
| Componentes de análisis | ||
Pérdida de datos |
Sensitive Data Protection |
Es el servicio que se usa para inspeccionar los recursos en busca de datos sensibles. |
Hallazgos de DLP |
BigQuery |
Es una tabla de BigQuery que cataloga las clasificaciones de datos dentro de la plataforma de datos. |
Políticas |
BigQuery |
Una tabla de BigQuery que contiene prácticas coherentes de administración de datos (por ejemplo, tipos de acceso a los datos). |
Exportación de la facturación |
BigQuery |
Es una tabla que almacena la información de costos que se exporta desde la Facturación de Cloud para habilitar el análisis de las métricas de costos que se asocian con los recursos de datos. |
Cloud Data Quality Engine |
Cloud Run |
Es una aplicación que ejecuta verificaciones de calidad de los datos para tablas y columnas. |
Hallazgos de la calidad de los datos |
BigQuery |
Es una tabla de BigQuery que registra las discrepancias identificadas entre las reglas de calidad de los datos definidas y la calidad real de los recursos de datos. |
| Componentes de informes | ||
Programador |
Cloud Scheduler |
Es un servicio que controla cuándo se ejecuta Cloud Data Quality Engine y cuándo se produce la inspección de Sensitive Data Protection. |
Motor de informes |
Cloud Run |
Es una aplicación que genera informes que ayudan a hacer un seguimiento y medir el cumplimiento de los controles del framework de CDMC. |
Hallazgos y recursos |
BigQuery y Pub/Sub |
Un informe de BigQuery de discrepancias o incoherencias en los controles de administración de datos, como aspectos faltantes, clasificaciones incorrectas o ubicaciones de almacenamiento que no cumplen con los requisitos. |
Exportaciones de etiquetas |
BigQuery |
Es una tabla de BigQuery que contiene información de aspectos extraída de Knowledge Catalog. |
| Otros componentes | ||
Administración de políticas |
Servicio de políticas de la organización |
Es un servicio que define y aplica restricciones sobre dónde se pueden almacenar los datos geográficamente. |
Políticas de acceso basadas en atributos |
Access Context Manager |
Es un servicio que define y aplica políticas de acceso detalladas y basadas en atributos para que solo los usuarios autorizados de ubicaciones y dispositivos permitidos puedan acceder a la información sensible. |
Metadatos |
Knowledge Catalog |
Es un servicio que almacena información de metadatos sobre las tablas que se usan en la malla de datos. |
Tag Engine |
Cloud Run |
Una aplicación que agrega aspectos a las entradas de tablas de BigQuery en Knowledge Catalog. |
Informes de CDMC |
Data Studio |
Paneles que permiten que tus analistas vean los informes que generaron los motores de la arquitectura de CDMC. |
Implementación de CDMC
En la siguiente tabla, se describe cómo la arquitectura implementa los controles clave en el framework de CDMC.
| Requisito del control de CDMC | Implementación |
|---|---|
El motor de informes detecta los recursos de datos que no cumplen con los requisitos y publica los hallazgos en un tema de Pub/Sub. Estos hallazgos también se cargan en BigQuery para generar informes con Data Studio. |
|
Se establece la propiedad de los datos migrados y generados por la nube |
Knowledge Catalog captura automáticamente los metadatos técnicos de BigQuery. Tag Engine aplica aspectos de metadatos empresariales, como el nombre del propietario y el nivel de sensibilidad, desde una tabla de referencia, lo que ayuda a garantizar que todos los datos sensibles se anoten con la información del propietario para el cumplimiento. Este proceso automatizado ayuda a proporcionar administración de datos y cumplimiento, ya que identifica y etiqueta los datos sensibles con la información del propietario adecuada. |
La automatización y la obtención y el consumo de datos se rigen por la automatización. |
Knowledge Catalog clasifica los recursos de datos anotándolos con
un aspecto que incluye una marca |
Se administra la soberanía de los datos y el movimiento de datos entre límites |
El servicio de políticas de la organización define las regiones de almacenamiento permitidas para los recursos de datos, y Access Context Manager restringe el acceso según la ubicación del usuario. Knowledge Catalog almacena las ubicaciones de almacenamiento aprobadas como aspectos de metadatos. El motor de informes compara estos aspectos con la ubicación real de los recursos de datos en BigQuery y publica cualquier discrepancia como hallazgos con Pub/Sub. Security Command Center proporciona una capa adicional de supervisión, ya que genera hallazgos de vulnerabilidades si se accede a los datos o se almacenan fuera de las políticas definidas. |
Knowledge Catalog almacena y actualiza los metadatos técnicos de todos los recursos de datos de BigQuery, lo que crea de forma eficaz un Data Catalog sincronizado de forma continua. Knowledge Catalog garantiza que las tablas y vistas nuevas o modificadas se agreguen de inmediato al catálogo, lo que mantiene un inventario actualizado de los recursos de datos. |
|
La protección de datos sensibles inspecciona los datos de BigQuery y, luego, identifica los tipos de información sensible. Luego, estos hallazgos se clasifican según una tabla de referencia de clasificación, y el nivel de sensibilidad más alto se asigna como un aspecto en Knowledge Catalog a nivel de columna y tabla. Tag Engine administra este proceso actualizando Knowledge Catalog con aspectos de sensibilidad cada vez que se agregan recursos de datos nuevos o se modifican los existentes. Este proceso garantiza una clasificación de datos actualizada de forma constante según la sensibilidad, que puedes supervisar y de la que puedes informar con Pub/Sub y herramientas de informes integradas. |
|
Los derechos de datos se administran y se aplican, y se hace un seguimiento de ellos |
Las etiquetas de política de BigQuery controlan el acceso a los datos sensibles a nivel de columna, lo que garantiza que solo los usuarios autorizados puedan acceder a datos específicos según la etiqueta de política asignada. IAM administra el acceso general al almacén de datos, mientras que Knowledge Catalog almacena las clasificaciones de sensibilidad. Se realizan verificaciones periódicas para garantizar que todos los datos sensibles tengan las etiquetas de política correspondientes, y las discrepancias se informan con Pub/Sub para su corrección. |
Se administra el acceso, el uso y los resultados éticos de los datos |
Los acuerdos de uso compartido de datos para proveedores y consumidores se almacenan en un almacén de datos de BigQuery dedicado para controlar los propósitos de consumo. Knowledge Catalog etiqueta los recursos de datos con la información del acuerdo del proveedor, mientras que los acuerdos del consumidor se vinculan a las vinculaciones de IAM para el control de acceso. Las etiquetas de consulta aplican los propósitos de consumo, lo que requiere que los consumidores especifiquen un propósito válido cuando consultan datos sensibles, que se validan con sus derechos en BigQuery. Un registro de auditoría en BigQuery hace un seguimiento de todo el acceso a los datos y garantiza el cumplimiento de los acuerdos de uso compartido de datos. |
La encriptación en reposo predeterminada de Google ayuda a proteger los datos que se almacenan en el disco. Cloud KMS admite claves de encriptación administradas por el cliente (CMEK) para mejorar la administración de claves. BigQuery implementa el enmascaramiento dinámico de datos a nivel de columna para la desidentificación y admite la desidentificación a nivel de aplicación durante la transferencia de datos. Knowledge Catalog almacena aspectos de metadatos para las técnicas de encriptación y desidentificación que se aplican a los recursos de datos. Las verificaciones automatizadas garantizan que los métodos de encriptación y desidentificación se alineen con las políticas de seguridad predefinidas, y que las discrepancias se informen como hallazgos con Pub/Sub. |
|
Hay un marco de trabajo de privacidad de datos definido y operativo |
Knowledge Catalog anota los recursos de datos sensibles con aspectos que contienen información relevante para la evaluación de impacto, como la ubicación del sujeto y los vínculos a los informes de evaluación. Tag Engine aplica estos aspectos según la sensibilidad de los datos y una tabla de políticas en BigQuery, que define los requisitos de evaluación según la residencia de los datos y los sujetos. Este proceso automatizado permite supervisar y generar informes de forma continua sobre el cumplimiento de los requisitos de evaluación de impacto, lo que garantiza que se realicen evaluaciones de impacto de protección de datos (DPIA) o evaluaciones de impacto de protección (PIA) cuando sea necesario. |
El ciclo de vida de los datos está planificado y administrado |
Knowledge Catalog etiqueta los recursos de datos con políticas de retención, especifica los períodos de retención y las acciones de vencimiento (como archivar o borrar). El Administrador de registros automatiza la aplicación de estas políticas purgando o archivando las tablas de BigQuery según los aspectos definidos. Esta aplicación de medidas garantiza el cumplimiento de las políticas del ciclo de vida de los datos y mantiene el cumplimiento de los requisitos de retención de datos, con cualquier discrepancia detectada y notificada a través de Pub/Sub. |
Cloud Data Quality Engine define y ejecuta reglas de calidad de los datos en columnas de tablas especificadas, lo que mide la calidad de los datos en función de métricas como la exactitud y la integridad. Los resultados de estas verificaciones, incluidos los porcentajes de éxito y los umbrales, se almacenan como aspectos en Knowledge Catalog. Almacenar estos resultados permite supervisar y generar informes de forma continua sobre la calidad de los datos, y cualquier problema o desviación de los umbrales aceptables se publica como hallazgo con Pub/Sub. |
|
Se establecen y aplican principios de administración de costos |
Knowledge Catalog almacena métricas relacionadas con los costos de los recursos de datos, como los costos de consultas, de almacenamiento y de salida de datos, que se calculan con los datos de facturación exportados de la Facturación de Cloud a BigQuery. Almacenar métricas relacionadas con los costos permite realizar un seguimiento y un análisis exhaustivos de los costos, lo que garantiza el cumplimiento de las políticas de costos y el uso eficiente de los recursos, y cualquier anomalía se informa con Pub/Sub. |
Las funciones integradas de linaje de datos de Knowledge Catalog hacen un seguimiento de la procedencia y el linaje de los recursos de datos, y representan visualmente el flujo de datos. Además, las secuencias de comandos de transferencia de datos identifican y registran la fuente original de los datos como un aspecto en Knowledge Catalog, lo que mejora la trazabilidad de los datos hasta su origen. |
Administración de acceso a los datos
El acceso a los datos de la arquitectura se controla a través de un proceso independiente que separa el control operativo (por ejemplo, la ejecución de trabajos de Dataflow) del control de acceso a los datos. El acceso de un usuario a un servicio de Google Cloud se define por una preocupación ambiental u operativa, y un grupo de ingeniería de la nube lo aprovisiona y aprueba. El acceso de un usuario a los recursos de datos de Google Cloud (por ejemplo, una tabla de BigQuery) es una preocupación de privacidad, reglamentaria o de administración, y está sujeto a un acuerdo de acceso entre las partes productoras y consumidoras, y se controla a través de los siguientes procesos. En el siguiente diagrama, se muestra cómo se aprovisiona el acceso a los datos a través de la interacción de diferentes componentes de software.
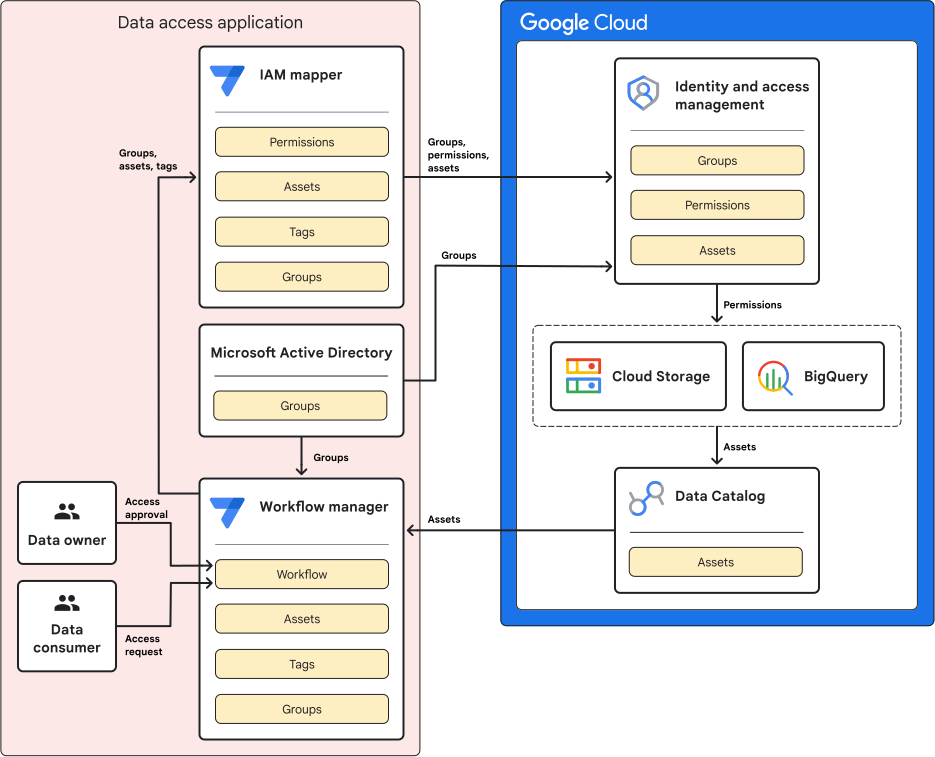
Como se muestra en el diagrama anterior, la incorporación de los accesos a los datos se controla con los siguientes procesos:
- Knowledge Catalog recopila y hace un inventario de los recursos de datos de la nube.
- El administrador de flujos de trabajo recupera los recursos de datos de Knowledge Catalog.
- Los propietarios de los datos se incorporan al administrador de flujos de trabajo.
El funcionamiento de la administración de acceso a los datos es el siguiente:
- Un consumidor de datos realiza una solicitud para un recurso específico.
- El propietario de los datos del recurso recibe una alerta sobre la solicitud.
- El propietario de los datos aprueba o rechaza la solicitud.
- Si se aprueba la solicitud, el administrador de flujo de trabajo pasa el grupo, el recurso y la etiqueta asociada al asignador de IAM.
- El asignador de IAM traduce las etiquetas del administrador de flujos de trabajo en permisos de IAM y otorga al grupo especificado permisos de IAM para el recurso de datos.
- Cuando un usuario quiere acceder al recurso de datos, IAM evalúa el acceso al recurso de Google Cloud en función de los permisos del grupo.
- Si se permite, el usuario accede al activo de datos.
Redes
El proceso de seguridad de los datos se inicia en la aplicación de origen, que puede residir de forma local o en otro entorno externo al proyecto deGoogle Cloud de destino. Antes de que se produzca cualquier transferencia de red, esta aplicación usa la federación de identidades para cargas de trabajo para autenticarse de forma segura en las API de Cloud de Google. Con estas credenciales, interactúa con Cloud KMS para obtener o unir las claves necesarias y, luego, emplea la biblioteca de Tink para realizar la encriptación y desidentificación iniciales en la carga útil de datos sensibles según las plantillas predefinidas.
Después de que se protege la carga útil de datos, esta se debe transferir de forma segura al proyecto de transferencia de Google Cloud . Para las aplicaciones locales, puedes usar Cloud Interconnect o, posiblemente, Cloud VPN. Dentro de la red deGoogle Cloud , usa Private Service Connect para enrutar los datos hacia el extremo de transferencia dentro de la red de VPC del proyecto de destino. Private Service Connect permite que la aplicación de origen se conecte a las APIs de Google con direcciones IP privadas, lo que garantiza que el tráfico no se exponga a Internet.
Toda la ruta de red y los servicios de transferencia de destino (Cloud Storage, BigQuery y Pub/Sub) dentro del proyecto de transferencia están protegidos por un perímetro de Controles del servicio de VPC. Este perímetro aplica un límite de seguridad, lo que garantiza que los datos protegidos que se originan en la fuente solo se puedan transferir a los servicios de Google Cloud autorizados dentro de ese proyecto específico.
Logging
Esta arquitectura usa las capacidades de Cloud Logging que proporciona el plano de bases empresariales.
Canalizaciones
La arquitectura de malla de datos empresarial usa una serie de canalizaciones para aprovisionar la infraestructura, la organización, los conjuntos de datos, las canalizaciones de datos y los componentes de la aplicación. Las canalizaciones de implementación de recursos de la arquitectura usan Terraform como la herramienta de infraestructura como código (IaC) y Cloud Build como el servicio de CI/CD para implementar las opciones de configuración de Terraform en el entorno de la arquitectura. En el siguiente diagrama, se muestra la relación entre las canalizaciones.
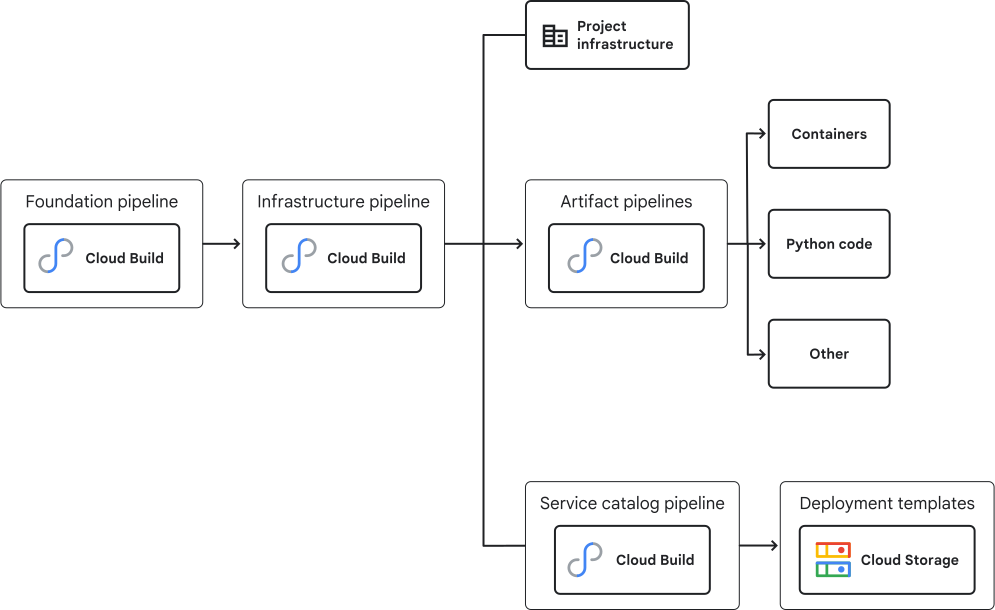
La canalización de base y la canalización de infraestructura forman parte del plano de bases empresariales. En la siguiente tabla, se describe el propósito de las canalizaciones y los recursos que aprovisionan.
| Canalización | Aprovisionado por | Recursos |
|---|---|---|
Canalización base |
Arranque |
|
Canalización de infraestructura |
Canalización base |
|
Canalización del Catálogo de servicios |
Canalización de infraestructura |
|
Canalizaciones de artefactos |
Canalización de infraestructura |
Las canalizaciones de artefactos producen los diversos contenedores y otros componentes de la base de código que usa la malla de datos. |
Cada canalización tiene su propio conjunto de repositorios de los que extrae archivos de código y configuración. Cada repositorio tiene una separación de funciones en la que los remitentes y las aprobaciones de las implementaciones de código operativo son responsabilidad de diferentes grupos.
Implementación interactiva a través del catálogo de servicios
Los entornos interactivos son el entorno de desarrollo dentro de la arquitectura y existen en la carpeta de desarrollo. La interfaz principal del entorno interactivo es el Catálogo de servicios, que permite a los desarrolladores usar plantillas preconfiguradas para crear instancias de los servicios de Google. Estas plantillas preconfiguradas se conocen como plantillas de servicio. Las plantillas de servicio te ayudan a aplicar tu postura de seguridad, como hacer que la encriptación de CMEK sea obligatoria, y también evitan que los usuarios tengan acceso directo a las APIs de Google.
En el siguiente diagrama, se muestran los componentes del entorno interactivo y cómo los científicos de datos implementan los recursos.
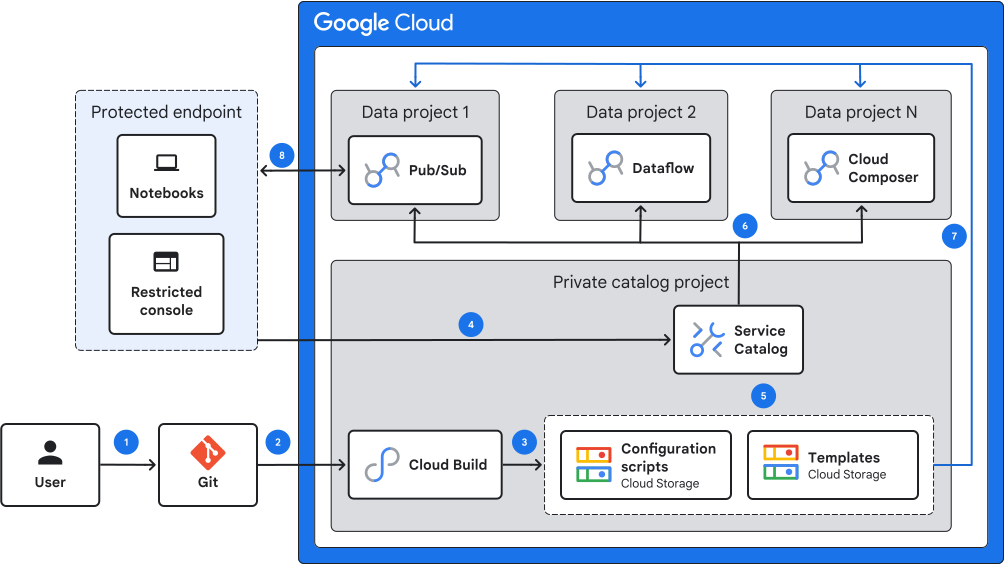
Para implementar recursos con el catálogo de servicios, se realizan los siguientes pasos:
- El ingeniero de MLOps coloca una plantilla de recursos de Terraform para Google Cloud en un repositorio de Git.
- El comando de confirmación de Git activa una canalización de Cloud Build.
- Cloud Build copia la plantilla y los archivos de configuración asociados en Cloud Storage.
- El ingeniero de MLOps configura el catálogo de servicios y las soluciones de este de forma manual. Luego, el ingeniero comparte el catálogo de servicios con un proyecto de servicio en el entorno interactivo.
- El científico de datos selecciona un recurso del catálogo de servicios.
- El catálogo de servicios implementa la plantilla en el entorno interactivo.
- El recurso extrae todas las secuencias de comandos de configuración necesarias.
- El científico de datos interactúa con los recursos.
Canalizaciones de artefactos
El proceso de transferencia de datos usa Managed Airflow y Dataflow para organizar el movimiento y la transformación de datos dentro del dominio de datos. La canalización de artefactos compila todos los recursos necesarios para la transferencia de datos y los traslada a la ubicación adecuada para que los servicios accedan a ellos. La canalización de artefactos crea los artefactos de contenedor que usa el organizador.
Controles de seguridad
La arquitectura de malla de datos empresarial usa un modelo de seguridad de defensa en profundidad en capas que incluye funciones predeterminadas de Google Cloud , servicios de Google Cloudy capacidades de seguridad que se configuran a través del plano de base empresarial. En el siguiente diagrama, se muestran las capas de los diversos controles de seguridad de la arquitectura.
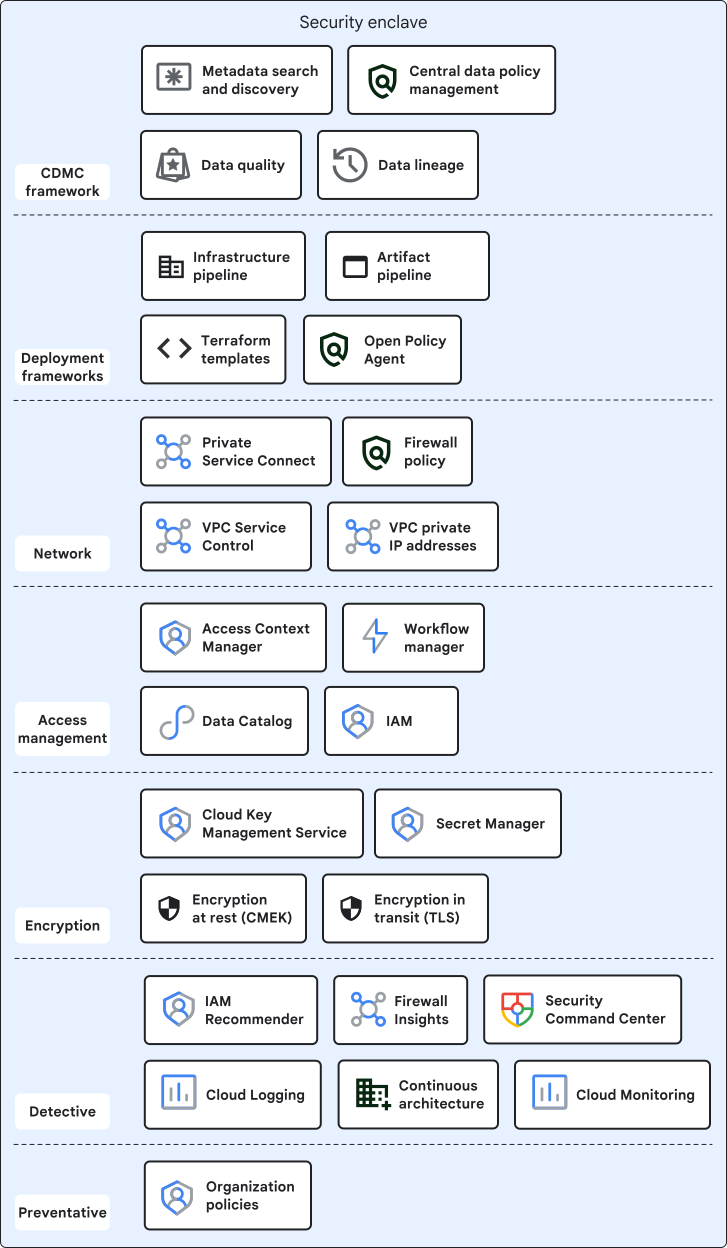
En la siguiente tabla, se describen los controles de seguridad asociados con los recursos de cada capa.
| Capa | Recurso | Control de seguridad |
|---|---|---|
Framework de CDMC |
Google Cloud Implementación de CDMC |
Proporciona un framework de administración que ayuda a proteger, administrar y controlar tus recursos de datos. Consulta el framework de controles clave de CDMC para obtener más información. |
Implementación |
Canalización de infraestructura |
Proporciona una serie de canalizaciones que implementan infraestructura, compilan contenedores y crean canalizaciones de datos. El uso de canalizaciones permite la auditabilidad, la trazabilidad y la repetibilidad. |
Canalización de artefactos |
Implementa varios componentes que no implementa la canalización de infraestructura. |
|
Plantillas de Terraform |
Crea la infraestructura del sistema. |
|
Open Policy Agent |
Ayuda a garantizar que la plataforma cumpla con las políticas seleccionadas. |
|
Red |
Private Service Connect |
Proporciona protecciones contra el robo de datos en torno a los recursos de la arquitectura en la capa de la API y la capa de IP. Te permite comunicarte con las APIs de Google Cloud mediante direcciones IP privadas para que puedas evitar exponer el tráfico a Internet. |
Red de VPC con direcciones IP privadas |
Ayuda a eliminar la exposición a amenazas de Internet. |
|
Controles del servicio de VPC |
Ayuda a proteger los recursos sensibles contra el robo de datos. |
|
Firewall |
Ayuda a proteger la red de VPC contra el acceso no autorizado. |
|
Administración de acceso |
Access Context Manager |
Controla quién puede acceder a qué recursos y ayuda a evitar el uso no autorizado de los recursos. |
Federación de identidades para cargas de trabajo |
Quita la necesidad de credenciales externas para transferir datos a la plataforma desde entornos locales. |
|
Knowledge Catalog |
Proporciona un índice de los recursos disponibles para los usuarios. |
|
IAM |
Proporciona acceso detallado. |
|
Encriptación |
Cloud KMS |
Te permite administrar tus claves de encriptación y Secrets, y ayudar a proteger tus datos a través de la encriptación en reposo y en tránsito. |
Secret Manager |
Proporciona un almacén de secretos que controla IAM para las canalizaciones. |
|
Encriptación en reposo |
De forma predeterminada, Google Cloud encripta los datos en reposo. |
|
Encriptación en tránsito |
De forma predeterminada, Google Cloud encripta los datos en tránsito. |
|
De detección |
Security Command Center |
Te ayuda a detectar parámetros de configuración incorrectos y actividad maliciosa en tu organización de Google Cloud. |
Arquitectura continua |
Verifica de forma continua tu organización de Google Cloud en función de una serie de políticas de OPA que hayas definido. |
|
Recomendador de IAM |
Analiza los permisos del usuario y proporciona sugerencias sobre la reducción de permisos para ayudar a aplicar el principio de privilegio mínimo. |
|
Estadísticas de firewall |
Analiza las reglas de firewall, identifica reglas de firewall demasiado permisivas y sugiere firewalls más restrictivos para ayudarte a fortalecer tu postura de seguridad general. |
|
Cloud Logging |
Proporciona visibilidad de la actividad del sistema y ayuda a habilitar la detección de anomalías y actividad maliciosa. |
|
Cloud Monitoring |
Realiza un seguimiento de los indicadores y eventos clave que pueden ayudar a identificar actividad sospechosa. |
|
Preventivo |
Política de la organización |
Te permite controlar y restringir acciones dentro de tu organización de Google Cloud. |
Workflows
En las siguientes secciones, se describen el flujo de trabajo del productor de datos y el flujo de trabajo del consumidor de datos, lo que garantiza controles de acceso adecuados según la sensibilidad de los datos y los roles de los usuarios.
Flujo de trabajo del productor de datos
En el siguiente diagrama, se muestra cómo se protegen los datos cuando se transfieren a BigQuery.
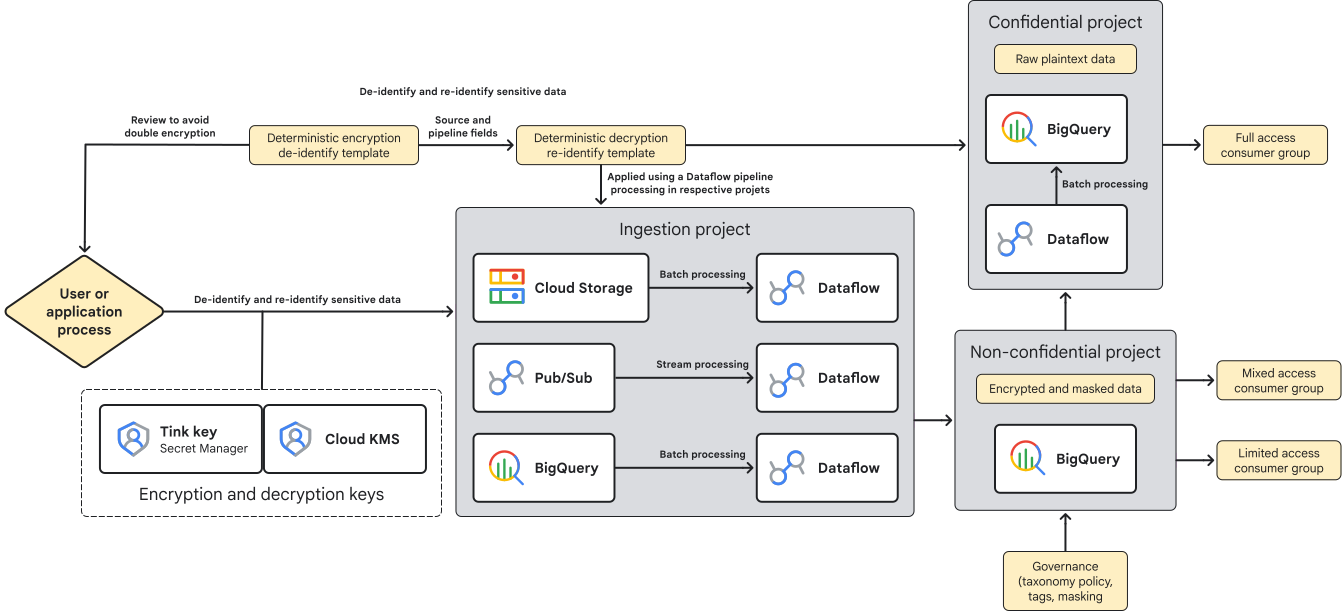
El flujo de trabajo para la transferencia de datos es el siguiente:
- Una aplicación que se integra en la federación de identidades para cargas de trabajo usa Cloud KMS para desencriptar una clave de encriptación unida.
- La aplicación usa la biblioteca de Tink para desidentificar o encriptar los datos con una plantilla.
- La aplicación transfiere datos al proyecto de transferencia en Google Cloud.
- Los datos llegan a Cloud Storage, BigQuery o Pub/Sub.
- En el proyecto de transferencia, los datos se desencriptan o se vuelven a identificar con una plantilla.
- Los datos desencriptados se encriptan o enmascaran según otra plantilla de desidentificación y, luego, se colocan en el proyecto no confidencial. Tag Engine aplica los aspectos y las etiquetas de política según corresponda.
- Los datos del proyecto no confidencial se transfieren al proyecto confidencial y se vuelven a identificar.
Se permite el siguiente acceso a los datos:
- Los usuarios que tienen acceso al proyecto confidencial pueden acceder a todos los datos de texto sin formato sin procesar.
- Los usuarios que tienen acceso al proyecto no confidencial pueden acceder a los datos enmascarados, con asignación de token o encriptados según las etiquetas de política asociadas con los datos y sus permisos.
Flujo de trabajo del consumidor de datos
En los siguientes pasos, se describe cómo un consumidor puede acceder a los datos almacenados en BigQuery.
- El consumidor de datos busca recursos de datos con Knowledge Catalog.
- Después de que el consumidor encuentra los recursos que busca, solicita acceso a ellos.
- El propietario de los datos decide si otorgar acceso a los recursos.
- Si el consumidor obtiene acceso, puede usar un notebook y el catálogo de soluciones para crear un entorno en el que pueda analizar y transformar los recursos de datos.
Resumen
El repositorio de GitHub te proporciona instrucciones detalladas para implementar la malla de datos enGoogle Cloud después de implementar la base empresarial. El proceso para implementar la arquitectura implica modificar tus repositorios de infraestructura existentes y, además, implementar nuevos componentes específicos de la malla de datos.
Completa la siguiente información:
- Completa todos los requisitos, incluidos los siguientes:
- Instala Google Cloud CLI, Terraform, Tink, Java y Go.
- Implementa el plano de bases empresarial (v4.1).
- Mantén los siguientes repositorios locales:
gcp-data-mesh-foundationsgcp-bootstrapgcp-environmentsgcp-networksgcp-orggcp-projects
- Modifica el plano de base existente y, luego, implementa las aplicaciones de malla de datos. Para cada elemento, completa lo siguiente:
- En tu repositorio de destino, revisa la rama
Plan. - Para agregar componentes de malla de datos, copia los archivos y directorios relevantes de
gcp-data-mesh-foundationsen el directorio de base adecuado. Reemplazar archivos cuando sea necesario - Actualiza las variables, los roles y la configuración de la malla de datos en los archivos de Terraform (por
ejemplo,
*.tfvarsy*.tf). Establece los tokens de GitHub como variables de entorno. - Realiza las operaciones de inicialización, planificación y aplicación de Terraform en cada repositorio.
- Confirma los cambios, envía el código a tu repositorio remoto, crea solicitudes de extracción y combínalas con tus entornos de desarrollo, no producción y producción.
- En tu repositorio de destino, revisa la rama
¿Qué sigue?
- Lee sobre la arquitectura y las funciones en una malla de datos.
- Importa datos de Google Cloud a un almacén de datos seguro de BigQuery.
- Implementa el framework de controles clave de CDMC en un almacén de datos de BigQuery.
- Lee sobre el plano de bases empresariales.