


Notre service Gen AI Evaluation Service fournit des outils pensés pour les entreprises, qui permettent d'évaluer les modèles d'IA générative de manière objective et en s'appuyant sur les données. Il accompagne et facilite un certain nombre de tâches de développement, comme les migrations de modèles, la modification des prompts et l'affinage.
Fonctionnalités de Gen AI Evaluation Service
La principale caractéristique du Gen AI Evaluation Service est la possibilité d'utiliser des rubriques adaptatives, un ensemble de tests de réussite ou d'échec personnalisés pour chaque prompt. Les rubriques d'évaluation sont semblables aux tests unitaires dans le développement de logiciels et visent à améliorer les performances des modèles pour diverses tâches.
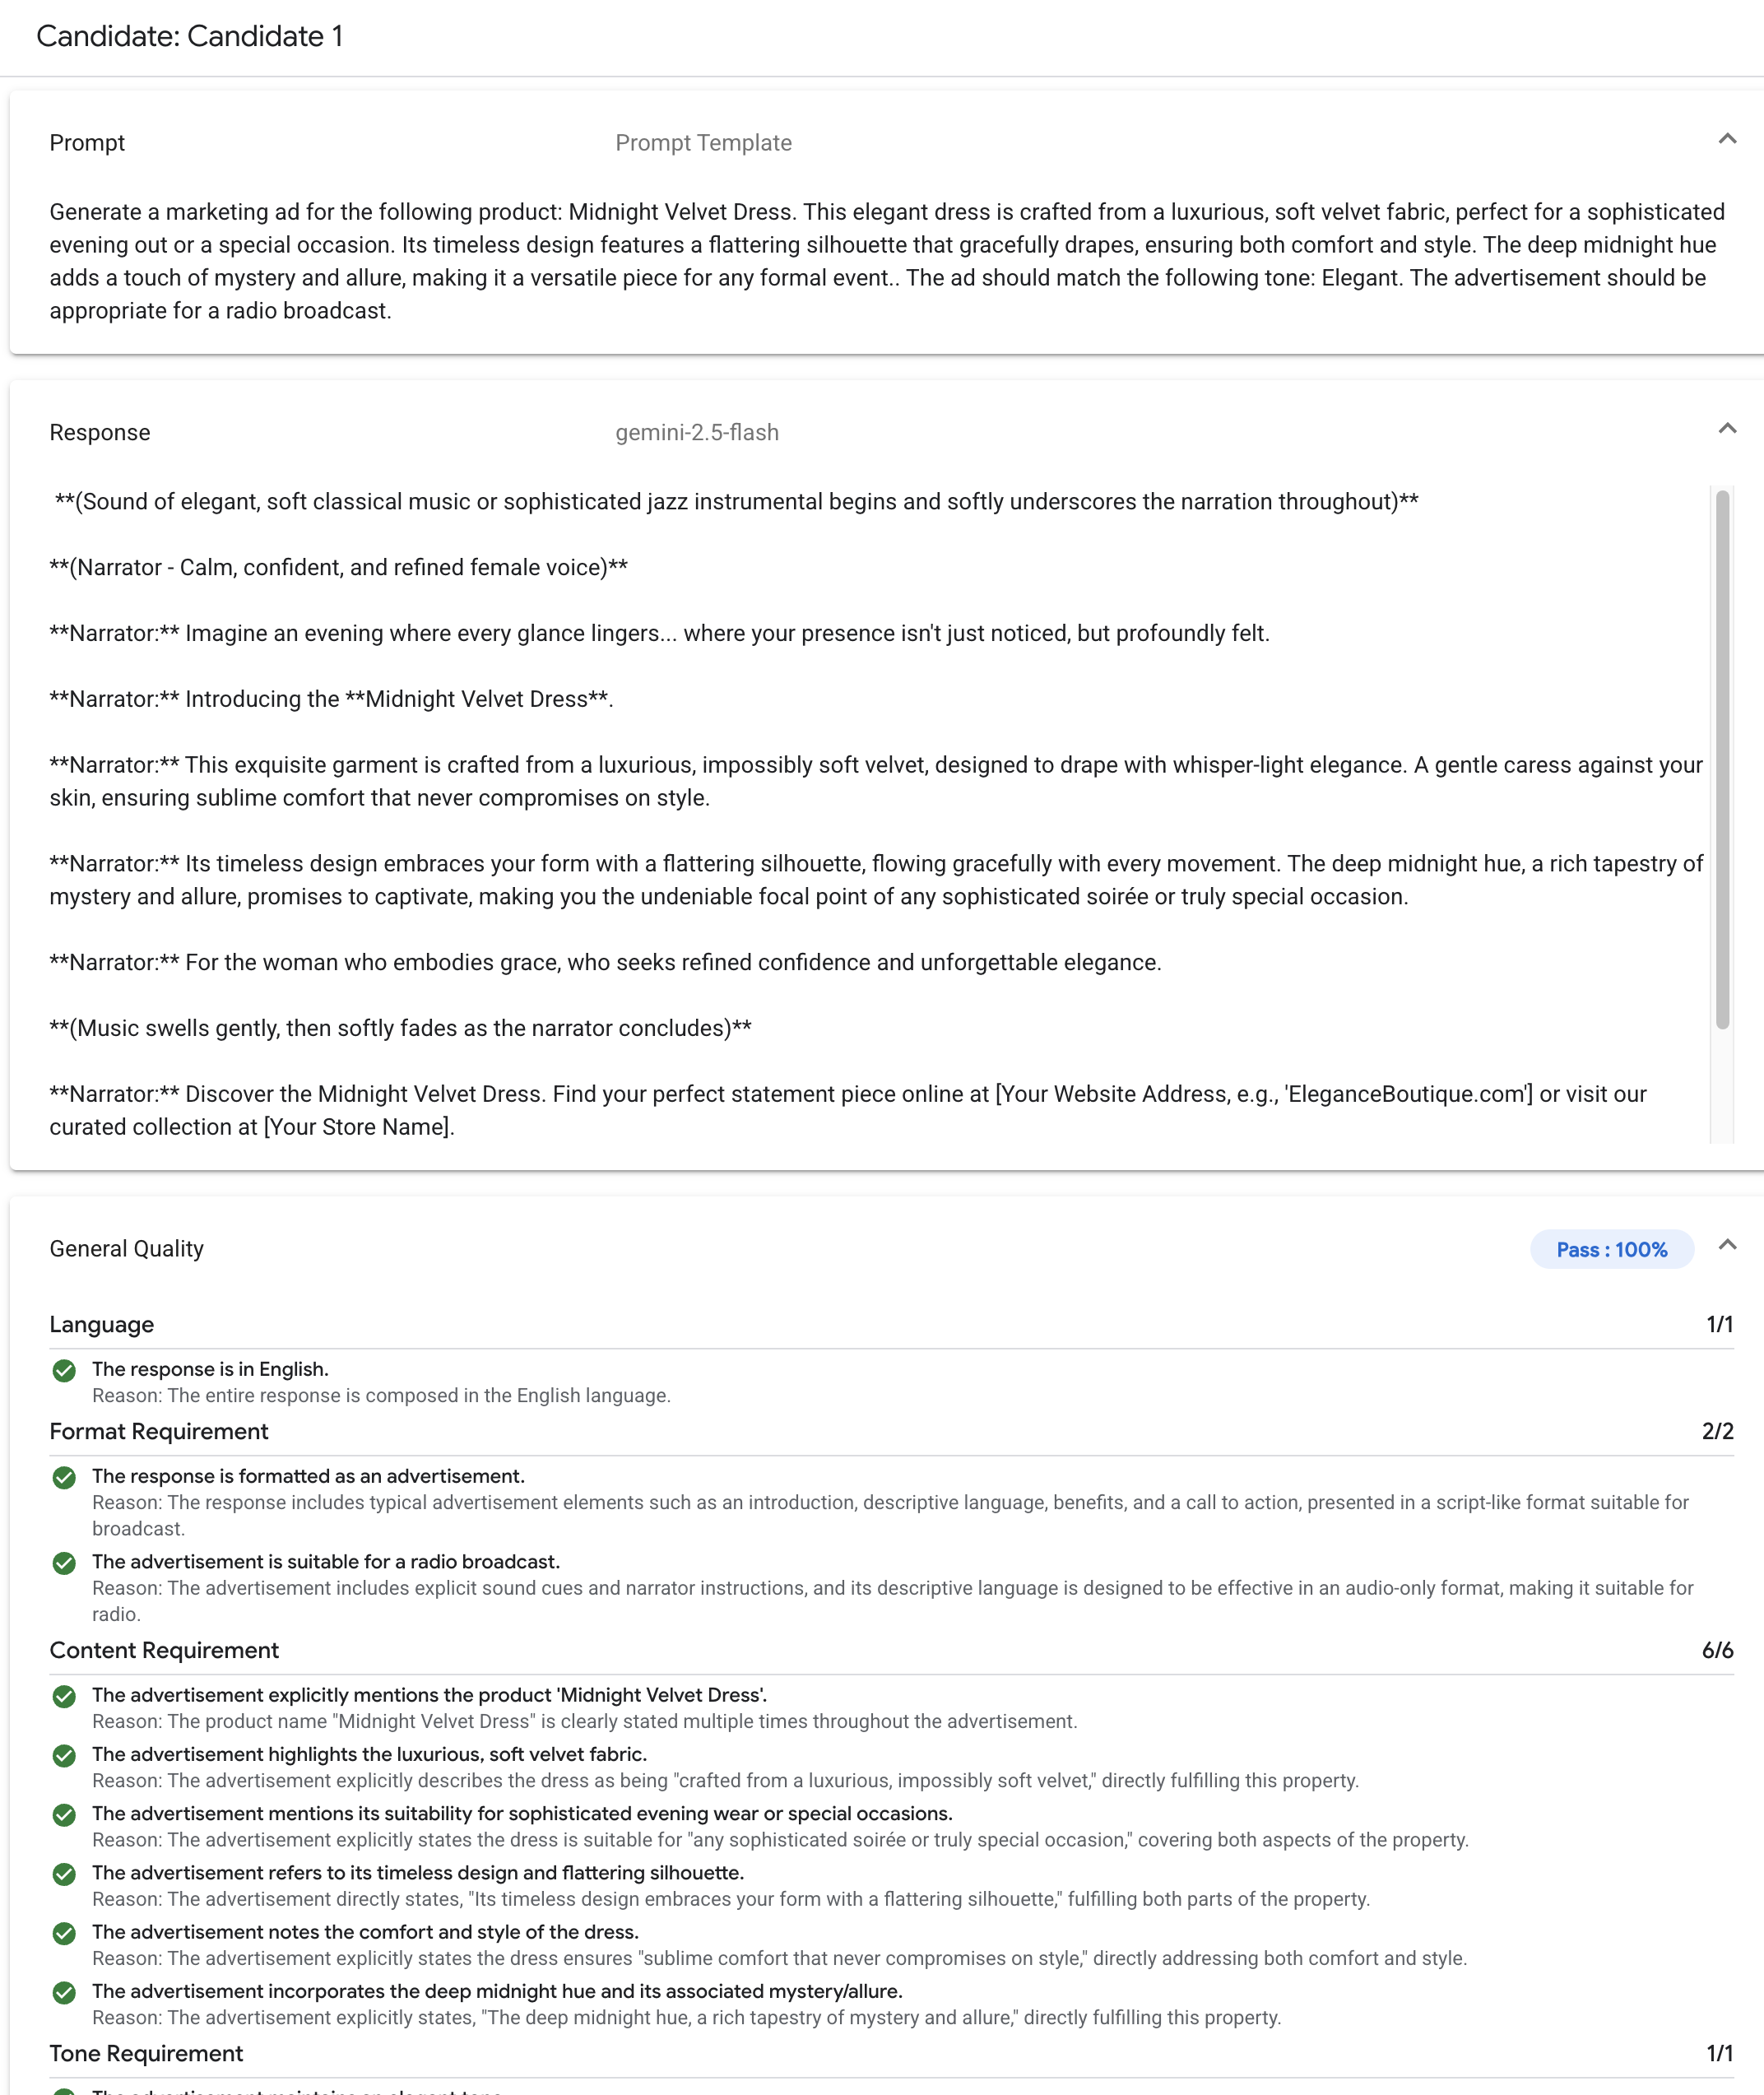
Le service d'évaluation de l'IA générative est compatible avec les méthodes d'évaluation courantes suivantes :
Rubriques adaptatives (recommandé) : génère un ensemble unique de rubriques de réussite ou d'échec pour chaque requête de votre ensemble de données.
Grilles d'évaluation statiques : appliquez un ensemble fixe de critères de notation à toutes les requêtes.
Métriques issues de calculs : utilisez des algorithmes déterministes comme
ROUGEouBLEUlorsqu'une vérité terrain est disponible.Fonctions personnalisées : définissez votre propre logique d'évaluation en Python pour des besoins spécifiques.
Génération d'un ensemble de données d'évaluation
Vous pouvez créer un ensemble de données d'évaluation de différentes manières :
Importez un fichier contenant des instances de prompt complètes, ou fournissez un modèle de prompt ainsi qu'un fichier correspondant de valeurs de variables pour remplir les prompts complétés.
Échantillonnez directement à partir des journaux de production pour évaluer l'utilisation réelle de votre modèle.
Utilisez la génération de données synthétiques pour générer un grand nombre d'exemples cohérents pour n'importe quel modèle de prompt.
Interfaces compatibles
Vous pouvez définir et exécuter vos évaluations à l'aide des interfaces suivantes :
ConsoleGoogle Cloud : interface utilisateur Web qui fournit un workflow guidé de bout en bout. Gérez vos ensembles de données, exécutez des évaluations et explorez en détail des rapports et des visualisations interactifs. Consultez Effectuer une évaluation à l'aide de la console.
SDK Python : exécutez des évaluations de manière programmatique et affichez des comparaisons de modèles côte à côte directement dans votre environnement Colab ou Jupyter. Consultez Effectuer une évaluation à l'aide du client GenAI dans le SDK Agent Platform.
Cas d'utilisation
Gen AI Evaluation Service vous permet de voir comment un modèle se comporte sur vos tâches spécifiques et par rapport à vos critères uniques, ce qui vous fournit des insights précieux qui ne peuvent pas être obtenus à partir de classements publics et de benchmarks généraux. Cela permet d'effectuer des tâches de développement critiques, y compris :
Migrations de modèles : comparez les versions de modèles pour comprendre les différences de comportement et affiner vos requêtes et paramètres en conséquence.
Trouver le meilleur modèle : comparez directement les modèles Google et tiers sur vos données pour établir une référence de performances et identifier celui qui convient le mieux à votre cas d'utilisation.
Amélioration des prompts : utilisez les résultats de l'évaluation pour guider vos efforts de personnalisation. Réexécuter une évaluation crée une boucle de rétroaction étroite, qui fournit des commentaires immédiats et quantifiables sur vos modifications.
Ajustement de modèle : évaluez la qualité d'un modèle ajusté en appliquant des critères d'évaluation cohérents à chaque exécution.
Évaluation de l'agent : évaluez les performances d'un agent à l'aide de métriques spécifiques à l'agent, telles que les traces de l'agent et la qualité des réponses.
Workflow d'évaluation
Pour effectuer une évaluation, vous devez généralement suivre les étapes suivantes :
Créer un ensemble de données d'évaluation : assemblez un ensemble de données d'instances de requêtes qui reflètent votre cas d'utilisation spécifique. Vous pouvez inclure des réponses de référence (vérité terrain) si vous prévoyez d'utiliser des métriques issues de calculs.
Définir les métriques d'évaluation : choisissez les métriques que vous souhaitez utiliser pour mesurer les performances du modèle.
Générer des réponses de modèle : sélectionnez un ou plusieurs modèles pour générer des réponses pour votre ensemble de données. Le SDK Agent Platform est compatible avec tous les modèles pouvant être appelés via
LiteLLM, tandis que la console est compatible avec les modèles Gemini.Exécuter l'évaluation : exécutez le job d'évaluation, qui évalue les réponses de chaque modèle par rapport aux métriques que vous avez sélectionnées.
Interpréter les résultats : examinez les scores agrégés et les réponses individuelles pour analyser les performances du modèle.
Métriques d'évaluation
Voici les principaux concepts liés aux métriques d'évaluation :
Rubriques : critères d'évaluation de la réponse d'un modèle ou d'une application LLM.
Métriques : score qui mesure la sortie du modèle par rapport aux critères d'évaluation.
Le service d'évaluation de l'IA générative propose les catégories de métriques suivantes :
Métriques basées sur des rubriques : intègrent des LLM dans les workflows d'évaluation pour évaluer la qualité des réponses du modèle. Les évaluations basées sur des grilles sont adaptées à diverses tâches, en particulier la qualité de l'écriture, la sécurité et le respect des instructions, qui sont souvent difficiles à évaluer avec des algorithmes déterministes.
Rubriques adaptatives (recommandé) : les rubriques sont générées de manière dynamique pour chaque requête, comme les tests unitaires. Les réponses sont évaluées à l'aide d'un ensemble unique de tests de réussite ou d'échec pour chaque prompt de votre ensemble de données. Les rubriques permettent de maintenir l'évaluation pertinente par rapport à la tâche demandée et visent à fournir des résultats objectifs, explicables et cohérents.
Les rubriques adaptatives sont généralement le moyen le plus rapide de commencer à évaluer, car elles garantissent que chaque évaluation est pertinente pour la tâche spécifique évaluée.
Rubriques statiques : les rubriques sont définies explicitement et la même rubrique s'applique à toutes les requêtes. Les réponses sont évaluées avec le même ensemble d'évaluateurs basés sur un score numérique. Un seul score numérique (par exemple, de 1 à 5) par requête. Utilisez des grilles d'évaluation statiques lorsqu'une évaluation est requise sur une dimension très spécifique ou lorsque la même grille d'évaluation est requise pour toutes les requêtes.
Métriques issues de calculs : évaluez les réponses à l'aide d'algorithmes déterministes, généralement en utilisant la vérité terrain. Un score numérique (par exemple, 0,0-1,0) par requête. Lorsque la vérité terrain est disponible et peut être mise en correspondance avec une méthode déterministe.
Métriques de fonction personnalisées (SDK Agent Platform uniquement) : définissez votre propre métrique via une fonction Python.
Exemple de rubriques adaptatives
Le processus d'évaluation de chaque requête utilise un système en deux étapes :
Génération de rubriques : le service analyse d'abord votre prompt et génère une liste de tests spécifiques et vérifiables (les rubriques) auxquels une bonne réponse doit répondre.
Validation de la grille d'évaluation : une fois que votre modèle a généré une réponse, le service l'évalue par rapport à chaque grille d'évaluation, en fournissant un verdict
PassouFailclair et une justification.
Le résultat final est un taux de réussite agrégé et une répartition détaillée des grilles d'évaluation que le modèle a validées, ce qui vous fournit des insights pratiques pour analyser les problèmes et mesurer les améliorations.
En passant de scores subjectifs de haut niveau à des résultats de test granulaires et objectifs, vous pouvez adopter un cycle de développement axé sur l'évaluation et appliquer les bonnes pratiques d'ingénierie logicielle au processus de création d'applications d'IA générative.
L'exemple suivant montre des exemples de rubriques adaptatives générées pour un ensemble de prompts :
Requête utilisateur : Write a four-sentence summary of the provided article about renewable energy, maintaining an optimistic tone.
Pour cette requête, l'étape de génération de la grille d'évaluation peut produire les grilles d'évaluation suivantes :
Critère 1 : la réponse est un résumé de l'article fourni.
Critère 2 : la réponse contient exactement quatre phrases.
Critère 3 : la réponse conserve un ton optimiste.
Votre modèle peut produire la réponse suivante : The article highlights significant growth in solar and wind power. These advancements are making clean energy more affordable. The future looks bright for renewables. However, the report also notes challenges with grid infrastructure.
Lors de la validation de la grille d'évaluation, le service d'évaluation de l'IA générative évalue la réponse par rapport à chaque grille d'évaluation :
Critère 1 : la réponse est un résumé de l'article fourni.
Verdict :
PassRaison : la réponse résume précisément les points principaux.
Critère 2 : la réponse contient exactement quatre phrases.
Verdict :
PassMotif : la réponse est composée de quatre phrases distinctes.
Critère 3 : la réponse conserve un ton optimiste.
Verdict :
FailRaison : la dernière phrase introduit un point négatif, ce qui nuit au ton optimiste.
Le taux de réussite final pour cette réponse est de 66,7 %. Pour comparer deux modèles, vous pouvez évaluer leurs réponses par rapport à ce même ensemble de tests générés et comparer leurs taux de réussite globaux.
Premiers pas avec les évaluations
Vous pouvez commencer à utiliser les évaluations à l'aide de la console.
Vous pouvez également utiliser le code suivant pour effectuer une évaluation avec le client GenAI dans le SDK Agent Platform :
from vertexai import Client
from vertexai import types
import pandas as pd

client = Client(project=PROJECT_ID, location=LOCATION)

# Create an evaluation dataset
prompts_df = pd.DataFrame({
    "prompt": [
        "Write a simple story about a dinosaur",
        "Generate a poem about Agent Platform",
    ],
})

# Get responses from one or multiple models
eval_dataset = client.evals.run_inference(model="gemini-2.5-flash", src=prompts_df)

# Define the evaluation metrics and run the evaluation job
eval_result = client.evals.evaluate(
    dataset=eval_dataset,
    metrics=[types.RubricMetric.GENERAL_QUALITY]
)

# View the evaluation results
eval_result.show()
Le service d'évaluation de l'IA générative propose deux interfaces du SDK Agent Platform :
Client GenAI dans le SDK Agent Platform (recommandé) (preview)
from vertexai import clientLe client GenAI est l'interface d'évaluation la plus récente et recommandée, accessible via la classe Client unifiée. Il est compatible avec toutes les méthodes d'évaluation et est conçu pour les workflows qui incluent la comparaison de modèles, la visualisation dans un notebook et des insights pour la personnalisation des modèles.
Module d'évaluation dans le SDK Agent Platform (disponibilité générale)
from vertexai.evaluation import EvalTaskLe module d'évaluation est l'ancienne interface, conservée pour assurer la rétrocompatibilité avec les workflows existants, mais qui n'est plus en cours de développement. Il est accessible via la classe
EvalTask. Cette méthode est compatible avec les métriques standards de LLM-as-a-Judge et les métriques issues de calculs, mais pas avec les méthodes d'évaluation plus récentes telles que les rubriques adaptatives.
Régions où le service est disponible
Les régions suivantes sont compatibles avec le service d'évaluation de l'IA générative :
Iowa (
us-central1)Caroline du Sud (
us-east1)Virginie du Nord (
us-east4)Columbus, Ohio (
us-east5)Dallas, Texas (
us-south1)Oregon (
us-west1)Las Vegas, Nevada (
us-west4)Varsovie, Pologne (
europe-central2)Finlande (
europe-north1)Madrid, Espagne (
europe-southwest1)Belgique (
europe-west1)Pays-Bas (
europe-west4)Milan, Italie (
europe-west8)Paris, France (
europe-west9)Numéro international (
global)
Notebooks disponibles
| Liens vers les notebooks | Description |
|---|---|
| Premiers pas : évaluation rapide de l'IA générative | Présente le service d'évaluation de l'IA générative. |
| Évaluer des modèles tiers avec Gen AI Evaluation Service | Montre comment utiliser le **SDK Agent Platform** pour évaluer différents types de modèles tiers, y compris les modèles accessibles via une API (comme OpenAI, Anthropic), Model as a Service (MaaS) de Gemini Enterprise Agent Platform Model Garden et les points de terminaison BYOM (Bring Your Own Model). |
| Migration de modèles avec le service d'évaluation de l'IA générative | Montre comment utiliser le **SDK Agent Platform** pour Gen AI Evaluation Service afin de comparer deux modèles propriétaires (par exemple, Gemini 2.0 Flash et Gemini 2.5 Flash). Il explique comment utiliser des métriques prédéfinies basées sur des rubriques adaptatives et comment les résultats de l'évaluation peuvent guider l'optimisation des prompts. Nous aborderons également des fonctionnalités clés telles que l'évaluation de plusieurs candidats, la visualisation dans un notebook et l'évaluation asynchrone par lot. |
| Évaluer la qualité de la conversion de texte en image avec le service d'évaluation de l'IA générative | Montre comment utiliser le SDK Vertex AI pour le service d'évaluation de l'IA générative afin d'évaluer la qualité des images générées à partir de prompts textuels. Il montre comment utiliser la métrique Gecko prédéfinie basée sur une grille d'évaluation adaptative. |
| Évaluer la qualité de la conversion de texte en vidéo avec le service d'évaluation de l'IA générative | Montre comment utiliser le **SDK Agent Platform** pour Gen AI Evaluation Service afin d'évaluer la qualité des vidéos générées à partir de prompts textuels. Il montre comment utiliser la métrique Gecko prédéfinie basée sur une grille d'évaluation adaptative. |