


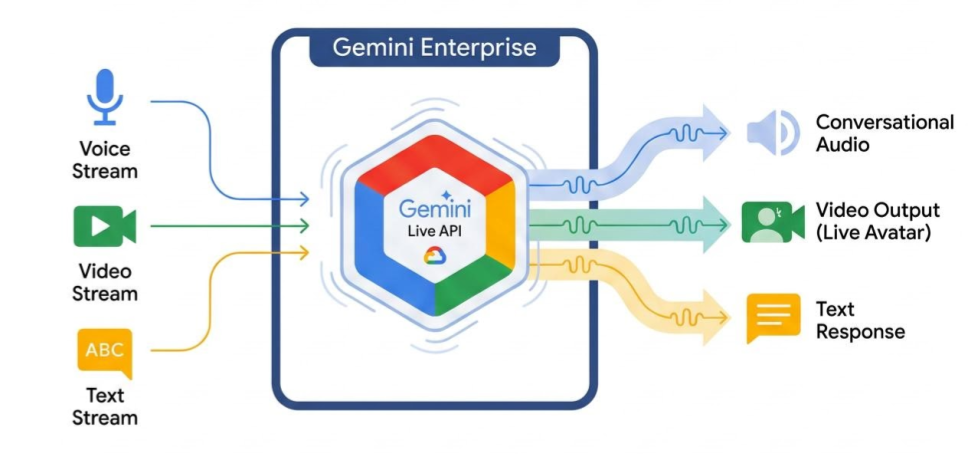
Gemini Live API 支持与 Gemini 进行低延迟、实时的语音和视频交互。它能够处理连续的音频、视频或文本流,以提供即时、自然逼真的语音回答。这为您的用户创造了自然的对话式体验。实时虚拟形象新增了与拟人化图标互动的选项,该图标可与语音回答同步,从而为用户提供更优质、更具个性化的体验。
在 Agent Studio 中试用 Gemini Live API
应用场景示例
Gemini Live API 可用于为各种行业构建实时语音和视频代理,包括:
品牌企业大使:部署在企业网络资产或移动应用中的互动式品牌代表,由授权员工肖像或已签署企业发布协议的付费人才生成。
电子商务和零售:提供个性化推荐的购物助理,以及解决客户问题的支持人员。
游戏:互动式非玩家角色 (NPC)、游戏内帮助助理和游戏内内容的实时翻译。
新一代界面:在机器人、智能眼镜和车辆中提供语音和视频功能。
医疗保健:可帮助处理医疗机构和护理后勤事宜的导航指南。
金融服务:可对日常银行业务请求进行分诊的对话式智能体。
教育:提供个性化指导和反馈的 AI 导师和学习伙伴。
主要特性
Gemini Live API 提供了一套全面的功能,用于构建强大的语音和视频代理:
高音质:Gemini Live API 可提供多种语言的自然、逼真的语音。
多语言支持:支持用 24 种语言进行对话。
打断功能:用户可以随时中断模型,以便进行响应式互动。
共情对话:根据用户输入内容的情绪表达调整回答风格和语气。
工具使用:集成函数调用和 Google 搜索等工具,实现动态交互。
音频转写:提供用户输入和模型输出的文本转写内容。如果转写是最终目标,而不是对话的辅助渠道,请参阅 Gemini 3.5 Transcribe。
主动音频:可让您控制模型何时响应以及在哪些情境下响应。
技术规格
下表列出了 Gemini Live API 的技术规范:
| 类别 | 详细信息 |
|---|---|
| 输入模态 | 音频(原始 16 位 PCM 音频,16kHz,小端序)、图片/视频(JPEG 1FPS)、文本 |
| 输出模态 | 音频(原始 16 位 PCM 音频,24kHz,小端字节序)、文本 |
| 视频(实时虚拟形象) | 视频 (mp4) |
| 协议 | 有状态 WebSocket 连接 (WSS) |
支持的模型
以下模型支持 Gemini Live API。根据您的交互需求选择合适的模型。
| 模型 ID | 可用性 | 使用场景 | 主要特性 |
|---|---|---|---|
gemini-3.8-live |
已全面推出 | 推荐。低延迟语音代理。支持无缝多语言切换。 |
|
gemini-live-2.5-flash-native-audio |
正式版 | 推荐。低延迟语音代理。支持无缝多语言切换和情感基调。 |
|
gemini-3.5-transcribe-live-preview |
预览 | 仅限语音转文字。实时字幕、听写和通话转写。返回的是文本,而不是音频,因此无法进行对话。 |
|
开始使用
选择与您的开发环境相符的指南:
合作伙伴集成
如果您想与我们的部分合作伙伴集成,这些平台已通过 WebRTC 协议集成了 Gemini Live API,可简化实时音频和视频应用的开发。
LiveKit 和 ADK 参考架构
对于需要复杂的会话编排、路由和多智能体委托的高级生产级语音助理,您可以使用 LiveKit (WebRTC) 通过智能体开发套件 (ADK) 构建低延迟的双向集成。Gemini Live API
借助此架构,您可以部署一个编排器智能体,用于处理初始客户互动,并将请求动态路由到专门的子智能体(例如,使用 transferAgent 编排将上下文委托给航班预订或酒店预订智能体)。
如需探索和部署此参考设计,请参阅 GitHub 上的官方参考代码库实现。