


使用 Spark 和 Lakehouse 執行階段目錄建立 Lakehouse
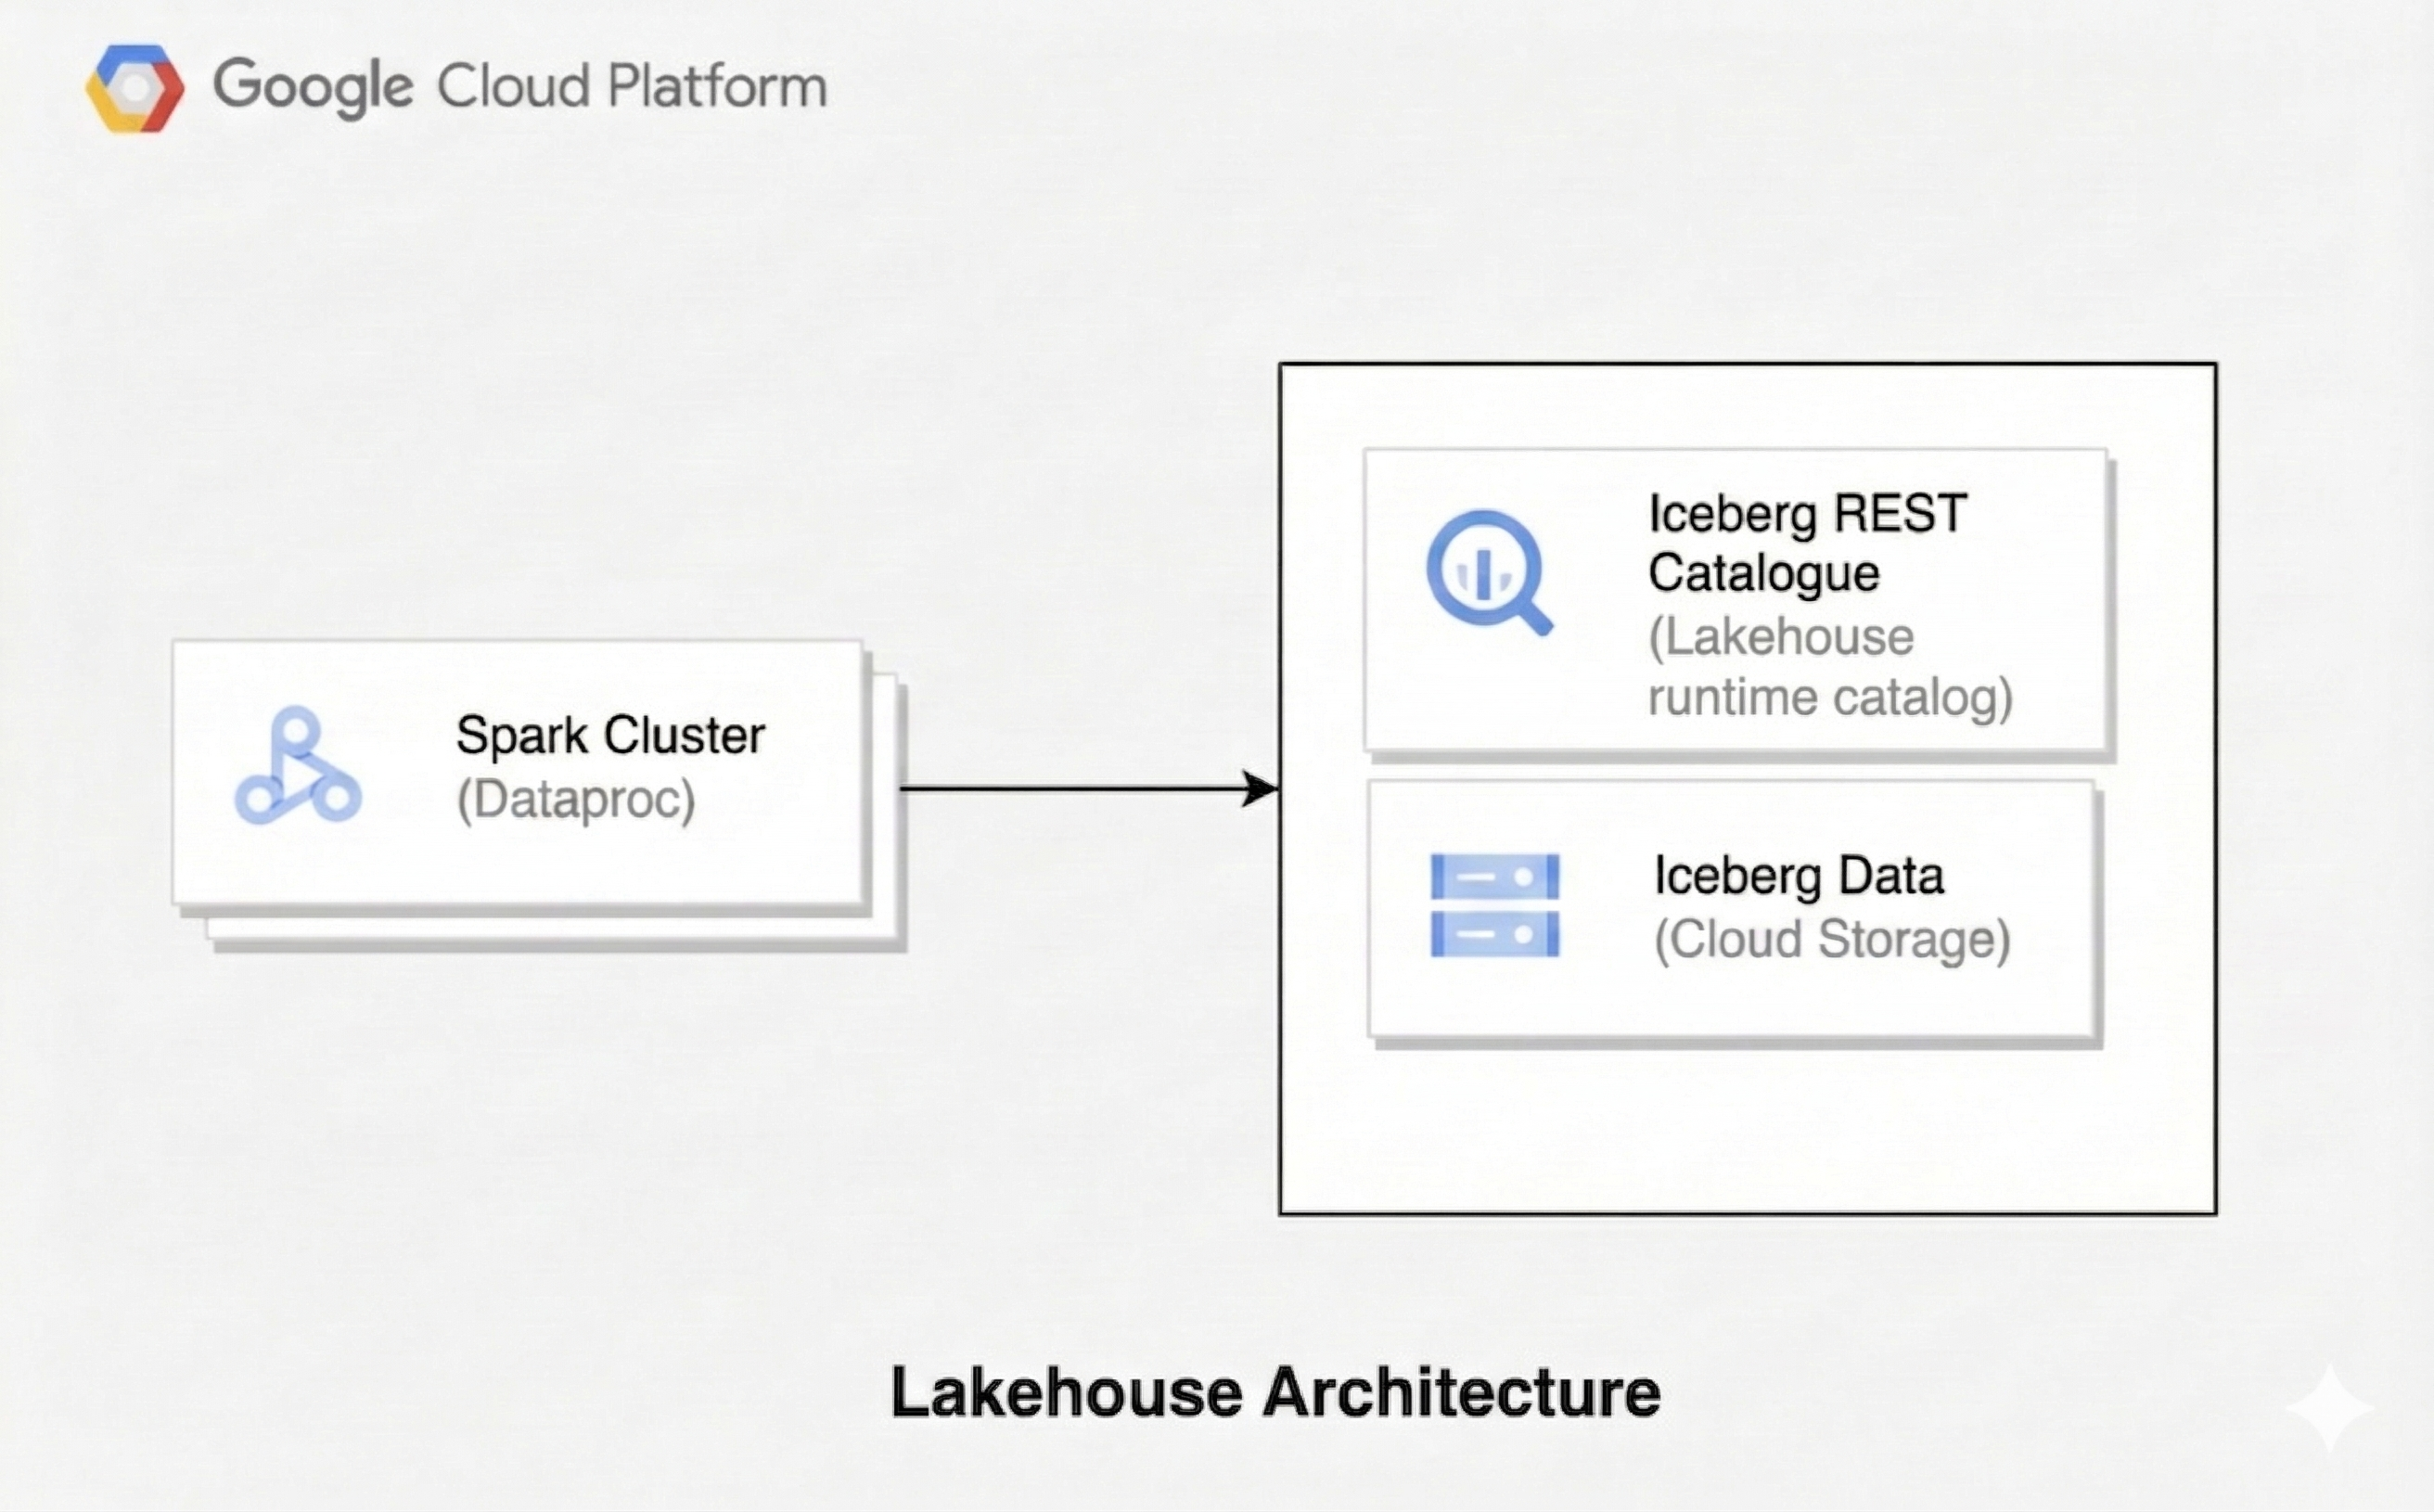
湖倉架構結合了資料湖泊的彈性,以及資料倉儲的資料管理功能。本文說明如何在 Google Cloud上設定湖倉。您將使用 Apache Iceberg 做為資料表格式、Managed Service for Apache Spark 進行處理,並使用 Lakehouse 執行階段目錄 Iceberg REST 目錄,統一管理中繼資料。
這個架構使用 Iceberg 等開放資料表格式,為 Cloud Storage 中的資料新增資料倉儲功能,例如交易和結構定義演進。這種做法可為資料建立單一事實來源,供各種引擎存取。
本文介紹在 Lakehouse 執行階段目錄中建立的目錄。如要透過 Lakehouse 執行階段目錄聯合目錄,查詢由 AWS Glue Data Catalog、Databricks Unity Catalog 或 Snowflake Horizon Catalog 管理的 Iceberg 資料表,請參閱「使用 Spark 查詢聯合目錄」。
關於 Lakehouse 執行階段目錄
Lakehouse 執行階段目錄是無伺服器、全代管的 metastore,建構於 Lakehouse 執行階段目錄之上。這項服務會儲存 Iceberg 等開放資料表格式的資料表中繼資料,並公開下列端點:
- Iceberg REST 目錄端點:可讓 Spark 和其他引擎透過標準 Iceberg REST 通訊協定,讀取及寫入 Iceberg 資料表。
- Hive 目錄端點:可讓 Spark 和 Hive 工作負載管理標準 Hive 和 Spark 資料表,例如 Parquet、ORC、Avro 和 Delta Lake 資料表,不需自行託管 Hive Metastore。
從 Managed Service for Apache Spark 映像檔和執行階段版本 4.0 開始,Lakehouse 執行階段目錄會是預設 Spark 目錄,因此您不需設定目錄,就能建立及查詢 Iceberg 資料表。
與 Hive Metastore 相比的優勢
根據預設,開放原始碼 Apache Spark 會將資料表中繼資料儲存在與叢集一起執行的 Hive Metastore 中,例如叢集主要執行個體上的內嵌 Apache Derby 資料庫或 Hive Metastore 服務。Lakehouse 執行階段目錄具有下列優點:
| 功能 | Spark Hive metastore | Lakehouse 執行階段目錄 |
|---|---|---|
| 基礎架構 | 在叢集上執行。您需要調整大小、修補、備份及擴充。 | 無伺服器且全代管。不須操作 metastore 基礎架構。 |
| 中繼資料生命週期 | 與叢集繫結。刪除臨時叢集時,中繼資料會遺失,且無伺服器工作負載沒有永久 metastore。 | 獨立於叢集、批次工作負載和工作階段,持續存在。 |
| 跨工作負載共用 | 除非您設定並連結外部 metastore,否則每個叢集都有自己的 metastore。 | 叢集、批次工作負載、工作階段和其他專案會共用同一個目錄。 |
| 多引擎存取權 | Spark 和 Hive。 | Spark、Hive、BigQuery,以及任何支援 Iceberg REST 通訊協定的引擎。 |
| 資料表格式 | Hive 資料表。Iceberg 需要額外的目錄設定。 | 透過 Iceberg REST 目錄端點存取 Iceberg 資料表,以及透過 Hive 目錄端點存取 Hive 資料表。 |
| 存取控管 | metastore 層級存取權,通常與資料存取權分開管理。 | 以 IAM 為基礎的目錄和資料表權限。 |
| 設定 | 每個叢集或工作負載中的手動目錄屬性。 | 映像檔和執行階段版本為 4.0 以上時,預設為啟用。 |
如需 Hive 目錄端點支援的 Hive Metastore 作業詳細清單,請參閱「與 Hive Metastore 的功能比較」。
事前準備
- 登入 Google Cloud 帳戶。如果您未曾使用過 Google Cloud,歡迎 建立帳戶,親自體驗實際使用我們產品的成效。新客戶還能獲得價值 $300 美元的免費抵免額,用於執行、測試及部署工作負載。
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.- 建立 Cloud Storage bucket,用於儲存 Iceberg 資料。
- 在 Lakehouse 執行階段目錄中建立目錄,並指向 bucket。建議使用多值區目錄。如果您使用自動建立的預設入門目錄,則對於映像檔和執行階段版本
4.0以上,這個步驟為選用。
必要的角色
您必須具備特定 Identity and Access Management (IAM) 角色,才能執行本頁中的範例。視組織政策而定,這些角色可能已授予。如要查看角色授予,請參閱「是否需要授予角色?」一節。
如要進一步瞭解如何授予角色,請參閱「管理專案、資料夾和組織的存取權」。
所需角色取決於工作負載的執行方式。Managed Service for Apache Spark 叢集和 Managed Service for Apache Spark 無伺服器執行階段 2.3 及更早版本,會以服務帳戶的身分執行工作負載。Managed Service for Apache Spark 無伺服器執行階段 3.0 以上版本預設會使用使用者憑證 (EUC) 執行工作負載,因此您必須將資料存取角色授予使用者帳戶,而非服務帳戶。如果您為 3.0 以上版本的執行階段指定自訂服務帳戶,工作負載會使用服務帳戶憑證執行。詳情請參閱「無伺服器部署作業角色」。
使用者角色
如要取得建立 Managed Service for Apache Spark 叢集、提交批次工作負載或建立互動式工作階段所需的權限,請要求管理員授予您下列 IAM 角色:
-
使用叢集或無伺服器執行階段 2.3 以下版本:
- 專案的 Dataproc 編輯者 (
roles/dataproc.editor) - Compute Engine 預設服務帳戶或自訂服務帳戶的服務帳戶使用者 (
roles/iam.serviceAccountUser)
- 專案的 Dataproc 編輯者 (
-
使用無伺服器執行階段 3.0 以上版本:專案的 Dataproc Serverless 編輯者 (
roles/dataproc.serverlessEditor) -
在無伺服器執行階段 3.0 以上版本使用服務帳戶憑證:自訂服務帳戶的服務帳戶使用者 (
roles/iam.serviceAccountUser)
如果您使用 Managed Service for Apache Spark 無伺服器執行階段 3.0 以上版本,並搭配使用者憑證 (預設),則還需要下列資料存取角色:
如要取得所需權限,以便使用使用者憑證讀取及寫入目錄中的資料表,請要求管理員授予您下列 IAM 角色:
-
在憑證販售模式中讀取及寫入資料表資料:在包含目錄的專案中,具備 BigLake 編輯者 (
roles/biglake.editor) 角色 -
在非憑證臨時配發模式下管理目錄資源及寫入資料表資料:
- 在包含目錄的專案中,具備 BigLake 編輯者 (
roles/biglake.editor) 角色 - 與目錄相關聯的所有 Cloud Storage bucket 的 Storage 物件使用者 (
roles/storage.objectUser)
- 在包含目錄的專案中,具備 BigLake 編輯者 (
服務帳戶角色
將下列角色授予執行工作負載的服務帳戶。只有在工作負載使用服務帳戶憑證執行時,Managed Service for Apache Spark 無伺服器執行階段 3.0 以上版本才需要這些角色。
為確保 Compute Engine 預設服務帳戶或自訂服務帳戶具備必要權限,可執行 Managed Service for Apache Spark 工作,以及讀取和寫入目錄中的資料表,請要求管理員將下列 IAM 角色授予 Compute Engine 預設服務帳戶或自訂服務帳戶:
-
在叢集或無伺服器執行階段 2.3 以下版本執行 Managed Service for Apache Spark 工作:專案的 Dataproc 工作站 (
roles/dataproc.worker) -
在無伺服器執行階段 3.0 以上版本執行 Managed Service for Apache Spark 工作:
- 專案的 Dataproc Serverless 節點 (
roles/dataproc.serverlessNode) - 專案的 Dataproc Resource Manager 節點服務代理 (
roles/dataprocrm.nodeServiceAgent)
- 專案的 Dataproc Serverless 節點 (
-
在憑證販售模式中讀取及寫入資料表資料:在包含目錄的專案中,具備 BigLake 編輯者 (
roles/biglake.editor) 角色 -
在非憑證臨時配發模式下管理目錄資源及寫入資料表資料:
- 在包含目錄的專案中,具備 BigLake 編輯者 (
roles/biglake.editor) 角色 - 與目錄相關聯的所有 Cloud Storage bucket 的 Storage 物件使用者 (
roles/storage.objectUser)
- 在包含目錄的專案中,具備 BigLake 編輯者 (
使用 Lakehouse 執行階段目錄
從映像檔和執行階段版本 4.0 開始,Managed Service for Apache Spark 會將 Lakehouse 執行階段目錄設為叢集、批次工作負載、互動式工作階段和執行階段設定檔的預設 Spark 目錄。您不需要建立目錄或設定任何目錄屬性。
在映像檔和執行階段版本 3.0 及更早版本中,您可以設定下列屬性,選擇加入預設的 Lakehouse 執行階段目錄:
- 批次工作負載、互動式工作階段和執行階段設定檔:
dataproc.lakehouse.defaultCatalog=standard-lh-catalog-REGION - 叢集:
dataproc:dataproc.lakehouse.defaultCatalog=standard-lh-catalog-REGION
將 REGION 替換為工作負載的區域,例如 us-central1。
Managed Service for Apache Spark 會按照下列方式解析預設目錄:
如果您設定
dataproc.lakehouse.defaultCatalog(叢集為dataproc:dataproc.lakehouse.defaultCatalog),Managed Service for Apache Spark 會使用您的值,不會變更。否則,如果是映像檔和執行階段版本
4.0以上,Managed Service for Apache Spark 會將dataproc.lakehouse.defaultCatalog設為區域入門目錄standard-lh-catalog-REGION,其中REGION是工作負載的區域。如果沒有,Managed Service for Apache Spark 會在執行工作負載的專案中自動建立。建立新手目錄時,不需要任何其他 IAM 角色。如果是
3.0以下版本的映像檔和執行階段,Managed Service for Apache Spark 不會設定預設目錄。如要選擇加入,請按照本節前述說明,明確設定dataproc.lakehouse.defaultCatalog=standard-lh-catalog-REGION。
設定預設目錄後,Spark 會以目錄名稱 default_catalog 和下列解析屬性註冊目錄:
| Spark 屬性 | 值 |
|---|---|
spark.sql.defaultCatalog |
default_catalog |
spark.sql.catalog.default_catalog |
org.apache.iceberg.spark.SparkCatalog |
spark.sql.catalog.default_catalog.type |
rest |
spark.sql.catalog.default_catalog.warehouse |
bl://projects/PROJECT_ID/catalogs/CATALOG_ID |
因此,不完整的資料表名稱 (例如 my_namespace.my_table) 會在 Lakehouse 執行階段目錄中解析為 default_catalog.my_namespace.my_table。
設定預設目錄
如要在舊版映像檔或執行階段,將 Lakehouse 執行階段目錄設為預設目錄,或使用入門目錄以外的目錄,請設定 dataproc.lakehouse.defaultCatalog=CATALOG 屬性 (叢集則為 dataproc:dataproc.lakehouse.defaultCatalog=CATALOG),其中 CATALOG 為下列其中一項:
standard-lh-catalog-REGION:工作負載專案中的區域入門目錄。projects/PROJECT_ID/catalogs/CATALOG_ID:現有目錄,可位於其他專案。
舉例來說,下列指令會提交批次工作負載,並使用現有目錄做為預設目錄:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
    --region=REGION \
    --version=RUNTIME_VERSION \
    --properties=dataproc.lakehouse.defaultCatalog=projects/PROJECT_ID/catalogs/CATALOG_ID
如要在 Google Cloud 控制台設定預設目錄,請參閱執行階段設定檔和叢集設定操作說明。
選擇不採用新手目錄
在映像檔和執行階段版本 4.0 以上,您可以將 dataproc.lakehouse.defaultCatalog=CATALOG (如果是叢集,則為 dataproc:dataproc.lakehouse.defaultCatalog=CATALOG) 設為其他目錄的完整資源名稱 (例如 projects/PROJECT_ID/catalogs/CATALOG_ID),選擇不使用區域入門目錄。Managed Service for Apache Spark 會使用您的目錄,而非入門目錄,且不會覆寫您明確設定的屬性。
驗證預設目錄
查看已解決的屬性:
如要執行互動式工作階段,請執行下列指令:
gcloud beta dataproc sessions describe SESSION_ID \
    --location=REGION \
    --format="yaml(runtimeConfig.properties)"
如果是叢集,請檢查主要節點上的
/etc/spark/conf/spark-defaults.conf。
在 Spark 應用程式中,確認預設目錄已啟用:
print(spark.conf.get("spark.sql.defaultCatalog")) # default_catalog
設定 Managed Service for Apache Spark 並建立 Spark 工作階段
設定叢集、批次工作負載或互動式工作階段,以使用 Lakehouse 執行階段目錄 Iceberg REST 目錄。這三種方法都支援 dataproc.lakehouse.catalog.CATALOG_NAME 簡化設定屬性 (建議),可讓 Managed Service for Apache Spark 讀取目錄定義,並產生 Iceberg REST Catalog Spark 屬性。只有叢集形式會採用 dataproc: 前置字元。
如果映像檔和執行階段版本為 4.0 以上,則可略過這項設定,直接使用預設 Lakehouse 執行階段目錄。請按照下列操作說明註冊自己的目錄,或在舊版設定 Lakehouse 執行階段目錄。
簡化設定和手動設定都會使用 Google 授權來存取 Iceberg (GoogleAuthManager),因此必須使用下列其中一個版本:
- Managed Service for Apache Spark 叢集:
2.2映像檔2.2.65以上版本、2.3映像檔2.3.11以上版本,或4.0以上版本映像檔。 - Managed Service for Apache Spark 無伺服器批次工作負載和互動式工作階段:
2.2執行階段2.2.60以上版本、2.3執行階段2.3.10以上版本,或3.0以上版本的執行階段。
在映像檔和執行階段版本 4.0 以上,Lakehouse 執行階段目錄是預設目錄。
如果是無伺服器批次工作負載和互動式工作階段,所需角色取決於執行階段版本。執行階段 3.0 以上版本預設會使用使用者憑證。詳情請參閱「必要的角色」。
叢集
使用簡化設定屬性 (建議做法),或在筆記本中手動指定目錄屬性,建立含有 Iceberg 和 Jupyter 選用元件的 Managed Service for Apache Spark 叢集。
使用屬性簡化設定 (建議)
使用目錄屬性建立叢集:
gcloud dataproc clusters create CLUSTER_NAME \
  --project=PROJECT_ID \
  --region=REGION \
  --image-version=IMAGE_VERSION \
  --optional-components=ICEBERG,JUPYTER \
  --enable-component-gateway \
  --properties='dataproc:dataproc.lineage.enabled=true,dataproc:dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark:spark.sql.defaultCatalog=CATALOG_NAME'
更改下列內容:
CLUSTER_NAME:叢集名稱。PROJECT_ID:Google Cloud 專案 ID。REGION:叢集的 Google Cloud區域,例如us-central1。IMAGE_VERSION:Managed Service for Apache Spark 映像檔版本,例如2.3-debian12。請參閱「支援的映像檔和執行階段版本」。CATALOG_NAME:本機 Spark 目錄的名稱,例如iceberg_catalog。可以與CATALOG_ID相同。CATALOG_ID:您在「事前準備」中建立的目錄 ID。
不需設定 dataproc:dataproc.lineage.enabled=true 屬性,Lakehouse 執行階段目錄 Iceberg REST 目錄也能正常運作。在資料歷程範例中,這個標籤用於追蹤歷程。
使用 Jupyter 筆記本 (Vertex AI Workbench 筆記本或在叢集上啟動的筆記本) 連線至叢集,並建立 SparkSession,不指定目錄設定:
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
將 APP_NAME 替換為 Spark 應用程式名稱。
手動設定
如果不使用簡化設定屬性,請按照前述步驟建立叢集,但不要在 --properties 旗標中加入 dataproc:dataproc.lakehouse.catalog.,然後連線至 Jupyter 筆記本,並手動設定 SparkSession,如下所示:
import pyspark
from pyspark.context import SparkContext
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
更改下列內容:
CATALOG_NAME:本機 Spark 目錄的名稱,例如iceberg_catalog。APP_NAME:Spark 應用程式的名稱。WAREHOUSE_PATH:倉儲的路徑。如為多值區目錄 (建議做法),請使用bl://projects/PROJECT_ID/catalogs/CATALOG_ID。如果是單一 bucket 目錄,請使用gs://CLOUD_STORAGE_BUCKET_NAME。PROJECT_ID:您的 Google Cloud 專案 ID。
使用憑證臨時配發功能進行設定
如要使用憑證販售功能,您必須使用憑證販售模式的目錄,並在 SparkSession 建構工具中加入下列程式碼,將 X-Iceberg-Access-Delegation 標頭新增至 Iceberg REST 目錄要求,並將值設為 vended-credentials:
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
以下範例說明如何設定 SparkSession,並啟用憑證販售功能:
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
如果目錄使用憑證販售模式,簡化設定會新增這個標頭。詳情請參閱 Iceberg 說明文件的「RESTCatalog 中的標頭」一節。
主控台設定
如要在Google Cloud 控制台建立叢集時設定 Lakehouse 執行階段目錄,請完成下列步驟:
在 Google Cloud 控制台中,前往 Managed Service for Apache Spark 的「Clusters」(叢集) 頁面。
按一下「Create cluster」(建立叢集),然後按一下「Cluster on Compute Engine」(Compute Engine 上的叢集) 列中的「Create」(建立)。
在 metastore 設定步驟中,選取「Select metastore and project」(選取 metastore 和專案) 下方的「Lakehouse runtime catalog」(Lakehouse 執行階段目錄)。
按照「執行階段設定檔」分頁中的說明,設定「專案 ID」、「Iceberg REST 端點」目錄,以及選用的「Hive 端點」目錄。
完成其餘叢集設定,然後按一下「Create」(建立)。
無伺服器
使用簡化的設定屬性 (建議做法),或手動指定目錄屬性,將 PySpark 批次工作負載提交至 Managed Service for Apache Spark 無伺服器。
使用屬性簡化設定 (建議)
提交批次工作負載時,請傳遞 dataproc.lakehouse.catalog.CATALOG_NAME 屬性 (不含 dataproc: 前置字元):
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark.sql.defaultCatalog=CATALOG_NAME"
更改下列內容:
PYSPARK_FILE:PySpark 應用程式檔案的gs://Cloud Storage 路徑。PROJECT_ID:Google Cloud 專案 ID。REGION:批次工作負載的區域。RUNTIME_VERSION:Managed Service for Apache Spark 無伺服器執行階段版本,例如3.0。必要角色取決於執行階段版本 (請參閱「支援的映像檔和執行階段版本」)。CATALOG_NAME:本機 Spark 目錄的名稱,例如iceberg_catalog。可以與CATALOG_ID相同。CATALOG_ID:您在「事前準備」中建立的目錄 ID。
在 PySpark 應用程式檔案中,建立 SparkSession,但不指定目錄設定:
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
手動設定
如果您不使用簡化設定屬性,請在提交批次工作負載時,在 --properties 旗標中指定目錄屬性:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
將 WAREHOUSE_PATH 替換為倉儲路徑。如要使用多值區目錄 (建議做法),請使用 bl://projects/PROJECT_ID/catalogs/CATALOG_ID。如果是單一 bucket 目錄,請使用 gs://CLOUD_STORAGE_BUCKET_NAME。
使用憑證臨時配發功能進行設定
如要使用憑證販售功能,您必須使用憑證販售模式的目錄,並在 --properties 旗標中加入下列屬性,將 X-Iceberg-Access-Delegation 標頭新增至 Iceberg REST 目錄要求,值為 vended-credentials:
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentials下列範例會提交具備憑證販售功能的批次工作負載:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentials,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
如果目錄使用憑證販售模式,簡化設定會新增這個標頭。詳情請參閱 Iceberg 說明文件的「RESTCatalog 中的標頭」一節。
無伺服器
使用 DataprocSparkSession API,透過筆記本建立 Managed Service for Apache Spark 無伺服器互動式工作階段,並使用簡化的設定屬性 (建議做法),或手動指定目錄屬性。
使用屬性簡化設定 (建議)
在已安裝 dataproc-spark-connect 套件的筆記本 (例如 BigQuery Studio 筆記本或 Vertex AI Workbench 筆記本) 中,建立工作階段時傳遞 dataproc.lakehouse.catalog.CATALOG_NAME 屬性 (不含 dataproc: 前置字元):
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config(f'dataproc.lakehouse.catalog.{catalog_name}', 'projects/PROJECT_ID/catalogs/CATALOG_ID') \
.config('spark.sql.defaultCatalog', catalog_name) \
.getOrCreate()
更改下列內容:
CATALOG_NAME:本機 Spark 目錄的名稱,例如iceberg_catalog。可以與CATALOG_ID相同。RUNTIME_VERSION:Managed Service for Apache Spark 無伺服器執行階段版本,例如3.0。必要角色取決於執行階段版本 (請參閱「支援的映像檔和執行階段版本」)。APP_NAME:Spark 應用程式的名稱。PROJECT_ID:Google Cloud 專案 ID。CATALOG_ID:您在「事前準備」中建立的目錄 ID。
您也可以在執行階段設定檔中設定 Lakehouse 目錄。詳情請參閱「執行階段設定檔」分頁。
手動設定
如果不使用簡化設定屬性,請在建立工作階段時指定目錄屬性:
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
按照本分頁先前簡化設定範例中的說明,替換 RUNTIME_VERSION。
將 WAREHOUSE_PATH 替換為倉儲路徑。如要使用多值區目錄 (建議做法),請使用 bl://projects/PROJECT_ID/catalogs/CATALOG_ID。如果是單一 bucket 目錄,請使用 gs://CLOUD_STORAGE_BUCKET_NAME。
使用憑證臨時配發功能進行設定
如要使用憑證販售功能,您必須使用憑證販售模式的目錄,並在工作階段建構工具中加入下列程式碼,將 X-Iceberg-Access-Delegation 標頭新增至 Iceberg REST 目錄要求,並將值設為 vended-credentials:
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
以下範例會建立具有憑證販售功能的會話:
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
如果目錄使用憑證販售模式,簡化設定會新增這個標頭。詳情請參閱 Iceberg 說明文件的「RESTCatalog 中的標頭」一節。
無伺服器
執行階段設定檔在 gcloud CLI 和 Dataproc API 中稱為工作階段範本,可儲存可重複使用的無伺服器設定,包括 metastore。從執行階段設定檔建立的互動式工作階段,會使用該設定檔的目錄設定。
主控台設定
前往 Google Cloud 控制台的「Runtime Profiles」(執行階段設定檔) 頁面。
按一下「Create」(建立),或按一下現有執行階段設定檔的名稱,然後按一下「Edit」(編輯)。
展開「Additional configuration」(其他設定),然後按一下「Metastore configuration」(Metastore 設定) 旁邊的「Edit」(編輯)。
選取「Lakehouse runtime catalog」(Lakehouse 執行階段目錄)。這是預設選項。
設定目錄:
- 專案 ID:目錄所在的專案。預設為目前的專案。
- Iceberg REST 端點:預設選取。選擇下列其中一個選項:
- 定義新的目錄,以使用區域入門目錄
standard-lh-catalog-REGION。 - 選擇現有的目錄 ID。
- 定義新的目錄,以使用區域入門目錄
- 選用:Hive 端點:勾選這個核取方塊,並指定 Hive 目錄的專案 ID、目錄 ID 和目錄名稱。
依序點選「儲存」和「建立」或「儲存」。
gcloud 設定
建立 YAML 檔案,在
runtimeConfig.properties中設定預設目錄:runtimeConfig: version: "RUNTIME_VERSION" properties: dataproc.lakehouse.defaultCatalog: projects/PROJECT_ID/catalogs/CATALOG_ID sparkConnectSession: {}
在執行階段版本
4.0以上,您可以省略dataproc.lakehouse.defaultCatalog,使用區域入門目錄。匯入檔案,建立或更新執行階段設定檔:
gcloud beta dataproc session-templates import RUNTIME_PROFILE_ID \
  --location=REGION \
  --source=FILE_NAME.yaml
更改下列內容:
RUNTIME_VERSION:Managed Service for Apache Spark 無伺服器執行階段版本,例如4.0。PROJECT_ID:包含目錄的專案。CATALOG_ID:目錄 ID。RUNTIME_PROFILE_ID:執行階段設定檔的 ID。REGION:執行階段設定檔的區域。FILE_NAME:YAML 檔案的名稱。
使用 Spark SQL 管理資料
設定 Spark 工作階段後,請使用 Spark SQL 執行資料管理作業。
設定目錄:dataproc.lakehouse.catalog. 屬性會向 Spark 註冊目錄,但不會將其設為「預設」目錄。上一節的範例設定了 spark.sql.defaultCatalog (叢集上的 spark:spark.sql.defaultCatalog),因此您可以使用不完整的資料表名稱。如果省略該屬性,請在資料表名稱前加上目錄名稱,例如 CATALOG_NAME.NAMESPACE_NAME.base_table。在映像檔和執行階段版本 4.0 以上,如未設定 dataproc.lakehouse.defaultCatalog,不完整的資料表名稱會解析為預設 Lakehouse 執行階段目錄 (default_catalog)。
建立命名空間。在 Lakehouse 執行階段目錄 Iceberg REST 目錄中,命名空間對應至 BigQuery 資料集。
spark.sql("CREATE NAMESPACE IF NOT EXISTS NAMESPACE_NAME")
spark.sql("USE NAMESPACE_NAME")
將
NAMESPACE_NAME替換為命名空間的名稱,例如spark_lakehouse。建立 Iceberg 格式的基礎資料表,並插入資料。
spark.sql("DROP TABLE IF EXISTS base_table PURGE")
spark.sql("CREATE TABLE base_table (id LONG) USING iceberg")
spark.sql("INSERT INTO base_table VALUES 0, 1, 2, 3, 4")
spark.sql("SELECT * FROM base_table").show()
輸出結果會與下列內容相似:
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   +---+
為新資料建立另一個資料表。
spark.sql("DROP TABLE IF EXISTS newdata PURGE")
spark.sql("CREATE TABLE newdata(id LONG) USING iceberg")
spark.sql("INSERT INTO newdata VALUES 3, 4, 5, 6")
spark.sql("SELECT * FROM newdata").show()
輸出結果會與下列內容相似:
   +---+
   | id|
   +---+
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
將新資料合併至基礎資料表。
spark.sql("""MERGE INTO base_table USING newdata
           ON base_table.id = newdata.id
           WHEN MATCHED THEN
             UPDATE SET base_table.id = newdata.id
           WHEN NOT MATCHED THEN INSERT * """)
spark.sql("SELECT * FROM base_table").show()
輸出結果會與下列內容相似:
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
更新基礎資料表中的記錄。
spark.sql(
     "UPDATE base_table SET id = (id + 100) WHERE (id % 2 == 0)"
 )
spark.sql("SELECT * FROM base_table").show()
輸出結果會與下列內容相似:
   +---+
   | id|
   +---+
   |  3|
   |104|
   |  5|
   |106|
   |100|
   |102|
   |  1|
   +---+
刪除基礎資料表中的記錄。
spark.sql("DELETE FROM base_table WHERE (id % 2 == 0)")
spark.sql("SELECT * FROM base_table").show()
輸出結果會與下列內容相似:
   +---+
   | id|
   +---+
   |  3|
   |  5|
   |  1|
   +---+
查詢歷來快照
查詢快照 ID,擷取資料表的先前版本。這項作業也稱為「時間旅行」。
擷取
MERGE、UPDATE和DELETE作業之前的資料表版本快照 ID。snapshot_ids = spark.sql( "SELECT snapshot_id FROM `NAMESPACE_NAME`.`base_table`.snapshots" ).collect() oldest_snapshot_id = snapshot_ids[1]["snapshot_id"]將
NAMESPACE_NAME替換為您建立的命名空間。使用擷取的快照 ID 查詢資料表。
df = (
     spark.read.format("iceberg")
     .option("versionAsOf", oldest_snapshot_id)
     .load("base_table")
 )
df.show()
輸出內容會顯示
MERGE作業之後,但在UPDATE或DELETE作業之前的資料表狀態。+---+ | id| +---+ | 0| | 1| | 2| | 3| | 4| | 5| | 6| +---+
探索資料歷程
使用 Managed Service for Apache Spark 2.2 以上版本的映像檔,即可透過資料歷程,追蹤 Lakehouse 執行階段目錄 Iceberg REST 目錄資料表之間的資料移動。
資料歷程範例
建立來源和目標 Iceberg 資料表,然後複製資料。
spark.sql("DROP TABLE IF EXISTS source_table PURGE")
spark.sql("DROP TABLE IF EXISTS target_table PURGE")
spark.sql("CREATE TABLE source_table (id LONG) USING iceberg")
spark.sql("""CREATE TABLE target_table
  USING ICEBERG
  AS SELECT max(id) as top_id FROM source_table
  """)
在 Google Cloud 控制台,前往 Knowledge Catalog 的「Search」(搜尋) 頁面。
搜尋其中一個資料表,然後按一下「
Lineage」分頁標籤: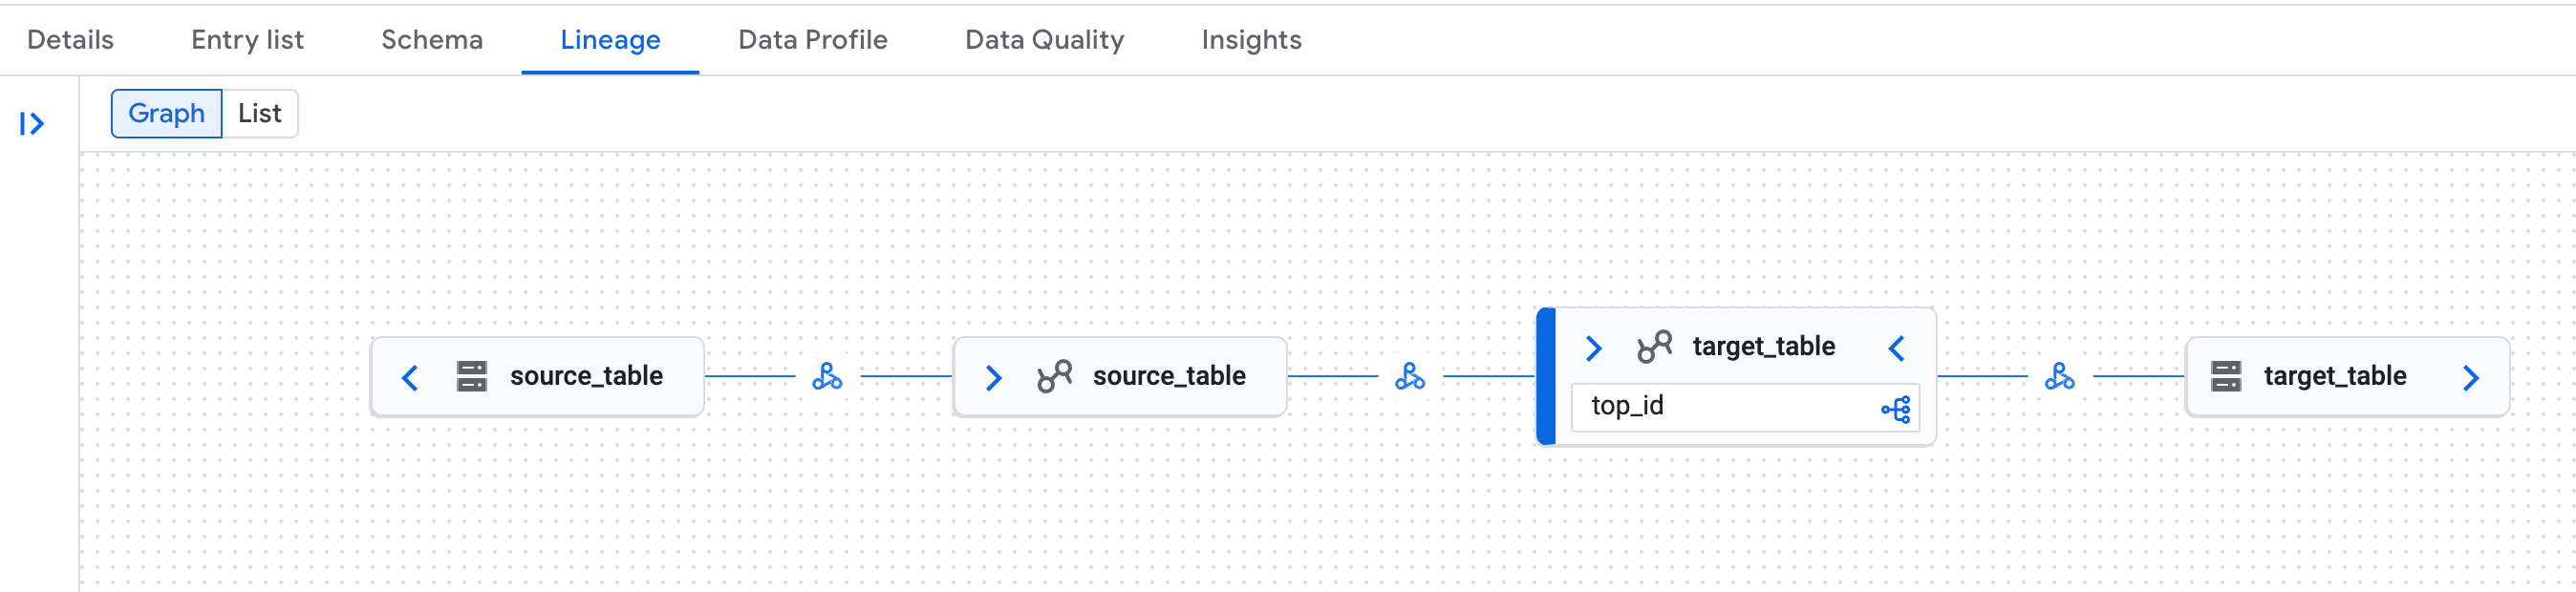
Google Cloud 控制台 Knowledge Catalog 頁面中的資料歷程圖範例。 資料歷程會辨識 Lakehouse 執行階段目錄 Iceberg REST 目錄資料表的邏輯 (Lakehouse 執行階段目錄資料表) 和實體 (Cloud Storage) 表示法。
資料歷程已知問題
在某些 Managed Service for Apache Spark 叢集中,由於 OpenLineage 程式庫問題,可能無法產生完整的資料歷程。這是已知限制。如果這項異動會影響工作負載,請與 Google Cloud 支援團隊聯絡。
後續步驟
- 進一步瞭解 Lakehouse 執行階段目錄 Iceberg REST 目錄。
- 使用 Spark 查詢聯合目錄。
- 探索 Apache Iceberg 的功能。
- 瞭解如何從 Lakehouse 執行階段目錄查詢 Iceberg 資料。
- 進一步瞭解資料歷程和 Managed Service for Apache Spark。