


Crea un lakehouse con Spark e il catalogo di runtime Lakehouse
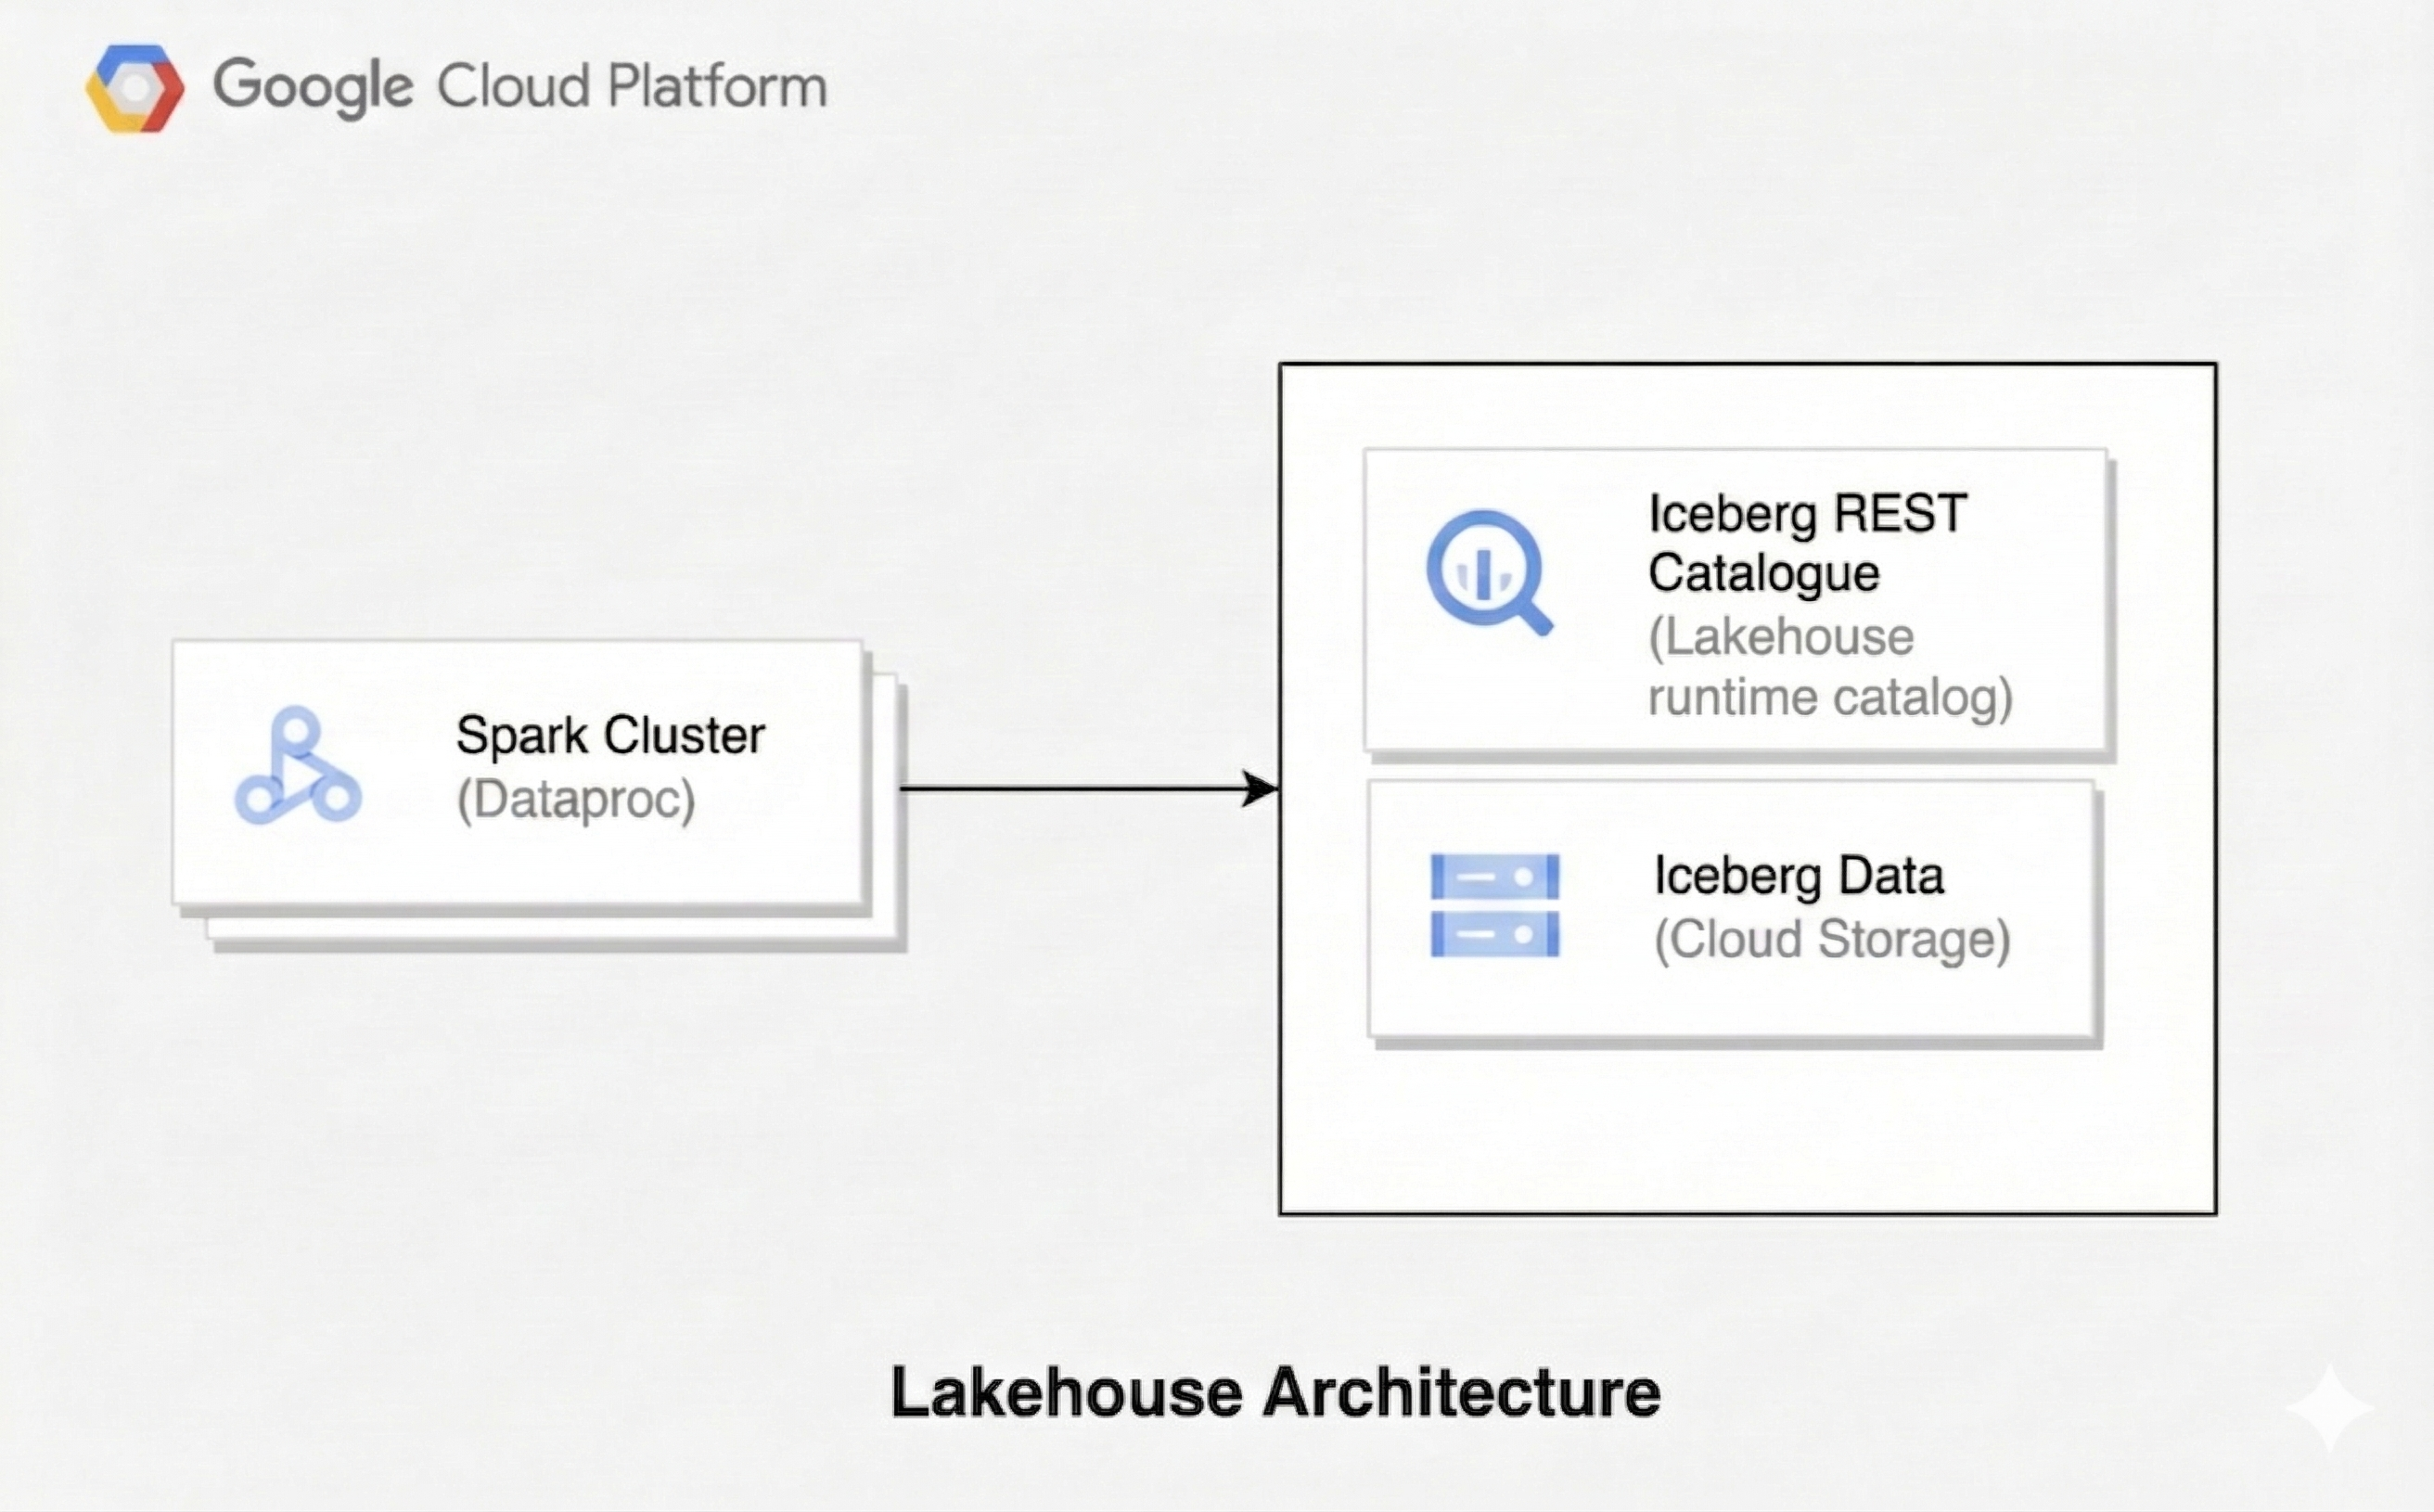
Un'architettura lakehouse combina la flessibilità di un data lake con le funzionalità di gestione dei dati di un data warehouse. Questo documento mostra come configurare un lakehouse su Google Cloud. Utilizzi Apache Iceberg come formato della tabella, Managed Service for Apache Spark per l'elaborazione e il catalogo di runtime Lakehouse Iceberg REST Catalog per la gestione unificata dei metadati.
Questa architettura utilizza formati di tabella aperti come Iceberg per aggiungere funzionalità di data warehousing, come transazioni ed evoluzione dello schema, ai dati in Cloud Storage. Questo approccio crea una Single Source Of Truth per i dati a cui possono accedere vari motori.
Questo documento riguarda i cataloghi che crei nel catalogo di runtime Lakehouse. Per eseguire query sulle tabelle Iceberg gestite da AWS Glue Data Catalog, Databricks Unity Catalog o Snowflake Horizon Catalog tramite i cataloghi federati del catalogo di runtime Lakehouse, consulta Esegui query sui cataloghi federati con Spark.
Prima di iniziare
- Accedi al tuo account Google Cloud . Se non conosci Google Cloud, crea un account per valutare le prestazioni dei nostri prodotti in scenari reali. I nuovi clienti ricevono anche 300 $di crediti senza costi per l'esecuzione, il test e il deployment dei workload.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.- Crea un bucket Cloud Storage per archiviare i dati Iceberg.
- Crea un catalogo nel catalogo di runtime Lakehouse che rimandi al tuo bucket. È consigliato un catalogo con più bucket.
Ruoli obbligatori
Per eseguire gli esempi in questa pagina sono necessari determinati ruoli IAM (Identity and Access Management). A seconda delle policy dell'organizzazione, questi ruoli potrebbero essere già stati concessi. Per controllare le concessioni dei ruoli, consulta Devi concedere i ruoli?.
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
I ruoli necessari dipendono dalla modalità di esecuzione del workload.
I cluster Managed Service for Apache Spark e i runtime serverless Managed Service for Apache Spark 2.3 e versioni precedenti eseguono i workload come account di servizio. I runtime serverless di Managed Service for Apache Spark 3.0 e versioni successive eseguono i workload con le credenziali dell'utente finale (EUC) per impostazione predefinita, quindi concedi i ruoli di accesso ai dati al tuo account utente anziché a un account di servizio. Se
specifichi un service account personalizzato per un runtime 3.0 o versioni successive, il workload
viene eseguito con le credenziali dell'account di servizio. Per saperne di più, vedi
Ruoli di deployment serverless.
Ruoli utente
Per ottenere le autorizzazioni necessarie per creare un cluster Managed Service for Apache Spark, inviare un workload batch o creare una sessione interattiva, chiedi all'amministratore di concederti i seguenti ruoli IAM:
-
Utilizza un cluster o un runtime serverless 2.3 o versioni precedenti:
- Dataproc Editor (
roles/dataproc.editor) sul progetto - Utente service account (
roles/iam.serviceAccountUser) sul account di servizio predefinito di Compute Engine o su un account di servizio personalizzato
- Dataproc Editor (
-
Utilizza un runtime serverless 3.0 o versioni successive:
Dataproc Serverless Editor (
roles/dataproc.serverlessEditor) sul progetto -
Utilizza le credenziali dell'account di servizio su un runtime serverless 3.0 o versioni successive:
Utente dell'account (
roles/iam.serviceAccountUser) sul service account personalizzato
Se utilizzi un runtime serverless Managed Service for Apache Spark 3.0 o versioni successive con
credenziali utente finale (impostazione predefinita), devi disporre anche dei seguenti ruoli di accesso ai dati:
Per ottenere le autorizzazioni necessarie per leggere e scrivere tabelle nel catalogo con le credenziali dell'utente finale, chiedi all'amministratore di concederti i seguenti ruoli IAM:
-
Leggi e scrivi i dati delle tabelle in modalità di distribuzione delle credenziali:
Editor BigLake (
roles/biglake.editor) sul progetto che contiene il catalogo -
Gestisci le risorse del catalogo e scrivi i dati della tabella in modalità di distribuzione non delle credenziali:
- BigLake Editor (
roles/biglake.editor) sul progetto che contiene il catalogo - Storage Object User (
roles/storage.objectUser) su tutti i bucket Cloud Storage associati al catalogo
- BigLake Editor (
Ruoli del service account
Concedi i seguenti ruoli al account di servizio che esegue il tuo workload.
I runtime serverless di Managed Service for Apache Spark 3.0 e versioni successive richiedono questi ruoli solo se il workload viene eseguito con le credenziali dell'account di servizio.
Per assicurarti che il account di servizio predefinito di Compute Engine o un account di servizio personalizzato disponga delle autorizzazioni necessarie per eseguire i job di Managed Service for Apache Spark e leggere e scrivere tabelle nel catalogo, chiedi all'amministratore di concedere i seguenti ruoli IAM al account di servizio predefinito di Compute Engine o a un account di servizio personalizzato:
-
Esegui i job di Managed Service for Apache Spark su un cluster o un runtime serverless 2.3 o versioni precedenti:
Dataproc Worker (
roles/dataproc.worker) sul progetto -
Esegui i job Managed Service for Apache Spark su un runtime serverless 3.0 o versioni successive:
- Dataproc Serverless Node (
roles/dataproc.serverlessNode) sul progetto - Dataproc Resource Manager Node Service Agent (
roles/dataprocrm.nodeServiceAgent) sul progetto
- Dataproc Serverless Node (
-
Leggi e scrivi i dati delle tabelle in modalità di distribuzione delle credenziali:
Editor BigLake (
roles/biglake.editor) sul progetto che contiene il catalogo -
Gestisci le risorse del catalogo e scrivi i dati della tabella in modalità di distribuzione non delle credenziali:
- BigLake Editor (
roles/biglake.editor) sul progetto che contiene il catalogo - Storage Object User (
roles/storage.objectUser) su tutti i bucket Cloud Storage associati al catalogo
- BigLake Editor (
Configura Managed Service for Apache Spark e crea una sessione Spark
Configura un cluster Managed Service for Apache Spark, un workload batch serverless Managed Service for Apache Spark o una sessione interattiva serverless Managed Service for Apache Spark per utilizzare il catalogo di runtime Iceberg REST del Lakehouse. Tutti e tre supportano la proprietà di configurazione semplificata dataproc.lakehouse.catalog.CATALOG_NAME (consigliata), che consente a Managed Service for Apache Spark di leggere la definizione del catalogo e generare le proprietà Spark del catalogo REST Iceberg. Solo la forma del cluster accetta il prefisso dataproc:.
Versioni di immagini e runtime supportate:
Sia la configurazione semplificata che quella manuale utilizzano l'autorizzazione Google
per Iceberg (GoogleAuthManager), che richiede una delle
seguenti versioni:
- Cluster Managed Service for Apache Spark: versioni immagine
2.22.2.65e successive o versioni immagine2.32.3.11e successive. - Sessioni interattive e workload batch serverless di Managed Service for Apache Spark: runtime
2.22.2.60e versioni successive, runtime2.32.3.10e versioni successive o runtime3.0.
Per i workload serverless batch e le sessioni interattive, i ruoli richiesti dipendono dalla versione di runtime. I runtime 3.0 e versioni successive utilizzano le credenziali dell'utente finale per impostazione predefinita. Per maggiori dettagli, consulta Ruoli richiesti.
Cluster
Crea un cluster Managed Service for Apache Spark con i componenti facoltativi Iceberg e Jupyter utilizzando le proprietà di configurazione semplificate (consigliato) o specificando manualmente le proprietà del catalogo nel notebook.
Configurazione semplificata utilizzando le proprietà (consigliato)
Crea il cluster con la proprietà del catalogo:
gcloud dataproc clusters create CLUSTER_NAME \
  --project=PROJECT_ID \
  --region=REGION \
  --image-version=IMAGE_VERSION \
  --optional-components=ICEBERG,JUPYTER \
  --enable-component-gateway \
  --properties='dataproc:dataproc.lineage.enabled=true,dataproc:dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark:spark.sql.defaultCatalog=CATALOG_NAME'
Sostituisci quanto segue:
CLUSTER_NAME: un nome per il cluster.PROJECT_ID: il tuo ID progettoGoogle Cloud .REGION: la regione Google Cloud del cluster, ad esempious-central1.IMAGE_VERSION: la versione immagine di Managed Service for Apache Spark, ad esempio2.3-debian12. Consulta Versioni di immagini e runtime supportate.CATALOG_NAME: un nome per il catalogo Spark locale, ad esempioiceberg_catalog. Può essere uguale aCATALOG_ID.CATALOG_ID: l'ID del catalogo che hai creato in Prima di iniziare.
La proprietà dataproc:dataproc.lineage.enabled=true non è obbligatoria per il corretto funzionamento del catalogo REST Iceberg del catalogo di runtime Lakehouse. Viene aggiunto per il monitoraggio della derivazione nell'esempio di derivazione dei dati.
Connettiti al cluster utilizzando un notebook Jupyter (un notebook Vertex AI Workbench o un notebook avviato sul cluster) e crea SparkSession senza specificare le configurazioni del catalogo:
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
Sostituisci APP_NAME con il nome della tua applicazione Spark.
Configurazione manuale
Se non utilizzi la proprietà di configurazione semplificata, crea il cluster
come descritto in precedenza senza dataproc:dataproc.lakehouse.catalog.
nel flag --properties, connettiti a un blocco note Jupyter e
configura manualmente SparkSession come segue:
import pyspark
from pyspark.context import SparkContext
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
Sostituisci quanto segue:
CATALOG_NAME: un nome per il catalogo Spark locale, ad esempioiceberg_catalog.APP_NAME: il nome della tua applicazione Spark.WAREHOUSE_PATH: il percorso del tuo warehouse. Per i cataloghi con più bucket (consigliato), utilizzabl://projects/PROJECT_ID/catalogs/CATALOG_ID. Per i cataloghi con un solo bucket, utilizzags://CLOUD_STORAGE_BUCKET_NAME.PROJECT_ID: il tuo ID progetto Google Cloud .
Configura con la distribuzione delle credenziali
Per utilizzare la distribuzione delle credenziali, devi utilizzare un catalogo in modalità di distribuzione delle credenziali e aggiungere l'intestazione X-Iceberg-Access-Delegation alle richieste del catalogo REST Iceberg con un valore vended-credentials aggiungendo la riga seguente al builder SparkSession:
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
Il seguente esempio configura SparkSession con
la distribuzione delle credenziali:
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
La configurazione semplificata aggiunge questa intestazione quando il catalogo utilizza la modalità di distribuzione delle credenziali. Per saperne di più, consulta la sezione Intestazioni in RESTCatalog della documentazione di Iceberg.
Serverless
Invia un workload batch PySpark a Managed Service for Apache Spark serverless utilizzando le proprietà di configurazione semplificate (consigliato) o specificando manualmente le proprietà del catalogo.
Configurazione semplificata tramite le proprietà (consigliata)
Passa la proprietà dataproc.lakehouse.catalog.CATALOG_NAME (senza il prefisso dataproc:) quando invii il workload batch:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark.sql.defaultCatalog=CATALOG_NAME"
Sostituisci quanto segue:
PYSPARK_FILE: il percorso Cloud Storagegs://del file dell'applicazione PySpark.PROJECT_ID: il tuo Google Cloud ID progetto.REGION: la regione del workload batch.RUNTIME_VERSION: la versione del runtime serverless di Managed Service for Apache Spark, ad esempio3.0. I ruoli richiesti dipendono dalla versione del runtime (consulta Versioni di immagini e runtime supportate).CATALOG_NAME: un nome per il catalogo Spark locale, ad esempioiceberg_catalog. Può essere uguale aCATALOG_ID.CATALOG_ID: l'ID del catalogo che hai creato in Prima di iniziare.
Nel file dell'applicazione PySpark, crea SparkSession senza
specificare le configurazioni del catalogo:
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
Configurazione manuale
Se non utilizzi la proprietà di configurazione semplificata, specifica le proprietà del catalogo nel flag --properties quando invii il carico di lavoro batch:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
Sostituisci WAREHOUSE_PATH con il percorso
del tuo warehouse. Per i cataloghi con più bucket (consigliato), utilizza
bl://projects/PROJECT_ID/catalogs/CATALOG_ID.
Per i cataloghi con un singolo bucket, utilizza gs://CLOUD_STORAGE_BUCKET_NAME.
Configura con la distribuzione delle credenziali
Per utilizzare la distribuzione delle credenziali, devi utilizzare un catalogo in modalità di distribuzione delle credenziali e aggiungere l'intestazione X-Iceberg-Access-Delegation alle richieste del catalogo REST Iceberg con un valore di vended-credentials aggiungendo la seguente proprietà al flag --properties:
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentialsL'esempio seguente invia un workload batch con distribuzione delle credenziali:
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentials,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
La configurazione semplificata aggiunge questa intestazione quando il catalogo utilizza la modalità di distribuzione delle credenziali. Per saperne di più, consulta la sezione
Intestazioni in RESTCatalog
della documentazione di Iceberg.
Serverless
Crea una sessione interattiva serverless Managed Service for Apache Spark da un notebook con l'API DataprocSparkSession, utilizzando proprietà di configurazione semplificate (consigliato) o specificando manualmente le proprietà del catalogo.
Configurazione semplificata tramite le proprietà (consigliata)
In un notebook in cui è installato il pacchetto dataproc-spark-connect, ad esempio un notebook BigQuery Studio o un notebook Vertex AI Workbench, passa la proprietà dataproc.lakehouse.catalog.CATALOG_NAME (senza il prefisso dataproc:) quando crei la sessione:
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config(f'dataproc.lakehouse.catalog.{catalog_name}', 'projects/PROJECT_ID/catalogs/CATALOG_ID') \
.config('spark.sql.defaultCatalog', catalog_name) \
.getOrCreate()
Sostituisci quanto segue:
CATALOG_NAME: un nome per il catalogo Spark locale, ad esempioiceberg_catalog. Può essere uguale aCATALOG_ID.RUNTIME_VERSION: la versione del runtime serverless di Managed Service for Apache Spark, ad esempio3.0. I ruoli richiesti dipendono dalla versione del runtime (vedi Versioni di runtime e immagini supportate).APP_NAME: il nome dell'applicazione Spark.PROJECT_ID: il tuo ID progettoGoogle Cloud .CATALOG_ID: l'ID del catalogo che hai creato in Prima di iniziare.
Puoi impostare queste proprietà anche in un template di sessione.
Configurazione manuale
Se non utilizzi la proprietà di configurazione semplificata, specifica le proprietà del catalogo quando crei la sessione:
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
Sostituisci RUNTIME_VERSION come descritto nell'esempio di configurazione semplificata riportato in precedenza in questa scheda.
Sostituisci WAREHOUSE_PATH con il percorso del tuo warehouse. Per i cataloghi con più bucket (consigliato), utilizza
bl://projects/PROJECT_ID/catalogs/CATALOG_ID.
Per i cataloghi con un singolo bucket, utilizza gs://CLOUD_STORAGE_BUCKET_NAME.
Configura con la distribuzione delle credenziali
Per utilizzare la distribuzione delle credenziali, devi utilizzare un
catalogo in modalità di distribuzione delle credenziali
e aggiungere l'intestazione X-Iceberg-Access-Delegation alle
richieste del catalogo REST Iceberg con un valore di
vended-credentials aggiungendo la seguente riga al
generatore di sessioni:
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
L'esempio seguente crea una sessione con la distribuzione delle credenziali:
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
La configurazione semplificata aggiunge questa intestazione quando il catalogo utilizza la modalità di distribuzione delle credenziali. Per saperne di più, consulta la sezione
Intestazioni in RESTCatalog
della documentazione di Iceberg.
Gestire i dati con Spark SQL
Dopo aver configurato la sessione Spark, utilizza Spark SQL per eseguire le operazioni di gestione dei dati.
Impostazione del catalogo: la proprietà dataproc.lakehouse.catalog. registra il catalogo con Spark, ma non lo rende il catalogo predefinito. Gli esempi nella sezione precedente impostano spark.sql.defaultCatalog (spark:spark.sql.defaultCatalog su un cluster) in modo da poter utilizzare nomi di tabelle non qualificati. Se ometti questa proprietà, qualifica i nomi delle tabelle con il nome del catalogo, ad esempio CATALOG_NAME.NAMESPACE_NAME.base_table.
Crea uno spazio dei nomi. Nel catalogo di runtime Lakehouse catalogo REST Iceberg, uno spazio dei nomi corrisponde a un set di dati BigQuery.
spark.sql("CREATE NAMESPACE IF NOT EXISTS NAMESPACE_NAME")
spark.sql("USE NAMESPACE_NAME")
Sostituisci
NAMESPACE_NAMEcon il nome del tuo spazio dei nomi, ad esempiospark_lakehouse.Crea una tabella di base in formato Iceberg e inserisci i dati.
spark.sql("DROP TABLE IF EXISTS base_table PURGE")
spark.sql("CREATE TABLE base_table (id LONG) USING iceberg")
spark.sql("INSERT INTO base_table VALUES 0, 1, 2, 3, 4")
spark.sql("SELECT * FROM base_table").show()
L'output è simile al seguente:
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   +---+
Crea un'altra tabella per i nuovi dati.
spark.sql("DROP TABLE IF EXISTS newdata PURGE")
spark.sql("CREATE TABLE newdata(id LONG) USING iceberg")
spark.sql("INSERT INTO newdata VALUES 3, 4, 5, 6")
spark.sql("SELECT * FROM newdata").show()
L'output è simile al seguente:
   +---+
   | id|
   +---+
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
Unisci i nuovi dati alla tabella di base.
spark.sql("""MERGE INTO base_table USING newdata
           ON base_table.id = newdata.id
           WHEN MATCHED THEN
             UPDATE SET base_table.id = newdata.id
           WHEN NOT MATCHED THEN INSERT * """)
spark.sql("SELECT * FROM base_table").show()
L'output è simile al seguente:
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
Aggiorna i record nella tabella di base.
spark.sql(
     "UPDATE base_table SET id = (id + 100) WHERE (id % 2 == 0)"
 )
spark.sql("SELECT * FROM base_table").show()
L'output è simile al seguente:
   +---+
   | id|
   +---+
   |  3|
   |104|
   |  5|
   |106|
   |100|
   |102|
   |  1|
   +---+
Elimina i record dalla tabella di base.
spark.sql("DELETE FROM base_table WHERE (id % 2 == 0)")
spark.sql("SELECT * FROM base_table").show()
L'output è simile al seguente:
   +---+
   | id|
   +---+
   |  3|
   |  5|
   |  1|
   +---+
Eseguire una query su un'istantanea storica
Recupera una versione precedente di una tabella eseguendo una query su un ID snapshot. Questa operazione è nota anche come viaggio nel tempo.
Recupera l'ID snapshot della versione della tabella prima delle operazioni
MERGE,UPDATEeDELETE.snapshot_ids = spark.sql( "SELECT snapshot_id FROM `NAMESPACE_NAME`.`base_table`.snapshots" ).collect() oldest_snapshot_id = snapshot_ids[1]["snapshot_id"]Sostituisci
NAMESPACE_NAMEcon lo spazio dei nomi che hai creato.Esegui una query sulla tabella utilizzando l'ID snapshot recuperato.
df = (
     spark.read.format("iceberg")
     .option("versionAsOf", oldest_snapshot_id)
     .load("base_table")
 )
df.show()
L'output mostra lo stato della tabella dopo l'operazione
MERGE, ma prima delle operazioniUPDATEoDELETE.+---+ | id| +---+ | 0| | 1| | 2| | 3| | 4| | 5| | 6| +---+
Scopri la derivazione dei dati
Utilizzando Managed Service for Apache Spark 2.2 e versioni successive delle immagini,
puoi monitorare lo spostamento dei dati tra le tabelle del catalogo runtime lakehouse
del catalogo REST di Iceberg
con la provenienza dei dati.
Esempio di derivazione dei dati
Crea tabelle Iceberg di origine e di destinazione, poi copia i dati.
spark.sql("DROP TABLE IF EXISTS source_table PURGE")
spark.sql("DROP TABLE IF EXISTS target_table PURGE")
spark.sql("CREATE TABLE source_table (id LONG) USING iceberg")
spark.sql("""CREATE TABLE target_table
  USING ICEBERG
  AS SELECT max(id) as top_id FROM source_table
  """)
Nella console Google Cloud , vai alla pagina Knowledge Catalog Ricerca.
Cerca una delle tabelle e fai clic sulla scheda
Lineage: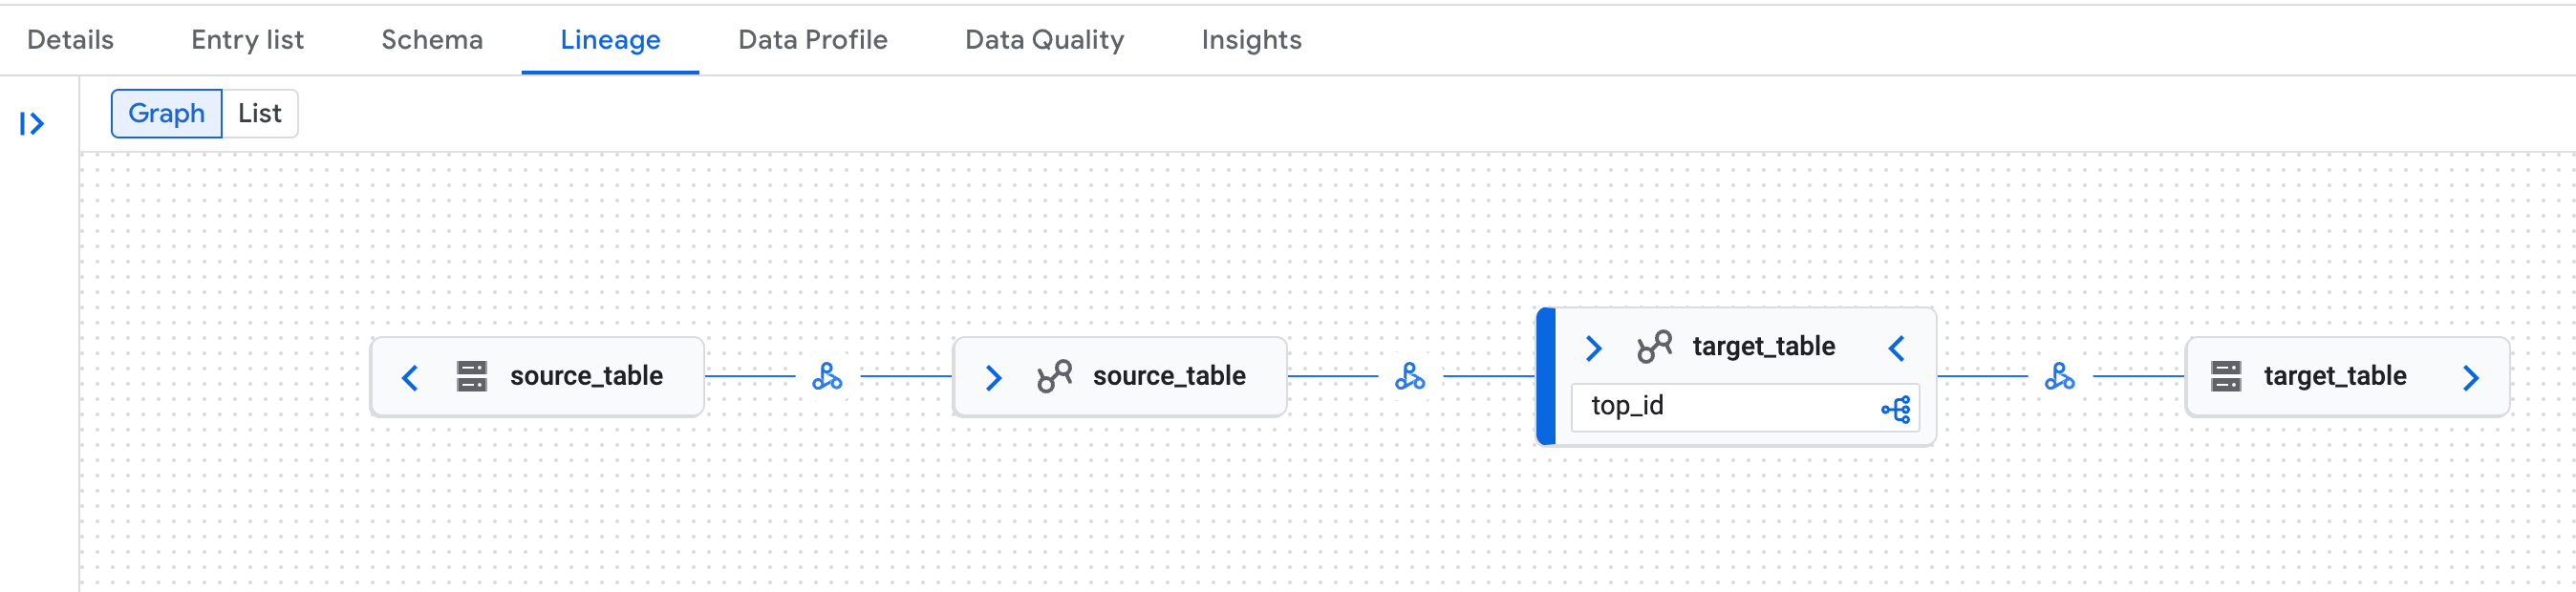
Esempio di grafico della derivazione dei dati nella pagina Knowledge Catalog della console Google Cloud . La derivazione dei dati riconosce sia le rappresentazioni logiche (tabella del catalogo di runtime Lakehouse) sia quelle fisiche (Cloud Storage) delle tabelle del catalogo REST Iceberg del catalogo di runtime Lakehouse.
Problemi noti relativi alla derivazione dei dati
In alcuni cluster Managed Service for Apache Spark, la derivazione completa dei dati potrebbe non essere generata a causa di un problema della libreria OpenLineage. Si tratta di una limitazione nota. Se influisce sui tuoi workload, contatta l'assistenza Google Cloud.
Passaggi successivi
- Scopri di più sul catalogo REST Iceberg del catalogo di runtime Lakehouse.
- Esegui query sui cataloghi federati con Spark.
- Esplora le funzionalità di Apache Iceberg.
- Scopri come eseguire query sui dati Iceberg dal catalogo di runtime Lakehouse.
- Scopri di più sulla derivazione dei dati e su Managed Service for Apache Spark.