


Créer un lakehouse avec Spark et le catalogue d'environnements d'exécution Lakehouse
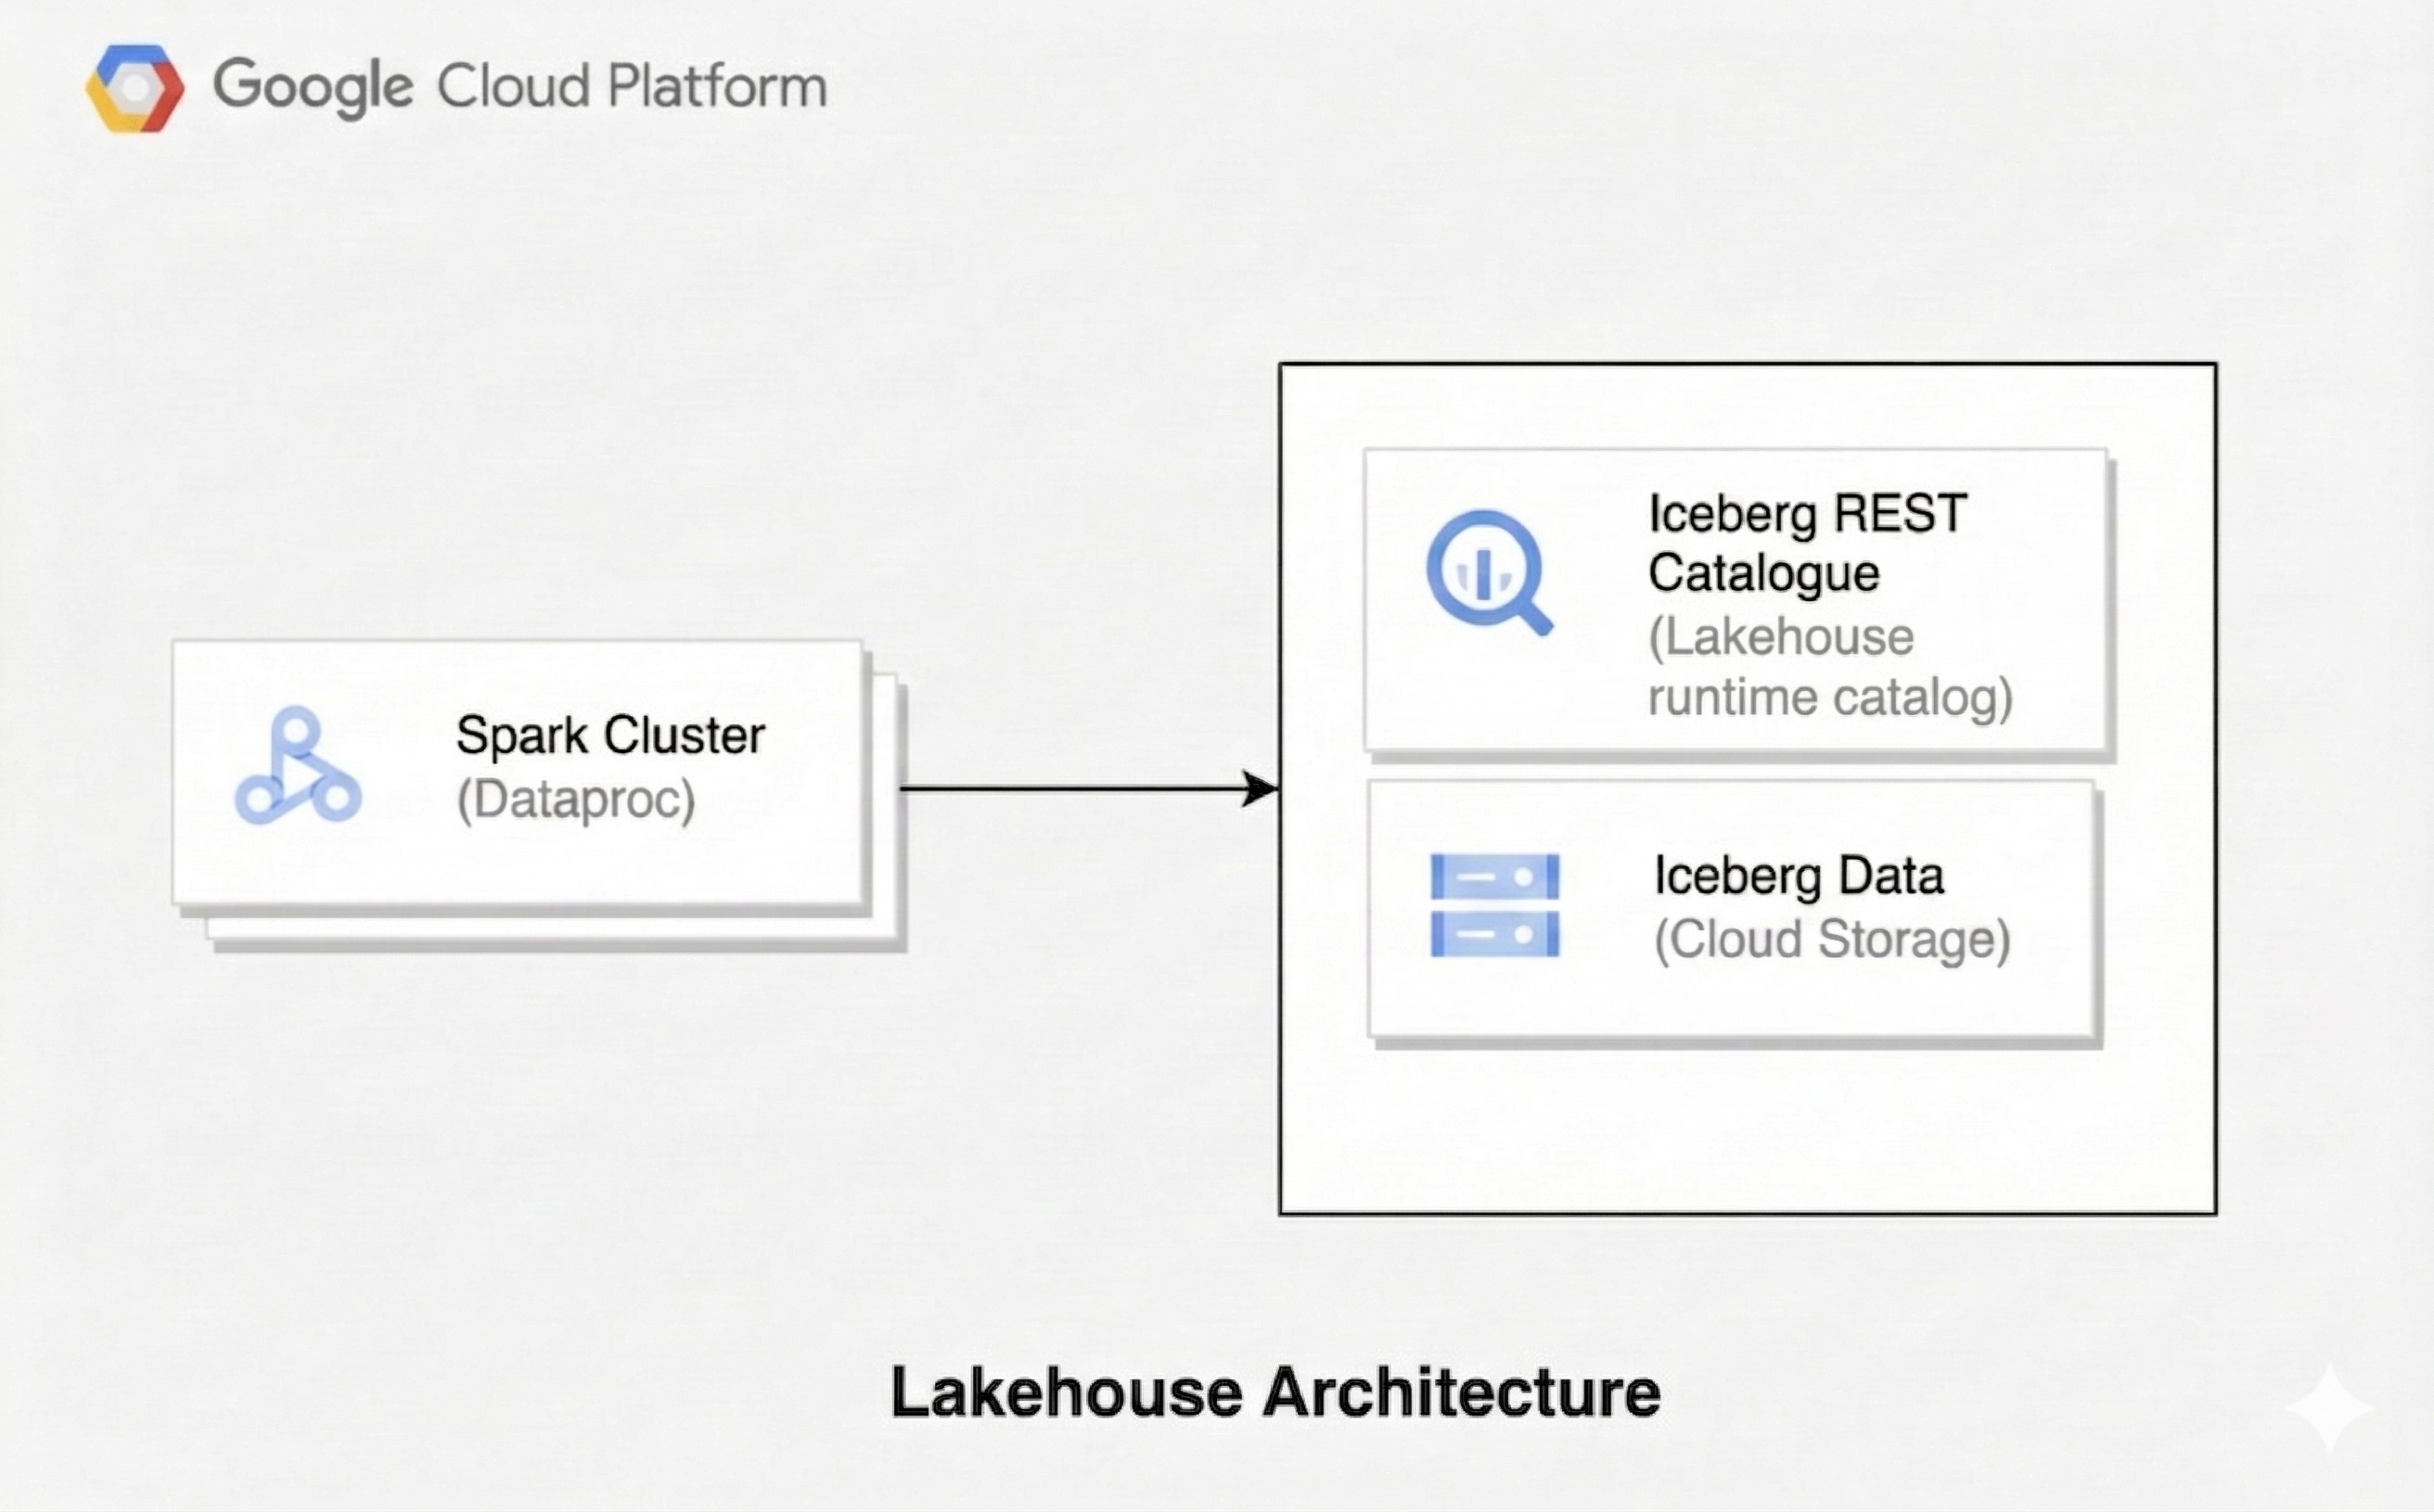
Une architecture de lakehouse combine la flexibilité d'un lac de données avec les fonctionnalités de gestion des données d'un entrepôt de données. Ce document vous explique comment configurer un lakehouse sur Google Cloud. Vous utilisez Apache Iceberg comme format de table, Managed Service pour Apache Spark pour le traitement et le catalogue d'exécution Lakehouse Iceberg REST Catalog pour la gestion unifiée des métadonnées.
Cette architecture utilise des formats de table ouverts tels qu'Iceberg pour ajouter des fonctionnalités d'entreposage de données, telles que les transactions et l'évolution des schémas, aux données dans Cloud Storage. Cette approche crée une source unique de vérité pour vos données, à laquelle différents moteurs peuvent accéder.
Ce document traite des catalogues que vous créez dans le catalogue d'environnements d'exécution Lakehouse. Pour interroger des tables Iceberg gérées par AWS Glue Data Catalog, Databricks Unity Catalog ou Snowflake Horizon Catalog via des catalogues fédérés du catalogue d'environnements d'exécution Lakehouse, consultez Interroger des catalogues fédérés avec Spark.
Avant de commencer
- Connectez-vous à votre compte Google Cloud . Si vous débutez sur Google Cloud, créez un compte pour évaluer les performances de nos produits en conditions réelles. Les nouveaux clients bénéficient également de 300 $ de crédits sans frais pour exécuter, tester et déployer des charges de travail.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that you have the permissions required to complete this guide.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Dataproc, BigLake, BigQuery, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.- Créez un bucket Cloud Storage pour stocker les données Iceberg.
- Créez un catalogue dans le catalogue d'environnements d'exécution Lakehouse qui pointe vers votre bucket. Nous vous recommandons d'utiliser un catalogue à plusieurs buckets.
Rôles requis
Certains rôles IAM (Identity and Access Management) sont requis pour exécuter les exemples de cette page. En fonction des règles d'administration, ces rôles peuvent déjà avoir été accordés. Pour vérifier les attributions de rôles, consultez Devez-vous attribuer des rôles ?.
Pour en savoir plus sur l'attribution de rôles, consultez Gérer l'accès aux projets, aux dossiers et aux organisations.
Les rôles dont vous avez besoin dépendent de la façon dont votre charge de travail s'exécute.
Les clusters Managed Service pour Apache Spark et les runtimes sans serveur Managed Service pour Apache Spark 2.3 et versions antérieures exécutent les charges de travail en tant que compte de service. Les runtimes sans serveur Managed Service pour Apache Spark 3.0 et versions ultérieures exécutent les charges de travail avec vos identifiants utilisateur finaux (EUC) par défaut. Vous accordez donc des rôles d'accès aux données à votre compte utilisateur au lieu d'un compte de service. Si vous spécifiez un compte de service personnalisé pour un environnement d'exécution 3.0 ou version ultérieure, la charge de travail s'exécute avec les identifiants du compte de service. Pour en savoir plus, consultez la section Rôles des déploiements serverless.
Rôles utilisateur
Pour obtenir les autorisations nécessaires pour créer un cluster Managed Service pour Apache Spark, envoyer une charge de travail par lot ou créer une session interactive, demandez à votre administrateur de vous accorder les rôles IAM suivants :
-
Utilisez un cluster ou un environnement d'exécution sans serveur version 2.3 ou antérieure :
- Éditeur Dataproc (
roles/dataproc.editor) sur le projet - Utilisateur du compte de service (
roles/iam.serviceAccountUser) sur le compte de service Compute Engine par défaut ou un compte de service personnalisé
- Éditeur Dataproc (
-
Utilisez un environnement d'exécution sans serveur 3.0 ou version ultérieure :
Éditeur Dataproc sans serveur (
roles/dataproc.serverlessEditor) sur le projet -
Utilisez les identifiants du compte de service sur un environnement d'exécution sans serveur 3.0 ou version ultérieure : Utilisateur du compte de service (
roles/iam.serviceAccountUser) sur le compte de service personnalisé
Si vous utilisez un environnement d'exécution sans serveur Managed Service pour Apache Spark 3.0 ou version ultérieure avec des identifiants d'utilisateur final (par défaut), vous avez également besoin des rôles d'accès aux données suivants :
Pour obtenir les autorisations nécessaires pour lire et écrire des tables dans votre catalogue avec des identifiants d'utilisateur final, demandez à votre administrateur de vous accorder les rôles IAM suivants :
-
Lire et écrire des données de table en mode de distribution d'identifiants : Éditeur BigLake (
roles/biglake.editor) sur le projet contenant le catalogue -
Gérer les ressources du catalogue et écrire des données de table en mode de distribution sans identifiants :
- Éditeur BigLake (
roles/biglake.editor) sur le projet contenant le catalogue - Utilisateur d'objets Storage (
roles/storage.objectUser) sur tous les buckets Cloud Storage associés au catalogue
- Éditeur BigLake (
Rôles de compte de service
Attribuez les rôles suivants au compte de service qui exécute votre charge de travail.
Les environnements d'exécution sans serveur Managed Service pour Apache Spark 3.0 et versions ultérieures n'ont besoin de ces rôles que si la charge de travail s'exécute avec les identifiants du compte de service.
Pour vous assurer que le compte de service Compute Engine par défaut ou un compte de service personnalisé dispose des autorisations nécessaires pour exécuter des jobs Managed Service pour Apache Spark, et lire et écrire des tables dans votre catalogue, demandez à votre administrateur d'attribuer les rôles IAM suivants au compte de service Compute Engine par défaut ou à un compte de service personnalisé :
-
Exécuter des jobs Managed Service pour Apache Spark sur un cluster ou un environnement d'exécution sans serveur 2.3 ou version antérieure :
Nœud de calcul Dataproc (
roles/dataproc.worker) dans le projet -
Exécutez des jobs Managed Service pour Apache Spark sur un environnement d'exécution sans serveur 3.0 ou version ultérieure :
- Nœud Dataproc sans serveur (
roles/dataproc.serverlessNode) sur le projet - Agent de service de nœud Resource Manager pour Dataproc (
roles/dataprocrm.nodeServiceAgent) sur le projet
- Nœud Dataproc sans serveur (
-
Lire et écrire des données de table en mode de distribution d'identifiants : Éditeur BigLake (
roles/biglake.editor) sur le projet contenant le catalogue -
Gérer les ressources du catalogue et écrire des données de table en mode de distribution sans identifiants :
- Éditeur BigLake (
roles/biglake.editor) sur le projet contenant le catalogue - Utilisateur d'objets Storage (
roles/storage.objectUser) sur tous les buckets Cloud Storage associés au catalogue
- Éditeur BigLake (
Configurer Managed Service pour Apache Spark et créer une session Spark
Configurez un cluster Managed Service pour Apache Spark, une charge de travail par lot sans serveur Managed Service pour Apache Spark ou une session interactive sans serveur Managed Service pour Apache Spark afin d'utiliser le catalogue REST Iceberg du catalogue d'environnements d'exécution Lakehouse. Tous les trois sont compatibles avec la propriété de configuration simplifiée dataproc.lakehouse.catalog.CATALOG_NAME (recommandée), qui permet à Managed Service pour Apache Spark de lire la définition du catalogue et de générer les propriétés Spark du catalogue REST Iceberg. Seule la forme de cluster utilise le préfixe dataproc:.
Versions d'image et d'exécution compatibles :
La configuration simplifiée et la configuration manuelle utilisent l'autorisation Google pour Iceberg (GoogleAuthManager), qui nécessite l'une des versions suivantes :
- Clusters Managed Service pour Apache Spark : versions d'image
2.22.2.65et ultérieures, ou versions d'image2.32.3.11et ultérieures. - Charges de travail par lot et sessions interactives Managed Service pour Apache Spark sans serveur : environnements d'exécution
2.22.2.60ou version ultérieure, environnements d'exécution2.32.3.10ou version ultérieure, ou environnements d'exécution3.0.
Pour les charges de travail par lot sans serveur et les sessions interactives, les rôles requis dépendent de la version de l'environnement d'exécution. Les environnements d'exécution 3.0 et versions ultérieures utilisent par défaut les identifiants de l'utilisateur final. Pour en savoir plus, consultez Rôles requis.
Cluster
Créez un cluster Managed Service pour Apache Spark avec les composants facultatifs Iceberg et Jupyter à l'aide de propriétés de configuration simplifiées (recommandé) ou en spécifiant manuellement les propriétés du catalogue dans votre notebook.
Configuration simplifiée à l'aide de propriétés (recommandé)
Créez le cluster avec la propriété de catalogue :
gcloud dataproc clusters create CLUSTER_NAME \
  --project=PROJECT_ID \
  --region=REGION \
  --image-version=IMAGE_VERSION \
  --optional-components=ICEBERG,JUPYTER \
  --enable-component-gateway \
  --properties='dataproc:dataproc.lineage.enabled=true,dataproc:dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark:spark.sql.defaultCatalog=CATALOG_NAME'
Remplacez les éléments suivants :
CLUSTER_NAME: nom de votre cluster.PROJECT_ID: ID de votre projetGoogle Cloud .REGION: région du cluster, par exempleus-central1. Google CloudIMAGE_VERSION: version de l'image Managed Service pour Apache Spark (par exemple,2.3-debian12). Consultez Versions d'image et d'environnement d'exécution compatibles.CATALOG_NAME: nom du catalogue Spark local, par exempleiceberg_catalog. Il peut être identique àCATALOG_ID.CATALOG_ID: ID du catalogue que vous avez créé dans la section Avant de commencer.
La propriété dataproc:dataproc.lineage.enabled=true n'est pas requise pour que le catalogue REST Iceberg du Lakehouse Runtime fonctionne correctement. Il est ajouté pour le suivi de la traçabilité dans l'exemple de traçabilité des données.
Connectez-vous au cluster à l'aide d'un notebook Jupyter (un notebook Vertex AI Workbench ou un notebook lancé sur le cluster), puis créez le SparkSession sans spécifier de configuration de catalogue :
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
Remplacez APP_NAME par le nom de votre application Spark.
Configuration manuelle
Si vous n'utilisez pas la propriété de configuration simplifiée, créez le cluster comme décrit précédemment sans dataproc:dataproc.lakehouse.catalog. dans l'option --properties, connectez-vous à un notebook Jupyter et configurez manuellement votre SparkSession, comme suit :
import pyspark
from pyspark.context import SparkContext
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
Remplacez les éléments suivants :
CATALOG_NAME: nom du catalogue Spark local, par exempleiceberg_catalog.APP_NAME: nom de votre application Spark.WAREHOUSE_PATH: chemin d'accès à votre entrepôt. Pour les catalogues à plusieurs buckets (recommandé), utilisezbl://projects/PROJECT_ID/catalogs/CATALOG_ID. Pour les catalogues à bucket unique, utilisezgs://CLOUD_STORAGE_BUCKET_NAME.PROJECT_ID: ID de votre projet Google Cloud .
Configurer avec la distribution d'identifiants
Pour utiliser la distribution d'identifiants, vous devez utiliser un catalogue en mode de distribution d'identifiants et ajouter l'en-tête X-Iceberg-Access-Delegation aux requêtes de catalogue REST Iceberg avec une valeur de vended-credentials en ajoutant la ligne suivante au générateur SparkSession :
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
L'exemple suivant configure SparkSession avec la distribution d'identifiants :
from pyspark.sql import SparkSession

catalog_name = "CATALOG_NAME"

spark = SparkSession.builder.appName("APP_NAME") \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
La configuration simplifiée ajoute cet en-tête lorsque le catalogue utilise le mode de distribution des identifiants. Pour en savoir plus, consultez la section En-têtes dans RESTCatalog de la documentation Iceberg.
Sans serveur
Envoyez une charge de travail par lot PySpark à Managed Service pour Apache Spark sans serveur à l'aide de propriétés de configuration simplifiées (recommandé) ou en spécifiant manuellement les propriétés du catalogue.
Configuration simplifiée à l'aide de propriétés (recommandé)
Transmettez la propriété dataproc.lakehouse.catalog.CATALOG_NAME (sans le préfixe dataproc:) lorsque vous envoyez la charge de travail par lot :
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="dataproc.lakehouse.catalog.CATALOG_NAME=projects/PROJECT_ID/catalogs/CATALOG_ID,spark.sql.defaultCatalog=CATALOG_NAME"
Remplacez les éléments suivants :
PYSPARK_FILE: chemin d'accès Cloud Storagegs://vers le fichier de votre application PySpark.PROJECT_ID: ID de votre projetGoogle Cloud .REGION: région de votre charge de travail par lot.RUNTIME_VERSION: version d'exécution sans serveur de Managed Service pour Apache Spark (par exemple,3.0). Les rôles requis dépendent de la version de l'environnement d'exécution (voir Versions d'image et d'environnement d'exécution compatibles).CATALOG_NAME: nom du catalogue Spark local, par exempleiceberg_catalog. Elle peut être identique àCATALOG_ID.CATALOG_ID: ID du catalogue que vous avez créé dans la section Avant de commencer.
Dans le fichier de votre application PySpark, créez le SparkSession sans spécifier de configurations de catalogue :
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("APP_NAME").getOrCreate()
Configuration manuelle
Si vous n'utilisez pas la propriété de configuration simplifiée, spécifiez les propriétés du catalogue dans le flag --properties lorsque vous envoyez votre charge de travail par lot :
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
Remplacez WAREHOUSE_PATH par le chemin d'accès à votre entrepôt. Pour les catalogues à plusieurs buckets (recommandé), utilisez bl://projects/PROJECT_ID/catalogs/CATALOG_ID.
Pour les catalogues à bucket unique, utilisez gs://CLOUD_STORAGE_BUCKET_NAME.
Configurer avec la distribution d'identifiants
Pour utiliser la distribution d'identifiants, vous devez utiliser un catalogue en mode de distribution d'identifiants et ajouter l'en-tête X-Iceberg-Access-Delegation aux requêtes du catalogue REST Iceberg avec la valeur vended-credentials en ajoutant la propriété suivante à l'option --properties :
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentialsL'exemple suivant envoie une charge de travail par lot avec la distribution d'identifiants :
gcloud dataproc batches submit pyspark PYSPARK_FILE \
  --project=PROJECT_ID \
  --region=REGION \
  --version=RUNTIME_VERSION \
  --properties="\
spark.sql.defaultCatalog=CATALOG_NAME,\
spark.sql.catalog.CATALOG_NAME=org.apache.iceberg.spark.SparkCatalog,\
spark.sql.catalog.CATALOG_NAME.type=rest,\
spark.sql.catalog.CATALOG_NAME.uri=https://biglake.googleapis.com/iceberg/v1/restcatalog,\
spark.sql.catalog.CATALOG_NAME.warehouse=WAREHOUSE_PATH,\
spark.sql.catalog.CATALOG_NAME.header.x-goog-user-project=PROJECT_ID,\
spark.sql.catalog.CATALOG_NAME.rest.auth.type=org.apache.iceberg.gcp.auth.GoogleAuthManager,\
spark.sql.catalog.CATALOG_NAME.io-impl=org.apache.iceberg.gcp.gcs.GCSFileIO,\
spark.sql.catalog.CATALOG_NAME.header.X-Iceberg-Access-Delegation=vended-credentials,\
spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
La configuration simplifiée ajoute cet en-tête lorsque le catalogue utilise le mode de distribution d'identifiants. Pour en savoir plus, consultez la section En-têtes dans RESTCatalog de la documentation Iceberg.
Sans serveur
Créez une session interactive sans serveur Managed Service pour Apache Spark à partir d'un notebook avec l'API DataprocSparkSession, en utilisant des propriétés de configuration simplifiées (recommandé) ou en spécifiant manuellement les propriétés du catalogue.
Configuration simplifiée à l'aide de propriétés (recommandé)
Dans un notebook sur lequel le package dataproc-spark-connect est installé, tel qu'un notebook BigQuery Studio ou un notebook Vertex AI Workbench, transmettez la propriété dataproc.lakehouse.catalog.CATALOG_NAME (sans le préfixe dataproc:) lorsque vous créez la session :
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config(f'dataproc.lakehouse.catalog.{catalog_name}', 'projects/PROJECT_ID/catalogs/CATALOG_ID') \
.config('spark.sql.defaultCatalog', catalog_name) \
.getOrCreate()
Remplacez les éléments suivants :
CATALOG_NAME: nom du catalogue Spark local, par exempleiceberg_catalog. Elle peut être identique àCATALOG_ID.RUNTIME_VERSION: version d'exécution sans serveur de Managed Service pour Apache Spark (par exemple,3.0). Les rôles requis dépendent de la version de l'environnement d'exécution (voir Versions d'image et d'environnement d'exécution compatibles).APP_NAME: nom de votre application Spark.PROJECT_ID: ID de votre projetGoogle Cloud .CATALOG_ID: ID du catalogue que vous avez créé dans la section Avant de commencer.
Vous pouvez également définir ces propriétés dans un modèle de session.
Configuration manuelle
Si vous n'utilisez pas la propriété de configuration simplifiée, spécifiez les propriétés du catalogue lorsque vous créez la session :
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
Remplacez RUNTIME_VERSION comme décrit dans l'exemple de configuration simplifiée plus haut dans cet onglet.
Remplacez WAREHOUSE_PATH par le chemin d'accès à votre entrepôt. Pour les catalogues à plusieurs buckets (recommandé), utilisez bl://projects/PROJECT_ID/catalogs/CATALOG_ID.
Pour les catalogues à bucket unique, utilisez gs://CLOUD_STORAGE_BUCKET_NAME.
Configurer avec la distribution d'identifiants
Pour utiliser la distribution d'identifiants, vous devez utiliser un catalogue en mode de distribution d'identifiants et ajouter l'en-tête X-Iceberg-Access-Delegation aux requêtes de catalogue REST Iceberg avec la valeur vended-credentials en ajoutant la ligne suivante au compilateur de session :
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials')
L'exemple suivant crée une session avec distribution d'identifiants :
from google.cloud.dataproc_spark_connect import DataprocSparkSession
from google.cloud.dataproc_v1 import Session

catalog_name = "CATALOG_NAME"

session_config = Session()
session_config.runtime_config.version = 'RUNTIME_VERSION'

spark = DataprocSparkSession.builder.appName("APP_NAME") \
.dataprocSessionConfig(session_config) \
.config('spark.sql.defaultCatalog', catalog_name) \
.config(f'spark.sql.catalog.{catalog_name}', 'org.apache.iceberg.spark.SparkCatalog') \
.config(f'spark.sql.catalog.{catalog_name}.type', 'rest') \
.config(f'spark.sql.catalog.{catalog_name}.uri', 'https://biglake.googleapis.com/iceberg/v1/restcatalog') \
.config(f'spark.sql.catalog.{catalog_name}.warehouse', 'WAREHOUSE_PATH') \
.config(f'spark.sql.catalog.{catalog_name}.header.x-goog-user-project', 'PROJECT_ID') \
.config(f'spark.sql.catalog.{catalog_name}.rest.auth.type', 'org.apache.iceberg.gcp.auth.GoogleAuthManager') \
.config(f'spark.sql.catalog.{catalog_name}.io-impl', 'org.apache.iceberg.gcp.gcs.GCSFileIO') \
.config(f'spark.sql.catalog.{catalog_name}.header.X-Iceberg-Access-Delegation', 'vended-credentials') \
.config('spark.sql.extensions', 'org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions') \
.getOrCreate()
La configuration simplifiée ajoute cet en-tête lorsque le catalogue utilise le mode de distribution des identifiants. Pour en savoir plus, consultez la section En-têtes dans RESTCatalog de la documentation Iceberg.
Gérer les données avec Spark SQL
Après avoir configuré la session Spark, utilisez Spark SQL pour effectuer des opérations de gestion des données.
Définir le catalogue : la propriété dataproc.lakehouse.catalog. enregistre le catalogue auprès de Spark, mais n'en fait pas le catalogue par défaut. Les exemples de la section précédente définissent spark.sql.defaultCatalog (spark:spark.sql.defaultCatalog sur un cluster) afin que vous puissiez utiliser des noms de table non qualifiés. Si vous omettez cette propriété, qualifiez les noms de table avec le nom du catalogue, par exemple CATALOG_NAME.NAMESPACE_NAME.base_table.
Créez un espace de noms. Dans le catalogue REST Iceberg du catalogue d'environnements d'exécution Lakehouse, un espace de noms correspond à un ensemble de données BigQuery.
spark.sql("CREATE NAMESPACE IF NOT EXISTS NAMESPACE_NAME")
spark.sql("USE NAMESPACE_NAME")
Remplacez
NAMESPACE_NAMEpar le nom de votre espace de noms, par exemplespark_lakehouse.Créez une table de base au format Iceberg et insérez des données.
spark.sql("DROP TABLE IF EXISTS base_table PURGE")
spark.sql("CREATE TABLE base_table (id LONG) USING iceberg")
spark.sql("INSERT INTO base_table VALUES 0, 1, 2, 3, 4")
spark.sql("SELECT * FROM base_table").show()
Le résultat ressemble à ce qui suit :
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   +---+
Créez une autre table pour les nouvelles données.
spark.sql("DROP TABLE IF EXISTS newdata PURGE")
spark.sql("CREATE TABLE newdata(id LONG) USING iceberg")
spark.sql("INSERT INTO newdata VALUES 3, 4, 5, 6")
spark.sql("SELECT * FROM newdata").show()
Le résultat ressemble à ce qui suit :
   +---+
   | id|
   +---+
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
Fusionnez les nouvelles données dans la table de base.
spark.sql("""MERGE INTO base_table USING newdata
           ON base_table.id = newdata.id
           WHEN MATCHED THEN
             UPDATE SET base_table.id = newdata.id
           WHEN NOT MATCHED THEN INSERT * """)
spark.sql("SELECT * FROM base_table").show()
Le résultat ressemble à ce qui suit :
   +---+
   | id|
   +---+
   |  0|
   |  1|
   |  2|
   |  3|
   |  4|
   |  5|
   |  6|
   +---+
Mettez à jour les enregistrements de la table de base.
spark.sql(
     "UPDATE base_table SET id = (id + 100) WHERE (id % 2 == 0)"
 )
spark.sql("SELECT * FROM base_table").show()
Le résultat ressemble à ce qui suit :
   +---+
   | id|
   +---+
   |  3|
   |104|
   |  5|
   |106|
   |100|
   |102|
   |  1|
   +---+
Supprimez des enregistrements de la table de base.
spark.sql("DELETE FROM base_table WHERE (id % 2 == 0)")
spark.sql("SELECT * FROM base_table").show()
Le résultat ressemble à ce qui suit :
   +---+
   | id|
   +---+
   |  3|
   |  5|
   |  1|
   +---+
Interroger un instantané historique
Récupérez une version précédente d'une table en interrogeant un ID d'instantané. Cette opération est également appelée voyage dans le temps.
Récupérez l'ID d'instantané de la version de la table avant les opérations
MERGE,UPDATEetDELETE.snapshot_ids = spark.sql( "SELECT snapshot_id FROM `NAMESPACE_NAME`.`base_table`.snapshots" ).collect() oldest_snapshot_id = snapshot_ids[1]["snapshot_id"]Remplacez
NAMESPACE_NAMEpar l'espace de noms que vous avez créé.Interrogez la table à l'aide de l'ID d'instantané récupéré.
df = (
     spark.read.format("iceberg")
     .option("versionAsOf", oldest_snapshot_id)
     .load("base_table")
 )
df.show()
Le résultat affiche l'état de la table après l'opération
MERGE, mais avant les opérationsUPDATEouDELETE.+---+ | id| +---+ | 0| | 1| | 2| | 3| | 4| | 5| | 6| +---+
Découvrir la traçabilité des données
À l'aide de Managed Service pour Apache Spark 2.2 et des versions d'image ultérieures, vous pouvez suivre le déplacement des données entre les tables du catalogue REST Iceberg du catalogue d'exécution Lakehouse avec la traçabilité des données.
Exemple de traçabilité des données
Créez des tables Iceberg sources et cibles, puis copiez les données.
spark.sql("DROP TABLE IF EXISTS source_table PURGE")
spark.sql("DROP TABLE IF EXISTS target_table PURGE")
spark.sql("CREATE TABLE source_table (id LONG) USING iceberg")
spark.sql("""CREATE TABLE target_table
  USING ICEBERG
  AS SELECT max(id) as top_id FROM source_table
  """)
Dans la console Google Cloud , accédez à la page Knowledge Catalog > Rechercher.
Recherchez l'une des tables, puis cliquez sur l'onglet
Lineage: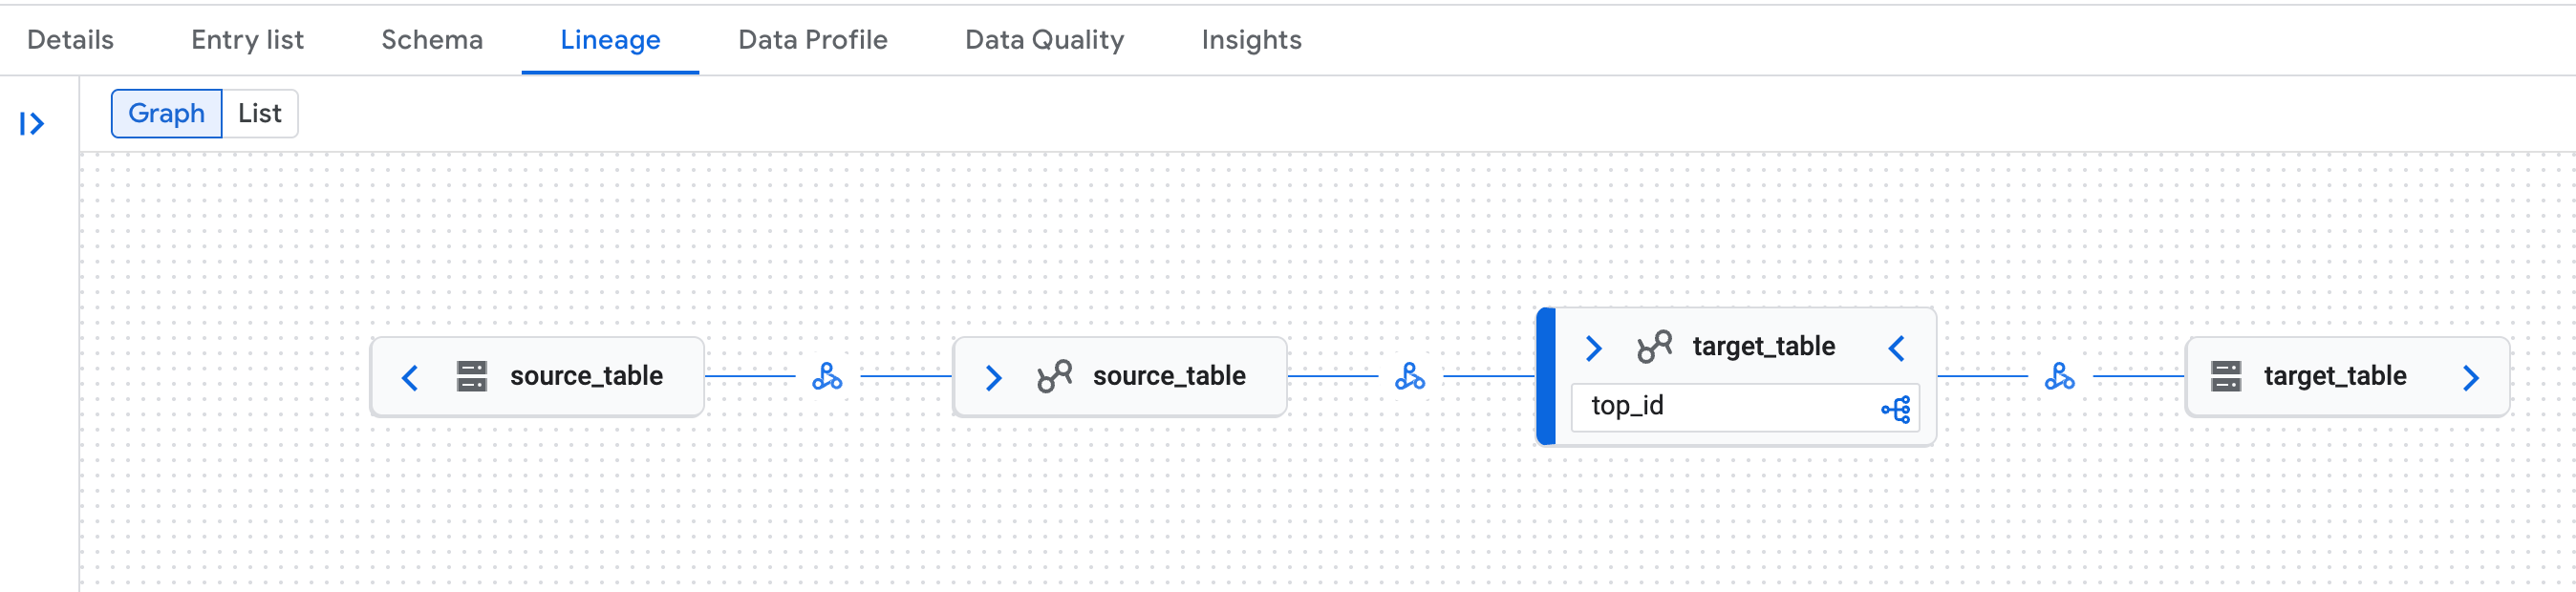
Exemple de graphique de traçabilité des données sur la page Knowledge Catalog de la console Google Cloud . La traçabilité des données reconnaît les représentations logique (table du catalogue d'environnements d'exécution Lakehouse) et physique (Cloud Storage) des tables du catalogue REST Iceberg du catalogue d'environnements d'exécution Lakehouse.
Problèmes connus liés à la traçabilité des données
Dans certains clusters Managed Service pour Apache Spark, il est possible que la traçabilité complète des données ne soit pas générée en raison d'un problème lié à la bibliothèque OpenLineage. Il s'agit d'une limitation connue. Si cela affecte vos charges de travail, contactez l'assistance Google Cloud.
Étapes suivantes
- En savoir plus sur le catalogue d'environnements d'exécution Lakehouse (catalogue REST Iceberg)
- Interrogez des catalogues fédérés avec Spark.
- Découvrez les fonctionnalités d'Apache Iceberg.
- Découvrez comment interroger des données Iceberg à partir du catalogue d'environnements d'exécution Lakehouse.
- En savoir plus sur la traçabilité des données et Managed Service pour Apache Spark