


什麼是自動調度資源
要估算工作負載「合適」的叢集 worker (節點) 數量並不容易,而且整個 pipeline 採用單一叢集大小通常不理想。使用者啟動的叢集資源調度可部分解決這項難題,但需要監控叢集使用率並手動介入。
Dataproc AutoscalingPolicies API 提供自動管理叢集資源的機制,並可自動調度叢集 worker VM 資源。Autoscaling Policy 是可重複使用的設定,說明採用自動調度資源政策的叢集 worker 應如何調度資源。並定義資源調度邊界、頻率和積極程度,讓您在整個叢集生命週期精細控管叢集資源。
自動調度資源的使用時機
使用自動調度資源:
在將資料儲存在外部服務 (例如 Cloud Storage 或 BigQuery) 的叢集上
在處理大量工作的叢集上
:向上擴充單一工作叢集
搭配強化版彈性模式,用於 Spark 批次工作
不建議在下列情況使用自動調度資源功能:
HDFS:自動調度資源功能不適用於調度叢集內 HDFS 的資源,原因如下:
- HDFS 使用率並非自動調度資源的信號。
- HDFS 資料只會託管於主要 worker。主要 worker 數量必須足以託管所有 HDFS 資料。
- 停用 HDFS DataNode 可能會延遲移除 worker。在移除 worker 之前,DataNode 會將 HDFS 區塊複製到其他 DataNode。視資料大小和複製係數而定,這項程序可能需要數小時。
YARN 節點標籤:由於 YARN-9088,自動調度資源功能不支援 YARN 節點標籤和
dataproc:am.primary_only屬性。使用節點標籤時,YARN 會錯誤回報叢集指標。Spark 結構化串流:自動調度資源不支援 Spark 結構化串流 (請參閱「自動調度資源和 Spark 結構化串流」)。
閒置叢集:不建議在叢集閒置時,使用自動調度資源功能將叢集縮減至最小。建立新叢集的速度與調整叢集大小一樣快,因此建議您刪除閒置叢集,並重新建立叢集。下列工具支援這種「暫時性」模型:
使用 Managed Service for Apache Spark 工作流程,在專屬叢集上排定一組工作,並在工作完成後刪除叢集。如需更進階的自動化調度管理功能,請使用以 Apache Airflow 為基礎的 Cloud Composer。
如果叢集處理臨時查詢或外部排定的工作負載,請使用叢集排定刪除功能,在指定的閒置期或時間長度過後,或在特定時間刪除叢集。
不同大小的工作負載:如果叢集同時執行小型和大型工作,安全停用縮減資源作業會等待大型工作完成。因此,長時間執行的工作會延遲叢集上較小工作的資源自動調度,直到長時間執行的工作完成為止。為避免這種情況,請將大小相近的小型工作分組到同一個叢集,並將每個長時間工作隔離到個別叢集。
啟用自動調度資源
如要為叢集啟用自動調度資源功能,請按照下列步驟操作:
以下任一項:
建立自動調度資源政策
Google Cloud 控制台
如要建立自動調度資源政策, 請使用 Google Cloud 控制台,從 Managed Service for Apache Spark 的「Autoscaling policies」(自動調度資源政策) 頁面選取「CREATE POLICY」(建立政策)。在「 Create policy」(建立政策) 頁面中,您可以選取政策建議面板,為特定工作類型或資源調度目標填入 自動調度資源政策欄位。
gcloud CLI
您可以使用 gcloud dataproc autoscaling-policies import 指令建立自動調度資源政策。這個指令會讀取定義自動調度資源政策的本機 YAML 檔案。檔案的格式和內容應與 autoscalingPolicies REST API 定義的設定物件和欄位相符。
下列 YAML 範例定義了 Managed Service for Apache Spark 標準叢集的政策,其中包含所有必要欄位。此外,這項設定也提供主要 worker 的 minInstances 和 maxInstances 值、次要 worker 的 maxInstances 值,並指定 4 分鐘的 cooldownPeriod (預設為 2 分鐘)。workerConfig 會設定主要 worker。在這個範例中,minInstances 和 maxInstances 設為相同的值,避免主要 worker 資源調度。
workerConfig:
  minInstances: 10
  maxInstances: 10
secondaryWorkerConfig:
  maxInstances: 50
basicAlgorithm:
  cooldownPeriod: 4m
  yarnConfig:
    scaleUpFactor: 0.05
    scaleDownFactor: 1.0
    gracefulDecommissionTimeout: 1h
下列 YAML 範例定義了 Managed Service for Apache Spark 標準叢集的政策,其中包含所有必要和選用的自動調度資源政策欄位。
clusterType: STANDARD
workerConfig:
  minInstances: 10
  maxInstances: 10
  weight: 1
secondaryWorkerConfig:
  minInstances: 0
  maxInstances: 100
  weight: 1
basicAlgorithm:
  cooldownPeriod: 2m
  yarnConfig:
    scaleUpFactor: 0.05
    scaleDownFactor: 1.0
    scaleUpMinWorkerFraction: 0.0
    scaleDownMinWorkerFraction: 0.0
    gracefulDecommissionTimeout: 1h
下列 YAML 範例定義了零規模叢集的政策。
如果是零規模叢集,請勿加入 workerConfig。
clusterType: ZERO_SCALE
secondaryWorkerConfig:
  minInstances: 0
  maxInstances: 100
  weight: 1
basicAlgorithm:
  cooldownPeriod: 2m
  yarnConfig:
    scaleUpFactor: 0.05
    scaleDownFactor: 1.0
    scaleUpMinWorkerFraction: 0.0
    scaleDownMinWorkerFraction: 0.0
    gracefulDecommissionTimeout: 1h
在本機終端機或 Cloud Shell 中執行下列 gcloud 指令,建立自動調度資源政策。輸入政策名稱。這個名稱會成為政策 id,您可以在後續的 gcloud 指令中使用這個名稱來參照政策。使用 --source 旗標,指定要匯入的自動調度資源政策 YAML 檔案本機路徑和檔案名稱。
gcloud dataproc autoscaling-policies import policy-name \
    --source=filepath/filename.yaml \
    --region=region
REST API
在 autoscalingPolicies.create 要求中定義 AutoscalingPolicy,建立自動調度資源政策。
建立自動調度資源叢集
建立自動調度資源政策後,請建立會使用該政策的叢集。叢集必須與自動調度資源政策位於相同區域。
Google Cloud 控制台
如要將自動調度資源政策套用至新叢集,請按照下列步驟操作:
- 開啟 Managed Service for Apache Spark 的「Create cluster」(建立叢集) 頁面。
- 在「定義叢集」部分的「選擇 worker 資源調度模式」下方,選取「自動調度資源」,然後在「政策」欄位中選取政策。
gcloud CLI
在本機終端機或 Cloud Shell 中執行下列 gcloud 指令,建立自動調度資源叢集。提供叢集名稱,並使用 --autoscaling-policy 旗標指定 policy ID (您在建立政策時指定的政策名稱) 或政策 resource URI (resource name) (請參閱 AutoscalingPolicy id 和 name 欄位)。
gcloud dataproc clusters create cluster-name \
    --autoscaling-policy=policy id or resource URI \
    --region=region
REST API
在 clusters.create 要求中加入 AutoscalingConfig,建立自動調度資源叢集。
為現有叢集啟用自動調度資源功能
建立自動調度資源政策後,您可以在相同區域的現有叢集上啟用該政策。
Google Cloud 控制台
Google Cloud 控制台不支援為現有叢集啟用自動調度資源政策。
gcloud CLI
在本機終端機或 Cloud Shell 中執行下列 gcloud 指令,為現有叢集啟用自動調度資源政策。提供叢集名稱,並使用 --autoscaling-policy 旗標指定 policy ID (您在建立政策時指定的政策名稱) 或政策 resource URI (resource name) (請參閱 AutoscalingPolicy id 和 name 欄位)。
gcloud dataproc clusters update cluster-name \
    --autoscaling-policy=policy id or resource URI \
    --region=region
REST API
如要為現有叢集啟用自動調度資源政策,請在 clusters.patch 要求的 updateMask 中,設定政策的 AutoscalingConfig.policyUri。
多叢集政策使用情形
自動調度資源政策會定義可套用至多個叢集的調度行為。如果叢集會共用類似的工作負載,或執行資源用量模式類似的工作,最適合在多個叢集套用自動調度資源政策。
您可以更新多個叢集使用的政策。更新會立即影響所有使用該政策的叢集自動調度資源行為 (請參閱 autoscalingPolicies.update)。如果不想將政策更新套用至使用該政策的叢集,請先停用叢集的自動調度資源功能,再更新政策。
Google Cloud 控制台
Google Cloud 控制台不支援停用叢集的自動調度資源功能。
gcloud CLI
在本機終端機或 Cloud Shell 中執行下列 gcloud 指令,停用叢集的自動調度資源功能。
gcloud dataproc clusters update cluster-name --disable-autoscaling \
    --region=region
REST API
如要停用叢集的自動調度資源功能,請在 clusters.patch 要求中,將 AutoscalingConfig.policyUri 設為空字串,並設定 update_mask=config.autoscaling_config.policy_uri。
- 無法刪除一或多個叢集使用的政策 (請參閱 autoscalingPolicies.delete)。
自動調度資源的運作方式
自動調度資源功能會在每個「冷卻」期結束時檢查叢集 Hadoop YARN 指標,判斷是否要調度叢集資源,以及更新幅度。
YARN 待處理資源指標 (待處理記憶體或待處理核心) 的值,會決定要向上或向下擴充。如果值大於
0,表示 YARN 工作正在等待資源,可能需要向上擴充。0值表示 YARN 有足夠的資源,因此可能不需要縮減資源或進行其他變更。如果待處理資源 > 0:
$estimated\_worker\_count =$
\[ \Biggl \lceil AVERAGE\ during\ cooldown\ period\Big(\frac{Pending + Available + Allocated + Reserved}{Resource\ per\ worker}\Big)\Biggr \rceil \]
如果待處理資源為 0:
$estimated\_worker\_count =$
\[ \Biggl \lceil AVERAGE\ during\ cooldown\ period\Big(\frac{Allocated + Reserved}{Resource\ per\ worker}\Big)\Biggr \rceil \]
根據預設,從 Managed Service for Apache Spark 映像檔 2.2 開始,自動配置器會監控 YARN 記憶體和 YARN 核心,以便分別評估記憶體和核心的
estimated_worker_count,並選取較大的 worker 數量。如果是先前的映像檔版本,除非您啟用核心型自動調度資源功能,同時監控 YARN 記憶體和核心,否則自動配置器只會監控 YARN 記憶體。$estimated\_worker\_count =$
\[ max(estimated\_worker\_count\_by\_memory,\ estimated\_worker\_count\_by\_cores) \]
\[ estimated\ \Delta worker = estimated\_worker\_count - current\_worker\_count \]
自動調度資源功能會根據預估的工作站數量變化,使用
scaleUpFactor或scaleDownFactor計算實際的工作站數量變化:if estimated Δworkers > 0: actual Δworkers = ROUND_UP(estimated Δworkers * scaleUpFactor) # examples: # ROUND_UP(estimated Δworkers=5 * scaleUpFactor=0.5) = 3 # ROUND_UP(estimated Δworkers=0.8 * scaleUpFactor=0.5) = 1 else: actual Δworkers = ROUND_DOWN(estimated Δworkers * scaleDownFactor) # examples: # ROUND_DOWN(estimated Δworkers=-5 * scaleDownFactor=0.5) = -2 # ROUND_DOWN(estimated Δworkers=-0.8 * scaleDownFactor=0.5) = 0 # ROUND_DOWN(estimated Δworkers=-1.5 * scaleDownFactor=0.5) = 0
如果 scaleUpFactor 或 scaleDownFactor 為 1.0,表示自動調度資源功能會調整資源,使待處理或可用資源為 0 (完美使用率)。
計算出 worker 數量的變更後,
scaleUpMinWorkerFraction和scaleDownMinWorkerFraction會做為門檻,決定自動調度資源功能是否會調整叢集資源。如果分數較低,代表即使Δworkers較小,自動調度資源功能也應調度資源。分數越大,表示只有在Δworkers較大時,才應進行資源調度。IF (Δworkers > scaleUpMinWorkerFraction * current_worker_count) then scale up
IF (abs(Δworkers) >  scaleDownMinWorkerFraction * current_worker_count),
THEN scale down.
如果需要調度資源的 worker 數量足以觸發調度資源,自動調度資源會使用
workerConfig、secondaryWorkerConfig和weight(主要 worker 與次要 worker 的比例) 的minInstancesmaxInstances限制,決定如何分配主要和次要 worker 執行個體群組的 worker 數量。這些計算結果是叢集在擴充期間的最終自動調度資源變更。如果符合下列條件,系統會取消以 2.0.57 以上、2.1.5 以上和更新版本映像檔建立的叢集自動調度資源縮減要求:
- 縮減資源作業正在進行中,且安全停用逾時值不為零,以及
「ACTIVE」YARN worker 數量 (「有效 worker」) 加上自動調度資源工具建議的 worker 總數變化 (
Δworkers) 等於或大於DECOMMISSIONING個 YARN worker (「停用 worker」),如以下公式所示:IF (active workers + Δworkers ≥ active workers + decommissioning workers) THEN cancel the scaledown operation
如需縮減資源取消範例,請參閱「自動調度資源功能何時會取消縮減資源作業?」一節。
自動調度資源設定建議
本節提供一些建議,協助您設定自動調度資源。
避免調度主要 worker 資源
主要 worker 會執行 HDFS Datanode,次要 worker 則僅負責運算。使用次要 worker 可有效擴充運算資源,不必佈建儲存空間,因此能更快擴充。HDFS Namenode 可能會有多個競爭狀況,導致 HDFS 損毀,使停用作業無限期停滯。如要避免這個問題,請勿調度主要 worker 的資源。例如:none
workerConfig:
minInstances: 10
maxInstances: 10
secondaryWorkerConfig:
minInstances: 0
maxInstances: 100
您需要對叢集建立指令進行一些修改:
- 將
--num-workers=10設為與自動調度資源政策的主要 worker 群組大小相符。 - 設定
--secondary-worker-type=non-preemptible,將次要 worker 設為非先占。(除非需要先占 VM)。 - 將主要 worker 的硬體設定複製到次要 worker。例如,將
--secondary-worker-boot-disk-size=1000GB設為與--worker-boot-disk-size=1000GB相符。
為 Spark 批次工作使用強化版彈性模式
搭配使用強化版彈性模式 (EFM) 和自動調度資源功能,可達到下列效果:
:在工作執行期間,加快叢集縮減速度
避免叢集縮減導致執行中的工作中斷
盡可能減少因先占次要 worker 先占而中斷執行中工作的次數
啟用 EFM 後,自動調度資源政策的優雅停用逾時時間必須設為 0s。自動調度資源政策只能自動調度次要 worker。
選擇安全停用逾時時間
從叢集移除節點時,自動調度資源功能支援 YARN 安全停用。安全停用功能可讓應用程式在各階段之間完成資料重組,避免工作進度倒退。自動調度資源政策中提供的安全停用逾時,是 YARN 在移除節點之前,等待執行中應用程式 (停用開始時執行的應用程式) 的時間上限。
如果程序未在指定的安全停用逾時期間內完成,worker 節點就會強制關閉,可能導致資料遺失或服務中斷。為避免這種情況,請將安全停用逾時時間設為比叢集處理的最長工作時間更長的值。舉例來說,如果預期最長的工作會執行一小時,請將逾時時間設為至少一小時 (1h)。
建議將執行時間超過 1 小時的工作遷移至專屬的臨時叢集,以免阻礙安全停用。
設定 scaleUpFactor
scaleUpFactor 控制自動配置器擴充叢集的積極程度。請指定介於 0.0 和 1.0 之間的數字,設定 YARN 待處理資源的分數值,以觸發節點新增作業。
舉例來說,如果有 100 個待處理容器,每個容器要求 512 MB,則待處理的 YARN 記憶體為 50 GB。如果 scaleUpFactor 為 0.5,自動配置器會新增足夠的節點,以增加 25 GB 的 YARN 記憶體。同樣地,如果為 0.1,自動配置器會新增足夠的節點,以達到 5 GB。請注意,這些值對應的是 YARN 記憶體,而非 VM 實際可用的記憶體總量。
建議先將 MapReduce 工作和已啟用動態分配功能的 Spark 工作設為 0.05。如果是執行器數量固定的 Spark 工作和 Tez 工作,請使用 1.0。如果 scaleUpFactor 為 1.0,表示自動調度資源功能會調整資源,使待處理或可用資源為 0 (完美使用率)。
設定 scaleDownFactor
scaleDownFactor 控制自動配置器縮減叢集的積極程度。請指定介於 0.0 和 1.0 之間的數字,設定 YARN 可用資源的分數值,達到這個值就會移除節點。
對於大多數需要頻繁擴充和縮減的多工作叢集,請將這個值保留為 1.0。由於安全停用功能,縮減資源作業的速度會明顯慢於擴充資源作業。設定 scaleDownFactor=1.0 會設定積極的縮減率,盡可能減少達到適當叢集大小所需的縮減作業數量。
如果叢集需要更高的穩定性,請將 scaleDownFactor 設為較低的值,以降低縮減速度。
將這個值設為 0.0,即可防止叢集縮減,例如使用臨時或單一工作叢集時。
設定 scaleUpMinWorkerFraction 和 scaleDownMinWorkerFraction
scaleUpMinWorkerFraction 和 scaleDownMinWorkerFraction 會與 scaleUpFactor 或 scaleDownFactor 搭配使用,預設值為 0.0。這些值代表自動配置器會擴充或縮減叢集資源的門檻:叢集大小必須增加或減少的最小分數值,才能發出擴充或縮減資源要求。
範例:除非 scaleUpMinWorkerFraction 小於或等於 0.05 (5%),否則自動配置器不會發出更新要求,將 5 個 worker 新增至 100 個節點的叢集。如果設為 0.1,自動配置器就不會發出擴充叢集的請求。同樣地,如果 scaleDownMinWorkerFraction 為 0.05,除非要移除至少 5 個節點,否則自動配置器不會發出縮減要求。
0.0 的預設值表示沒有門檻。
強烈建議在大型叢集 (> 100 個節點) 上設定較高的 scaleDownMinWorkerFraction 門檻,避免不必要的小型調度資源作業。
選擇等待期
cooldownPeriod 會設定一段時間,自動配置器在這段時間內不會發出變更叢集大小的要求。您可以使用這項功能,限制自動配置器變更叢集大小的頻率。
cooldownPeriod 的下限和預設值為兩分鐘。如果政策設定的 cooldownPeriod 較短,工作負載變更會更快影響叢集大小,但叢集可能會不必要地擴充及縮減。建議做法是,使用較短的 cooldownPeriod 時,將政策的 scaleUpMinWorkerFraction 和 scaleDownMinWorkerFraction 設為非零值。這樣一來,只有在資源使用率變化足以觸發叢集更新時,叢集才會擴充或縮減。
如果工作負載容易受到叢集大小變更的影響,可以增加冷卻期。舉例來說,如果您執行批次處理工作,可以將冷卻期設為 10 分鐘以上。嘗試不同的等待期,找出最適合工作負載的值。
worker 數量界限和群組權重
每個 worker 群組都有 minInstances 和 maxInstances,可設定各群組的大小硬性限制。
每個群組也都有一個名為 weight 的參數,用於設定兩個群組之間的目標平衡。請注意,這項參數僅供參考,如果群組達到大小下限或上限,系統只會從其他群組新增或移除節點。因此,weight 幾乎一律可以保留預設值 1。
使用以核心為基礎的自動調度資源功能
對於 CPU 密集型應用程式,最佳做法是使用主導資源計算機進行資源分配。這是 Managed Service for Apache Spark 映像檔 2.2 版起的預設 YARN 設定。如果是較舊的映像檔版本,Managed Service for Apache Spark 會將 YARN 設為使用記憶體指標分配資源,除非您在建立叢集時設定下列屬性,將 YARN 設為使用 Dominant Resource Calculator:
capacity-scheduler:yarn.scheduler.capacity.resource-calculator=org.apache.hadoop.yarn.util.resource.DominantResourceCalculator
自動調度資源指標和記錄
下列資源和工具可協助您監控自動調度資源作業,以及這些作業對叢集和工作的影響。
Cloud Monitoring
使用 Cloud Monitoring 執行下列操作:
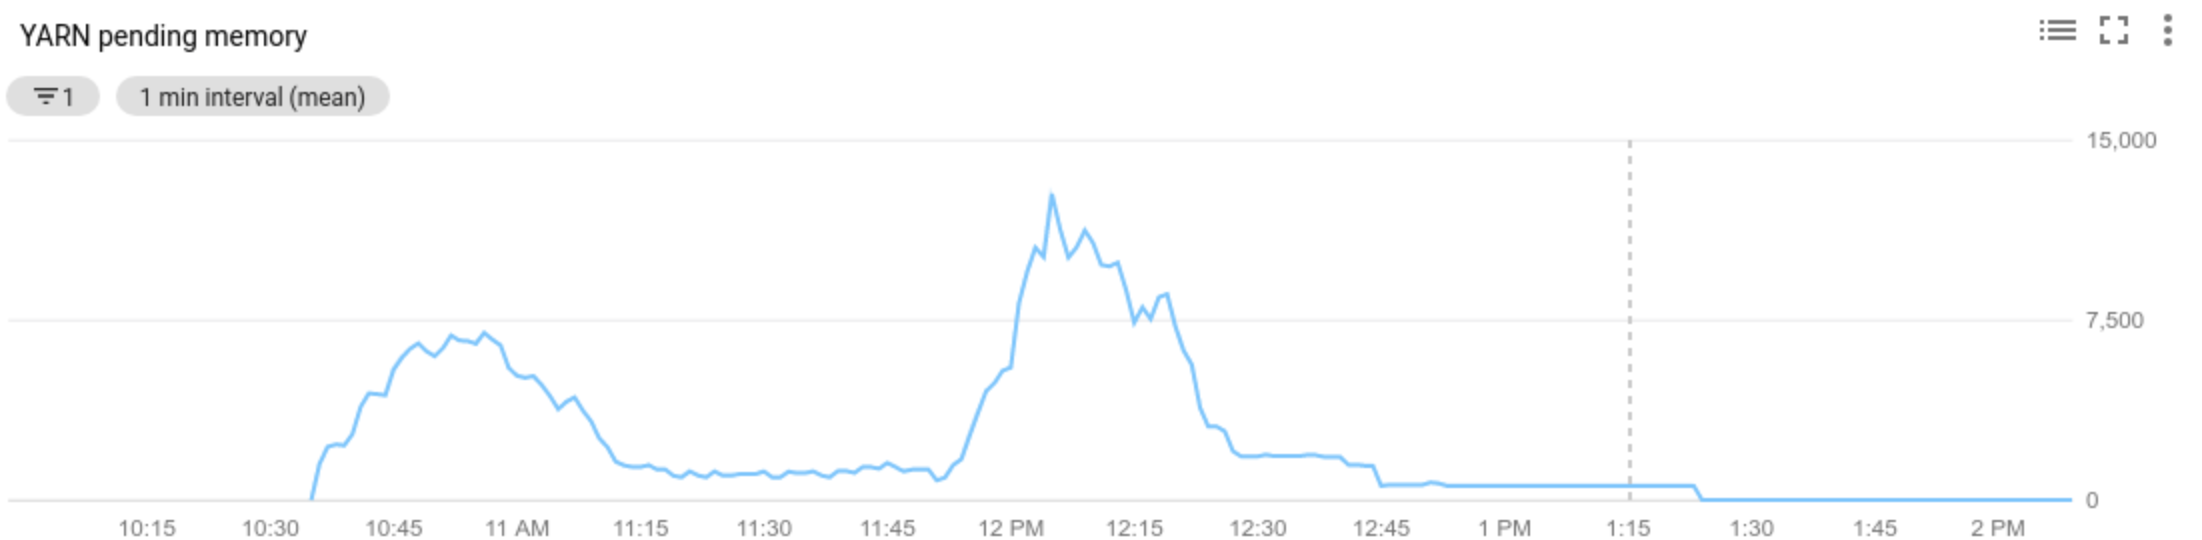
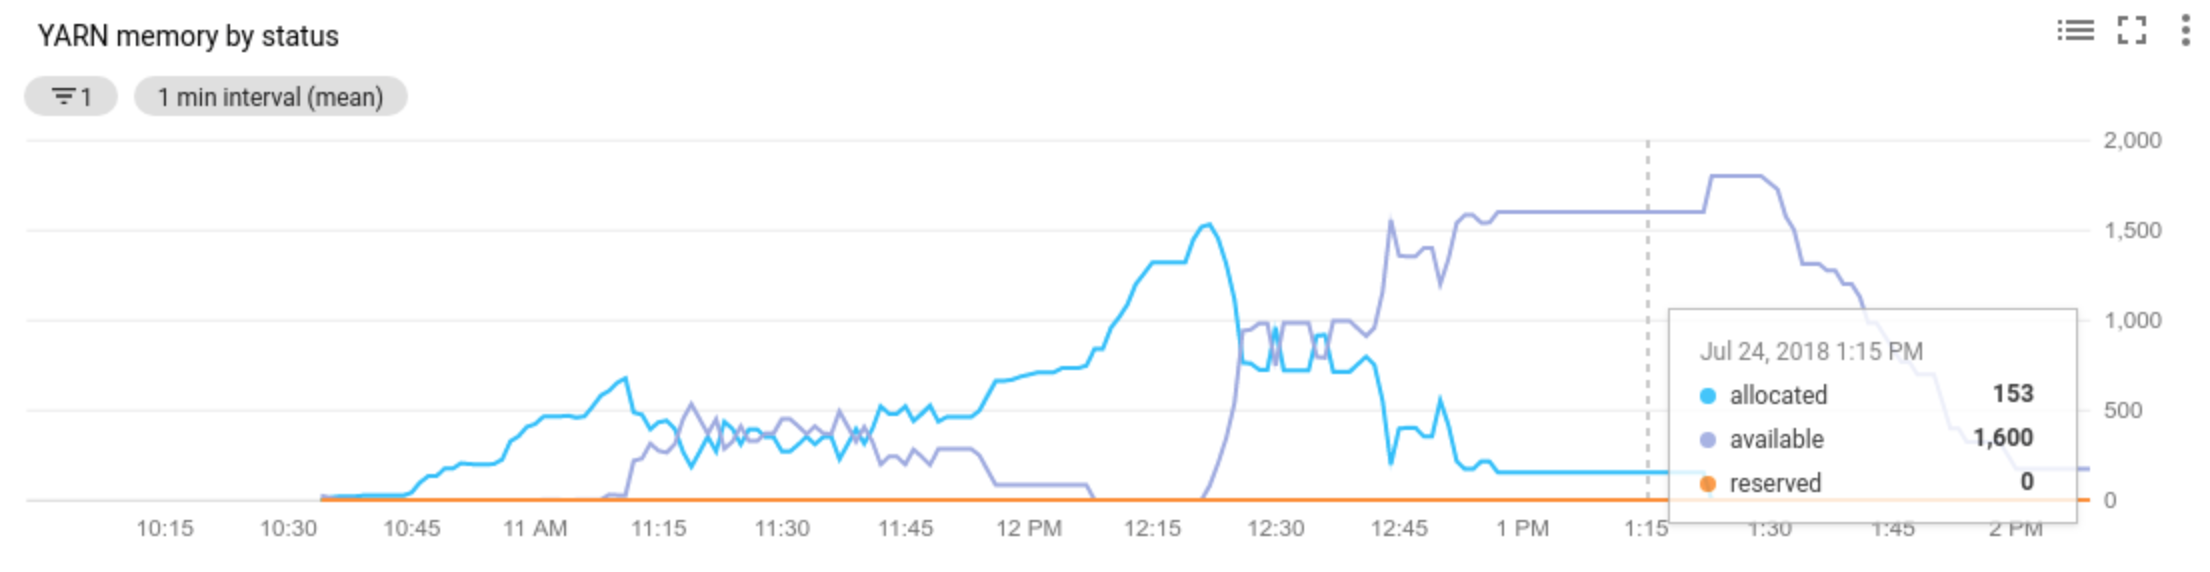
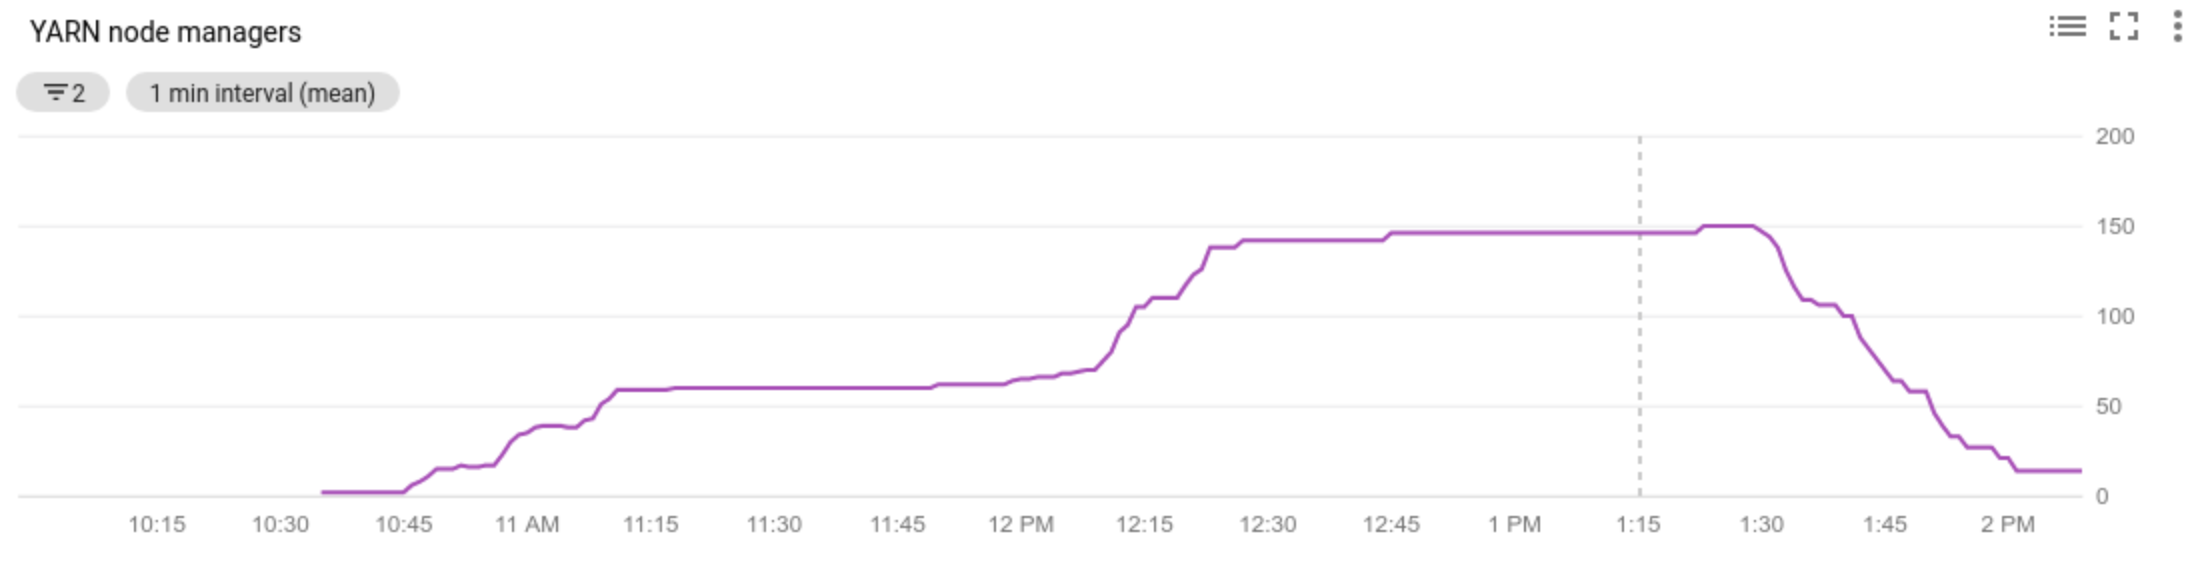
- 查看自動調度資源使用的指標
- 查看叢集中的 Node Manager 數量
- 瞭解自動調度資源功能是否調整叢集資源的原因
Cloud Logging
使用 Cloud Logging 查看 Managed Service for Apache Spark 自動配置器的記錄。
1) 找出叢集的記錄。
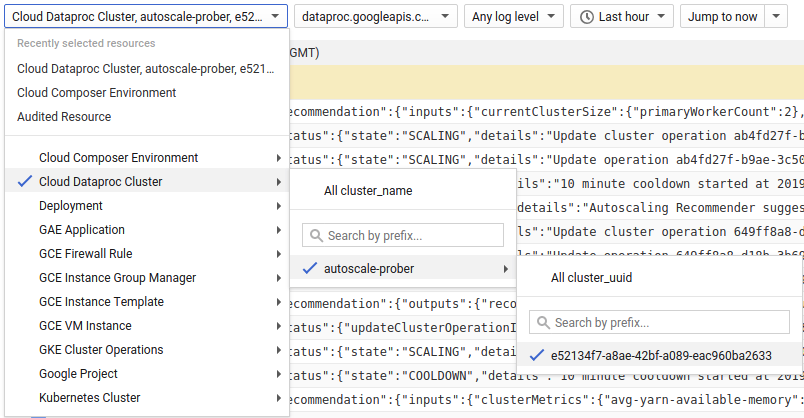
2) 選取「dataproc.googleapis.com/autoscaler」。
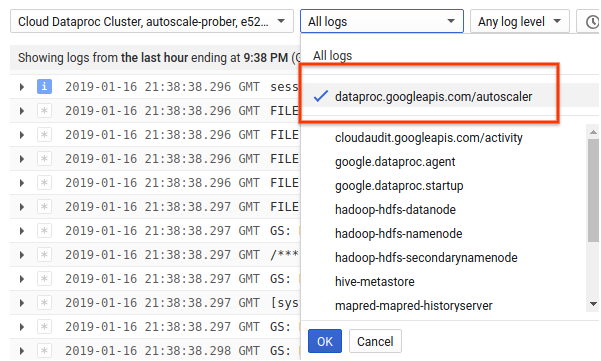
3) 展開記錄訊息,查看 status 欄位。記錄檔採用 JSON 格式,這是機器可讀的格式。
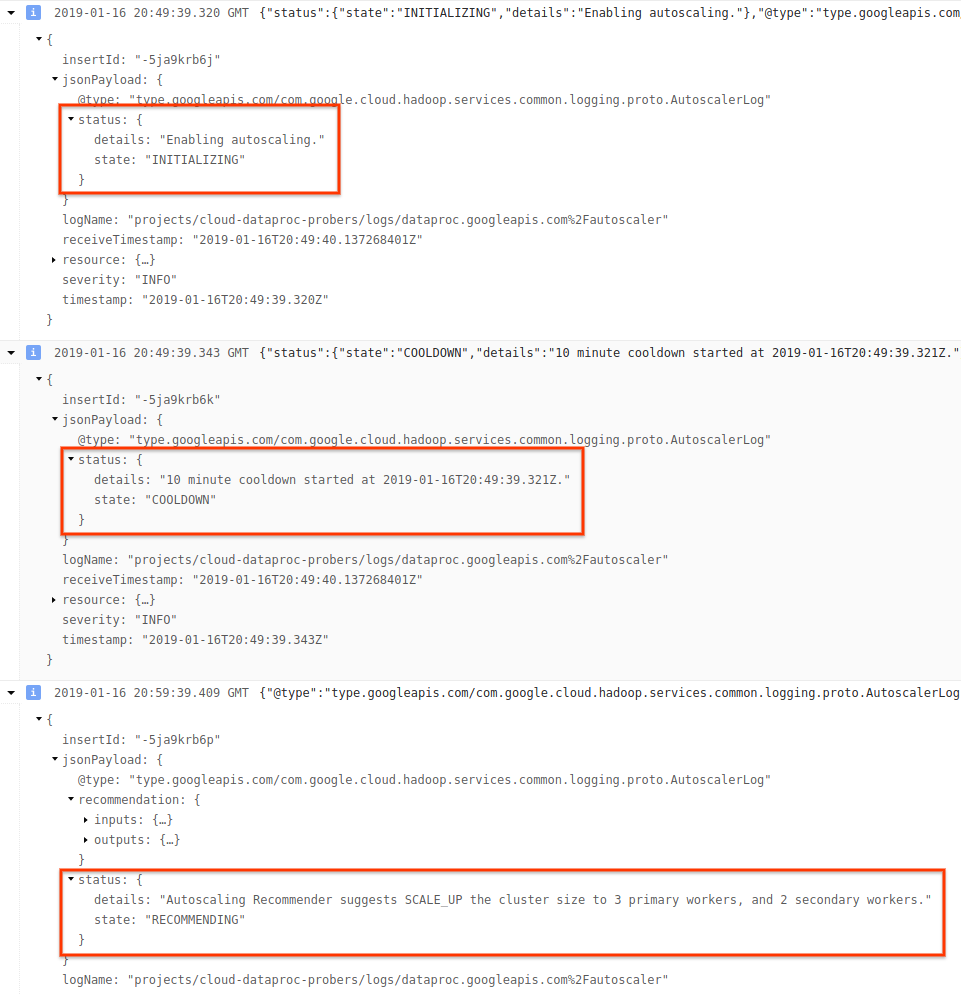
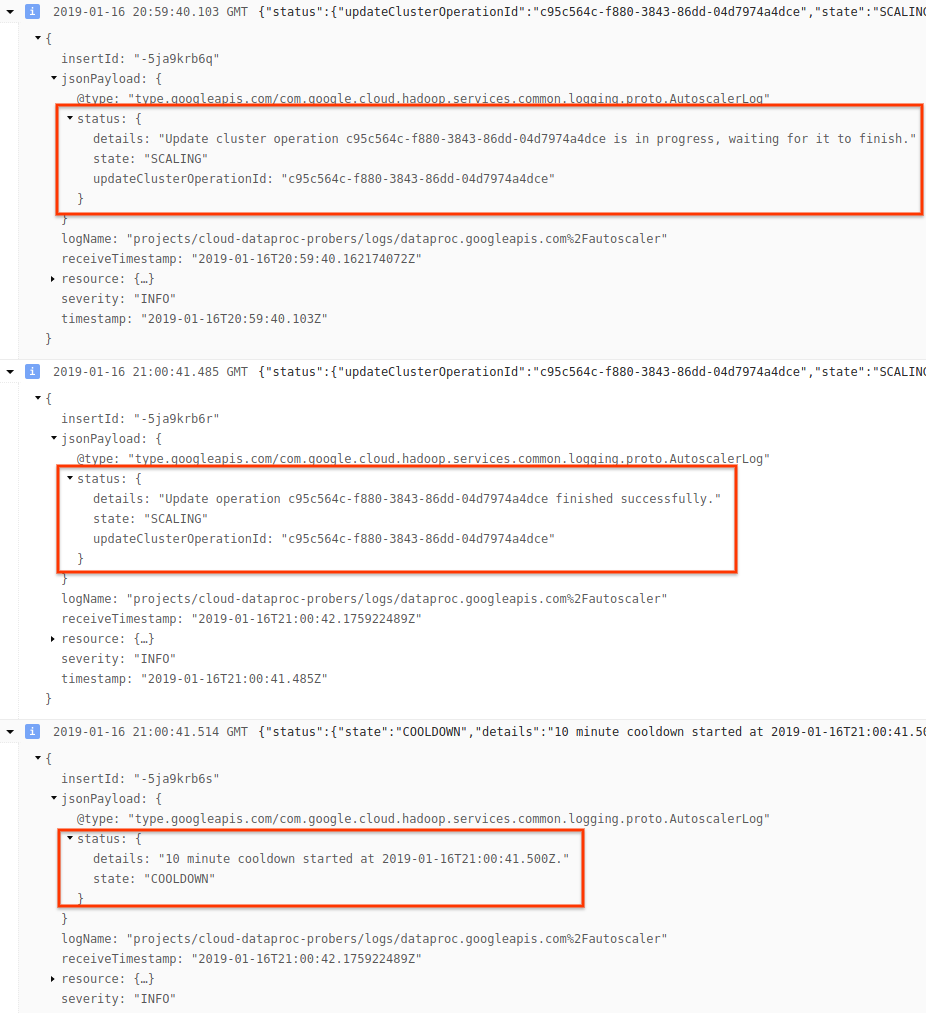
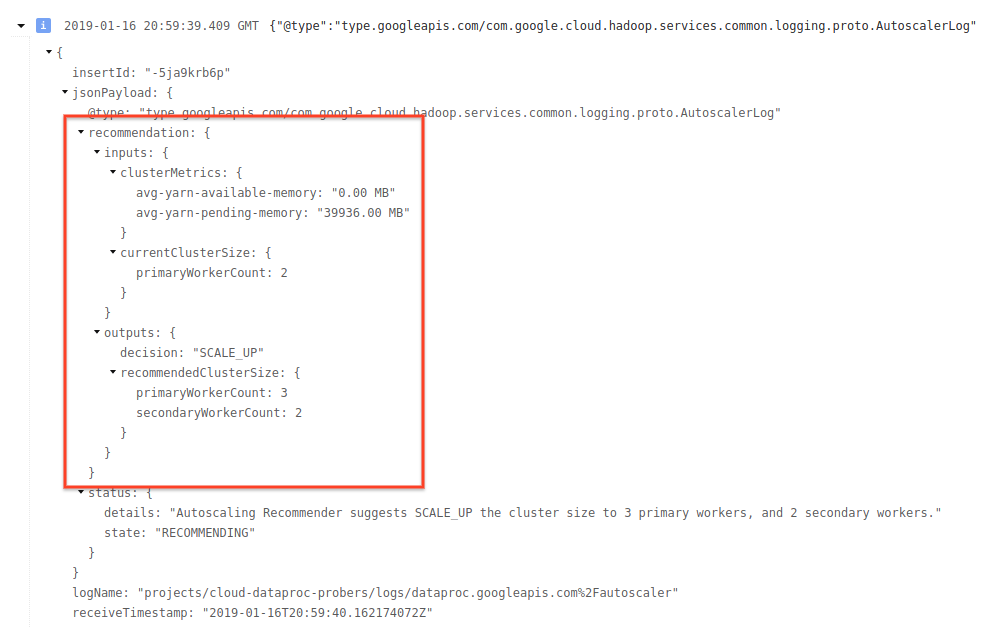
4) 展開記錄訊息,查看資源調度建議、用於資源調度決策的指標、原始叢集大小,以及新的目標叢集大小。
背景:使用 Apache Hadoop 和 Apache Spark 自動調度資源
以下各節將說明自動調度資源功能如何與 Hadoop YARN、Hadoop Mapreduce、Apache Spark、Spark Streaming 和 Spark Structured Streaming 交互運作 (或不交互運作)。
Hadoop YARN 指標
自動調度資源功能主要依據下列 Hadoop YARN 指標:
Allocated resource是指整個叢集中執行容器所占用的 YARN 資源總量。如果有 6 個執行中的容器,最多可使用 1 個資源單位,則已分配的資源為 6 個。Available resource是叢集中未由分配容器使用的 YARN 資源。如果所有 Node Manager 共有 10 個資源單位,且已分配 6 個,則有 4 個可用資源。如果叢集有可用 (未使用) 的資源,自動調度資源功能可能會從叢集移除 worker。Pending resource是待處理容器的 YARN 資源要求總和。待處理容器正在等待 YARN 釋出空間,以便執行。只有在可用資源為零或太少,無法分配給下一個容器時,待處理資源才會不為零。如有待處理的容器,自動調度資源功能可能會在叢集中新增 worker。
您可以在 Cloud Monitoring 中查看這些指標。根據預設,YARN 記憶體會是叢集總記憶體的 0.8 倍,其餘記憶體則保留給其他 Daemon 和作業系統使用,例如網頁快取。您可以使用「yarn.nodemanager.resource.memory-mb」YARN 設定覆寫預設值 (請參閱「Apache Hadoop YARN、HDFS、Spark 和相關屬性」)。
自動調度資源和 Hadoop MapReduce
MapReduce 會將每個對應和縮減工作,當做獨立的 YARN 容器執行。工作開始時,MapReduce 會為每項對應工作提交容器要求,導致待處理的 YARN 記憶體用量大幅增加。對應工作完成後,待處理記憶體就會減少。
當 mapreduce.job.reduce.slowstart.completedmaps 完成時 (Managed Service for Apache Spark 預設為 95%),MapReduce 會將所有 reducer 的容器要求排入佇列,導致待處理記憶體再次激增。
除非對應和縮減工作需要幾分鐘以上,否則請勿將自動調度資源 scaleUpFactor 設為高值。將 worker 新增至叢集至少需要 1.5 分鐘,因此請確保有足夠的待處理工作,可讓新 worker 執行幾分鐘。建議先將 scaleUpFactor 設為待處理記憶體的 0.05 (5%) 或 0.1 (10%)。
自動調度資源和 Spark
Spark 在 YARN 之上新增一層排程。具體來說,Spark Core 的動態分配功能會向 YARN 要求容器來執行 Spark 執行器,然後在這些執行器的執行緒上排定 Spark 工作。Managed Service for Apache Spark 叢集預設會啟用動態分配功能,因此會視需要新增及移除執行程式。
Spark 一律會向 YARN 要求容器,但如果沒有動態分配,則只會在工作開始時要求容器。動態分配功能會視需要移除容器或要求新容器。
Spark 會從少量執行器開始 (自動調度資源叢集上為 2 個),並在有待處理工作時,持續將執行器數量加倍。這可減少待處理記憶體 (減少待處理記憶體用量激增的情況)。建議您將 Spark 工作的自動調度資源 scaleUpFactor 設為較大的數字,例如 1.0 (100%)。
停用 Spark 動態分配
如果您執行的個別 Spark 工作無法受益於 Spark 動態分配,可以將 spark.dynamicAllocation.enabled=false 和 spark.executor.instances 設為 false,停用 Spark 動態分配。在個別 Spark 工作執行期間,您仍可使用自動調度資源功能,擴充及縮減叢集。
含有快取資料的 Spark 工作
如果不再需要資料集,請設定 spark.dynamicAllocation.cachedExecutorIdleTimeout 或取消快取資料集。根據預設,Spark 不會移除含有快取資料的執行器,這會導致叢集無法縮減。
自動調度資源和 Spark Streaming
Spark Streaming 有自己的動態分配版本,會使用串流專屬信號來新增及移除執行器,因此請設定
spark.streaming.dynamicAllocation.enabled=true,並將spark.dynamicAllocation.enabled=false設為停用 Spark Core 的動態分配。請勿將安全停用 (自動調度資源
gracefulDecommissionTimeout) 用於 Spark 串流工作。如要安全地移除 worker 並自動調度資源,請設定檢查點,以容許錯誤。
或者,如要使用 Spark Streaming,但不自動調度資源,請按照下列步驟操作:
- 停用 Spark Core 的動態分配 (
spark.dynamicAllocation.enabled=false),以及 - 設定工作的執行器數量 (
spark.executor.instances)。請參閱「叢集屬性」。
自動調度資源和 Spark 結構化串流
自動調度資源與 Spark Structured Streaming 不相容,因為 Spark Structured Streaming 不支援動態分配 (請參閱 SPARK-24815:Structured Streaming 應支援動態分配)。
透過分區和平行處理控制自動調度資源
雖然平行處理量通常是由叢集資源設定或決定 (例如,HDFS 區塊數量由工作數量控制),但自動調度資源則相反:自動調度資源會根據工作平行處理量設定 worker 數量。以下是設定工作平行處理的指南:
- 雖然 Managed Service for Apache Spark 會根據叢集的初始大小設定 MapReduce 縮減工作的預設數量,但您可以設定
mapreduce.job.reduces來提高縮減階段的平行處理程度。 - Spark SQL 和 Dataframe 平行處理作業由
spark.sql.shuffle.partitions決定,預設值為 200。 - Spark 的 RDD 函式預設為
spark.default.parallelism,在工作啟動時會設為 worker 節點的核心數量。不過,所有建立重組的 RDD 函式都會採用分區數量的參數,這會覆寫spark.default.parallelism。
請確保資料平均分區。如果鍵偏斜程度嚴重,一或多項工作可能需要比其他工作更長的時間,導致使用率偏低。
自動調度資源預設 Spark 和 Hadoop 屬性設定
自動調度資源叢集具有預設叢集屬性值,有助於在移除主要 worker 或搶占次要 worker 時,避免工作失敗。建立具備自動調度資源功能的叢集時,您可以覆寫這些預設值 (請參閱「叢集屬性」)。
預設會提高工作、應用程式主節點和階段的重試次數上限:
yarn:yarn.resourcemanager.am.max-attempts=10
mapred:mapreduce.map.maxattempts=10
mapred:mapreduce.reduce.maxattempts=10
spark:spark.task.maxFailures=10
spark:spark.stage.maxConsecutiveAttempts=10
預設為重設重試計數器 (適用於長時間執行的 Spark 串流工作):
spark:spark.yarn.am.attemptFailuresValidityInterval=1h
spark:spark.yarn.executor.failuresValidityInterval=1h
預設讓 Spark 的慢速啟動動態分配機制從小規模開始:
spark:spark.executor.instances=2
常見問題 (FAQ)
本節包含自動調度資源的常見問答。
高可用性叢集和單一節點叢集可以啟用自動調度資源功能嗎?
高可用性叢集可啟用自動調度資源功能,但單一節點叢集不支援 (單一節點叢集不支援調整大小)。
可以手動調整自動調度資源叢集的大小嗎?
可以。調整自動調度資源政策時,您可能會決定手動調整叢集大小,做為臨時措施。不過,這些變更只會暫時生效,自動調度資源功能最終會縮減叢集。
建議您考慮下列做法,而非手動調整自動調度資源叢集的大小:
更新自動調度資源政策。對自動調度資源政策所做的任何變更,都會影響使用該政策的所有叢集 (請參閱「多叢集政策使用方式」)。
卸離政策,並手動將叢集調整為偏好的大小。
取得 Managed Service for Apache Spark 支援。
Managed Service for Apache Spark 與 Dataflow 自動調度資源功能有何不同?
請參閱「Dataflow 水平自動調度資源」和「Dataflow Prime 垂直自動調度資源」。
Managed Service for Apache Spark 開發團隊能否將叢集狀態從「ERROR」重設回「RUNNING」?
一般來說,不建議這麼做。這麼做需要手動驗證重設叢集狀態是否安全,而且通常需要其他手動步驟 (例如重新啟動 HDFS NameNode),才能重設叢集。
如果 Managed Service for Apache Spark 在作業失敗後無法判斷叢集狀態,就會將叢集狀態設為 ERROR。ERROR 中的叢集不會自動調度資源。常見原因包括:
Compute Engine API 傳回的錯誤,通常發生在 Compute Engine 服務中斷期間。
HDFS 停用程序發生錯誤,導致 HDFS 進入損毀狀態。
Dataproc Control API 錯誤,例如「Task lease expired」(工作租約已到期)。
刪除並重新建立狀態為 ERROR 的叢集。
自動調度資源功能何時會取消縮減資源作業?
下圖說明自動調度資源功能何時會取消縮減作業 (另請參閱「自動調度資源功能的運作方式」)。
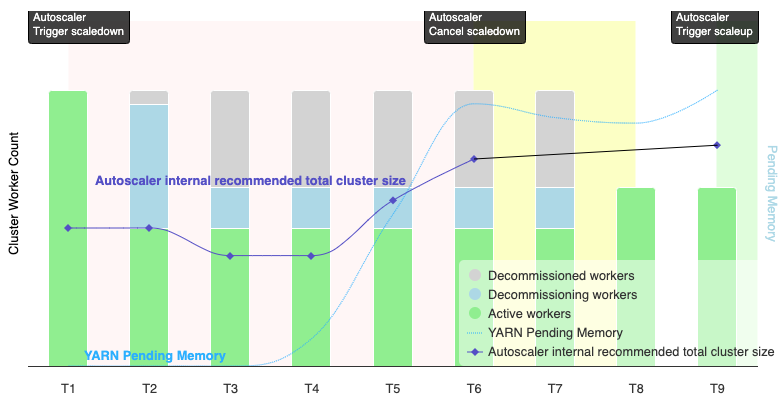
注意:
- 叢集已啟用自動調度資源功能,僅依據 YARN 記憶體指標調度資源。
- T1-T9 代表自動調度資源工具評估 worker 數量時的冷卻時間間隔 (事件時間已簡化)。
- 堆疊長條代表活躍、停用中和已停用的叢集 YARN worker 數量。
- 自動配置器建議的工作站數量 (黑線) 是根據 YARN 記憶體指標、YARN 活躍工作站數量和自動調度資源政策設定 (請參閱「自動調度資源的運作方式」)。
- 紅色背景區域表示縮減作業執行的期間。
- 黃色背景區域表示縮減資源作業取消期間。
- 綠色背景區域代表擴充作業的期間。
下列作業會在以下時間執行:
T1:自動配置器啟動安全停用縮減作業,將目前叢集 worker 數量縮減約一半。
T2:自動配置器會持續監控叢集指標。不會變更縮減建議,且縮減作業會繼續進行。部分 worker 已停用,其他 worker 正在停用 (Managed Service for Apache Spark 會刪除已停用的 worker)。
T3:自動配置器計算出 worker 數量可進一步縮減,可能是因為有額外的 YARN 記憶體可用。不過,由於活躍工作站數量加上建議的工作站數量變更,不等於或大於活躍工作站加上停用工作站的數量,因此不符合縮減取消條件,自動配置器不會取消縮減作業。
T4:YARN 回報待處理記憶體增加。不過,自動配置器不會變更建議的工作站數量。與 T3 相同,縮減資源取消條件仍未滿足,因此自動配置器不會取消縮減資源作業。
T5:YARN 待處理記憶體增加,自動配置器建議的 worker 數量變化量增加。不過,由於使用中的 worker 數量加上建議的 worker 數量變更,小於使用中加上停用中的 worker 數量,因此仍不符合取消條件,縮減作業不會取消。
T6:YARN 待處理記憶體進一步增加。運作中的 worker 數量加上自動配置器建議的 worker 數量變化,現在大於運作中加上停用中的 worker 數量。符合取消條件,自動配置器會取消縮減資源作業。
T7:自動配置器正在等待取消縮減資源作業完成。自動配置器不會在這段期間內評估及建議變更 worker 數量。
T8:縮減資源作業取消完成。停用的 worker 會新增至叢集並啟用。自動配置器偵測到縮減作業取消完成,並等待下一個評估週期 (T9) 計算建議的工作站數量。
T9:T9 時間沒有任何進行中的作業。自動配置器會根據自動配置器政策和 YARN 指標,建議執行向上擴充作業。