


מה זה התאמה אוטומטית לעומס (Autoscaling)
קשה להעריך את המספר ה "נכון" של עובדי (צמתים) אשכול לעומס עבודה, ולעתים קרובות גודל אשכול יחיד לצינור שלם הוא לא אידיאלי. שינוי גודל האשכול שמתבצע על ידי המשתמש פותר חלקית את הבעיה הזו, אבל דורש מעקב אחרי ניצול האשכול והתערבות ידנית.
AutoscalingPolicies API של Dataproc מספק מנגנון לאוטומציה של ניהול משאבי האשכול, ומאפשר התאמה אוטומטית של משאבי ה-VM של ה-worker באשכול. Autoscaling Policy היא הגדרה שניתן לעשות בה שימוש חוזר, שמתארת איך ה-workers באשכול שמשתמשים במדיניות ההתאמה האוטומטית לעומס צריכים להתאים את עצמם לעומס. היא מגדירה את גבולות ההתאמה לעומס, את התדירות ואת האגרסיביות, כדי לספק שליטה פרטנית במשאבי האשכול לאורך כל משך החיים של האשכול.
מתי כדאי להשתמש בהתאמה אוטומטית לעומס (automatic scaling)
שימוש בהתאמה אוטומטית לעומס:
באשכולות שמאחסנים נתונים בשירותים חיצוניים, כמו Cloud Storage או BigQuery
באשכולות שמעבדים הרבה משימות
כדי להרחיב אשכולות של משימה אחת בהתאם לעומס (scale up)
עם מצב גמישות משופר למשימות באצווה של Spark
לא מומלץ להשתמש בהתאמה אוטומטית לעומס במקרים הבאים:
HDFS: התאמה אוטומטית לעומס לא מיועדת להתאמה לעומס של HDFS באשכול, כי:
- השימוש ב-HDFS הוא לא אות להתאמה אוטומטית לעומס (autoscaling).
- נתוני HDFS מתארחים רק בעובדים הראשיים. מספר ה-primary workers צריך להספיק לאירוח כל נתוני ה-HDFS.
- הוצאה משימוש של DataNodes ב-HDFS עלולה לעכב את ההסרה של העובדים. לפני שמסירים את העובד, צמתי נתונים מעתיקים בלוקים של HDFS לצמתי נתונים אחרים. התהליך הזה יכול להימשך כמה שעות, בהתאם לגודל הנתונים ולגורם השכפול.
תוויות של צמתים ב-YARN: התאמה אוטומטית לעומס לא תומכת בתוויות של צמתים ב-YARN, ולא במאפיין
dataproc:am.primary_onlyבגלל YARN-9088. YARN מדווח באופן שגוי על מדדי אשכולות כשמשתמשים בתוויות של צמתים.Spark Structured Streaming: התאמה אוטומטית לעומס לא תומכת ב-Spark Structured Streaming (ראו התאמה אוטומטית לעומס ו-Spark Structured Streaming).
אשכולות בלי פעילות: לא מומלץ להשתמש בהתאמה אוטומטית לעומס (automatic scaling) כדי להקטין את הגודל של אשכול לגודל המינימלי כשהאשכול בלי פעילות. יצירת אשכול חדש היא מהירה כמו שינוי הגודל של אשכול קיים, לכן כדאי למחוק אשכולות לא פעילים וליצור אותם מחדש. הכלים הבאים תומכים במודל "זמני":
משתמשים בתהליכי עבודה ב-Managed Service for Apache Spark כדי לתזמן קבוצת משימות באשכול ייעודי, ואז מוחקים את האשכול כשהמשימות מסתיימות. לתזמור מתקדם יותר, השתמשו ב-Cloud Composer, שמבוסס על Apache Airflow.
באשכולות שמבצעים שאילתות אד-הוק או עומסי עבודה שתוזמנו חיצונית, אפשר להשתמש בCluster Scheduled Deletion כדי למחוק את האשכול אחרי תקופה מסוימת של חוסר פעילות או משך זמן מסוים, או בשעה ספציפית.
עומסי עבודה בגדלים שונים: כשמשימות קטנות וגדולות פועלות באשכול, צמצום הדרגתי של כמות השרתים ימתין עד שהמשימות הגדולות יסתיימו. כתוצאה מכך, משימה שפועלת במשך זמן רב תעכב את ההתאמה האוטומטית לעומס (automatic scaling) של המשאבים למשימות קטנות יותר שפועלות באשכול, עד שהמשימה שפועלת במשך זמן רב תסתיים. כדי להימנע מכך, קבצו יחד באשכול משימות קטנות בגודל דומה, ובודדו כל משימה ארוכה באשכול נפרד.
הפעלת התאמה אוטומטית לעומס (autoscaling)
כדי להפעיל את ההתאמה האוטומטית לעומס (automatic scaling) באשכול:
אחת משתי האפשרויות:
יצירת מדיניות התאמה לעומס (autoscaling)
מסוףGoogle Cloud
כדי ליצור מדיניות התאמה לעומס, בוחרים באפשרות CREATE POLICY בדף Autoscaling policies של Managed Service for Apache Spark במסוף Google Cloud . בדף Create policy, אתם יכולים לבחור חלונית של המלצות למדיניות כדי לאכלס את השדות של מדיניות ההתאמה האוטומטית לעומס (autoscaling) של סוג העבודה או יעד התאמה לעומס ספציפיים.
CLI של gcloud
אפשר להשתמש בפקודה gcloud dataproc autoscaling-policies import כדי ליצור מדיניות התאמה אוטומטית לעומס. היא קוראת קובץ YAML מקומי שמגדיר מדיניות של התאמה אוטומטית לעומס. הפורמט והתוכן של הקובץ צריכים להתאים לאובייקטים ולשדות של ההגדרות האישיות שמוגדרים על ידי ה-API בארכיטקטורת REST של autoscalingPolicies.
הדוגמה הבאה ב-YAML מגדירה מדיניות לאשכולות רגילים של Managed Service for Apache Spark, עם כל השדות הנדרשים. הוא גם מספק את הערכים של minInstances ו-maxInstances ל-primary workers, את הערך של maxInstances ל-secondary workers (ניתנים להפסקה לפני הזמן), ומציין cooldownPeriod של 4 דקות (ברירת המחדל היא 2 דקות). השדה workerConfig מגדיר את ה-primary workers. בדוגמה הזו, הערכים של minInstances ושל maxInstances זהים כדי למנוע שינוי גודל של העובדים הראשיים.
workerConfig:
  minInstances: 10
  maxInstances: 10
secondaryWorkerConfig:
  maxInstances: 50
basicAlgorithm:
  cooldownPeriod: 4m
  yarnConfig:
    scaleUpFactor: 0.05
    scaleDownFactor: 1.0
    gracefulDecommissionTimeout: 1h
בדוגמה הבאה ב-YAML מוגדרת מדיניות לאשכולות רגילים של Managed Service for Apache Spark, עם כל השדות הנדרשים והאופציונליים של מדיניות ההתאמה לעומס.
clusterType: STANDARD
workerConfig:
  minInstances: 10
  maxInstances: 10
  weight: 1
secondaryWorkerConfig:
  minInstances: 0
  maxInstances: 100
  weight: 1
basicAlgorithm:
  cooldownPeriod: 2m
  yarnConfig:
    scaleUpFactor: 0.05
    scaleDownFactor: 1.0
    scaleUpMinWorkerFraction: 0.0
    scaleDownMinWorkerFraction: 0.0
    gracefulDecommissionTimeout: 1h
בדוגמה הבאה של קובץ YAML מוגדרת מדיניות לאשכולות עם אפס צמתים.
באשכולות עם אפס קנה מידה, אל תכללו אתworkerConfig.
clusterType: ZERO_SCALE
secondaryWorkerConfig:
  minInstances: 0
  maxInstances: 100
  weight: 1
basicAlgorithm:
  cooldownPeriod: 2m
  yarnConfig:
    scaleUpFactor: 0.05
    scaleDownFactor: 1.0
    scaleUpMinWorkerFraction: 0.0
    scaleDownMinWorkerFraction: 0.0
    gracefulDecommissionTimeout: 1h
כדי ליצור את מדיניות ההתאמה האוטומטית לעומס, מריצים את הפקודה gcloud בטרמינל מקומי או ב-Cloud Shell. נותנים שם למדיניות. השם הזה יהפוך למדיניות id, שאפשר להשתמש בה בפקודות gcloud הבאות כדי להפנות למדיניות. משתמשים בדגל --source כדי לציין את הנתיב המקומי ואת שם הקובץ של קובץ ה-YAML של מדיניות ההתאמה לעומס (autoscaling) שרוצים לייבא.
gcloud dataproc autoscaling-policies import policy-name \
    --source=filepath/filename.yaml \
    --region=region
API בארכיטקטורת REST
יוצרים מדיניות של התאמה אוטומטית לעומס על ידי הגדרת AutoscalingPolicy כחלק מבקשת autoscalingPolicies.create.
יצירת אשכול עם התאמה אוטומטית לעומס (autoscaling)
אחרי שיוצרים מדיניות התאמה אוטומטית לעומס (autoscaling), יוצרים אשכול שישתמש במדיניות ההתאמה האוטומטית לעומס. האשכול צריך להיות באותו אזור שבו מוגדרת מדיניות שינוי הגודל האוטומטי.
מסוףGoogle Cloud
כדי להחיל מדיניות של התאמה אוטומטית לעומס (automatic scaling) על אשכול חדש:
- פותחים את הדף Managed Service for Apache Spark Create cluster.
- בקטע Define your cluster, בקטע Choose worker scaling mode, בוחרים באפשרות Autoscaling ואז בוחרים את המדיניות בשדה Policy.
CLI של gcloud
מריצים את הפקודה הבאה של gcloud מטרמינל מקומי או ב-Cloud Shell כדי ליצור אשכול עם התאמה אוטומטית לעומס. נותנים שם לאשכול ומשתמשים בדגל --autoscaling-policy כדי לציין את policy ID (שם המדיניות שציינתם כשיצרתם את המדיניות) או את המדיניות resource URI (resource name) (ראו את השדות id ו-name של AutoscalingPolicy).
gcloud dataproc clusters create cluster-name \
    --autoscaling-policy=policy id or resource URI \
    --region=region
API בארכיטקטורת REST
כדי ליצור אשכול עם התאמה אוטומטית לעומס, צריך לכלול את AutoscalingConfig כחלק מבקשת clusters.create.
הפעלת התאמה אוטומטית לעומס באשכול קיים
אחרי שיוצרים מדיניות התאמה אוטומטית לעומס (autoscaling), אפשר להפעיל את המדיניות באשכול קיים באותו אזור.
מסוףGoogle Cloud
אי אפשר להפעיל מדיניות של שינוי גודל אוטומטי באשכול קיים במסוף Google Cloud .
CLI של gcloud
כדי להפעיל מדיניות של התאמה אוטומטית לעומס באשכול קיים, מריצים את הפקודה gcloud מהטרמינל המקומי או מ-Cloud Shell. מזינים את שם האשכול ומשתמשים בדגל --autoscaling-policy כדי לציין את policy ID (השם של המדיניות שציינתם כשיצרתם את המדיניות) או את המדיניות resource URI (resource name) (ראו את השדות AutoscalingPolicy id ו-name).
gcloud dataproc clusters update cluster-name \
    --autoscaling-policy=policy id or resource URI \
    --region=region
API בארכיטקטורת REST
כדי להפעיל מדיניות של התאמה אוטומטית לעומס באשכול קיים, צריך להגדיר את AutoscalingConfig.policyUri של המדיניות ב-updateMask של בקשת clusters.patch.
שימוש במדיניות של כמה אשכולות
מדיניות התאמה אוטומטית לעומס מגדירה את אופן ההתאמה לעומס שאפשר להחיל על כמה אשכולות. כדאי להחיל מדיניות של התאמה אוטומטית לעומס על כמה אשכולות כשהאשכולות חולקים עומסי עבודה דומים או מריצים משימות עם דפוסי שימוש דומים במשאבים.
אפשר לעדכן מדיניות שמשמשת כמה אשכולות. העדכונים משפיעים באופן מיידי על התנהגות ההתאמה לעומס (autoscaling) בכל האשכולות שמשתמשים במדיניות (ראו autoscalingPolicies.update). אם אתם לא רוצים שעדכון מדיניות יחול על אשכול שמשתמש במדיניות, השביתו את ההתאמה לעומס באשכול לפני עדכון המדיניות.
מסוףGoogle Cloud
אי אפשר להשבית את המידרוג האוטומטי באשכול במסוף Google Cloud .
CLI של gcloud
מריצים את הפקודה הבאה של gcloud מטרמינל מקומי או ב-Cloud Shell כדי להשבית את ההתאמה האוטומטית לעומס באשכול.
gcloud dataproc clusters update cluster-name --disable-autoscaling \
    --region=region
API בארכיטקטורת REST
כדי להשבית את ההתאמה האוטומטית לעומס באשכול, מגדירים את AutoscalingConfig.policyUri למחרוזת ריקה ומגדירים את update_mask=config.autoscaling_config.policy_uri בבקשת clusters.patch.
- אי אפשר למחוק מדיניות שנמצאת בשימוש באשכול אחד או יותר (ראו autoscalingPolicies.delete).
איך פועלת התאמה אוטומטית לעומס (autoscaling)
התאמה אוטומטית לעומס בודקת את מדדי Hadoop YARN של האשכול בכל פעם שתקופת ה"צינון" מסתיימת כדי לקבוע אם לשנות את קנה המידה של האשכול, ואם כן, מה יהיה היקף העדכון.
ערך המדד של המשאבים הממתינים ב-YARN (זיכרון ממתין או ליבות ממתינות) קובע אם להרחיב או לצמצם. ערך שגדול מ-
0מציין שמשימות YARN ממתינות למשאבים, ויכול להיות שצריך להרחיב אנכית בהתאם לעומס (scale up). הערך0מציין של-YARN יש מספיק משאבים, כך שלא נדרשת הפחתה או שינויים אחרים.אם המשאב בהמתנה הוא > 0:
$estimated\_worker\_count =$
\[ \Biggl \lceil AVERAGE\ during\ cooldown\ period\Big(\frac{Pending + Available + Allocated + Reserved}{Resource\ per\ worker}\Big)\Biggr \rceil \]
אם המשאב בהמתנה הוא 0:
$estimated\_worker\_count =$
\[ \Biggl \lceil AVERAGE\ during\ cooldown\ period\Big(\frac{Allocated + Reserved}{Resource\ per\ worker}\Big)\Biggr \rceil \]
כברירת מחדל, החל מתמונה 2.2 של Managed Service for Apache Spark, המידרוג האוטומטי עוקב אחרי זיכרון YARN וליבות YARN, כך ש-
estimated_worker_countמוערך בנפרד עבור זיכרון וליבות, ונבחר מספר ה-workers הגדול יותר שמתקבל. בגרסאות קודמות של התמונה, המידרוג האוטומטי עוקב רק אחרי הזיכרון של YARN, אלא אם מפעילים התאמה אוטומטית לעומס שמבוססת על ליבות כדי לעקוב גם אחרי הזיכרון וגם אחרי הליבות של YARN.$estimated\_worker\_count =$
\[ max(estimated\_worker\_count\_by\_memory,\ estimated\_worker\_count\_by\_cores) \]
\[ estimated\ \Delta worker = estimated\_worker\_count - current\_worker\_count \]
בהתאם לשינוי המשוער שנדרש במספר ה-workers, המערכת משתמשת ב
scaleUpFactorאו בscaleDownFactorכדי לחשב את השינוי בפועל במספר ה-workers:if estimated Δworkers > 0: actual Δworkers = ROUND_UP(estimated Δworkers * scaleUpFactor) # examples: # ROUND_UP(estimated Δworkers=5 * scaleUpFactor=0.5) = 3 # ROUND_UP(estimated Δworkers=0.8 * scaleUpFactor=0.5) = 1 else: actual Δworkers = ROUND_DOWN(estimated Δworkers * scaleDownFactor) # examples: # ROUND_DOWN(estimated Δworkers=-5 * scaleDownFactor=0.5) = -2 # ROUND_DOWN(estimated Δworkers=-0.8 * scaleDownFactor=0.5) = 0 # ROUND_DOWN(estimated Δworkers=-1.5 * scaleDownFactor=0.5) = 0
אם הערך של scaleUpFactor או scaleDownFactor הוא 1.0, ההתאמה האוטומטית לעומס תתבצע כך שהמשאב בהמתנה או המשאב הזמין יהיה 0 (ניצול מושלם).
אחרי שמחושב השינוי במספר ה-workers, הערך של
scaleUpMinWorkerFractionו-scaleDownMinWorkerFractionמשמש כסף לקביעה אם ההתאמה האוטומטית לעומס (automatic scaling) תשנה את קנה המידה של האשכול. שבר קטן מציין שההתאמה האוטומטית לעומס צריכה להתבצע גם אם הערך שלΔworkersקטן. שבר גדול יותר אומר שהשינוי צריך להתרחש רק כשהערך שלΔworkersגדול.IF (Δworkers > scaleUpMinWorkerFraction * current_worker_count) then scale up
IF (abs(Δworkers) >  scaleDownMinWorkerFraction * current_worker_count),
THEN scale down.
אם מספר ה-workers שצריך להגדיל או להקטין גדול מספיק כדי להפעיל את ההתאמה לעומס, המערכת משתמשת בגבולות
minInstancesmaxInstancesשלworkerConfigו-secondaryWorkerConfigו-weight(היחס בין ה-workers הראשיים למשניים) כדי לקבוע איך לפצל את מספר ה-workers בין קבוצות המכונות של ה-workers הראשיים והמשניים. התוצאה של החישובים האלה היא השינוי הסופי של ההתאמה האוטומטית לעומס באשכול לתקופת ההתאמה לעומס.בקשות להקטנת קנה מידה של התאמה אוטומטית לעומס יבוטלו באשכולות שנוצרו עם גרסאות תמונה 2.0.57 ומעלה, 2.1.5 ומעלה וגרסאות תמונה מאוחרות יותר אם:
- מתבצע צמצום הדרגתי של כמות השרתים עם ערך זמן קצוב לתפוגה שאינו אפס, וגם
מספר ה-YARN workers הפעילים ("active workers") בתוספת השינוי במספר הכולל של ה-workers שהומלצו על ידי ה-autoscaler (
Δworkers) שווה ל-DECOMMISSIONINGYARN workers או גדול ממנו ("decommissioning workers"), כפי שמוצג בנוסחה הבאה:IF (active workers + Δworkers ≥ active workers + decommissioning workers) THEN cancel the scaledown operation
דוגמה לביטול של הקטנת נפח מופיעה בקטע מתי ההתאמה האוטומטית לעומס מבטלת פעולה של הקטנת נפח?.
המלצות להגדרות של התאמה אוטומטית לעומס
בקטע הזה מפורטות המלצות שיעזרו לכם להגדיר התאמה אוטומטית לעומס.
הימנעות מהתאמה לעומס (scaling) של ה-primary workers
ה-workers הראשיים מריצים HDFS Datanodes, בעוד שה-workers המשניים הם רק לחישוב.
השימוש ב-workers משניים מאפשר להגדיל את משאבי המחשוב ביעילות בלי להקצות נפח אחסון, וכך אפשר להגדיל את המשאבים מהר יותר.
יכולים להיות כמה מרוצי תהליכים ב-Namenodes של HDFS שגורמים ל-HDFS להיות פגום, כך שהוצאה משימוש נתקעת ללא הגבלת זמן. כדי להימנע מהבעיה הזו, לא מומלץ לשנות את גודל העובדים הראשיים. לדוגמה: none
workerConfig:
minInstances: 10
maxInstances: 10
secondaryWorkerConfig:
minInstances: 0
maxInstances: 100
צריך לבצע כמה שינויים בפקודה ליצירת אשכול:
- מגדירים את
--num-workers=10כך שיתאים לגודל של קבוצת ה-primary worker במדיניות ההתאמה האוטומטית לעומס. - מגדירים את
--secondary-worker-type=non-preemptibleכדי להגדיר עובדים משניים שלא ניתן לקטוע את הפעולה שלהם. (אלא אם רוצים להשתמש במכונות וירטואליות זמניות). - העתקת הגדרת החומרה מ-primary workers ל-secondary workers. לדוגמה, מגדירים את
--secondary-worker-boot-disk-size=1000GBכך שיתאים ל---worker-boot-disk-size=1000GB.
שימוש במצב גמישות משופרת למשימות באצווה של Spark
שימוש במצב גמישות משופר (EFM) עם התאמה אוטומטית לעומס (automatic scaling) כדי:
הפעלה של הקטנה מהירה יותר של קנה המידה של האשכול בזמן שהעבודות פועלות
כדי למנוע שיבושים במשימות שפועלות בגלל הקטנת האשכול
צמצום ההפרעות למשימות שפועלות בגלל הפסקה לפני הזמן של עובדים משניים שניתנים להפסקה לפני הזמן
אם EFM מופעל, צריך להגדיר את פסק הזמן לצמצום הדרגתי של כמות השרתים של מדיניות ההתאמה האוטומטית לעומס ל-0s. מדיניות ההתאמה לעומס (autoscaling) צריכה להתאים את העומס רק בעובדים המשניים.
בחירת זמן קצוב לתפוגה של צמצום הדרגתי של כמות השרתים
התכונה 'שינוי גודל אוטומטי' תומכת בהוצאה מסודרת משימוש של YARN כשמסירים צמתים מאשכול. צמצום הדרגתי של כמות השרתים מאפשר לאפליקציות לסיים את ערבוב הנתונים בין השלבים, כדי למנוע עיכוב בהתקדמות המשימה. זמן הקצוב לצמצום הדרגתי של כמות השרתים שמוגדר במדיניות של התאמה אוטומטית לעומס הוא משך הזמן המקסימלי ש-YARN ימתין לאפליקציות שפועלות (אפליקציות שפעלו כשהתחיל הצמצום הדרגתי של כמות השרתים) לפני הסרת הצמתים.
אם תהליך לא מסתיים במסגרת הזמן שמוגדר להפסקת פעילות הדרגתית, צומת העובד נסגר בכוח, וזה עלול לגרום לאובדן נתונים או לשיבוש בשירות. כדי למנוע את המצב הזה, צריך להגדיר את זמן הקצוב לתפוגה של צמצום הדרגתי של כמות השרתים לערך ארוך יותר מהמשימה הארוכה ביותר שהאשכול יעבד. לדוגמה, אם אתם צופים שהמשימה הכי ארוכה תימשך שעה, הגדירו את הזמן הקצוב לתפוגה לשעה אחת לפחות (1h).
כדי למנוע חסימה של צמצום הדרגתי של כמות השרתים, כדאי להעביר משימות שנמשכות יותר משעה לאשכולות זמניים משלהן.
ההגדרה scaleUpFactor
scaleUpFactor קובע את רמת האגרסיביות של המידרוג האוטומטי בהגדלת אשכול.
צריך לציין מספר בין 0.0 ל-1.0 כדי להגדיר את הערך השברי של משאב YARN בהמתנה שגורם להוספת צומת.
לדוגמה, אם יש 100 קונטיינרים בהמתנה שכל אחד מהם מבקש 512MB, אז יש 50GB של זיכרון YARN בהמתנה. אם scaleUpFactor הוא 0.5, אז המידרוג האוטומטי יוסיף מספיק צמתים כדי להוסיף 25GB של זיכרון YARN. באופן דומה, אם הוא 0.1, הכלי להרחבה אוטומטית יוסיף מספיק צמתים ל-5GB. הערה: הערכים האלה תואמים לזיכרון YARN, ולא לזיכרון הכולל שזמין פיזית במכונה וירטואלית.
נקודת התחלה טובה היא 0.05 למשימות MapReduce ולמשימות Spark עם הקצאה דינמית מופעלת. למשימות Spark עם מספר קבוע של מבצעים ולמשימות Tez, משתמשים ב-1.0. אם הערך של scaleUpFactor הוא 1.0, ההתאמה האוטומטית לעומס תתבצע כך שהמשאב הזמין או בהמתנה יהיה 0 (ניצול מושלם).
ההגדרה scaleDownFactor
ההגדרה scaleDownFactor קובעת את רמת האגרסיביות של הקטנת קנה המידה של אשכול על ידי הכלי לשינוי גודל אוטומטי. מציינים מספר בין 0.0 ל-1.0 כדי להגדיר את הערך השברי של המשאב הזמין ב-YARN שגורם להסרת הצומת.
כדאי להשאיר את הערך הזה על 1.0 ברוב האשכולות עם כמה משימות שצריך להרחיב ולהקטין לעיתים קרובות. כתוצאה מהצמצום ההדרגתי של כמות השרתים, פעולות של צמצום כמות השרתים איטיות משמעותית מפעולות של הגדלת כמות השרתים. הגדרה של scaleDownFactor=1.0 קובעת קצב הקטנה אגרסיבי, שממזער את מספר הפעולות של הקטנת קנה המידה שנדרשות כדי להשיג את גודל האשכול המתאים.
אם יש אשכולות שצריכים יציבות רבה יותר, אפשר להגדיר ערך נמוך יותר של scaleDownFactor כדי להקטין את קצב ההקטנה.
כדי למנוע את הקטנת האשכול, למשל כשמשתמשים באשכולות זמניים או באשכולות של משימה אחת, מגדירים את הערך הזה כ-0.0.
הגדרה של scaleUpMinWorkerFraction ושל scaleDownMinWorkerFraction
הפרמטרים scaleUpMinWorkerFraction ו-scaleDownMinWorkerFraction משמשים עם scaleUpFactor או scaleDownFactor, וערכי ברירת המחדל שלהם הם 0.0. הם מייצגים את ספי ההפעלה שבהם יתבצע גידול או הקטנה של האשכול על ידי Autoscaler: הגידול או ההקטנה המינימליים של גודל האשכול שנדרשים כדי להנפיק בקשות להגדלה או להקטנה.
דוגמאות: המידרוג האוטומטי לא ישלח בקשת עדכון להוספת 5 workers לאשכול של 100 צמתים, אלא אם הערך של scaleUpMinWorkerFraction קטן מ-0.05 (5%) או שווה לו. אם הערך הוא 0.1, המידרוג האוטומטי לא ישלח בקשה להרחבה אנכית של האשכול.
באופן דומה, אם scaleDownMinWorkerFraction הוא 0.05, המידרוג האוטומטי לא יסיר לפחות 5 צמתים.
ערך ברירת המחדל 0.0 מציין שאין סף.
מומלץ מאוד להגדיר ערך גבוה יותר של scaleDownMinWorkerFractionthresholds באשכולות גדולים (יותר מ-100 צמתים) כדי להימנע מפעולות התאמה קטנות ומיותרות.
בחירת תקופת צינון
ההגדרה cooldownPeriod קובעת תקופה שבה לא יישלחו בקשות לשינוי גודל האשכול על ידי קנה המידה האוטומטי. אתם יכולים להשתמש בו כדי להגביל את התדירות שבה ה-autoscaler משנה את גודל האשכול.
הערך המינימלי וערך ברירת המחדל של cooldownPeriod
הוא שתי דקות. אם מגדירים במדיניות cooldownPeriod קצר יותר, שינויים בעומס העבודה ישפיעו מהר יותר על גודל האשכול, אבל יכול להיות שהאשכולות יתרחבו או יצטמצמו שלא לצורך. כשמשתמשים בערך cooldownPeriod קצר יותר, מומלץ להגדיר את הערכים scaleUpMinWorkerFraction ו-scaleDownMinWorkerFraction של המדיניות לערך שאינו אפס. כך אפשר לוודא שהאשכול יורחב או יצומצם רק כשהשינוי בניצול המשאבים מצדיק עדכון של האשכול.
אם עומס העבודה שלכם רגיש לשינויים בגודל האשכול, אתם יכולים להגדיל את תקופת הצינון. לדוגמה, אם מריצים עבודת עיבוד באצווה, אפשר להגדיר את תקופת ההמתנה ל-10 דקות או יותר. כדאי לנסות תקופות צינון שונות כדי למצוא את הערך שהכי מתאים לעומס העבודה שלכם.
גבולות של מספר העובדים ומשקלים של קבוצות
לכל קבוצת עובדים יש minInstances ו-maxInstances שמגדירים מגבלה קשיחה על הגודל של כל קבוצה.
לכל קבוצה יש גם פרמטר שנקרא weight, שקובע את יעד האיזון בין שתי הקבוצות. חשוב לזכור שהפרמטר הזה הוא רק רמז, ואם קבוצה מגיעה לגודל המינימלי או המקסימלי שלה, צמתים יתווספו רק לקבוצה השנייה או יוסרו ממנה. לכן, כמעט תמיד אפשר להשאיר את weight בערך ברירת המחדל 1.
שימוש בהתאמה אוטומטית של קנה מידה שמבוססת על ליבות
באפליקציות שדורשות שימוש אינטנסיבי במעבד (CPU), מומלץ להשתמש ב-Dominant Resource Calculator להקצאת משאבים. זו הגדרת ברירת המחדל של YARN החל מגרסת התמונה 2.2 של Managed Service for Apache Spark. בגרסאות קודמות של קובצי אימג', Managed Service for Apache Spark מגדיר את YARN לשימוש במדדי זיכרון להקצאת משאבים, אלא אם מגדירים את המאפיין הבא כשיוצרים אשכול כדי להגדיר את YARN לשימוש ב-Dominant Resource Calculator:
capacity-scheduler:yarn.scheduler.capacity.resource-calculator=org.apache.hadoop.yarn.util.resource.DominantResourceCalculator
מדדים ויומנים של התאמה לעומס (autoscaling)
המשאבים והכלים הבאים יכולים לעזור לכם לעקוב אחרי פעולות ההתאמה האוטומטית לעומס וההשפעה שלהן על האשכול ועל המשימות שלו.
Cloud Monitoring
אפשר להשתמש ב-Cloud Monitoring כדי:
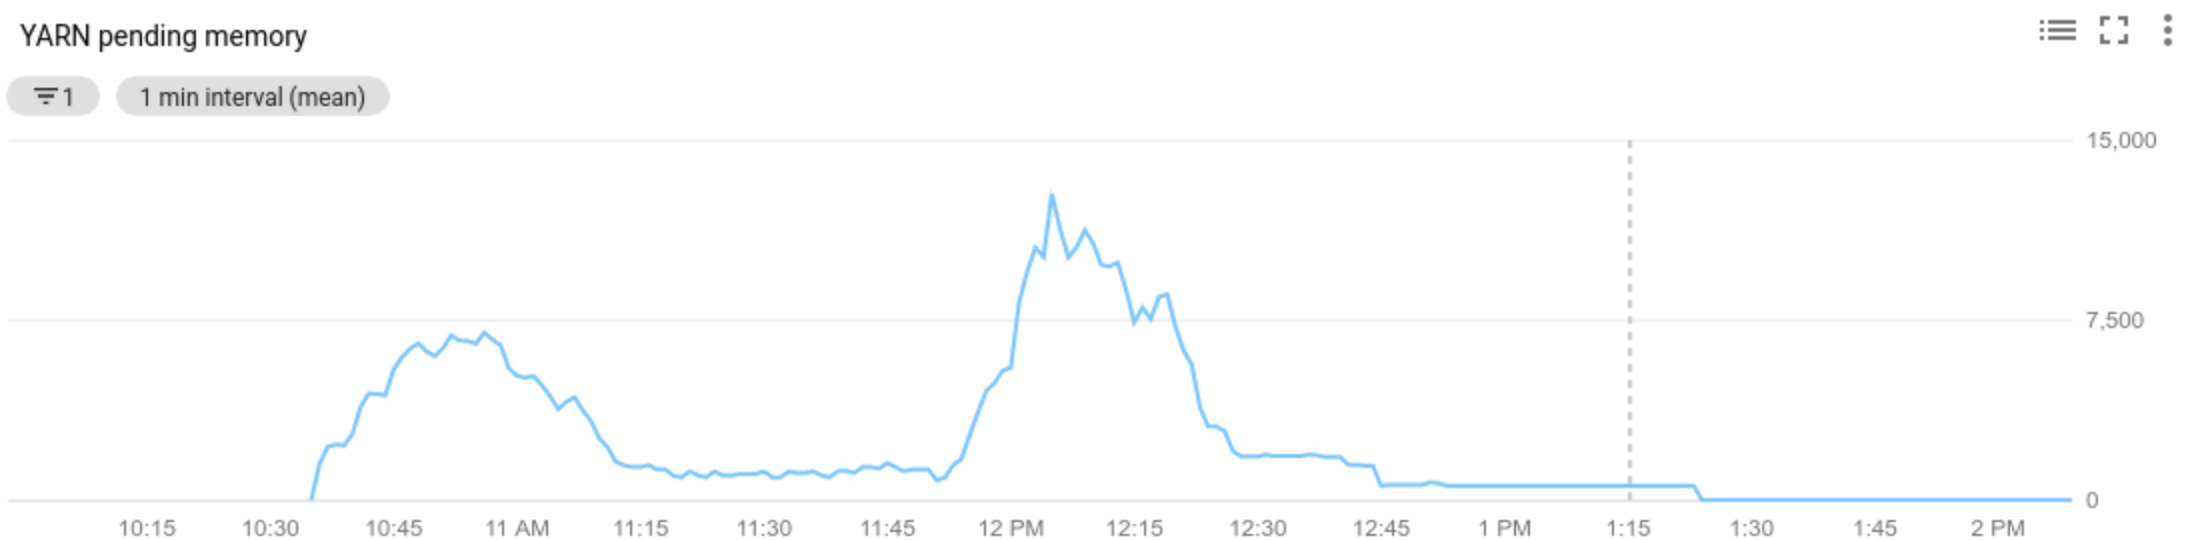
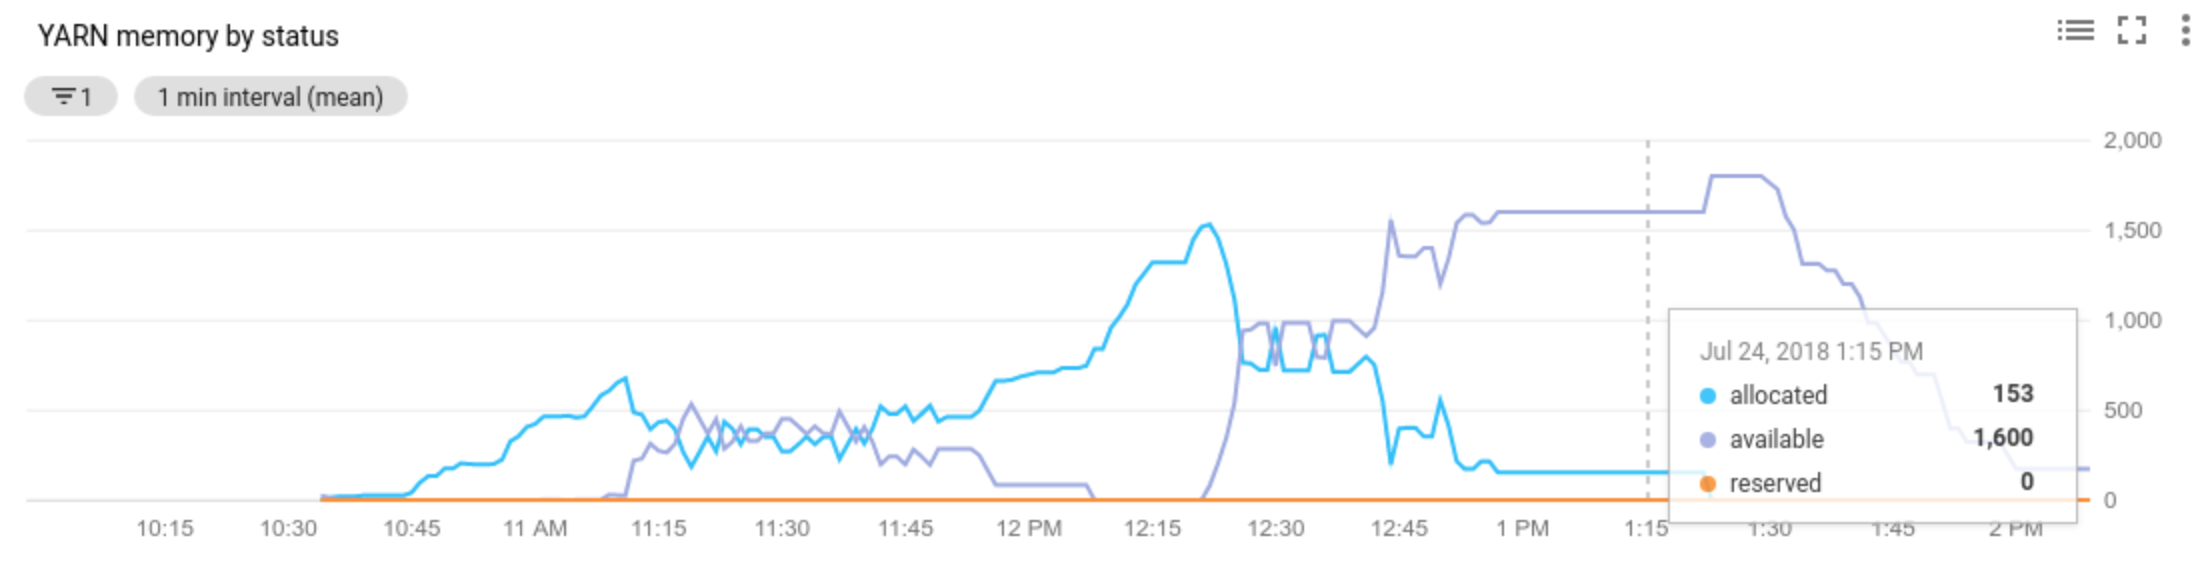
- לצפות במדדים שמשמשים להתאמה אוטומטית לעומס
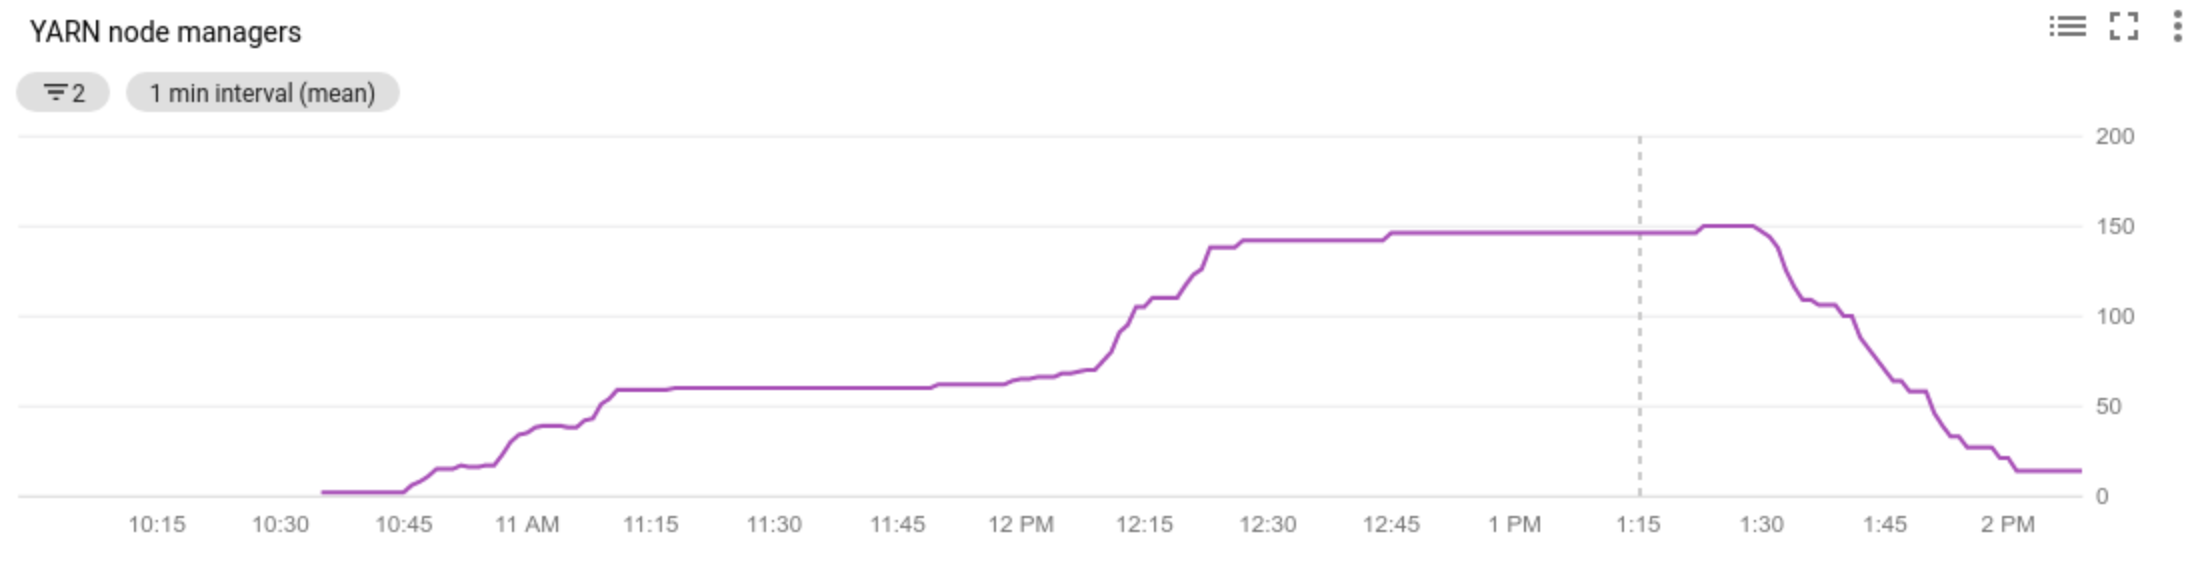
- לראות את מספר מנהלי הצמתים באשכול
- להבין למה ההתאמה האוטומטית לעומס שינתה או לא שינתה את קנה המידה של האשכול
Cloud Logging
אתם יכולים להשתמש ב-Cloud Logging כדי לצפות ביומנים של Managed Service for Apache Spark Autoscaler.
1) מאתרים את היומנים של האשכול.
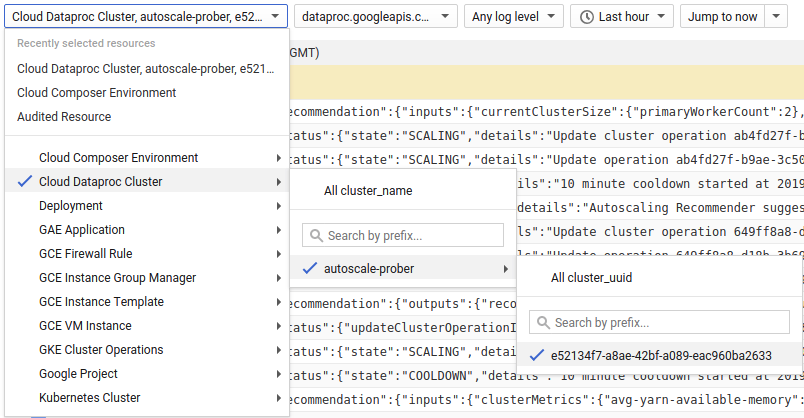
2) לוחצים על dataproc.googleapis.com/autoscaler.
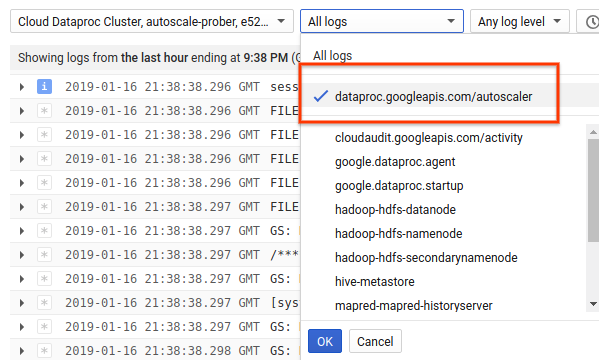
3) מרחיבים את הודעות היומן כדי לראות את השדה status. היומנים הם בפורמט JSON, פורמט קריא למכונה.
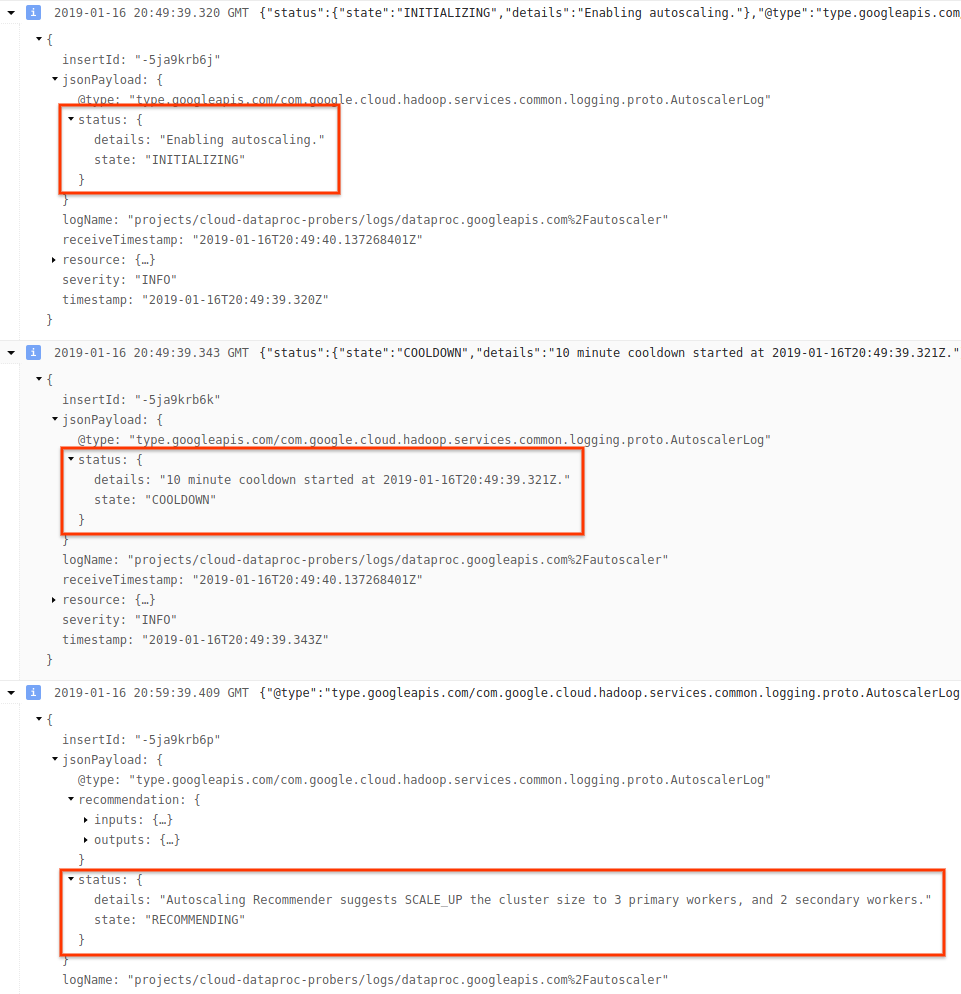
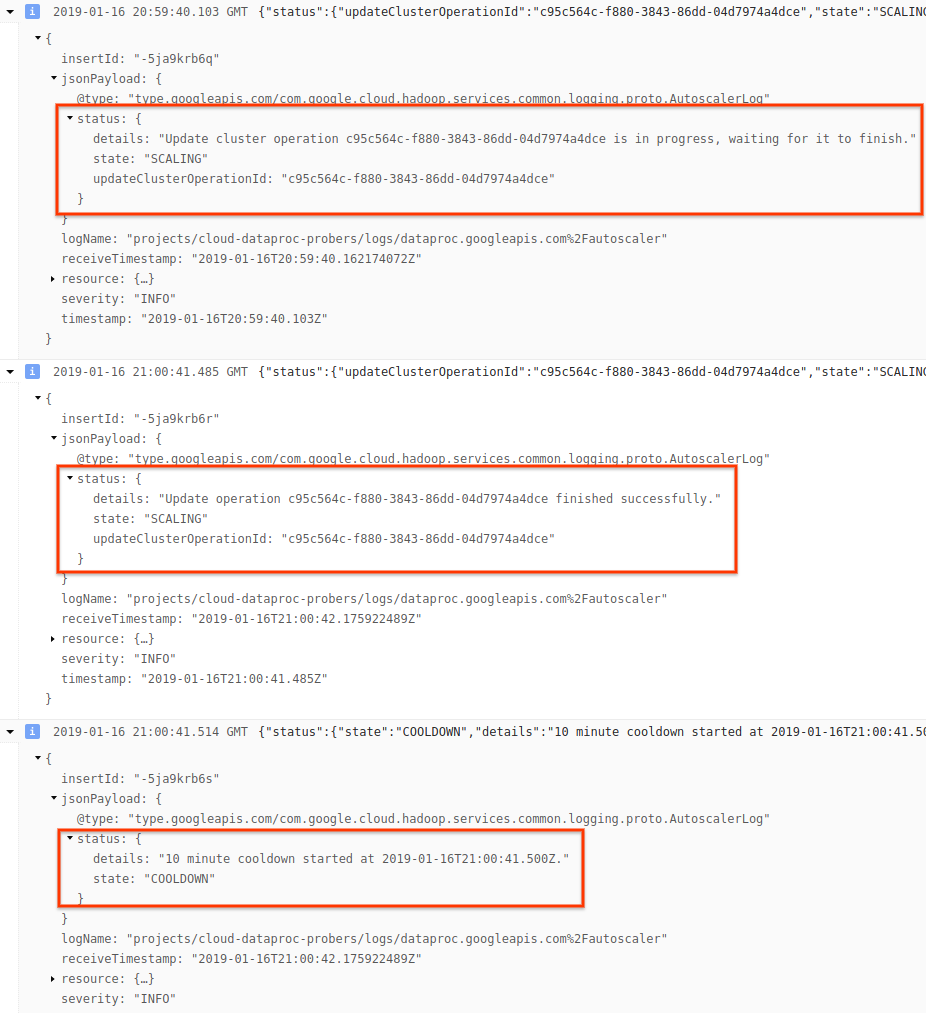
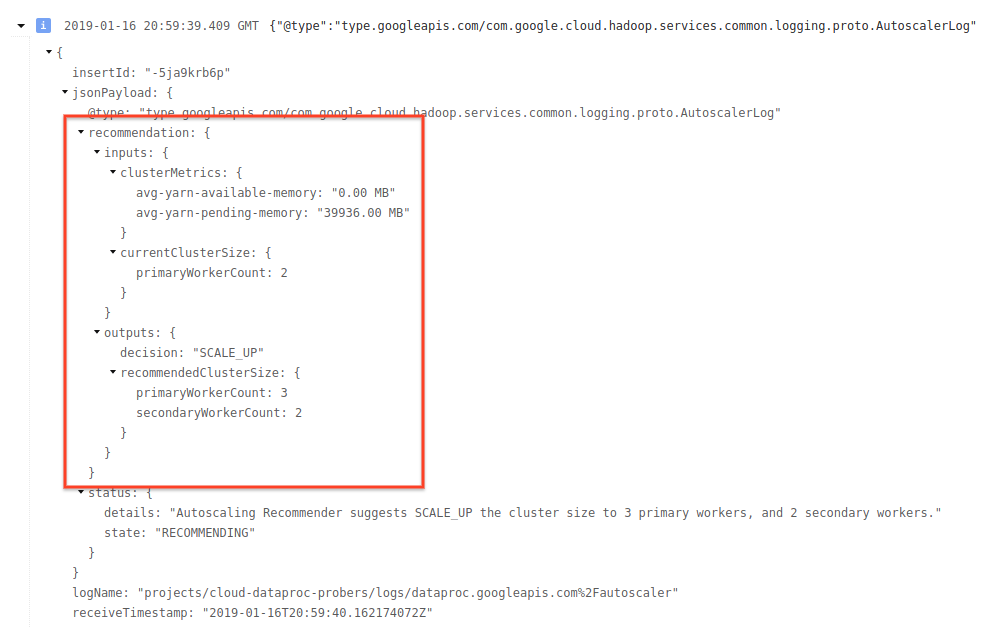
4) מרחיבים את הודעת היומן כדי לראות את ההמלצות לשינוי קנה המידה, המדדים ששימשו לקבלת ההחלטות לגבי שינוי קנה המידה, הגודל המקורי של האשכול והגודל החדש של אשכול היעד.
רקע: התאמה אוטומטית לעומס (autoscaling) עם Apache Hadoop ו-Apache Spark
בקטעים הבאים מוסבר איך פועלת ההתאמה האוטומטית לעומס (או לא פועלת) עם Hadoop YARN ו-Hadoop Mapreduce, ועם Apache Spark, Spark Streaming ו-Spark Structured Streaming.
מדדי Hadoop YARN
התאמה אוטומטית לעומס מתמקדת במדדים הבאים של Hadoop YARN:
Allocated resourceמייצג את סך משאבי ה-YARN שנדרשים להפעלת קונטיינרים בכל האשכול. אם יש 6 קונטיינרים פעילים שיכולים להשתמש בעד יחידה אחת של משאב, יש 6 משאבים שהוקצו.
Available resourceהוא משאב YARN באשכול שלא נמצא בשימוש על ידי קונטיינרים שהוקצו. אם יש 10 יחידות של משאבים בכל מנהלי הצמתים ו-6 מהן מוקצות, יש 4 משאבים זמינים. אם יש באשכול משאבים זמינים (שלא בשימוש), יכול להיות שההתאמה האוטומטית לעומס תסיר מהאשכול את ה-workers.
Pending resourceהוא הסכום של בקשות המשאבים של YARN למאגרים בהמתנה. מאגרי תגים בהמתנה ממתינים למקום להפעלה ב-YARN. המשאב בהמתנה הוא לא אפס רק אם המשאב הזמין הוא אפס או קטן מדי להקצאה לקונטיינר הבא. אם יש קונטיינרים בהמתנה, יכול להיות שההתאמה האוטומטית לעומס תוסיף עובדים לאשכול.
אתם יכולים לראות את המדדים האלה ב-Cloud Monitoring. כברירת מחדל, הזיכרון של YARN יהיה 0.8 * הזיכרון הכולל באשכול, והזיכרון שנותר ישמש לשימוש במערכת ההפעלה ובדמונים אחרים, כמו מטמון הדפים. אפשר לבטל את ערך ברירת המחדל באמצעות הגדרת התצורה של YARN yarn.nodemanager.resource.memory-mb (ראו מאפיינים שקשורים ל-Apache Hadoop YARN, HDFS ו-Spark).
התאמה אוטומטית לעומס ו-Hadoop MapReduce
MapReduce מפעיל כל משימת מיפוי וצמצום כקונטיינר YARN נפרד. כשהמשימה מתחילה, MapReduce שולח בקשות לקונטיינרים לכל משימת מיפוי, וכתוצאה מכך יש עלייה חדה בזיכרון YARN בהמתנה. ככל שמשימות המיפוי מסתיימות, הזיכרון בהמתנה פוחת.
כש-mapreduce.job.reduce.slowstart.completedmaps מסתיימים (95% כברירת מחדל ב-Managed Service for Apache Spark), MapReduce מוסיף לתור בקשות לקונטיינרים לכל ה-reducers, וכתוצאה מכך יש עוד עלייה חדה בזיכרון בהמתנה.
אם משימות ה-map וה-reduce לא נמשכות כמה דקות או יותר, אל תגדירו ערך גבוה להתאמה אוטומטית לעומס (scaleUpFactor). הוספת עובדים לאשכול נמשכת לפחות דקה וחצי, לכן חשוב לוודא שיש מספיק עבודה בהמתנה כדי להעסיק את העובד החדש למשך כמה דקות. נקודת התחלה טובה היא להגדיר את scaleUpFactor ל-0.05 (5%) או ל-0.1 (10%) מהזיכרון בהמתנה.
התאמה אוטומטית לעומס ו-Spark
Spark מוסיף שכבת תזמון נוספת מעל YARN. באופן ספציפי, ההקצאה הדינמית של Spark Core שולחת בקשות ל-YARN למאגרים כדי להריץ את מנהלי הביצוע של Spark, ואז מתזמנת משימות של Spark בשרשורים במנהלי הביצוע האלה. באשכולות של Managed Service for Apache Spark, הקצאה דינמית מופעלת כברירת מחדל, כך שנוספים ומסירים תהליכי ביצוע לפי הצורך.
מערכת Spark תמיד מבקשת קונטיינרים מ-YARN, אבל בלי הקצאה דינמית, היא מבקשת קונטיינרים רק בתחילת העבודה. בהקצאה דינמית, המערכת תסיר מאגרים או תבקש מאגרים חדשים לפי הצורך.
Spark מתחיל ממספר קטן של מבצעים – 2 באשכולות עם התאמה אוטומטית לעומס – וממשיך להכפיל את מספר המבצעים כל עוד יש משימות בצבר המשימות.
כך אפשר להקטין את העלייה החדה בזיכרון בהמתנה. מומלץ להגדיר את scaleUpFactor של ההתאמה האוטומטית לעומס למספר גדול, כמו 1.0 (100%), בשביל משימות Spark.
השבתת ההקצאה הדינמית של Spark
אם אתם מריצים משימות Spark נפרדות שלא נהנות מההקצאה הדינמית של Spark, אתם יכולים להשבית את ההקצאה הדינמית של Spark על ידי הגדרת spark.dynamicAllocation.enabled=false והגדרת spark.executor.instances.
עדיין אפשר להשתמש בהתאמת קנה מידה אוטומטית כדי להגדיל ולהקטין את האשכולות בזמן שהפעלתם את משימות Spark הנפרדות.
משימות Spark עם נתונים שנשמרו במטמון
כבר לא צריך את מערכי הנתונים, צריך להגדיר את spark.dynamicAllocation.cachedExecutorIdleTimeout או לבטל את השמירה שלהם במטמון. כברירת מחדל, Spark לא מסיר תהליכי הפעלה ששמרו נתונים במטמון, מה שמונע את הקטנת קנה המידה של האשכול.
התאמה אוטומטית לעומס (autoscaling) ו-Spark Streaming
ל-Spark Streaming יש גרסה משלו של הקצאה דינמית שמשתמשת באותות ספציפיים לסטרימינג כדי להוסיף ולהסיר תהליכי הפעלה. לכן, צריך להגדיר את
spark.streaming.dynamicAllocation.enabled=trueולהשבית את ההקצאה הדינמית של Spark Core על ידי הגדרתspark.dynamicAllocation.enabled=false.אל תשתמשו בצמצום הדרגתי של כמות השרתים (התאמה לעומס (autoscaling)
gracefulDecommissionTimeout) עם משימות Spark Streaming. במקום זאת, כדי להסיר בבטחה workers באמצעות התאמה אוטומטית לעומס, מגדירים נקודות ביקורת לעמידות בפני תקלות.
לחלופין, כדי להשתמש ב-Spark Streaming בלי התאמה אוטומטית לעומס:
- משביתים את ההקצאה הדינמית של Spark Core (
spark.dynamicAllocation.enabled=false), וגם - מגדירים את מספר המבצעים (
spark.executor.instances) לעבודה. מידע נוסף על מאפייני אשכול
התאמה לעומס (autoscaling) ו-Spark Structured Streaming
אין תאימות בין התאמה אוטומטית לעומס לבין Spark Structured Streaming כי Spark Structured Streaming לא תומך בהקצאה דינמית (ראו SPARK-24815: Structured Streaming should support dynamic allocation).
שליטה בהתאמה לעומס (autoscaling) באמצעות חלוקה למחיצות (partitioning) ומקביליות (parallelism)
בדרך כלל, רמת המקביליות מוגדרת או נקבעת על ידי משאבי האשכול (לדוגמה, מספר בלוקי ה-HDFS שולט במספר המשימות), אבל כשמשתמשים בהתאמה אוטומטית לעומס (automatic scaling), המצב הפוך: ההתאמה האוטומטית לעומס (automatic scaling) מגדירה את מספר ה-workers בהתאם לרמת המקביליות של העבודה. ההנחיות הבאות יעזרו לכם להגדיר את מקביליות המשימות:
- השירות המנוהל של Apache Spark מגדיר את מספר ברירת המחדל של משימות MapReduce reduce על סמך הגודל הראשוני של האשכול, אבל אתם יכולים להגדיר את
mapreduce.job.reducesכדי להגדיל את המקביליות של שלב ה-reduce. - ההקבלה של Spark SQL ו-Dataframe נקבעת על ידי
spark.sql.shuffle.partitions, שמוגדר כברירת מחדל ל-200. - פונקציות ה-RDD של Spark מוגדרות כברירת מחדל ל-
spark.default.parallelism, שמוגדר למספר ליבות בצמתי העובדים כשהעבודה מתחילה. עם זאת, כל פונקציות ה-RDD שיוצרות ערבובים מקבלות פרמטר למספר המחיצות, שמבטל אתspark.default.parallelism.
חשוב לוודא שהנתונים מחולקים באופן שווה. אם יש הטיה משמעותית במפתחות, יכול להיות שמשימה אחת או יותר יימשכו הרבה יותר זמן ממשימות אחרות, וכתוצאה מכך הניצול יהיה נמוך.
הגדרות ברירת המחדל של המאפיינים של Spark ו-Hadoop להתאמה לעומס (autoscaling)
לאשכולות עם התאמה אוטומטית לעומס יש ערכי ברירת מחדל של מאפייני אשכול, שעוזרים למנוע כשלים במשימות כשמסירים את ה-primary workers או כשמפקיעים את ה-secondary workers. אפשר לשנות את ערכי ברירת המחדל האלה כשיוצרים אשכול עם התאמה לעומס (ראו מאפייני אשכול).
ברירות מחדל להגדלת המספר המקסימלי של ניסיונות חוזרים למשימות, למנהלי אפליקציות ולשלבים:
yarn:yarn.resourcemanager.am.max-attempts=10
mapred:mapreduce.map.maxattempts=10
mapred:mapreduce.reduce.maxattempts=10
spark:spark.task.maxFailures=10
spark:spark.stage.maxConsecutiveAttempts=10
ברירות המחדל לאיפוס מוני הניסיונות החוזרים (שימושי למשימות Spark Streaming שפועלות לאורך זמן):
spark:spark.yarn.am.attemptFailuresValidityInterval=1h
spark:spark.yarn.executor.failuresValidityInterval=1h
ברירת המחדל היא שמנגנון ההקצאה הדינמית של Spark, שמתחיל לאט, יתחיל מגודל קטן:
spark:spark.executor.instances=2
שאלות נפוצות
בקטע הזה מופיעות שאלות ותשובות נפוצות בנושא התאמה אוטומטית לעומס.
האם אפשר להפעיל התאמה אוטומטית לעומס (auto-scaling) באשכולות עם זמינות גבוהה ובאשכולות עם צומת יחיד?
אפשר להפעיל התאמה אוטומטית לעומס באשכולות עם זמינות גבוהה, אבל לא באשכולות עם צומת יחיד (אשכולות עם צומת יחיד לא תומכים בשינוי גודל).
האם אפשר לשנות את הגודל של אשכול עם קנה מידה אוטומטי באופן ידני?
כן. יכול להיות שתחליטו לשנות את הגודל של אשכול באופן ידני כפתרון זמני בזמן שאתם משנים את מדיניות ההתאמה לעומס. עם זאת, השינויים האלה יהיו זמניים בלבד, ובסופו של דבר התכונה 'התאמה אוטומטית לעומס' תצמצם את גודל האשכול.
במקום לשנות את הגודל של אשכול עם התאמה אוטומטית לעומס באופן ידני, כדאי:
עדכון מדיניות ההתאמה האוטומטית לעומס. כל שינוי במדיניות של התאמה אוטומטית לעומס ישפיע על כל האשכולות שמשתמשים כרגע במדיניות הזו** (ראו שימוש במדיניות של כמה אשכולות).
מנתקים את המדיניות ומשנים את גודל האשכול באופן ידני לגודל המועדף.
קבלת תמיכה ב-Managed Service for Apache Spark
מה ההבדל בין Managed Service for Apache Spark לבין שינוי גודל אוטומטי ב-Dataflow?
מידע נוסף זמין במאמרים בנושא התאמה אוטומטית לעומס ב-Dataflow והתאמה אוטומטית לעומס ב-Dataflow Prime.
האם צוות הפיתוח של Managed Service for Apache Spark יכול לאפס את סטטוס האשכול מ-ERROR בחזרה ל-RUNNING?
באופן כללי, לא. כדי לעשות זאת, צריך לבדוק באופן ידני אם בטוח לאפס את מצב האשכול. לעיתים קרובות אי אפשר לאפס את האשכול בלי לבצע שלבים ידניים אחרים, כמו הפעלה מחדש של HDFS NameNode.
הסטטוס ERROR מוגדר לאשכול ב-Managed Service for Apache Spark כשאי אפשר לקבוע את הסטטוס של האשכול אחרי פעולה שנכשלה. לא מתבצע מידרוג אוטומטי של אשכולות ב-ERROR. היא מופיעה בדרך כלל מהסיבות הבאות:
שגיאות שמוחזרות מ-Compute Engine API, לרוב במהלך הפסקות זמניות של Compute Engine.
מערכת HDFS נכנסת למצב פגום בגלל באגים בהוצאה משימוש של HDFS.
שגיאות ב-Dataproc Control API, כמו "Task lease expired".
מוחקים ויוצרים מחדש אשכולות שהסטטוס שלהם הוא ERROR.
מתי התאמה אוטומטית לעומס מבטלת פעולת הקטנה?
התרשים הבא ממחיש מתי ההתאמה האוטומטית לעומס תבטל פעולה של הקטנת קנה המידה (ראו גם איך פועלת ההתאמה האוטומטית לעומס).
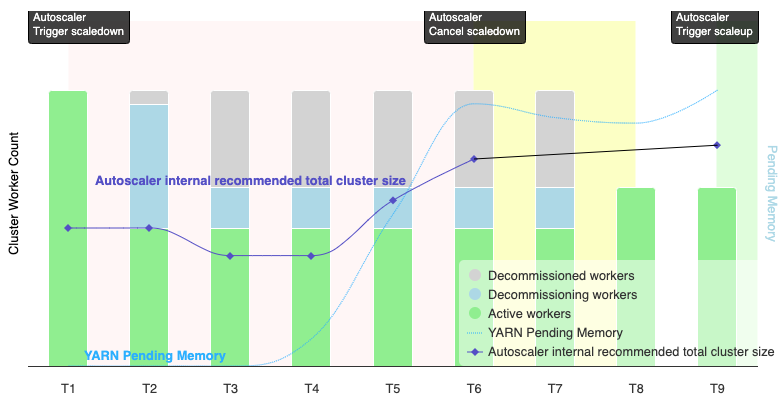
הערות:
- באשכול מופעלת התאמה אוטומטית לעומס (autoscaling) על סמך מדדי הזיכרון של YARN בלבד (ברירת המחדל).
- T1-T9 מייצגים את מרווחי הזמן של הצינון, שבהם ה-autoscaler מעריך את מספר ה-workers (תזמון האירועים פושט).
- העמודות המצטברות מייצגות את מספר ה-workers של YARN באשכול שהם פעילים, בתהליך הוצאה משימוש או שהוצאו משימוש.
- מספר העובדים המומלץ על ידי התכונה להתאמה אוטומטית לעומס (הקו השחור) מבוסס על מדדי הזיכרון של YARN, על מספר העובדים הפעילים של YARN ועל הגדרות המדיניות של התאמה אוטומטית לעומס (ראו איך התאמה אוטומטית לעומס פועלת).
- האזור עם הרקע האדום מציין את התקופה שבה פעולת ההקטנה פועלת.
- האזור עם הרקע הצהוב מציין את התקופה שבה פעולת ההקטנה מתבטלת.
- האזור הירוק ברקע מציין את התקופה של פעולת ההרחבה.
הפעולות הבאות מתרחשות בזמנים הבאים:
T1: המידרוג האוטומטי מתחיל פעולת ביטול הדרגתית של ההקצאה כדי לצמצם את מספר העובדים באשכול בכמחצית.
T2: המידרוג האוטומטי ממשיך לעקוב אחרי המדדים של האשכול. ההמלצה לצמצום לא משתנה, והפעולה של צמצום ממשיכה. חלק מה-workers הוצאו משימוש, ואחרים בתהליך הוצאה משימוש (Managed Service for Apache Spark ימחק את ה-workers שהוצאו משימוש).
T3: המידרוג האוטומטי מחשב שאפשר לצמצם אנכית את מספר ה-workers עוד יותר, יכול להיות שהסיבה לכך היא שזיכרון YARN נוסף הפך לזמין. עם זאת, מכיוון שמספר ה-workers הפעילים בתוספת השינוי המומלץ במספר ה-workers לא שווה למספר ה-workers הפעילים בתוספת ה-workers שהוצאו משימוש או גדול ממנו, הקריטריונים לביטול הקטנת ההתאמה לא מתקיימים, והמידרוג האוטומטי לא מבטל את פעולת הקטנת ההתאמה.
T4: YARN מדווח על עלייה בזיכרון בהמתנה. עם זאת, המידרוג האוטומטי לא משנה את ההמלצה שלו לגבי מספר ה-workers. כמו ב-T3, הקריטריונים לביטול ההקטנה לא מתקיימים, והמידרוג האוטומטי לא מבטל את פעולת ההקטנה.
T5: הזיכרון הממתין של YARN גדל, והשינוי במספר ה-workers שמומלץ על ידי ה-autoscaler גדל. עם זאת, מכיוון שמספר ה-workers הפעילים בתוספת השינוי המומלץ במספר ה-workers קטן ממספר ה-workers הפעילים בתוספת ה-workers שהוצאו משימוש, הקריטריונים לביטול עדיין לא מתקיימים ופעולת ההקטנה לא מבוטלת.
T6: הזיכרון בהמתנה של YARN ממשיך לגדול. מספר העובדים הפעילים בתוספת השינוי במספר העובדים שמומלץ על ידי קנה המידה האוטומטי גדול עכשיו ממספר העובדים הפעילים בתוספת העובדים שיצאו משימוש. הקריטריונים לביטול מתקיימים, והמידרוג האוטומטי מבטל את פעולת ההקטנה.
T7: המידרוג האוטומטי ממתין לסיום הביטול של פעולת צמצום הקיבולת. במהלך המרווח הזה, ההתאמה האוטומטית לעומס לא מעריכה את מספר ה-workers ולא ממליצה על שינוי במספר שלהם.
T8: הסתיימה הפעולה של ביטול הקטנת קנה המידה. עובדים שהוצאו משימוש נוספים לאשכול והופכים לפעילים. המידרוג האוטומטי מזהה שהביטול של פעולת ההקטנה הושלם, וממתין לתקופת ההערכה הבאה (T9) כדי לחשב את מספר ה-workers המומלץ.
T9: אין פעולות פעילות בזמן T9. בהתאם למדיניות של ה-autoscaler ולמדדי YARN, ה-autoscaler ממליץ על פעולת הגדלה.